Как организовать общий контекст между разными AI-платформами
На идею этой статьи меня натолкнул разговор с менеджером продукта, который использовал несколько AI-платформ для работы над одним проектом.
В зависимости от задачи он выбирал разные инструменты: один AI, по его мнению, лучше справлялась с дизайном, другая - с аудитом. Иногда он выполнял одну и ту же задачу в нескольких AI-сервисах, чтобы сравнить результаты.
Но при переходе между AI-платформами приходилось заново передавать информацию о продукте: требования, ограничения и ранее принятые решения. Если в ходе работы с одной платформой появлялись новые решения или менялись требования, эту информацию нужно было вручную передавать остальным. Иначе разные AI продолжали работать с разными версиями контекста.
Для передачи контекста существуют разные решения. Можно использовать единый интерфейс для нескольких моделей, например Open WebUI, или предоставить AI-инструментам доступ к общим документам через интеграции либо MCP.
Я выбрал вариант с единым источником проектного контекста, к которому могут обращаться разные AI-платформы. В качестве хранилища можно использовать, например, Google Drive или GitHub. В моём случае это GitHub и Markdown-файлы: они позволяют организовать документацию в простой структуре, отслеживать изменения через Git и не привязывать контекст к конкретному AI-сервису.
Так появился AI Context Kit, который я покажу на практическом примере.
В предыдущей статье я рассказывал, как организовать проектный контекст для длительной работы с AI-чатами. Здесь покажу, как использовать такой контекст в нескольких AI-платформах, не поддерживая отдельную копию для каждой.
Что такое AI Context Kit
AI Context Kit - открытый набор шаблонов и инструкций для организации проектного контекста в Git-репозитории.
В основе лежит простая идея: разделить информацию о проекте на несколько Markdown-файлов, каждый из которых отвечает за свою часть контекста.
При этом AI Context Kit не является отдельной AI-платформой или MCP-сервером. Он не обрабатывает запросы и не синхронизирует диалоги между сервисами. Его задача - предоставить готовую структуру проектной документации и правила её использования и обновления.
Способ подключения и возможность изменять файлы зависят от конкретного AI-инструмента.
Как устроен AI Context Kit
В репозитории AI Context Kit находятся готовые шаблоны документов. Для работы с ними создаём собственный GitHub-репозиторий, копируем необходимые шаблоны и организуем структуру следующим образом:
my-ai-context/
├── PROJECTS.md
└── projects/
    ├── project-one/
    │   ├── PROJECT.md
    │   ├── CONTEXT.md
    │   └── INSTRUCTIONS.md
    └── project-two/
        ├── PROJECT.md
        ├── CONTEXT.md
        └── INSTRUCTIONS.md
В корне созданного репозитория находится PROJECTS.md — реестр проектов. В директории projects/ для каждого проекта создаётся отдельная папка с тремя основными документами.
PROJECT.md - описание проекта.
Здесь хранится относительно постоянная информация: цели, аудитория, границы проекта и основные ограничения. Например, для нового продукта можно описать, какую проблему он решает, для кого предназначен и какие требования необходимо учитывать.
Пошаговое создание репозитория и подключение AI-платформ описаны в инструкции по настройке.
CONTEXT.md - текущее состояние.
Самая динамичная часть контекста. В ней фиксируются принятые решения, значимые результаты, открытые вопросы и следующие шаги. Например, если при проектировании интерфейса вы решили отказаться от одной из функций продукта, это изменение стоит сохранить в CONTEXT.md, чтобы другие AI-инструменты учитывали его в дальнейшей работе.
INSTRUCTIONS.md - правила работы с контекстом.
Этот файл определяет, как AI должен использовать проектные документы, учитывать существующие решения и поддерживать контекст актуальным. Например, после важного этапа предлагать изменения в CONTEXT.md, согласовывать их с пользователем и проверять актуальную версию файла перед обновлением.
Отдельно в настройках AI-проекта указываются GitHub-репозиторий и директория, из которой необходимо загружать документы. Таким образом, разные AI-платформы могут обращаться к одному набору файлов, используя собственные механизмы подключения.
Зачем разделять контекст на несколько файлов?
Разные части проектной информации изменяются с разной частотой. Цели и ограничения могут оставаться неизменными месяцами, а решения, результаты и следующие шаги обновляются регулярно. Такое разделение позволяет обновлять текущее состояние проекта, не переписывая его полное описание. При необходимости структуру можно расширить документами с исследованиями, задачами или историей решений.
Практический пример: один проект в разных AI-платформах
Для демонстрации создаём проект product-launch - пример сервиса планирования личных задач. В рамках проекта нужно определить концепцию продукта, разработать интерфейс и провести аудит решения.
Для каждого этапа можно использовать тот AI-инструмент, который удобнее для конкретной задачи. При этом разные AI смогут обращаться к одному источнику проектного контекста GitHub-репозиторию.
Шаг 1. Создаём общий контекст
В репозитории создаём отдельную директорию projects/product-launch/ с тремя файлами: PROJECT.md, CONTEXT.md и INSTRUCTIONS.md.
В PROJECT.md описываем продукт, его аудиторию, цели и ограничения.
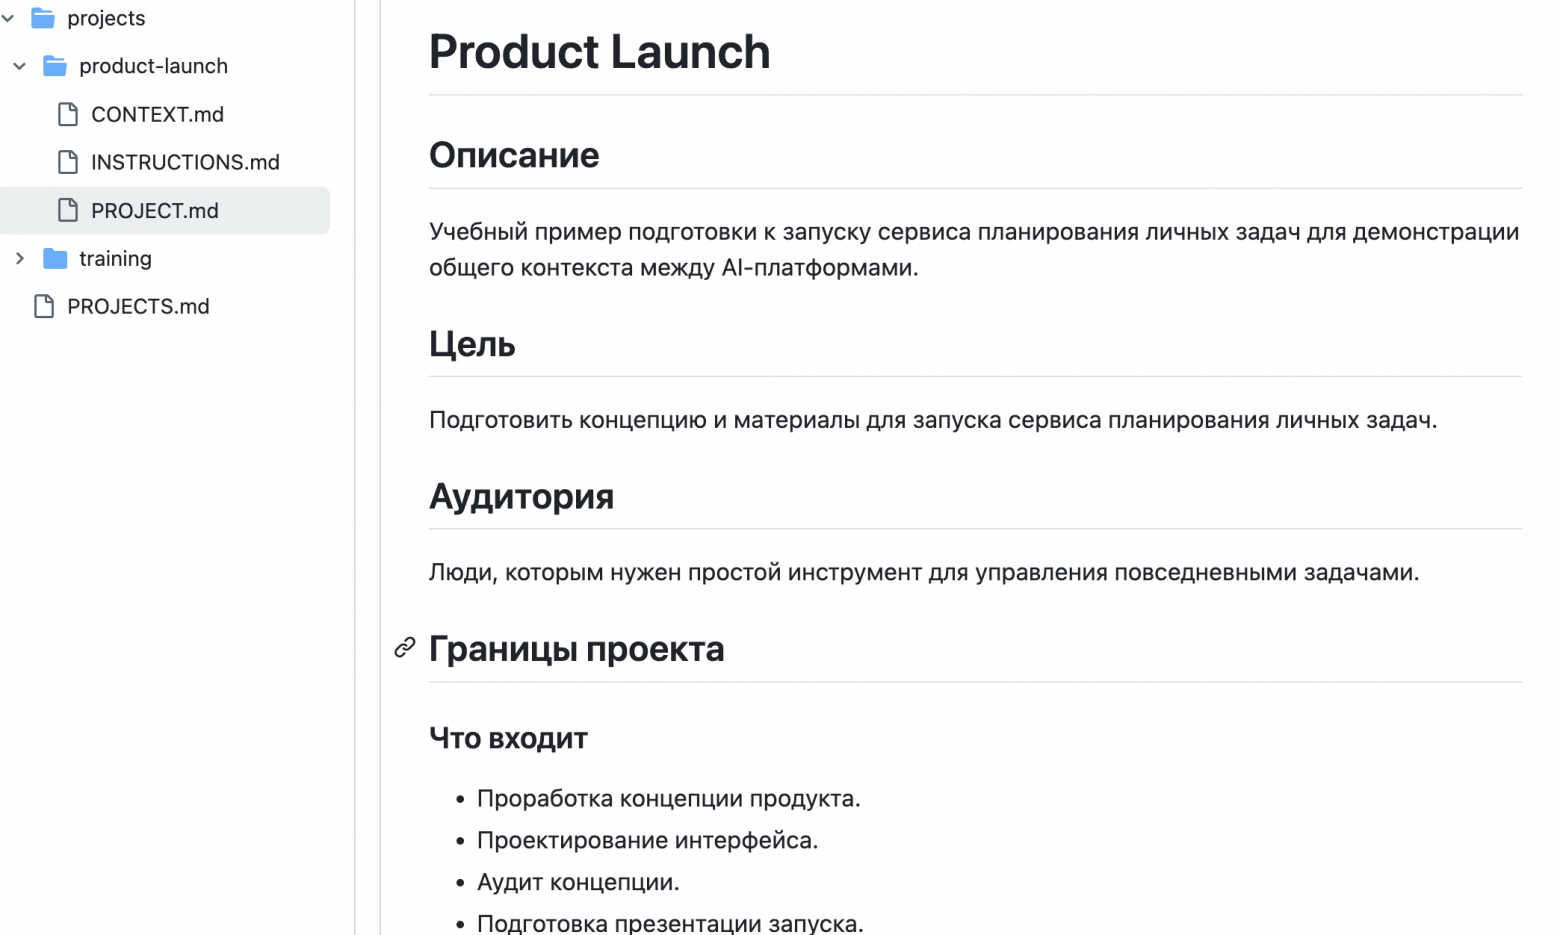
В CONTEXT.md фиксируем текущее состояние проекта: подготовку концепции, принятые решения и следующий этап.
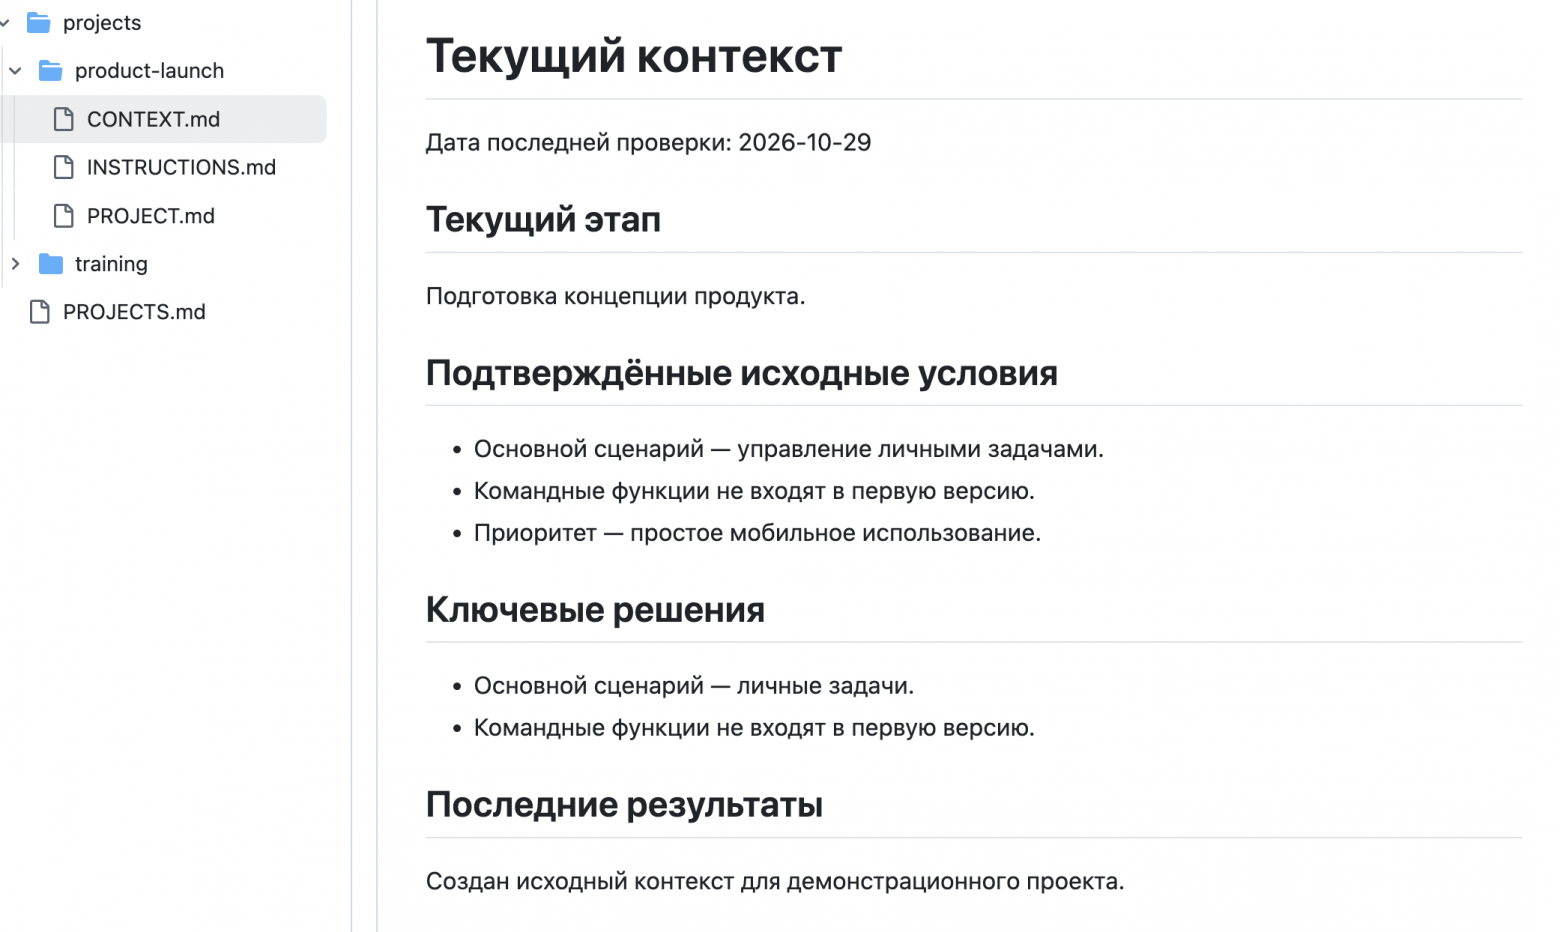
CONTEXT.md.В INSTRUCTIONS.md задаём правила работы AI с проектом.
Теперь у проекта есть общий источник информации, к которому можно подключить разные AI-платформы.
Шаг 2. Работаем над дизайном
Концепцию интерфейса прорабатываем в ChatGPT.
Подключаем GitHub через доступную интеграцию. В Project Instructions указываем репозиторий, директорию projects/product-launch/ и файлы, которые необходимо прочитать.
Для примера принимаем решение: главный экран должен показывать задачи на сегодня, а календарь будет дополнительным способом просмотра задач. Сохраняем его в CONTEXT.md, чтобы оно было доступно на следующих этапах.
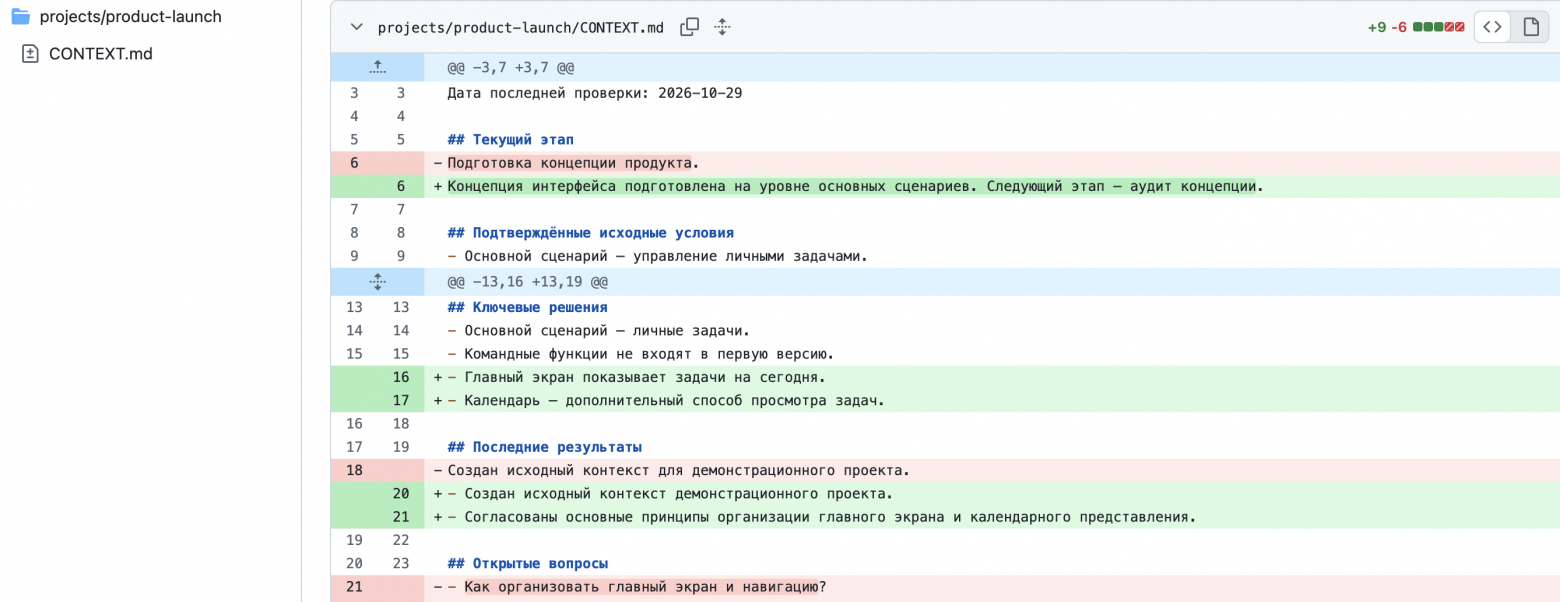
CONTEXT.md после обсуждения концепции интерфейсаПри этом в общий контекст переносим не всю историю обсуждения, а только принятые решения и информацию, необходимую для следующих этапов проекта.
Шаг 3. Переходим к аудиту в Claude
Подключаем тот же GitHub-репозиторий и указываем директорию projects/product-launch/. Просим Claude прочитать актуальный CONTEXT.md.
В ответе Claude видим решения, зафиксированные на предыдущем этапе: главный экран показывает задачи на сегодня, а календарь остаётся дополнительным способом просмотра задач.
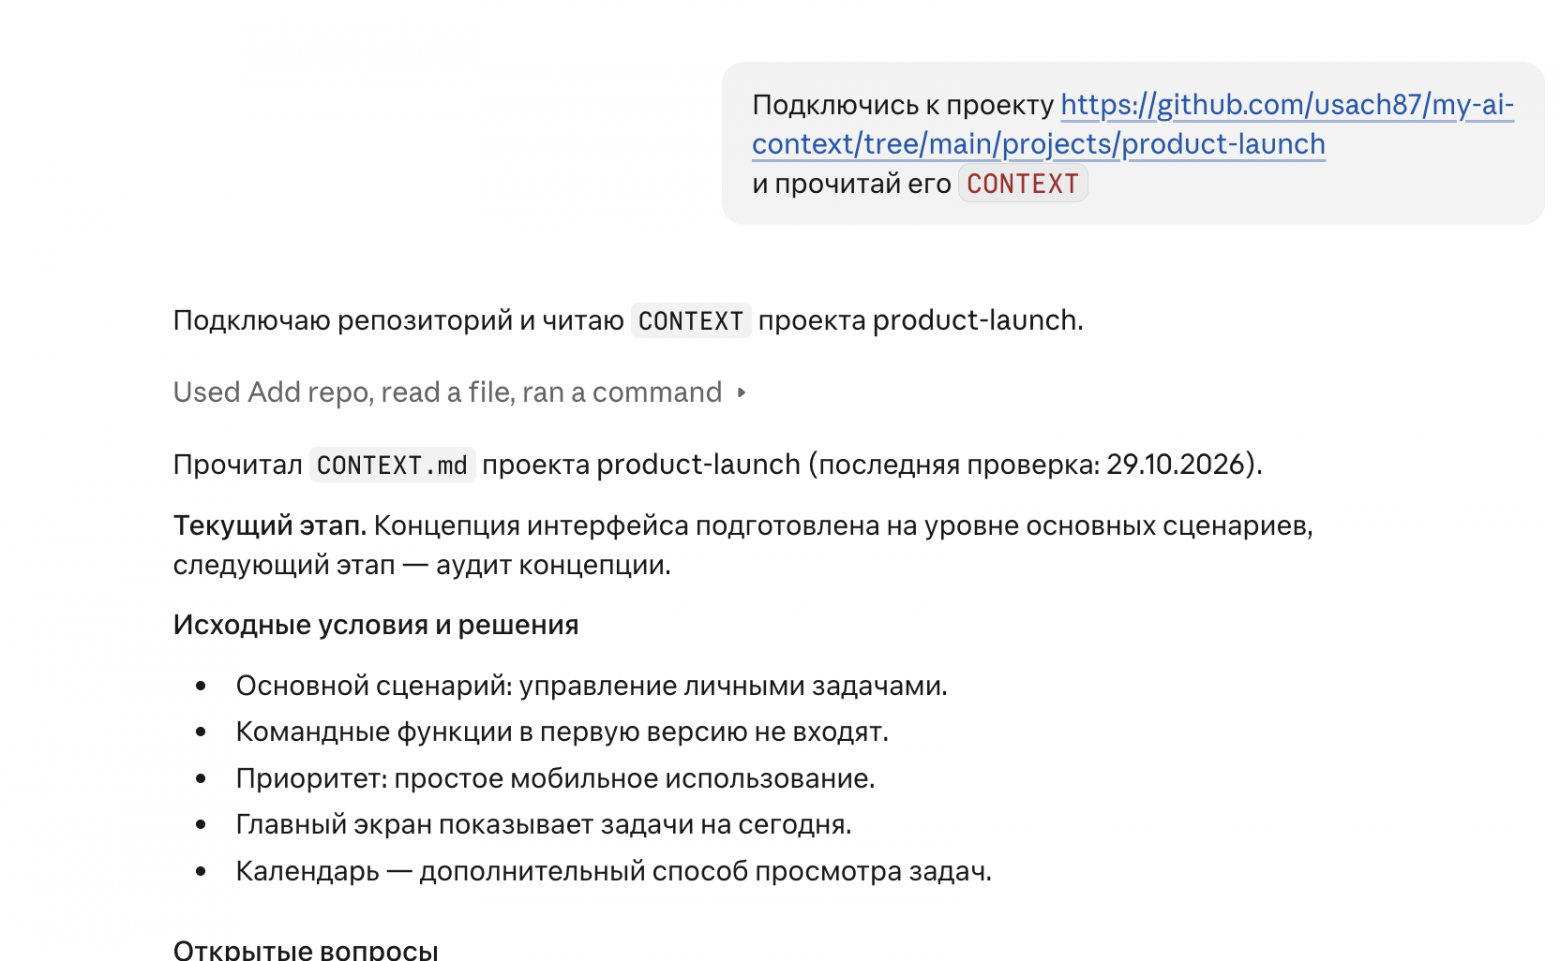
CONTEXT.md и получает решения, принятые на предыдущем этапеТеперь можно переходить к аудиту интерфейса, не пересказывая историю обсуждения в ChatGPT.
Как поддерживать контекст актуальным
Общее хранилище само по себе не гарантирует актуальность информации. Если важное решение не попало в CONTEXT.md, следующий AI-инструмент получит устаревшие данные. А одновременное редактирование документов разными AI может привести к конфликтам версий или потере изменений.
Чтобы снизить эти риски, в AI Context Kit предусмотрены правила работы с контекстом через INSTRUCTIONS.md. AI должен использовать актуальные проектные документы, а перед важными решениями и обновлением CONTEXT.md - проверять их свежую версию. После значимых изменений AI предлагает обновить контекст и сохраняет правки только после согласования с пользователем. При этом фиксируются не все обсуждения, а лишь информация, необходимая для дальнейшей работы.
Перед записью также важно проверять, не изменился ли документ с момента чтения. Если интеграция поддерживает условную запись с проверкой версии файла, например по SHA, это помогает предотвратить случайную перезапись чужих изменений. Если автоматическое обновление недоступно, правки можно внести вручную.
Таким образом, актуальность контекста зависит не только от общего хранилища, но и от соблюдения правил его обновления.
Ограничения и безопасность
AI Context Kit не обеспечивает автоматическую синхронизацию между AI-платформами. Возможности работы с GitHub зависят от конкретного AI: где-то доступна встроенная интеграция или MCP, а где-то документы придётся передавать вручную.
Инструкции в Markdown также не гарантируют, что AI всегда прочитает нужные файлы и выполнит все правила. Поэтому важно проверять, какой контекст действительно использовался.
Отдельное внимание стоит уделить доступу к данным. Для непубличной информации используйте приватные репозитории и не храните в них секреты. При этом разделение проектов по папкам не обеспечивает изоляцию прав: если проектам нужны разные уровни доступа, лучше использовать отдельные репозитории.
Наконец, подход предназначен для передачи структурированного проектного контекста, а не истории переписки, памяти моделей или всех созданных материалов. Макеты, презентации и другие артефакты остаются отдельными ресурсами.
Заключение
AI Context Kit позволяет использовать общий проектный контекст в разных AI-платформах, сохраняя его в обычных Markdown-файлах внутри Git-репозитория. Такой подход не требует собственного сервера, позволяет отслеживать изменения и не привязывает проектную документацию к одному AI-сервису.
При этом актуальность информации зависит от того, насколько последовательно обновляется контекст и как организован доступ к нему.
Шаблоны, инструкции и примеры настройки доступны в репозитории: AI Context Kit - GitHub
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.