Вредные советы для тех, кто хочет угробить A/B-эксперимент
Как без багов в коде получить мусорные данные, ложную победу и продуктовый релиз, который лучше было не выкатывать
Привет, Хабр! На связи команда ad-hoc аналитики X5 Tech.
В цифровых продуктах даже мелочь — цвет кнопки, формулировка заголовка или порядок экранов — влияет на поведение пользователей. Чтобы не гадать, команды запускают A/B-тесты: сравнивают варианты и выбирают решение, подтверждённое данными. Сегодня мы разберём надёжные способы всё испортить.
Разработчик закончил фичу, код покрыт тестами, на стенде всё зелёное, на проде ничего не падает. Команда уже готова раскатить изменения на всех, но приходят аналитики и говорят: «Эксперимент невалиден, данные использовать нельзя». Звучит как бюрократия, пока не разберёшься в деталях.
Любой A/B-тест состоит из маршрутизации пользователей, логики входа в эксперимент, деления на группы, метрик и правил принятия решений. Ошибка на любом этапе превращает тест в генератор красивых, но бесполезных графиков.
Что вообще проверяет A/B-тест
Если в двух словах, пользователей делят на две группы и показывают две версии в течение определённого периода времени. Контрольная видит старую версию, тестовая — новую. Потом команда сравнивает метрики и решает, можно ли считать разницу эффектом фичи, а не случайным шумом.
В хорошей реализации пользователь попадает в группу один раз, группа не меняется в процессе эксперимента, событие пишется в правильный момент, а метрики отражают реальный пользовательский и бизнес-результат.
В плохой реализации всё выглядит почти так же. Разница в том, что данные искажены: события пишутся не в тот момент, группы пересобираются по ходу, а метрики измеряют не то, что нужно. На выходе получаются такие же красивые графики, только верить им нельзя.
Вредный совет №1. Подглядывайте в тест каждый день
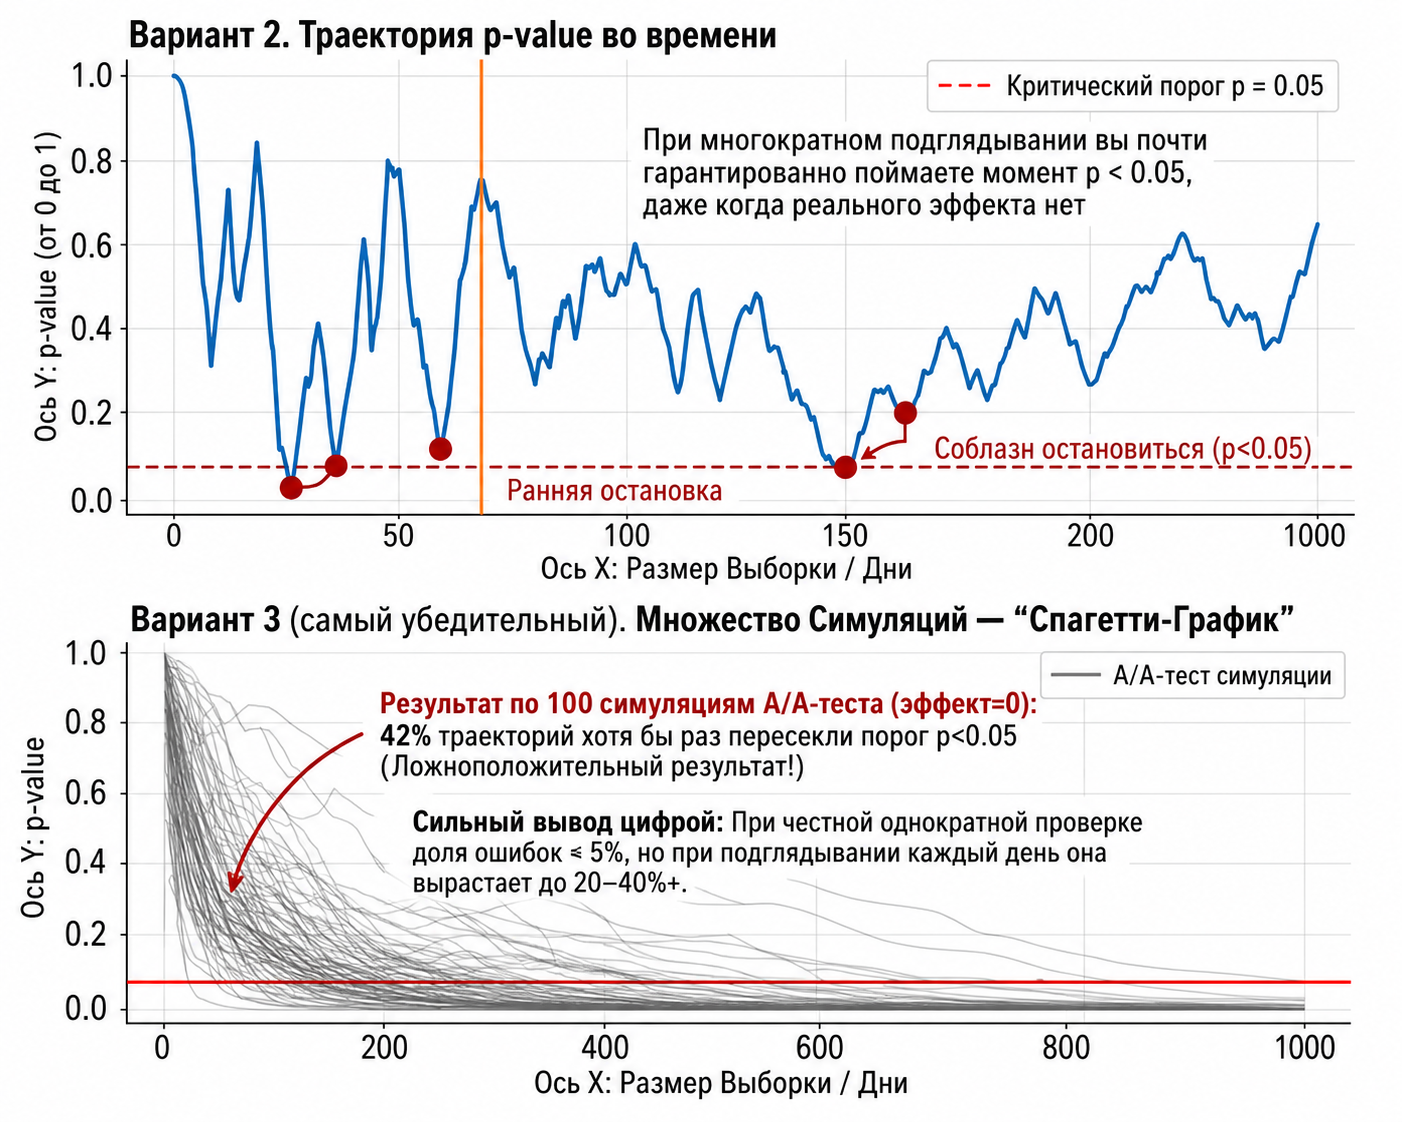
Классическая ситуация: тест длится второй день, метрика выросла на 50%, продакт прибегает с криком «катим на всех». График зелёный, настроение отличное, деньги якобы уже лежат на столе.
Но если проверять результаты A/B-теста по ходу эксперимента, риск ошибки первого рода вырастает выше запланированных 5%. Мы рискуем принять случайное колебание за реальный эффект и выкатить изменение, которое на самом деле ни на что не влияет. Чем чаще команда смотрит на промежуточные графики, готовая остановить тест в удачный момент, тем выше шанс найти «победу» там, где её нет.
Это не запрет смотреть на мониторинг вообще. Сломанные события, краши, резкое падение выручки и технические алерты нужно видеть сразу. Но решение о победе в ходе теста должно приниматься по заранее заданному правилу: сколько длится эксперимент, какая основная метрика, какой минимальный эффект хотим поймать, какой метод проверки используем. Без такого правила команда играет в казино с интерфейсом аналитической панели.
Вредный совет №2. Тестируйте по всем пользователям
Представим, что команда тестирует новую кнопку оплаты в корзине. Логично, что изменение увидят только те пользователи, которые дошли до корзины. Но если запустить тест на вообще всех пользователей, в метрики попадут и те, кто просто открыл приложение, посмотрел пару товаров и ушёл.
Если до нужного экрана доходит только 5% аудитории, то эффект от кнопки размоется среди остальных 95% пользователей, которые её даже не видели. На графиках это будет выглядеть так, будто ничего не произошло. На самом же деле эффект есть, просто мы добавили в сравнение лишних людей.
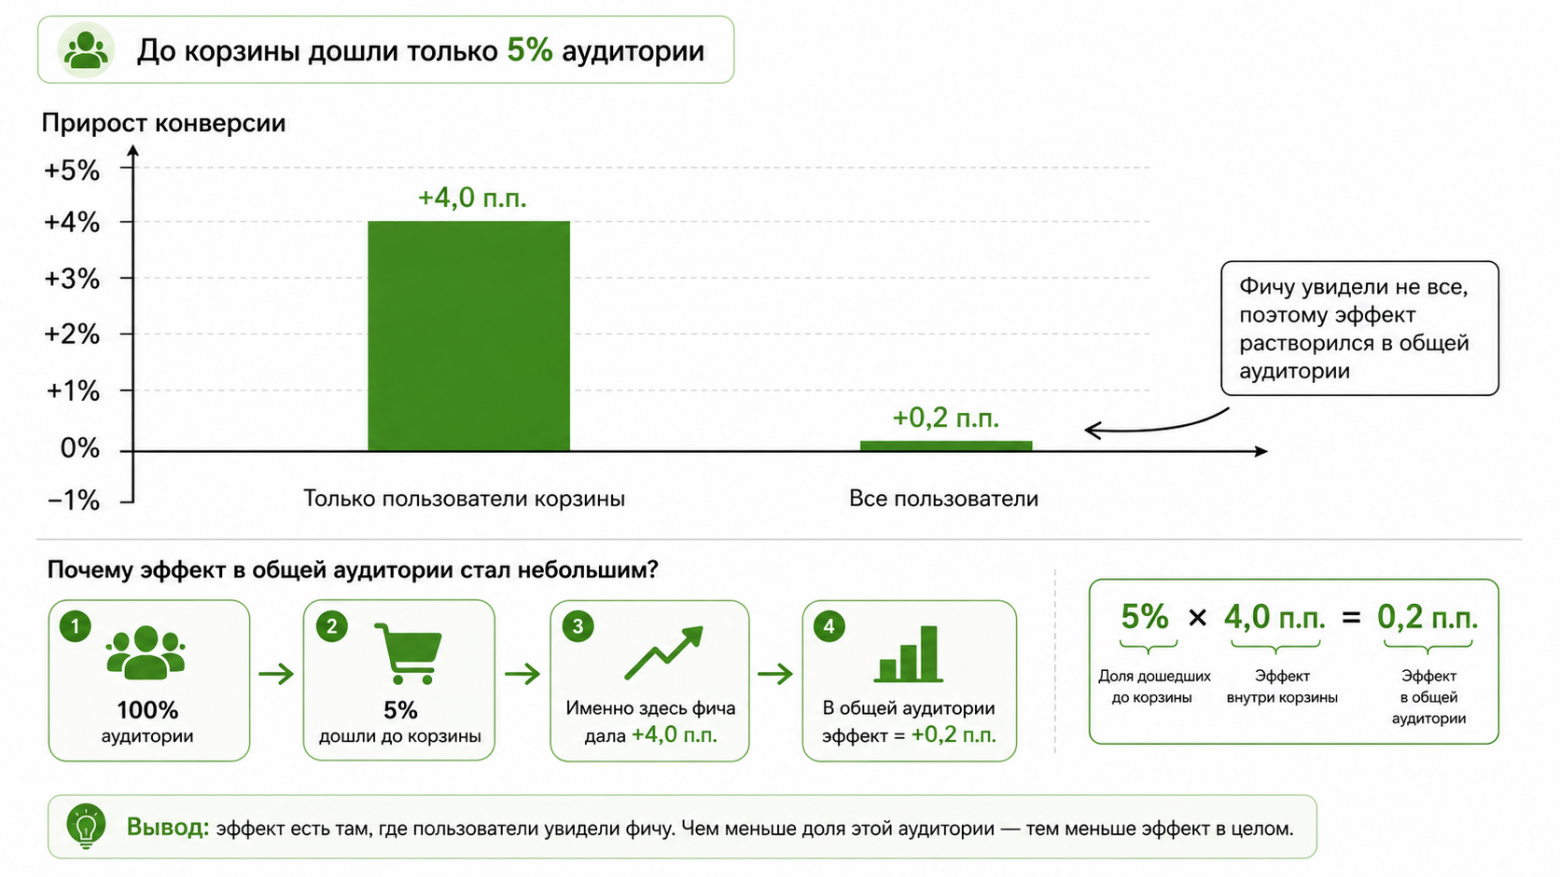
Поэтому нужно фиксировать участие в тесте в момент реального контакта: когда пользователь увидел новый элемент, попал в изменённый сценарий или открыл нужный экран. Этот подход называют триггерным анализом. Он оценивает только ту часть аудитории, которую реально затронул эксперимент, и помогает не размывать результаты.
Вредный совет №3. Считайте эффект новизны настоящей любовью пользователей
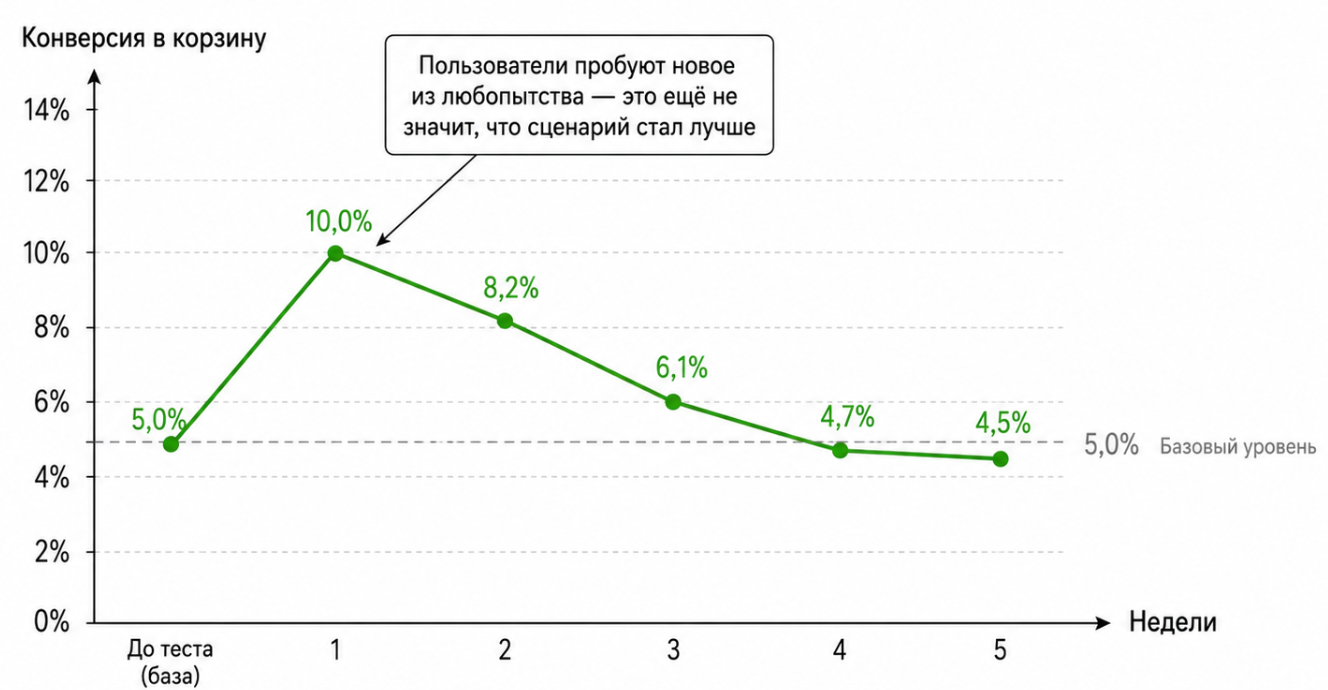
Команда меняет привычную кнопку «Купить» на модный свайп. В первую неделю конверсия вырастает в два раза. Все довольны: интерфейс свежий, пользователи активно взаимодействуют, тест «доказал» успех. Но спустя месяц метрика падает ниже старой версии.
Так работает эффект новизны. Пользователи изучают необычный интерфейс, пробуют новое действие, нажимают и свайпают из любопытства. Это не всегда означает, что сценарий стал удобнее или полезнее. Иногда продукт просто получил краткий всплеск внимания.
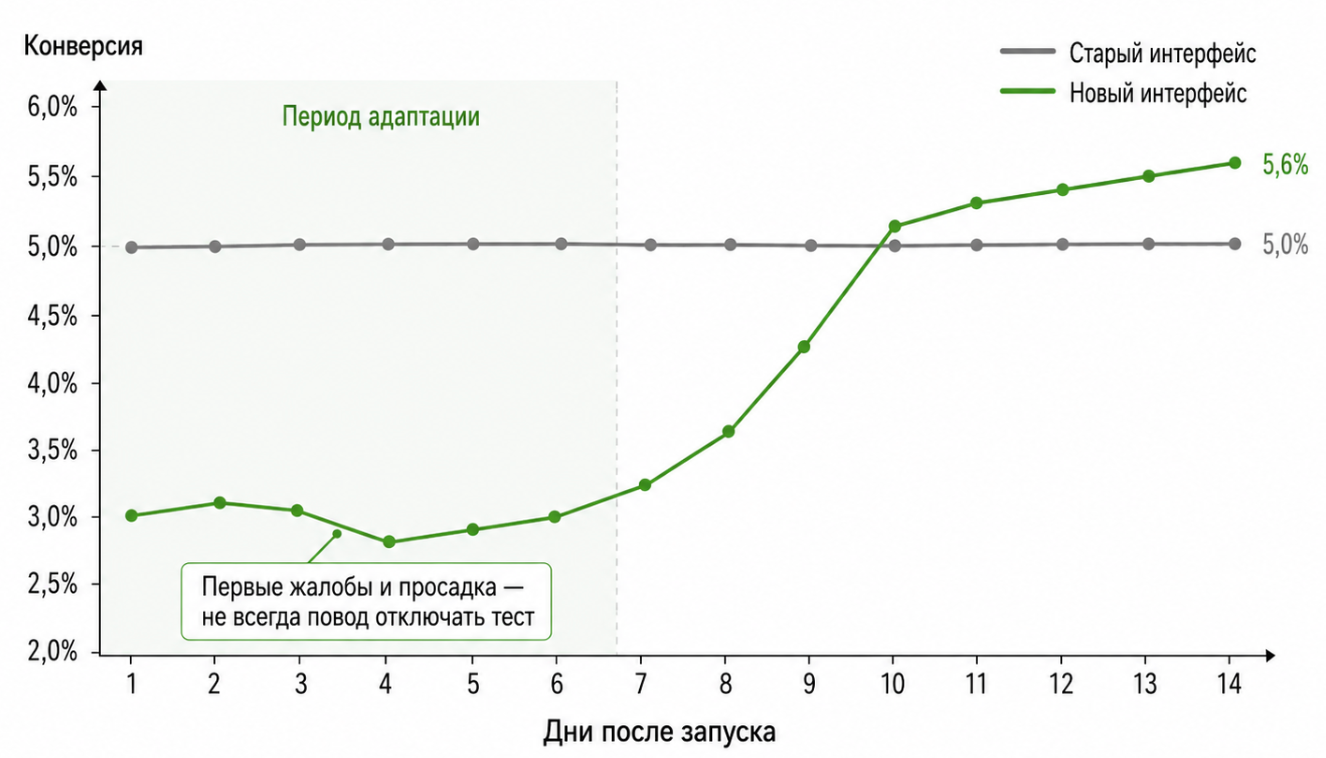
Для заметных изменений интерфейса стоит закладывать период привыкания. Первые дни можно использовать для технического контроля: всё ли грузится, нет ли крашей, корректно ли пишутся события. Основной подсчёт лучше начинать после адаптации, когда пользователь уже не тыкает в элемент потому, что он странный и новый.
Вредный совет №4. Убейте редизайн в первые сутки
Есть и обратная история. Команда делает более удобный, но непривычный редизайн. В первые дни метрики падают, в сторах появляются отзывы в стиле «Дуров, верни стену», в чатах начинается пожар. Тест выключают.
Через неделю пользователи, скорее всего, привыкнут, а спустя две начнут пользоваться новым сценарием быстрее. Но фичу уже похоронили.
Так проявляется отторжение изменений. Люди не любят, когда продукт ломает привычные маршруты. Даже полезное изменение сначала может ухудшить поведение: пользователю нужно найти кнопку, понять новую структуру, перестроить мышечную память.
Это не значит, что любой провал надо терпеть. Если редизайн ломает ключевой сценарий, бьёт по оплате или вызывает массовые ошибки, его надо чинить. Но для крупных изменений стоит заранее отделять период адаптации от периода измерения. Иначе команда принимает решение исходя не из качества интерфейса, а из отторжения аудитории на самом старте.
Вредный совет №5. Смотрите только на метрику, которую легко улучшить
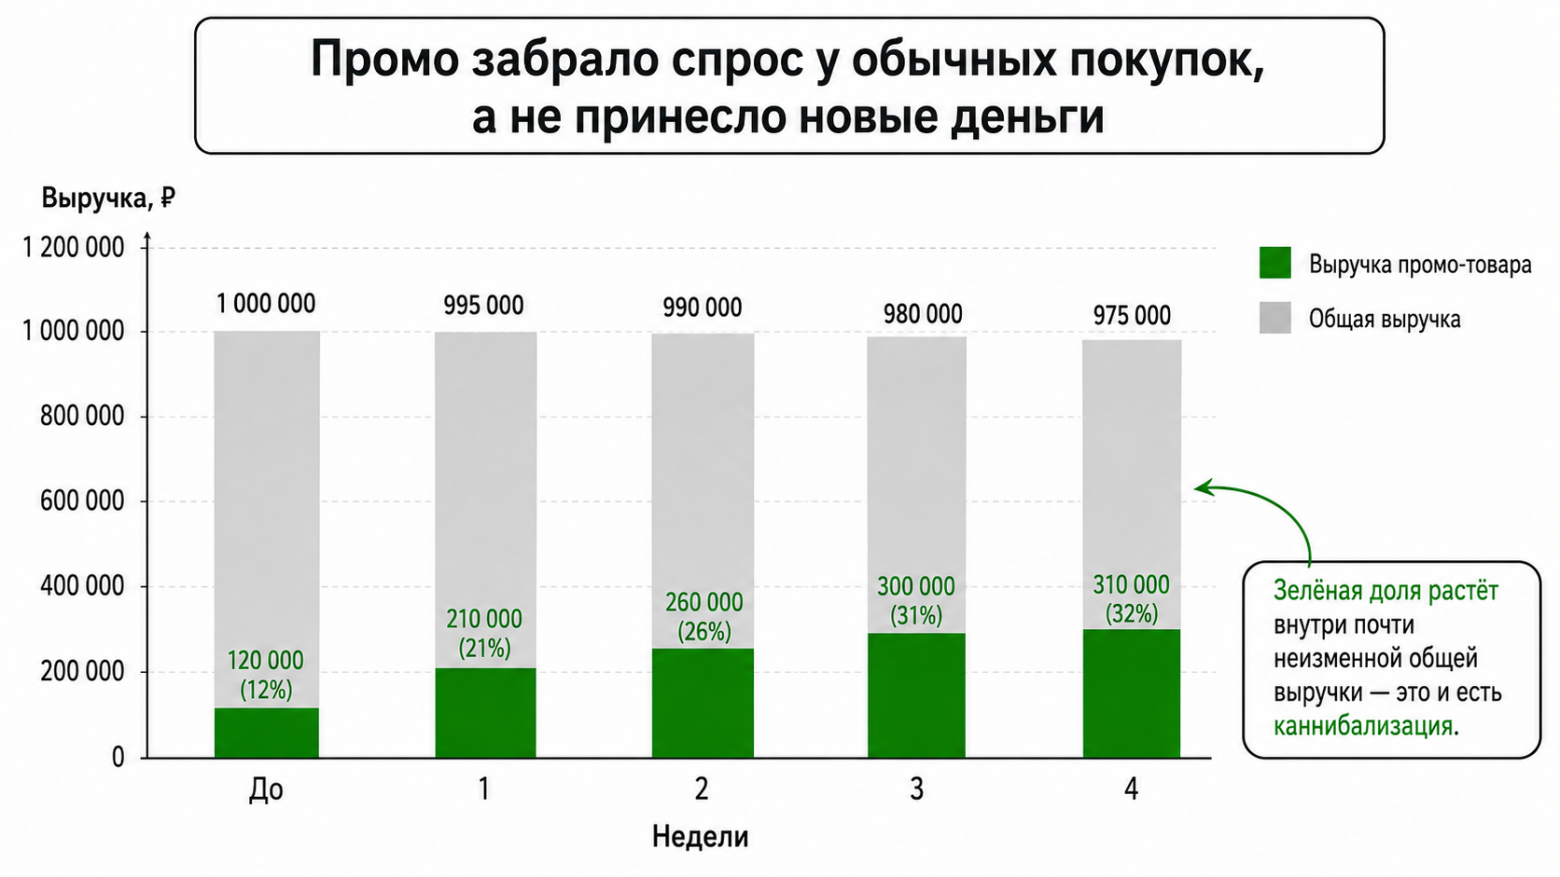
Команда промо делает огромный баннер на главном экране. Например, акцию на бананы — купить их можно по сниженной цене. Клики растут, продажи акционных товаров растут, тест выглядит успешным. Потом кто-то смотрит общую выручку и видит, что она стоит на месте или падает. Ведь вместо яблок и груш покупатели стали брать бананы, соблазнившись скидкой. И вот у нас просели другие категории товаров, которые могли быть и дороже, и увеличились бананы, которые дешевле. Если бананы скоро испортятся и нам надо продать их во что бы то ни стало — это хороший план, чтоб получить хоть какую-то выручку за них. Но если такой ситуации нет, то покупки бананов просто откусили кусок у другой категории товаров.
Так баннер не принёс новых денег, а просто перетянул внимание с других товаров. Метрика баннера победила, а бизнес потерял деньги.
Это называется каннибализация метрик. Она часто возникает в рекомендациях, промо, поиске, подписках, внутренних витринах и любых сценариях, где одна фича может отнять трафик у другой. Для таких тестов нужна не одна красивая метрика, а набор защитных метрик. Если проверяем промо, надо смотреть не только клики и продажи акционного товара, но и общую выручку, маржу, средний чек, возвраты, влияние на соседние категории.
Вредный совет №6. При таймауте отправляйте пользователя в контроль
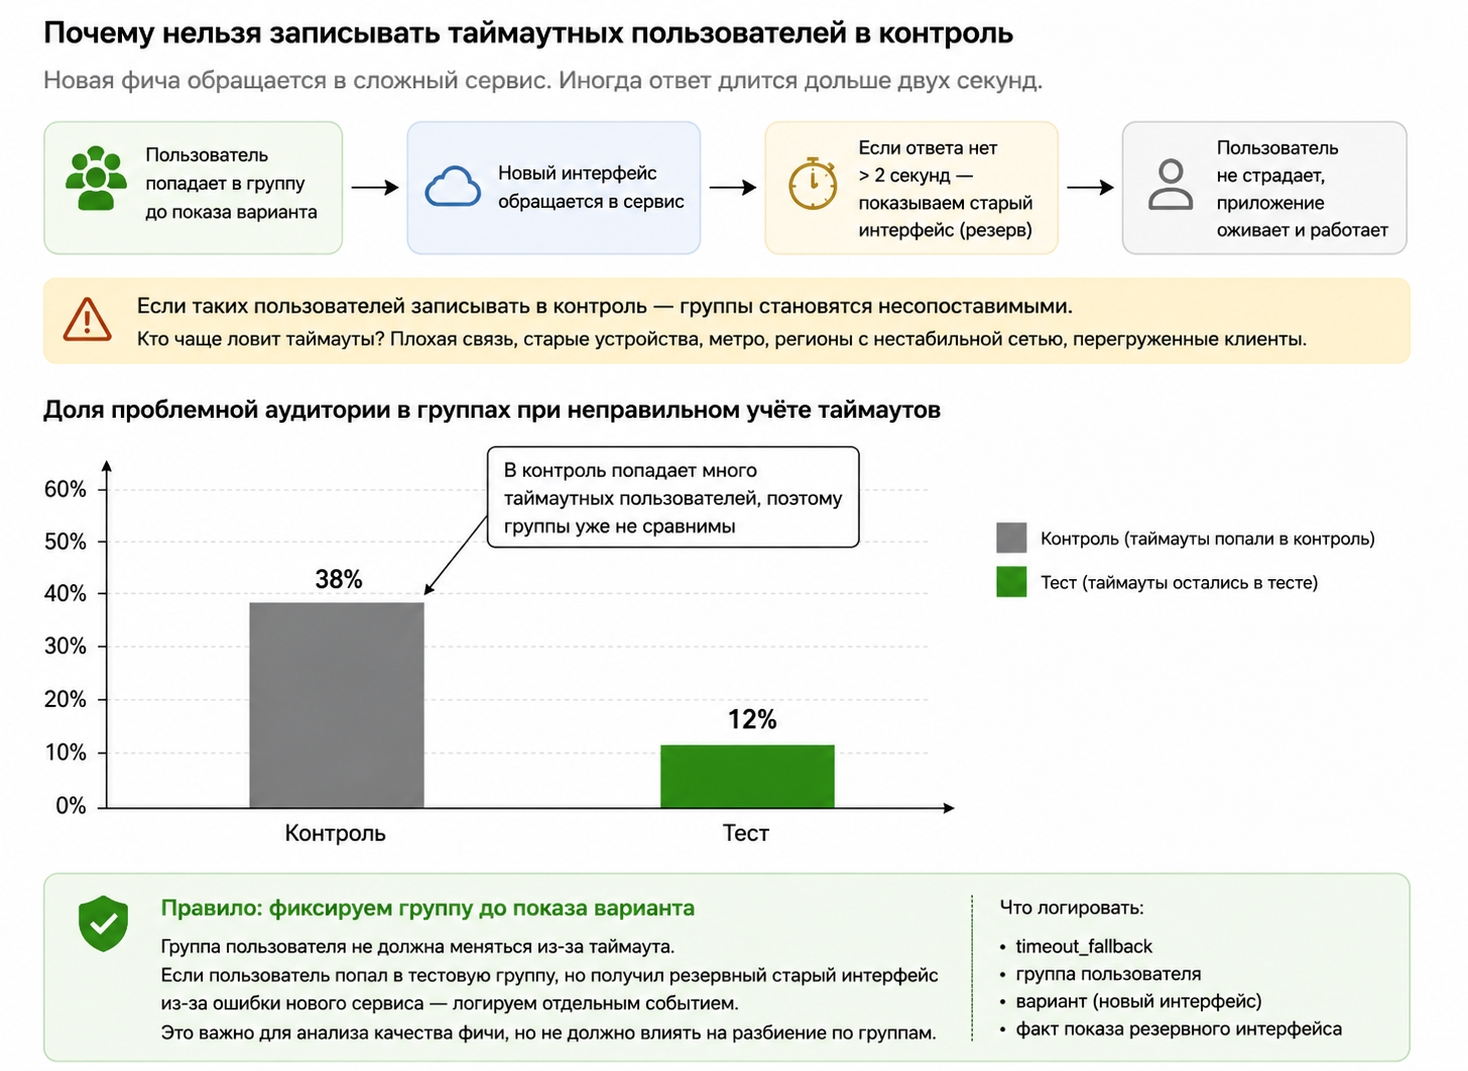
Новая фича обращается в сложный сервис. Иногда ответ длится дольше двух секунд. Разработчик делает надёжный резервный сценарий: если новый сервис не ответил, показываем старый интерфейс. Пользователь не страдает, приложение оживает и работает. Кажется, всё правильно.
Проблема появляется, если таких пользователей записывают в контрольную группу.
Кто чаще ловит таймауты? Пользователи с плохой связью, старые устройства, мобильный интернет в метро, регионы с нестабильной сетью, перегруженные клиенты. Если все они автоматически «переезжают» в старый интерфейс, контрольная группа становится тяжелее, а тестовая — чище и богаче технически.
Но проблема в том, что команда уже сравнивает не старую и новую версию, а разные аудитории.
Правило простое: группа пользователя должна фиксироваться в момент попадания в эксперимент и не меняться из-за таймаута. Если пользователь попал в тестовую группу, но получил резервный старый интерфейс из-за ошибки нового сервиса, это надо логировать отдельным событием. Такой случай важен для анализа качества фичи, но не должен влиять на разбиение по группам, иначе произойдёт подмена групп.
Вредный совет №7. Режьте данные, пока не наткнётесь на победу
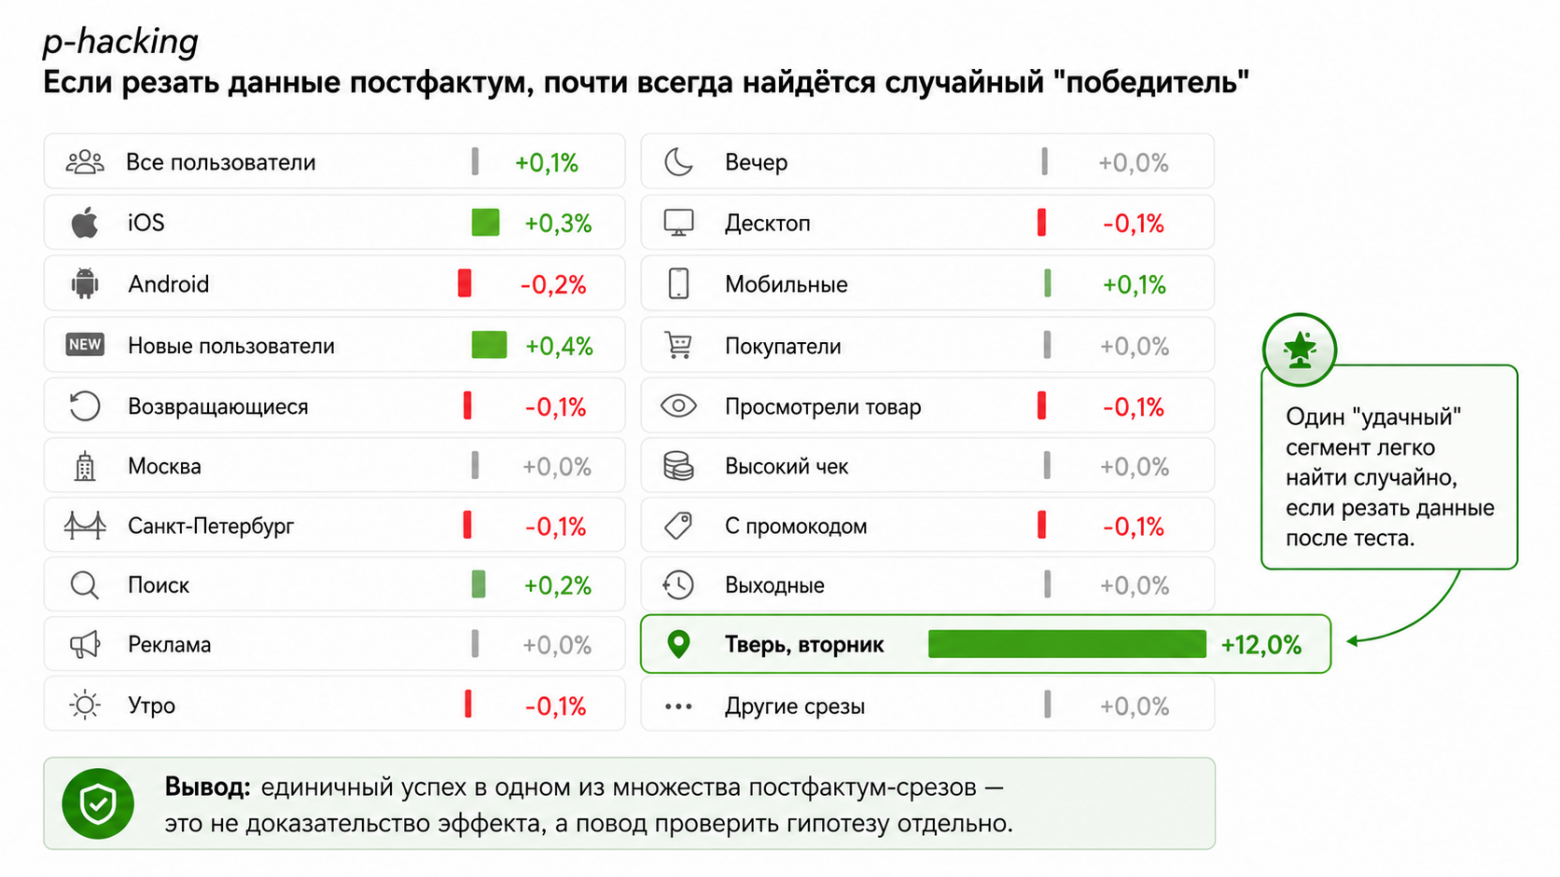
Общий тест не дал эффекта. Команда начинает искать: «А если посмотреть только iOS? А только Android? А новых пользователей? А тех, кто пришёл во вторник? А Москву без области? А пользователей из Твери, которые открыли приложение после обеда?». Где-нибудь зелёный сегмент всегда найдётся, но это будет лишь статистическая ловушка.
Чем больше срезов команда проверяет постфактум, тем выше шанс случайной «победы». Если для каждого сравнения оставлять стандартный порог ошибки, общий риск ложного вывода взлетит. Так работает p-hacking: данные режут до тех пор, пока случайность не покажется продуктовым эффектом.
Анализировать сегменты можно и нужно, но закладывать их в дизайн эксперимента нужно заранее. Например, сразу зафиксировать на старте: мы оцениваем общую метрику, а также отдельно сегменты iOS/Android и новых/старых пользователей. Тогда команда точно знает число сравнений и может применить поправку на множественную проверку гипотез. Главное — продумать все нюансы исследования ещё «на берегу», на этапе дизайна эксперимента.
Вредный совет №8. Смешайте три фичи в одном релизе
«Зачем запускать три теста? Давайте сразу поменяем цвет кнопки, перепишем рекомендации и обновим пуши». И вот через неделю метрики падают на 5%. Но что именно сломало конверсию? Новый цвет? Алгоритм рекомендаций? Пуши, которые всех достали? Или сочетание факторов?
Так рождается франкенштейн-релиз. Он удобен для календаря релизов и плохо подходит для эксперимента. A/B-тест должен проверять одну гипотезу. Если изменений несколько, нужен дизайн, который позволяет разделить эффекты.
Большой пакет изменений может быть нормальным продуктовым релизом, но плохим экспериментом. После него нельзя уверенно сказать, что именно дало тот или иной эаффект.
Вредный совет №9. Не проверяйте баланс групп
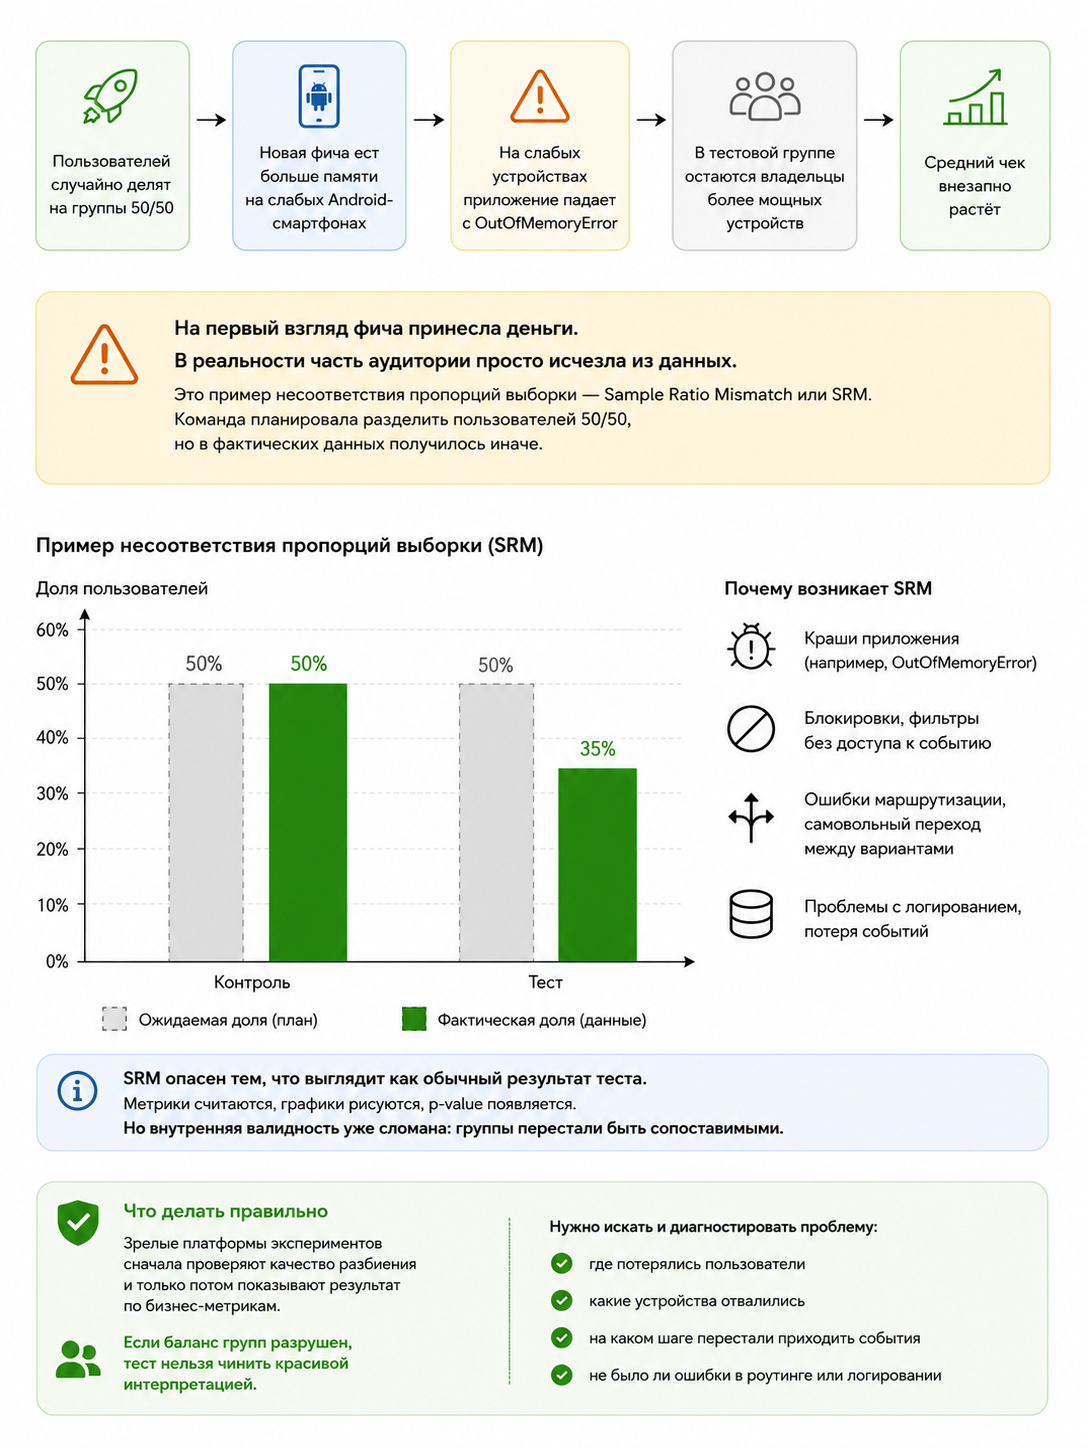
Новая фича ест больше оперативной памяти. На слабых Android-смартфонах приложение падает с OutOfMemoryError. В тестовой группе остаются владельцы более мощных устройств. Средний чек внезапно растёт.
На первый взгляд фича принесла деньги. В реальности часть аудитории просто исчезла из данных. Это пример несоответствия пропорций выборки — Sample Ratio Mismatch или SRM. Команда планировала разделить пользователей 50/50, но в фактических данных получилось иначе. Например, часть тестовой группы не долетела до события из-за краша, блокировки, ошибки маршрутизации, проблем с логированием или самовольного перехода между вариантами.
SRM опасен тем, что выглядит как обычный результат теста. Метрики считаются, графики рисуются, p-value появляется. Но внутренняя валидность уже сломана: группы перестали быть сопоставимыми.
Поэтому зрелые платформы экспериментов сначала проверяют качество разбиения и только потом показывают результат по бизнес-метрикам.
Один из базовых технических чеков — SRM-тест: он проверяет, совпали ли фактические пропорции групп с тем, что запланировано. Если эксперимент должен был делить пользователей 50/50, то в данных тоже должно быть примерно 50% пользователей в контроле и 50% в тесте. Небольшие случайные отклонения нормальны, но сильный перекос — например 50/38 вместо 50/50 — сигнализирует, что часть аудитории где-то потерялась.
Важно: SRM-тест не сообщает, какая версия лучше, и не оценивает бизнес-эффект фичи. Он отвечает на более базовый вопрос: можно ли вообще доверять сравнению групп. Если баланс разрушен, тест не починить красивой интерпретацией. Нужно искать и диагностировать проблему: где потерялись пользователи, какие устройства отвалились, на каком шаге перестали приходить события, не было ли ошибки в роутинге, логировании или доставке варианта.
Вредный совет №10. Оптимизируйте метрику, а не продукт
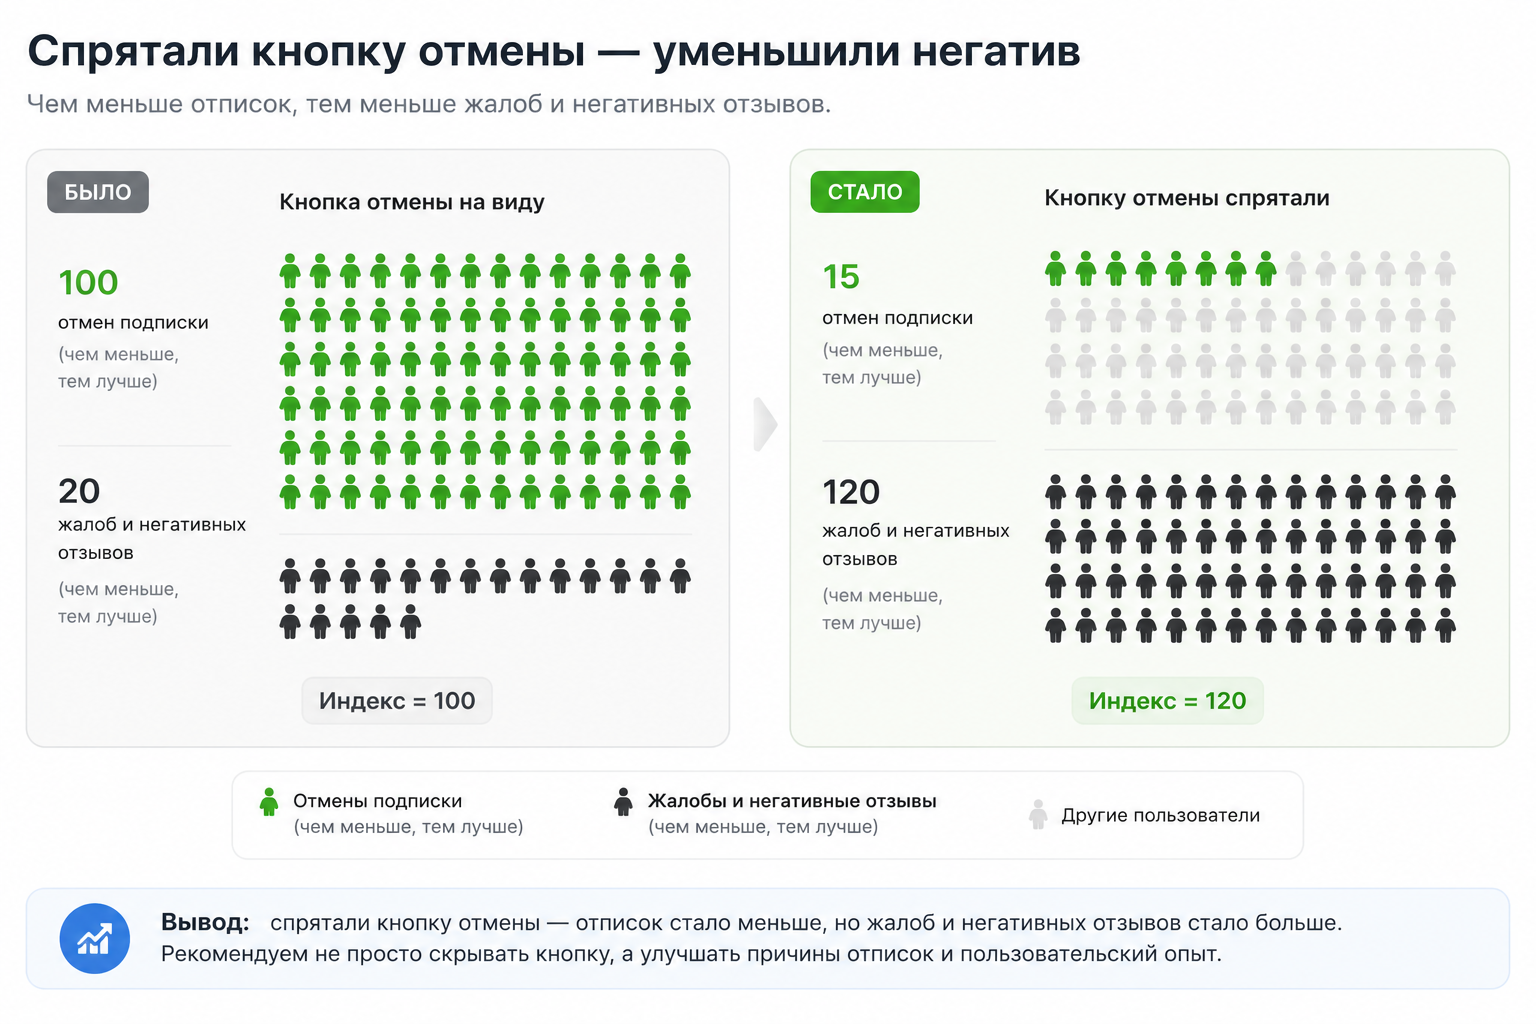
Допустим, задача — снизить долю отписок. Команда решает сделать кнопку «Отменить подписку» прозрачной и размером 1×1 пиксель. Отписки падают почти до нуля. Формально тест успешен.
Но затем пользователи идут в поддержку, пишут злые отзывы, оспаривают транзакции в банках и портят рейтинг приложения в сторах. Целевая метрика улучшилась, а продукт стал хуже.
Так в продуктовых тестах проявляется закон Гудхарта: когда показатель становится целью, он перестаёт быть хорошим показателем. Особенно быстро это происходит там, где метрику легко «хакнуть» дизайном. Поэтому у каждого эксперимента должны быть не только целевые метрики, но и ограничения (guardrail-метрики). Оценивайте систему целиком: метрик должно быть несколько, они должны включать контрольные показатели и отвечать здравому смыслу. И конечно, не стоит тестировать всякую ерунду вроде невидимых кнопок.
Вредный совет №11. Запускайте A/B-тест там, где нет трафика
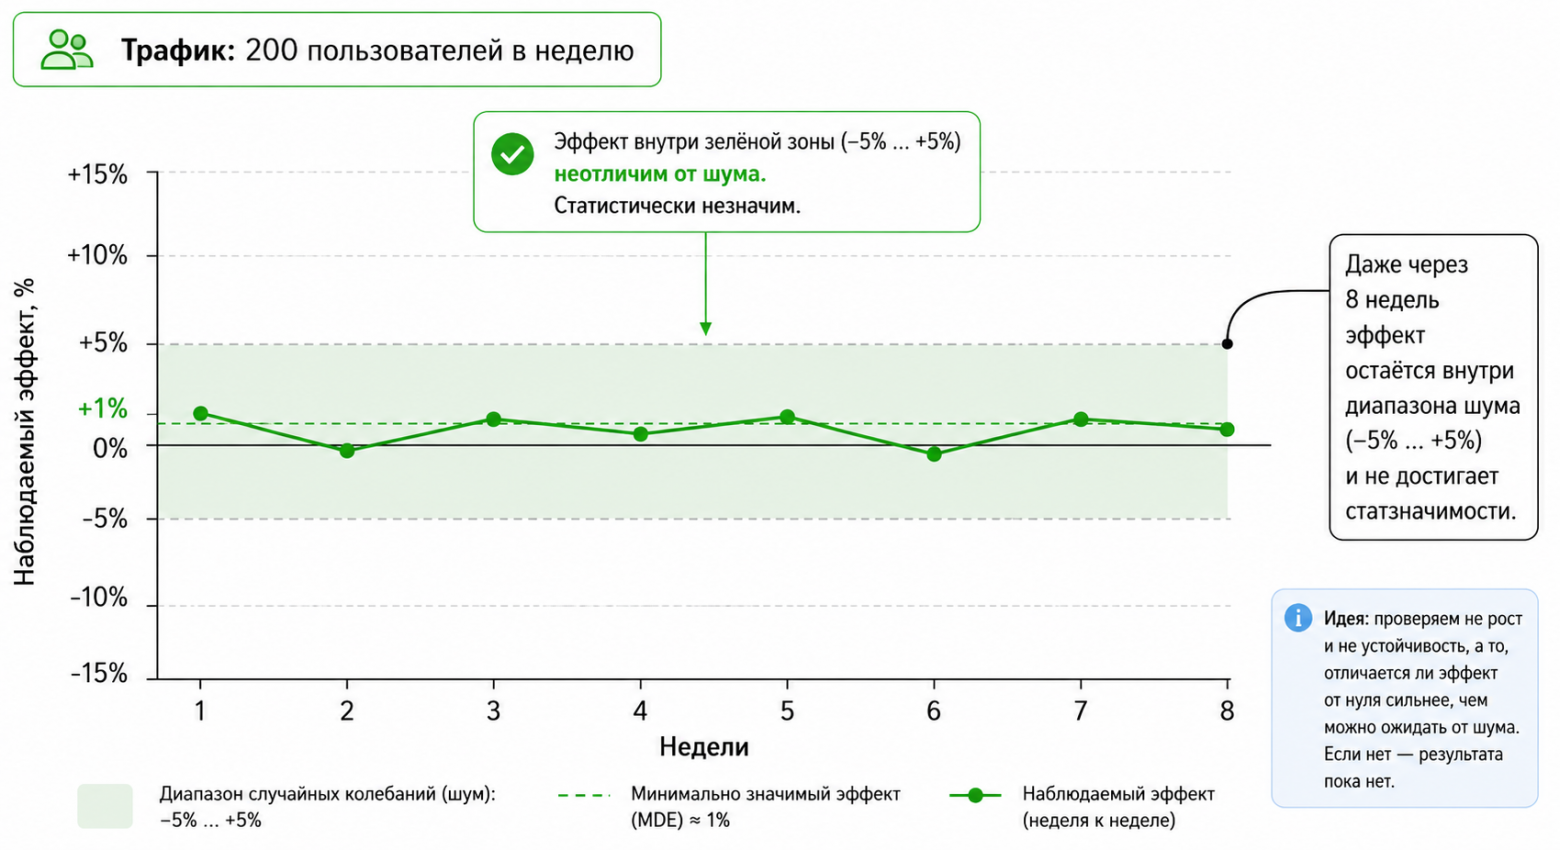
Представьте B2B-панель, куда заходят всего 200 менеджеров в месяц. Если запустить тест нового меню, собирать статистику придётся месяцев восемь. Для бизнеса это слишком долго.
На малом трафике тяжело поймать небольшие изменения за разумное время. Если новая фича даёт прирост всего в пару процентов, тест может длиться месяцами и так и не показать значимых результатов.
Перед стартом важно проводить дизайн эксперимента и рассчитывать MDE (минимальный детектируемый эффект) под ваш трафик. Если копить данные придётся слишком долго, лучше выбрать другой инструмент: UX-исследования, коридорные тесты, качественную аналитику, ручную проверку сценариев или пилот на нескольких крупных клиентах.
A/B-тестирование эффективно только тогда, когда у вас есть достаточный поток пользователей, а ожидаемый эффект от фичи сопоставим с расчётным MDE.
Выводы
Фиксируйте пользователя в момент реального контакта. Не добавляйте в тест тех, кто просто зашёл в приложение и не дошёл до фичи. Держите группу стабильной, несмотря на сетевые сбои, и логируйте резервные сценарии отдельно, чтобы не перемешивать пользователей.
Следите за технической чистотой. Если новый экран крашится на старых смартфонах, вы получите смещённую выборку. Перед анализом бизнес-метрик всегда проверяйте баланс групп, краши, таймауты и потери событий.
Один эксперимент должен отвечать на один продуктовый вопрос. Если одновременно меняются рекомендации, пуши и кнопки, тест может показать общий эффект пакета, но не объяснит, какая часть сработала.
Смотрите на картину целиком. Рост кликов, падение отписок или увеличение продаж одной категории не равны успеху, если вместе с ними просели выручка, удержание, поддержка, возвраты или рейтинг.
Проводите дизайн эксперимента до его начала. Аналитики, разработчики и продакты должны заранее договориться, кого считать участником, сколько продлится тест, какие метрики будут контрольными и что считать техническим сбоем. Правильный дизайн предотвращает большинство ошибок аналитики!
Над статьёй работали члены команды Ad‑Hoc X5 Tech: Матвей Пришибилович и Никита Беляев.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.