Мой агент получил высокий балл. Проверяю, что он сделал
Как проверить, что диалоговый агент выполнил задачу, если бенчмарк поставил высокий балл? В первой пробе мой агент получил награду 1 на всех пяти задачах. Потом заглушка без единого вызова инструмента набрала 34% на полном наборе.
Я разрабатываю собственную экспериментальную систему и называю её ELM. В её диалоговом варианте код предлагает действия, нейросеть выбирает из них, а код исполняет вызов и собирает ответ. В проверяемом здесь режиме нейросеть не пишет текст ответа.
Чтобы понять, что стоит за высокой наградой, я стал считать действия отдельно и проверил свой цикл исполнения контрольной моделью. Эта статья — разбор измерения и ошибок агента.
Считаю действия рядом с итоговой наградой
В ELM код предлагает действия, нейросеть-судья выбирает из них, код собирает ответ и исполняет вызов. Судья возвращает вероятности, текст не пишет. Цикл хранит состояние и результаты инструментов. Я проверял его на airline из tau2-bench, коммит b7ea9074c1cb: пользователь — другая модель, инструменты работают с базой бронирований.
pass^1 — доля задач с наградой 1 за один запуск каждой. Первая проба дала pass^1 = 1,000: все пять задач получили такую награду. Но совпавших с эталоном действий было 2 из 13. «Пять из пяти» пришлось перечитать.
Награда здесь проверяет конечное состояние базы и коммуникационные условия, путь к результату в неё не входит. У 24 из 50 задач эталон не меняет базу: начальное состояние совпадает с целевым. communicate_info заполнено у шести задач. Все пять задач моей первой пробы были без изменения базы.
Я написал noop_agent: приветствие, уточняющий вопрос, затем повтор до остановки симулятора или предела шагов. Вызовов нет. На 50 задачах получилось pass^1 = 0,340 при 0 из 142 ожидаемых действий. На 30 отладочных задачах — 0,400.
Из 24 задач без записи заглушка прошла 17. Шесть оборвались по пределу шагов, одна не прошла коммуникационную проверку. Эти 34% зависят от набора и завершения диалогов. Они не доказывают, что бенчмарк сломан: справочный ответ или корректный отказ могут законно не менять базу. Для оценки поведения нужны разбор задач, трасс диалога и соблюдения регламента.
Рядом с наградой я стал считать совпадения действий по эталону и трассе: имя инструмента и аргументы. Это диагностический контроль, а не универсальная мера успеха: допустим другой корректный путь. Цель и соблюдение правил нужно проверять отдельно. В tasks.json ожидается 142 действия на полном наборе, 84 на dev, 58 на отложенных задачах. Встроенные action_checks не заменяют этот счёт: знаменатель зависит от хода симуляции, после провала проверки базы поле может быть пустым.
Сравниваю ELM с заглушкой на одном наборе
Чистый ELM-dev на 30 задачах дал pass^1 = 0,333 против 0,400 у заглушки. Действий — 23 из 84 против нуля. Это не подтверждает преимущество ELM. Она сделала 460 вызовов, из них 411 — повторы; один встретился 100 раз. Набралось 713 ходов, затрат которых награда не показывает.
Прогон на 50 задачах операционная система убила после 41. Пик памяти дерева процессов — 27 555 МБ, у завершённых задач 24 из 95 действий и pass^1 = 0,268. Прерванную ячейку нельзя напрямую сравнивать с полной заглушкой. Причиной роста памяти оказался цикл без ограничений на повтор и вывод; память удалённого судьи тут не измерена.
Сажаю одну модель в два цикла
Чтобы отделить ошибки судьи от ошибок цикла, я проверил один deepseek-chat на трёх одинаковых задачах в референсном агенте бенчмарка и в моём цикле. Симулятор пользователя одинаковый; меняется цикл исполнения, или харнесс.
В референсе модель выполнила 5 из 5 действий за 22 хода, пик RSS — 407,0 МБ. В первой пробе моего харнесса — 0 из 5, 31 ход и 11 592,2 МБ. Отладка сместилась к контракту между выбором, состоянием и исполнением. Три задачи не дают надёжной оценки общего эффекта, но прежние цифры не позволяли выделить качество судьи.
Допуск к полным прогонам: 4 из 5 действий на этой тройке, пик ниже 1 ГБ, никаких потерь задач. До выполнения всех условий широкие прогоны остановлены.
Ячейка и набор | pass^1 | Действия |
|---|---|---|
Заглушка, все 50 задач | 0,340 | 0/142 |
Заглушка, dev 30 задач | 0,400 | 0/84 |
ELM, чистый dev 30 задач | 0,333 | 23/84 |
DeepSeek, референс, 3 задачи | 1,000 | 5/5 |
DeepSeek, мой цикл, лучшая проба, 3 задачи | 1,000 | 3/5 |
DeepSeek, мой цикл, последняя проба, 3 задачи | 0,333 | 3/5 |
Контрольная тройка показывает: даже pass^1 = 1,000 соседствует с неполным выполнением действий.
Разбираю повторы и потерянные задачи
За десять проб я нашёл несколько ошибок контракта. Повтор cancel_reservation дописывал попытку в объект брони, инструмент возвращал всё более длинный вывод. Ограничения на повтор, объём фактов из ответа и число значений на ключ состояния остановили рост памяти.
Две задачи из трёх завершались с меткой INFRASTRUCTURE_ERROR — «ошибка инфраструктуры». Причина была в моём коде разбора ответа: DeepSeek вернул число с пояснением, код не распознал его, и вызов nogen.ask завершился исключением. Теперь обёртка печатает трейсбек, эпизод без награды остаётся провалом в знаменателе. Потери удалось довести до нуля.
Сравнение реплики только с предыдущей пропускало A-B-A-B. Агент делал 99 ходов без инструмента, счётчик видел один повтор. Расширение окна само по себе диалог не вылечило.
Лучшая проба, v9, появилась после переноса проверки регламента к моменту записи в базу. Получилось 3 из 5 действий, 136 ходов и 409,8 МБ; все диалоги завершились. В последней, v10, я добавил условие «перед записью прочитай целевую запись». Оно не выполнялось, и цикл уходил в передачу человеку: 169 из 175 вызовов были transfer_to_human_agents с одинаковым текстом. Получилось снова 3 из 5 действий, уже 206 ходов и 337,7 МБ.
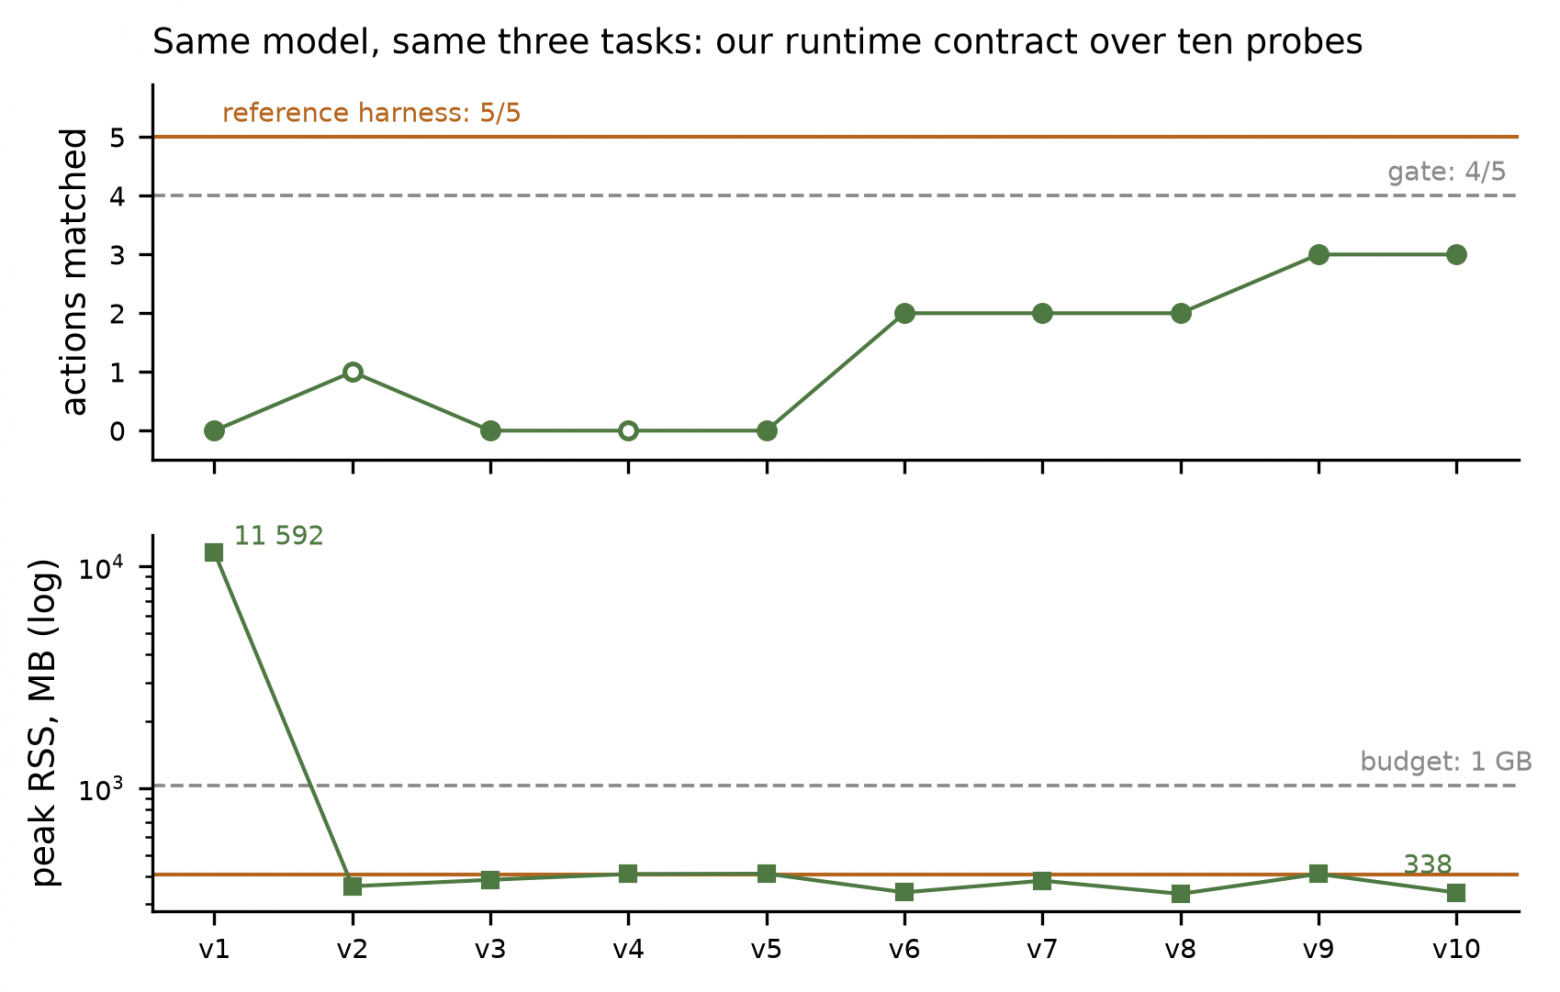
Десять проб моего харнесса на трёх задачах с одним DeepSeek: совпавшие действия и локальный пик RSS. v2 и v4 сняты с незафиксированными правками и оставлены только для хронологии; допуск 4 из 5 действий не пройден.
Память и потерю задач я исправил. Допуск по действиям не выполнен: нужно 4 из 5, получено 3. Длина диалога тоже осталась проблемой: 136–206 ходов против 22 у референса. В обеих последних пробах отменялась неверная бронь: кандидат выбирался из общего пула, а не из прочитанных записей, совпавших с описанием пользователя.
Проверяю цену и чистоту теста
Лучшая проба моего цикла с DeepSeek стоила расчётные $0,0240 на задачу, 104,7 обращения к рантайму. Метаданные показывали $0,0274 и 207: один HTTP-запрос учитывался дважды, по интерфейсу судьи и провайдеру. Нужен расчёт по одной ставке. Исторические ставки DeepSeek — $0,27 за миллион входных и $1,10 выходных токенов; текущий прайс отсюда не следует. Кэширование не измерял. Цена ELM-dev не снята: счётчик появился позже.
RSS показывает дерево процессов на моей машине. Судья работает удалённо, его ресурсы неизвестны. Токены референсного харнесса мои счётчики не видят. Поэтому память сравнивает локальные харнессы, а полная стоимость двух систем здесь не установлена.
Чистого независимого test нет. Отдельной проверки 20 отложенных задач не было. Задача 2 вошла в тройку для отладки; прерванный прогон включал 17 отложенных задач, полный прогон заглушки затронул все 20. Будущий тест на них уже нельзя считать нетронутым.
Исправляю цикл до следующего сравнения
Следующий шаг: выбирать бронь по проверенным деталям, фиксировать однократное чтение и сокращать диалог. После выполнения допуска можно сравнивать решателей. Вклад судьи на tau2 я пока не измерил.
Для своего агента я забираю заглушку, счёт действий рядом с наградой и модель в двух харнессах. Они помогли найти ошибки цикла до замены судьи.
Код и метаданные: https://github.com/ADanMan/elm-research. Репозиторий пока приватный, планирую открыть после публикации статей. Препринт на arXiv не опубликован: нужен endorsement в cs.CL. Если можете помочь, напишите в личные сообщения на Хабре.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.