Абляционный анализ компонентов StyleGAN-NADA: от ансамбля CLIP до Gradient Clipping
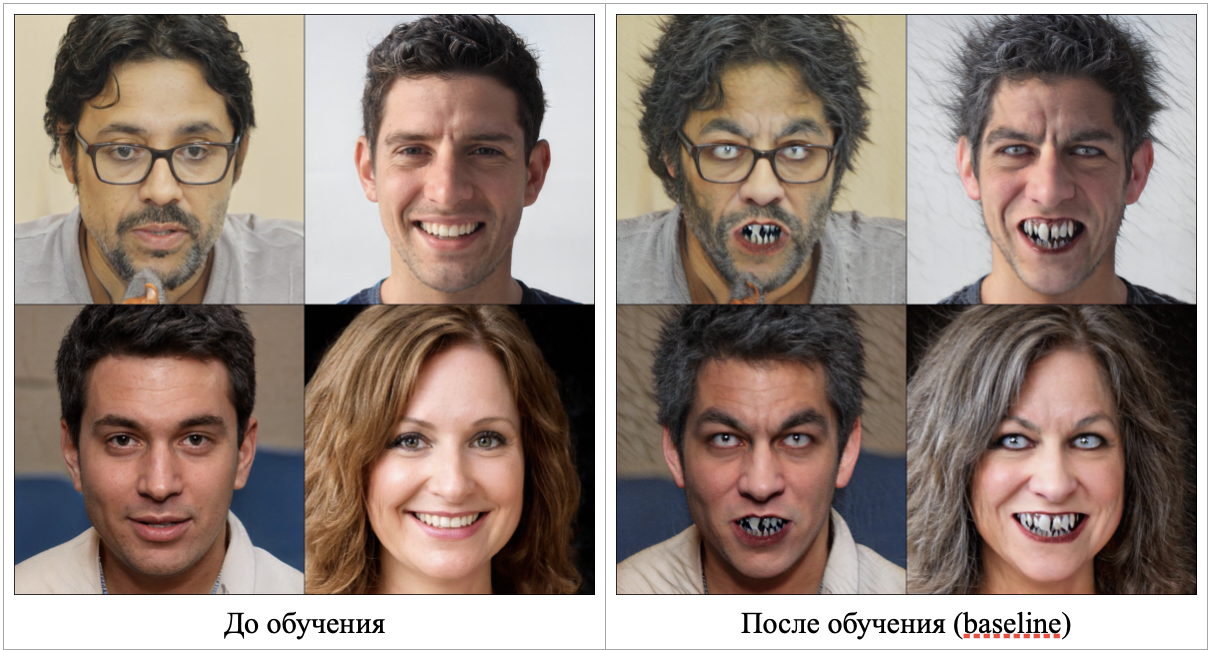
Генеративные модели, такие как StyleGAN2, способны создавать изображения лиц. Однако для управления ими обычно требуется либо оптимизация латентного представления, поступающего на вход генератора, либо обучение генератора с нуля, либо fine-tuning (дообучение) предобученной модели. Метод StyleGAN-NADA (No Annotation Domain Adaptation) предложил подход: адаптировать генеративную модель (StyleGAN2) к новому домену без единого изображения. Вместо этого используется семантическая сила больших моделей, предварительно обученных контрастивным методом на тексте и изображениях (CLIP).
Однако, как и любой метод, основанный на градиентном обучении, StyleGAN-NADA чувствителен к настройкам. В этой статье я исследую, как различные методы регуляризации, ограничение нормы градиента (Gradient Clipping), использование мультипромптов и адаптивный выбор обучаемых слоев влияют на процесс адаптации. Я разобрал 8 конфигураций и посмотрел, какие компоненты критически важны для стабильного и качественного результата.
Метод
В основе метода лежит направленная функция потерь Directional CLIP Loss. Идея заключается в том, чтобы вычислять разницу между векторами изображения после и до обучения, и сопоставлять ее с разницей между текстовыми векторами целевого и исходного доменов. Генератор обновляет свои веса так, чтобы в CLIP-пространстве направление визуальных изменений совпадало с направлением текстовых. Более подробно метод описан в оригинальной статье от специалистов из Tel Aviv University и NVIDIA Research: StyleGAN-NADA: CLIP-Guided Domain Adaptation of Image Generators, а также в моей статье-обзоре.
Помимо базового метода, в мою реализацию добавлены и исследованы следующие компоненты:
Ансамбль CLIP-моделей: использование двух моделей CLIP (ViT-B/16 и ViT-B/32) вместо одной для получения более устойчивых эмбеддингов;
Мультипромпты: использование 77 шаблонов промптов вместо одного слова для лучшего понимания контекста моделью CLIP;
L2-регуляризация: штраф за сильное отклонение весов генератора от исходных предобученных весов;
Patch-based loss: вычисление CLIP-потерь на случайных вырезанных патчах изображения для сохранения локальной структуры;
LPIPS-регуляризация: перцептивная функция потерь для сохранения визуальной стабильности и предотвращения появления артефактов;
Адаптивная разморозка слоев: перед началом эпохи оптимизируется вектор в пространстве W+, затем оценивается, какие блоки генератора изменились сильнее всего, и размораживаются только они;
Gradient Clipping: ограничение нормы градиентов для предотвращения «взрыва градиентов».
Эксперименты
Чтобы понять, как каждый из добавленных компонентов влияет на результат, был проведен абляционный анализ. Суть метода заключается в том, чтобы по очереди отключать определенные компоненты и сравнивать результаты с базовой конфигурацией (baseline).
Все запуски проводились с одинаковыми гиперпараметрами: 300 эпох обучения, целевой (target) промпт werewolf, исходный (source) human, фиксированный seed (2), одинаковые коэффициенты регуляризации и learning rate. Были протестированы 8 конфигураций:
baseline – все компоненты включены;
no_clip – используется одна модель CLIP (ViT-B/16) вместо ансамбля;
no_prompt – используется один промпт вместо 77 шаблонов;
no_l2 – отключена L2-регуляризация;
no_patch – отключен patch-based loss;
no_lpips – отключена LPIPS-регуляризация;
no_adaptive – отключена адаптивная разморозка (обучаются все слои);
no_grad_clip – отключен Gradient Clipping.
Для оценки качества использовались следующие метрики:
Directional CLIP Loss – основная целевая метрика (чем меньше, тем лучше сгенерированное изображение соответствует тексту);
LPIPS – метрика перцептивного расстояния от исходного изображения. Показывает, насколько сильно изображение отклонилось от оригинала (структурная стабильность);
Diversity – среднее попарное расстояние LPIPS между сгенерированными изображениями (показывает, не сошелся ли генератор в один и тот же результат);
Нормы градиентов по блокам – вспомогательная метрика для анализа того, какие слои обучаются наиболее активно.
Каждые 50 эпох сохранялись сгенерированные изображения и контрольные точки (checkpoints) модели. Это позволило отследить динамику изменений не только по метрикам, но и визуально.
Результаты
После обучения 8 конфигураций были собраны метрики и визуализированы результаты. Анализ выявил следующие закономерности.
1. Gradient Clipping – критически важный компонент.
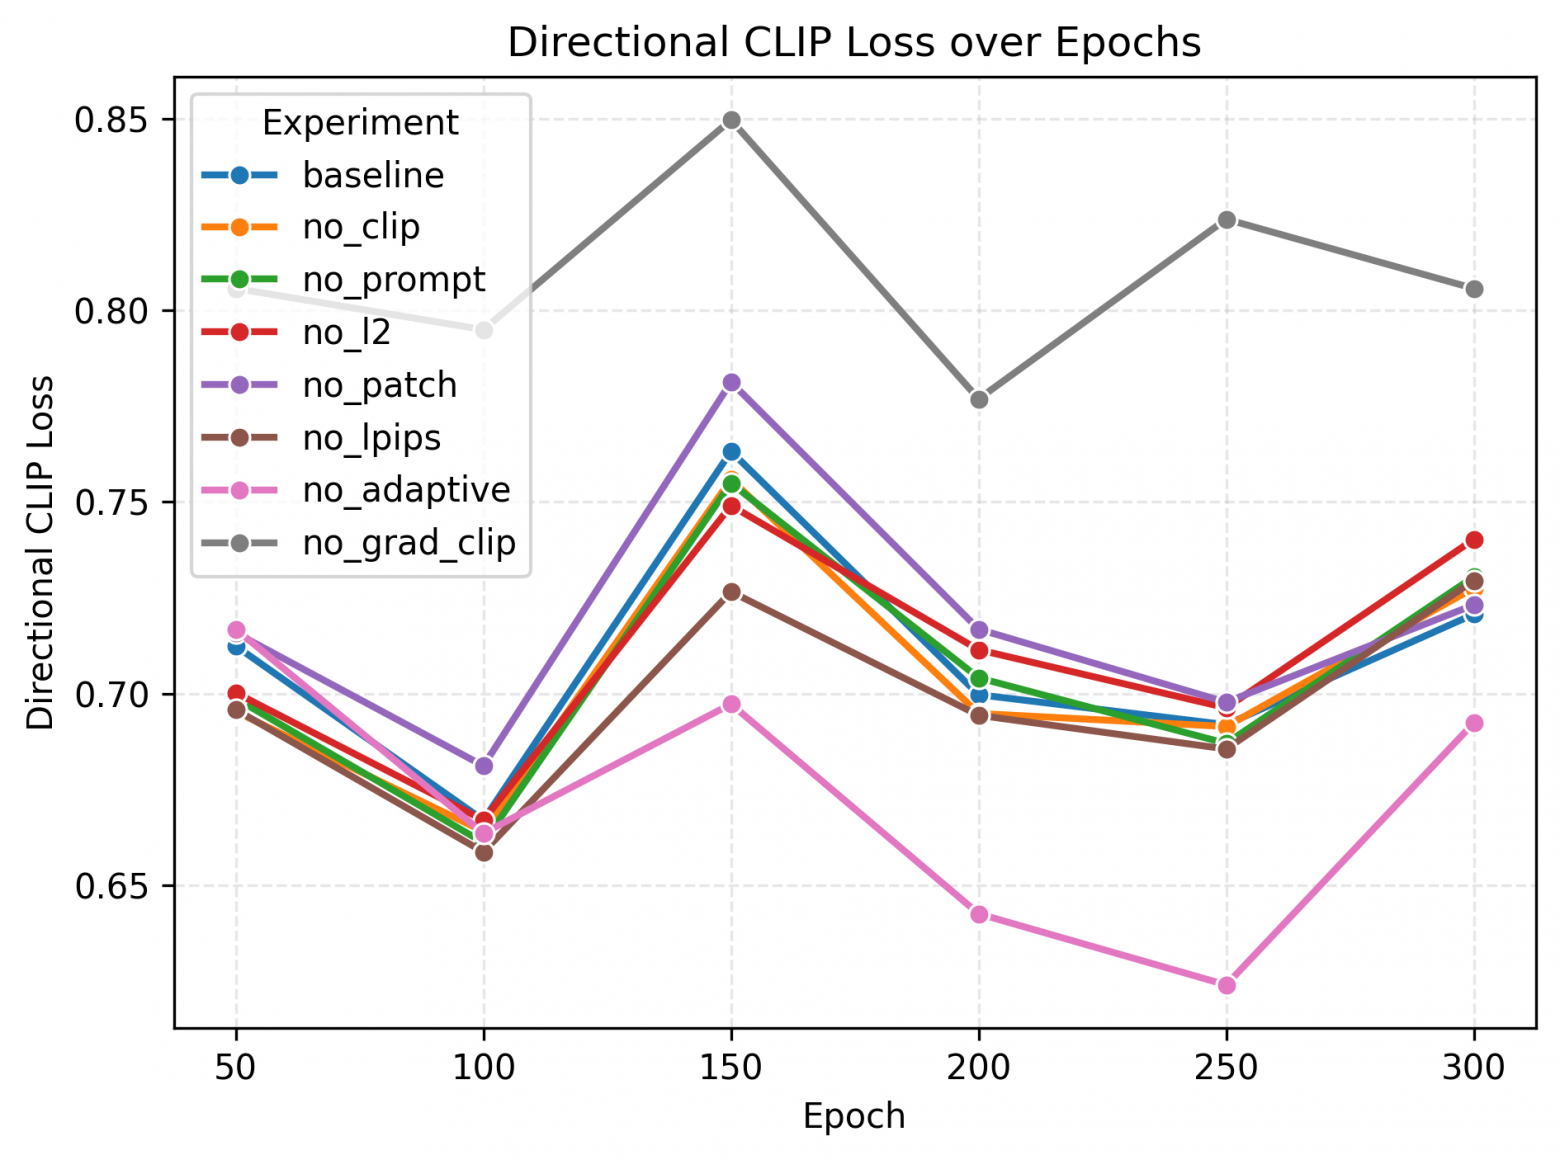
Самым контрастным оказался результат без ограничения нормы градиента (no_grad_clip). На графике Directional CLIP Loss (рис. 1) видно, что без Gradient Clipping ошибка остаётся на высоком уровне (0.78 - 0.85), не показывая устойчивого снижения, в то время как у baseline она падает до 0.66 - 0.72.
StyleGAN2 имеет огромное количество параметров, и при вычислении CLIP-лосса градиенты могут «взрываться». Gradient Clipping ограничивает их норму, не давая весам уйти в случайное состояние. Без него обучение становится нестабильным, и генератор не может выучить направление текста.
2. Адаптивная разморозка слоёв – компромисс между таргетом и изначальным изображением.
Конфигурация no_adaptive (без адаптивного выбора слоёв) на графике Directional CLIP Loss (розовая линия, рис. 1) показывает лучший результат среди всех: ошибка падает до 0.62 - 0.69.
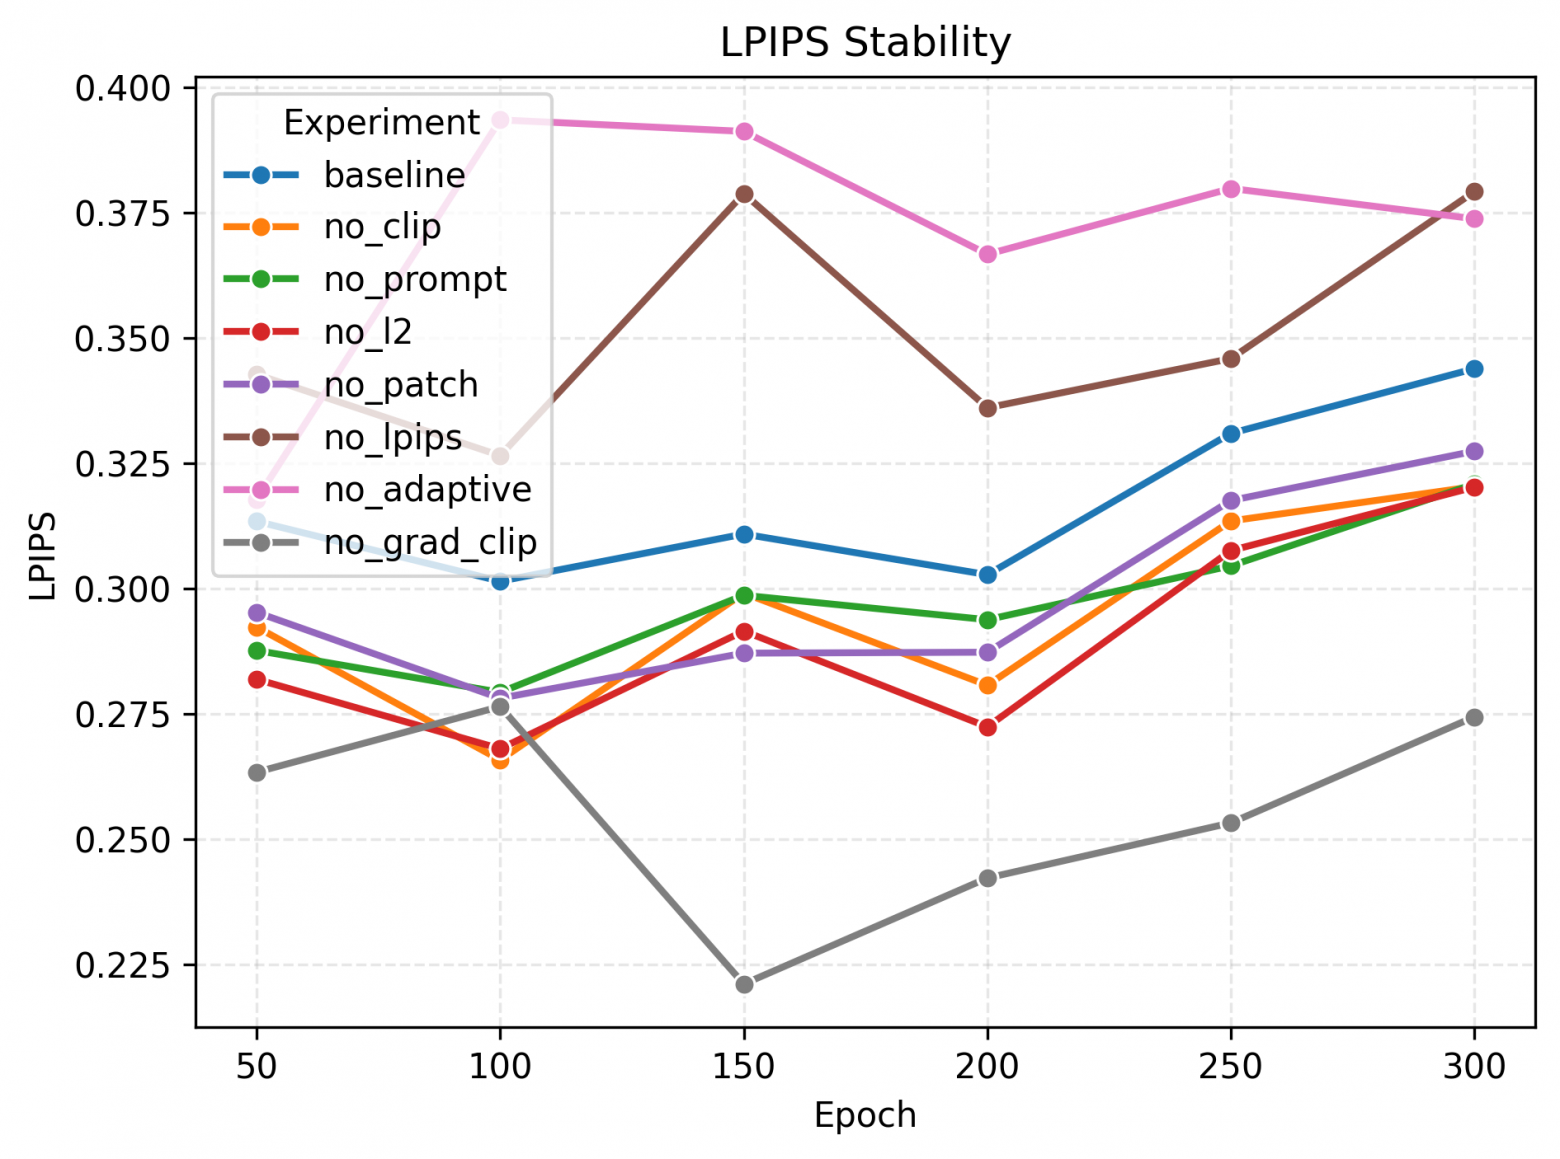
Однако если посмотреть на график LPIPS Stability (рис. 2), то у no_adaptive значения LPIPS самые высокие (0.37 - 0.39), в то время как у baseline они держатся на уровне 0.30 - 0.34.
Обучение всех слоёв позволяет генератору лучше соответствовать текстовому промпту (werewolf), но при этом сильно искажается исходная структура лица. Адаптивная разморозка (выбор только тех слоёв, которые наиболее сильно меняются в W+) сохраняет человеческую идентичность и не даёт полностью уйти в целевой домен. Это компромисс между силой изменений и стабильностью.
Также стоит отметить, что у конфигурации no_grad_clip значения LPIPS самые низкие. Однако это не говорит о высоком качестве – генератор просто не адаптировался должным образом.
3. Влияние регуляризаций (L2, Patch, LPIPS).
Если посмотреть на общий график Directional CLIP Loss (рис. 1), то конфигурации no_l2, no_patch и no_lpips идут практически рядом с baseline. На первый взгляд, они не дают значительного выигрыша в целевой метрике. Однако их вклад виден в деталях:
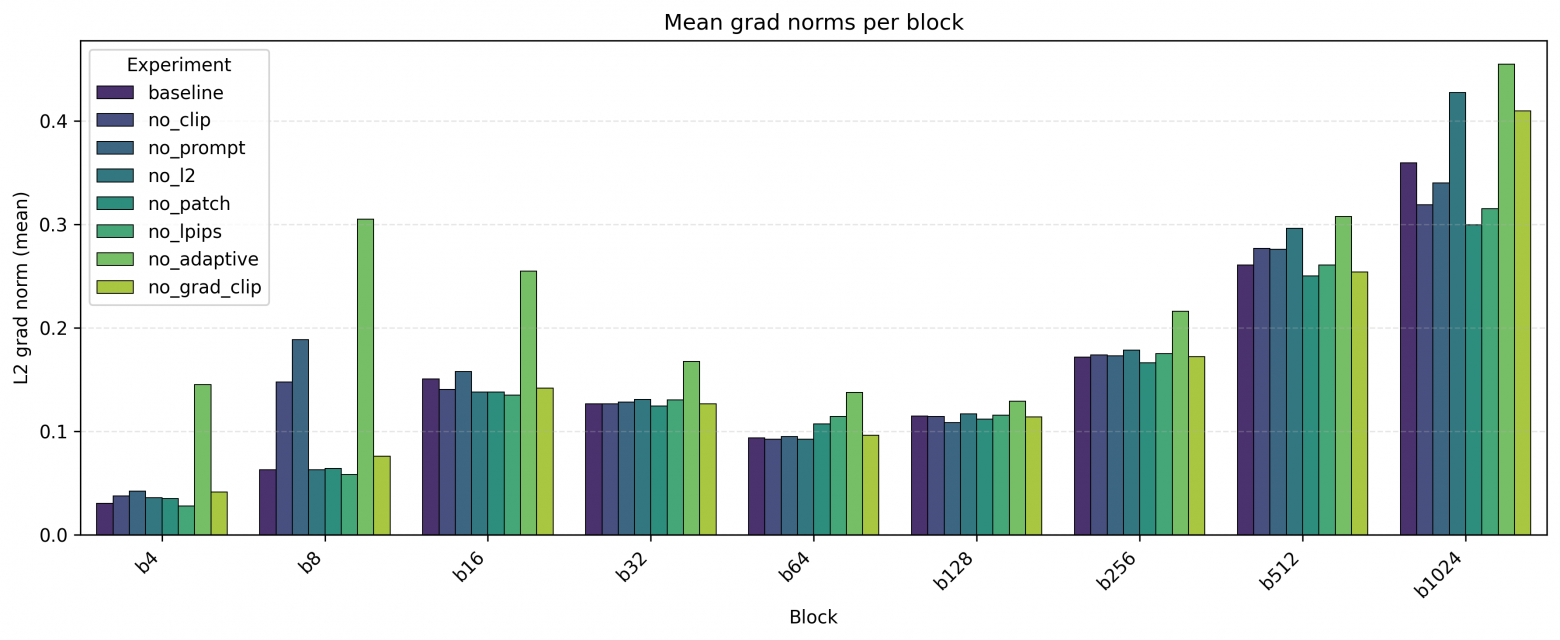
L2-регуляризация (график Mean grad norms per block, рис. 3): без неё градиенты в поздних слоях генератора (b1024) заметно выше (0.43 против 0.36 у baseline). L2 сдерживает дрейф весов и делает обучение стабильнее.
LPIPS-регуляризация: без неё на сгенерированных изображениях появляются более сильные артефакты, а значение LPIPS Stability уходит вверх.
Patch-based loss: без него локальная структура (волосы и т.д.) размыты сильнее.
4. Ансамбль CLIP и мультипромпты.
Отключение второй CLIP-модели (no_clip) даёт результат, очень близкий к baseline. Отключение мультипромптов (no_prompt) также не сильно влияет на качество обучения и генерации. Это подтверждает, что данные компоненты улучшают стабильность, но не являются критическими для работоспособности метода.
5. Анализ градиентов по блокам.
На графике Mean grad norms per block (рис. 3) видно, что при использовании baseline наибольшие градиенты наблюдаются в поздних блоках (b512, b1024). Это логично так как низкоуровневые блоки отвечают за геометрию и текстуру, а высокоуровневые – за детали (в нашем случае – за появление черт волка). В конфигурации no_adaptive градиенты в ранних блоках (b4, b8) в разы выше, что подтверждает: без адаптивного выбора обучаются все слои, включая те, которые не должны меняться.
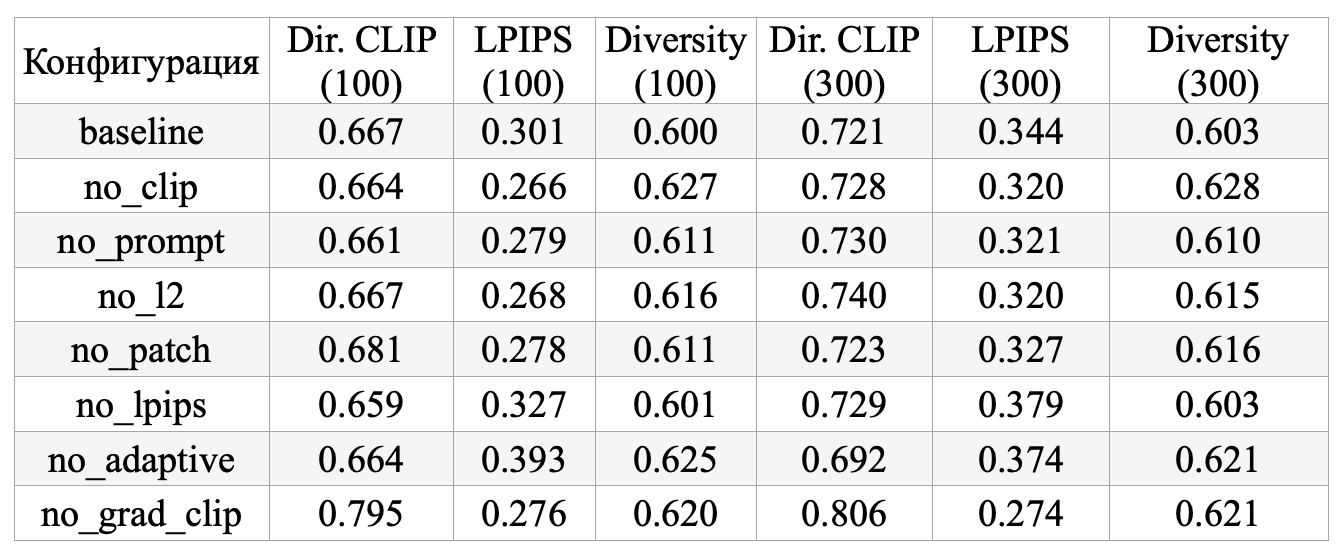
Значения Diversity у всех конфигураций остаются стабильными (0.60 - 0.63), что говорит о том, что генератор не теряет разнообразие при адаптации.
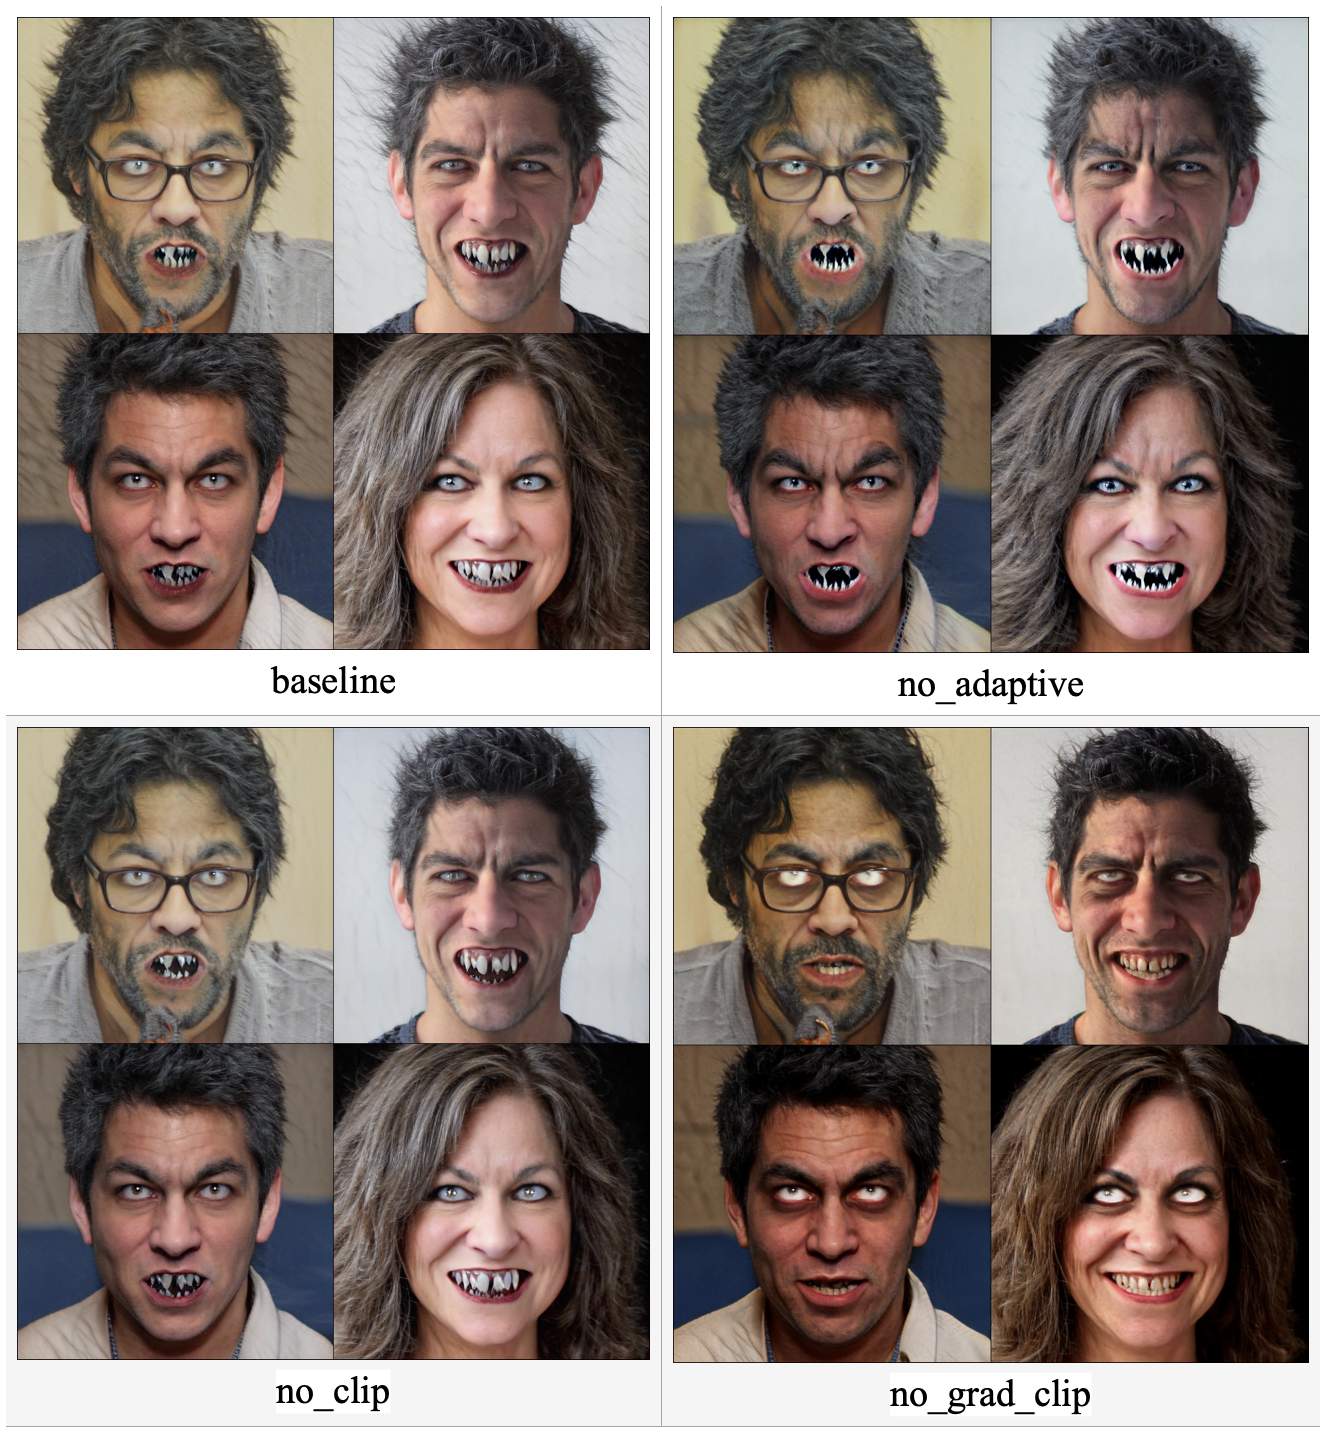
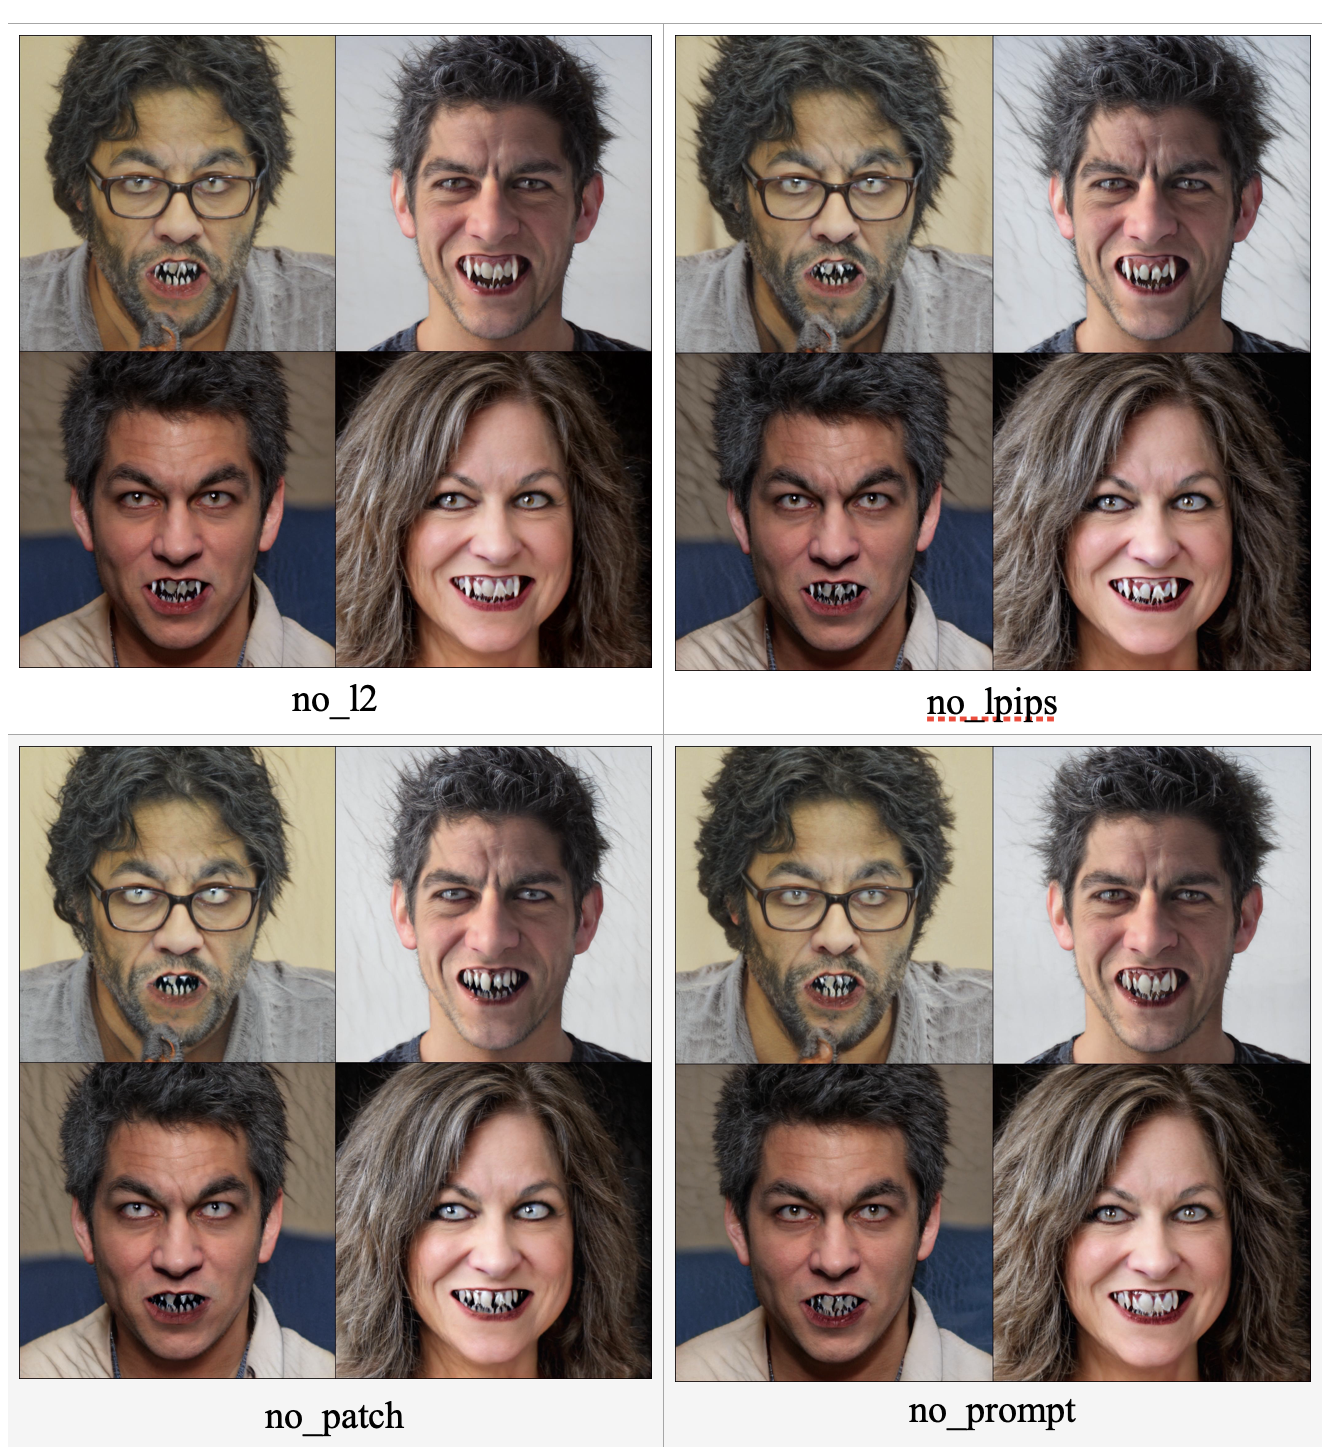
На рис. 4, 5 представлено визуальное сравнение сгенерированных изображений на 300-й эпохе. Видно, что baseline сохраняет структуру лица, но добавляет черты волка. Конфигурация no_adaptive сильнее искажает лицо, а no_grad_clip демонстрирует слабую адаптацию. Отсутствие Patch-based loss, L2 и LPIPS-регуляризации приводит к появлению чуть большего количества артефактов и «шума». Отключение второй CLIP-модели и мультипромптов также не сильно влияют на качество генерации.
Для наглядности ниже приведена сводная таблица с ключевыми метриками. В качестве точек сравнения выбраны 100-я эпоха (минимум Directional CLIP Loss для большинства конфигураций) и 300-я эпоха (завершение обучения).
Заключение
В ходе этого исследования я реализовал метод StyleGAN-NADA и провел полный абляционный анализ его компонентов. Результаты наглядно показали, что качество и стабильность текстовой адаптации генеративных моделей зависят не только от базовой архитектуры, но и от правильной настройки вспомогательных механизмов.
Основные выводы:
Gradient Clipping – обязательный компонент. Без ограничения нормы градиента обучение становится нестабильным: ошибка Directional CLIP Loss не снижается, а генератор практически не адаптируется к целевому домену. Визуально это подтверждается тем, что сгенерированные изображения остаются почти неизменными.
Адаптивная разморозка слоев – это инструмент контроля. Она уменьшает силу текстовой адаптации ради сохранения исходной структуры изображения. Это компромисс между соответствием тексту и сохранением человеческой идентичности.
Регуляризации (L2, Patch, LPIPS) критически важны для визуального качества. Хотя они не дают значительного выигрыша в целевой метрике CLIP, их отсутствие приводит к появлению большего количества артефактов. L2-регуляризация дополнительно сдерживает дрейф весов в поздних слоях генератора, что делает обучение стабильнее.
Ансамбль CLIP и мультипромпты улучшают стабильность, но не являются критическими. Их отключение не приводит к сильному падению качества, однако они делают обучение чуть более устойчивым.
Оптимальная точка остановки – около 100-й эпохи. Дальнейшее обучение приводит к плато или даже к деградации метрик.
Проект показал, что правильная настройка вспомогательных механизмов и понимание градиентов играют большую роль в конечном итоге.
Код проекта и полные результаты экспериментов доступны в репозитории StyleGAN-NADA-reimplementation на GitHub.
Ссылки
Оригинальная статья от специалистов из Tel Aviv University и NVIDIA Research: StyleGAN-NADA: CLIP-Guided Domain Adaptation of Image Generators.
Репозиторий от авторов: github.com/rinongal/StyleGAN-nada.
Оригинальная статья CLIP: Learning Transferable Visual Models From Natural Language Supervision.
Репозиторий CLIP: github.com/openai/CLIP.
Оригинальная статья StyleGAN: A Style-Based Generator Architecture for Generative Adversarial Networks.
Репозиторий StyleGAN: github.com/NVlabs/stylegan.
Оригинальная статья StyleGAN2: Analyzing and Improving the Image Quality of StyleGAN.
Репозиторий StyleGAN2: github.com/NVlabs/stylegan2.
Репозиторий StyleGAN-NADA-reimplementation: github.com/KBaron34/StyleGAN-NADA-reimplementation.
Литературный обзор на статью: StyleGAN-NADA: CLIP-Guided Domain Adaptation of Image Generators: habr.com/ru/articles/943034.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.