Builder ELT — open‑source инструмент для построения потоков данных
Всем привет!
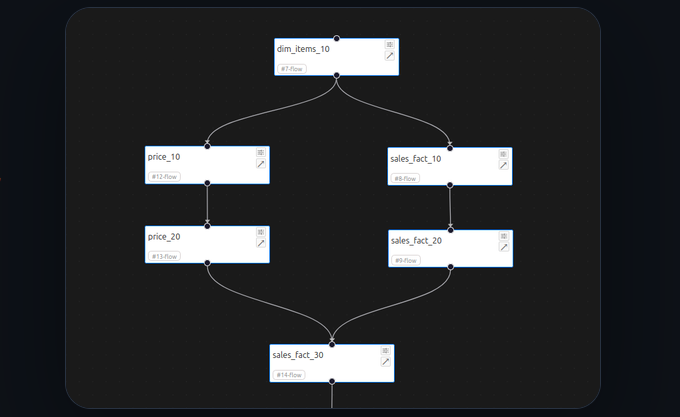
Builder ELT — open-source ELT-приложение, которое позволяет визуально создавать потоки загрузки, объединять их в цепочки и запускать по расписанию. Преобразования выполняются средствами целевой базы данных на нативном SQL, а Python используется для работы с нестандартными источниками и API. Приложение не хранит в себе пользовательские данные. Основная цель создать стандартизированное решение, в котором можно было бы быстро и легко создать ELT поток, не теряя гибкость SQL трансформаций. В итоге любой аналитик знающий SQL может загрузить себе данные.
Откуда это все и зачем.
Примерно в начале 2026 года, работая инженером аналитиком на проекте, я написал питон код для стандартизации ELT процессов. В нем все как обычно: дельта/фулл выборка и запись в журнал.
Процесс загрузки данных повторяется на каждом проекте, а каждый ELT разработчик пишет код по своему. Хотелось стандартизировать хотя бы реперные точки, уменьшить время разработки и кол-во ошибок. Конечно любая стандартизация это постановка в рамки и уменьшение гибкости. Но здесь сработало правило 20/80. В добавок аналитики как правило зависели от специалистов ELT и ждали новые данные.
Сначала был написан пул питон функций и использовалось в виде локального питон-пакета. Далее для удобства был прикручен GUI и база данных для хранения метаданных. Получилось приложение, в котором можно было подключаться к источнику/приемнику, создавать поток и планировать запуск. В каком-то виде уже можно было работать. Далее для возможности создавать очередь потоков был прикручен celery и redis. Ну и на сладкое провайдер авторизации keycloak.
На данный момент в приложении реализован функционал: моделирование потоков, цепочек, мониторинг загрузок, дата менеджмент, model lineage, автодокументация, управление доступом и полномочиями, система деплоя. Ну и о самом приятном, можно персонально установить тему и язык. Все есть в документации https://getbelt.dev/docs/ru/. Документация на бесплатном хостинге Cloudflare, если не откроется, вы знаете что делать. Далее я пройдусь по функциональным разделам.
Моделирование потоков, цепочек
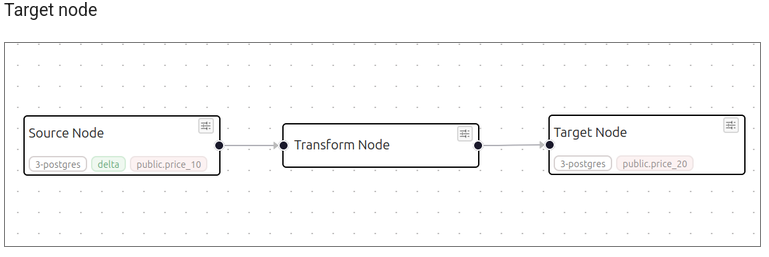
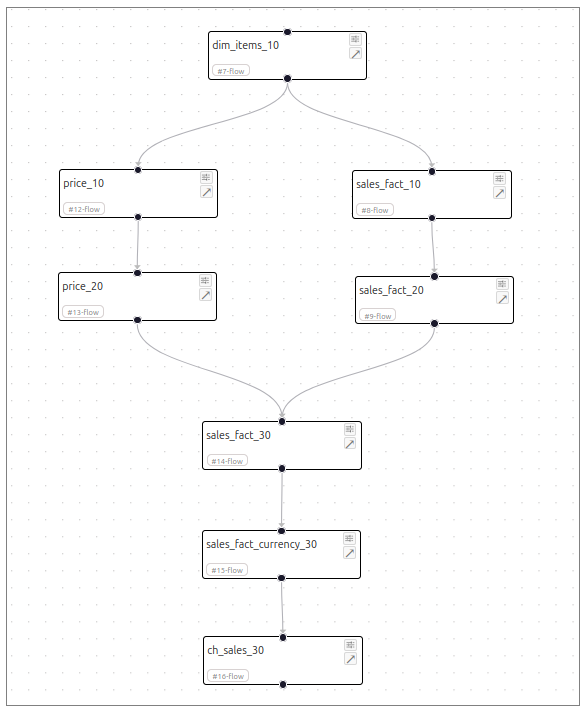
Моделирование состоит из трех основных строительных элементов: подключение, поток, цепочка. Поток — это конкретный ELT процесс и основной исполнитель. Потоки бывают для экстракции сырых данных и для трансформаций. Трансформации пишутся строго на нативном SQL цели и выполняются там же. Система не хранит бизнес данные в себе. Цепочка состоит из потоков и строится в виде графа. Цепочку можно планировать на периодическое выполнение.
Например нужно загрузить таблицу с преобразованием. Я создаю интеграционный поток, далее создаю трансформационный поток, в котором пишу SQL преобразования и добавляю эти два потока в цепочку, которую запускаю вручную или планирую.
Скрытый текст
Скрытый текст
При настройке потока, если данных много мы выбираем колонку по которой система нарежет пакеты. То есть данные будут загружаться последовательно пакетами, что позволяет ограничивать объём данных, обрабатываемых за один раз. В этом еще одна хитрость. Информация по каждому пакету записывается в журнал, благодаря чему можно отследить историю пакета. Либо если пришли ошибочные данные, мы понимаем какой пакет нужно перезагрузить.
Мониторинг загрузок
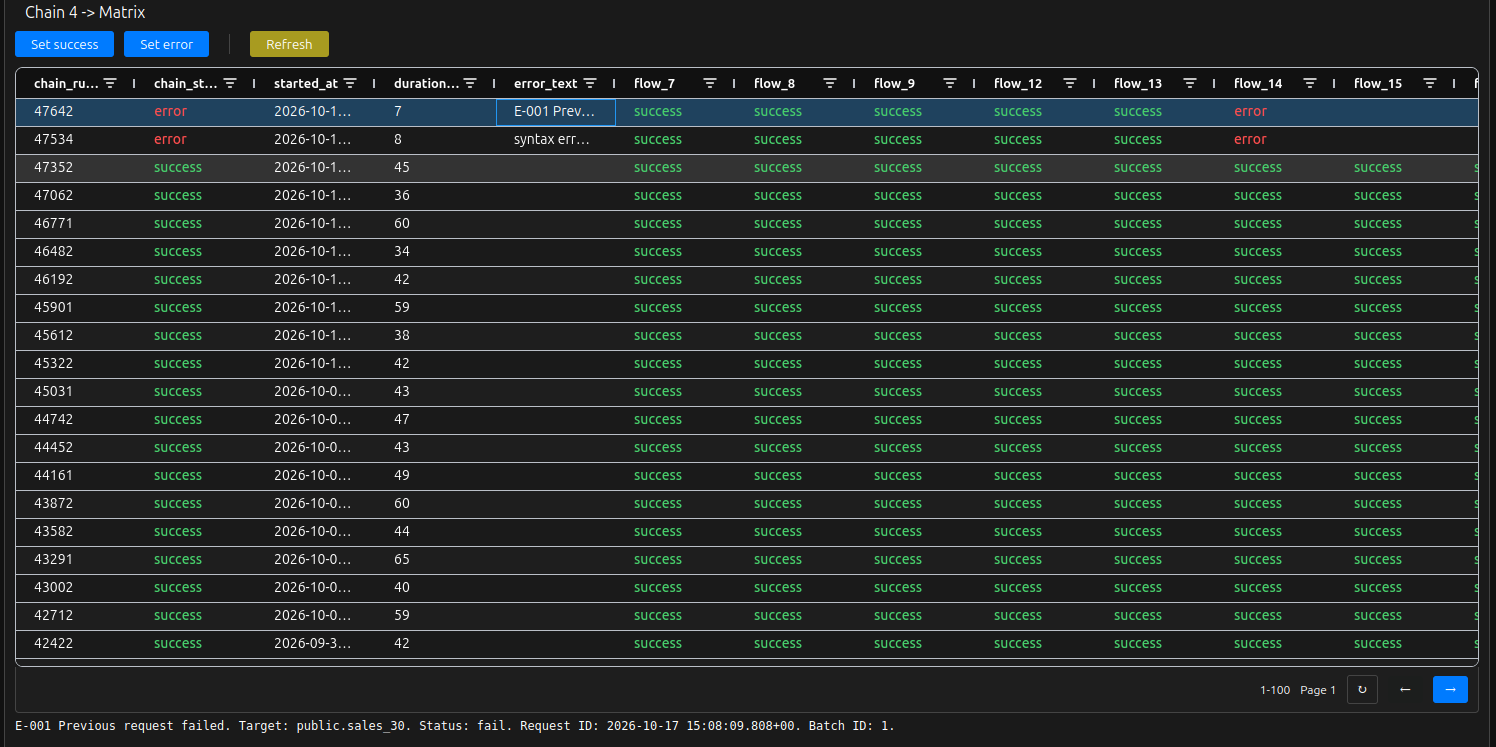
Мониторинг показывает статус и другую мета-информацию выполнения цепочек и потоков. Весь мониторинг построен по принципу drill-down, то есть можно провалиться из цепочки до конкретного загруженного пакета данных. Прочесть ошибку. На картинке список запусков конкретной цепочки со статусами по каждому потолку в ней. Внизу выведена ошибка.
Скрытый текст
Дата менеджмент
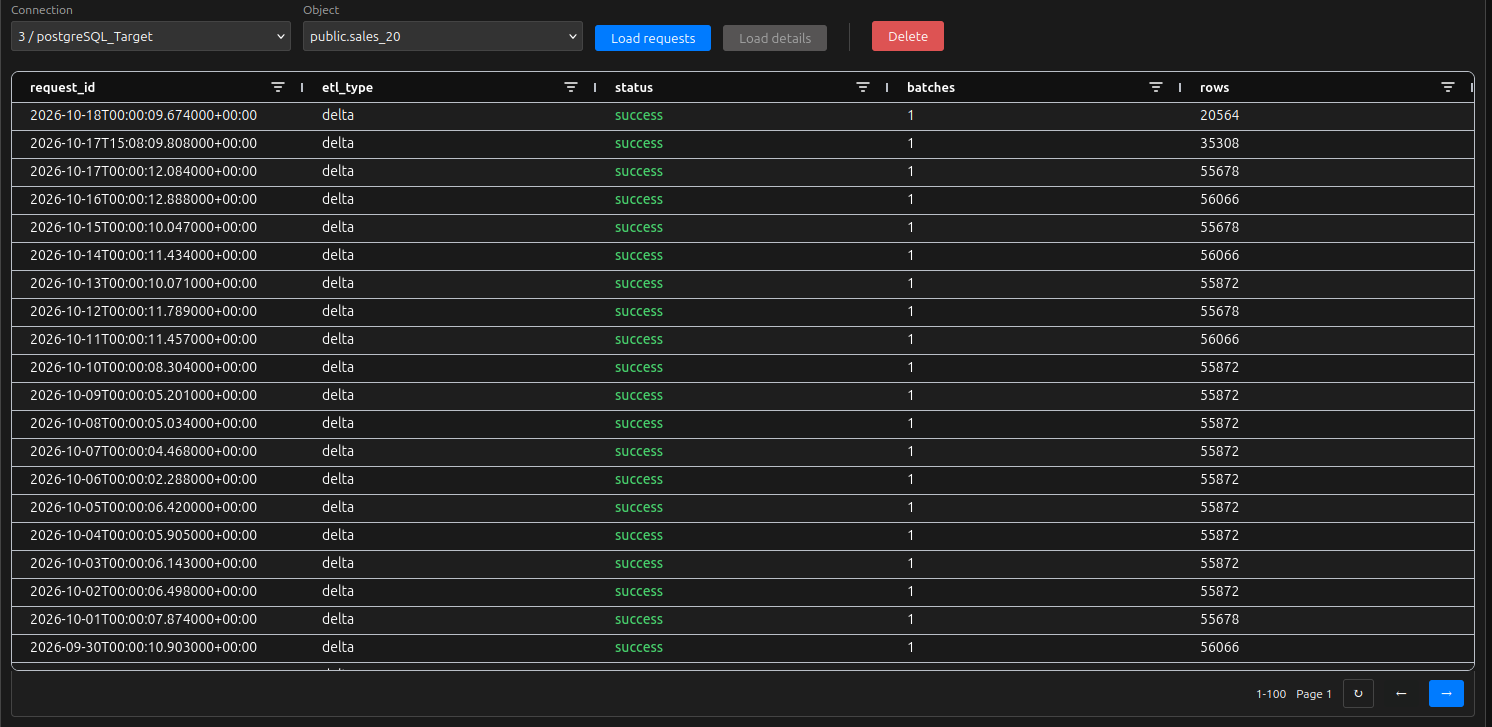
Дата-менеджмент — это панель управления загруженными пакетами данных, которая позволяет контролировать их состояние, находить проблемные загрузки и точечно удалять или перезагружать данные в таблицах.
При загрузке данных между разными системами данные делятся на пакеты, где каждый пакет помечается своим уникальным номером Request ID, Batch ID. Внутри одной системы при загрузках трансформационными потоками этот уникальный номер не меняется. По этому уникальному номеру можно точечно управлять загруженными данными, отслеживать статусы загрузок для оперативного контроля целостности данных в цепочке. Точечно удалять и перезагружать данные.
Скрытый текст
Model lineage
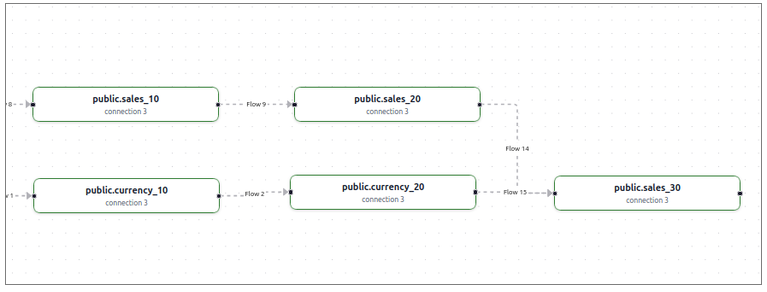
Происхождение данных на уровне таблиц — это карта движения данных, которая показывает полную цепочку их прохождения от первоначальных источников до конечных таблиц и витрин.
В платформе он строится автоматически на основе потоков и позволяет пользователям:
Видеть, из каких исходных таблиц собирается конкретная витрина данных.
Понимать, на какие еще процессы и таблицы повлияет изменение структуры текущей таблицы.
Быстро находить первопричину сбоев, отслеживая всю цепочку потоков назад до источника.
Скрытый текст
Автодокументация
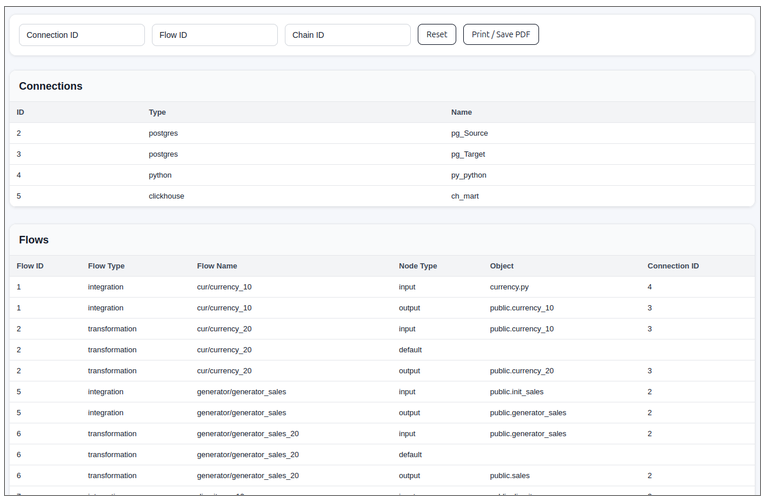
Куда же без нее:) Для удобства документирования проекта был сделан функционал по автоматическому генерированию html странички. Страница содержит три таблицы со списком объектов: Подключения, Потоки и Цепочки.
Скрытый текст
Управление доступом
Belt использует внешний провайдер для входа пользователей и управления их ролями. По умолчанию используется Keycloak, но вместо него можно подключить корпоративный провайдер, совместимый с OpenID Connect (OIDC).
Приложение проверяет роли пользователей согласно таблице:
Роль | Полномочия |
| Просмотр подключений, потоков, цепочек, мониторинга и других доступных объектов. |
| Включает все из viewer. Редактирование подключений, расписаний. Запуск потоков и цепочек. Выполнение операций дата менеджмента |
| Просмотр, создание, изменение и удаление объектов, а также выполнение доступных рабочих операций. |
| Выполнение процессов Deploy. |
Деплой
Belt Deploy переносит изменения между стендами (dev, test, prod). На исходном стенде формируется пакет из выбранных объектов, который затем последовательно проходит тест и продуктив. Пакет содержит файлы изменений, подготовленные на текущем стенде. У каждого пакета есть уникальный package_uuid. Этот идентификатор сохраняется при импорте и последующем экспорте, поэтому продвижение одного изменения видно как единая цепочка.
Почему не git. Потому что из моей практики, не на всех проектах есть гит. И где его нет, просто закрывают на это глаза. Как развитие возможность отправлять изменения в гит будет в дальнейшем. Не дошли руки.
Персонализация
Всего есть возможность установить шесть разных тем. Удобно назначать для каждой среды свою тему, например для разработки - темная, тест - зеленая, продуктив - белая.
Установка
У приложения есть лендинг https://getbelt.dev/. Там есть переход в гитхаб, где можно посмотреть код, и инструкцию по установке, лицензию. От себя добавлю, что установка делается bash скриптом:
apt update
apt install -y git ca-certificates
git clone https://github.com/analytics-engineer/belt-public.git
cd belt-public
bash deploy.cloud.sh <SERVER_IP>
Если нет https сертификата, нужно зайти в контейнер и установить определенные флаги на None, в инструкции это есть. Здесь дублирую команды, ничего сложного:
docker exec -it belt-keycloak /opt/keycloak/bin/kcadm.sh config credentials \
  --server http://localhost:8080 --realm master --user admin
docker exec belt-keycloak /opt/keycloak/bin/kcadm.sh update realms/master -s sslRequired=NONE
docker exec belt-keycloak /opt/keycloak/bin/kcadm.sh update realms/belt -s sslRequired=NONE
Далее переходите в браузер и авторизируйтесь под админом. Админский пароль сгенерировался автоматически и лежит в файле .env. Посмотреть его соответственно команда nano .env.
Технические данные
На данный момент приложение состоит из контейнеров:
belt-frontend - Веб-интерфейс на React
belt-backend - бекенд на питон
belt-scheduler - Проверяет cron-расписания и запускает цепочки
belt-celery-worker - Рабочая лошадка потоков
belt-redis - Брокер очереди задач Celery
belt-postgres-meta - Хранит метаданные приложения
belt-keycloak - Авторизация пользователей и управление доступом
belt-keycloak-db - Отдельная PostgreSQL для данных Keycloak
Минимальные требования к железу ОС Linux 2 vCPU, 4 GB RAM, 20 GB SSD.
Что далее
Хотелось бы добавить уведомления при сбоях загрузок и расширить типы источников/приемников.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.