Peut-on faire confiance aux réponses générées par IA dans les "aperçus" de Google ? Quel impact sur l’information ?
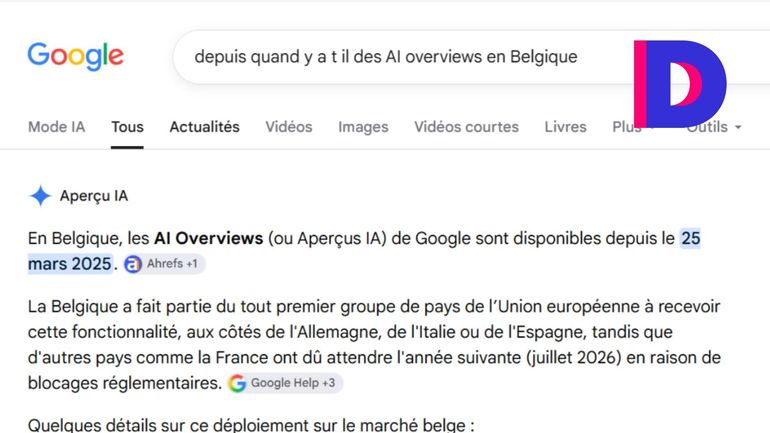
C’est désormais le réflexe de beaucoup d’internautes, quand ils font une recherche sur Google : ils s’arrêtent à l'"Aperçu IA" ("Google AI Overviews", en anglais) proposé en tête de page. Pratique, l’assistant d’intelligence artificielle de Google Gemini a tout digéré pour eux. Ils ne prennent donc plus la peine de faire tourner la molette de leur souris, pour descendre plus bas sur la page, et cliquer sur les liens proposés. Nous sommes entrés dans l’ère du "zero click search" : une fois dans Google, l’internaute ne clique souvent plus, il y reste.
"Pour vous donner un ordre de grandeur, je fais une synthèse ici des études récentes et de ce que j’observe : en gros, on a perdu 40 à 50% des clics qui viennent depuis la page 1 de Google", affirme Xavier Degraux, consultant et formateur en marketing digital et réseaux sociaux.
Ça ne fait évidemment pas les affaires des sites référencés, et plus particulièrement des médias, devenus si Google-dépendants pour s’assurer des visites. Nous y reviendrons. Mais, d’abord, cela fait-il vraiment les affaires des visiteurs eux-mêmes, vous et moi, à la recherche d’informations sur le net ?
Google Search ne dégaine pas (encore) ses aperçus IA à chaque sollicitation.
D’après Xavier Degraux, selon les études, sur 100 requêtes, il y a entre 20 et 55 réponses qui comportent des aperçus. Quand ils sont présents, ces aperçus ne sont pas toujours fiables.
Des abeilles dans nos ordinateurs ?
Un aperçu IA a par exemple stipulé que des abeilles étaient présentes dans nos ordinateurs. "Une société d’informatique très connue avait écrit un article-poisson d’avril qui racontait qu’une des composantes majoritaires des ordinateurs, c’étaient des abeilles, raconte Laurence Dierickx, maîtresse de conférences à l’ULB et chercheuse postdoctorante en Intelligence artificielle à l’Université de Bergen, en Norvège. C’est une blague, c’est grotesque mais Google ne sait pas que c’est une blague et l’a intégrée dans son aperçu."
Dans la majorité des cas, on peut avoir de bonnes réponses. C’est bien ça le problème.
Laurence Dierickx, maîtresse de conférences à l’ULB
Évidemment, cela a été corrigé depuis.
La recherche d’information via des agents IA, que ce soit dans les aperçus proposés par Google ou si vous faites des recherches via ChatGPT ou autre, conjugue toutefois plusieurs problèmes, estime la chercheuse.
Des systèmes peu fiables
Elle les énumère: "Le problème de la recherche en temps réel en ligne, dans un univers ouvert, non contrôlé, avec des contenus de qualité extrêmement variable ; les problèmes des modèles de langage eux-mêmes comme les hallucinations (l’invention de contenus qui ont l’air plausibles mais qui sont inventés) ou la "sycophantie algorithmique" (le robot cherche à être plaisant et, ce faisant, peut faire des erreurs) et puis ce qu’on appelle le bruit sémantique, c’est-à-dire le fait de brouiller la réponse avec des informations qui n’ont rien à voir, ou justement oublier une information très importante."
"Et donc, si on mélange tout ça, on a des systèmes potentiellement peu fiables. Même si, dans la majorité des cas, on peut avoir de bonnes réponses. C’est bien ça le problème."
75% de francophones ?
Faisons un test. Posons, dans Google Search, la question : Combien de francophones y a-t-il en Belgique ?
✦ Aperçu IA
Par communauté/région (environ 4,8 millions) : Elle regroupe la population de la Fédération Wallonie-Bruxelles (environ 3,6 millions en Wallonie et plus d'1 million à Bruxelles).
Par pourcentage de locuteurs (environ 75 ou 76% de la population, soit près de 8,8 millions selon l’Organisation internationale de la Francophonie) : Ce chiffre inclut les personnes ayant une maîtrise variable du français dans l’ensemble du pays, notamment à Bruxelles et dans les communes à facilités. LeSoir + 2
La réponse n’est pas fausse, mais il faut décoder. S’il n’y a pas de recensement linguistique en Belgique, on considère en général qu’il y a dans notre royaume entre 4,5 et 5 millions de francophones, ce qui représente environ 40% de la population. Ce décompte comprend les personnes vivant en Wallonie, à l'exception des germanophones ainsi que les personnes parlant le français vivant à Bruxelles. 40%, cela correspond à la première réponse apportée par l'aperçu IA. Beaucoup moins à la deuxième, qui évoque 75% de la population.
Quand on lit la suite, on comprend que, pour cette deuxième partie de la réponse, l’IA de Google a été piocher dans un article du Soir, cité en source, qui cite des chiffres "contestés" de l'Organisation internationale de la Francophonie. On y lit que "77 % des Belges seraient Francophones, soit un total de 8,8 millions sur 11,8 millions d’habitants." Mais tout le but de l'article est justement d'analyser en quoi l'Organisation se base sur une définition "pour le moins étonnante" de ce qu'est un francophone : "un citoyen ou une citoyenne de la Francophonie, sans que la maîtrise du français soit déterminante". La réponse n’est pas fausse, mais elle met sur le même pied deux comptages très différents, et elle ne met pas en avant le plus pertinent. Elle pourrait induire l’internaute en erreur.
Un vrai faux avatar
Dans la vidéo ci-dessous, Diane Benhamou (alias Estherium), une créatrice de contenu qui vulgarise la tech et l’intelligence artificielle sur TikTok et Instagram, explique que ses followers ont commencé à croire qu’elle était un avatar, parce que c’est ce que disait l’aperçu Google à son propos. Elle a pu démentir, en chair et en os, dans le podcast "expertes à la une" de TF1.
Le problème c’est de faire cohabiter des sources de qualité et des sources qui ne sont pas de qualité.
Laurence Dierickx, maîtresse de conférences à l’ULB
Il y a donc des ratés, ce qui ne veut pas dire qu’ils sont systématiques, loin de là, mais cela appelle à la vigilance. On ne sait pas comment Google sélectionne ses sources. "C’est une boîte noire !", s’exclame Xavier Degraux. "En théorie, Google dit privilégier les sources les plus qualitatives, et pour eux la qualité, c’est à la fois la profondeur d’expertise, et la popularité mais la popularité auprès d’institutions reconnues. Si, par exemple, votre site est cité par la RTBF, média d’autorité, vous allez être mieux référencé."
Youtube souvent cité
Parmi les sources les plus citées, on retrouve beaucoup Youtube, qui fait lui-même partie de l’écosystème Google, et aussi le réseau Linkedin. Laurence Dierickx mène pour l’instant une recherche sur quatre moteurs de recherche basés sur l’IA utilisés par les journalistes (Bing Copilot, Google AI, Duck AI, Perplexity). Elle nous livre des résultats préliminaires.
Sur 400 recherches effectuées dans Google IA :
- Youtube est cité 506 fois,
- Facebook 110 fois,
- LinkedIn 94 fois,
- Reddit 65 fois,
- Wikipedia 444 fois,
- la BBC 105 fois,
- des sources institutionnelles.gov 891 fois.
Google IA cite aussi, on l’a vu dans notre exemple plus haut, des médias de qualité, comme Le Soir. Le lien est là, qui peut être cliqué, mais la réalité c’est que, depuis le lancement de Google AI Overview en Belgique, les audiences des médias francophones ont baissé, comme en France, même si, pour diverses raisons, la chute est moins soudaine, et moins drastique.
Dès l’apparition de Google AI Overview en Belgique en mars 2025, la croissance positive constatée à la fin de 2024 et au début de 2025 s’est rapidement dégradée, avec une forte accélération en 2026, analyse Rossel pour l’ensemble de la presse quotidienne belge francophone (rassemblée au sein de Lapresse.be). En janvier 2026, la diminution du nombre de visites est de 8,6%. En septembre 2026, elle est de 26,4%. Or, la baisse de trafic peut entraîner une diminution des revenus publicitaires, et freiner l’acquisition de nouveaux abonnés. Et donc mettre en danger le modèle économique qui permet une information fouillée et de qualité.
Notez que ces chiffres ne tiennent pas compte des audiences, généralement stables ou en croissance, des apps des différents acteurs. Et qu’il est difficile d’imputer toute la baisse uniquement à Google AI Overview, son impact est considérable, et indéniable, mais d’autres facteurs peuvent jouer.
Les sites de presse écrite quotidienne francophones bloquent les robots d’intelligence artificielle générative. ChatGPT ou Perplexity, par exemple, ne peuvent pas proposer de réponse qui se nourrirait de leur contenu, car les quotidiens les empêchent d’y accéder. Mais avec Google, l’histoire est tout autre.
"Pervers"
"On permet à Google d'accéder à nos contenus, même ceux qui se trouvent derrière un paywall, parce que ça nous permet d’être indexés [dans les recherches Google] de manière pertinente, explique Coralie Vrancken, directrice générale du pôle Le Soir chez Rossel, et administratrice de La Presse.be. Mais Google abuse de ça. Ils récupèrent l’information, et maintenant, ils l’exploitent pour pouvoir formuler des réponses, y compris des réponses qui intègrent des éléments qui se trouvent derrière un paywall, sans renvoyer vers nos sites."
Et la source indiquée bénéficie finalement plus à Google qu’à la source elle-même : "C’est pervers. Ils ajoutent la marque qui dégage de la crédibilité. Les gens se disent très probablement :'ah bon, en plus, c’est résumé sur base d’un truc du Soir, c’est bon, c’est fiable'."
Du côté de la RTBF, Christophe Chantraine, directeur des publications digitales, observe également un recul de fréquentation du site d'information, en ligne avec les tendances constatées sur le marché belge francophone. "On voit aussi une baisse de trafic provenant de Google Discover (flux d’actualité personnalisé agrégeant des contenus de différents médias, qui apparaît dès que vous ouvrez Google sur votre smartphone, ndlr). On essaie d’optimiser ça au maximum parce que ça reste une source de trafic super importante."
"Qui va débrancher la prise IA ?"
Jusqu’à cet été, un média ne pouvait pas se retirer d’AI Overviews, empêcher ses robots de le "scrapper", sans se retirer automatiquement de Google Search, ce qui n’est pas une option. Depuis une décision de l’autorité britannique de la concurrence, c’est à présent possible.
"Mais qui va débrancher la prise IA ?, se demande Xavier Degraux. Qui va prendre ce risque-là en sachant que, du coup, les autres vont prendre la place, ceux qui ne vont pas débrancher la prise IA. Moi, c’est ce que j’appelle un faux choix, en réalité."
Par ailleurs, "ma crainte, ajoute Christophe Chantraine (RTBF), c’est qu’en bloquant les moteurs IA de Google, on impacte d’une manière ou d’une autre notre capacité à être référencé dans les autres outils de Google. Or, il y a toute une myriade d’outils autour de Google, dont Google Discover, qui permettent aux contenus de la RTBF d’apparaître."
Favoriser le lien direct
Pour Christophe Chantraine, le meilleur moyen de ne pas être à la merci des algorithmes, c’est de favoriser le plus possible le lien direct avec les internautes : pousser l’application mobile, faire en sorte que les gens l’aient sur leur smartphone, qu’ils en fassent un réflexe quotidien.
Les quotidiens francophones (notamment) suivent la même stratégie, assure Coralie Vrancken (Le Soir et La Presse.be). "Et du côté du Soir, on essaie aussi de se rapprocher physiquement de notre communauté de lecteurs. On travaille beaucoup sur le développement des événements, comme celui qu’on a organisé avec Julien Moinil. C’est quelque part une nouvelle manière de faire du journalisme."
Les médias se battent aussi à un autre niveau. La World Association of News Publishers, dont fait partie La Presse.be, est membre de la coalition SPUR (Standards for Publisher Usage Rights) visant à "créer un marché équitable pour l’utilisation des contenus par les systèmes d’IA". La société média belge Mediahuis (De Standaard, Het Nieuwsblad, Gazet van Antwerpen, Het Belang van Limburg) compte parmi ses membres fondateurs. Le New York Times, l’AFP, et Radio France viennent de les rejoindre.
En France, l’Apig, organisme collectif regroupant près de 300 quotidiens français, a saisi l’Autorité de la concurrence le 11 août pour contester le "déploiement unilatéral" d’Overview.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.