Как читать результаты нагрузочного тестирования и не обмануть себя
Вы прогнали нагрузочный тест. Получили файл с результатами, а, может, и автоматически сгенерированный отчет с графиками и таблицами. Среднее время ответа - 4 секунды. Цель - 5 секунд. Отлично или все-таки что-то не так?
Эта статья про то, как пользуясь базовыми понятиями математической статистики, сделать анализ результатов тестирования таким, чтобы его читали и на его основе принимали правильные решения.
Математика, без которой никуда
Три вещи, которые надо понять.
1. Среднее арифметическое - зло (почти всегда)
Например, мы провели три независимых эксперимента, в результате которых получили три разных набора данных. В каждом - 100 измерений времени ответа.
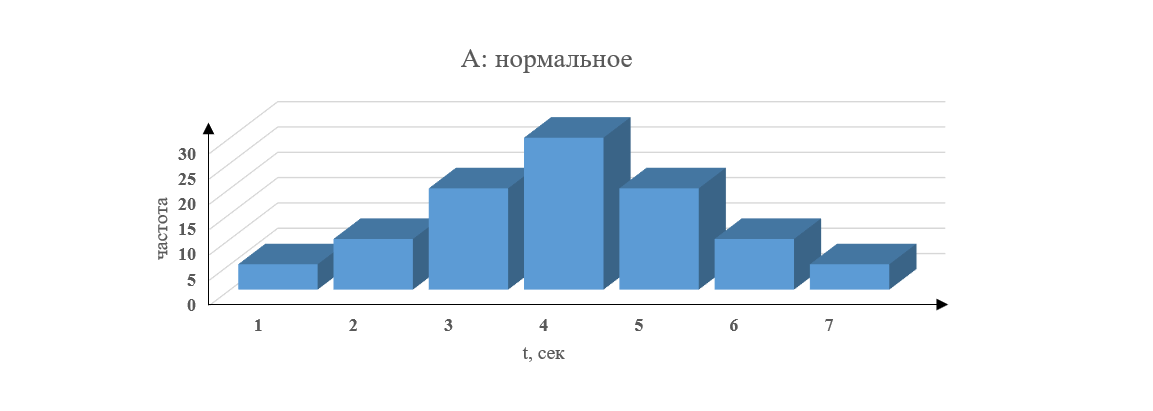
Набор A: 5, 10, 20, 30, 20, 10, 5 точек (значения от 1 до 7). Нормальное распределение.
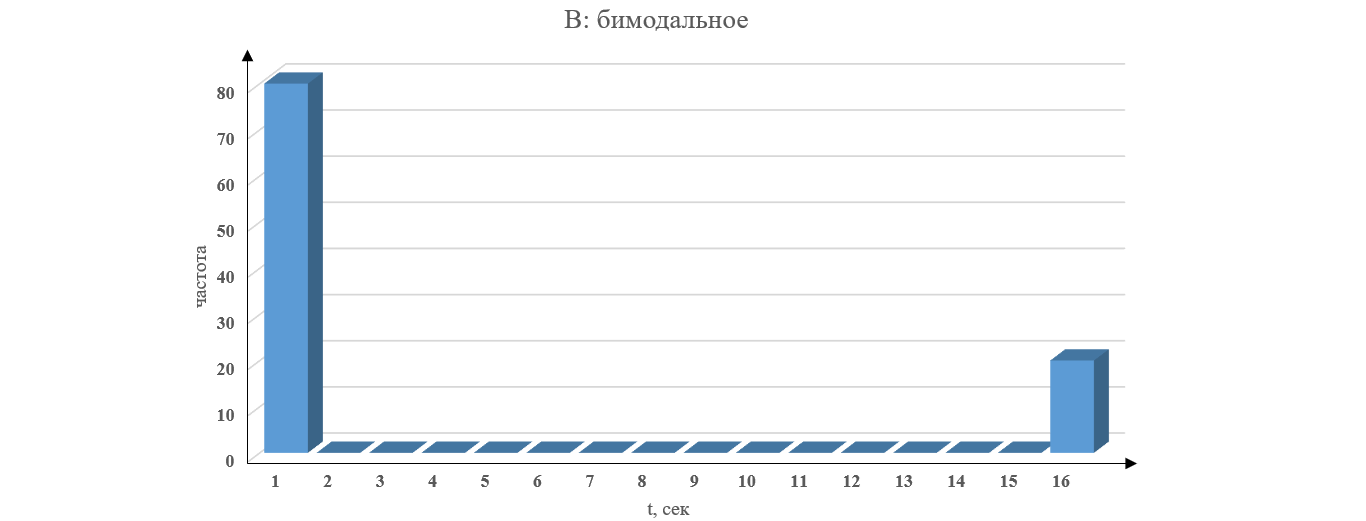
Набор B: 80 раз по 1 секунде, 20 раз по 16 секунд.
Набор C: равномерное распределение от 0 до 8.
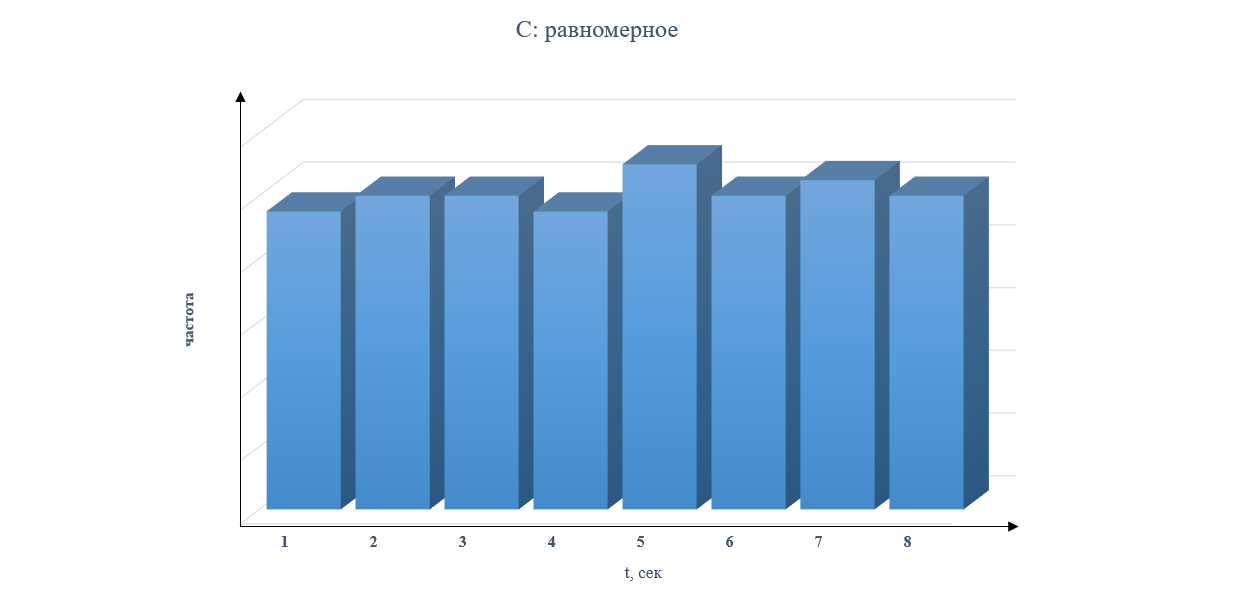
У всех трёх среднее равно 4 секундам при цели в 5 секунд. По среднему все хорошо, а как на самом деле?
В наборе B 80% пользователей получили 1 секунду, но 20% - 16 секунд. Получается каждый пятый клиент ждёт 16 секунд.
Что делать: никогда не оперируйте только средним значением. Обязательно добавляйте метрики для полноты понимания результатов:
размер выборки (сколько измерений),
минимум и максимум,
стандартное отклонение,
а лучше перцентили.
2. Перцентиль - ваш лучший друг
Перцентиль - это значение, которое заданная случайная величина не превышает с фиксированной вероятностью, заданной в процентах. Перцентиль показывает сколько процентов измерений находятся на заданном уровне или ниже.
Набор А: 95-й перцентиль равен 6 секундам (при цели 5 секунд - плохой результат)
Набор B: 95-й перцентиль равен 16 секундам (ужасный результат), но 80-й перцентиль равен 1 секунде (отлично). Это противоречие показывает, что данные неоднородны.
Набор С: распределение равномерное.
Важный нюанс: перцентили корректно работают только на нормально распределённых данных без диких выбросов. Но даже в этом случае они дают гораздо более реалистичную картину, чем среднее.
3. Стандартное отклонение и выбросы
Стандартное отклонение - это показатель того, на сколько сильно значения в наборе разбросаны относительно их среднего значения. Чем меньше отклонение - тем данные стабильнее.
Набор A: ~ 1.45 сек.
Набор B: ~ 6 сек.
Набор C: ~ 2.34 сек.
Правило большого пальца: если стандартное отклонение больше половины среднего, данные подозрительны. Либо распределение ненормальное, либо присутствует ошибка.
Что считать выбросом? Теоретически всё, что выходит за три стандартных отклонения (99% данных). Но на практике в коммерческих проектах часто пользуются более простым определением:
Выброс — это редкое нетипичное наблюдение, которое может быть следствием ошибки измерения или аномалии, которую не стоит моделировать.
Как работать с выбросами
Перезапустите тест и сравните результаты.
Если «странная» точка исчезла, скорее всего, выброс можно исключить.
Если появилась снова — это не выброс, это реальное поведение системы.
Можно исключать до 1% измерений, если они не повторяются в других тестах.
Важнейшее предупреждение: исключить из анализа не значит игнорировать. Выбросы необходимо записывать в отдельный лог. Отслеживайте паттерны между тестами.
Как понять, что результаты отображают реальное состояние приложения
На коммерческих проектах никто не считает t-тесты и хи-квадраты вручную. Но понимать, что результаты неслучайны, обязательно.
Минимальные требования:
100 измерений (лучше больше),
как минимум 2 независимых прогона (ещё лучше - 5).
Правило 5 прогонов (если вы ожидаете, что результаты будут похожи)
Если больше 20% прогонов (1 из 5) выбиваются из общей картины, проблема в окружении, приложении или самом тесте.
Если 90-й перцентиль какого-то прогона выше максимума или ниже минимума другого, прогоны статистически разные.
Если все таймеры в прогоне заметно выше/ниже, прогон не похож.
Если отличается только один таймер, а остальные похожи, тест в целом статистически эквивалентен (но на этот таймер стоит посмотреть отдельно).
Простой принцип: данные считаются надёжными, если они эквивалентны минимум для 80% тестовых прогонов.
Доверительные интервалы - честный способ сказать «не знаю точно»
В нагрузочном тестировании почти никогда нет 100% уверенности в результатах. Потому что модель нагрузки - это всегда приближение к реальности.
Как показывать доверительные интервалы без формул
Постройте три сценария:
лучший (минимальная нагрузка, оптимальные сценарии),
ожидаемый (наиболее реалистичный),
худший (максимальная нагрузка, пессимистичные сценарии).
На графике отметьте цель по времени ответа. Точки пересечения кривых с целью покажут диапазон нагрузки, при которой система ещё работоспособна.
Пример вывода: «С 95-процентной уверенностью (по нашей оценке, что лучший и худший сценарии действительно граничные) система выдерживает от 100 до 200 одновременных пользователей».
Да, интервал может быть широким. Но это честно, и это гораздо лучше, чем обещать «ровно 150 пользователей» и провалиться на проде.
Построение отчёта
Когда мы получили результаты тестов, проанализировали их, необходимо рассказать о полученных результатах.
Хорошая практика - не ждать финального документа, а каждый день-два отправлять стейкхолдерам график с кратким резюме («CPU не превышал 45% при цели 70%», «время ответа страницы входа деградирует после 150 пользователей»).
Не буду подробно описывать, из каких разделов должен состоять отчет и сколько графиков в него нужно добавить. Из моего опыта, в отчете важно человеческим языком рассказать аудитории о полученных результатах, о конкретных проблемных запросах и т.д.
Нагрузочное тестирование — это не «погоняли и выдали график». Это инструмент принятия бизнес-решений. А любой инструмент работает только тогда, когда результат можно интерпретировать однозначно и действовать на его основе.
Запомните три вещи.
Математика (перцентили, стандартное отклонение, проверка на выбросы) — это не занудство, а единственный способ не солгать себе и другим.
Статистическая значимость без сложных формул — это более ста измерений, 2-5 прогонов и правило «похоже хотя бы на 80%».
Отчёт — это не свалка графиков, а история со своей аудиторией, ключевым сообщением и призывом к действию.
Статья написана в рамках ХабраЧелленджа 6.0, который прошел в ЛАНИТ весной 2026 года. О том, что такое ХабраЧеллендж, читайте здесь.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.