Тестовые данные отдельно, код отдельно: 5 способов изолировать данные в автотестах на Java
Архитектура конвейера разрешения конфигураций
Способ №1. Параметры командной строки
Способ №2. Типизированная конфигурация через библиотеку Owner
Способ №3. Data-Driven Testing в TestNG
Способ №4. Динамическая фабрика данных
Способ №5. Хранение секретов
Сравнительная матрица подходов
Дерево решений
4 главных антипаттерна
Личный опыт
Знакомо? Ещё как. Было у нас так: запускаем тесты на CI, всё падает. Смотрим логи — таймаут. Думали, стенд прилёг. А потом находим: кто-то опять зашил localhost:8080 прямо в базовый класс. Классика жанра.
Или другой заход. Включили параллельный запуск на 16 потоков. Половина тестов красная. Причём нестабильно: то один упадёт, то другой. Копаемся — два потока схватили одну тестовую учётку и заблокировали друг друга. Один логинится, второй меняет пароль, первый получает 401 и идёт курить.
А причина одна: мы тащим тестовые данные прямо в код проверок. Так быть не должно — код тестов должен заниматься только тестами и не знать, где вы запускаетесь и под кем. Сменился стенд? Обновились логины? Ок, меняем только окружение запуска, в сами проверки не лезем.
В статье расскажу про пять способов, как развести данные и код. Без длинной теории, сразу с примерами. Америку не открою, но, быть может, эта информация будет кому-то полезной и сэкономит время и нервы.
Архитектура конвейера разрешения конфигураций
Прежде чем переходить к инструментам, зафиксируем общую схему: как данные попадают в тестовый фреймворк.
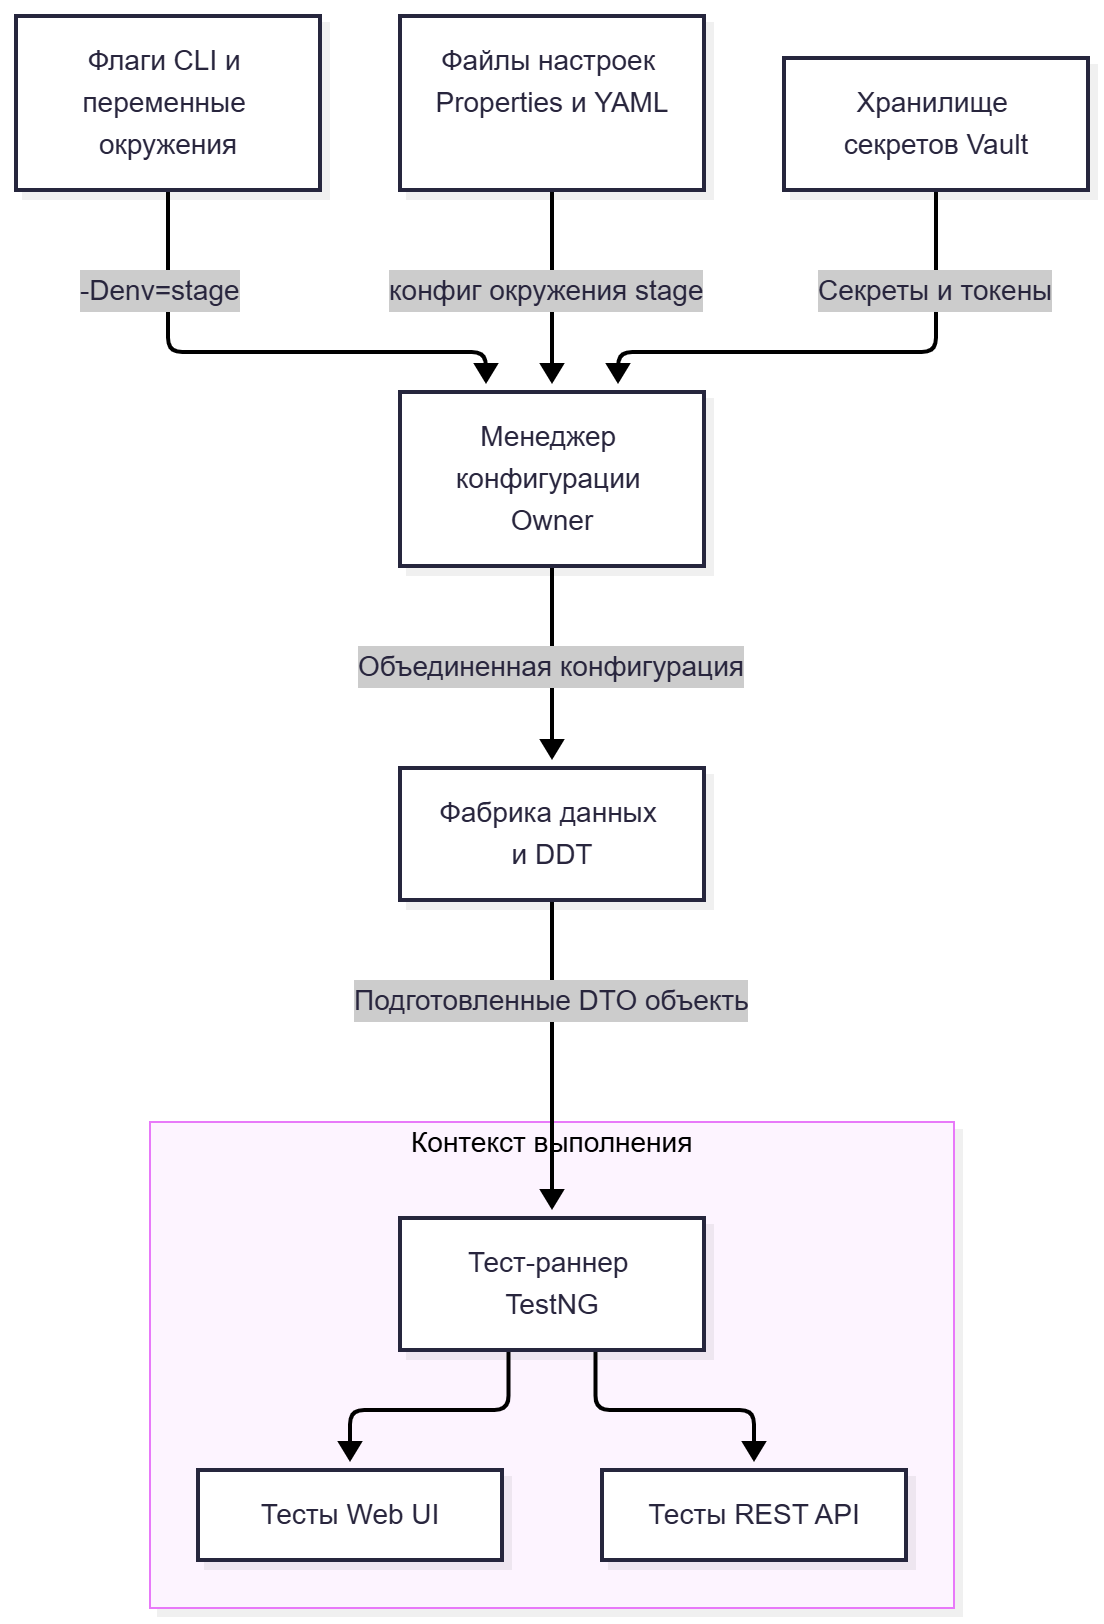
Слоёв четыре. Первый — источники: всё, что снаружи фреймворка, включая CLI-флаги сборщика, файлы настроек в ресурсах, переменные CI/CD и секреты из Vault. Второй — менеджер конфигурации: читает параметры, мерджит профили стендов и проверяет наличие обязательных ключей. Третий — слой тестовых данных: превращает сырые конфигурации в типизированные Java-объекты или генерирует уникальные сущности на лету. Четвёртый — контекст тестов: тестовые методы получают готовые данные и занимаются только проверкой бизнес-логики.
Способ 1. Параметры командной строки
Самый простой способ — параметры командной строки, доступные в Java из коробки: сторонние зависимости не нужны, ключи передаются прямо в команду запуска сборщика.
Maven или Gradle прокидывают флаги через -D, а код ловит их через System.getProperty(). Важно не забывать про дефолтные значения: если тест запустят локально без параметров, код не должен падать с NullPointerException. Поэтому всегда нужен фоллбэк на локальный стенд или dev-окружение.
У подхода есть ограничения: он годится для двух-трёх флагов — адреса стенда, таймаута. Когда параметров становится больше десяти, команда запуска превращается в длинную нечитаемую строку. Типизации тоже нет: опечатка в числе приведёт к NumberFormatException в рантайме.
Пример кода на Java
public class EnvironmentConfig {

    public static String getBaseUrl() {
        // Считываем системное свойство с дефолтным фоллбэком на dev
        String env = System.getProperty("env", "dev").toLowerCase();

        switch (env) {
            case "stage":
                return "https://stage.example.com";
            case "prod":
                return "https://example.com";
            case "dev":
            default:
                return "https://dev.example.com";
        }
    }

    public static int getTimeout() {
        return Integer.parseInt(System.getProperty("timeout", "10"));
    }
}
Способ 2. Типизированная конфигурация через библиотеку Owner
Когда проект разрастается, прописывать настройки в CLI надоедает: хочется держать их в файлах под каждый стенд, но парсить файлы вручную — лишняя рутина. Здесь помогает библиотека Owner.
Вместо шаблонного кода объявляется обычный Java-интерфейс с аннотациями, а библиотека сама мапит ключи из файлов на методы. Типы приводятся автоматически: если в файле 10, в коде будет int, а не строка.
Удобнее всего приоритеты загрузки. Owner можно настроить так: сначала системные переменные, затем файл окружения, в конце — дефолтный. Запустили с -Denv=stage — подтянулся stage. Ничего не передали — взялся dev-профиль. Код чистый, без единого if-else.
Пример реализации
Подключаем зависимость в
pom.xml:
<dependency>
    <groupId>org.aeonbits.owner</groupId>
    <artifactId>owner</artifactId>
    <version>1.0.12</version>
</dependency>
Создаем интерфейс конфигурации:
import org.aeonbits.owner.Config;

@Config.LoadPolicy(Config.LoadType.MERGE)
@Config.Sources({
    "system:properties",
    "system:env",
    "classpath:config/${env}.properties",
    "classpath:config/default.properties"
})
public interface ProjectConfig extends Config {

    @Key("base.url")
    @DefaultValue("https://dev.example.com")
    String baseUrl();

    @Key("api.timeout")
    @DefaultValue("5000")
    int apiTimeout();

    @Key("db.pool.size")
    @DefaultValue("10")
    int dbPoolSize();

    @Key("admin.user.enabled")
    boolean isAdminEnabled();
}
Использование в базовом тестовом классе TestNG:
import org.aeonbits.owner.ConfigFactory;
import org.testng.annotations.BeforeSuite;

public class BaseTest {
    protected static ProjectConfig config;

    @BeforeSuite(alwaysRun = true)
    public void initConfiguration() {
        // Owner автоматически подставит значение env из -Denv=... и загрузит нужный файл
        config = ConfigFactory.create(ProjectConfig.class);
    }
}
Способ 3. Data-Driven Testing в TestNG
Бывает, логика проверки одна, а входных данных много — например, форма регистрации или расчёт скидок. Писать под каждую строку отдельный @Test — плохой путь, и в TestNG для этого есть @DataProvider: значения выносятся в CSV-файл в ресурсах проекта, а дата-провайдер читает строки и передаёт их тестовому методу.
Отдельно стоит сказать про параллельность. Флаг parallel = true в аннотации — и TestNG сам распределит строки по потокам, а в отчёте Allure каждая строка будет отдельной проверкой. Если упадёт конкретный кейс, это сразу видно.
У подхода есть ограничения: в TestNG нет встроенного чтения CSV, так что парсер придётся написать один раз самому. А если в таблице 50 колонок, ревьюить её в пул-реквесте неудобно.
Схема жизненного цикла динамических данных
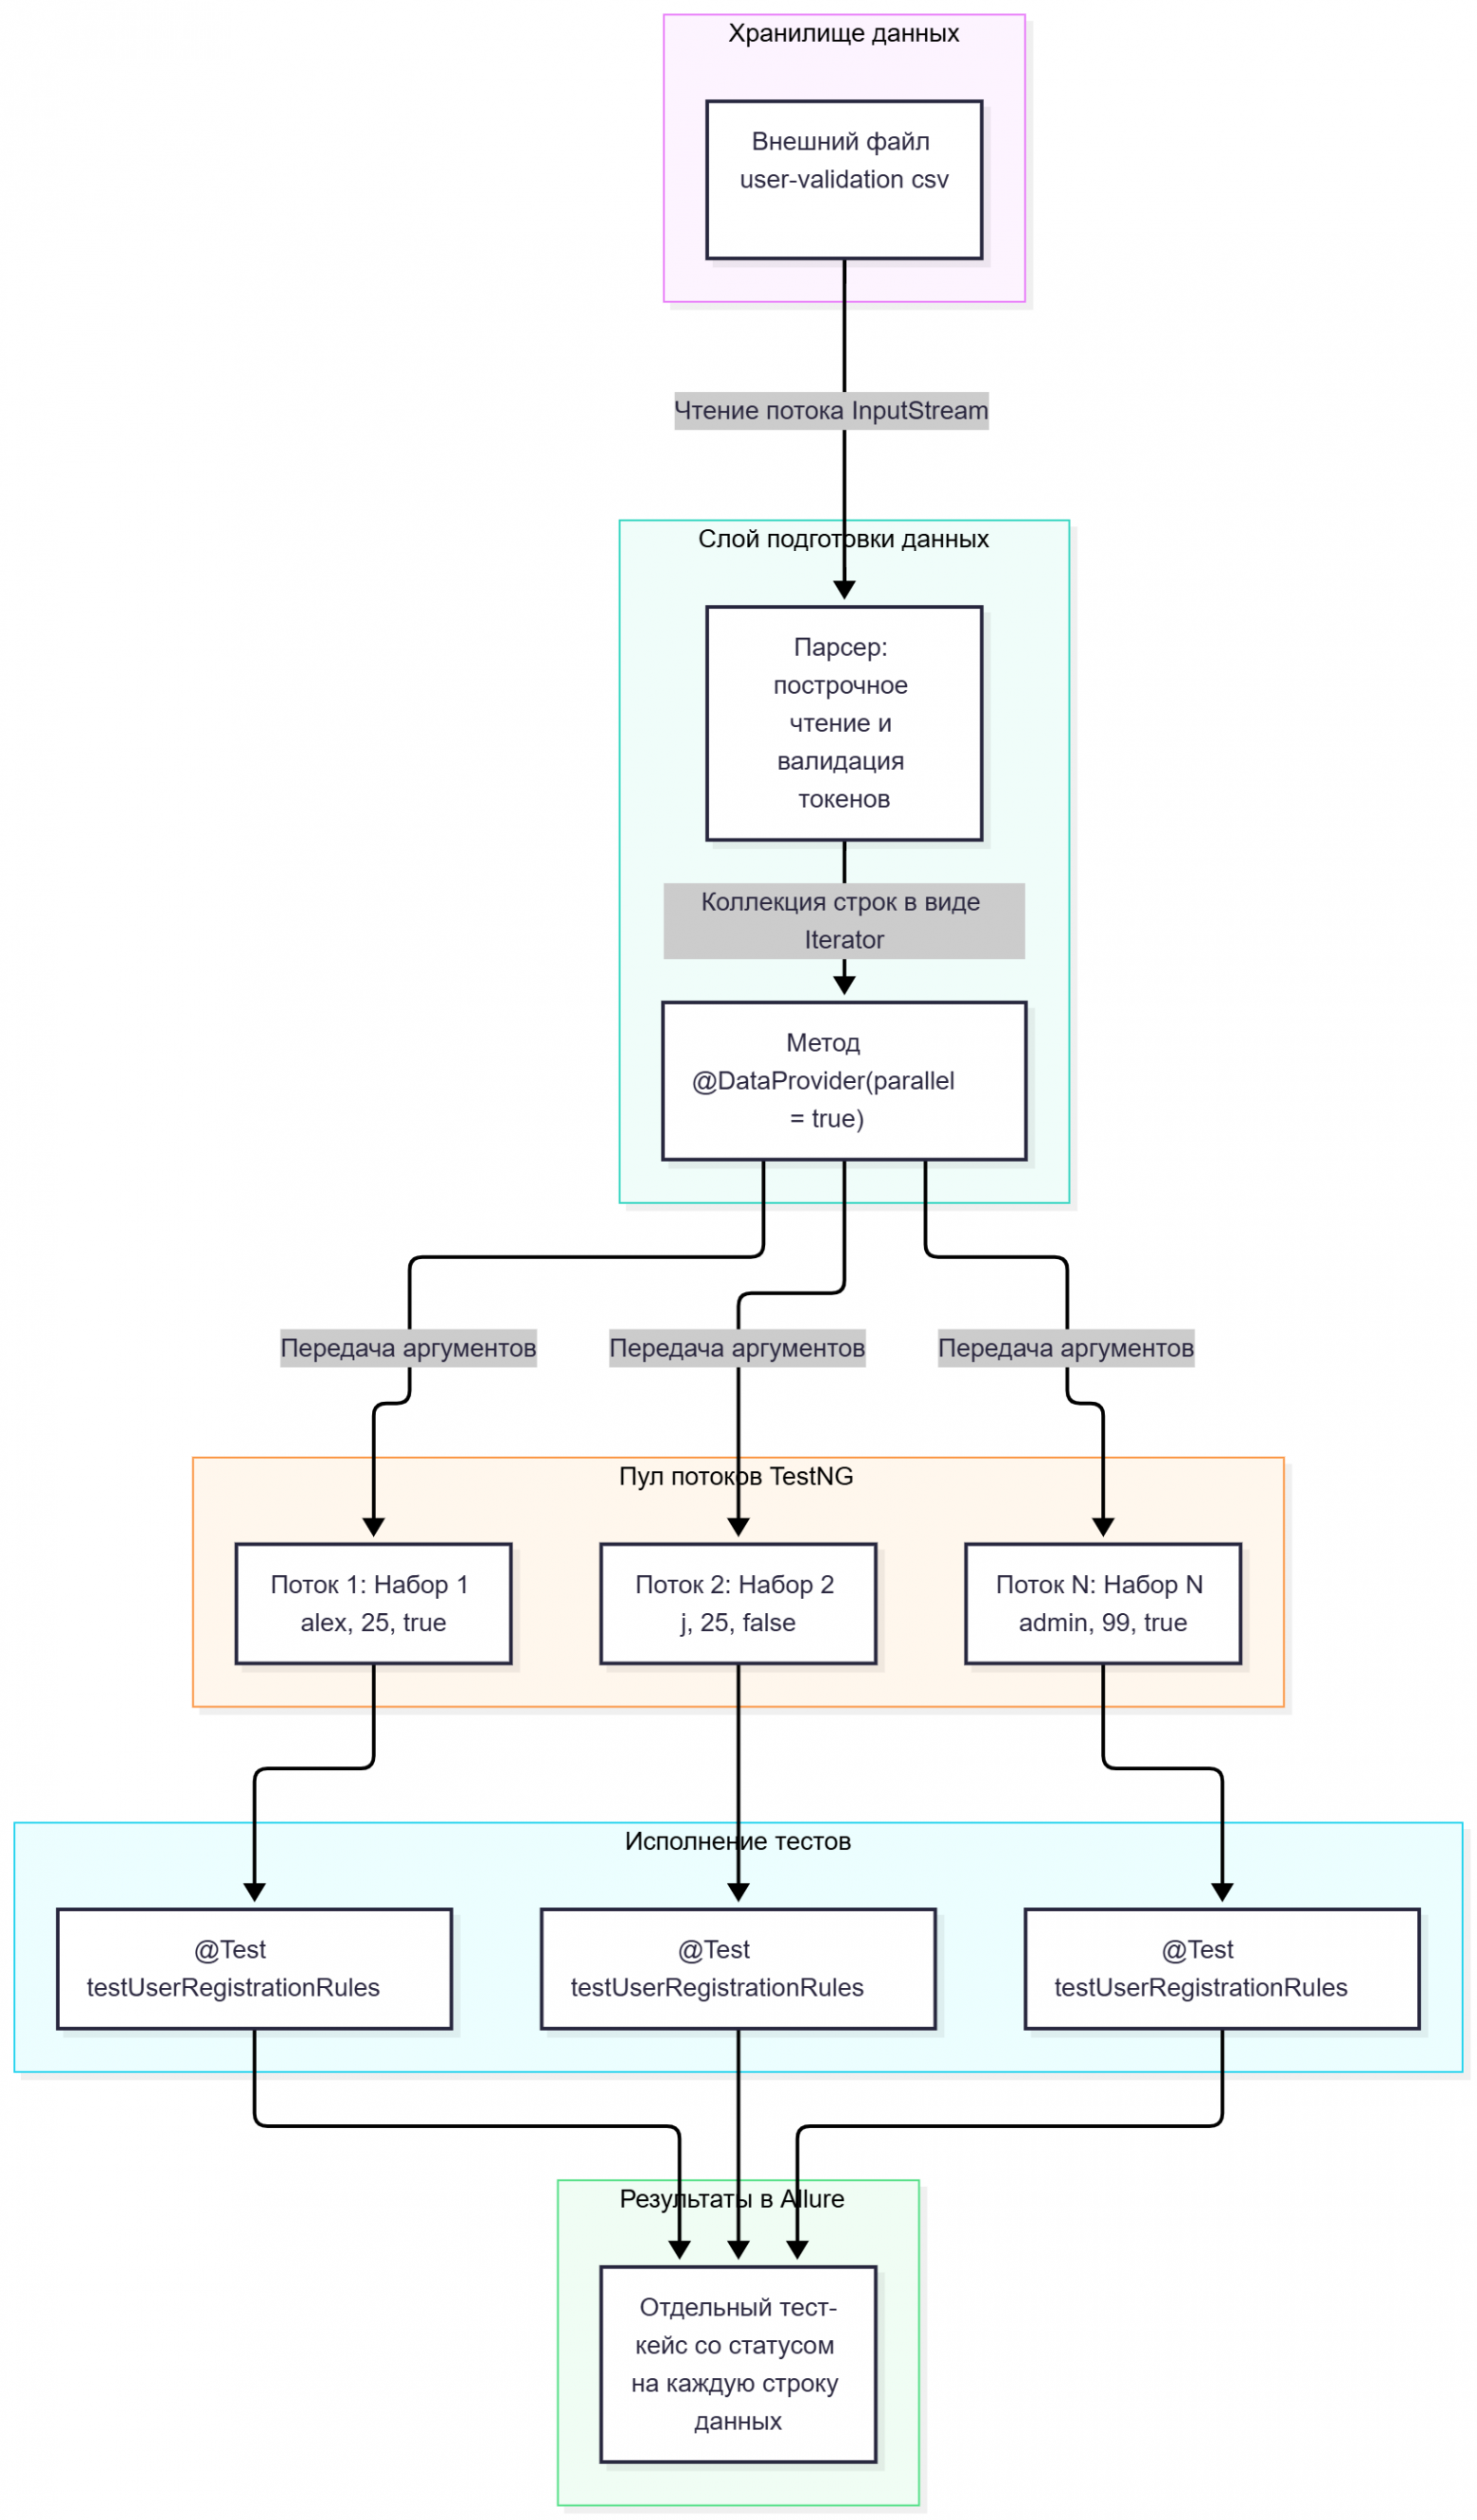
Пример с чтением внешнего CSV-файла
Файл с данными
src/test/resources/testdata/user-validation.csv:
username, email, age, isValid
alex, alex@test.com, 25, true
j, invalid-email, 25, false
validUser, user@domain.co, 17, false
admin_user, admin@company.ru, 99, true
Код теста и дата-провайдера:
import org.testng.Assert;
import org.testng.annotations.DataProvider;
import org.testng.annotations.Test;

import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.nio.charset.StandardCharsets;
import java.util.ArrayList;
import java.util.Iterator;
import java.util.List;

public class UserValidationTest {

    @DataProvider(name = "userValidationData", parallel = true)
    public Iterator<Object[]> provideUserData() throws Exception {
        List<Object[]> testData = new ArrayList<>();

        try (var inputStream = getClass().getResourceAsStream("/testdata/user-validation.csv");
             var reader = new BufferedReader(new InputStreamReader(inputStream, StandardCharsets.UTF_8))) {

            // Пропускаем шапку таблицы
            String line = reader.readLine();

            while ((line = reader.readLine()) != null) {
                if (line.isBlank()) continue;
                String[] tokens = line.split(",\\s*");
                testData.add(new Object[]{
                    tokens[0],
                    tokens[1],
                    Integer.parseInt(tokens[2]),
                    Boolean.parseBoolean(tokens[3])
                });
            }
        }
        return testData.iterator();
    }

    @Test(dataProvider = "userValidationData", description = "Проверка правил валидации пользователей")
    public void testUserRegistrationRules(String username, String email, int age, boolean expectedResult) {
        UserDto user = new UserDto(username, email, age);
        boolean actualResult = UserValidator.isValid(user);

        // В TestNG порядок ассерта: actual, expected
        Assert.assertEquals(actualResult, expectedResult);
    }
}
Плюсы и Минусы
Главный плюс подхода — максимальная гибкость: провайдер может читать любые источники (CSV, JSON через Jackson, Excel через Apache POI) и собирать типизированные объекты. Параллельность идёт из коробки: флаг parallel = true в аннотации @DataProvider автоматически распределяет наборы данных по потокам, а Allure и репортер TestNG фиксируют каждую итерацию как независимый тест-кейс со своими параметрами.
Есть и минусы. В TestNG нет встроенной аннотации формата @CsvFileSource, поэтому логику чтения файлов придётся инкапсулировать в утилитный класс. CSV на 40+ колонок трудно читать при код-ревью в Git, а вложенные иерархические структуры тяжело укладывать в плоские таблицы.
Способ 4. Динамическая фабрика данных (Test Data Factory)
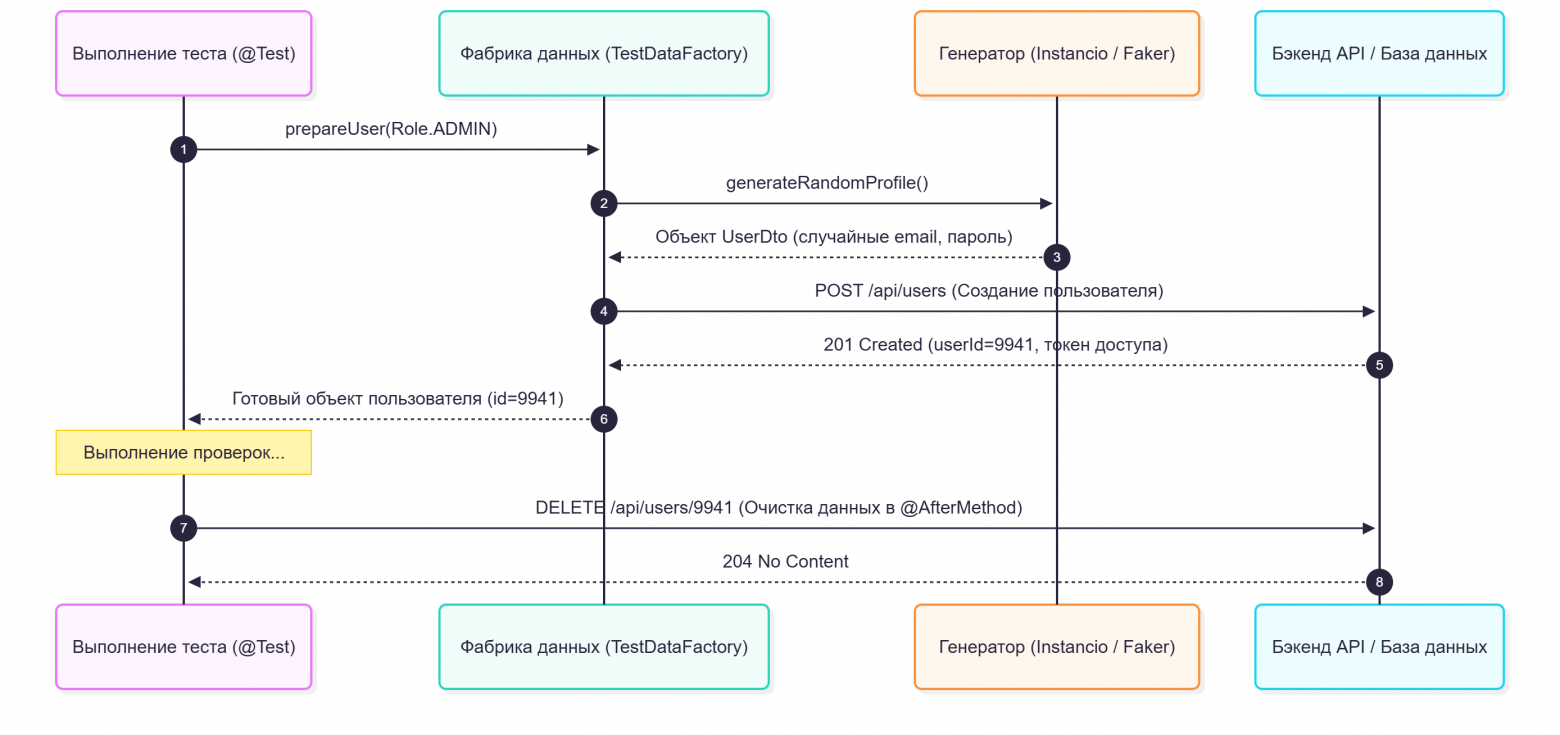
Если тесты идут параллельно и меняют базу, статические файлы рано или поздно приведут к пересечению по данным. Решение — генерировать данные во время прогона. Сначала библиотека вроде Instancio или Faker создаёт случайного пользователя: имя, уникальную почту, пароль. Затем фабрика отправляет POST /api/users на бэкенд, сервер создаёт запись и возвращает ID с токеном — тест использует токен для проверок, а в @AfterMethod созданный пользователь удаляется через DELETE-запрос.
Минус — дополнительные вызовы API увеличивают время прогона. Зато изоляция полная: потоки не пересекаются по данным.
Схема жизненного цикла динамических данных
Пример реализации фабрики с библиотекой Instancio
import org.instancio.Instancio;
import org.instancio.Select;

public class TestUserFactory {

    private final UserApiClient api = new UserApiClient();

    public UserDto createRandomUser() {
        // Генерируем объект со случайным валидным email
        UserDto payload = Instancio.of(UserDto.class)
                .set(Select.field("email"), "autotest_" + System.currentTimeMillis() + "@test.com")
                .set(Select.field("role"), "CUSTOMER")
                .create();

        // Регистрируем сущность через реальный бэкенд API
        return api.createUser(payload);
    }

    public void deleteUser(Long userId) {
        api.deleteUser(userId);
    }
}
Использование в тесте TestNG:
import org.testng.Assert;
import org.testng.annotations.AfterMethod;
import org.testng.annotations.BeforeMethod;
import org.testng.annotations.Test;

public class OrderFlowTest {

    private final TestUserFactory userFactory = new TestUserFactory();
    private UserDto user;

    @BeforeMethod
    public void prepareIsolatedData() {
        // Каждому запуску теста — свой собственный пользователь
        user = userFactory.createRandomUser();
    }

    @AfterMethod(alwaysRun = true)
    public void cleanupData() {
        if (user != null) {
            userFactory.deleteUser(user.getId());
        }
    }

    @Test
    public void testCheckoutOrder() {
        OrderResponse response = new OrderClient().createOrder(user.getToken(), new ProductDto("Laptop"));
        Assert.assertNotNull(response.getOrderId(), "Идентификатор заказа должен быть сформирован");
    }
}
Плюсы и Минусы
Главный плюс — полная изоляция: тесты гарантированно не пересекаются и могут безопасно запускаться в 20+ потоков. Прогону не важно, что делали ручные тестировщики или другие команды на Stage до него, а данные не устаревают — не нужно вручную обновлять пароли или регенерировать токены в файлах.
Минусы тоже есть. На проекте должны быть стабильные ручки API для создания и удаления сущностей, а дополнительные сетевые запросы перед каждым тестом немного увеличивают общее время сьюта.
Способ 5. Хранение секретов (Vault)
Пароли и мастер-токены в .properties в репозитории — прямой путь к разговору со службой безопасности, даже если репозиторий приватный. Для этого есть хранилища: HashiCorp Vault, AWS Secrets Manager или Masked Variables в GitLab CI. Фреймворк паролей не знает: раннер получает временный токен, идёт в Vault и держит ключи в памяти JVM только на время прогона. Минус — порог входа: без настроенных политик доступов не получится запускать локально.
Пример кода интеграции с Vault
import com.bettercloud.vault.Vault;
import com.bettercloud.vault.VaultConfig;

public class SecretVaultManager {

    private static String dbPassword;

    public static synchronized String getDatabasePassword() {
        if (dbPassword == null) {
            try {
                VaultConfig config = new VaultConfig()
                        .address(System.getenv("VAULT_ADDR"))
                        .token(System.getenv("VAULT_TOKEN"))
                        .build();

                Vault vault = new Vault(config);
                dbPassword = vault.logical()
                        .read("secret/data/qa/database")
                        .getData()
                        .get("password");
            } catch (Exception e) {
                throw new RuntimeException("Не удалось получить секреты из Vault", e);
            }
        }
        return dbPassword;
    }
}
Сравнительная матрица подходов
Сведём все пять подходов в одну таблицу, чтобы было проще выбрать подходящий под задачу:
Подход | Сложность реализации | Уровень безопасности | Параллельный запуск | Основная область применения |
|---|---|---|---|---|
CLI / Системные свойства | Низкая | Средняя | Высокая | Переключение стендов ( |
Файлы конфигураций + Owner | Средняя | Низкая (если секреты в Git) | Средняя | Настройка статических профилей проекта и окружений |
TestNG | Низкая | Высокая | Высокая | Массовая проверка валидации форм, граничных значений и расчетов |
Test Data Factory (API) | Высокая | Высокая | Максимальная | Создание уникальных бизнес-сущностей под каждый отдельный тест |
Vault / Менеджеры секретов | Высокая | Максимальная | Высокая | Хранение боевых паролей, платежных токенов и приватных ключей |
Дерево решений: как выбрать подходящий способ под задачу
Чтобы не изобретать велосипед каждый раз, держите практическую схему принятия решений:
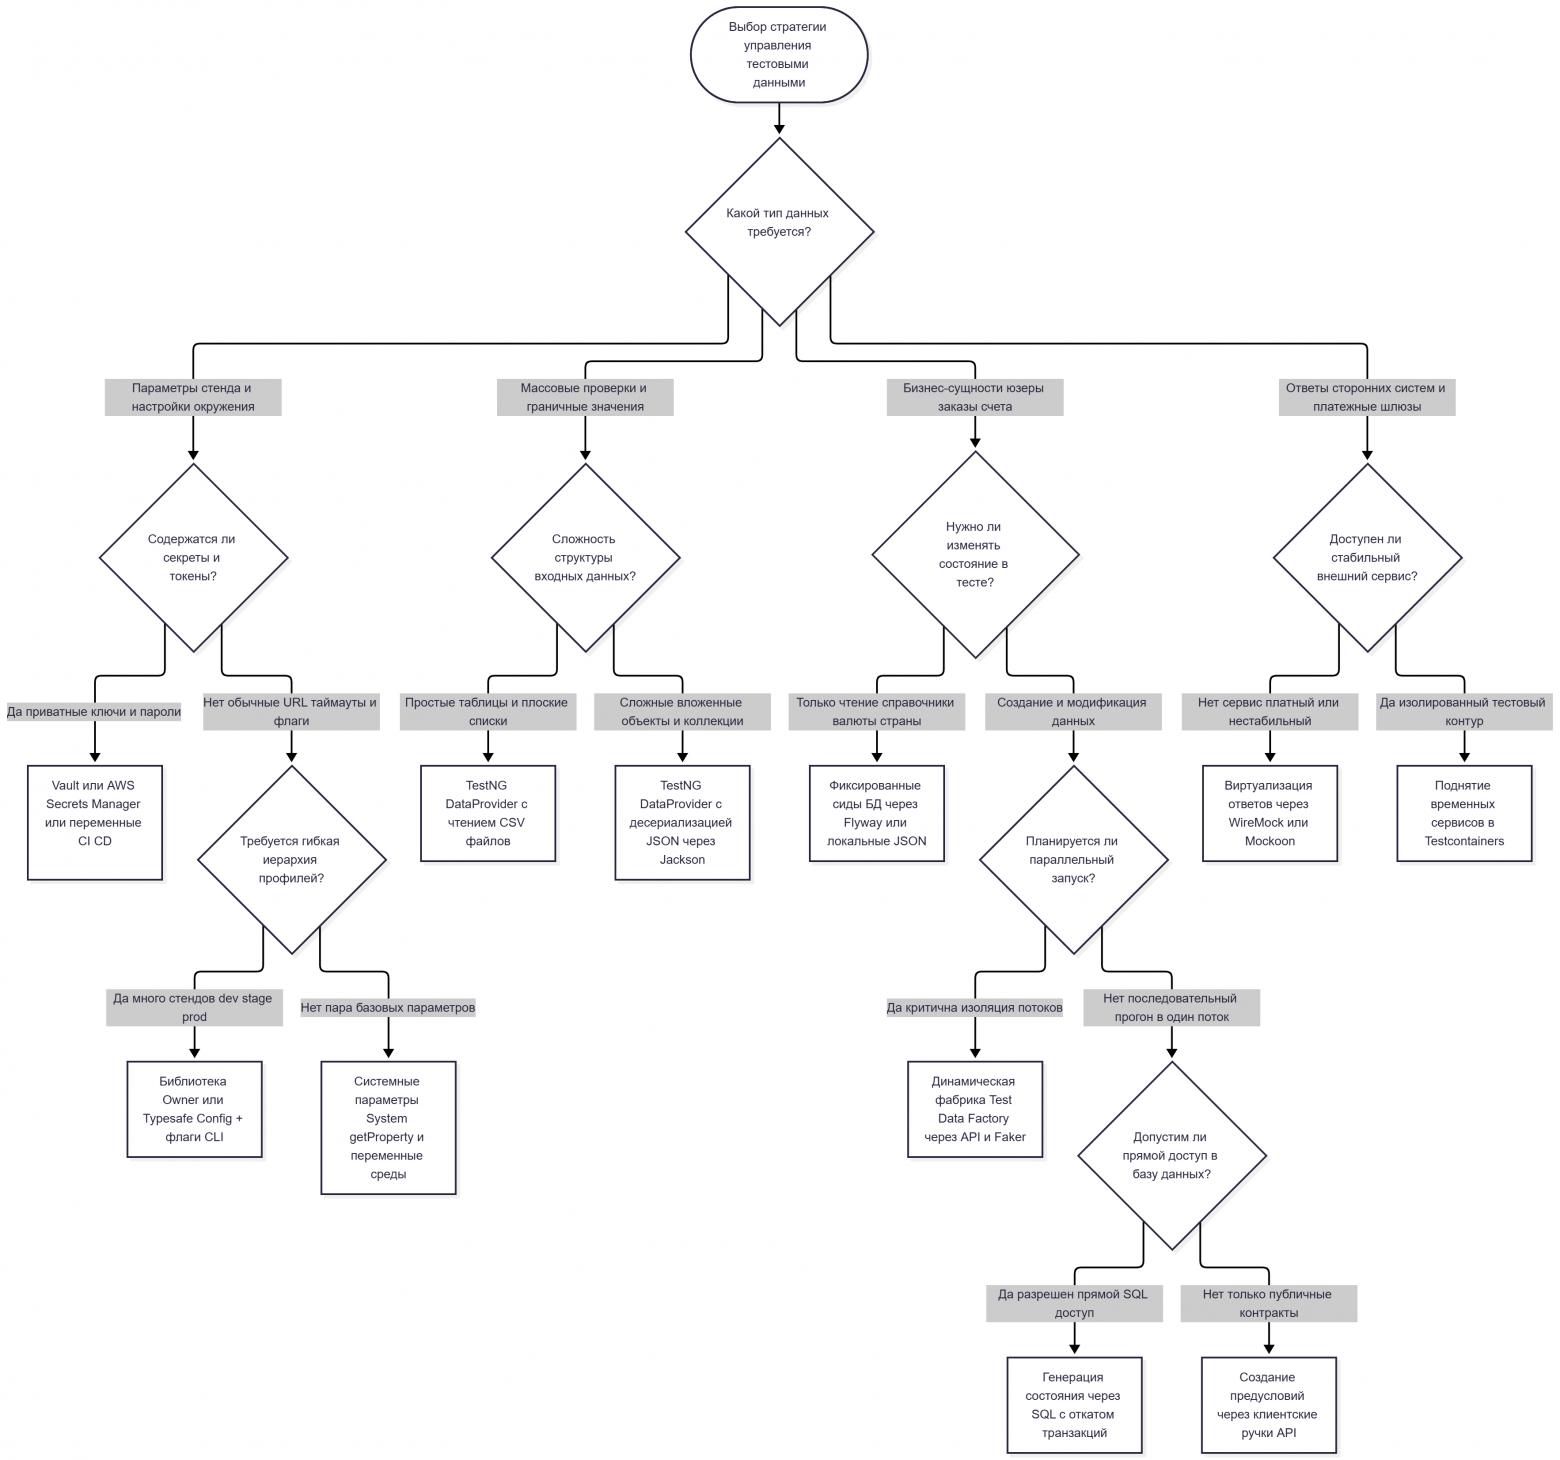
Схема помогает быстро определить, какой подход подходит для вашей задачи: от выбора стенда до генерации изолированных данных.
4 главных антипаттерна при работе с тестовыми данными
1. Общее изменяемое состояние (Shared Mutable State)
Симптом: по очереди тесты проходят, а при запуске в 8 потоков на CI падают случайным образом. Причина — тест А меняет баланс или пароль пользователя, а тест Б в этот момент пытается авторизоваться под ним же. Решение: использовать Test Data Factory и выдавать каждому тесту отдельный экземпляр сущности.
2. Секреты в системе контроля версий
Симптом: в репозитории лежит application.properties со строкой master.admin.pass=SuperSecret123. Причина — сделали временно, чтобы быстрее завести тесты, и забыли убрать. Решение: добавить локальные конфиги в .gitignore, а секреты передавать через переменные окружения пайплайна или Vault.
3. Таблицы-гиганты (Giga-CSV)
Симптом: в проекте CSV на 60 колонок и 2000 строк, и никто уже не понимает, почему правка в колонке BA ломает половину сьюта. Причина — попытка описать сложный E2E-сценарий через плоскую таблицу. Решение: CSV — только для простых проверок граничных значений и валидаций, а сложные сценарии описывать через типизированные объекты и Builder.
4. Отсутствие уборки за собой (Forgotten Teardown)
Симптом: через полгода прогонов база стенда раздувается до сотен гигабайт, а поиск по пользователям отвечает с 10-секундным таймаутом. Причина — тесты создают записи и никогда их не удаляют. Решение: обязательная очистка в @AfterMethod(alwaysRun = true) или изолированные контейнеры через Testcontainers.
Личный опыт
В теории хочется собрать сложную схему: Vault, фабрики, генераторы. Выглядит солидно, особенно на собеседованиях. Но на боевом проекте мы взяли обычный TestNG @DataProvider с CSV — и не пожалели.
У нас много тарифных сеток и табличных проверок: сотни пограничных случаев покрыты тремя тестами. К тестам подключились ручные тестировщики — Java им знать не нужно: нашёл баг, дописал строку в CSV и сделал коммит, тест подхватит данные сам. И это быстро: с parallel = true весь сьют проходит за пару минут. Просто и надёжно.
Заключение
Идеального решения для тестовых данных не существует. Всё зависит от архитектуры системы, стабильности стендов и требований безопасности. Главное правило — не привязывать данные намертво к тестовым классам. Код должен оставаться чистым и независимым от данных.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.