TG (telegram-parser) — обзор проекта
Репозиторий: https://github.com/TheMyxa/telegram-parser
Лицензия/статус: открытый публичный проект
Текущая версия: 2.3.1
TG — это открытый некоммерческий local-first инструмент для выгрузки и аналитики комментариев Telegram-каналов, который превращает поток обсуждений и постов в чатах и каналах «Телеграма» в структурированный, пригодный для анализа датасет прямо на компьютере пользователя, без облачных посредников.
Большинство каналов в Telegram — это не только посты, но и оживлённая «параллельная» жизнь вокруг них в чате тг-каналов, где агрегируются комментарии к постам, формируются ветки обсуждений с реакциями, стикерами, ответами, упоминаниями, ссылками и мультимедиа. Эта живая активность часто ценнее самого поста: она показывает, что реально задело аудиторию, какие комментаторы и темы формируют повестку.
Проблема в том, что Telegram не даёт удобных инструментов, чтобы забрать эти данные одним куском и проанализировать их. Штатный экспорт чатов ограничен, привязан к ручным действиям и не масштабируется на десятки каналов. Именно этот разрыв и закрывает TG:
TG выгружает посты каналов, комментарии обсуждений, реакции, ссылки и (опционально) медиафайлы;
умеет инкрементально обновлять уже собранные датасеты, а не перекачивать всё заново;
сохраняет результат в JSON / CSV / Parquet / PostgreSQL;
поднимает локальный веб-дашборд с графиками, деревом комментариев, профилями пользователей и фильтрами;
умеет анализировать данные через LLM (промпты на русском, английском и китайском);
предоставляет MCP-сервер для автоматизации через AI-клиенты;
упакован в Docker Compose — «одна команда для запуска».
Ключевая идея TG — локальность: API-ключи, сессия Telegram, выгруженные данные и медиа не покидают машину пользователя.
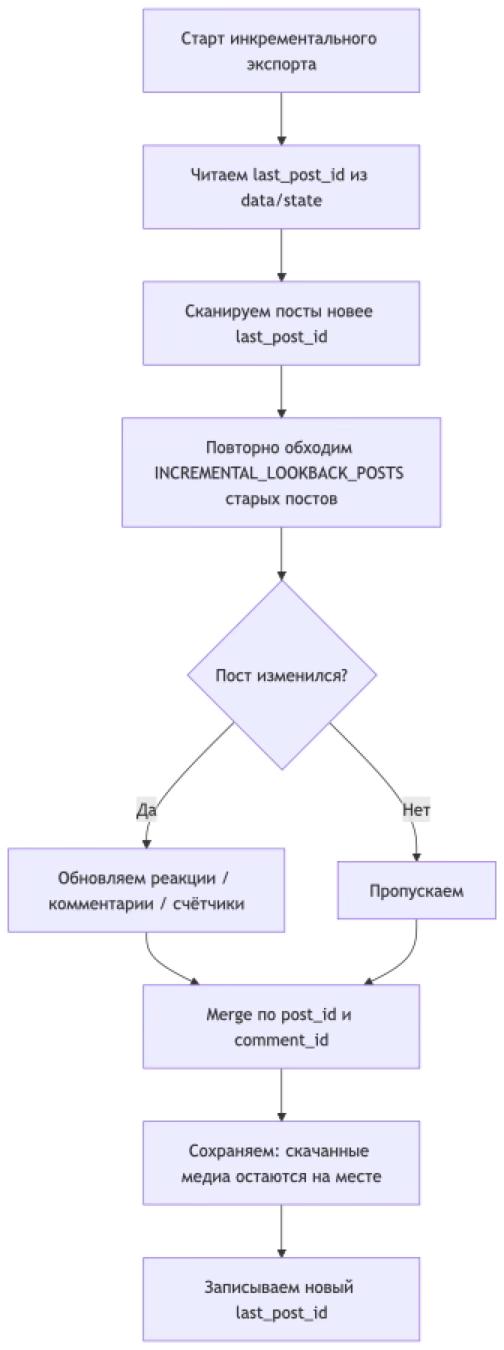
Центральная механика TG — инкрементальный экспорт. Вместо того чтобы каждый раз выкачивать канал с нуля (что медленно и рискованно из-за лимитов Telegram), TG помнит, что уже собрано, и при следующем запуске догружает лишь изменения: новые посты, свежие комментарии, обновившиеся счётчики просмотров и реакций. Один раз настроил — дальше данные копятся сами.
Собранные данные не запираются в проприетарном формате: на выходе — обычный JSON, который легко читать, парсить и передавать в любые другие инструменты, а также готовые выгрузки в CSV, Parquet (для аналитики и pandas/Spark) и PostgreSQL (для командной работы и сложных запросов). Поверх этих данных идёт веб-дашборд: графики активности по дням, топы пользователей и эмодзи, самые обсуждаемые посты, древовидное отображение ветки комментариев и фильтры по пользователю, дате, реакции, наличию медиа и ответов. Дашборд работает полностью офлайн — он просто читает локальные файлы.
Отдельная ценность — автоматизация. Три режима позволяют выбрать подходящий формат сбора:
разовый экспорт (забрать и остановиться);
Scheduler (регулярно обновлять каналы по расписанию, например раз в час);
Watch (держать сессию открытой и ловить изменения почти в реальном времени).
А через MCP-сервер и LLM-анализ проект встраивается в современный AI-стек: языковая модель может сама по запросу открыть выгрузку, найти нужные комментарии, посчитать метрики и написать текстовую сводку.
Конфиденциальность как архитектурное решение: секреты (.env), сессия Telegram, приватные выгрузки, скачанное медиа и результаты анализа по умолчанию исключены из Git и лежат только на вашей машине. Единственный внешний сервис, с которым проект говорит, — это Telegram API; и, если не подключаться к удалённой LLM, ни один байт собранных данных наружу не уйдёт.
Главные возможности: карта функциональности
Каждая строка — это отдельная законченная функциональность: сбор данных, их обновление, хранение, визуализация или автоматизация. Вместе они образуют полный цикл «от канала до инсайта».
Возможность | Описание |
|---|---|
Выгрузка постов и комментариев | Через Telethon, с поддержкой одного или нескольких каналов ( |
Инкрементальный экспорт | Сканирует новые посты + «оглядывается» назад на N старых, обновляя счётчики, реакции и комментарии |
Watch mode | Долгоживущий процесс: следит за каналами и обновляет изменённые посты в реальном времени |
Медиа | Опциональная выгрузка вложений в |
Анонимизация | Замена |
Форматы вывода | JSON, CSV, Parquet, PostgreSQL |
Веб-дашборд (порт | Графики, дерево комментариев, фильтры, профили, запуск экспорта из браузера |
Scheduler mode | Автообновление выбранных каналов каждые N минут |
Сравнение периодов |
|
LLM-анализ | Анализ JSON-выгрузок по встроенным или своим промптам ( |
MCP-сервер | Локальная автоматизация через stdio для AI-клиентов |
Docker Compose | Готовый сетап для локального запуска |
Что это даёт
Данные вместо догадок. Вместо «кажется, эта тема зашла» — график по дням и точные цифры по реакциям.
Дёшево и безопасно. Инкремент вместо перекачки = меньше запросов к Telegram и ниже риск блокировки.
Открытый формат. JSON/CSV/Parquet/SQL — данные остаются вашими и работают с любой экосистемой.
AI-friendly. MCP и LLM-анализ делают датасет доступным для агентов и чат-ботов.
Приватность по умолчанию. Local-first не как опция, а как основа.
Архитектура и поток данных
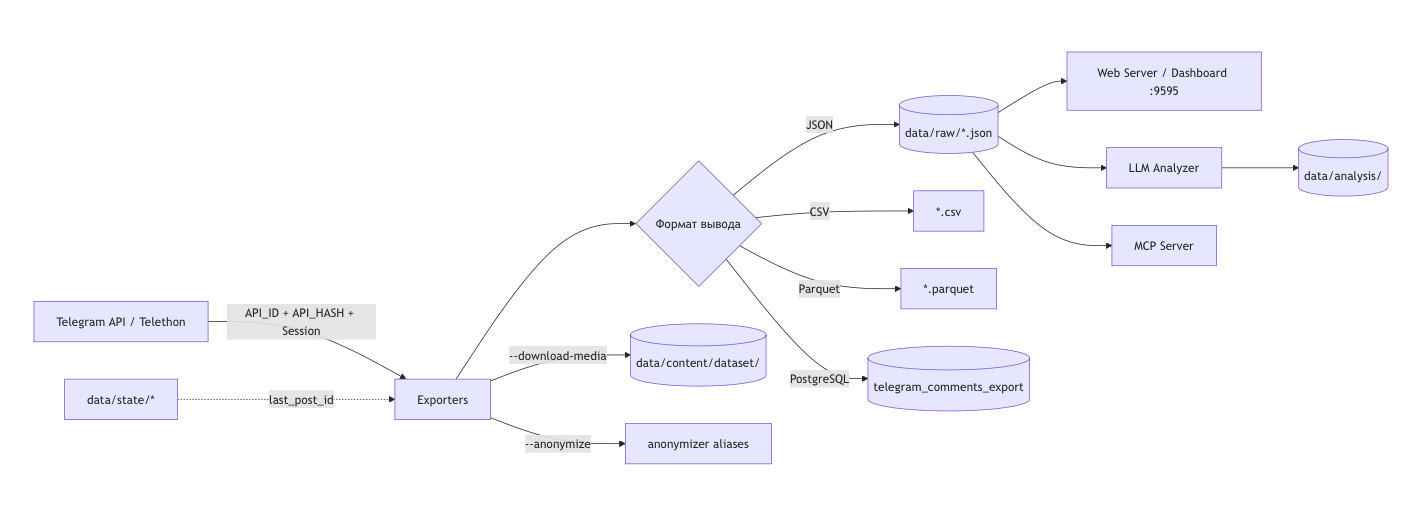
Схема пайплайна
Логика инкрементального экспорта
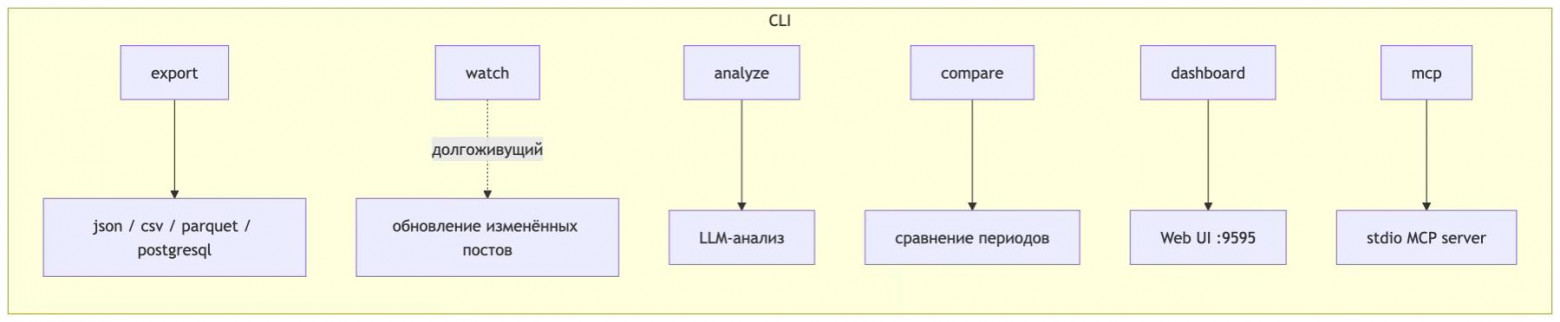
Режимы работы
Как это работает — словами
Весь конвейер строится вокруг нескольких слоёв, каждый из которых отвечает за одну задачу. Понимание этих слоёв помогает и при первом запуске, и при отладке.
Слой доступа к Telegram. В основе лежит библиотека Telethon — официальный по духу клиент Telegram API, работающий от имени обычного пользовательского аккаунта, а не бота. Именно поэтому здесь не нужен бот-токен: вы авторизуетесь своим аккаунтом, а между запусками переиспользуете сохранённую сессию (файл в sessions/). Такой поход даёт доступ к комментариям и реакциям каналов, которые через бот-API часто недоступны или ограничены. Однако, поскольку Telegram косо смотрит на массовый сбор данных через пользовательские аккаунты, такие аккаунты могут ограничить или забанить. Поэтому для использования TG лучше использовать не основной аккаунт, а отдельный — или использовать основной на свой страх и риск.
Слой выгрузки (exporters). Он берёт список каналов из CHANNEL, идёт по постам, для каждого раскрывает обсуждение, собирает комментарии вместе с авторами, ответами и реакциями. Здесь же работают «предохранители»: паузы между запросами (POSTS_PAUSE_SECONDS, POSTS_PAUSE_AFTER_POSTS) и обработка FloodWaitError — если Telegram просит подождать, экспортер сначала сохраняет уже собранное, а потом ждёт.
Слой хранения (storage). Запись в файлы выполняется атомарно: данные сначала собираются полностью, а затем заменяют прежний файл. Это значит, что обрыв процесса не оставит после себя битый датасет. Тот же слой читает JSON при открытии дашборда.
Слой состояния (state). Файлы data/state/<channel>_state.json помнят, докуда дошла предыдущая выгрузка (last_post_id). Благодаря этому следующий запуск знает, что уже есть, и не повторяет лишнюю работу. Это тот самый «компас» инкрементальности.
Слой представления. Дашборд (api/ + web/) — обычный локальный HTTP-сервер с фронтендом на HTML/CSS/JS. Он не тянет данные из интернета: все графики и таблицы строятся из локальных файлов в data/raw.
Слой надстройки. Поверх готовых данных работают три независимых инструмента: analyze (LLM), compare (сравнение периодов) и mcp (машиночитаемый доступ для AI-агентов). Ни один из них не обязателен — это «плюшки» для тех, кому нужен анализ, а не просто выгрузка.
Структура проекта
Путь | Назначение |
|---|---|
| Единый CLI: |
| Совместимый entrypoint для |
| Локальный веб-сервер и API дашборда |
| Совместимый entrypoint для |
| Хелперы сериализации сообщений Telegram |
| Оркестрация выгрузки и форматы вывода |
| Чтение JSON и атомарная запись файлов |
| Сводки по датасетам и хелперы аналитики |
| Реализация LLM-анализа |
| Совместимый entrypoint для |
| MCP-сервер для локального экспорта и анализа |
| Файлы промптов LLM ( |
| Загрузчик |
| Алиасы для анонимизированных пользователей |
| Выгруженные датасеты |
| Скачанное медиа |
| Результаты LLM-анализа |
| Состояние инкрементальной выгрузки |
| Сервисы Docker Compose |
|
|
Формат данных
Данные спроектированы так, чтобы их можно было читать и человеку, и программе. Верхний уровень — массив постов; внутри каждого поста живёт массив комментариев, а внутри комментария — объект автора. Такая вложенность повторяет саму структуру Telegram (пост → обсуждение → реплики) и позволяет одним файлом описать весь диалог вокруг публикации, без внешних ключей и справочников.
Формат намеренно «плоский» там, где это полезно: даты — строки в ISO-подобном виде, реакции — простой список {emoji, count}, ссылки — готовые URL. Благодаря этому JSON одинаково хорошо ложится и в pandas, и в SQL, и в любой визуализатор, не требуя предварительной нормализации.
Основной JSON — это список постов:
[
  {
    "post_id": 101,
    "post_date": "2026-07-10 10:00:00+00:00",
    "post_text": "Post text",
    "post_views": 1200,
    "post_forwards": 10,
    "post_link": "https://t.me/channel/101",
    "post_media": null,
    "post_reactions": [{"emoji": "fire", "count": 12}],
    "comments": [
      {
        "comment_id": 501,
        "comment_date": "2026-07-10 10:05:00+00:00",
        "comment_text": "Comment text",
        "comment_link": "https://t.me/channel/501",
        "comment_media": null,
        "reply_to_msg_id": null,
        "comment_reactions": [],
        "user": {
          "user_id": 1001,
          "username": "alice",
          "first_name": "Alice",
          "last_name": null,
          "bot": false,
          "premium": false
        }
      }
    ]
  }
]
Поля ошибок (частичный экспорт):
Поле | Уровень | Когда появляется |
|---|---|---|
| пост | Не удалось скачать медиа поста |
| пост | Ошибка на шаге выгрузки, но данные частично сохранены |
| комментарий | Не удалось скачать медиа комментария |
CLI-команды
Проект сознательно построен вокруг одного entrypoint. Вместо десятка скриптов вы запоминаете одну команду tg и её подкоманды — это упрощает и документацию, и автоматизацию. В Docker тот же CLI вызывается через docker compose run --rm cli, поэтому локальный запуск и запуск в контейнере практически идентичны.
Единый entrypoint: tg <command> [options] (в Docker: docker compose run --rm cli <command>).
Команды делятся на три смысловые группы: сбор данных (export, watch), анализ (analyze, compare), интерфейсы (dashboard, mcp), плюс служебная config-check для проверки настроек.
Команда | Пример | Что делает |
|---|---|---|
|
| Экспорт в JSON: |
|
| Инкрементальный экспорт в |
|
| + скачивание медиа |
|
| + анонимизация пользователей |
|
| Альтернативные форматы |
|
| Непрерывное отслеживание |
|
| LLM-анализ выгрузки |
|
| Сравнение периодов |
|
| Запуск веб-UI |
|
| Запуск MCP-сервера по stdio |
|
| Валидация конфигурации |
--toвcompare— исключительно (exclusive). Если--fileне указан, берётся самый свежий JSON изdata/raw.
Веб-дашборд и API
Дашборд — это «витрина» проекта и, пожалуй, самая наглядная его часть. Он превращает сухой JSON в понятную картину: вы видите, как менялась активность по дням, кто пишет больше всех, какие реакции преобладают, какие посты вызвали бурное обсуждение. Древовидный вид комментариев делает читаемыми длинные ветки ответов, а фильтры позволяют мгновенно сузить выборку до нужного пользователя, периода, эмодзи или постов с медиа.
Ценность дашборда ещё и в том, что он стирает границу между «техническим» и «содержательным»: аналитику не нужно знать Python, чтобы получать ответы на вопросы. А поскольку интерфейс запускает экспорт прямо из браузера и показывает прогресс, весь цикл «собери → посмотри → пойми» укладывается в одну вкладку.
Дашборд доступен на http://localhost:9595 и умеет:
загружать JSON-файл вручную;
открывать локальные выгрузки из
data/raw(сортировка по дате/каналу);показывать имя файла, посты, комментарии, уникальных пользователей, реакции;
строить графики по дням, топ пользователей, топ эмодзи, самые обсуждаемые посты;
открывать пост и показывать комментарии деревом;
фильтровать по пользователю, диапазону дат, эмодзи, медиа и ответам;
открывать профиль пользователя;
редактировать
.envпрямо из вкладки Export;запускать экспорт из браузера с прогрессом;
включать Scheduler mode (авто-обновление каждые N минут);
включать Watch mode (непрерывное обновление изменённых постов).
Ключевые эндпоинты API
Метод | Endpoint | Назначение |
|---|---|---|
GET |
| Текущая версия приложения |
GET |
| Список JSON-выгрузок из |
GET |
| Счётчики и метаданные одной выгрузки |
GET |
| Сравнение комментариев, пользователей, реакций |
GET |
| Текущее состояние планировщика |
GET |
| История запусков |
GET |
| Детали одного запуска |
POST |
| Старт авто-экспорта |
POST |
| Стоп авто-экспорта |
GET |
| Состояние Watch mode |
POST |
| Старт Watch mode |
POST |
| Стоп Watch mode |
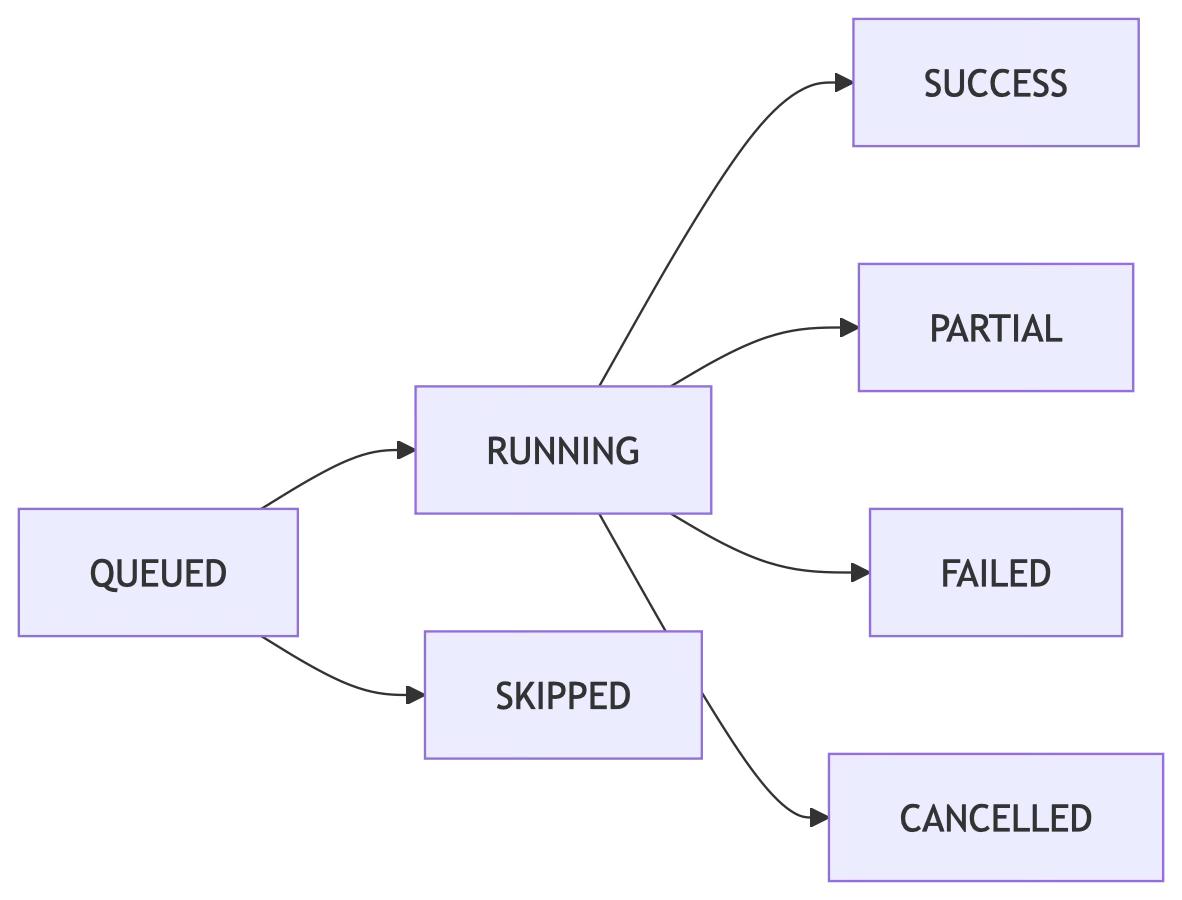
Статусы запусков планировщика
История хранится в data/scheduler/ — JSON-файл на каждый запуск.
Статус | Значение |
|---|---|
| Запуск в очереди |
| Выполняется |
| Успешно завершён |
| Частичные данные |
| Ошибка |
| Пропущен (предыдущий ещё идёт) |
| Отменён |
Scheduler и Watch — в чём разница. Оба режима автоматизируют сбор, но решают разные задачи. Scheduler работает «по будильнику»: он запускает экспорт сразу при включении, а затем повторяет его каждые N минут. Если предыдущая выгрузка ещё идёт к моменту нового запуска, итерация помечается как SKIPPED и не наслаивается — это защита от гонок. Watch же держит соединение открытым и реагирует на события: как только в канале появляется пост или в обсуждении всплывает новый комментарий, соответствующий пост обновляется. Проще говоря, Scheduler — это «проверяй по расписанию», Watch — это «следи непрерывно».
MCP-сервер (инструменты автоматизации)
MCP (Model Context Protocol) — открытый протокол, позволяющий AI-клиентам вызывать внешние инструменты. Поддержка MCP превращает TG из «человеческого» инструмента в машиночитаемый: языковая модель или агент может сам открыть выгрузку, получить сводку, найти комментарии по теме или даже запустить новый экспорт — разумеется, с явным подтверждением (confirm=true), чтобы случайное действие не ушло в прод.
В отличие от дашборда, MCP-сервер не рисует графиков — он отдаёт структурированные данные и действия по стандартному протоколу. Это открывает путь к сценариям вроде «спроси у чат-бота, что писали про X за последнюю неделю» или «пусть агент сам поддерживает датасет в актуальном состоянии».
Запуск: docker compose run --rm -i cli mcp или python main.py mcp.
Инструмент | Что делает |
|---|---|
| Читает не-секретные значения конфига (секреты маскирует) |
| Список JSON-выгрузок в |
| Сводка по выгрузке |
| Получить конкретный пост |
| Поиск по комментариям |
| Список файлов LLM-анализа |
| Чтение результата анализа |
| Запуск LLM-анализа |
| Запуск экспорта Telegram (требует |
| Статус процесса экспорта |
Конфигурация (.env)
Настройка сведена к одному файлу. Такой выбор делает проект переносимым: чтобы поднять TG на новой машине, достаточно скопировать .env, сессию и (при желании) уже собранные датасеты. Docker при первом старте автоматически создаёт .env из шаблона, а дашборд позволяет редактировать значения прямо из браузера — то есть порог входа для нетехнического пользователя остаётся низким.
Ключевая философия конфигурации — валидация по требованию: команда просит ровно те настройки, которые ей нужны. Нет смысла требовать параметры PostgreSQL, когда вы экспортируете в JSON, и наоборот.
Docker при первом старте сам создаёт .env из .env.example. Ключевые переменные:
Переменная | Назначение |
|---|---|
| Учётные данные приложения Telegram API |
| Один или несколько каналов через запятую (напр. |
| Путь к файлу сессии Telethon (обычно |
| Базовая папка вывода (обычно |
| Сколько новых/последних постов сканировать за запуск |
| Сколько уже выгруженных старых постов перепроверять |
| Длительность паузы (сек) |
| Пауза после каждых N обработанных постов |
| Параметры PostgreSQL-выгрузки |
| Эндпоинт и модель для |
Конфиг валидируется по командам: export требует Telegram-настройки, analyze — LLM-настройки, PostgreSQL-параметры грузятся только для postgresql-выгрузки.
Безопасность и приватность
В проектах, работающих с социальными данными, приватность — это не абстрактное требование, а ежедневная практика. TG исходит из того, что выгрузка содержит персональные данные (имена, username, id), а сессия Telegram фактически приравнивается к ключу от аккаунта. Поэтому безопасность заложена в саму разметку репозитория: всё чувствительное по умолчанию не попадает в Git и лежит локально.
Философия здесь проста: инструмент не должен становиться ещё одним облаком, которое хранит ваши данные непонятно где. Вы владеете и ключами, и данными, и сессией.
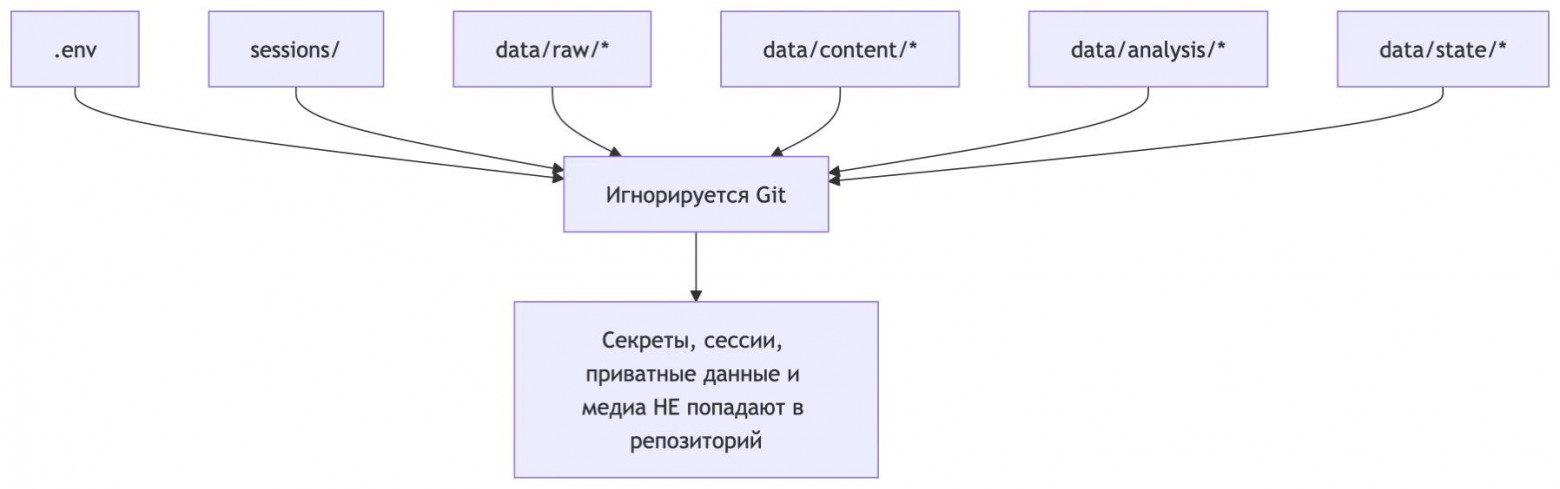
⚠️ Проект подчёркивает local-first подход: всё хранится и обрабатывается локально, данные не уходят на сторонние сервисы (если только вы сами не настроите внешний LLM-endpoint).
Лимиты Telegram и рекомендации
Это, пожалуй, наименее «документированная» и одновременно самая практичная часть работы с любым Telegram-парсером. Telegram намеренно не раскрывает точных лимитов и применяет их адаптивно — в зависимости от аккаунта, частоты запросов и общей нагрузки. Поэтому главный принцип TG: не гнать, а дружить с API. Частые мелкие запросы с паузами куда безопаснее одного агрессивного «дампа», и именно поэтому в проекте есть и паузы, и инкремент, и корректная реакция на FloodWaitError.
Отдельно стоит отметить поведение при срабатывании лимита: экспортер не теряет уже собранное, а сохраняет его и лишь затем ждёт положенное время. Это превращает потенциальный сбой в предсказуемую паузу, а не в потерянную ночную выгрузку.
Telegram не публикует единый универсальный лимит для всех сценариев Telethon. Экспортер делает паузы и корректно обрабатывает FloodWaitError, сохраняя уже собранные данные перед ожиданием.
Рекомендации из документации:
держать
POST_LIMITразумным;использовать инкрементальный экспорт вместо полной перекачки;
не отключать паузы;
избегать частых повторных выгрузок одного крупного канала;
не запускать много сессий параллельно с одного аккаунта.
Сценарии использования
Инструмент универсален настолько, насколько универсальны сами обсуждения в Telegram. Вот несколько типовых сценариев, которые хорошо показывают, кому и зачем нужен TG.
Кто | Задача | Как использует TG |
|---|---|---|
Контент-маркетолог | Понять, что заходит аудитории | Экспортирует свой канал, смотрит топ постов по реакциям и комментариям в дашборде |
Медиааналитик / исследователь | Изучить повестку | Собирает несколько каналов, сравнивает периоды через |
Комьюнити-менеджер | Найти активных участников* | Открывает профили комментаторов, топ пользователей по числу реплик |
Продуктовая команда | Собрать фидбек | Ключевые слова по комментариям, выгрузка в PostgreSQL для дашбордов BI |
Data Scientist | Построить ML-модель | Parquet-выгрузка напрямую в pandas/Jupyter, без ручного парсинга |
Разработчик AI-агентов | Дать агенту доступ к данным | Подключает MCP-сервер, агент сам ищет и суммирует комментарии |
Контент-редактор | Сделать текстовую сводку | Запускает |
*Т.к. выгрузка TG может содержать персональные данные, следует помнить, что сбор и хранение чужих персональных данных регулируются законом: GDPR в ЕС, 152-ФЗ «О персональных данных» в РФ. Ответственность за законность их сбора и использования лежит на пользователе. Также для защиты персональных данных есть режим анонимизации
anonymizer.
Общая нить всех сценариев одна: данные из «сырых» чатов превращаются в структуру, по которой можно принимать решения, а сам путь от канала до инсайта не выходит за пределы вашей машины.
Цифры и факты
Репозиторий: https://github.com/TheMyxa/telegram-parser
Текущая версия: 2.3.1
Лицензия/статус: открытый публичный проект ·
Звёзд ★ 128
9 форков
Коммитов: 11
Языки промптов LLM: ru, en, zh
Форматы вывода: JSON, CSV, Parquet, PostgreSQL
Порт дашборда: 9595
Основной язык: Python
Стейт-файлы:
data/state/<channel>_state.json
Быстрый старт
Первый запуск умещается в три действия: получить ключи Telegram API на https://my.telegram.org/apps, выполнить docker compose up --build и открыть http://localhost:9595, где в разделе Export заполняются настройки канала и запускается первая выгрузка. Дальше можно переключаться на инкрементальный экспорт, Watch или Scheduler — по мере необходимости.
Для тех, кто предпочитает полностью локальную установку без Docker, достаточно pip install -r requirements.txt и команд python main.py .... А чтобы «пощупать» дашборд без подключения к Telegram, в репозитории лежит готовый демо-файл examples/example.json.
# Docker (рекомендуется)
docker compose up --build
# → открыть http://localhost:9595

# CLI в Docker
docker compose run --rm cli config-check
docker compose run --rm cli export json --incremental

# Локально без Docker
pip install -r requirements.txt
python main.py config-check
python main.py export json --incremental
python main.py dashboard
Демо без подключения к Telegram: файл examples/example.json.
Итого
TG — маленький, но плотный по функциональности проект, который позволяет превратить обсуждения Telegram в структурированные данные для анализа. Его сильные стороны — инкрементальность (не качает лишнего), local-first (приватен по умолчанию), открытые форматы и готовность к AI (MCP и LLM-анализ). Одним инструментом закрываются и сбор, и визуализация, и автоматизация — от разовой выгрузки до непрерывного мониторинга десятков каналов.
Если вам нужно быстро понять, о чём писал канал за месяц, кто формирует обсуждение и какие темы «выстреливают», — весь путь укладывается в пару команд и один браузерный таб. А для более серьёзной аналитики проект без швов интегрируется с pandas, BI-системами и AI-агентами через уже готовые экспортеры и MCP.
Если эта публикация вас вдохновила и вы хотите поддержать автора — не стесняйтесь нажать на кнопку
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.