Алмазы, CXL и терабитный Ethernet: анонсы серверного железа в октябре
Производители ищут, чем заменить дорогую HBM, учат серверы делить DRAM через CXL, выделяют под ИИ-агентов отдельные CPU-стойки и, конечно, анонсируют новые GPU. Привет, Хабр! С вами Сергей Ковалёв, менеджер продукта Выделенные серверы в Selectel. Расскажем о новинках в нашем традиционном дайджесте за октябрь.
О чем писал Selectel
NVIDIA Rubin в формате PCIe
Из презентации сервера HPE ProLiant DL585a Gen13 стало известно, что NVIDIA готовит PCIe-версии ускорителей Rubin™ для обычных стоек с воздушным охлаждением. Из-за ограничений по теплоотводу и пропускной способности шины PCIe-версии будут слабее флагманских, а их появление ожидается в 2027 году.
Microsoft Maia 300
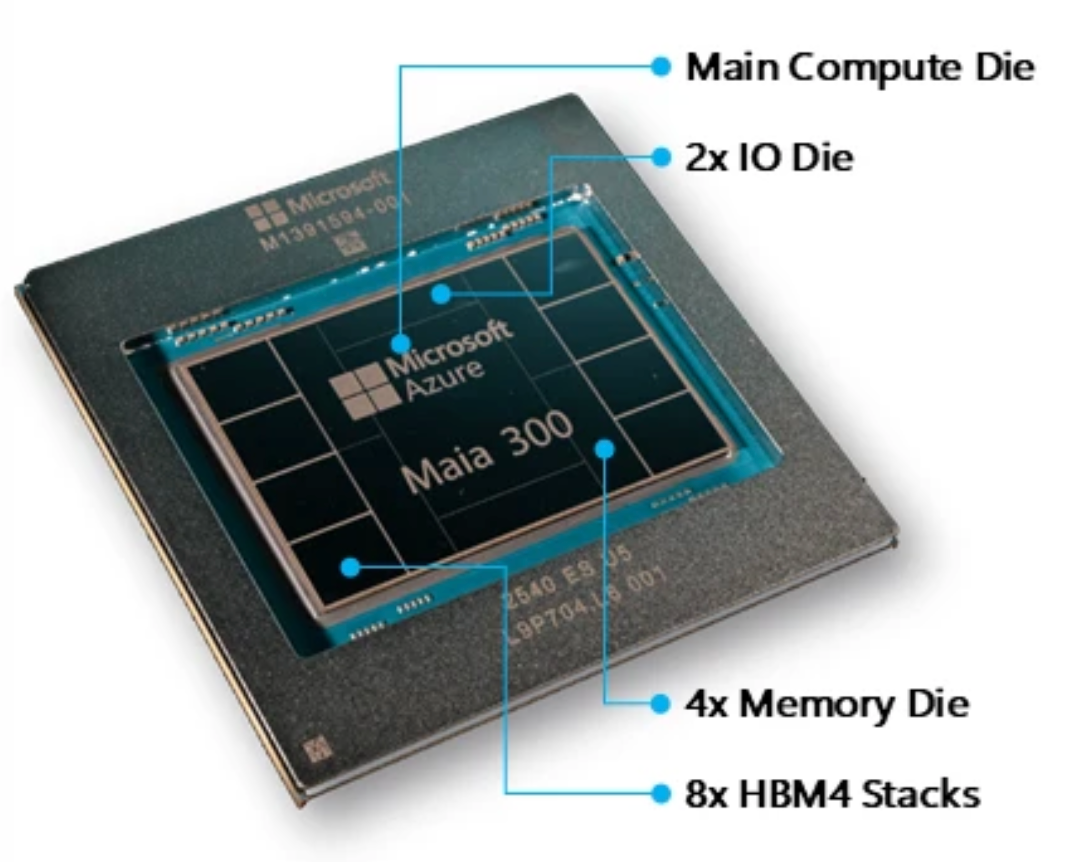
Microsoft представила ускоритель Azure Maia 300 для инференса LLM и агентских сценариев. Устройство получило 288 ГБ HBM4 с пропускной способностью 18 ТБ/с, а его энергопотребление составляет 950 Вт. Стойка вмещает 96 таких ускорителей, суперпод же объединяет до 12 288 устройств. Подробности — в статье.
Осенние мини-ПК
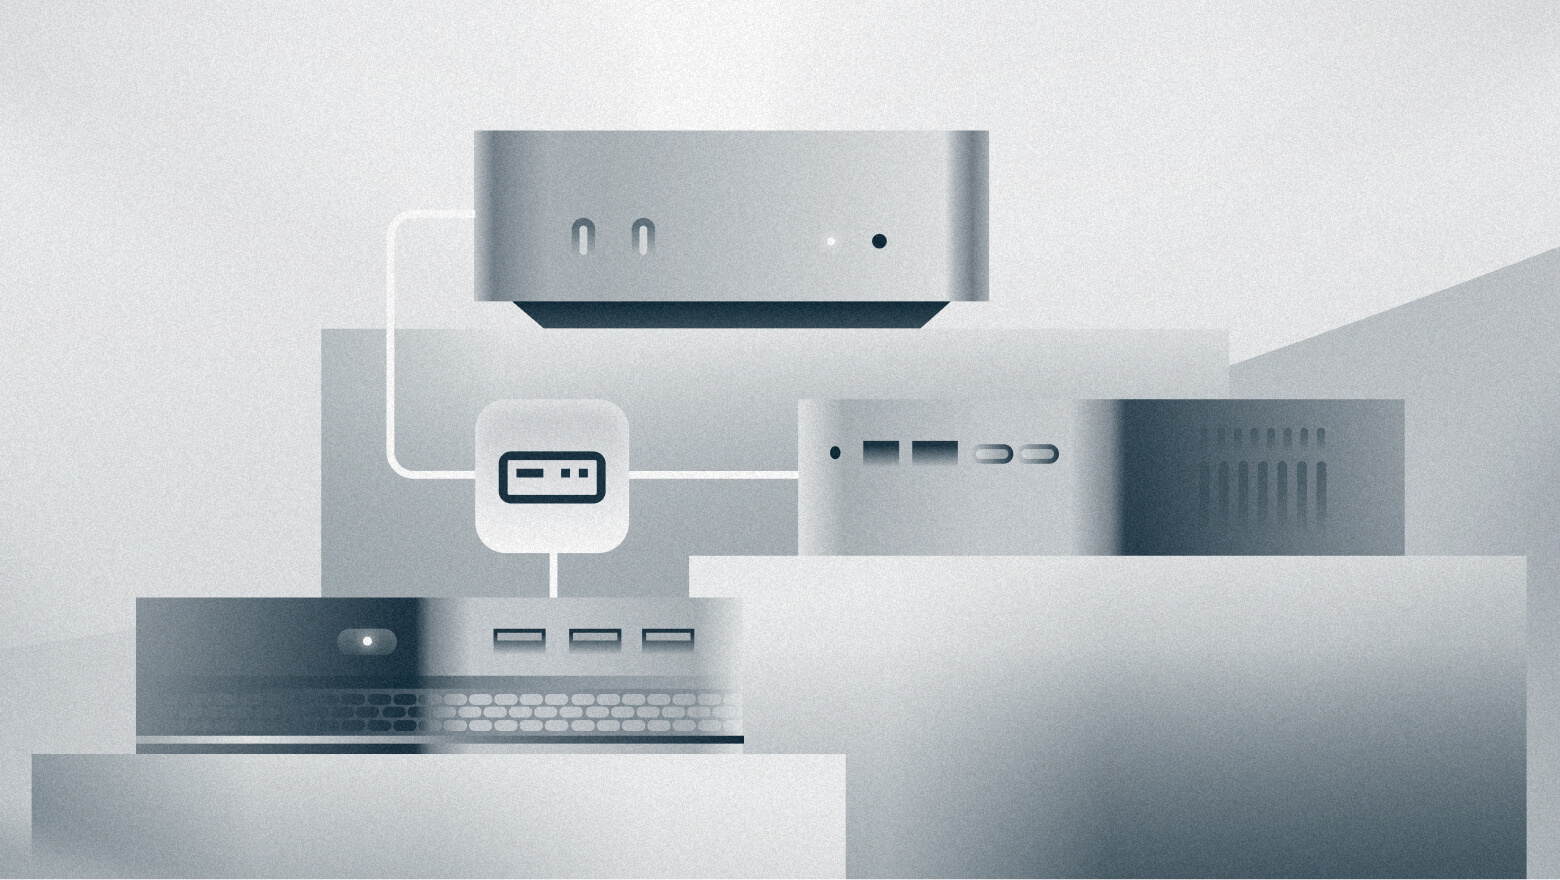
Среди осенних новинок ASUS выпустила две модели: ProArt GR1X на ARM-платформе NVIDIA RTX™ Spark с общей памятью до 128 ГБ и Ascent QN10 на Snapdragon X2 Elite. AAEON представила промышленный UP Xtreme PTL Edge Air без вентиляторов, с мембранным охлаждением Frore AirJet. В свою очередь, GMKtec EVO-X5 Pro получил 192 ГБ памяти и рассчитан на локальный запуск моделей объемом до 320 млрд параметров. Все новинки — в материале.
Другие новости
Intel GPU D270 Crescent Island — GPU c LPDDR5X
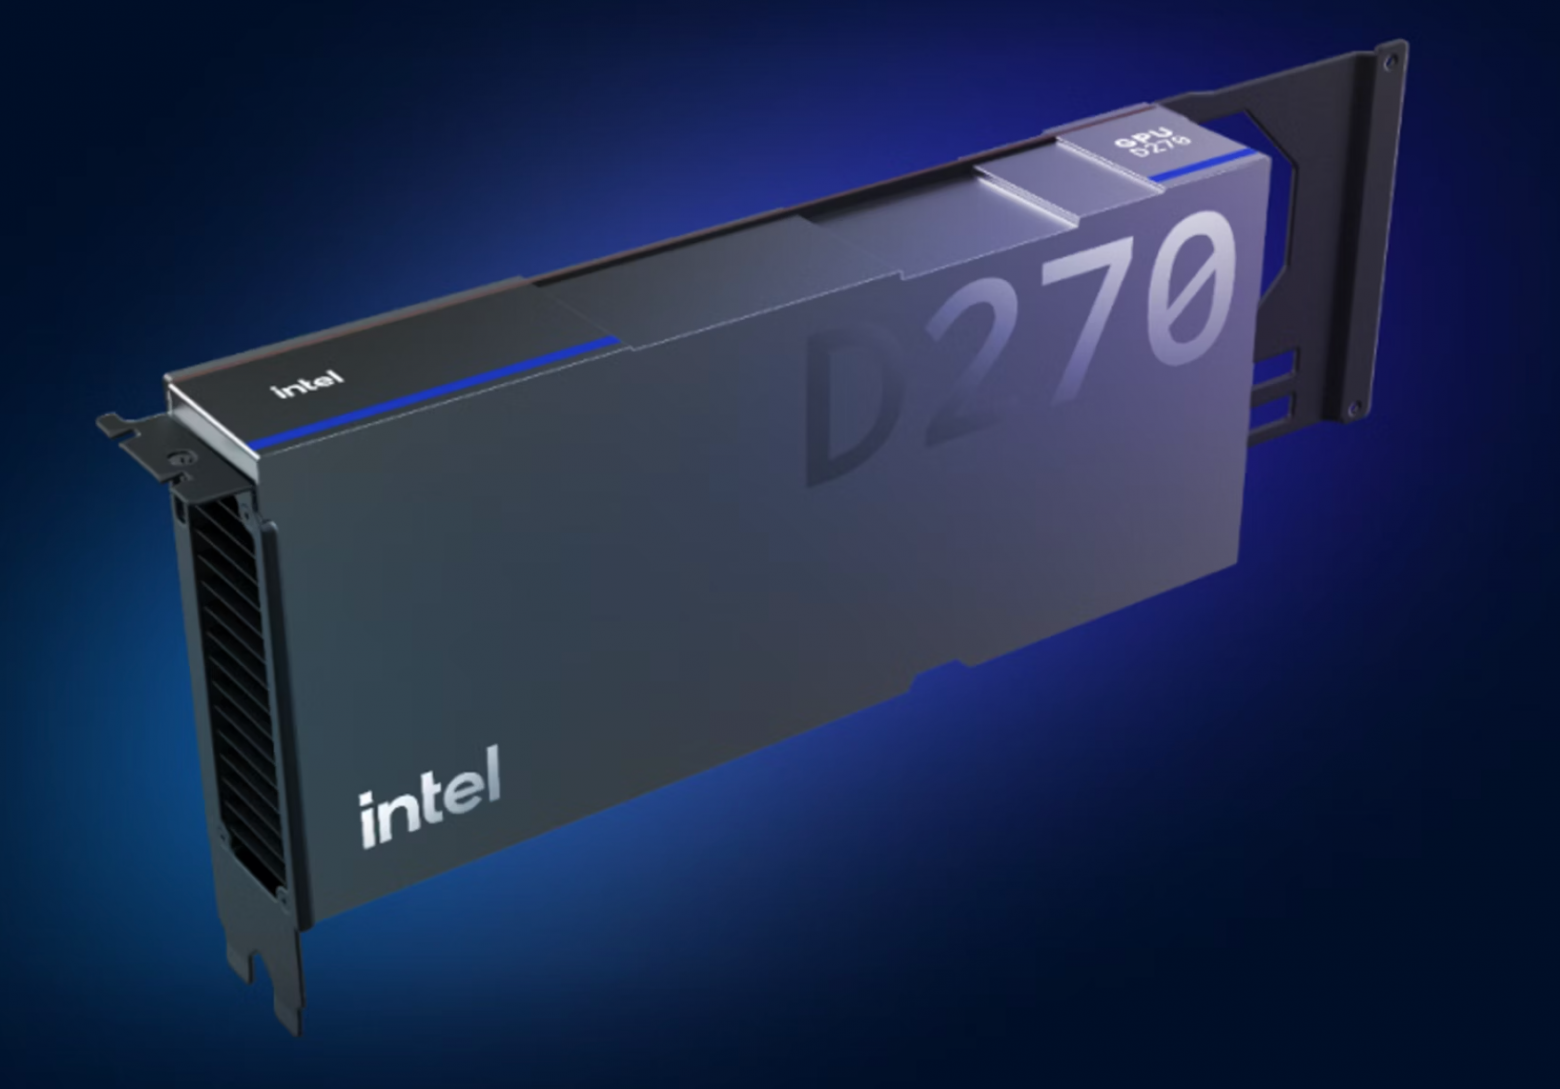
Intel дали имя и представили ускоритель Crescent Island: Intel GPU D270. Это первый продукт новой линейки D-Series.
Со времен Ponte Vecchio это первые серверные ИИ-GPU от Intel, которые реально начали поступать на рынок: инженерные образцы уже у OEM-производителей, заказчиков и западных облачных провайдеров. Напомню, что линейки Rialto Bridge и Falcon Shores так и не были доведены до коммерческих поставок.
Характеристики:
архитектура Xe3P без графических блоков: 32 ядра Xe, 256 матричных движков XMX, частота около 2,5 ГГц;
производительность: FP8 — 1,3 Пфлопс, FP64 — 10,2 Тфлопс;
память: LPDDR5X, до 480 ГБ у партнерских версий и 160 ГБ у референсной карты Intel;
карта двухслотовая, PCIe 5.0 x16;
воздушное охлаждение;
TDP 350 Вт.
Подход с использованием памяти LPDDR5X применяет ряд производителей GPU. Пока HBM в дефиците и дорожает, для инференса с длинным контекстом объем памяти оказывается нужнее ее пиковой пропускной способности.
По оценке Intel, одна карта вмещает модель на 300 млрд параметров, восемь карт — модели на триллион с лишним. Код под Arc Pro переносится без переписывания ядер, обещаны PyTorch, vLLM, SGLang и Triton. Для сравнения: у AMD Instinct™ MI450X доступно до 432 ГБ HBM4, у NVIDIA Rubin™ — 288 ГБ. Показатели сопоставимы по объему, но не по пропускной способности. Кроме того, Intel тактично обходит вопрос межкарточного взаимодействия, где узким горлышком неизбежно выступит шина PCIe.
За рекордами D270 не гонится, и Intel этого не скрывает: ставка сделана на большой объем медленной памяти и на обычные стойки с воздухом. Ниша реальная, вопрос в том, успеют ли софт и поставки за гонкой производителей.
Altera Agilex 2X — FPGA для ИИ и роботов
Altera анонсировали новое поколение FPGA Agilex 2X, флагманом которого стало семейство Agilex 27. Целевые рынки: ИИ-инфраструктура, терабитный Ethernet, 6G и аэрокосмическая отрасль.
Новое в архитектуре — отдельная внутрикристальная сеть HyperFlow: она гоняет данные между блоками на нескольких терабитах в секунду и не тратит на это программируемую логику. Регистры HyperFlex третьего поколения «разбросаны» по всей трассировке, и Quartus конвейеризует дизайн, не занимая ресурсы.
По безопасности полный комплект: постквантовая криптография, MACsec, IDE для PCIe и шифрование памяти «на лету».
В состав Agilex 27 входят:
трансиверы со скоростью передачи до 256 Гбит/с,
аппаратные контроллеры 800GbE и 1,6TbE,
PCIe 6.0 и 7.0,
UCIe для чиплетов,
контроллеры DDR5, LPDDR5X и LPDDR6.
Ниже флагмана стоят Agilex 25 для видео, Agilex 23 с SoC для промавтоматики, роботов и сенсоров и Agilex 22 без процессорной части для систем с большим числом портов ввода-вывода. Все устройства поддерживают среду проектирования Quartus Prime с ИИ-помощником QuartusIQ.
Главный минус: инженерные образцы Agilex 27 появятся на рынке только во второй половине 2027 года. Однако до этого времени проектировать устройства возможно в симуляторе.
Iluvatar CoreX Tiangai 300 — конкуренция с NVIDIA H200
Шанхайский Iluvatar CoreX на презентации для китайских СМИ заявил, что его новый GPU Tiangai 300 работает на уровне NVIDIA® H200, а в ряде специфических задач даже обгоняет его.
На генерации изображений по текстовому описанию китайский чип выдал 0,101 картинки в секунду при 100% успешных задач, в то время как H200 — 0,086 картинки с результатом в 87,5% успешных генераций. Государственная компания INESA еще в июле зафиксировала преимущество Tiangai 300 по пропускной способности на уровне 1,05 относительно H200 в «типичном развертывании». На MoE-модели новинка показала плюс 15% к пропускной способности и до 30% меньшие задержки первого токена на длинных текстах. В дообучении Qwen3-32B чип сравнивали уже с H100 и получили коэффициент 1,33.
Сам Tiangai 300 показали еще летом на WAIC 2026, а в январе компания опубликовала дорожную карту с целью обойти Rubin™ к 2027 году. Для понимания масштаба: по данным TrendForce, в 2024 году у Iluvatar было около 0,3% китайского рынка GPGPU.
Стоит учитывать, что все цифры заявлены самой компанией и связанными с государственными лабораториями. Сравнение с H200, чипом 2023 года, удобно для отчетов. С одной стороны, это демонстрирует существующий отрыв от мировых лидеров, а с другой — в Китае целый ряд производителей уже взяли эту планку (например, Huawei или Zhenwu). Развертывания на десятки тысяч ускорителей уже идут, а мы ждем более конкурентный рынок GPU и возможность для выбора.
AMD Helion — стойка на CPU для агентного ИИ
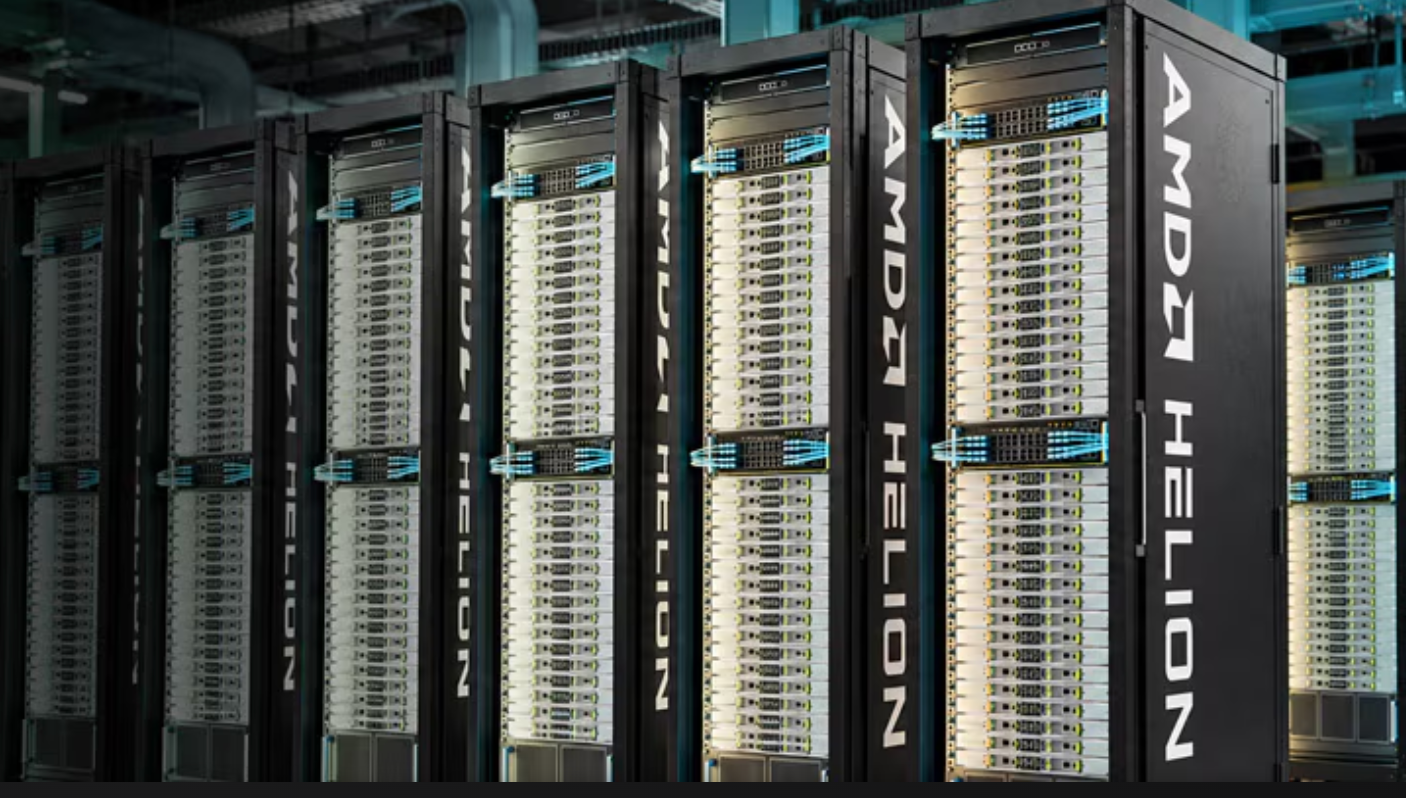
AMD выпустила эталонный проект Helion™. Это стойка ORv3 высотой 44OU под агентный ИИ. Если Helios™ с 72 GPU отвечает за модели, то Helion — за все вокруг них: вызовы инструментов, исполнение кода, оркестрацию. Это работа для CPU.
Предусмотрено два варианта реализации платформы.
Для гиперскейлеров: стойка только на EPYC™ Venice 9006 (суммарно до 32 768 ядер), которая подключается к отдельной инфраструктуре инференса.
Для корпоративных заказчиков — все в одном шкафу: узлы EPYC™, до 16 GPU AMD Instinct™ MI350P, интерконнект до 102,4 Тбит/с и вычисления общего назначения.
Есть версии с жидкостным и воздушным охлаждением.
В конце 2026 года стартуют поставки конфигураций от OEM-партнеров, среди которых заявлены Dell, HPE, Supermicro, Foxconn, Wiwynn и другие.
На рынке происходит заметный сдвиг. Ранее стоечные ИИ-продукты строились вокруг GPU, а теперь CPU-стойка стала самостоятельной единицей. Плотность в 32 000 ядер в шкафу впечатляет, но пока это референс, серийных систем и цен еще нет.
Арендуйте сервер с доставкой на вашу площадку
Предоставим мощные серверы для запуска проекта on-premise с помесячной оплатой, полным контролем над железом на этапе запуска и возможностью выкупа.
NVIDIA MGX 1.2 — в один день с AMD Helion
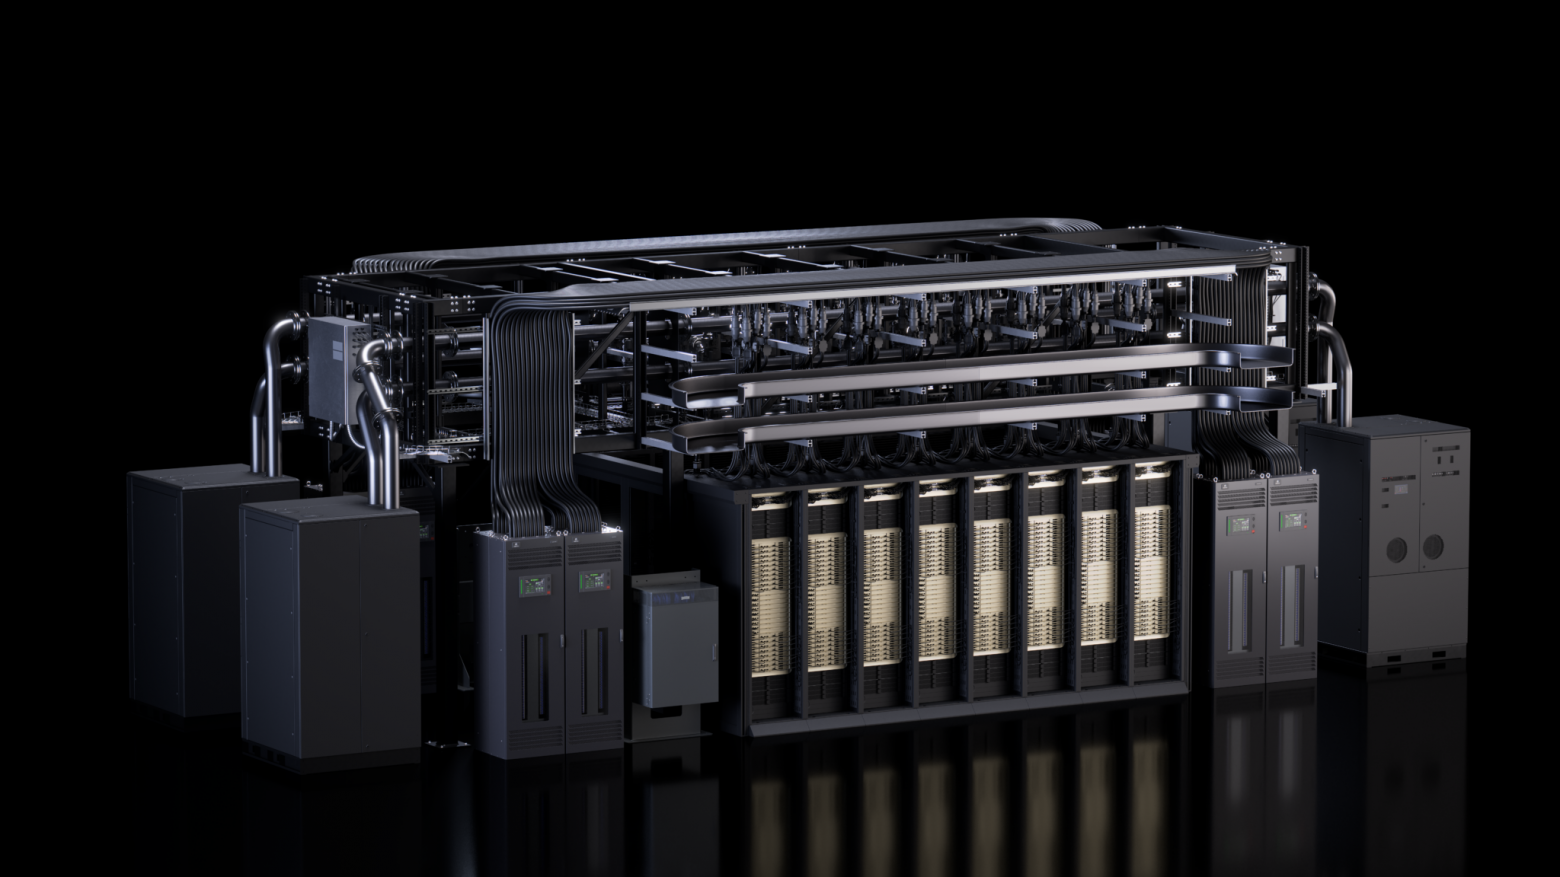
NVIDIA передала в OCP спецификации стоек и узлов Vera Rubin™ в рамках MGX и вошла в Open DC Initiative, где готовят референс ИИ-ЦОД третьего поколения.
В обновленные спецификации MGX1.2 добавлены СЖО с соединениями типа blind-mate, стандартизированная стоечная инфраструктура интерконнекта и DC-шина на 5 000 А с жидкостным охлаждением. Кроме того, появились поддержка 19-дюймового оборудования и стоек повышенной плотности, конфигурируемые IO-модули, безвентиляторные узлы на СЖО и единые интерфейсы питания и охлаждения. Потолок — 250 кВт на стойку.
Отдельно описана стойка на CPU Vera™: Vera Rubin™ NVL72 занимается обучением и инференсом, а CPU-стойка берет на себя работу с внешними инструментами, оркестрацию и песочницы. Ровно та же идея, что у AMD Helion™, причем анонсы состоялись в один и тот же день. Неоднозначное совпадение.
Открытый MGX выгоден и самой NVIDIA: чем больше вендоров строит совместимые стойки, тем шире рынок для ее чипов.
Astera Labs Orion — стойка для любых ускорителей
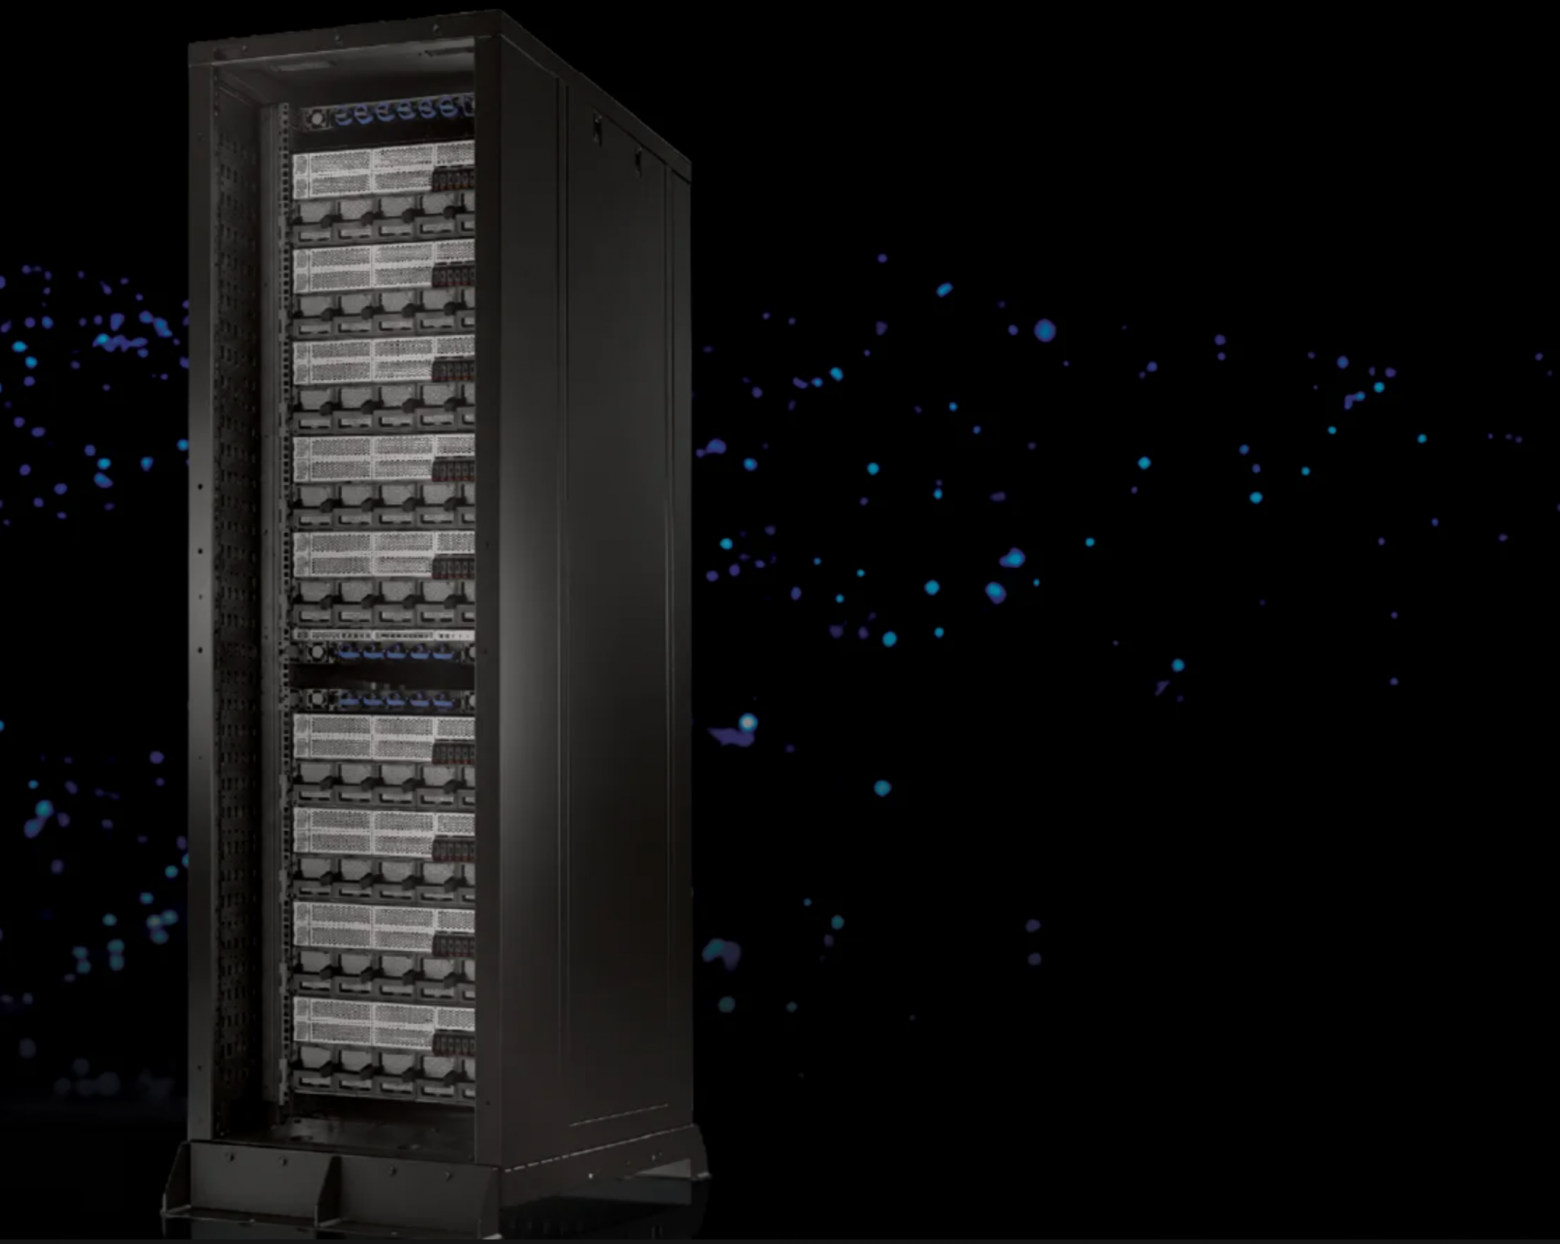
Astera Labs показали эталонную стойку Orion, куда можно ставить любые PCIe-ускорители без привязки к проприетарным платформам NVIDIA или AMD. «Неооблака» часто не могут достать топовые GPU, а разрабатывать свою стоечную платформу долго и дорого.
В основе этой архитектуры лежат 320-линейные коммутаторы Scorpio X-Series на PCIe 6.0. Двухуровневая топология дает до 80 ускорителей в стойке и до 160 в поде, все в одном PCIe-домене без перехода на Ethernet или InfiniBand. В набор входят шесть референсов: стойка, вычислительный лоток на восемь карт, лоток коммутации, модуль расширения памяти с CXL-контроллерами Leo, соединительная и вычислительная платы. Управляют всем COSMOS Rack Manager и Fabric Manager.
Поставки через OEM и ODM стартуют с первого квартала 2027 года. Сама Astera ускорители не выпускает, зато продает почти все остальное в стойке: коммутаторы, ретаймеры, CXL и софт.
SpacemiT Vital Stone V100 — серверный RISC-V процессор
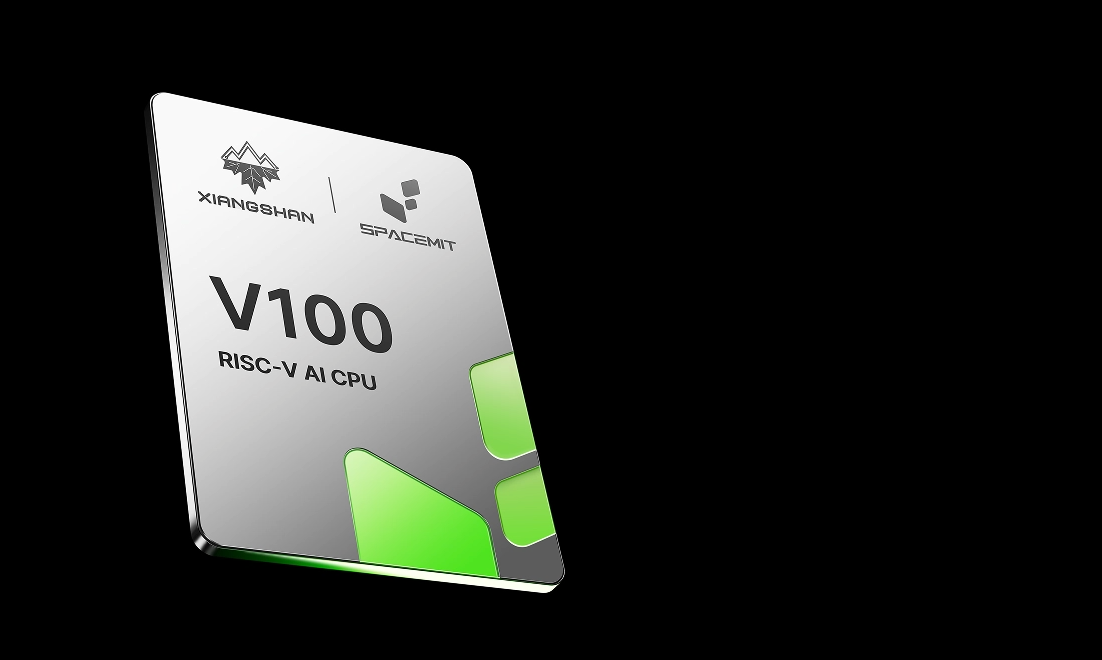
Китайская SpacemiT выпустила серверный RISC-V-процессор Vital Stone V100. Разработчики позиционируют его как первый в индустрии чип, полностью соответствующий серверной спецификации RISC-V: он поддерживает UEFI, ACPI, SMBIOS и профиль RVA23.
Характеристики:
46 ядер суммарно: 40 собственных X100 с частотой до 2,4 ГГц и 2 МБ L2-кэша, а также 6 ядер Xiangshan Kunming Lake V2R2 с частотой до 2,1 ГГц и 1 МБ L2-кэша;
память: восемь каналов DDR5-4800;
52 линии PCIe 5.0;
TDP 120 Вт;
техпроцесс 12 нм, корпус FCBGA 58,5 × 75,4 мм;
есть двухсокетный режим, суммарно 92 ядра;
аппаратно ускорены AES, SHA, RSA и китайские SM2, SM3, SM4.
Любопытно сравнить с первоначальными планами. В январе 2025 года V100 анонсировали как процессор, несущий «до 64 ядер X100» на 2,5 ГГц. Однако в серийной версии ядер меньше, причем часть из них другой архитектуры. С Xeon® и EPYC™ сравнивать нечего, даже ARM-серверы далеко впереди. Зато из коробки работают openEuler, openKylin, Ubuntu, Debian и Fedora, портированы KVM, QEMU, Docker, MySQL и PostgreSQL. Для развития RISC-V и рядовых задач этого хватит. А вот «обучение ИИ-моделей» из пресс-релиза выглядит смело, здесь максимум возможно подавать данные ускорителям.
Kioxia GP1 — SSD на XL-Flash третьего поколения
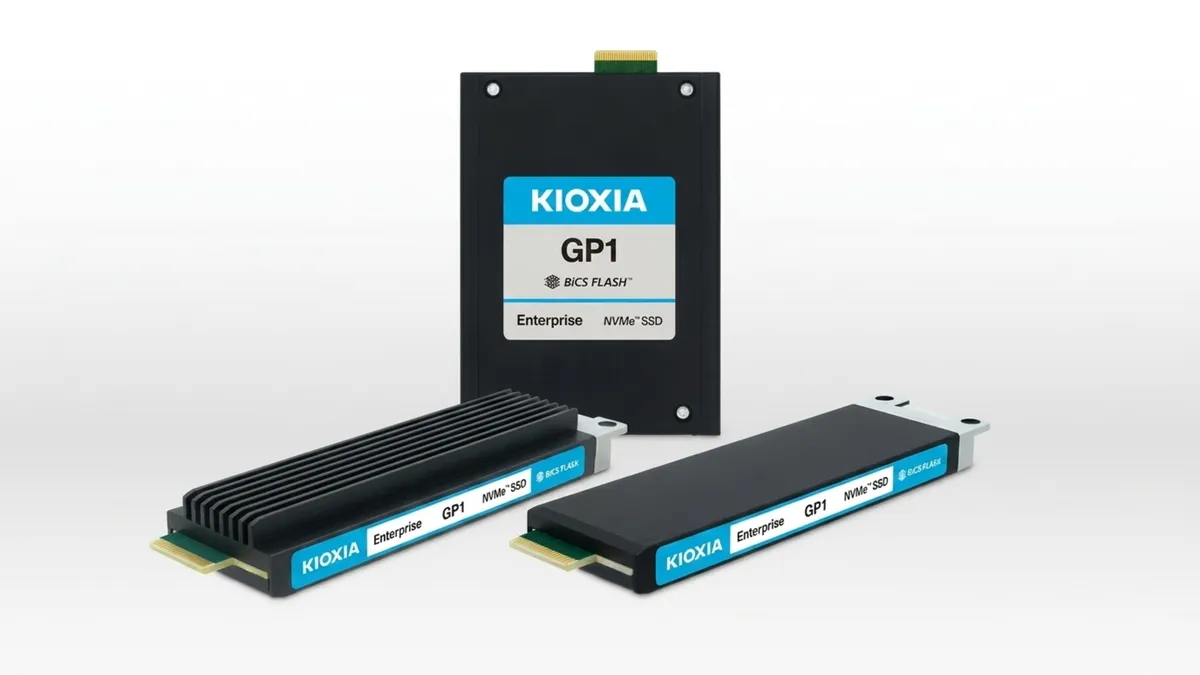
Kioxia заявляет, что побила собственный августовский рекорд. Представлен обновленный SSD GP1 на XL-Flash третьего поколения, модель выдает больше 20 млн IOPS на случайном чтении блоками по 512 байт. Это вдвое больше, чем показатель в 10 млн IOPS, который демонстрировал накопитель первого поколения.
Память XL-Flash Gen3 читает втрое и пишет примерно в 2,5 раза быстрее предшественника. Словарные и битовые шины укоротили, чтобы снизить RC-задержку, а также добавили плоскостей на кристалл (у Gen2 их 16). Заявленная эффективность на операцию выросла на 40% при чтении и на 80% при записи.
Характеристики:
интерфейс остался прежний: PCIe 6.0 и NVMe 2.2;
форматы E3.S и E1.S;
у первых GP1 MLC-ячейки работают в режиме pSLC;
ресурс до 50 DWPD.
Остальные характеристики новой версии не раскрыты, так что пока это скорее техническая демонстрация.
Устройства линейки GP1 занимают промежуточный слой между HBM и обычными SSD. Фактически этот продукт можно назвать наследником накопителей Optane. В дорожной карте Kioxia уже стоят 100 млн IOPS на PCIe 7.0. Достойное продолжение закрытого направления у Intel.
Kioxia CM9-DLC — SSD на водяном охлаждении
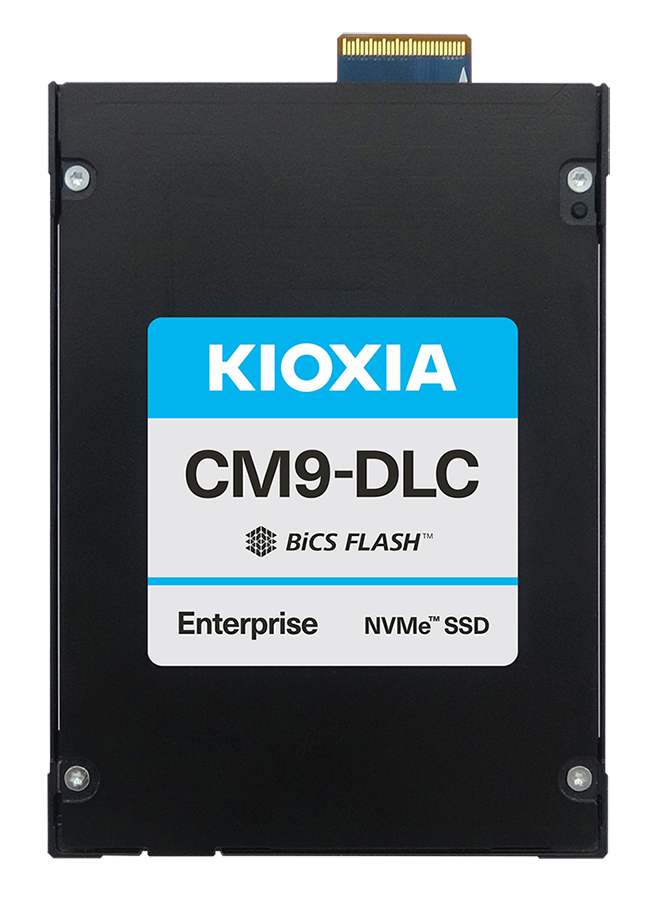
Еще одна новинка от Kioxia: серия CM9-DLC. Накопители E3.S с прямым жидкостным охлаждением для кэширования контекста в ИИ-серверах.
Характеристики:
версии для смешанной нагрузки: 6,4, 12,8 и 25,6 ТБ с ресурсом 3 DWPD;
версии под чтение: 7,68, 15,36 и 30,72 ТБ и показателем 1 DWPD;
двухпортовые, память BiCS FLASH TLC восьмого поколения;
PCIe 5.0 и NVMe 2.0;
последовательное чтение — до 14 800 МБ/с, запись — до 11 000 МБ/с, случайное чтение 4K — до 3,4 млн IOPS.
В CM9-DLC есть PLP, мгновенное стирание и сквозное шифрование. Диски можно применять и в серверах с воздушным охлаждением, но основное применение они найдут в серверах с СЖО. Когда весь сервер стоит на воде, SSD с обдувом остается последним горячим компонентом — теперь их тоже подключили к контуру.
SP Industrial — SSD на eTLC
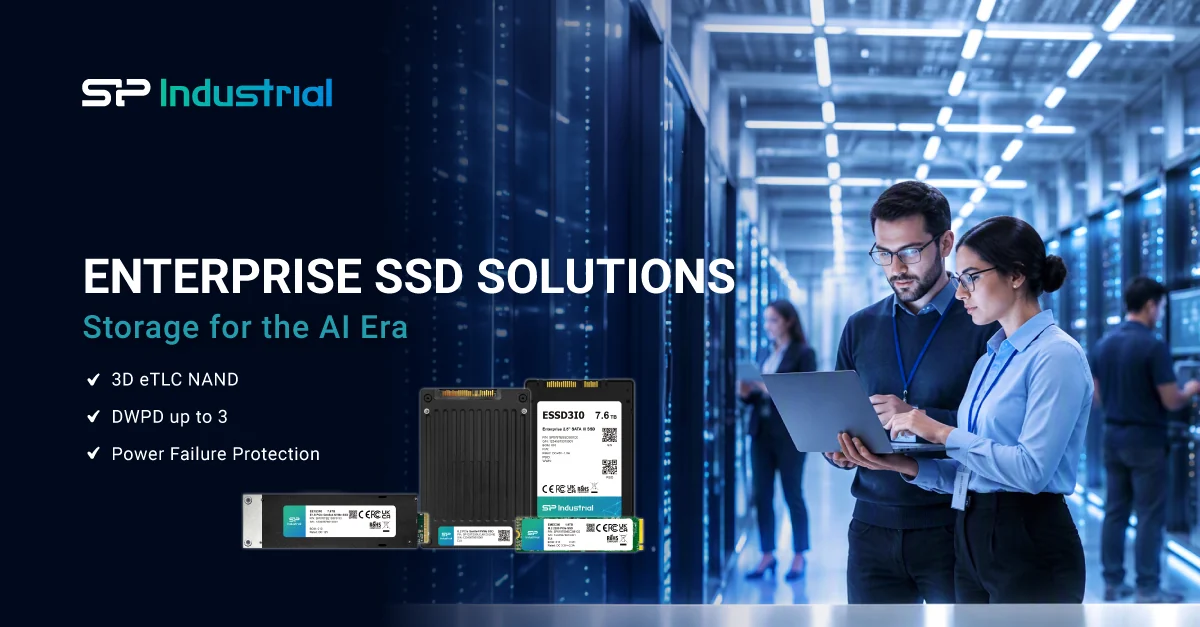
Промышленное подразделение Silicon Power выпустило шесть корпоративных SSD на 3D eTLC с DRAM-буфером и защитой от сбоев питания. В новой модели произошел переход на PCIe 5.0 в форматах E1.S и U.2. В прошлых поколениях U.2 были максимум на PCIe 4.0.
Состав анонсированной линейки:
форм-фактор E1.S (EE1S3F0): емкость до 7,6 ТБ, реализована аппаратная поддержка пространств имен;
форм-фактор U.2 (ESSU3J0, ESSU3F0, ESSU3I0): модели объемом до 15,3 ТБ;
Загрузочные M.2 2280 (EMEC3I0): емкость от 480 ГБ до 1,9 ТБ на PCIe 4.0;
SATA SFF объемом до 7,6 ТБ.
Заявлен ресурс 1 или 3 DWPD. Полных характеристик нет, но для edge-серверов и сетевого оборудования линейка выглядит подходящей.
Marvell Structera X 3406 и 3506 — CXL-расширители памяти
Marvell выпустили второе поколение CXL-расширителей памяти. Названия читаются как шифр: первая цифра — поколение CXL, вторая — тип DDR, последние две — число каналов. Например, 3406: CXL 3, DDR4, шесть каналов.
Характеристики:
модель 3406 поддерживает 18 модулей DDR4 RDIMM на 1 600 МТ/с (по три модуля на канал), обеспечивая суммарный объем пула до 9 ТБ;
модель 3506 поддерживает 12 модулей DDR5 RDIMM, до 6 ТБ;
оба чипа работают по CXL 3.2 через PCIe 6.0 x16;
шесть каналов вместо четырех у моделей 2404 и 2504 предыдущего поколения;
один контроллер обслуживает до четырех хостов с суммарной полосой до 256 ГБ/с.
Блок сжатия LZ4 дает 250 ГБ/с, впятеро больше прежнего, и, по заявлениям Marvell, увеличивает эффективный объем в 2–3 раза. Для LLM обещают TTFT на 40–50% меньше при той же длине контекста. Есть RAS StructGuard, Caliptra 2.0, шифрование канала CXL, AES-256 для памяти и постквантовая защита.
Из-за сочетания характеристик Marvell называет свои решения первыми такими CXL-расширителями. Образцы обещаны в первом квартале 2027 года. Любопытно, что представлена версия под DDR4. На рынке все еще много серверов с таким типом памяти, и Marvell предлагает превратить это в общий пул под KV-кэш. Таким образом, технология помогает сэкономить, а не потратить.
Samsung и AMD — CXL-пул DRAM — 1
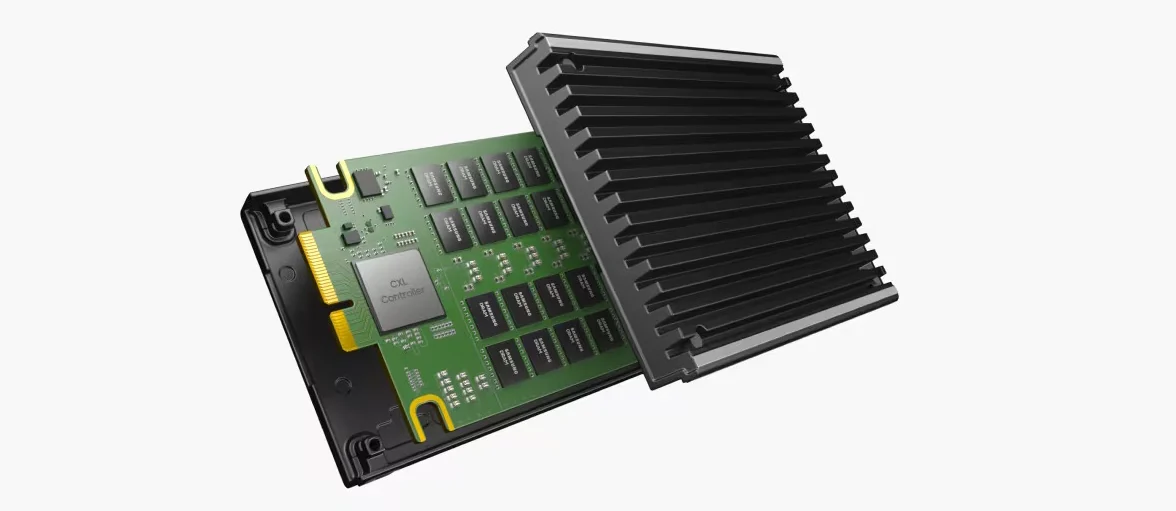
Samsung и AMD показали пул памяти на модулях CMM-D для агентного инференса. Работает он на механизме CXL Dynamic Capacity Device: память выдается хосту по запросу и возвращается обратно. Если у одного экземпляра LLM разросся контекст, он временно берет емкость из пула, а потом отдает.
По данным Samsung, внедрение этой технологии позволяет сократить TTFT до 38%, в то время как показатель полезной пропускной способности (goodput) увеличивается до 3,3 раз по сравнению со статическим распределением. Технология решает проблему простоев CPU, когда объем и полоса памяти не успевают за числом ядер.
Тестирование проводили на платформе AMD. Конфигурацию серверов, топологию CXL-коммутаторов, задержки и сроки выхода не раскрыли, так что это пока демонстрация, а не продукт.
Astera Labs Leo — CXL-пул DRAM — 2
Под тот же сценарий Astera Labs выпустила контроллеры Leo X-Series: они подключают память прямо к сетевому слою GPU-ускорителей, минуя CPU, и берут на себя KV-кэш и контекст агентов. Leo 2 E-Series (CXL 3.2, PCIe 6.0) расширяют память одного процессора без лишних сокетов, Leo 2 P-Series собирают из нее пул на несколько хостов.
За один месяц CXL-пулы показали несколько компаний: похоже, тема созрела.
Контроллеры Microchip: Switchtec PCIe 6.0, Flashtec 5016 и SmartRAID 4300
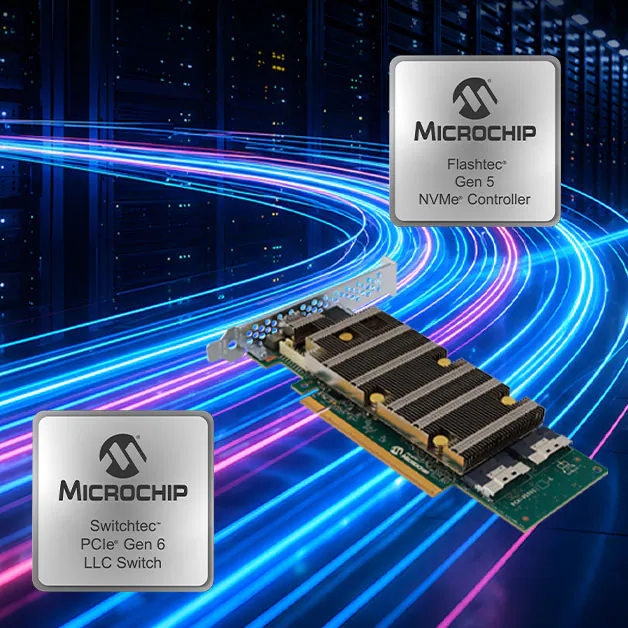
Microchip выпустила сразу три продукта.
Коммутатор Switchtec PCIe 6.0 в компактном исполнении:
64 линии и 32 порта с бифуркацией от x2 до x16,
интегрированный DMA и поддержка Multicast,
аппаратный RoT и Secure Boot.
SSD-контроллер Flashtec 5016 на PCIe 5.0:
16 каналов NAND,
до четырех рангов DDR5-5200,
FDP и ZNS,
CNSA 2.0,
два порта,
до 3,5 млн IOPS на случайном чтении 4K и больше 14 ГБ/с.
Самый интересный продукт из тройки — обновленный SmartRAID 4300. Он считает RAID для NVMe-дисков, подключенных напрямую к CPU, поэтому общая скорость не упирается в его собственный PCIe 4.0 x16. По характеристикам:
обслуживание до 32 накопителей и поддержка 64 логических томов;
RAID 0/1/10/5/50/6/60;
в Linux на RAID 0 карта демонстрирует до 27,2 млн IOPS на чтении и до 300 ГБ/с на последовательном чтении.
Пересборка идет по схеме P2P между SSD, без участия процессора. Низкопрофильная HHHL-карта на 21 Вт против программного RAID, который съедает часть ядер, — хороший аргумент для тех, кто считает стоимость ядра.
NVIDIA и Cisco: формат USFP
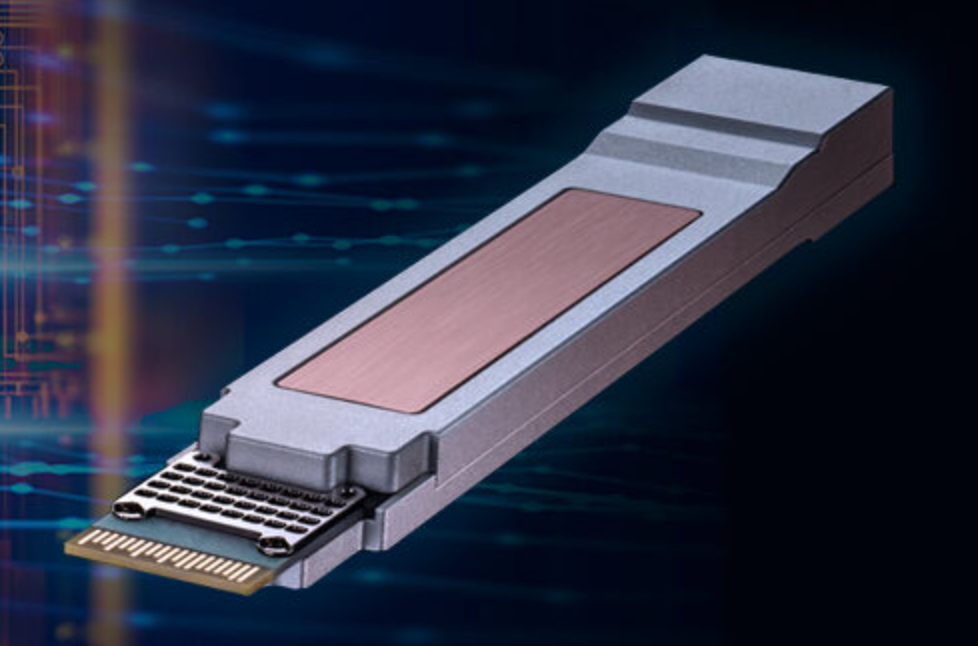
NVIDIA и Cisco предложили новый форм-фактор съемных оптических трансиверов — USFP (Ultra-Dense Small Form Factor Pluggable), рассчитанный на 400 Гбит/с на электрическую линию. Первые модули получат 16 полнодуплексных линий, то есть 6,4 Тбит/с в корпусе размером с OSFP. Дальше в роадмапе уже значится удвоение показателей — 32 линии и 12,8 Тбит/с.
Плотность полосы на передней панели вчетверо выше, чем у нынешних модулей на 200 Гбит/с на линию, а энергоэффективность примерно в 1,3 раза лучше. При этом один модуль рассеивает до 100 Вт без собственного контура охлаждения. Разъем с двумерной матрицей контактов подключается в два этапа: сначала фиксируется корпус, потом высокоскоростные контакты. Меньше износ, чище сигнал.
Корпуса и разъемы делают TE Connectivity и Amphenol, спецификацию обещают открыть через MSA. Нюанс: Arista в USFP не участвует. Вместо этого они продвигают собственный формат XPO, в котором нет NVIDIA и Cisco. Возможно, на линиях 400G нас ждет очередная война форм-факторов. Сроков и цен пока нет.
Celestica DS6005 и Micas Networks — Tomahawk 6 в железе
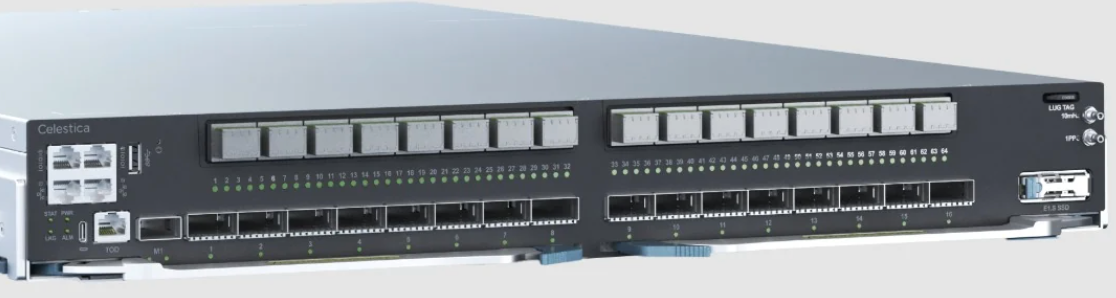
Broadcom Tomahawk 6 на 102,4 Тбит/с добрался до готовых изделий. Представлен Celestica DS6005 — CPO-коммутатор высотой 1.5OU для ORv3 на Tomahawk 6 Davisson:
64 порта по 1,6 Тбит/с через 16 разъемов MMC-16;
16 сменных лазерных модулей ELSFP на передней панели;
полностью жидкостное охлаждение;
AMD Ryzen™ в роли управляющего процессора и SONiC в роли ОС.
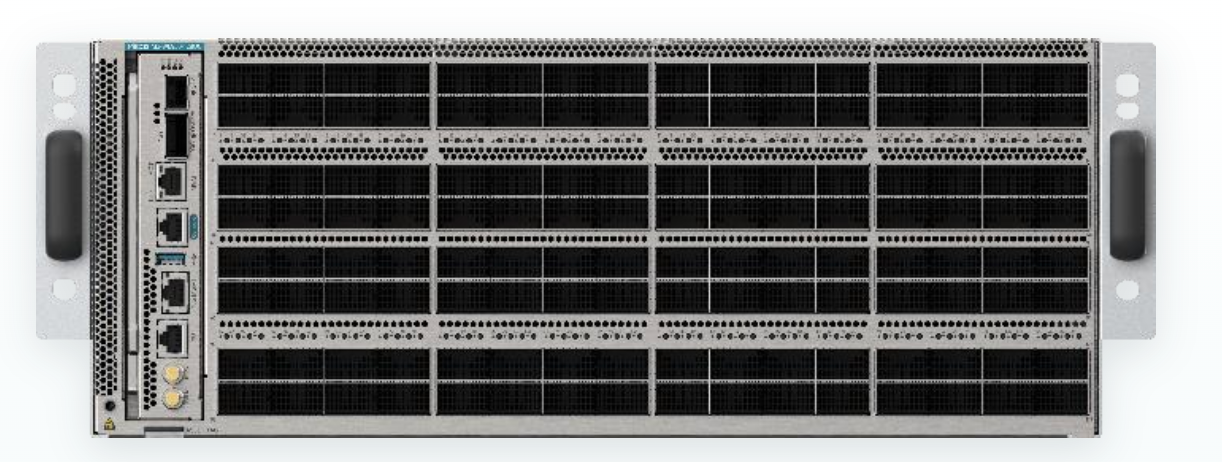
В свою очередь, компания Micas Networks показала сразу три модели.
M2-W6950-128OC-FA: решение в форм-факторе 4U, воздушное охлаждение, 128 портов OSFP по 800 Гбит/с. Производство стартует в текущем квартале.
M2-W6951-64HC-CP: высокоплотный коммутатор высотой 2U на СЖО, 64 порта по 1,6 Тбит/с. Старт серийного производства намечен на конец 2026 года.
CPO-версия в корпусе 1U на базе Davisson с 64 оптическими портами MMC DR8 — с первого квартала 2027 года.
Хорошо видно, как одна и та же полоса 102,4 Тбит/с ужимается: 4U — на воздухе, 2U — на воде, 1U — с CPO. Вынесенные наружу лазеры ELSFP как ответ на главный страх перед CPO: если лазер умрет, коммутатор целиком менять не придется.

Собственный сервер Selectel
В основе — самые современные процессоры Intel® Xeon® 6, до 8 ТБ DDR5 и специально разработанная материнская плата. Арендуйте сервер у нас или закажите в свой дата‑центр.
Frore LiquidJet Diamond — охлаждение с алмазами
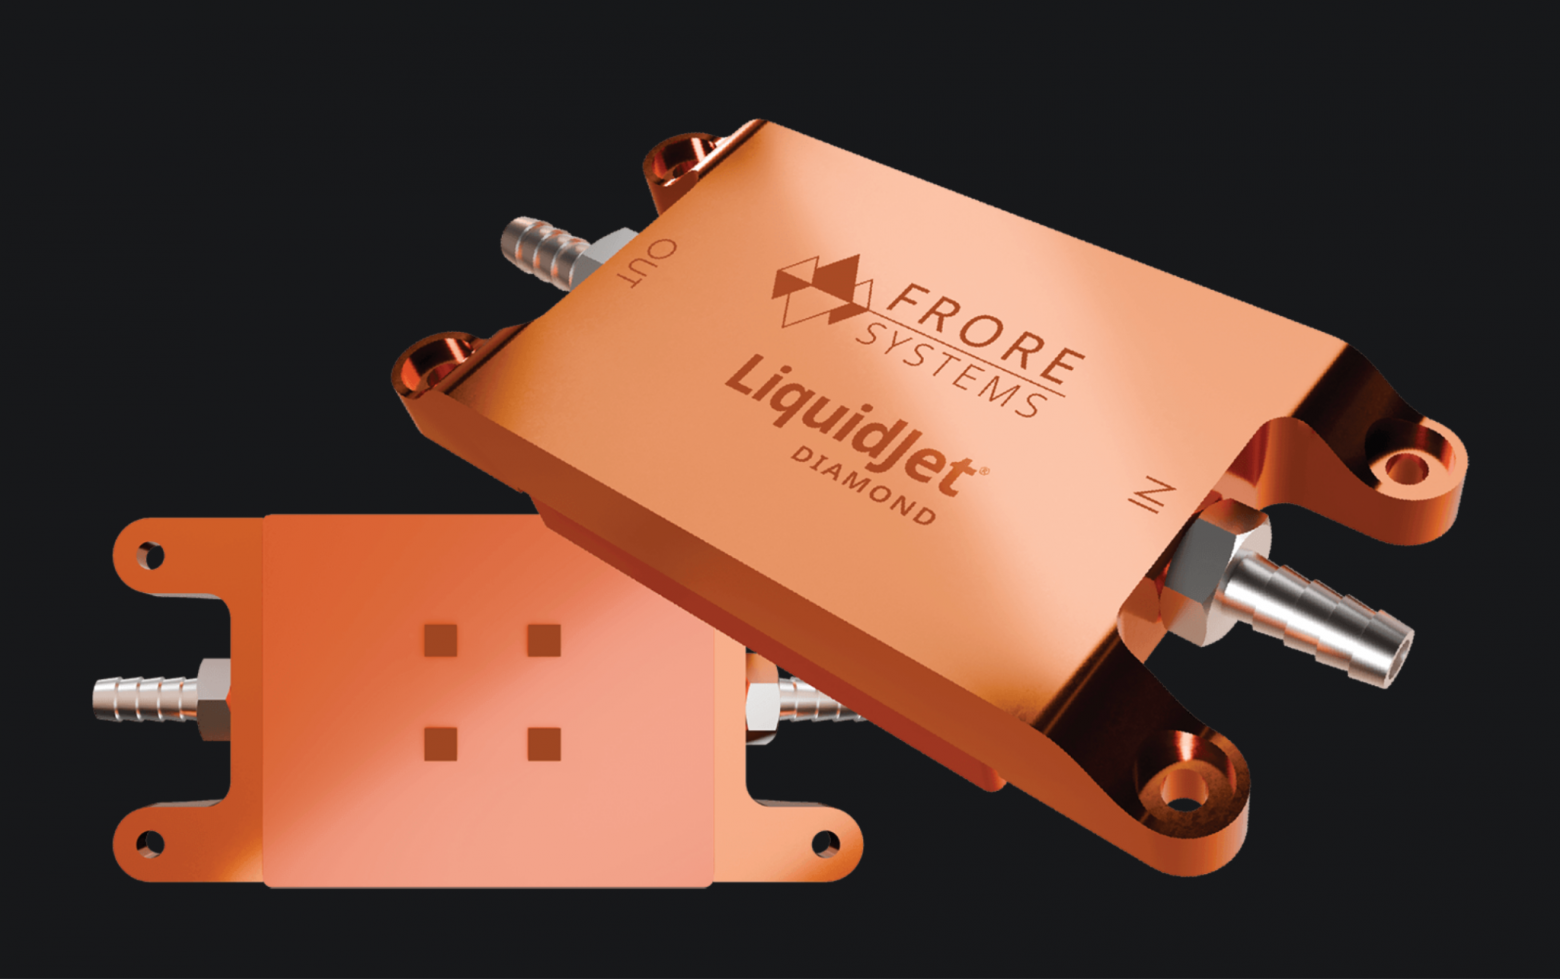
Frore Systems представила технологию LiquidJet Diamond, интегрировав синтетические алмазы непосредственно в структуру водоблока. Это заказная пластина под конкретный GPU со встроенным теплораспределителем, где алмазные вставки стоят точно над горячими точками кристалла.
Основа — архитектура LiquidJet с трехмерным многоступенчатым ультракоротким контуром: каналы сначала ведут жидкость на хотспоты, а потом на кристалл и HBM. Исходная версия снижала температуру GPU на 12 °C относительно обычных пластин с ребрами, а алмаз дает еще до 10°C на горячих точках. В сумме — минус 16–22°C.
Пластина держит хотспот 5 × 5 мм с плотностью 770 Вт/см², но с оговорками: температура воды на входе в контур составляла 25°C, Tj — до 95°C, термоинтерфейс PTM7950 и кристалл без крышки. На OCP Frore показывала охлаждение конфигурации NVIDIA® Rubin™ на 2 300 Вт.
Обещанные плюс 30–35% токенов на ватт — расчет по термомоделям, а не замер энергопотребления ЦОД. В источниках не уточняется, как Frore производит и крепит алмазные пластины, хотя от этого зависят цена и выход годных устройств. Сама идея оптимальная: дорогой материал только там, где без него никак.
Заключение
Подводя итоги октября, стоит зафиксировать несколько моментов. Во-первых, индустрия нашла временный способ обойти дефицит дорогой HBM: Intel® D270 берет до 480 ГБ более доступной LPDDR5X вместо дефицитной HBM. Во-вторых, AMD и NVIDIA синхронно, в один день, показали отдельные CPU-стойки для агентного ИИ. Большая часть новинок доберется до серийного железа только в 2027 году, тогда и проверим обещания производителей.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.