Как перестать жечь токены в Claude Code при работе с Figma MCP — инструкция для дизайнеров
Полтора месяца мы собирали экраны в чужой дизайн-системе «руками» ИИ-агента — такая задача свыше. С самого начала Claude ходил в макет за каждой мелочью и расходовал огромное количество токенов буквально в пустоту. Это оказалось самой дорогой частью работы.
Привет! Я Максим Григорьев, UX/UI-дизайнер в Далее. В этой статье расскажу, как мы умерили аппетит Claude, перенеся 473 переменные и 60 компонентов в markdown, и на чем споткнулись дважды, чиня экономику.
Как мы поняли, на что тратим токены впустую
Дизайн-систему ведет отдельная команда, у нас к файлу просмотровый доступ, и менять там нельзя ничего. К макетам Claude ходил через MCP-сервер Figma, то есть прямо из чата читал файл, к которому у нас был доступ.
В первые сессии агент собирал блок, доходил до поля ввода и останавливался. Ему было непонятно, какой компонент брать. Дальше — запрос в макет, ожидание, ответ. Потом то же самое на кнопке, на бейдже, на отступе между ними.
Каждый такой поход стоит не только времени. Это еще и вызов, который может не вернуться, так как на тяжелых чтениях транспорт рвется и часть сессии уходит в никуда.
Мне кажется, здесь и прячется главное непонимание про расход токенов. Обычно экономию ищут в длине промта, но по факту все тратится не на промт, а на количество обращений к источнику.
Как нашли решение
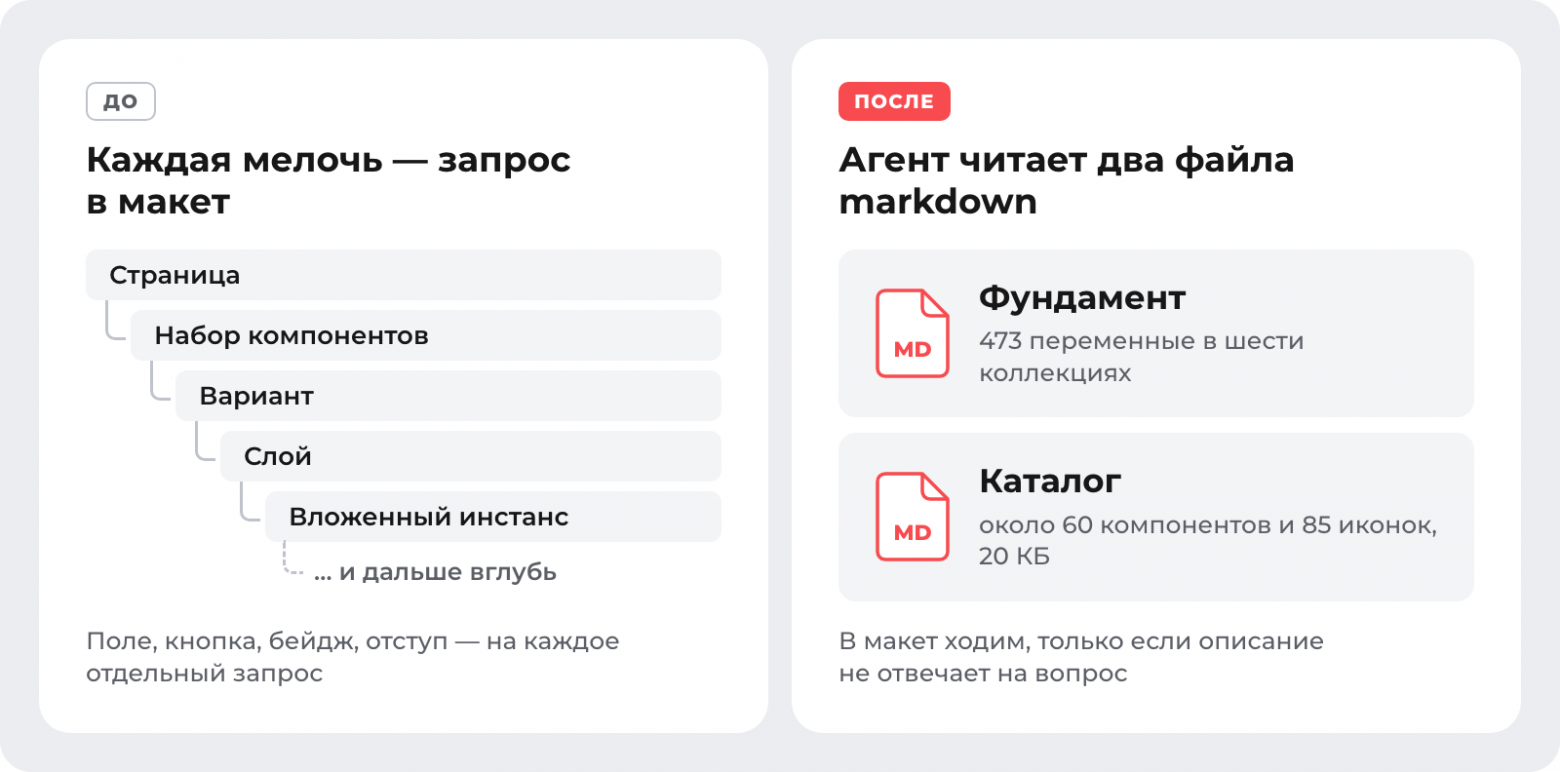
Дизайн-система — это по сути дерево из страницы и наборов компонентов. Внутри наборов еще варианты, внутри вариантов — слои, внутри слоев — вложенные инстансы. Казалось бы, доступ к макету у агента есть, пусть читает сам. Но проблема в том, что мешает размер.
Если пустить обход вглубь, он не заканчивается. А если и заканчивается, то ответ приходит такого объема, что прочитать его дороже, чем собрать экран руками. И тут мы подумали, а что если один раз обойти всю систему, описать ее словами и отдать агенту уже готовый текстовый индекс макета.
Как устроен индекс
Наш индекс — это два файла markdown, которые мы подгрузили к проекту в Claude. Первый описывает фундамент, второй — каталог компонентов.
Файл #1
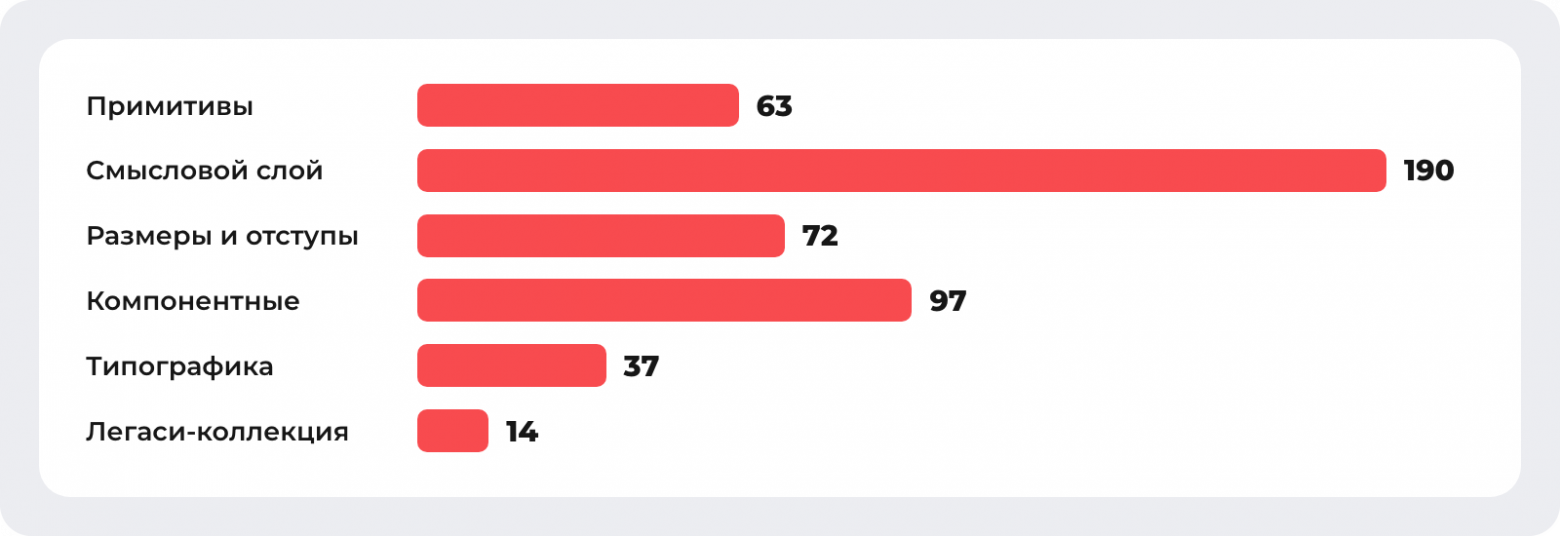
В системе есть 473 переменных, которые мы упаковали агенту, разложив на шесть коллекций:
Слой | Число переменных | Что внутри | Модов |
Примитивы | 63 | Сырые значения: палитра, статусные цвета, прозрачности, числовая шкала | 1 |
Смысловой слой | 190 | Фоны, текст, иконки, границы, состояния кнопок и полей. Почти целиком ссылки на примитивы | 1 |
Размеры и отступы | 72 | Гэпы, паддинги, радиусы, сетка, брейкпоинты | 4 |
Компонентные | 97 | Размеры под конкретные компоненты: иконки, кнопки, поля, навигация, индикаторы | 4 |
Типографика | 37 | Размеры и интерлиньяж заголовков и абзацев | 4 |
Легаси-коллекция | 14 | Параллельный набор с прибитыми значениями. Не используем — про нее отдельно ниже | 1 |
Слои различаются еще и адаптивностью. Примитивы и цвета находятся в одном моде, а размерные и типографические коллекции имеют четыре мода-брейкпоинта: 1440, 1024, 768 и 375. В индексе значения записаны для десктопа, остальные моды помечены.
Файл #2
Здесь у нас около шестидесяти компонентов и 85 иконок, у каждого записаны назначение, матрица вариантов и идентификатор узла.
Матрицы описали компактно, в одну строку: свойство, двоеточие, значения через вертикальную черту. Булевы свойства и слоты обозначили метками.
Запись одного компонента:
Файл #2
Здесь у нас около шестидесяти компонентов и 85 иконок, у каждого записаны назначение, матрица вариантов и идентификатор узла.
Матрицы описали компактно, в одну строку: свойство, двоеточие, значения через вертикальную черту. Булевы свойства и слоты обозначили метками.
Запись одного компонента:
### Button Primary
- Назначение: основная кнопка действия
- Варианты: Size: L | M | S;
            State: Default | Hover | Active | Disable;
            Text[bool], Icon left[bool], Icon right[bool],
            Button text[text]
- Node ID: 10:154
Всего по четырем строкам видно все, что нужно для сборки: три размера, четыре состояния, две необязательные иконки и текстовый слот. Плюс идентификатор узла — по нему агент создает инстанс, не разыскивая компонент заново.
Все 60 записей занимают 20 килобайт. Это тот объем, который агент читает целиком, держа в «голове» всю сессию.
Как готовили индекс под свой проект и на чем споткнулись дважды
При обходе макета для индекса мы взяли только два уровня: переменные и верхний уровень страницы компонентов. Внутрь инстансов не заходили. Векторные иллюстрации пропускали. Сам скан делали одним проходом через того же агента и тот же MCP-сервер Figma.
Главное правило скана дизайн-системы — никакой рекурсии. Звучит как ограничение, но на деле это единственный способ дойти до конца. С рекурсией обход либо не завершится, либо вернет объем, который бесполезен.
Сначала Claude забрал все переменные и их коллекции, потом верхний уровень страницы с компонентами. Все собранное записал в два файла по заранее заданному формату — 3–4 строки на компонент, обязательно с идентификатором узла.
Быстро, компактно, но у такого подхода есть свой недостаток — агент видит не все и часть элементов в индекс не попадает.
Дальше — подробнее о том, что упустили после дебютного обхода и о чем узнали уже через 1,5 месяца работ.
Что скан пропустил в первый раз
Первый проход системы мы сделали в июле, и сборка каталога нам показалась вполне успешной. Отправили агенту — стали быстрее получать экраны.
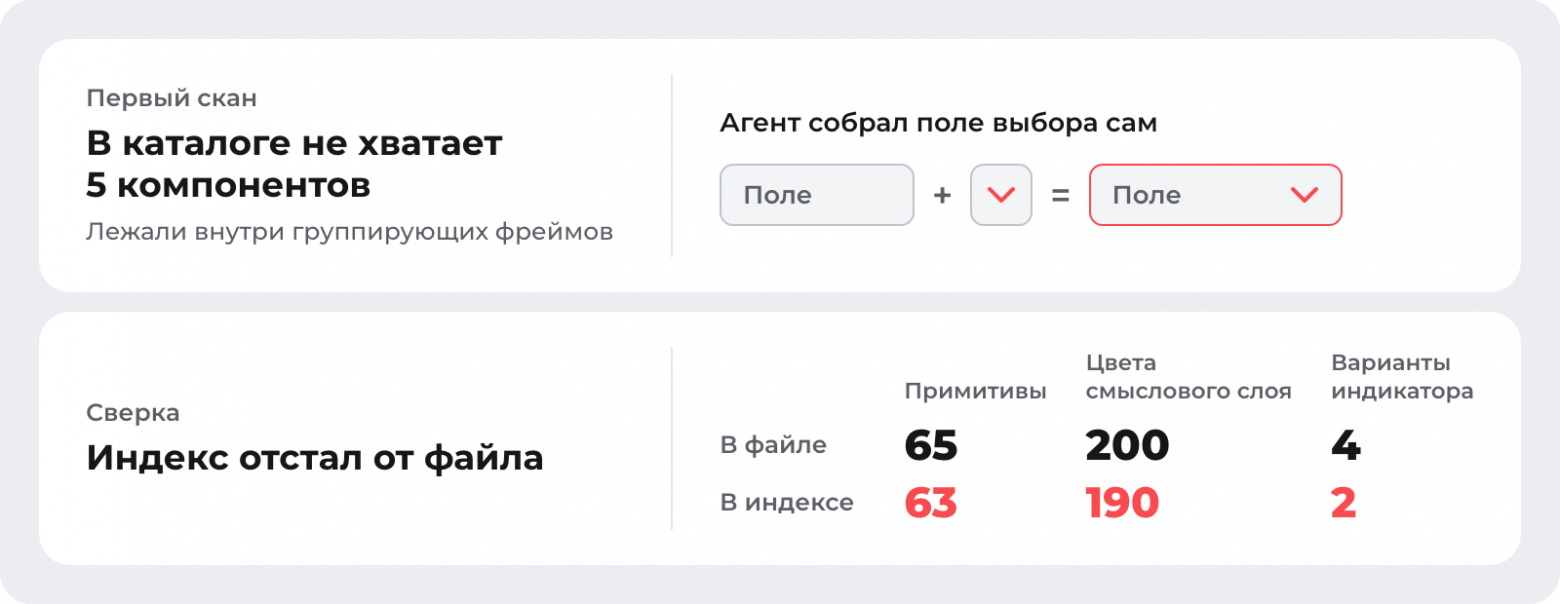
Через день выяснили, что в каталоге нет 5 компонентов: выпадающего списка, его панели, строки внутри панели и двух бейджей. Они лежали на два уровня глубже остальных, внутри группирующих фреймов, а обход раскрывал такие фреймы только на один уровень. Формат записи в markdown тут ни при чем, виновата глубина скана.
Пока элементов не было, вместо выпадающего списка агент на свое усмотрение подобрал обычное поле и иконку-шеврон. Внешне похоже, но по сути самодельный компонент вместо готового, который все это время ждал реализации.
Такой подвох сразу не заметить. Он очевиден только на ревью, когда сравниваешь макет с результатом.
Что ж, мы сделали выводы. После скана надо было детальнее перепроверить основные категории. Поля, кнопки, индикаторы, навигация — пройтись по списку и убедиться, что каждая категория представлена. Автоматический обход что-нибудь да пропустит, вопрос только в том, найдете вы это через день или через месяц.
Мы досканировали недостающее на следующий день отдельным дополнением в тот же файл — с пометкой о причине.
Как индекс отстал от системы
Вторая история дороже первой, потому что тянулась дольше. В середине августа мы переносили дизайн-систему в код. Делали это не по индексу, а по самому файлу напрямую — и на этом сверка вскрылась.
Найденные расхождения:
примитивов 65, а в индексе 63;
цветов в смысловом слое 200, а в индексе 190;
у одного из индикаторов 4 варианта, а в индексе записано 2.
Ничего катастрофического, но неприятно. Полтора месяца часть работы шла по описанию, которое уже разошлось с оригиналом.
Вывод: индекс — не разовый артефакт, а файл, который надо постоянно актуализировать. Его состояние надо проверять так же, как состояние самих макетов. Дизайн-система меняется, пока вы по ней собираете, и это нормально.
Как обновлять индекс дифом
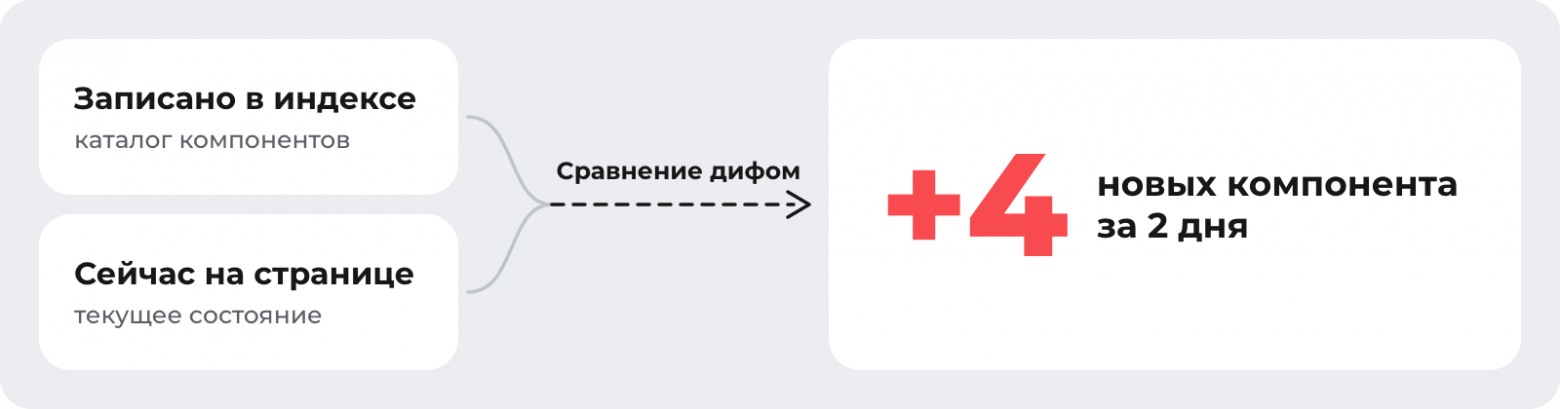
Полное пересканирование каждый раз возвращает нас к той же проблеме, от которой уходили. Поэтому мы обновляем индекс дифом. Проход сравнивает текущее состояние страницы с записанным и показывает только разницу: что добавилось, что изменилось, что пропало.
Первый такой диф занял несколько минут и показал четыре новых компонента, которые дизайнеры добавили за два дня. Варианты у существующих не изменились — это тоже полезная информация о том, что старую часть каталога трогать не надо.
Что еще показало сканирование
Индексация оказалась побочно полезной. Она вскрыла вещи, которые иначе мы нашли бы в самый неудобный момент.
- Параллельная коллекция. В коллекции из 14 переменных коды цветов заданы напрямую, без ссылок на примитивы. Часть из них дублирует смысловой слой, часть вообще не имеет пары в примитивах. Использовать ее нельзя, и хорошо, что мы узнали об этом до сборки, а не после.
- Расхождение в имени начертания. Переменная веса шрифта хранит одну строку, а само начертание в макете называется чуть иначе, с другой заглавной буквой в середине. Глазами разницы не видно. При программной установке шрифта загрузка падает.
- Опечатка в имени токена. Один из токенов записан с удвоенной буквой. На работу это не влияет, но поиск по правильному имени ничего не находит, и на этом можно потерять полчаса.
Все три пункта — не ошибки нашей работы и не задачи для нас. Система чужая, править ее мы не можем. Мы завели их отдельным списком как запросы к команде системы, а у себя записали обходы.
В чем индекс — не помощник
Чтобы не создавать ложного впечатления, подчеркну, что индекс убирает походы за справкой, но не исключает работу с макетом. Сборка все равно идет через прямые вызовы, ведь инстанс создается в файле, а не в тексте. Проверка результата тоже механическая — глазами и скриншотом.
Индекс не знает и о правилах команды. Это набор компонентов, в котором не записано, что хлебные крошки у нас идут отдельной строкой, а не внутри шапки, и что вместо сырых точек берется готовый компонент пагинации. Это мы разобрали на эталонном экране команды и записали в свой файл конвенций. Заняло действо полдня, зато сэкономили три круга правок по типу «у нас так не делают».
И индекс не рассказывает о прорехах дизайн-системы. Например, где у компонента нет нужного состояния, где лейбл наезжает на иконку при растянутой ширине или где в слотах остается дефолтная рыба. Для работы с этим у нас есть док с вопросами к команде системы и обратной связью.
Что теперь сделал бы иначе
Индексировал бы до первой сборки экрана, а не параллельно с ней. Мы начали собирать раньше, чем закончили индекс. Из-за этого часть первых экранов пришлось переделывать.
Проверял бы сразу полноту руками, а не через день. Всего 5 пропущенных компонентов стали причиной самодельного поля и обошлись лишним кругом правок.
Заложил бы сверку индекса в регулярную работу. Например, перед крупным блоком экранов и перед передачей в разработку.
Записывал бы не только то, что в системе есть, но и то, чего в ней нет. Список дырок и обходов оказался почти таким же полезным, как сам каталог.
Несмотря на некоторые шероховатости, все же, чтобы сократить расход токенов, агенту нужен не доступ к источнику, а его компактное описание. Доступ остается для тех случаев, когда файл не может ответить на вопрос.
Для нас индекс дал самую заметную экономию за проект
Точного замера токенов до и после у нас нет, поэтому цифру «во сколько раз» я называть не буду. Но собрал примерные данные из своего учета:
Операция | С индексом и инструкциями, замер | Без них, оценка |
Один экран или слайд в Figma | 3-4 млн | 5-6 млн |
Серия из шести экранов | около 20 млн | 28–32 млн |
Адресная правка серии | около 18 млн | 25–29 млн |
Четыре новых экрана с нуля | около 16 млн | 22–26 млн |
Адаптация экранов под десктоп | около 5 млн | 7–8 млн |
Служебная задача | около 2 млн | около 3 млн |
Слева то, что мы реально тратили на операцию, справа — оценка, сколько в среднем выходит без индекса. Служебные задачи — это подведение итогов, закрытие задач и подобное.
По моим личным наблюдениям, походов в макет стало на порядок меньше и сократилось время выполнения. Другие близкие замеры в числах можно найти на просторах.
Например, в одном из исследований на тему экономии токенов агентов запускали на 124 задачах в 10 репозиториях с файлом инструкций и без него. Наличие файла AGENTS.md в корне репозитория сократило время выполнения задач и расход выходных токенов агентом при работе с реальными GitHub Pull Requests.
Медианное время выполнения задачи снизилось на 28,64% — с 98,57 до 70,34 секунды, а среднее на 20,27% — со 162,94 до 129,91 секунды.
Медианный расход выходных токенов сократился на 16,58% — с 2 925 до 2 440 токенов, а средний на 20,08% — с 5 744,81 до 4 591,46 токена.
Авторы отмечают, что наибольший эффект наблюдается в сложных и ресурсоемких задачах, где без инструкции агент тратит много шагов на исследование структуры проекта.
Но в исследовании ETH Zurich такие файлы в среднем удорожали работу больше чем на 20 % и при этом в целом не улучшали результат. Однако здесь была немного другая цель. Авторы хотели узнать, действительно ли AGENTS.md и CLAUDE.md помогают агентам решать реальные задачи и проходить юнит-тесты, а не просто быстрее завершать работу. Для методологии использовали 438 реальных GitHub-задач из двух бенчмарков: классического SWE-BENCH Lite и нового CTXBENCH на базе репозиториев с живыми контекстными файлами.
Мне кажется, что успех таких исследований основан на объеме индекса. Экономит короткое и плоское описание, а раздутое съедает то, что сэкономило. Но это тоже мой личный вывод.
А что думаете вы и как добиваетесь меньшего расхода токенов? Делитесь опытом и советами.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.