Сколько «агентских сил» под капотом? Почему AI-агентов всё ещё трудно сравнивать
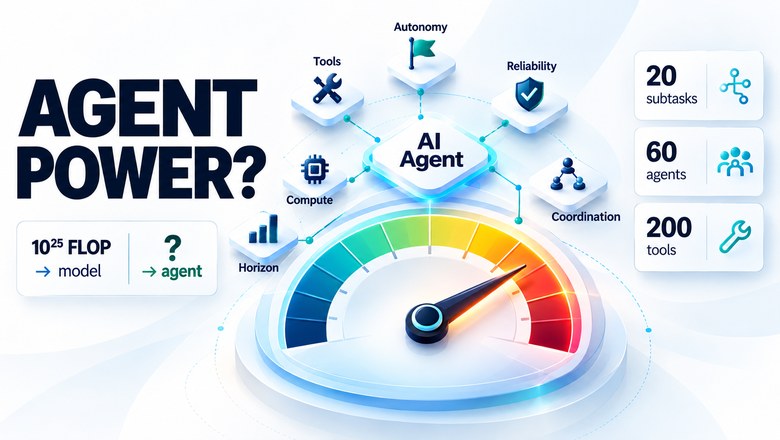
20 исполнимых подзадач. 60 одновременно работающих агентов. 200 интегрированных инструментов.
16 октября эти цифры появились в объявлении №48 Министерства коммерции и Министерства науки и технологий Китая, где опубликован проект изменений каталога технологий, запрещённых или ограниченных к экспорту.
Сама новость на первый взгляд вполне обычная. Государства не любят терять контроль над чувствительными технологиями, особенно если речь идёт о критической инфраструктуре, обороне или ключевых государственных системах. Китайское Минкоммерции примерно так свою логику и объясняет: AI всё шире применяется в чувствительных областях, риски распространения растут, крупные экономики уже используют экспортные ограничения.
Но дальше документ становится заметно интереснее.
Для AI-агентов китайский проект пытается провести границы не только по масштабу, но и по качеству работы:
Что измеряют | Порог в проекте |
|---|---|
Планирование и декомпозиция | не менее 20 исполнимых подзадач, точность декомпозиции не ниже 80%, средняя успешность подзадач не ниже 90% |
Мультиагентное взаимодействие | не менее 60 одновременно сотрудничающих агентов; при одинаковом эффекте общее время выполнения должно быть не более чем вдвое больше минимального времени одиночного выполнения; соответствие конечного вывода эталонному ответу не ниже 85% |
Работа с инструментами | не менее 200 интегрированных сторонних инструментов, точность выбора не ниже 90%, средняя сквозная успешность не ниже 90% в сценариях, требующих совместного использования минимум трёх типов инструментов |
В приложении есть и четвёртая категория: технологии принятия решений в игровых сценариях. Подробный разбор приложения с порогами опубликован, например, в Cloud Security Alliance и ChinaTalk. А высокопроизводительные агенты, специально или преимущественно предназначенные для критической инфраструктуры, обороны или ключевых государственных систем, предлагается относить уже к запрещённым для экспорта технологиям.
То есть это не просто три больших числа. Китайская попытка заметно серьёзнее: масштаб, качество, а местами ещё и назначение системы.
И вот тут становиться интересно.
90% чего именно? На каком наборе задач? Кто определяет эталонный ответ? И что останется от этих 90%, когда агент выйдет из теста в реальную систему?
Проект каталога пока обсуждается, комментарии принимаются до 15 ноября. При этом временная регистрация перед экспортом перечисленных технологий действует уже с 16 октября. Речь идёт именно о передаче технологии, а не вообще о зарубежном использовании китайских AI-сервисов. Уже опубликованные через open source или научные работы технологии документ выводит из сферы управления. Для ограниченных больших моделей MOFCOM отдельно поясняет, что обычный API, веб-интерфейс или SaaS сам по себе не считается экспортом технологии модели.
Сам по себе подход понятен. Регулятору не нужно вывести универсальный закон интеллекта. Ему нужна граница, которую можно проверить и применить.
У покупателя задача другая. Он пытается понять, будет ли конкретная система делать конкретную работу, насколько стабильно, сколько это будет стоить и что произойдёт при сбое.
Похожие цифры, разные вопросы.
Отсюда и главный вопрос этой статьи: что вообще значит «этот агент мощнее»?
Когда рейтинг становится частью закона
В том же китайском проекте есть любопытная деталь для больших моделей.
Ключевые технологии больших моделей предлагается ограничивать при любом из трёх условий: объём вычислений не меньше 10²⁶ FLOP, не меньше 2 трлн параметров либо мировой топ-10 на момент экспорта. Последнее относится к публичным оценкам ведущих оценочных организаций и крупных отраслевых платформ по общей результативности, специальным бизнес-возможностям, глобальному объёму вызовов, безопасности и эффективности обучения.
Вот это уже занятно.
Мы привыкли относиться к рейтингам как к исследовательской или маркетинговой вещи. Хороший результат, красивая таблица, место выше конкурента. А здесь публичная оценка потенциально становится частью юридического критерия.
В Европе количественная логика тоже знакома. Article 51 EU AI Act использует порог больше 10²⁵ FLOP совокупных вычислений обучения как один из механизмов презумпции high-impact capabilities для general-purpose AI model с systemic risk.
Для модели, выходит, можно попробовать считать compute, параметры, место в рейтинге. Не идеально, но объект хотя бы относительно понятен.
С агентом всё сложнее. Агент уже не сводится к модели.
Возьмём одну и ту же LLM. В первом случае дадим ей инструкцию, пять инструментов и одну попытку.
А во втором добавим память, планировщик, браузер, выполнение кода, повторные попытки и несколько субагентов. Модель одна и та же, а вот система вокруг неё уже другая.
Именно поэтому сегодня мы всё чаще сравниваем не модели, а сборки вокруг моделей. Название LLM на первой странице продукта все ещё мало говорит о том, как система держит состояние, выбирает инструменты, восстанавливается после ошибки и проверяет собственный результат.
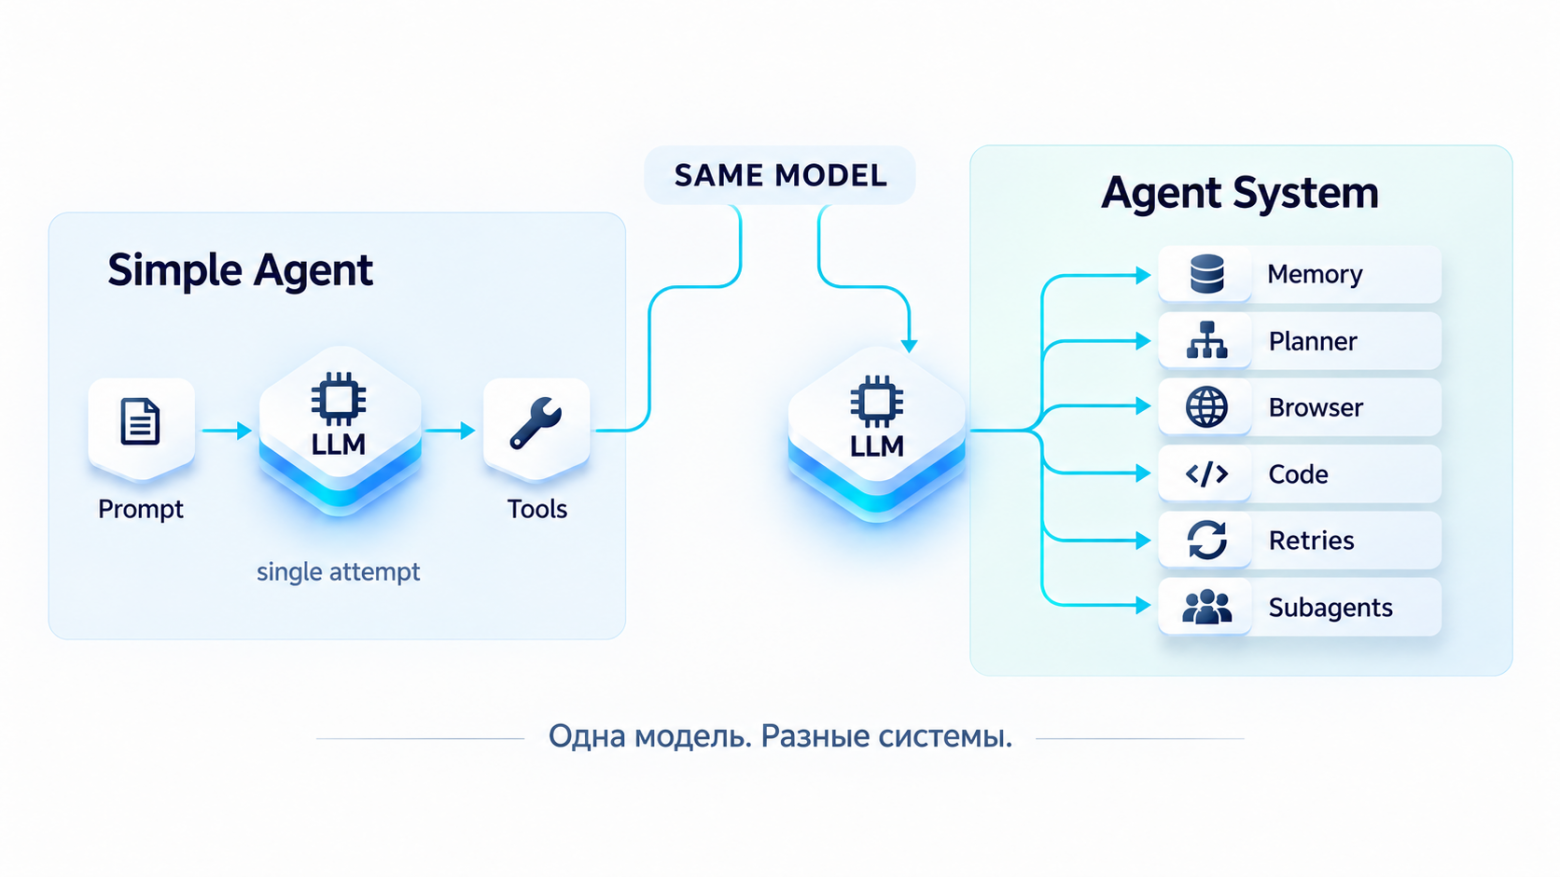
Вот и первая проблема с «агентскими силами». Модель можно измерять отдельно, но всей машины это уже не описывает.
Ну хорошо. Может быть, тогда всё скажут бенчмарки?
Бенчмарк хороший. Что именно он доказал?
Без лабораторных тестов здесь не обойтись. Чтобы сравнивать системы, очевидно нужно фиксировать задачи, среду, ограничения и процедуру оценки.
Проблемы начинаются чуть позже, когда аккуратный результат теста почти незаметно превращается в обещание для продакшна.
В вылизанном демо задача определена заранее, инструменты доступны, состояние среды известно, критерий успеха зафиксирован. В реальной работе API отвечает неожиданно, состояние меняется между двумя шагами, инструмент зависает, а формально успешное действие иногда не даёт нужного эффекта в целевой системе.
Я уже разбирал похожий разрыв в собственных лабораторных кейсах. В одном случае, в статье «ИИ-агенту запретили запись в CRM. Но CRM всё равно изменилась», агенту запрещали запись, но CRM всё равно менялась из-за возможностей downstream-компонента. В другом, «ИИ-агенту разрешили не больше 100 единиц. Три корректных ALLOW дали итог 120», на детерминированном стенде без LLM три отдельно корректных решения ALLOW по 40 дали совокупный эффект 120 при лимите 100.
Это конечно не аргумент против бенчмарков и не production-инциденты. Скорее напоминание о простой вещи: локально правильный результат компонента и фактическое поведение всей системы могут расходиться.
Гладко было на бумаге, да забыли про овраги.
Поэтому итоговый score мне интересен вместе с условиями, при которых он появился.
Восемь часов. Чьих?
Один из самых наглядных примеров даёт METR с task-completion time horizon.
Если у агента условный восьмичасовой горизонт при 50% success, это не значит, что он восемь часов подряд автономно работал. Речь идёт о сложности задачи: человеку-эксперту на такую задачу потребовалось бы, например, около восьми часов, а агент в тестовой выборке имеет примерно 50% вероятность успеха.
Это весьма полезная метрика. Она позволяет спросить, работу какого масштаба система вообще способна довести до результата. Однако для покупателя тут же появляется следующий вопрос: похожи ли его собственные задачи на те, где этот горизонт измеряли? METR прямо указывает, что набор в основном состоит из software engineering, machine learning и cybersecurity tasks. Переносить тот же вывод на бухгалтерию, закупки или юридический анализ автоматически не получится.
Цифра красивая, но контекст всё равно нужен.
Один раз получилось. А можно рассчитывать на повтор?
Давайте представим две системы. Первая решила сложную задачу один раз из восьми запусков. Вторая решила её восемь раз подряд.
На демонстрации обе способны показать успешный результат. А вот в ежедневной операции это уже совсем разные предложения.
Здесь, по моему, стоит разделить два вопроса: может ли система вообще найти решение и насколько этот результат воспроизводим. pass@k, например, позволяет учитывать ситуацию, когда хотя бы одна из нескольких попыток оказалась успешной. Для поиска сложного решения это вполне здоровая постановка вопроса.
Но если попыток было восемь, как понять, какая из них правильная?
Сам агент знать это не обязан. В рабочей системе результат может проверять отдельный валидатор, тест, монитор или человек. Вопрос злесь в другом: есть ли такой механизм вообще.
Если правильный результат умеет выбрать только оценщик бенчмарка, а в рабочей системе такой проверки нет, агент всё ещё может быть способен решить задачу. Но полагаться на него автономно нельзя.
Хороший результат. За какие деньги?
Есть ещё одна переменная, которую легко потерять за процентом успешности: бюджет выполнения.
UK AI Security Institute показывает, что измеряемые возможности агента меняются вместе с test-time compute. Дополнительный бюджет можно потратить на более длинную траекторию, проверку, исправление ошибок или несколько параллельных попыток.
В исследовании это вполне оправдано. Там важно понять предел возможностей системы.
В реальной эксплуатации всё куда как прозаичнее: за каждую дополнительную попытку, токены и время кто-то обязательно платит. Возьмём условный пример на одном наборе задач: агент A решает 85% с первой попытки, а у агента B хотя бы одна из восьми попыток успешна в 92% случаев. Если B обходится заметно дороже с учётом всех запусков, объявить победителя на основании этих двух процентов уже не получится.
Для разовой сложной задачи B может быть прекрасным выбором, если удачный результат можно проверить. Для миллиона повторяющихся операций расклад будет уже другим.
Итак, получается, что результат бенчмарка без условий мало что говорит сам по себе. Всё решают условия, в которых его получили.
Что спросить до покупки
Допустим, международного стандарта «агентских сил» пока нет. Ждать его для каждого проекта бессмысленно.
Но это не значит, что покупателю не на что опереться. Я бы начал с нескольких простых вопросов. апример:
Что именно проверяли? Какие задачи, какой сложности, в какой среде? Человеческие часы, число шагов агента и его фактический runtime не равны друг другу.
Насколько результат повторяем? Один удачный запуск и девять из десяти успешных запусков тоже означают разные вещи.
Какую систему тестировали? Какая модель, какая обвязка, память, инструменты, retries, субагенты? После изменения половины сборки старый результат уже не обязательно описывает новый продукт.
Какой был бюджет? Время, токены, деньги, число попыток, параллельные исполнители.
Сколько помогал человек и что происходило после сбоя? Кто исправлял план, подтверждал действие, выбирал удачную попытку? Агент замечает, что пошёл не туда, перестраивается, останавливается, зовёт человека или продолжает действовать?
Кто подтвердил результат? Сам агент, тест, человек, другая модель или фактическое состояние целевой системы?
Разумеется это не новая методология. Просто минимальный контекст, без которого выражение «наш агент мощнее» слишком легко понять не верно.
А когда агент получает возможность реально менять внешнюю систему, я бы добавил ещё два вопроса:
что ему разрешено делать?
что произойдёт, если он ошибётся?
Здесь становится видно ещё одно ограничение любых «агентских сил». Capability и risk не одно и то же. Агент с пятью необратимыми операциями может требовать более жёсткого контроля, чем система с двумястами безобидными инструментами.
Но это уже другая история.
Теперь возвращаемся к китайскому документу.
Китайская попытка выглядит лучше, чем кажется сначала
После METR, повторяемости и test-time compute китайские пороги читаются немного иначе.
Поначалу 20, 60 и 200 легко принять просто за большие числа. Но проект уже содержит ответы на часть очевидных возражений. Для инструментов требуется не только масштаб интеграции, но и точность выбора, а также и сквозная успешность. Для декомпозиции заданы accuracy и success rate. Для мультиагентного режима есть также условия по времени и соответствию эталонному ответу.
Это сильнее простого подсчёта компонентов.
Однако проблема измерения никуда не исчезла. Она просто поднялась на уровень выше.
На каких задачах считается 90%? Как формируется эталонный ответ? Каков бюджет повторных попыток? Насколько эти проценты переносятся на другую среду, права доступа и другой набор инструментов?
У больших моделей есть похожая тонкость. Мировой топ-10 не привязан к одной фиксированной таблице и оценивается на момент экспорта. Разные оценщики могут получить разный порядок, а место модели способно измениться без изменения самой модели.
Вот тут, на мой взгляд, китайский документ становится особенно интересным. Регулятор столкнулся практически с той же проблемой, что и покупатель: чтобы число стало полезной границей, нужно объяснить, как оно получено.
Для экспортного контроля нынешний подход вполне может оказаться рабочим. Он и не должен быть универсальной теорией возможностей агента.
Сегодня экспорт. А дальше?
Классификация возможностей уже перестаёт быть только предметом разговора для исследователей.
Регулятору она нужна для экспортного контроля. Покупателю для выбора продукта. Страховщику могут понадобиться данные о надёжности, автономности и последствиях ошибок. Для некоторых систем со временем вполне могут появиться отдельные классы допуска, ответственности или сертификации.
Не исключено, что в более длинной перспективе подобная классификация понадобится и для отдельных фискальных режимов. Но говорить сегодня о готовящемся «налоге на агентские силы» пока оснований нет.
Какими будут такие классы, я не знаю. Горизонт задач? Надёжность? Степень автономности? Последствия действий? Скорее всего, одной характеристики здесь будет мало.
И снова 20, 60 и 200
В начале китайский документ выглядел как ещё одна новость об экспортном контроле.
После более внимательного чтения всё становится куда интереснее.
Китай не нашёл универсальную «лошадиную силу» для AI-агента. Похоже, он даже её и не искал. Для конкретной государственной задачи выбраны несколько измеримых признаков, дополненных требованиями к качеству и назначению технологии.
Именно поэтому эта попытка мне кажется очень важной.
Не потому, что 20, 60 и 200 можно превратить в новую шкалу. Наоборот, документ хорошо показывает, насколько трудно это сделать. Даже когда пороги записаны числами, сразу возникают вопросы о наборе задач, способе оценки, эталонном ответе, бюджете и переносе результата в реальную среду.
Возможно, одной универсальной «агентской силы» вообще никогда не появится. У автомобиля тоже недостаточно знать мощность двигателя. Есть масса, расход, грузоподъёмность, тормозной путь, условия эксплуатации. Просто язык для сравнения автомобилей давно сложился.
Для агентов он формируется сейчас.
И если завтра вам скажут: «наш агент мощнее», спорить заранее не обязательно.
Я бы просто спросил: мощнее в какой работе, насколько стабильно, при каком бюджете и кто это проверял?
Сегодня этого уже достаточно, чтобы понимать, что именно стоит за словами «агент стал мощнее».
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.