Ваши секреты не должны уходить в облако: знакомьтесь, Obscura
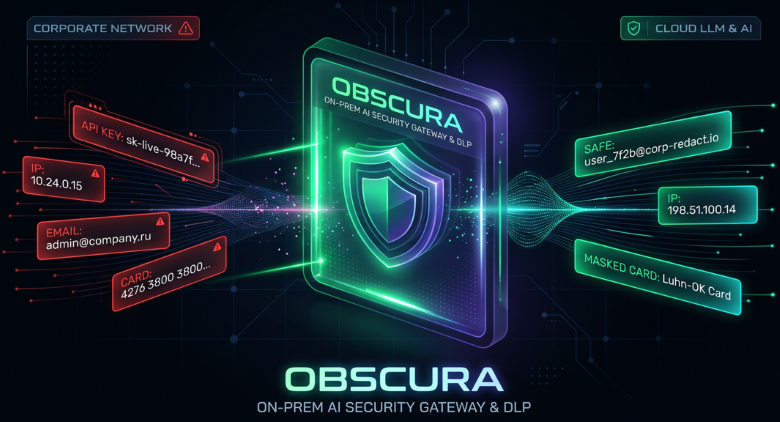
Obscura: свой on-prem шлюз, который не даёт секретам утечь в ИИ и не ломает ответы модели
Летом я писал, что будет, если сливать рабочие данные в ChatGPT: логи SOC, конфиги Cisco и FortiGate, внутренние IP, почты сотрудников. Тогда я сделал офлайн-инструмент, который чистит конфиг руками инженера до отправки. Он решает проблему для того, кто помнит им воспользоваться. Но компания не может полагаться на то, что все всегда вспомнят.
Поэтому я сделал следующий шаг: шлюз, который стоит между человеком и нейросетью, проверяет каждый запрос и решает, что с ним делать. Называется Obscura. Он работает on-prem, данные остаются внутри сети.
Рис. 1. Главный экран консоли
Как это работает
Клиент ходит в шлюз как в обычный OpenAI-совместимый API (/v1/chat/completions), для Anthropic есть адаптер /v1/messages. Для веб-интерфейсов вроде ChatGPT есть расширение Chrome/Edge/Firefox, для файлов и картинок отдельный инспектор, плюс встроенный корпоративный чат.
Режимов работы три:
• Monitor: только смотрим и пишем в журнал;
• Warn: пользователь сам выбирает «замаскировать» или «отправить как есть»;
• Enforce: маскируем или блокируем до отправки.
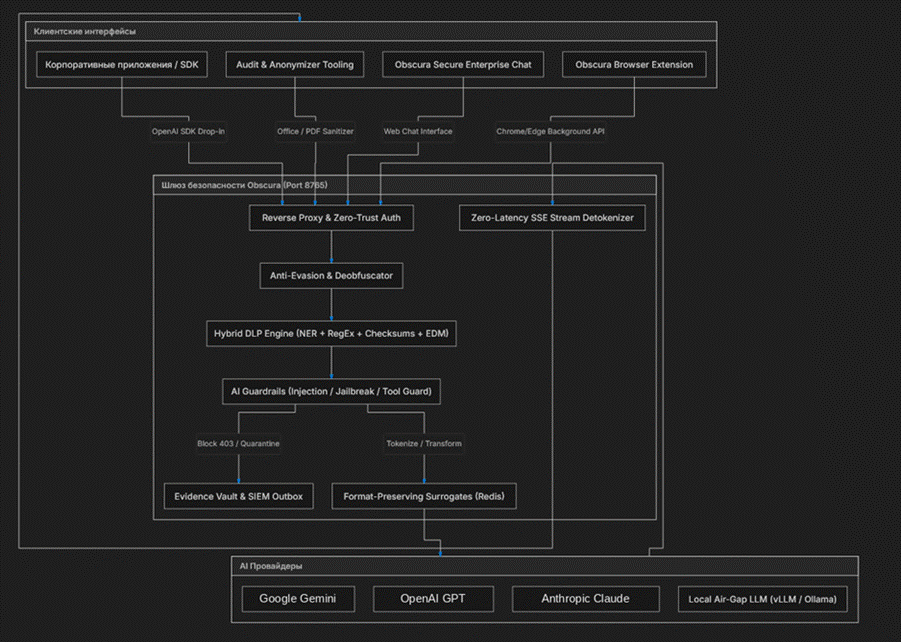
Рис. 2. Архитектура шлюза
Стек: Python, FastAPI, SQLite в WAL, Redis, spaCy, Svelte 5 для веб-консоли.
NER – RU/EN/AZ/TR
Большинство DLP делают под английский. Русские данные у них проходят хуже: другие форматы документов, кириллический контекст, склонения. В Obscura для русского есть свои правила: ИНН (10 и 12 цифр, с проверкой контрольной суммы), СНИЛС, банковские карты, реквизиты, телефоны, а ещё API-ключи и токены (sk-..., AWS, GitHub, JWT). Совпадение по regex подтверждается контрольной суммой, поэтому случайное число реже превращается в «номер карты».
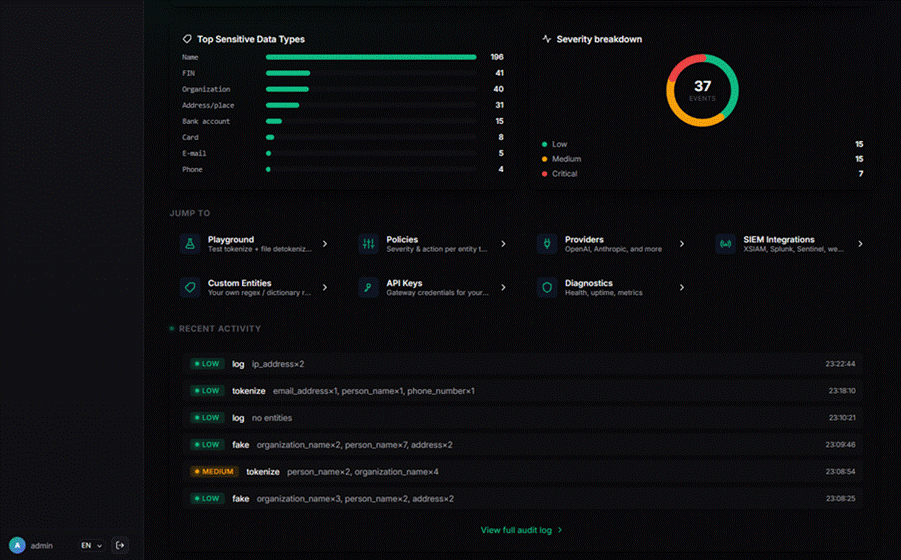
Рис. 3. Типы найденных данных и распределение по severity
Проблема: [EMAIL_1] ломает ответ модели
Обычно данные заменяют метками. Для чата нормально, для кода и JSON нет: модель получает посреди структуры непонятную метку, может сломать формат или начать рассуждать о ней. Поэтому в Obscura есть режим синтетических суррогатов:
Что нашли | Что уходит в модель |
номер карты | другой номер, проходящий проверку Луна |
IP-адрес | адрес из тестовой сети RFC 5737, например 198.51.100.14 |
имя | другое правдоподобное имя |
Модель видит нормальные данные и отвечает естественно, а шлюз возвращает в ответ настоящие значения. Генератор детерминированный: одно значение внутри запроса даёт один суррогат. Скорость около 18 800 значений в секунду, все сгенерированные карты проходят Luhn.
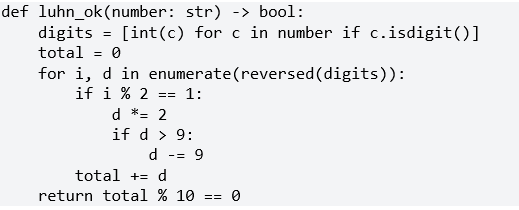
Стриминг: самая неприятная часть
При stream=True ответ приходит кусками по 1–2 символа. Токен может прийти как "[", "EMA", "IL_1", "]", и поиск подстроки по каждому куску не работает. Решение: конечный автомат со скользящим окном. Обычный текст уходит клиенту сразу, а хвост, который может оказаться началом токена, держится в буфере, пока не станет ясно, что это. Упрощённая иллюстрация (не код из репозитория):
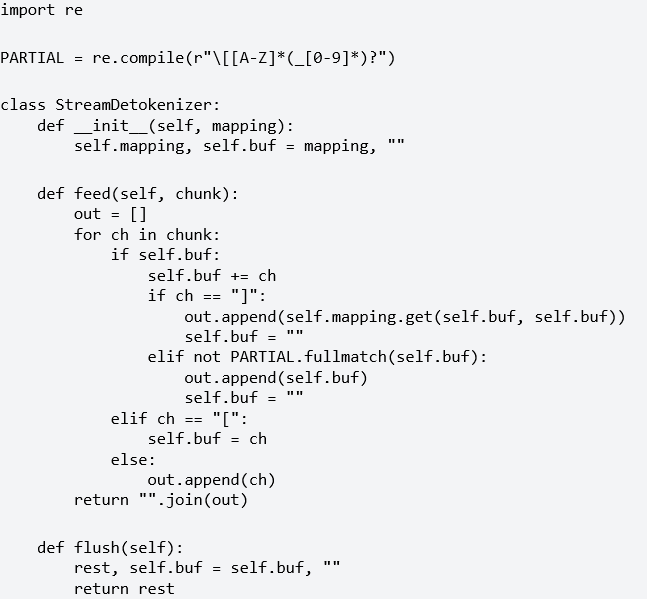
Для русского текста это особенно важно: каждая кириллическая буква занимает два байта UTF-8, и границы чанков могут резать их пополам. Я проверял «хаотической» фрагментацией: чанки по 1–3 байта, разорванные скобки и UTF-8, ложные префиксы. Потерянных байт 0. На 100 параллельных потоков: P50 0,056 мс, P95 0,486 мс, P99 10,9 мс.
Как шлюз решает, что это секрет
Один regex даёт слишком много ложных срабатываний, поэтому у каждого срабатывания несколько признаков: формат и контрольная сумма, контекстные слова рядом, энтропия Шеннона строки-кандидата и следы де-обфускации. Перед детекторами текст нормализуется: раскодируются Base64 и Hex, удаляются невидимые символы, склеиваются разреженные цифры и leetspeak.
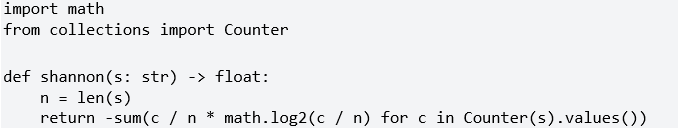
Энтропию считаю для отдельных длинных строк без пробелов, а не для всего текста: у обычной прозы она тоже около 4 бит.
Всё это видно в журнале как «вердикт»: офицер безопасности понимает, почему сработало правило, и может его поправить. Журнал связан хэшами, правка или удаление строки ломают цепочку, и это ловит кнопка «Verify chain integrity».
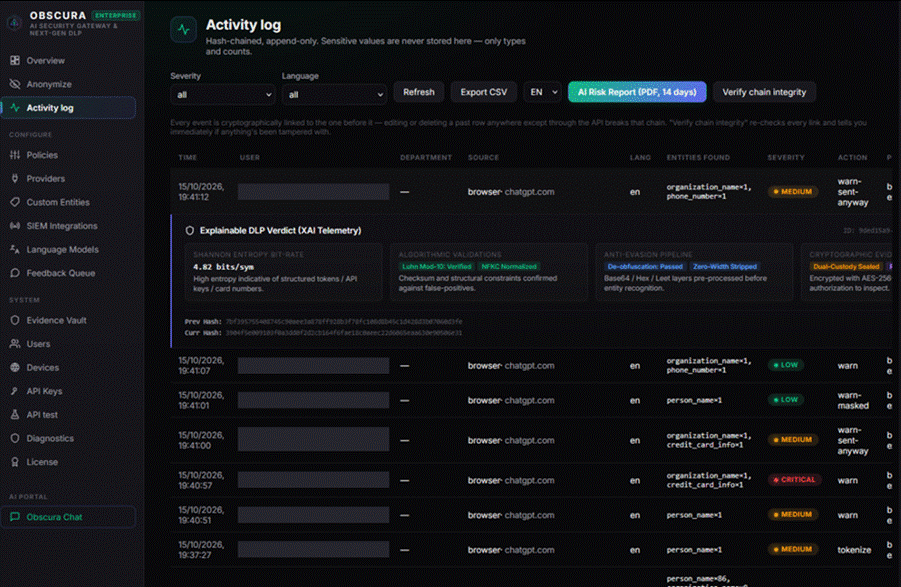
Рис. 4. Журнал событий и объяснение вердикта
Парк браузеров
Расширение регистрирует каждый браузер как устройство. Если расширение отключили или удалили, устройство замолкает, и это видно в консоли сразу, а не после инцидента.
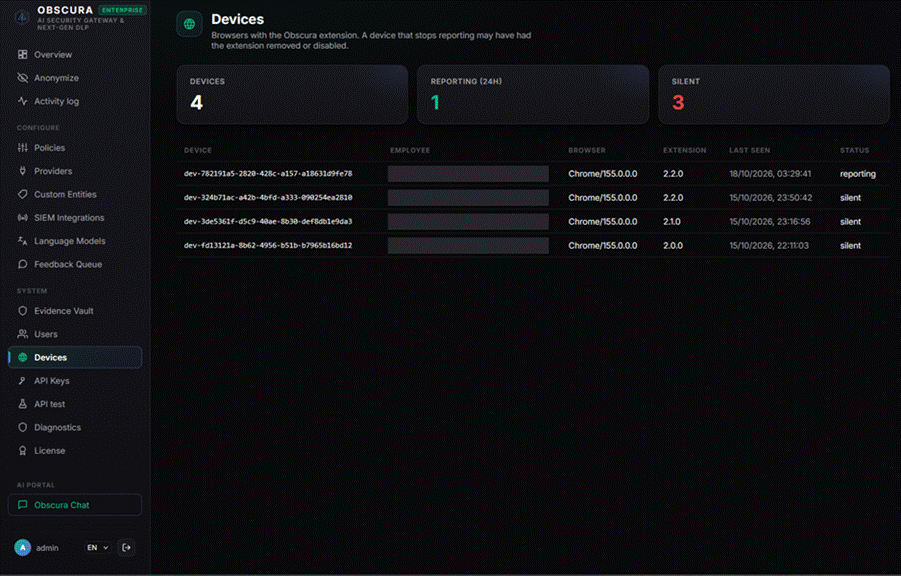
Рис. 5. Устройства с расширением
Картинки
Скриншот с паспортом или картой тоже утечка. Инспектор достаёт текст через OCR и пускает его в тот же конвейер. Если нашёлся секрет, запрос блокируется (403), оригинал шифруется и кладётся в хранилище улик, а SecOps получает алерт.
Улики
Перехваченное нельзя хранить в логах открытым текстом. Поэтому фрагменты шифруются, а доступ идёт по принципу четырёх глаз: один офицер подаёт заявку с обоснованием, второй одобряет, выдаётся токен на 15 минут. Для «права на забвение» есть крипто-удаление: стирается ключ записи, шифротекст остаётся, цепочка журнала не рвётся.
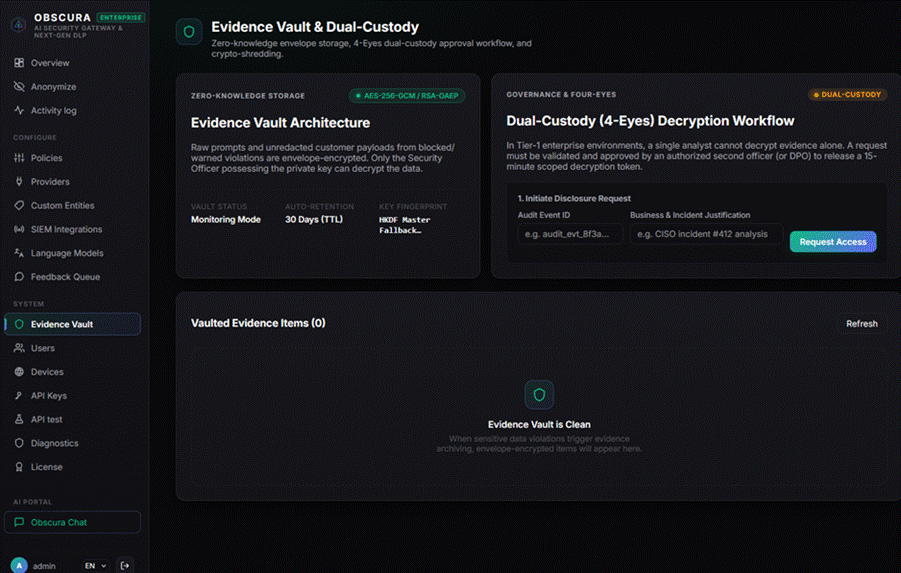
Рис. 6. Хранилище улик
Агенты, бюджет, политики
• Инъекции и jailbreak: эвристики плюс оценка риска, защита системного промпта.
• Tool Guard: проверка аргументов вызовов инструментов на shell-инъекции и SSRF.
• Лимиты токенов: TPM и TPD на ключ или отдел, ответ 429 до того, как запрос ушёл в платную модель.
• Симулятор политик: новое правило прогоняется по логам за 7/14/30/90 дней, видно, сколько легальных запросов оно бы заблокировало, ещё до включения.
• SIEM: отправка алертов (только метаданные, без самих значений) через webhook и интеграции.
Цифры
Все цифры мои, синтетические, с домашнего ПК: AMD Family 21, ~3,1 ГГц, 20 ГБ RAM, Windows 10. Железо старое.
Метрика | Значение |
Детокенизатор P50 / P95 / P99 | 0,056 / 0,486 / 10,9 мс |
Генерация суррогатов | ≈ 18 800 значений/с |
Потерянные байты при фрагментации | 0 |
Гонки при 50 параллельных бронированиях квот | 0 |
Тесты | 515 из 515, pip-audit без CVE |
Границы
Тесты показывают, что код делает то, что я задумал, а не качество детекции на реальных запросах. Детектор построен на правилах и NER, а не на обученном классификаторе, поэтому нестандартные форматы он пропускает, а числа, похожие на телефоны (номера заказов), иногда ловит ошибочно. Секрет, пересказанный своими словами, шлюз не поймает. Независимого аудита и боевой эксплуатации пока нет. Проект развивается каждый день, новые функции появляются постоянно.
Как я делал это с ИИ-агентом
В разработке использовал Claude Code, ChatGPT, DeepSeek и Antigravity. Больше всего понравились Claude Code(Opus, Sonnet) и ChatGPT(Astra) они помогли ускорить разработку и тестирование. Конечно, ИИ может ошибаться, поэтому его результаты нужно проверять. Перед реальным внедрением команда специалистов проведёт дополнительные тесты, проверку безопасности и соответствия стандартам. ИИ также будет использоваться как дополнительный инструмент для поиска проблем и улучшения системы.
Что дальше
Прозрачный перехват на уровне ядра (eBPF), SSO, мультирегиональное хранилище и много других функций!
Нужны ваши советы
Если вы работали над похожими проектами или видите, как можно улучшить Obscura, буду рад вашим идеям в комментариях. Особенно интересно, какие русскоязычные данные и форматы сложнее всего обнаруживать и каких функций не хватает подобным шлюзам в реальных компаниях.
Планирую выпустить Obscura через два месяца. До релиза проведём дополнительные функциональные тесты и проверки безопасности с участием специалистов.
После релиза предоставлю всем желающим возможность бесплатно протестировать Obscura в течение 30 дней. Чтобы получить доступ, достаточно написать мне в личные сообщения или Telegram.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.