Claude Opus 5.5の推論能力が11月3日から急激に低下したとの指摘、1400件の利用履歴から変化が判明
AnthropicのAIモデル「Claude Opus 5.5」の推論能力が2026年11月3日頃から急激に低下した可能性が指摘されています。開発者のシェーン・メロー氏がAIによるプログラミング支援ツール「Claude Code」の利用履歴約1400件を分析したところ、モデル名が変わっていないにもかかわらず、AIの思考を示す文章や作業の進め方に大きな変化が見つかったとのことです。
— Shane Melaugh (@shanemelaugh) 2026年11月7日is Opus 5.5 nerfed?
I just had Gemini 4 Argon analyze 1,400 Claude Code sessions and it found that on November 3, something definitely happened.
the model name didn't change, but the way it does reasoning took a sharp turn. pic.twitter.com/6xnofvg1rv
メロー氏はClaude Opus 5.5を使用する中で、以前は問題なく処理できていた作業がうまく進まなくなったと感じたそう。そこでGoogleのAIモデル「Gemini 4 Argon」を使い、2026年10月9日から11月7日までのClaude Codeの利用履歴約1400件を分析しました。
以下の画像はメロー氏が公開した分析結果です。11月3日を境にAIの思考内容を示す文章の特徴が大きく変化していることが分かります。
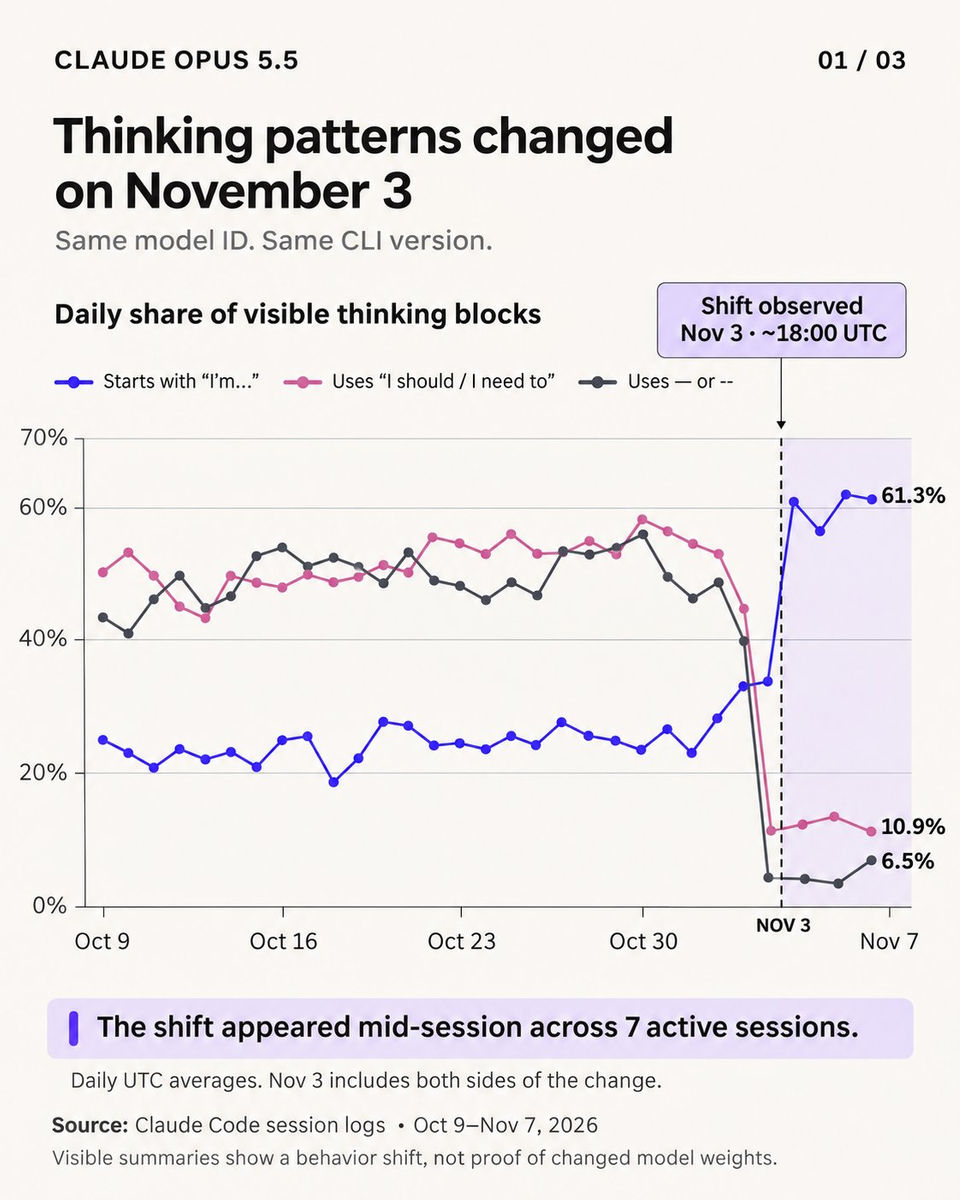
分析によると「I'm」で始まる文章の割合は従来の20~30%程度から61.3%に増加。一方で「I should」や「I need to」といった表現の割合は約50%から10.9%に減少し、ダッシュ記号の使用率も40~55%から6.5%まで低下しました。変化が起きたのは日本時間の11月4日3時頃で、作業中だった7件のセッションでも同様の変化が確認されたとのことです。
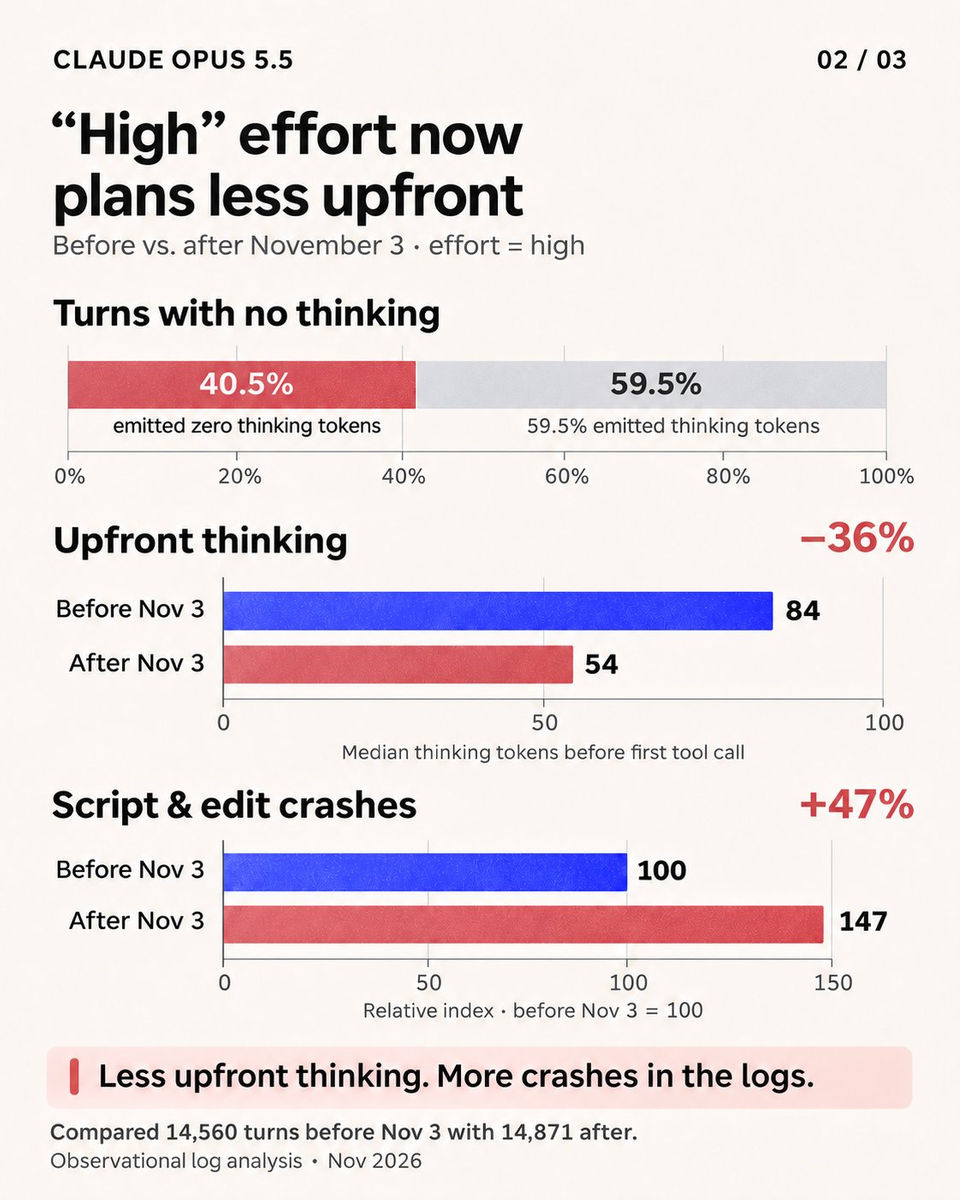
さらにメロー氏はAIが実際の作業を始めるまでに費やす思考量にも注目しました。Claude Opus 5.5には推論に費やす処理量を調整する設定があり、複雑な問題では推論の負荷を高めることで解決能力の向上が期待できます。しかし、推論負荷を「high」に設定した場合でも、「変化」以降は最初の操作に取りかかるまでの思考量が減少していたそうです。
以下の画像は11月3日前後の推論量とエラー発生状況を比較したもの。11月3日以前の1万4560回のやり取りとそれ以降の1万4871回のやり取りを比較したところ、最初の操作までに使用する思考トークン数の中央値は84から54へと約36%減少したほか、スクリプトの実行やプログラムの編集に関するエラーの指標も47%増加していたとのこと。また、分析対象のやり取りの40.5%では思考トークンが出力されていなかったとのことです。
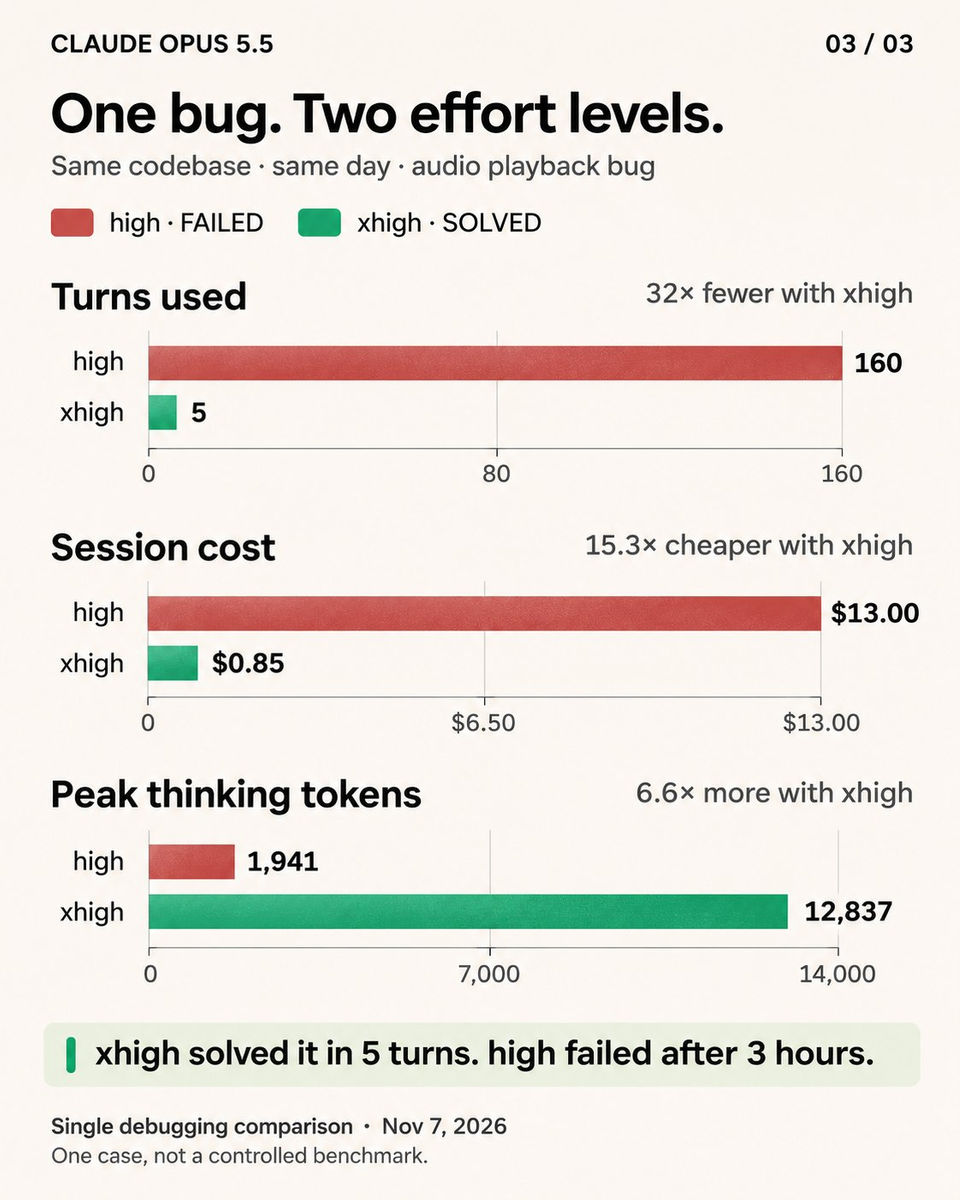
メロー氏は推論負荷の違いによって問題解決能力にどの程度の差が生じるのかも検証しています。同じプログラムに存在する音声再生の不具合について「high」と、さらに多くの推論処理を行う「xhigh」の2つの設定で修正を試みました。
以下の画像は同じ不具合を異なる推論負荷で修正した結果です。highでは160回のやり取りを繰り返しても修正できなかった一方、xhighでは5回のやり取りで修正に成功したとのことです。highでは約3時間かけても問題を解決できず、費用は13ドル(約2000円)に達しました。一方でxhighは0.85ドル(約134円)の費用で修正に成功しており、やり取りの回数は32分の1、費用は約15分の1に収まっています。思考トークン数の最大値もhighの1941に対してxhighは1万2837と約6.6倍になりました。
なお、Anthropicの公式資料によるとClaude Codeなどで利用者に表示される思考内容はAIの内部処理をそのまま示したものではなく、別のAIモデルが作成した要約とのこと。そのため、思考内容を要約する仕組みが変更されただけでも表示される文章の特徴が大きく変化する可能性があります。
実際に開発者のテオ・ブラウン氏は約45万8000件のClaude Opus 5.5の応答履歴を調査し、Anthropicが思考内容を要約する仕組みをアカウントごとに順次変更している可能性を指摘しました。ブラウン氏の調査でも文章の特徴が変化していたものの、変更時期はアカウントによって10月30日から11月4日まで異なっていたとのこと。また、応答1回当たりの平均思考トークン数は369から413に増加しており、ブラウン氏は「私の環境では能力低下の兆候は見つかりませんでした」と述べています。
— Theo - t3.gg (@theo) 2026年11月8日Dug into this more. Anthropic appears to be rolling out a change to the reasoning summarizer on a per-account basis.
No sign of degraded capability for me. I think they're just trying to fix the reasoning traces (they've been utter garbage for weeks, complained about this… https://t.co/8ajTQAYx13 pic.twitter.com/uhUvTiS3Nf
メロー氏は今回の調査について「科学的に厳密な性能評価ではない」と説明しており、個人的な利用体験をきっかけに分析したことを強調しています。また、エンジニアが集うニュース共有サイトのHacker Newsでも性能低下を実感したという報告が相次ぐ一方、思考内容の要約方法が変更されただけではないかという意見も出ています。記事作成時点ではClaude Opus 5.5の推論能力が実際に低下したかどうかは明らかになっておらず、Anthropicによる詳しい説明や追加検証が待たれています。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.