Затащи меня в харнесс. Часть X. Принципы организации памяти: .md файлы, скиллы, концепция дриминга
Представьте, что у вас в команде появился очень хороший разработчик. В первый день он быстро разобрался в проекте, нашел нужный сервис, выяснил, почему падают тесты и закрыл кучу тикетов. На следующий день вы даете ему новую задачу в том же, и, вот беда, оказывается, у разработчика амнезия. Он снова начал разбираться с нуля в том же самом проекте, наступая на те же грабли, что и вчера. Примерно так работает ии-агент.
Напоминает сюжет из фильма «Мементо», где наутро герой ничего не помнит, хотя является полностью. И, как в фильме Нолана, агент записывает на себе все, что считает важным.
Умный агент, который каждый раз начинает с нуля
Поводом написать эту главу сейчас стало выступление Ламис Мукты из Anthropic. В своем выступлении она рассказывала о том, как организовать память агентов и зачем им может понадобиться dreaming - отдельный процесс, который разбирает прошлые сессии и приводит накопленные знания в порядок. Слайды взяты из ее презентации. Ссылка
У модели могут быть прекрасные общие знания, зашитые в весах, но она не обязана из коробки знать устройство вашего репозитория, принятый в команде процесс или причину, по которой вы три раза отвергли определенное решение. Если где-то в системе не хранится опыт агента, то пятидесятая задача может начинаться почти так же, как первая.
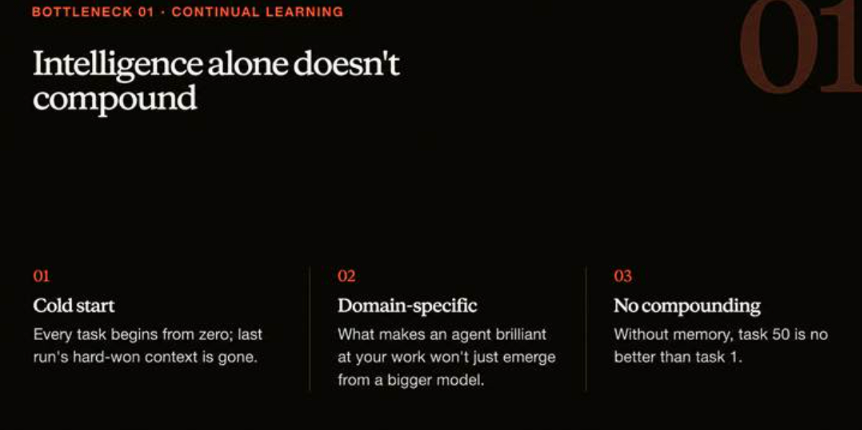
Здесь важно не смешивать несколько вещей. Контекстное окно - это данные, которые модель видит при конкретном вызове. Транскрипт - запись сообщений и действий сессии. Durable state из хранит состояние выполнения: какой шаг работает, что подтверждено и что ожидается. Память в этой статье - отобранные сведения, которые можно использовать в будущих задачах. Она может жить долго, но не заменяет ни журнал, ни актуальное состояние системы.
Как развивалась память: от одного файла до каталога
На слайде выступления показана эволюция нескольких подходов: один файл CLAUDE.md, инструменты памяти, skills и файловая память, которую агенты читают и редактируют. Я бы не воспринимал это как обязательную лестницу эволюции: но в Claude Code прошли именно этим путем.
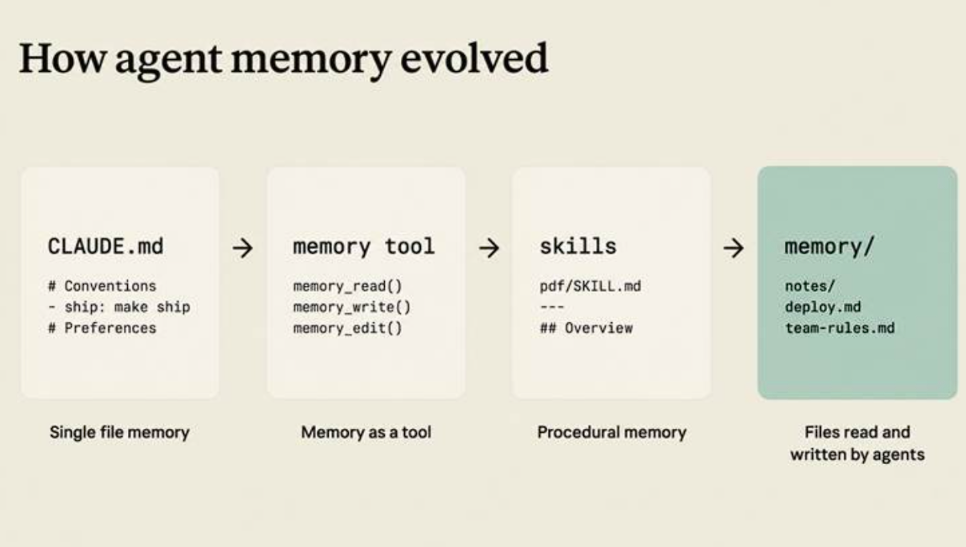
Итак, начнем. Мы поняли, что наш агент просто не помнит ничего о проекте, если этого нет в контексте промпта, поэтому самый простой вариант - положить основные правила проекта в человекочитаемый файл. Там может быть команда запуска тестов, расположение сервисов и договорённости команды. Это легко проверить глазами и положить под контроль версий.
Собственно, для этого существует CLAUDE.md. Туда можно записать всё, но если писать вообще всё, рано или поздно получится документ размером с инструкцию по эксплуатации атомного ледокола. Его целиком загружают в контекст каждой сессии, так что лишний текст будет тратить место и внимание агента при любой задаче, даже при исправлении опечатки.
Агент начинает сам записывать и читать память
Следующий шаг по улучшению памяти - дать агенту возможность осуществлять операции чтения и записи памяти. Тогда важные сведения можно сохранять между сессиями, а при новой задаче выбирать нужные. Память в таком случае можно представить как обычный инструмент, такой же, как поиск по файлам или запуск команд.
Например. у модели есть три функции: memory_read() читает запись, memory_write() создаёт новую, memory_edit() меняет часть существующей.
Модель сама решает, когда их вызвать. Она видит описания инструментов и, если задача требует, передаёт нужный запрос, например прочитать заметку о тестах или записать найденную причину бага. Программа, которая запускает модель, выполняет этот вызов и возвращает результат обратно в диалог. Модель видит ответ и продолжает работу.
Модель может при этом не работать с файлами напрямую. Она не обязана знать пути и структуру папок: она просит «прочитай память про тесты», а где и как это хранится, решает реализация. Под инструментом может лежать папка с markdown-файлами, база данных или что-то ещё. Это также даёт контроль: можно ограничить, что именно модель может читать и писать, и проверять записи до сохранения.
Чтение нужно, чтобы подгрузить знания в контекст. Запись создаёт новое. Редактирование меняет точечно, без перезаписи всего файла, поэтому меньше риска потерять соседние сведения.
Skills спешат на помощь
Skill - это набор инструкций для определённого типа работы. Если память хранит факты («тесты запускаются командой X»), то skill хранит порядок действий («как выпустить релиз: что проверить, какие команды запустить, что делать при ошибке»).
Физически skill - это папка с файлом SKILL.md. В начале файла стоит короткое описание: как называется skill и когда его применять. Ниже идёт сама инструкция, а при необходимости рядом лежат вспомогательные файлы: шаблоны, скрипты, примеры.
Работает это так. Агент постоянно видит только список доступных skills с их описаниями, поэтому их может быть много без затрат на контекст. Когда задача совпадает с описанием, агент загружает полную инструкцию и следует ей. Пользователь может и сам вызвать skill по имени.
Отличие от заметок в памяти в том, что skill - это переиспользуемая процедура. Его можно положить в общую папку и применять в разных проектах, а заметка обычно привязана к конкретному проекту. Поэтому правила организации работы удобнее держать в skills, а сведения о конкретном проекте - в памяти или в CLAUDE.md.
Хороший skill описывает не только шаги, но и типичные ошибки и способы их проверить. Плохо написанный skill с расплывчатым описанием либо не сработает, когда нужен, либо сработает не в тот момент.
В skill могут лежать не только текст инструкции, но и исполняемые вещи. В папке рядом с SKILL.md можно положить скрипты, например на Python или PowerShell, которые агент запускает так же, как обычные команды. Туда же кладут шаблоны документов, примеры входных и выходных данных, конфиги, справочные таблицы. Инструкция в SKILL.md говорит агенту, когда и какой файл использовать.
Скрипт полезен там, где нужна точность: проверить, что тесты прошли, собрать отчёт по строгому формату, переименовать сотни файлов по правилу. Модель может ошибиться, если попросить её сделать это текстом, а скрипт сделает одинаково каждый раз. Поэтому в хорошем skill инструкция обычно звучит так: запусти вот этот скрипт и проверь результат, а не «сделай вручную».
Есть и ещё более мощный вариант: skill может подключать внешние инструменты, то есть давать агенту доступ к сервисам через подключенные серверы или API. Тогда skill описывает, как работать с конкретной системой, например с трекером задач или базой данных.
Скрипт из skill выполняется на вашей машине с вашими правами, поэтому запускать чужие skills без проверки небезопасно: их нужно читать так же внимательно, как любой чужой код.
Skills добавляют процедурную сторону: не только «что известно», но и «как выполнять определённый тип работы».
Структурированная память
memory/
   project/architecture.md
   project/tests.md
   team/conventions.md
   preferences/writing.md
   archive/…
Это иллюстрация, а не обязательная структура. Полезно отделить правила организации, заметки конкретного проекта, предпочтения пользователя и временные выводы задачи. Иначе агент однажды применит договорённость одной команды к другому проекту просто потому, что обе заметки нашлись по слову «deploy».
Итого у нас есть:
1. Запись. Во время работы агент решает, что стоит сохранить: договорённость команды, предпочтение пользователя, найденную причину бага. Он создаёт или обновляет markdown-файл, и это обычная операция записи.
2. Индекс. В начале сессии агент читает короткий файл-оглавление, по одной строке на заметку, например - [Тесты](project/tests.md) — как запускать. Сами заметки в контекст не грузятся, только список. Это та же роль, что у MEMORY.md в моей собственной памяти.
3. Чтение по необходимости. Когда задача совпадает с заметкой, агент открывает нужный файл. Так в контекст попадает только то, что нужно сейчас, и это решает проблему раздутого CLAUDE.md из прошлого.
4. Поиск. Если индекса не хватает, агент ищет по содержимому обычными средствами (grep, поиск по имени файла). Поэтому структура папок и понятные имена важны: поиск работает только по тем словам, которые реально есть в тексте.
5. Редактирование. Память не статична, агент строит ее самостоятельно.
Из чего состоит запись памяти
Чтобы не быть голословным, давайте посмотрим на пример. Агент работает с определенным документом, в котором есть ошибка. Он выяснил, что источник ошибки кроется в неверном импорте данных из хранилища. В соседней сессии эти сведения могут пригодиться снова. Но если просто записать «таблица ломается», через неделю никто не поймёт, какая таблица, где она ломается и исправили ли ее вообще.
Условная запись в Markdown могла бы выглядеть так:
---
 id: docx-table-empty-cell
 scope: project/translator
 type: investigation
 status: needs_recheck
 source: session-123 / turn-45
 updated: 2026-11-04
 ---
 # Пустая ячейка в DOCX
 В сессии воспроизведено расхождение при импорте
 таблицы с пустой ячейкой. Проверить текущий код
 и тестовый файл перед выводом о причине.
Здесь id помогает найти и обновить запись, scope ограничивает проект, type показывает характер заметки, а status говорит, что сведения нужно перепроверить. source позволяет вернуться к исходной сессии, updated — понять возраст записи. Текст оставляет возможность, что код уже изменился. Значения в примере вымышлены; такие поля — вариант устройства, а не обязательный формат.
Обратите внимание: дата сама по себе не сообщает, что факт устарел. Команда запуска теста может быть актуальна годами, а информация о работающей версии сервиса — устареть через минуту. Поэтому для разных типов памяти нужны разные правила проверки. Иначе однажды агент радостно сообщит пользователю, что всё развёрнуто, потому что полгода назад кто-то оставил ему такую заметку.
Запомнить — не значит вывалить всё в контекст
Допустим, у нас накопилась тысяча заметок. Технически можно отправлять их все в каждом запросе. Чем больше нерелевантного текста мы подмешиваем, тем больше платим за обработку и тем сложнее модели найти нужное среди соседних фактов.
Поэтому память полезно читать постепенно. Сначала определить область задачи и посмотреть краткий индекс или метаданные, затем найти подходящие записи по ключевым словам и при необходимости семантическим поиском, после чего открыть только те фрагменты, которые действительно нужны. Поиск по смыслу полезен, когда пользователь и автор заметки называют одну вещь по-разному. Точный поиск хорош для имён файлов, кодов ошибок и идентификаторов. Ни один из них не гарантирует, что найденная запись истинна.
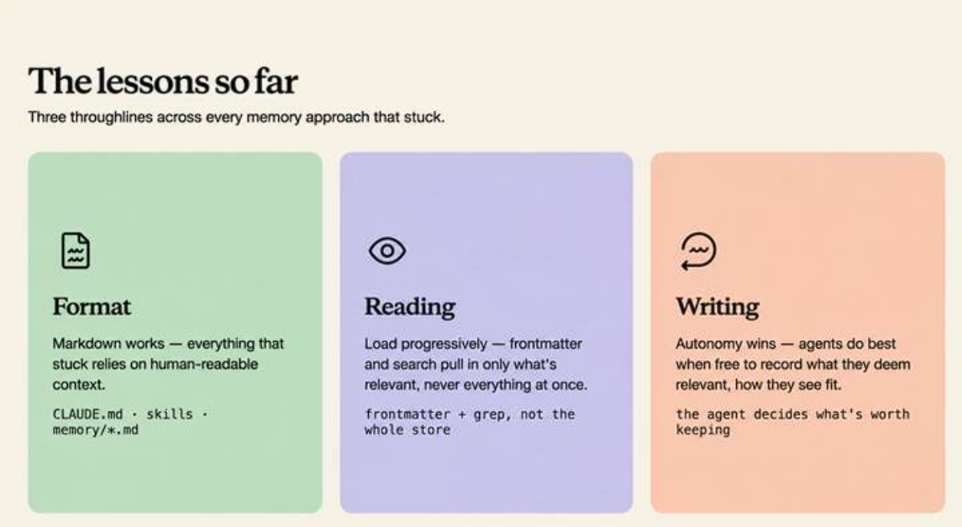
Пример. Пользователь просит исправить импорт таблицы. Агент находит заметку о расположении обработчика DOCX и прошлом дефекте с пустой ячейкой. Затем открывает текущий код и тесты. Если заметка описывает старую ветку, это не повод уверенно объявлять старую причину новой ошибкой. Память помогает сократить поиск; она не освобождает от проверки.
Для записи пригодятся тема, область действия, дата, источник и оговорки. Короткая заметка «тест сломан» почти бесполезна. Запись «при запуске без зависимости X тест Y завершился ошибкой; на окружении Z не проверено» даёт следующему агенту направление и границы знания. Важные решения полезно снабжать ссылкой на исходный документ или изменение, если у читателя есть к ним доступ.
Пример: как агент получает нужную память
запрос + текущий проект + права
   → поиск по индексу памяти
   → отбор записей в разрешённой области
   → чтение нескольких подходящих заметок
   → проверка текущего кода и тестов
   → решение задачи
   → кандидат на обновление памяти
Сначала система получает идентификатор проекта и проверяет, какие разделы памяти пользователь и агент вправе читать. Затем ищет по словам DOCX, таблица и пустая ячейка; при необходимости добавляет поиск по смыслу. Из найденного отбирает несколько заметок по области действия, связи с запросом и актуальности. Если хороших совпадений нет, агент продолжает исследование без них, а не притягивает первую попавшуюся заметку к задаче.
Допустим, нашлась запись из предыдущего примера. Агент открывает упомянутый тест, проверяет текущую версию обработчика и пытается воспроизвести проблему. Если ошибка подтверждена, он исправляет код и обновляет заметку, указывая основание. Если не подтверждена - фиксирует условия проверки и неопределённость. Одно лишь отсутствие ошибки при одном запуске ещё не доказывает, что она исправлена во всех условиях.
При таком подходе в запрос модели не уезжает весь каталог памяти. Точный лимит записей и токенов настраивается вашей системой. Слишком строгий лимит может отрезать важный контекст, слишком щедрый снова превратить каждый запрос в переезд библиотеки.
Агент сам пишет память. Что может пойти не так?
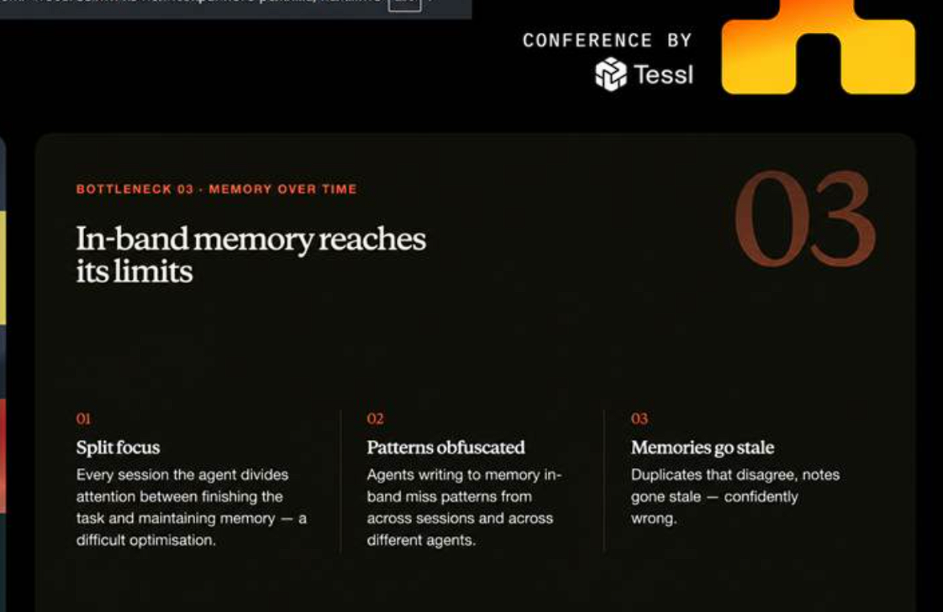
Кажется заманчивым поручить агенту самому решать, что стоит запомнить. Человек не обязан после каждой задачи писать ему методичку, а найденные решения могут пригодиться следующим сессиям. Именно это имеется в виду под накоплением опыта на уровне системы: веса модели при этом не обязательно меняются. Мы сохраняем и позже подаём ей сведения, а не проводим дообучение.
Но агент решает задачу и одновременно выбирает, что сохранить. Он может пропустить важное, записать случайный вывод как правило или перенести в память фрагмент недоверенного документа с чужой инструкцией. А ещё одна сессия видит лишь свою часть картины: в ней ошибка встретилась один раз, тогда как в десяти других на неё наступили все остальные агенты.
Наконец, память стареет. Проект переехал, настройку изменили, тест починили, а запись осталась. Через месяц она звучит так же уверенно, как в день создания. Поэтому записям нужны источник, область применимости, механизм обновления и возможность удалить или отозвать неверный вывод. Не всякое повторение делает утверждение верным: десять агентов могут повторить одну и ту же ошибку из одной и той же устаревшей заметки.
Память для многих агентов: версии, хэши и права
Когда агент один и заметки правит только он, файлов может хватить надолго. Когда агентов много, начинается обычная разработка распределённых систем, которую никто не отменял только потому, что теперь в ней участвует LLM.
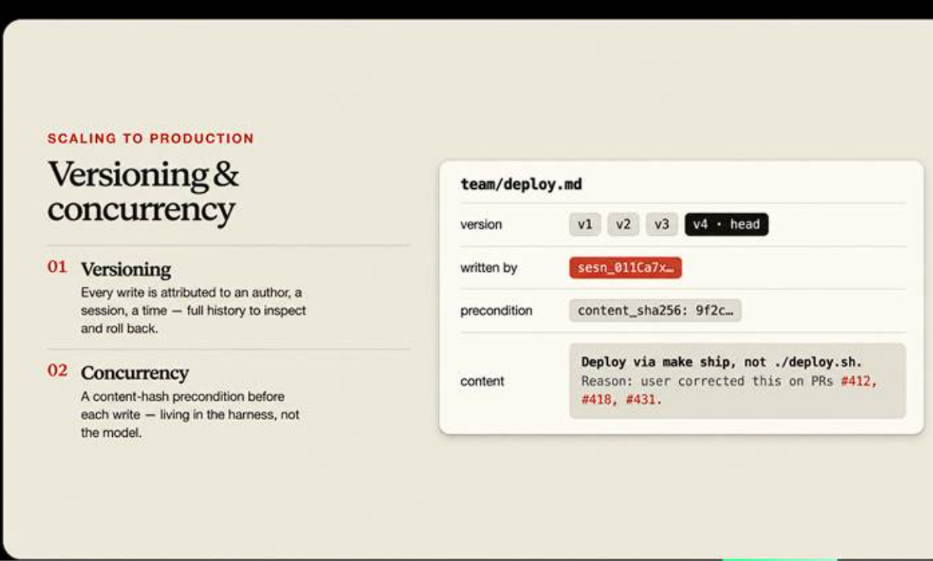
Представим: два агента одновременно прочитали tests.md. Первый добавил информацию о новой команде. Второй, работая со старой копией, записал свой текст поверх файла. Изменение первого исчезло. Модель может быть очень сильной, но от гонки записи её интеллект не спасёт.
На слайде предлагается проверять хэш содержимого как условие записи. Агент читает файл и получает его версию или хэш. Перед записью хранилище атомарно сравнивает ожидаемое значение с текущим. Если совпало, то сохраняет новую версию. Если нет, то отклоняет запись как конфликт: агент перечитывает актуальный файл, сравнивает изменения и при необходимости готовит обновление заново. Проверка и запись должны составлять одну атомарную операцию; отдельная проверка с последующей обычной записью сама оставляет окно для гонки.
current = store.read(path)                 # содержимое и версия
 proposal = make_update(current.content)	# предлагаемые изменения
 store.write_if_version(                    # атомарная условная запись
 	path, proposal, expected=current.version
 )
Это схема интерфейса, не готовая реализация. Хэш здесь помогает обнаружить изменение содержимого, а не оценить правильность новой заметки. Для истории полезно отдельно хранить автора, сессию, время, версию, источник и предыдущие изменения. Тогда ошибочную запись можно найти и откатить.
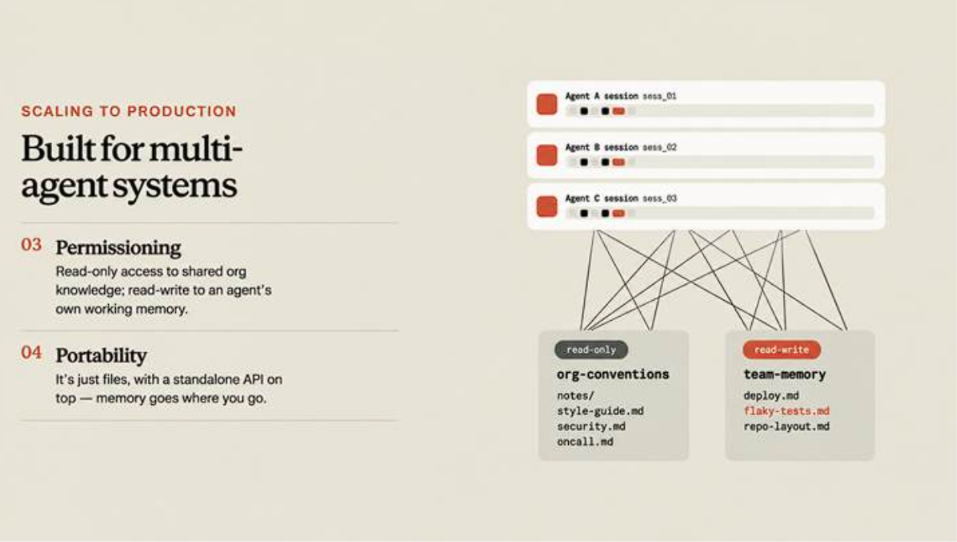
Права тоже должны обеспечиваться вне модели. Общие правила организации могут быть доступны агенту только для чтения, а рабочие заметки команды — для чтения и записи. Личные сведения, данные клиентов и записи разных проектов нельзя смешивать в одну доступную всем папку. Путь к файлу и инструкция в промпте сами по себе не являются системой авторизации: область доступа нужно проверять при каждом чтении и каждой записи.
Переносимость файлов удобна, но не равна разрешению копировать их куда угодно. Вместе с памятью между средами должны переноситься только те данные, для которых это разрешено. Иначе мы действительно решим проблему кросс-сессий, одновременно создав проблему утечки данных.
Пример: два агента меняют одну заметку
Чтобы было понятно, зачем здесь вообще хэш, рассмотрим последовательность событий. Пусть файл tests.md содержит версию v1: «Запускайте тесты командой pytest».
Агент А и агент Б одновременно читают v1. А выясняет, что для тестов DOCX нужна дополнительная зависимость. Б выясняет, что интеграционные тесты требуют отдельного сервиса. Оба готовят изменения к одному и тому же исходному тексту.
А записывает v2. После этого Б пытается записать результат, рассчитанный на v1. Хранилище сравнивает ожидаемую версию v1 с текущей v2 и возвращает конфликт. Б перечитывает v2, видит изменение А, добавляет своё уточнение и повторяет запись уже с условием expected=v2. Если за это время файл снова изменился, цикл повторяется с ограничением попыток либо конфликт передаётся на разбор.
В итоге ни одно из двух изменений не должно молча потеряться. При этом если А написал «зависимость обязательна», а Б — «зависимость больше не нужна», механизм версий не разрешит смысловое противоречие. Он лишь не даст незаметно затереть запись. Разобраться, какая информация актуальна, всё равно придётся по коду, тестам и другим источникам.
Dreaming: когда агентам дают время разобрать тетрадки
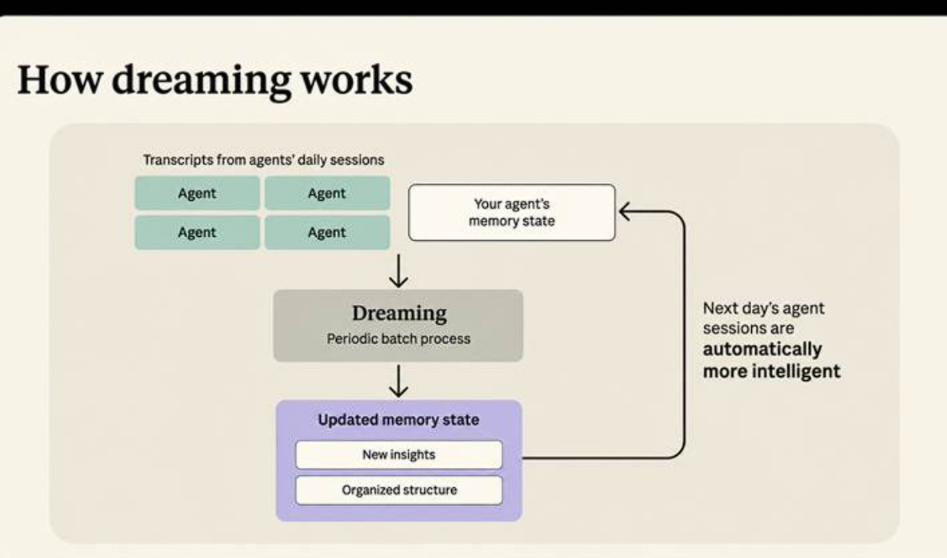
Вот мы и добрались до сновидений.Dreaming - это отдельная пакетная обработка, которая запускается вне обычного выполнения пользовательской задачи. На вход подаются текущая память и записи нескольких сессий. На выходе получается пересмотренное хранилище или предложения по его изменению.
В выступлении приводтся неплохая аналогия: учитель проверяет работы учеников и замечает, что почти все ошибаются в одном месте. Возможно, проблема не в каждом ученике отдельно, а в том, что в учебном плане не объяснена нужная тема. Тогда имеет смысл исправить материал, а не надеяться, что следующий ученик случайно догадается сам.
В агентской системе такой процесс может заметить, что разные агенты снова и снова ищут один и тот же файл, получают одинаковую ошибку инструмента или игнорируют важное ограничение. После этого он проверяет, есть ли подходящая запись, не устарела ли она и не стоит ли добавить объяснение. Ошибка инструмента - повод исследовать инструмент или его конфигурацию, а не автоматически менять настройки production по результатам чтения логов.
Что происходит во время одного прохода
На слайде показана конкретная схема: исходное хранилище клонируется в выходное, оркестратор запускает субагентов для сессий, а те читают и изменяют выходную копию. Это удобный способ разбирать несколько историй параллельно. Но сама по себе копия ещё не решает конфликтов между субагентами и не доказывает правильность их выводов.
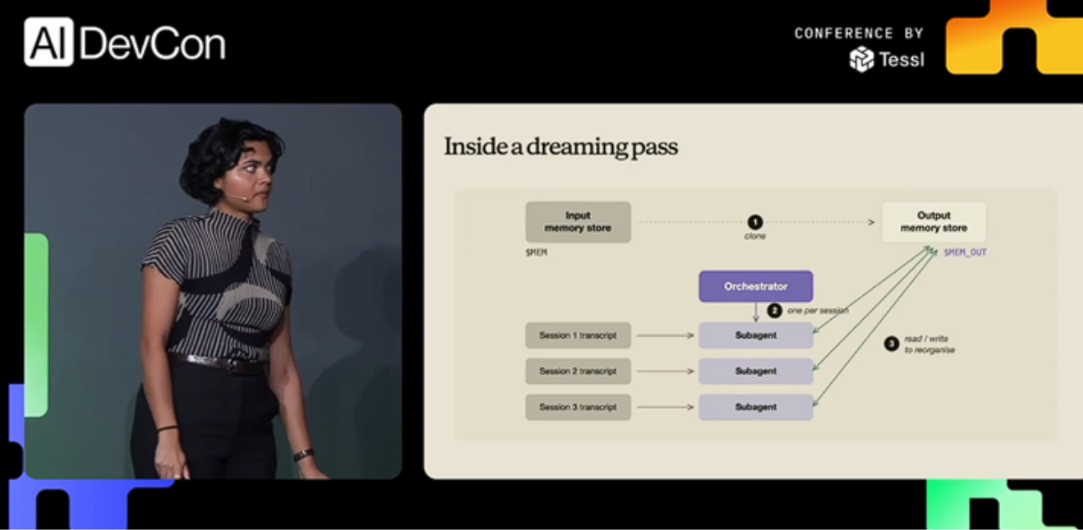
В собственной реализации я бы разделил этот процесс на понятные шаги:
1. Выбрать набор завершённых сессий и зафиксировать версию памяти, относительно которой идёт анализ. Ограничить доступ к транскриптам и убрать данные, которые не нужны для разбора.
2. Раздать сессии субагентам. Попросить не просто сделать summary, а найти повторяющиеся затруднения, исправления пользователя, противоречия памяти и факты с указанием источника.
3. Собрать наблюдения у оркестратора. Он может запросить дополнительные примеры, проверить повторяемость и отличить единичную ошибку от устойчивого паттерна.
4. Подготовить изменения: добавить заметку, уточнить область действия, объединить дубликаты, отметить устаревшую запись или предложить её удаление. Рядом сохранить основания и неопределённость.
5. Проверить изменения и применить их с учётом прав и версии исходной памяти. Для чувствительных или широких изменений предусмотреть просмотр человеком; при конфликте с новым содержимым пересобрать предложение.
6. Проверить результат на отложенных задачах и наблюдать, помогает ли новая память. Если стало хуже, вернуться к предыдущей версии и выяснить почему.
Это предлагаемая схема проверки, а не утверждение, что все перечисленные стадии в точности реализованы в показанной системе Anthropic. Например, на слайде субагенты работают с выходной копией; в другом дизайне они могут только предлагать изменения, а применять их будет отдельный сервис. Главное, чтобы человек мог понять, откуда взялось новое правило и как его отменить.
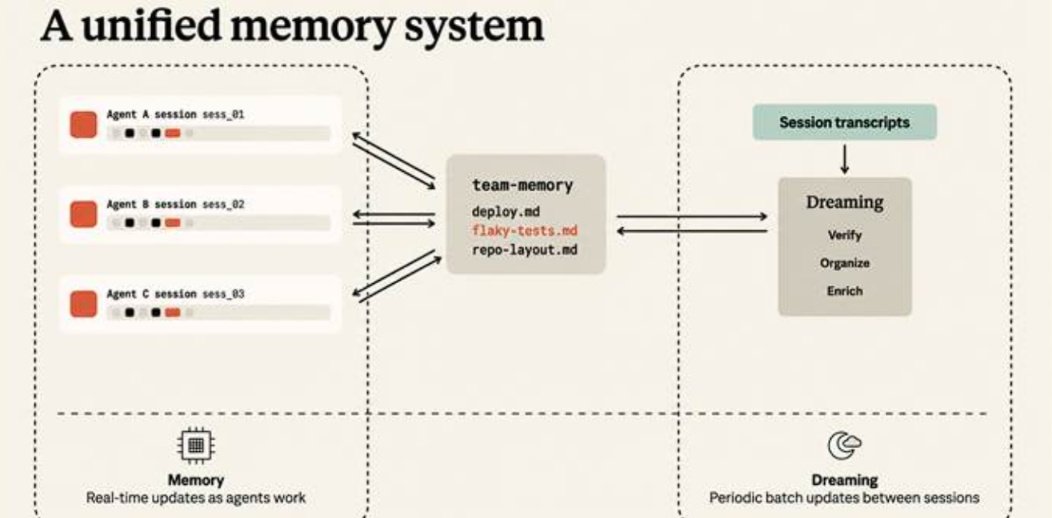
Итого получаются два связанных процесса. Во время работы агент читает нужную память и может сохранить полезное наблюдение. Между сессиями отдельный процесс рассматривает более широкую картину, находит противоречия и приводит память в порядок. Второй процесс не заменяет первый: немедленно полезный факт незачем откладывать до ночной обработки. И наоборот, текущая сессия не обязана в одиночку разбирать всю историю организации.
Пример: что именно может найти dreaming
Допустим, за день прошло 20 сессий с задачами на импорт документов. В пяти из них агент безуспешно запускает интеграционный тест, потому что сервис зависимости не поднят. В трёх пользователь объясняет, как его запустить. Ещё в двух агент обходит тест и помечает проверку неполной.
Отдельный агент в каждой из этих сессий может решить свою задачу и записать частный результат. А процесс dreaming получает возможность увидеть общую картину: проблема повторяется, существующая заметка о тестах не описывает обязательную зависимость, а исправление пользователя встречается в нескольких независимых сессиях.
Кандидат на изменение памяти мог бы выглядеть так:
Файл: project/tests.md
 Предложение: дополнить раздел интеграционных тестов.
 Наблюдение: в 5 из 20 изученных сессий тест не
 запустился без сервиса зависимости.
 Основания: session-02, session-07, session-11,
 session-14, session-19.
 Ограничение: причина требует проверки по конфигурации
 и актуальной документации проекта.
Числа и идентификаторы здесь условные. Обратите внимание на знаменатель: «пять сессий» звучит иначе, если всего их было шесть, а не двадцать. Само повторение ошибки ещё не проверяет причину: например, все пять сессий могли использовать одну неправильную инструкцию. Прежде чем менять заметку, нужно сверить конфигурацию и выполнить подходящую проверку.
Если подтверждено, в память добавляется короткая инструкция запуска зависимости и ссылка на её источник. Если нет - можно сохранить гипотезу как требующую проверки или вообще ничего не менять. А если выяснилось, что сбоит сам инструмент, это отдельная задача на диагностику. Переписать заметку «инструмент работает» в «инструмент не работает» на основании пяти похожих traceback-ов ещё не починить инструмент.
А теперь немного саморекламы: Code Memory для DeepSeek Harness
Пока я разбирался с организацией памяти агентов, у меня появился собственный плагин Code Memory (CM) для DeepSeek Harness. Он решает более узкую задачу, чем dreaming из выступления: помогает агенту находить в проекте подходящий исходный код и получать его в компактном виде. Это память о структуре кода, а не система, которая по транскриптам самостоятельно формирует новые правила и делает выводы за несколько сессий.
Мотивация довольно приземлённая. Агенту дали задачу исправить функцию. Он делает glob, затем grep, затем читает файл, затем ищет вызовы, затем читает ещё три файла, потому что на всякий случай. После чего в историю попадает столько исходного кода, что счёт за токены уже начинает интересовать бухгалтерию. Идея CM - заранее разобрать проект и по запросу собрать для модели небольшой контекст с нужными точками входа и связями.
https://github.com/kobubu/Rag-Coding
Ниже приведена таблица экономии токенов и ускорении работы с помощью Code Memory
CM versus no CM | Codex, GPT-6 Luna | Claude Code, Sonnet 5.5 |
|---|---|---|
Independently checked solutions | 41/42 vs 40/42 | 42/42 vs 42/42 |
Total model tokens | 58.0% fewer | 40.4% fewer |
Estimated / reported price | 29.0% lower | 18.0% lower |
Total session time | 35.9% lower | 35.1% lower |
Median session | 7.3 s vs 12.2 s | 12.4 s vs 18.7 s |
Продолжение следует.
Телеграм канал автора, где он что‑то пишет про ML, NLP и разработку
Теги:
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.