30 тысяч проверок в секунду на двух ядрах
В публикации о библиотеке cuallee в Journal of Open Source Software приведён показательный бенчмарк. Авторы проверяли датасет NYC Taxi объёмом 19,8 млн строк. Всего выполнялось 38 проверок: 19 на полноту и 19 на уникальность значений в колонках. Результаты выглядели так. [1]
Инструмент | Версия в публикации | Время выполнения |
Great Expectations | 0.18.13 | 66 с |
Soda | 1.4.10 | 43 с |
PyDeequ | 1.3.0 | 11 с |
cuallee | 0.10.3 | 7 с |
Если разделить число строк на семь секунд, получится около 2,8 млн строк в секунду. Если дополнительно умножить его на 38 проверок, число станет ещё внушительнее. Но ни то ни другое не говорит, сколько стоит выполнение одного правила.
Проверки полноты и уникальности описывают свойства всего набора данных. Полнота может вычисляться агрегированием, уникальность — через подсчёт различных значений, группировку или другой план обработки. Движок (СУБД или Spark) может объединять совместимые вычисления, распараллеливать их и пользоваться оптимизациями хранения. Поэтому 38 проверок — это не обязательно 38 независимых проходов по данным и тем более не 38 отдельных программ для каждой строки.
Для своего сценария это полезный бенчмарк. Но он не отвечает на вопрос, сколько раз в секунду система сможет выполнить алгоритм проверки сложного JSON-объекта. Мы приводим его, чтобы показать: прежде чем сравнивать результаты, нужно договориться о единице работы. Версии и время в таблице взяты из публикации 2024 года и могли устареть.
Что именно выполняет Сервис исполнения правил
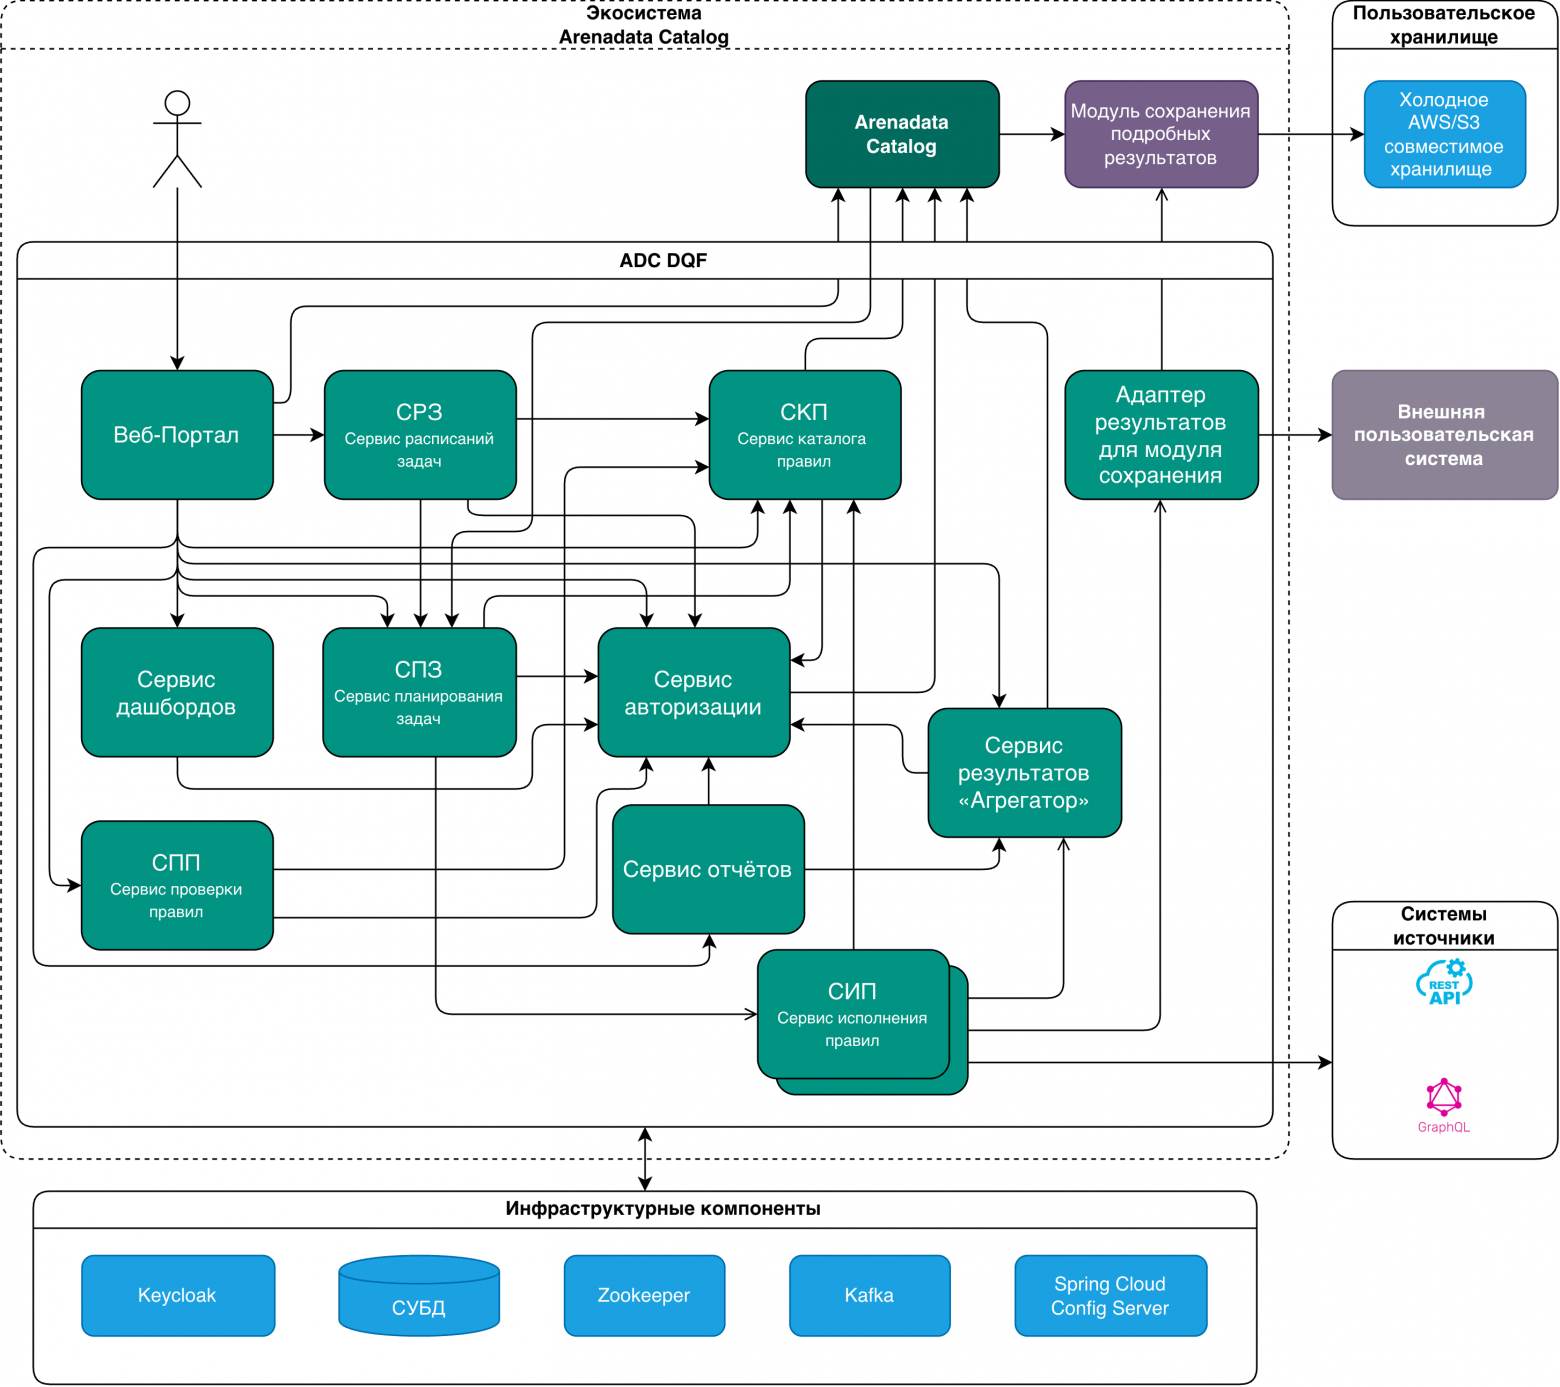
Сервис исполнения правил — СИП, — получает входной объект, исполняет над ним правило и формирует результат. Правила хранятся в каталоге, планировщик отправляет данные на проверку, а агрегатор результатов принимает результаты и строит статистику. [6]
На схеме ниже много сервисов, но в статье речь пойдёт только о четырёх:
СИП — сервис исполнения правил. Получает задания из Kafka, исполняет над каждым объектом правило на DQL и отправляет результат агрегатору. Его производительность — главная тема статьи.
Планировщик — на схеме СПЗ, сервис планирования задач. Принимает данные через API, разбивает их на атомарные задания и передаёт в СИП через топик Kafka.
Каталог правил — на схеме СКП, сервис каталога правил (DQF Complex Algorithms Storage Service, или CAS). Хранит правила и алгоритмы проверок; СИП загружает их оттуда и держит в локальном кэше.
Агрегатор — сервис результатов. Принимает результаты проверок, сохраняет их в базу данных и отдаёт результаты и статистику через API.
Правило на языке DQL (Data Quality Language) — это структурированная последовательность шагов. Шаг может проверить значение, преобразовать данные, сохранить промежуточный результат в контекст исполнения, обратиться к внешнему источнику или передать управление другой части алгоритма. Язык поддерживает ветвления, циклы и обработку коллекций. Правила описываются в YAML, но, по сути, могут быть небольшими программами над объектом. [5]
Например, алгоритм check_living_area_second проходит по массиву помещений, обрабатывает элементы в зависимости от условий, накапливает две величины и сравнивает их с исходными данными. Он использует промежуточные переменные, цикл и ветви обработки ошибок. Это уже заметно больше работы, чем одно сравнение поля с null.
Синтетический sample_algo ещё тяжелее. В нём есть операции над коллекциями, конкатенация строк, преобразования числовых типов, регулярные выражения, работа с метками времени, цикл while, арифметика и набор логических проверок. При этом значительная часть данных создаётся внутри самого алгоритма. Такой сценарий нужен, чтобы изучить, как исполняется язык; реальную бизнес-проверку он не моделирует.
Поэтому дальше под RPS СИП мы будем понимать количество завершённых исполнений конкретного правила над входным объектом в секунду. Одно исполнение может содержать несколько проверок и вычислений. Скорость чтения сообщений из Kafka, количество HTTP-запросов и количество элементарных проверок внутри правила — другие показатели.
Как мы проводили нагрузочные тесты
Чтобы измерить сам СИП, мы по возможности изолировали его от остальных компонентов DQF. Сначала сервис останавливали. Нагрузочный скрипт k6 создавал правило в каталоге и заполнял Kafka-очередь read_q необходимым количеством сообщений. Затем СИП запускали и снимали метрики, пока очередь не опустела. Такой сценарий позволял не путать пропускную способность исполнения со скоростью генератора нагрузки.
При этом в замер попадало не только вычисление выражений DQL: чтение и разбор сообщений, получение правила и формирование результата тоже входили в путь обработки.
В основных прогонах в Kafka было около 5 млн сообщений при двух потоках-слушателях сервиса исполнения правил. СИП тестировали с лимитом в один и два CPU, памятью 1 ГБ, одной репликой и уровнем логирования error. У всего стенда было 24 vCPU и 48 ГБ RAM, поэтому «два CPU» в результатах означает лимит СИП, а не ресурсы всей конфигурации.
Для каждого правила было два варианта входных данных. Первый — минимальный объект, содержащий только необходимые для сценария данные. Для random_rule и sample_algo это мог быть пустой объект: данные для вычислений создавались самим правилом. Второй — тот же объект плюс примерно 1 КБ дополнительных данных, которые правило не использует. В отчётах они называются «балластом».
С балластом размер сообщения ближе к реальному: в работающей системе объект редко состоит только из двух полей, нужных конкретному правилу. Но совпадение по размеру ещё не делает синтетический тест эквивалентом промышленной нагрузки.
Всего мы использовали четыре характерных алгоритма.
Правило | Что делает |
| Проверка ИНН физического лица |
| Обход массива помещений, вычисление и сверка площадей |
| Несколько преобразований и условных проверок с использованием времени |
| Составной синтетический сценарий с коллекциями, строками, регулярными выражениями, датами и циклом |
Под катом их имплементация на DQL:
check_inn_test
- SetValue:
    expr: $.objects
    result: $.variables.input
- CheckInn:
    config:
      allowPerson: true
      strict: true
    input:
      inn: $.objects.inn
    result: $.variables.checkLegalEntityResult
check_living_area_second
- SetValue:
    expr: 0
    result: $.variables.livingAreaCalculated
- SetValue:
    expr: 0
    result: $.variables.totalAreaCalculated
- SetValue:
    expr: $.objects
    result: $.variables.input
- for-each: $.variables.prem
  in: $.objects.premises
  do:
    - all-of:
        - CheckValue: $.variables.prem.type == "ROOM"
        - SetValue:
            expr: $.variables.livingAreaCalculated + $.variables.prem.area
            result: $.variables.livingAreaCalculated
      otherwise:
        - Continue: {}
    - SetValue:
        expr: $.variables.totalAreaCalculated + $.variables.prem.area
        result: $.variables.totalAreaCalculated
- CheckValue: $.variables.livingAreaCalculated == $.objects.livingArea
  otherwise:
    - SetValue:
        expr: '"Посчитанная жилая площадь не совпадает с заявленной"'
        result: $.variables.errorDescription
    - CheckValue: false
- CheckValue: $.variables.totalAreaCalculated == $.objects.totalArea
  otherwise:
    - SetValue:
        expr: '"Посчитанная общая площадь не совпадает с заявленной"'
        result: $.variables.errorDescription
    - CheckValue: false
random_rule
- SetValue:
    expr:
      in: $.objects
      time: now()
    result: $.variables
- SetValue:
    expr: int(format('ru', '{0, temporal, SSS}', timestamp($.variables.time)))
    result: $.variables.milli_num
- SetValue:
    expr:
      obj:
        - 0
        - 99
      str:
        - 100
        - 199
      int:
        - 200
        - 299
      boolean:
        - 300
        - 599
      nullable:
        - 700
        - 799
      decimal:
        - 800
        - 899
      arr:
        - 900
        - 984
      error:
        - 989
        - 995
    result: $.variables.holds
- CheckValue: >-
    !($.variables.milli_num >= $.variables.holds.error[0] &&
    $.variables.milli_num <= $.variables.holds.error[1])
  otherwise: # Тут генерируется гарантируемая ошибка
    - SetValue:
        expr: '''NaN'''
        result: $.variables.toExcept
    - CheckValue: ($.variables.toExcept + 1) > 200
# Просто сравниваем наши входные данные со "случайными" данными
- CheckValue: >
    ($.variables.milli_num >= $.variables.holds.obj[0] && $.variables.milli_num
    <= $.variables.holds.obj[1] && applicable($.objects, 'object'))

    || ($.variables.milli_num >= $.variables.holds.str[0] &&
    $.variables.milli_num <= $.variables.holds.str[1] && applicable($.objects,
    'string'))

    || ($.variables.milli_num >= $.variables.holds.int[0] &&
    $.variables.milli_num <= $.variables.holds.int[1] && applicable($.objects,
    'int'))

    || ($.variables.milli_num >= $.variables.holds.boolean[0] &&
    $.variables.milli_num <= $.variables.holds.boolean[1] &&
    applicable($.objects, 'bool'))

    || ($.variables.milli_num >= $.variables.holds.nullable[0] &&
        $.variables.milli_num <= $.variables.holds.nullable[1] &&
        $.objects == null)

    || ($.variables.milli_num >= $.variables.holds.decimal[0] &&
    $.variables.milli_num <= $.variables.holds.decimal[1] &&
    applicable($.objects, 'decimal'))

    || ($.variables.milli_num >= $.variables.holds.arr[0] &&
    $.variables.milli_num <= $.variables.holds.arr[1] && applicable($.objects,
    'length'))
sample_algo
- SetValue:
    expr:
      in: $.objects
      time: now()
    result: $.variables
- SetValue:
    expr: '42'
    result: $.variables.answer
- CheckValue: $.variables.answer == 42
  otherwise:
    - SetValue:
        expr: '"Установленное значение числа не равно ожидаемому (42)"'
        result: $.variables.errorDescription
    - CheckValue: false
- SetValue:
    expr: concat("Сформированная строка - ", 2, "плюс", 2.5, "=", fraction("18/4"))
    result: $.variables.concatResult
- SetValue:
    expr: concat($.variables.concatResult, ' и не равно ', null)
    result: $.variables.concatResult
- CheckValue: >-
    $.variables.concatResult == 'Сформированная строка - 2плюс2.5=9 / 2 и не
    равно null'
  otherwise:
    - SetValue:
        expr: '"Сформированная стрка не совпадает с ожидаемой"'
        result: $.variables.errorDescription
    - CheckValue: false
- SetValue:
    expr:
      - 3
      - 2
      - 3
    result: $.variables.initial_collection
- AppendValue:
    expr: 1*2 - 1
    result: $.variables.initial_collection
- Collect:
    items:
      extract: $.variables.initial_collection
      filter: int($.item) != 4/2
      transform:
        val: $.item
      unique: true
    result: $.variables.collection
- CheckValue: '$.variables.collection == [{"val": 3}, {"val": 1}]'
  otherwise:
    - SetValue:
        expr: '"Массив не совпадает с ожидаемым"'
        result: $.variables.errorDescription
    - CheckValue: false
- SetValue:
    expr: '[''response'', ''is'', 42, ''or'', 42.0]'
    result: $.variables.join_collection
- SetValue:
    expr: ''' '''
    result: $.variables.space
- CheckValue: >
    join($.variables.join_collection, $.variables.space) == 'response is 42 or
    42.0' &&  join(['это', 'статическая', 'коллекция', '!'], '--') ==
    'это--статическая--коллекция--!'
  otherwise:
    - SetValue:
        expr: '"Сформированный из массива текст не совпадает с ожидаемым"'
        result: $.variables.errorDescription
    - CheckValue: false
- CheckValue: true && (true || !true)
  otherwise:
    - SetValue:
        expr: '"Произошла ошибка при использовании логических операторов"'
        result: $.variables.errorDescription
    - CheckValue: false
- CheckValue: length($.variables.collection) == 2
  otherwise:
    - SetValue:
        expr: '"Произошла ошибка при использовании функции length"'
        result: $.variables.errorDescription
    - CheckValue: false
- SetValue:
    expr:
      - 33
      - '''test'''
      - null
    result: $.variables.test_collection
- CheckValue: 33 in $.variables.test_collection
  otherwise:
    - SetValue:
        expr: '"33 не входит в тестовую коллекцию"'
        result: $.variables.errorDescription
    - CheckValue: false
- CheckValue: 34 nin $.variables.test_collection
  otherwise:
    - SetValue:
        expr: '"34 входит в тестовую коллекцию"'
        result: $.variables.errorDescription
    - CheckValue: false
- SetValue:
    expr: '''^Нач'''
    result: $.variables.regexp
- SetValue:
    expr: '''Начало строки должно совпадать'''
    result: $.variables.regexpTest
- CheckValue: |
    $.variables.regexpTest =~ $.variables.regexp
    && '555' =~ '[0-9]{0,3}'
  otherwise:
    - SetValue:
        expr: '"Произошла ошибка при использовании регулярного выражения"'
        result: $.variables.errorDescription
    - CheckValue: false
- CheckValue: >
    shiftTimestamp('2023-01-01T10:01:00+03:00', 'P6M1D', 'Europe/Moscow') ==
    timestamp('2023-07-02T10:01:00+03:00')
  otherwise:
    - SetValue:
        expr: '"Не прошла проверка функционального вызова `shiftTimestamp`"'
        result: $.variables.errorDescription
    - CheckValue: false
- CheckValue: "format('ru', '{0}, {1}, {2}, {3}, {4}, {5}', null, true, 1, 3.14, fraction('1/3'), date('2023-01-01'))\n== 'null, true, 1, 3.14, 1 / 3, 2023-01-01' &&\nformat('ru', '{0, string, lower}, {1, string, upper}', 'Тест', 'снилс') == 'тест, СНИЛС' &&\nformat('ru', '{0, number,}, {0, number,,##.00}', 1234567) == '1\_234\_567, 1\_23\_45\_67,00' &&\nformat('ru', '{0, temporal, dd.MM.y}, {0, temporal, HH:mm:ss}', timestamp('2023-01-01T02:01:37+03:00')) ==\n'01.01.2023, 02:01:37'\n"
  otherwise:
    - SetValue:
        expr: '"Не прошла проверка функционального вызова `format`"'
        result: $.variables.errorDescription
    - CheckValue: false
- SetValue:
    expr: 2
    result: $.variables.BASE_NUM
- SetValue:
    expr: 1
    result: $.variables.twoToTenthPower
- SetValue:
    expr: 1
    result: $.variables.i
- while: $.variables.i <= 10
  do-at-least-once:
    - SetValue:
        expr: $.variables.i + 1
        result: $.variables.i
    - SetValue:
        expr: $.variables.twoToTenthPower * $.variables.BASE_NUM
        result: $.variables.twoToTenthPower
- CheckValue: $.variables.twoToTenthPower == 1024
  otherwise:
    - SetValue:
        expr: '"Не прошла проверка встроенного алгоритма `while`"'
        result: $.variables.errorDescription
    - CheckValue: false
Четыре разных алгоритма позволяют увидеть зависимость скорости от сложности правила.
Что получилось
В прогонах без балласта проверка ИНН достигла 15 851 RPS на одном CPU. Более сложные правила работали медленнее, а переход на два CPU ускорил все четыре алгоритма.
Правило | Max RPS 1 CPU | Max RPS 2 CPU | Рост |
check_inn_test | 15 851 | 30 457 | ×1,92 |
random_rule | 4 272 | 9 267 | ×2,17 |
check_living_area_second | 3 094 | 6 778 | ×2,19 |
sample_algo | 1 381 | 3 177 | ×2,30 |
Рост больше чем вдвое ещё не доказывает сверхлинейного масштабирования: мы сравниваем Max RPS отдельных прогонов, а не средние по серии повторов с оценкой разброса. Корректнее сказать так: при переходе с одного CPU на два производительность всех четырёх алгоритмов выросла примерно вдвое.
Влияние размера сообщения
Теперь посмотрим, что изменил дополнительный килобайт данных. Сведём все четыре алгоритма в одну таблицу.
Правило | 1 CPU без балласта | 1 CPU с балластом | 2 CPU без балласта | 2 CPU с балластом |
| 15 851 | 11 752 | 30 457 | 21 878 |
| 4 272 | 3 733 | 9 267 | 8 462 |
| 3 094 | 3 062 | 6 778 | 6 537 |
| 1 381 | 1 316 | 3 177 | 2 948 |
Для check_living_area_second балласт практически не изменил результат: 3094 → 3062 RPS на одном CPU и 6778 → 6537 на двух. Для тяжёлого sample_algo эффект тоже оказался сравнительно небольшим: 1381 → 1316 и 3177 → 2948 соответственно.
А вот простая и очень быстрая проверка ИНН чувствительнее к дополнительным расходам: на одном CPU Max RPS снизился с 15 851 до 11 752, на двух — с 30 457 до 21 878.
Так и должно быть. Чем меньше времени занимает само правило, тем бо́льшую долю полной стоимости обработки могут занимать передача, сериализация и разбор сообщения. Чем тяжелее алгоритм, тем меньше на его фоне значит лишний килобайт входных данных. Правда, это наша интерпретация: профилирование по этапам мы не проводили.
Что ограничивает производительность DQF
Цифра в 30 тысяч исполнений в секунду хорошо смотрится сама по себе. Но для эксплуатации гораздо интереснее другой вопрос: что должно произойти, чтобы эти 30 тысяч превратились в 15, 5 или вообще в ноль? Нагрузочное тестирование выявило несколько таких факторов.
Кэш правил
Чтобы выполнить проверку, СИП должен знать, какой алгоритм применить к входному объекту. Запрашивать описание алгоритма в каталоге для каждого сообщения было бы слишком дорого, поэтому алгоритмы кэшируются прямо в сервисе исполнения.
В одном из ранних тестов использовался другой, более разнообразный профиль: 88 правил и 365 алгоритмов форматно-логического контроля (ФЛК), равномерно распределённых по потоку сообщений. На двух CPU максимальная пропускная способность составила около 1650 RPS. Условия тоже отличались (2 ГБ памяти, уровень логирования INFO), поэтому сравнивать этот результат с check_inn_test напрямую нельзя.
Затем мы искусственно увеличивали долю обращений, при которых нужного алгоритма не было в локальном кэше. Когда промахов кэша было около 20%, производительность падала почти вдвое, а при 50% обработка фактически останавливалась: узким местом становились CAS и скорость получения и обработки алгоритмов.
Этот тест показывает, что производительность DQF нужно рассматривать как минимум в двух режимах. В установившемся режиме основную работу составляет исполнение правила. При массовых промахах кэша характер нагрузки меняется: СИП начинает зависеть от задержки и пропускной способности каталога.
Поэтому замер только одного режима может ввести в заблуждение. Ранний тест показывает, насколько важен кэш, но переносить те же проценты падения на четыре алгоритма из основного теста нельзя.
Стоимость аудита
В том же раннем исследовании отдельно включали отправку событий аудита во внешнюю систему. В тех условиях это снижало пропускную способность в среднем примерно на 20%.
Эта цифра не универсальна и зависит от объёма событий, конфигурации и сценария. Но она напоминает о том, что легко упустить при сравнении DQ-продуктов: скорость вычислительного ядра и скорость всей промышленной системы — разные вещи.
У чистого алгоритма путь выглядит как «вход → правило → результат». В полном процессе к нему могут добавиться приём и авторизация, получение правила, аудит, транспорт результатов, сохранение и агрегация. Поэтому максимальный RPS СИП нельзя выдавать за производительность всего DQF.
Производительность остальных сервисов
DQF — это не только СИП. Если он обрабатывает десятки тысяч сообщений в секунду, планировщик, каталог и агрегатор должны выдерживать соответствующую нагрузку, иначе начнёт расти очередь.
Планировщик
У планировщика отдельно измеряли внешнюю и внутреннюю пропускную способность. Внешняя — это скорость приёма данных через API и отправки их в виде атомарных заданий в СИП через топик Kafka. Здесь хорошо видно, как влияет размер пачки. Скорость в таблице считается во входных объектах, а не в HTTP-запросах.
Объектов в запросе | Приблизительная скорость приёма объектов в секунду |
1 | 521 |
10 | 3 820 |
100 | 11 900 |
1 000 | 18 000 |
10 000 | 20 000 |
Это хороший пример того, почему скорость API в запросах и скорость обработки в объектах — разные метрики. Если в одном HTTP-запросе тысяча объектов, системе не нужно тысячу раз платить за HTTP-взаимодействие, аутентификацию, создание транзакции и сопутствующие операции.
Во внутренних тестах планировщика меняли размер буфера и задержку между отправками сообщений в СИП. В зависимости от настроек скорость составляла десятки тысяч сообщений в секунду; при отключённом СИП отдельные конфигурации доходили примерно до 30 тыс. RPS.
С включённым СИП внутренняя пропускная способность планировщика упиралась в скорость потребителя. В отчёте отдельно отмечено, что она приближалась к показателям нагрузочных тестов СИП. Настраивая размер буфера и темп отправки, можно согласовать скорость производителя и потребителя.
Агрегатор
Агрегатор (сервис результатов) тестировали отдельно. С одним обработчиком Kafka внутренняя пропускная способность составляла около 6200 сообщений в секунду, с двумя — около 11 000. Сервис был ограничен двумя CPU и примерно 2 ГБ памяти.
Масштабирование заметно, но возникает другое ограничение — работа с базой данных. Чем больше в ней становилось сохранённых результатов, тем сильнее снижалась скорость API-запросов. Производительность /results/{taskId} и /statistics/{taskId} зависела от объёма данных в БД и настроек пула соединений.
Это также показывает, почему изолированные максимумы нельзя сложить в обещание для всей системы. СИП в одном тесте достигал около 30 тысяч исполнений в секунду, а один Агрегатор с двумя обработчиками в своём сценарии — около 11 тысяч сообщений. При сопоставимом потоке результатов производительность последующего этапа нужно учитывать отдельно: при 30 тыс. исполнений в секунду узким местом станет один агрегатор (~11 тыс./с), и его нужно масштабировать отдельно.
На каждом этапе узкое место своё. У планировщика важны размер пачки и скорость формирования сообщений. У СИП — CPU, сложность алгоритма и попадание в кэш. У Агрегатора — число потребителей и скорость сохранения результатов. У API результатов — структура запросов, объём накопленных данных и работа СУБД.
Поэтому фраза «DQF выдерживает X RPS» без уточнения сервиса и сценария была бы некорректной.
Производительность и эксплуатационная нагрузка
Во всех приведённых тестах основная цифра — Max RPS. Вместе с графиками ресурсов он помогает оценить предельную скорость, сравнить конфигурации и найти узкие места. Но Max RPS — не SLA.
Из результата «check_inn_test — 30 457 RPS» нельзя автоматически заключить, что промышленная инсталляция сможет круглосуточно обрабатывать 30 457 объектов каждую секунду.
Для расчёта мощности под реальную эксплуатацию нужно знать:
устойчивая пропускная способность на длительном интервале;
задержки p95 и p99;
загрузка CPU и памяти, работа сборщика мусора;
скорость роста очередей;
поведение при промахах кэша;
восстановление после всплесков нагрузки;
запас до насыщения ресурсов.
Пиковая пропускная способность показывает возможности движка в конкретном тесте, но для выбора допустимой постоянной нагрузки её недостаточно. Наши результаты описывают вычислительную мощность СИП и то, как он масштабируется в контролируемых условиях, но гарантий для произвольной конфигурации DQF не дают.
Модели исполнения в инструментах Data Quality
Теперь можно вернуться к Great Expectations, Soda и Deequ. С точки зрения пользователя, они решают одну задачу: описать требования к качеству данных и проверить, выполняются ли они. Но путь от правила до процессора у них разный.
Great Expectations поддерживает исполнение через Pandas, Spark и SQLAlchemy. Для Spark и SQL несколько совместимых метрик могут объединяться в одну группу вычислений и выполняться вместе — так это описано в документации Execution Engine версии 0.18, взятой именно в этой версии ради сопоставимости с бенчмарком cuallee. [2]
В типичном SQL-сценарии Soda превращает проверки на SodaCL в запросы к источнику данных. Основные вычисления идут на стороне источника, и весь набор данных в Soda обычно не передаётся. Отдельные функции, например, получение примеров ошибочных строк, могут требовать передачи части данных. [3]
Deequ построен поверх Apache Spark и предназначен для вычисления метрик качества на больших наборах данных. PyDeequ предоставляет для него Python-интерфейс. [4]
Условно можно выделить две модели. В первой определение проверки превращается в SQL-запрос или план Spark, который выполняется над датасетом. Она хорошо подходит для проверок полноты, уникальности, количества строк, распределений, min/max и других статистических характеристик. Совместимые метрики можно считать вместе, хотя за один проход это получается не всегда.
Во второй модели каждый объект передаётся правилу и получает собственный результат. Так работает DQF СИП. Здесь правило может быть алгоритмом: проверить несколько атрибутов, пройти по вложенному массиву, посчитать производные значения, выбрать ветвь, при необходимости обратиться к справочнику и сформировать результат.
Граница между моделями не жёсткая. SQL способен выражать сложную построчную логику, Spark — обрабатывать потоки и отдельные записи, а DQL — обращаться к источникам через JDBC. Важно, какая модель удобнее для конкретной задачи.
Когда SQL и Spark особенно эффективны
Возьмём проверку: доля NULL в колонке должна быть меньше 1%. Для SQL-системы это естественная задача. Запрос для PostgreSQL, который считает долю пустых значений:
SELECT
    COUNT(*) FILTER (WHERE value IS NULL)::double precision
    / NULLIF(COUNT(*), 0) AS null_share
FROM data;
СУБД посчитает агрегат и вернёт одно число. Для пустой таблицы результат будет NULL, и как трактовать этот случай, нужно решить отдельно. Передавать ради такой проверки каждый объект через Kafka, десериализовать JSON и выполнять над ним отдельное правило — обычно лишние расходы.
В таком тесте DQF вполне может уступить решению, которое считает на стороне источника. И это будет значить лишь то, что SQL-модель лучше подходит для этой задачи. Насколько велика разница, без эквивалентного теста сказать нельзя.
Когда задача становится алгоритмом
Теперь немного изменим условие. Нужно проверить объект недвижимости: пройти по помещениям и пересчитать площадь, проверить тип каждого помещения, для жилого и нежилого объекта применить разные требования. Затем проверить адрес по справочнику. Если адрес удалось нормализовать, использовать полученные компоненты в следующих шагах. При определённом сочетании ошибок сформировать отдельный результат.
SQL всё ещё способен выразить такую логику. Но вопрос постепенно меняется с «можно ли написать такой SQL?» на «как удобно сопровождать всю бизнес-логику качества данных?» Здесь от специализированного движка правил нужна уже не только скорость, но и удобная модель, в которой такую логику легко описывать и сопровождать.
Обращение к внешнему источнику при этом не бесплатно: скорость такого правила может определяться задержками справочника или БД, а не операциями DQL. В наших тестах такой сценарий не измерялся.
Когда какой подход имеет смысл
После этих измерений было бы странно заканчивать сравнением мест с первого по четвёртое. Выбор инструмента разумнее начинать с вопроса «какую работу мы собираемся выполнять?»
Инструмент | Основная модель в рассматриваемом сценарии | Естественно подходящие задачи |
DQF СИП | Исполнение алгоритма над входным объектом | Ветвления, циклы, вложенные структуры и проверка поступающих объектов |
Great Expectations | Проверка пакета данных (Batch) через Pandas, Spark или SQL | Проверки наборов данных в пайплайнах обработки |
Soda | Сканирование (scan) с вычислением SQL-метрик в источнике | Проверки таблиц и агрегатных показателей без переноса всего датасета |
Deequ | Вычисление метрик поверх Spark | Метрики качества больших наборов данных в Spark |
Таблица описывает соответствие задачи модели исполнения, а не исчерпывающий каталог возможностей продуктов. [2–6]
Для доли NULL, числа строк, min/max и полноты большой таблицы обычно естественно считать всё на стороне СУБД (push-down). Для массовых статистических метрик в озере данных — распределённая обработка в Spark. Для сложной логики над отдельным объектом, особенно в момент его поступления, — программируемый движок правил.
Вопрос в том, какая модель для системы основная и какой ценой ей достаётся нетипичный сценарий. Универсального рейтинга производительности DQ-фреймворков из наших тестов не получается.
В чём преимущество модели DQF
Преимущество DQF в задачах такого класса — возможность исполнять сложную логику над отдельным объектом при небольших затратах ресурсов. На двух CPU в тестах без балласта мы получили 30 457 исполнений check_inn_test в секунду, 6778 исполнений check_living_area_second и 3177 исполнений sample_algo.
За последней цифрой — не одна проверка NOT NULL, а полноценная программа с циклом, коллекциями, строками, регулярными выражениями и датами.
В промышленной системе контроля качества данных рано или поздно появляются такие правила:
если объект относится к типу A:
    проверить X
    рассчитать Y
    для каждого элемента Z:
        проверить несколько атрибутов
    если Y попадает в заданный диапазон:
        применить дополнительную проверку
иначе:
    использовать другой набор требований
Чем больше такой логики, тем больше проверка качества данных похожа на небольшую программу над объектом. Для этого в DQL есть явная модель шагов и контекст исполнения.
Результаты показывают и другое: производительность меняется вместе со сложностью правила. На том же лимите ресурсов проверка ИНН выполняется почти на порядок быстрее sample_algo. Если бы четыре очень разных алгоритма давали одинаковые числа, возник бы вопрос: мы вообще измеряем скорость исполнения или упираемся в транспорт либо другой компонент?
У нас картина такая, какой она и должна быть, когда узкое место — вычисления: чем тяжелее алгоритм, тем ниже пропускная способность, а вдвое больше CPU дают примерно вдвое больше производительности. Речь при этом только о протестированных правилах: превосходства над другими движками это не доказывает.
Потоковая обработка
Есть ещё одна особенность, которую легко упустить, если смотреть только на бенчмарки пакетной обработки. В рассматриваемых сценариях GX работает с пакетами данных, Soda запускает сканирование набора данных, Deequ вычисляет метрики через Spark. Для DQF проверка отдельного поступившего объекта — штатный сценарий: СИП получает сообщения из очереди и отправляет результаты; Kafka — один из поддерживаемых транспортов. [2–6]
Представим систему, в которую непрерывно приходят изменения клиентских данных. Можно периодически собирать их пакетами: записать данные в таблицу, через 15 минут запустить проверку и обнаружить ошибку. А можно встроить проверку в поток: объект поступает в правило, формируется результат, затем продолжается обработка.
У обоих подходов своя область применения. Spark также поддерживает потоковую обработку, а проверку датасета можно запускать часто. Речь о том, как организована проверка, а не о том, что другие инструменты не умеют работать с регулярно поступающими данными.
Для потокового сценария вопрос звучит так: можем ли мы проверять данные с той же скоростью, с которой они приходят, без растущей очереди? Задержка обнаружения ошибки становится так же важна, как пропускная способность.
Для масштаба: пик правила площадей на двух CPU — около 6800 исполнений в секунду. Даже 6000 объектов в секунду — это 21,6 млн объектов в час.
Реальной конфигурации нужны запас, измерение задержек и согласованная мощность планировщика, СИП, агрегатора и БД. Строить её по одному Max RPS нельзя. Однако результаты позволяют всерьёз рассматривать исполнение алгоритмов DQL прямо в потоке, а не только в ночной пакетной обработке.
Что подтверждают измерения
Наши тесты не доказывают, что DQF быстрее Great Expectations, Soda или Deequ на любой задаче. Мы не запускали эти продукты на том же железе с эквивалентными правилами. Публичные бенчмарки проводились на других стендах, версиях и задачах, поэтому прямое сравнение цифр было бы некорректным.
Мы также не утверждаем, что исполнение отдельного правила над каждой записью всегда лучше вычислений на стороне СУБД. Для агрегата вроде
COUNT(*) FILTER (WHERE email IS NULL)передача каждого объекта через отдельный движок правил, скорее всего, будет лишней работой.
Наконец, цифры DQF — результаты нагрузочного тестирования отдельных компонентов и прежде всего Max RPS. Это не SLA готовой промышленной инсталляции. Исследования кэша и аудита проводились на другом профиле и не задают универсальных коэффициентов пересчёта.
Зато тесты подтверждают другое: сложная логика проверки отдельного объекта не обязательно требует больших ресурсов именно от сервиса исполнения. В протестированных сценариях DQF выполнял тысячи составных и десятки тысяч более лёгких правил в секунду при лимите СИП в два CPU. При удвоении лимита CPU все четыре выбранных алгоритма показали рост максимальной скорости примерно вдвое.
Сколько стоит одна проверка
В начале статьи мы поставили под сомнение метрику «строк в секунду». Тесты только подтвердили: без контекста она мало что значит.
19,8 млн строк за семь секунд могут быть отличным результатом. Но если система за это время вычисляет свойства датасета через оптимизированные операции, это одна вычислительная задача. Три тысячи объектов в секунду могут выглядеть менее впечатляюще. Но если над каждым объектом выполняется небольшая программа с циклом, коллекциями, преобразованием данных и бизнес-условиями — это другая работа.
Поэтому при обсуждении производительности полезнее сначала выяснить: что является одной проверкой, где она выполняется, какая логика исполняется над данными и сколько ресурсов для этого требуется.
В нашем случае ответ такой. При лимите СИП в два CPU DQF смог выполнять до 30 тысяч простых проверок (вроде ИНН) в секунду, около 6–7 тысяч правил с обработкой вложенной структуры и более трёх тысяч тяжёлых составных алгоритмов. При этом мы увидели реальные ограничения: промахи кэша, аудит, размер сообщения и производительность соседних компонентов способны заметно изменить итоговую картину.
В этом мы и видим практическую ценность архитектуры DQF: правило качества данных остаётся полноценным алгоритмом, а измеренная стоимость исполнения позволяет всерьёз рассматривать проверку прямо в потоке данных.
У вопроса «сколько строк в секунду?» всё-таки есть ответ. Просто сначала нужно договориться, что именно мы делаем с каждой из этих строк.
Источники
[1] Vazquez H., Grosboillot V. cuallee: A Python package for data quality checks across multiple DataFrame APIs. Journal of Open Source Software, 2024, 9(98), 6684. Бенчмарк — с. 2. https://doi.org/10.21105/joss.06684
[2] Great Expectations. Execution Engine. Документация версии 0.18 — модели Pandas, Spark, SQLAlchemy и объединение вычислений метрик. https://docs.greatexpectations.io/docs/0.18/reference/learn/terms/execution_engine/
[3] Soda. Soda overview и Run a scan and view results. Документация Soda v3 — выполнение SQL-запросов в источнике и запуск сканирования. https://docs.soda.io/soda-documentation/soda-v3/learning-resources/product-overview и https://docs.soda.io/soda-documentation/soda-v3/run-a-scan
[4] AWS Labs. Deequ README. Описание библиотеки поверх Apache Spark и Python-интерфейса PyDeequ. https://github.com/awslabs/deequ/blob/master/README.md
[5] Руководство по языку Data Quality Language. Разделы о правиле, контексте исполнения, базовых алгоритмах и механизмах управления потоком. https://publisher.arenadc.io/doc/dqfdocs/20260403_Руководство_по_языку_Data_Quality_Language.pdf.
[6] ADC.DQF. Руководство администратора. Состав компонентов и взаимодействие сервисов. https://publisher.arenadc.io/doc/dqfdocs/20260724_Руководство_Администратора_ADС_DQF.pdf.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.