Квантование RWKV-7: что ломается в моделях разного размера
Модели семейства RWKV с линейной по длине последовательности рекуррентной структурой привлекательны для локального запуска, но инструментов квантования для них заметно меньше, чем для трансформеров. В этой работе я описываю инструмент rwkv-quant, сжимающий RWKV-7 двумя готовыми пресетами, и систематически разбираю, где именно при квантовании теряется качество и как это зависит от размера модели.
Работа началась с наблюдения, которое противоречит обычной интуиции «чем больше модель, тем меньше относительная потеря». Пресет COMPRESSION на 2.9B показал +4.04% по перплексии против +2.85% на 1.5B. Выяснение причины заняло основную часть исследования и привело к набору результатов, которые я считаю полезными независимо от конкретного инструмента.
Вклад работы.
Локализация потерь. Разложение KL по группам матриц (leave-one-out) показывает, что на 2.9B вред сосредоточен в двух местах: выходной проекции нулевого блока (
o_projслоя 0) и таблице эмбеддинга. Хранение первой в bf16 стоит 0.5% файла и снимает 39% KL; перевод второй с 5 на 6 бит стоит 1.1% файла и снимает ещё 22% (раздел 4).Механизм и предсказуемость. Вход проблемной матрицы несёт массивный канал, но сама концентрация энергии вред не предсказывает: у 7.2B она выражена сильнее всех, а модель квантуется лучше всех. Я показываю, что три естественные локальные метрики ошибки не работают, и описываю метрику, которая работает: ошибка в остаточном потоке, умноженная на измеренное усиление (раздел 5).
Автоподбор битности по правилу «вред на байт», работающий в обе стороны (одна цена байта для повышения и понижения), с измерением по одной матрице за проход (раздел 6).
GPTQ на сетке пресета без изменения формата, ядер и размера файла; показано, что регуляризация важнее размера калибровки и что методы автоподбора и GPTQ складываются почти мультипликативно (раздел 7). GPTQ в пресете REDUCTION описан в разделе 8.
Сводка по шести размерам от 0.1B до 13.3B с доверительными интервалами, полученными парным бутстрэпом по окнам (раздел 9), и сравнение с GGUF и MLX при равном размере файла (раздел 10).
Методологические находки. Утечка калибровочного корпуса в оценочный набор и её измеренный масштаб (раздел 3.4); разброс результата GPTQ между численно эквивалентными реализациями и его количественная оценка (раздел 7.6); четыре инженерные ошибки, исказившие измерения (приложение A).
2. Связанные работы
Квантование с коррекцией ошибки. GPTQ (Frantar et al., 2022) квантует колонки матрицы по одной и разносит ошибку каждой на ещё не квантованные колонки через обратный гессиан входных активаций. Я переношу GPTQ на асимметричную суперблочную сетку (раздел 7) и симметричную сетку типа Q6_K (раздел 8). Формат файла и ядра при этом не меняются.
Взвешивание по активациям. AWQ и матрица важности imatrix в llama.cpp используют статистики активаций, чтобы защитить более важные каналы. В моём инструменте статистика активаций (AW, activation-weighted) определяет выбор масштаба и сдвига групп весов; без неё 4 бита в o_proj разрушают 2.9B (раздел 4.3).
Выбросы и массивные активации. Dettmers et al. (2022, LLM.int8()) описали выбросы признаков, концентрированные в нескольких каналах скрытого состояния, и их роль в деградации квантованных трансформеров. Sun et al. (2024) описали «массивные активации» — значения на порядки больше медианных в немногих каналах. Массивный канал на входе o_proj нулевого блока (раздел 4.3) — прямая родня этих явлений, но, как я покажу, его сила сама по себе не предсказывает вред.
3. Постановка и методика
3.1 Модели
Исследуется линейка RWKV-7 шести размеров. Для изоляции факторов использованы три пары: 0.4B/1.5B (одна глубина, ширина вдвое больше), 2.9B/7.2B (одна глубина L=32, ширина 2560 против 4096) и 7.2B/13.3B (одна ширина, глубина 32 против 61).
модель | слоёв L | ширина D | голов H=D/64 | D/L | серии чекпоинтов |
|---|---|---|---|---|---|
0.1B | 12 | 768 | 12 | 64 | g1d |
0.4B | 24 | 1024 | 16 | 42.7 | g1d |
1.5B | 24 | 2048 | 32 | 85.3 | g1d, g1h, g1j |
2.9B | 32 | 2560 | 40 | 80 | g1h, g1j |
7.2B | 32 | 4096 | 64 | 128 | g1j |
13.3B | 61 | 4096 | 64 | 67.2 | g1j |
Итоговые таблицы (разделы 9–10) относятся к серии g1j; диагностика (раздел 4) частично использует g1d и g1h, это указано в тексте.
3.2 Пресеты
Инструмент rwkv-quant сжимает модель двумя пресетами.
REDUCTION (почти без потерь). Проекции (
proj) — 8 бит, симметричная раскладкаsym_awс группой 16 весов;cmix(каналовое микширование, FFN) — 6 бит; эмбеддинг и голова — 8 бит; LoRA-веткиw,a,v— 6 бит,g— 8 бит (блок 64). Сжатие около 2.1x.COMPRESSION (агрессивный). Проекции — 4 бита, асимметричная суперблочная раскладка
asym_sb6_awс группой 32;cmix— 4 бита, ноffn.key— 5 бит; эмбеддинг — 6 бит (в ранних измерениях 5, раздел 4.5); голова — 5 бит; LoRA-ветки те же, что в REDUCTION. Сжатие около 3.1x.
В раскладках с суффиксом _aw масштаб и сдвиг каждой группы подбираются поиском, взвешенным по среднему квадрату входной активации канала E[x²], то есть по статистике, снятой на калибровочном корпусе. Раскладка REDUCTION симметричная (масштаб на блок из 16 весов, без сдвига; int8-коды масштабов против одного fp16-множителя на суперблок из 16 блоков; 6 или 8 бит). Раскладка COMPRESSION (sb6) асимметричная суперблочная: блок из 32 весов, суперблок из 8 блоков (256 колонок); масштаб и сдвиг каждого блока хранятся 6-битными кодами qs и qm относительно двух fp16-множителей суперблока.
Не квантуются и хранятся в bf16 малые поканальные векторы (k_k, k_a, r_k), нормы и bias LoRA-веток. У таблицы эмбеддинга статистики активаций нет (её вход — индексы токенов), поэтому её сетка в обоих пресетах подбирается без AW-взвешивания; GPTQ эмбеддинг также не затрагивает.
Две правки, найденные в разделе 4, входят в финальный COMPRESSION: выходная проекция нулевого слоя (o_proj слоя 0) хранится в bf16, эмбеддинг — в 6 битах. Пресет без этих правок в тексте называется «базовым» (в логах compression_nol0).
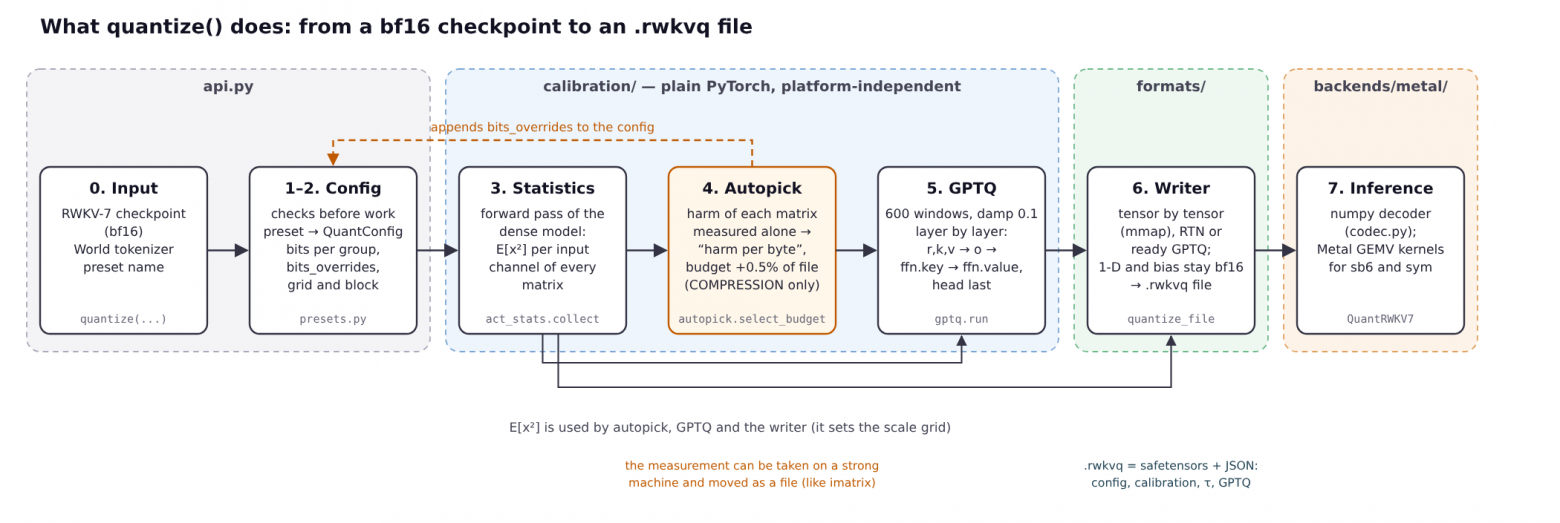
Рис. 1. Конвейер quantize(). Статистика активаций E[x²] используется автоподбором, GPTQ и записью; результат автоподбора дописывается в конфиг (bits_overrides). Калибровка не зависит от платформы; формат и бэкенд отделены от неё.
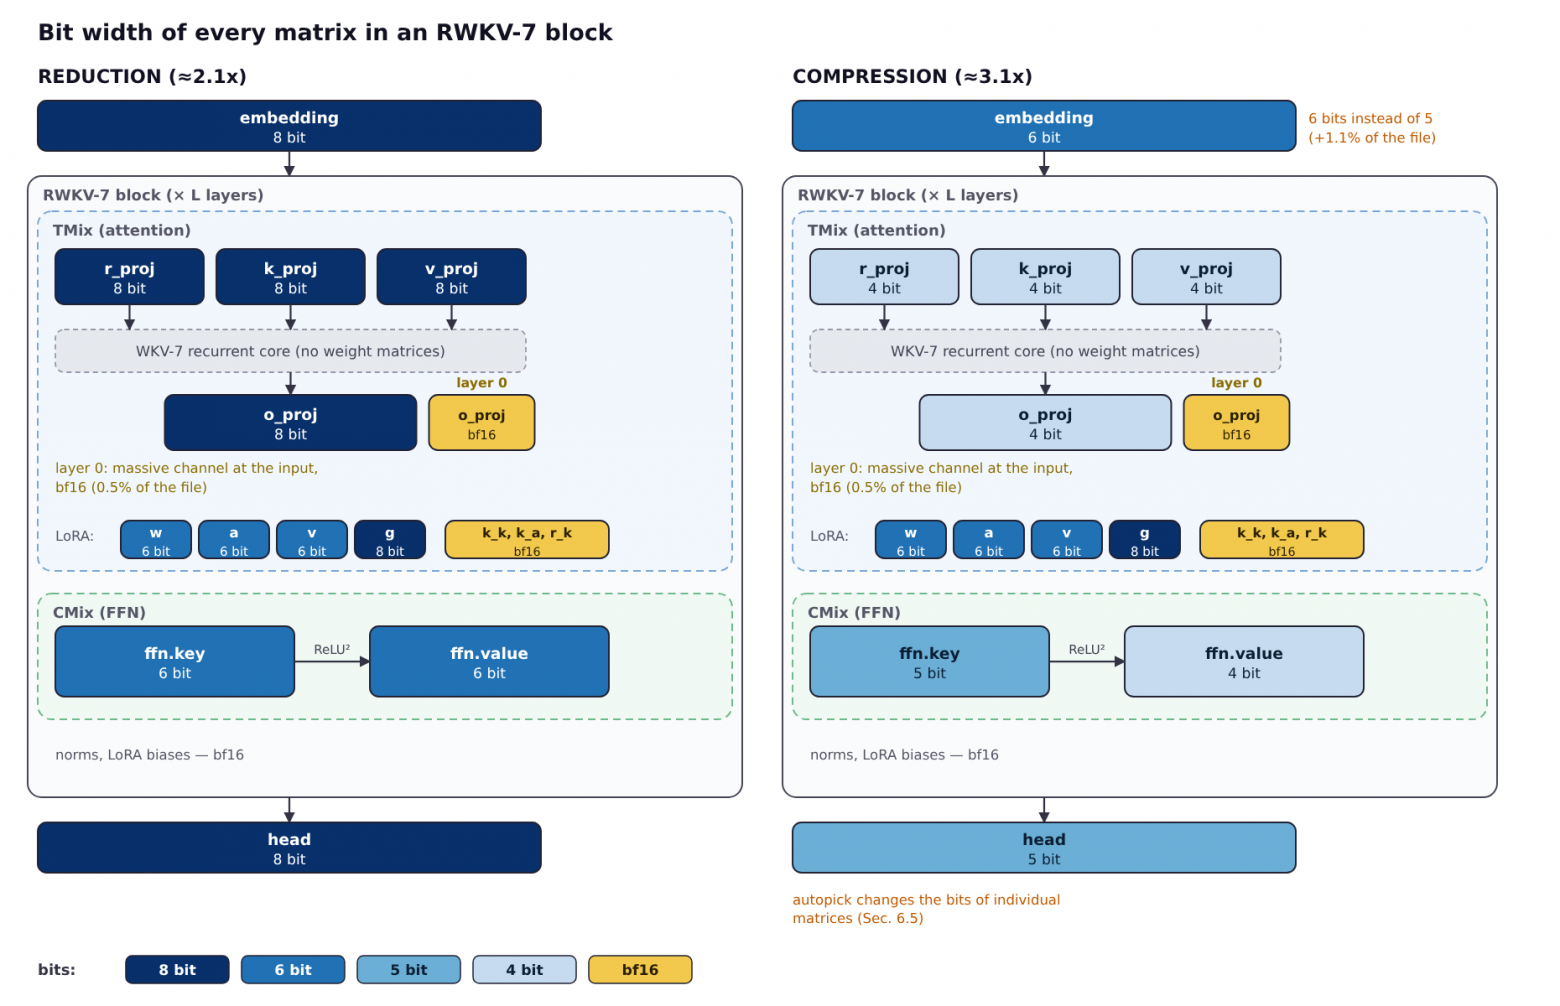
Рис. 2. Битность матриц в пресетах REDUCTION и COMPRESSION. Выделены две фиксированные правки: o_proj слоя 0 в bf16 и эмбеддинг на 6 бит вместо 5 (раздел 4). Автоподбор (раздел 6) меняет биты отдельных матриц поверх пресета COMPRESSION.
3.3 Метрики и приборы
Основная метрика — KL(bf16‖квант) на токен: расхождение распределения следующего токена у квантованной модели от распределения bf16-модели. Эталонные логиты считаются в fp32 и сохраняются на диск (5.09 ГБ на модель). Вторая метрика — относительное изменение перплексии (Δppl, в процентах) к bf16-модели. Эталон принимается числом (оценка эталонного плеча), а не размером файла.
Используются два пути вычислений, и их абсолютные KL различаются, поэтому сравнивать можно только внутри одного прибора:
fake-путь (PyTorch): веса квантуются и тут же деквантуются, вычисления в плотных тензорах; работает на Mac (MPS) и на сервере (CUDA);
реальный путь (MLX): коды упакованы в формат
.rwkvqи читаются Metal-ядрами; только Mac.
Приборы перечислены в приложении C.
3.4 Оценочные наборы и утечка
Первый набор eval_corpus_multiling (en/ru/sr, 38 окон по 512 токенов) использовался в разделах 4–6 и оказался целиком лежащим внутри калибровочного корпуса пакета: общих 16-грамм 100%. Для метода, калибруемого по корпусу, это прямая утечка.
Масштаб утечки измерен на GPTQ (раздел 7), откалиброванном по корпусу пакета: на 1.5B выигрыш по KL текста составил −61.8% на старом наборе и −27.1% на чистом, то есть утечка завысила выигрыш в 2.3 раза. Код чист (одно окно из 24 содержит общие 16-граммы, 0.03%).
AW-статистика задета частично: её 23 окна по 512 токенов содержат 23.9% 16-грамм старого набора и пересекаются с 13 из 38 его окон. Абсолютные числа раздела 4 получены на тексте, по которому AW частично взвешивала поиск; направление смещения в пользу AW, величина не измерялась. Сравнения внутри раздела (какая матрица, какой бит) сделаны при одной и той же статистике, и смещение входит в оба плеча. Автоподбор утечкой не воспользовался: на 1.5B −16.1% на старом наборе и −17.6% на чистом.
Чистые наборы (ни одной общей 16-граммы ни с одним калибровочным корпусом):
eval_text_heldout: Википедия en/ru/sr, по 12 окон на язык (36 окон);eval_code_heldout: 24 окна Python/Swift (закрытый набор);eval_code_open: 48 окон (24 Python, 24 Swift) из открытых репозиториев автора.
Правило: любой калиброванный метод мерится только на чистых наборах, и перед замером проверяется, что пересечение 16-грамм калибровки с набором равно нулю. Разделы 4–5 и таблица выбора порога в разделе 6.3 измерены на старом наборе (в таблице раздела 6.3 окна не участвовали в выборе, но лежат внутри калибровочного корпуса); результат автоподбора перепроверен на чистых наборах в разделе 6.4. Разделы 7–10 используют только чистые наборы.
3.5 Статистика
Доверительные интервалы строятся парным бутстрэпом по окнам (20 000 повторов, окна ресэмплируются вместе для обоих сравниваемых плеч). При сравнении с чужими форматами то же самое делается для отношений KL. У KL полуширина 95%-интервала составляет 7–12% от значения. Дополнительно, для оценки разброса самого GPTQ между реализациями, использованы реплики с переставленным порядком окон калибровки (раздел 7.6).
4. Где теряется качество
Замечание о наборах. Измерения разделов 4 и 5 сделаны на первом оценочном наборе (раздел 3.4), частично пересекающемся с AW-статистикой. Абсолютные значения могут быть слегка смещены в пользу AW; сравнения между матрицами и битностями внутри раздела сделаны при одной статистике. Все дальнейшие результаты (разделы 6.4–10) получены на чистых наборах уже с найденными здесь правками в пресете.
Базовый вопрос: почему COMPRESSION на 2.9B деградирует сильнее, чем на 1.5B (+4.04% против +2.85% по ppl)?
4.1 Разложение потерь по группам матриц
Вклад группы матриц определяется методом leave-one-out: вклад = KL(всё квантовано) − KL(всё, кроме этой группы). Результаты для серии g1h, реальный путь (Mac, MLX):
группа | 1.5B: KL (доля) | 1.5B: ppl, п.п. | 2.9B: KL (доля) | 2.9B: ppl, п.п. |
|---|---|---|---|---|
| 0.00578 (16%) | 0.64 | 0.02368 (46%) | 1.82 |
| 0.01317 (37%) | 0.99 | 0.01035 (20%) | 0.63 |
эмбеддинг | 0.00120 (3%) | 0.07 | 0.00874 (17%) | 0.83 |
| 0.00442 (12%) | 0.43 | 0.00400 (8%) | 0.36 |
голова | 0.00440 (12%) | 0.39 | 0.00310 (6%) | 0.36 |
| 0.00443 (12%) | 0.37 | 0.00378 (7%) | 0.52 |
| ≤4% | ≤0.08 | ≤2% | ≤0.12 |
Сумма вкладов равна 101% и 107%, то есть группы почти аддитивны. На 2.9B выделяются две группы: o_proj (46% всего KL) и эмбеддинг (17%); на 1.5B их вклад скромный (16% и 3%), главный вклад даёт cmix.value.
Тот же разбор на сервере (fake-путь, серия g1j, базовый пресет compression_nol0) подтверждает картину:
модель | базовый KL |
| весь | эмбеддинг |
| голова |
|---|---|---|---|---|---|---|
1.5B | 0.050962 | 0.5% | 13% | 2.8% | 29% | 8.3% |
2.9B | 0.077513 | 39% | 45% | 30% | — | — |
7.2B | 0.022984 | 3.9% | 13% | 8.4% | 25% | 9.4% |
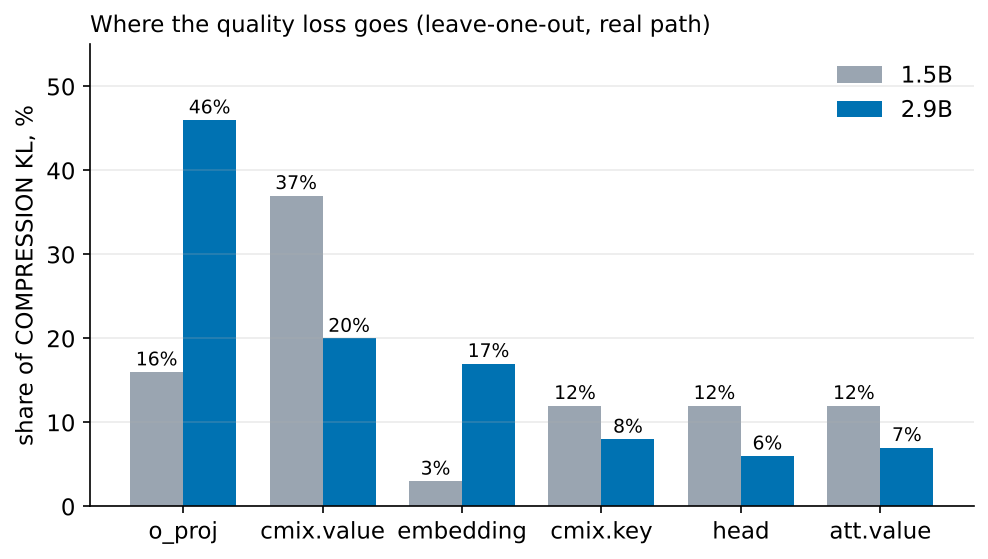
Рис. 3. Доли потерь KL по группам матриц (leave-one-out, реальный путь, серия g1h), 1.5B и 2.9B. Данные первой таблицы раздела.
4.2 Главная находка: o_proj нулевого слоя
На 2.9B 85–86% вклада всей группы o_proj приходится на одну матрицу: выходную проекцию нулевого блока. Прямой эксперимент (реальный путь, 2.9B, g1h) сравнивает базовый пресет с его вариантами, в которых отдельные части o_proj хранятся с большей точностью:
плечо | KL | ppl | en / ru / sr | прирост файла |
|---|---|---|---|---|
базовый | 0.052048 | +4.04% | +4.24 / +3.21 / +5.71 | — |
| 0.031966 | +2.43% | +3.02 / +2.19 / +2.36 | +9.4 МБ (+0.5%) |
| 0.051512 | +4.07% | ≈ базовый | +9.4 МБ |
весь | 0.046043 | +3.54% | ru хуже: 3.21→3.44 | +26.2 МБ |
весь | 0.036305 | +2.89% | — | +52.4 МБ |
Одна матрица 2560×2560 в bf16 возвращает 85% вклада группы o_proj за 0.5% файла и работает лучше, чем перевод всего o_proj в 6 бит за 2.8% файла. Контрольное плечо (слой 31) эффекта не даёт, то есть дело именно в нулевом слое. После правки 2.9B становится лучше 1.5B: +2.43% против +2.85%.
Та же правка на других масштабах (реальный путь):
пресет | модель | KL: базовый → с правкой | ppl | прирост файла |
|---|---|---|---|---|
COMPRESSION | 0.1B | 0.08960 → 0.08279 (−7.6%) | +8.68% → +8.01% | +0.8 МБ |
COMPRESSION | 0.4B | 0.04965 → 0.04891 (−1.5%) | +4.31% → +4.28% | +1.5 МБ |
COMPRESSION | 1.5B | 0.03599 → 0.03585 (−0.4%) | +2.85% → +2.87% | +6.0 МБ |
COMPRESSION | 2.9B | 0.05205 → 0.03197 (−39%) | +4.04% → +2.43% | +9.4 МБ |
REDUCTION | 0.4B / 1.5B | без изменений | — | +1.0 / +3.9 МБ |
REDUCTION | 2.9B | 0.001635 → 0.001573 (−3.8%) | +0.08% → +0.06% | +6.1 МБ |
Значимы только эффекты на 0.1B и 2.9B: на 0.4B и 1.5B изменение кросс-энтропии не отличается от нуля. Поправка существенна лишь в COMPRESSION на 2.9B и, в меньшей степени, на 0.1B.
4.3 Механизм: массивный канал на входе o_proj слоя 0
Вход o_proj нулевого слоя несёт «массивный канал»: один-два канала на несколько порядков сильнее остальных по среднему квадрату активации E[x²].
модель | max/медиана E[x²] | доля энергии в 8 каналах | номер канала |
|---|---|---|---|
0.1B g1d | 2 628 | 0.77 | 112 |
0.4B g1d | 22 580 | 0.91 | 53 |
1.5B g1d | 2 245 | 0.46 | 1202 |
1.5B g1h | 3 740 | 0.53 | 1202 |
1.5B g1j | 4 227 | 0.54 | 1202 |
2.9B g1h | 7 199 995 | 0.98 | 517 |
2.9B g1j | 7 564 462 | 0.98 | 517 |
7.2B g1j | 6 626 554 | 0.99 | 160 |
Номер канала один и тот же у всех серий одной ширины: 1202 у трёх серий 1.5B, 517 у двух серий 2.9B. Следовательно, это свойство ширины и архитектуры, а не конкретного прогона обучения.
Насколько AW-статистика держит эту матрицу, видно из плеча «o4s»: те же 4 бита, но поиск без AW, только в o_proj.
модель | KL: базовый → без AW | ppl |
|---|---|---|
1.5B | 0.035992 → 0.042974 | +2.85% → +3.57% |
2.9B | 0.052048 → 0.340025 | +4.04% → +37.2% |
На 2.9B AW держит почти всё: без неё 4 бита в o_proj разрушают модель.
4.4 Почему именно 2.9B, а не «все большие модели»
Ожидание «больше модель — меньше деградация» в целом верно: на 2.9B все обычные группы (r, k, v, cmix, голова, LoRA) уносят меньше, чем на 1.5B, даже в абсолютных числах. Выбиваются только o_proj и эмбеддинг.
Однако на 7.2B массивный канал выражен сильнее всех (99% энергии в восьми каналах), а квантуется эта модель лучше всех: базовый KL 0.023 против 0.078 у 2.9B и 0.051 у 1.5B (одна серия g1j, один прибор), и правка слоя 0 даёт там лишь −3.9%. Значит, сила массивного канала сама по себе не объясняет вред.
Прямой замер вреда от квантования одной матрицы (квантуется только o_proj слоя 0, остальное в bf16) на 2.9B и 7.2B:
KL | ‖Δx‖/‖x‖ на слое 0 | пик по глубине | |
|---|---|---|---|
2.9B | 0.020290 | 13% | 31% (слои 13–16) |
7.2B | 0.001427 | 3.4% | 6.7% (слой 13) |
Разница в 14 раз по KL создаётся в момент впрыска ошибки в остаточный поток, а не при её распространении: усиление вниз по глубине у обеих моделей близкое (2.4x и 2.0x к середине сети). Это подводит к вопросу, чем вред вообще предсказывается (раздел 5).
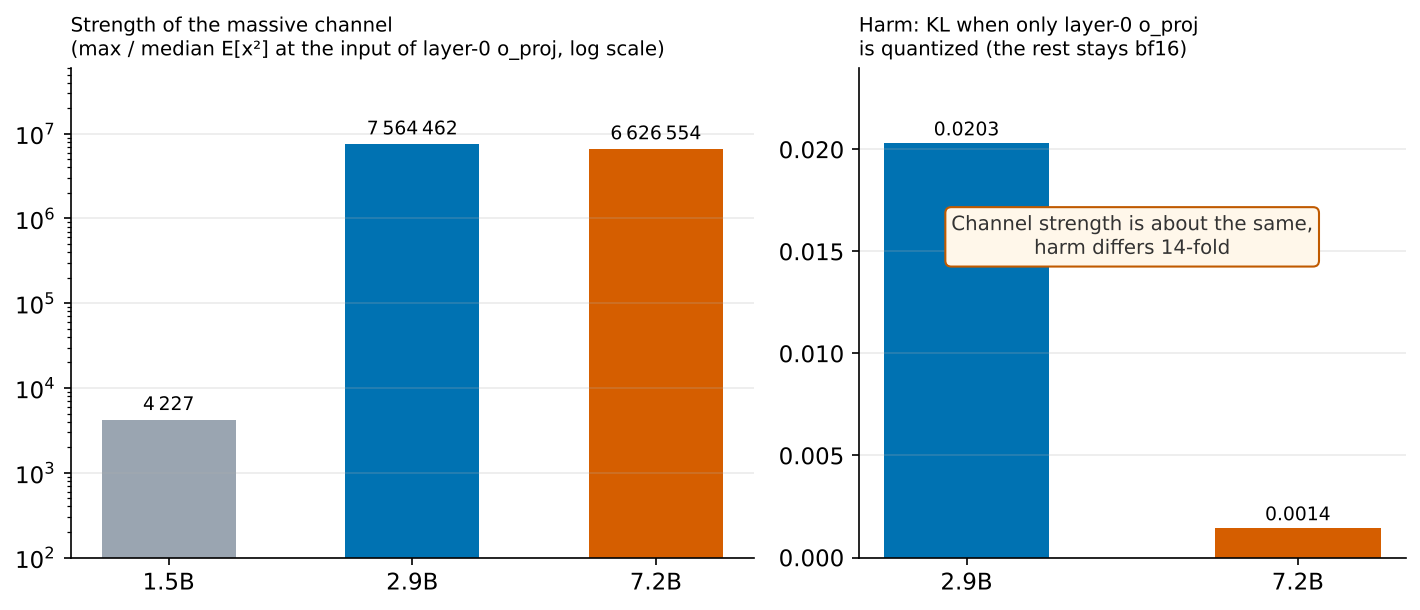
Рис. 4. Сила массивного канала (max/медиана E[x²]; серии g1j) и вред от квантования только o_proj слоя 0 на 2.9B и 7.2B. Сила канала почти одинакова, вред различается в 14 раз.
4.5 Второй адрес: эмбеддинг
На 2.9B эмбеддинг уносит 17% KL (серия g1h) и 30% (g1j), на 1.5B — 3%. Перевод эмбеддинга из 5 бит в 6 (реальный путь, поверх пресета с правкой слоя 0):
модель | KL | ppl | en / ru / sr | прирост файла |
|---|---|---|---|---|
2.9B, базовый | 0.031966 | +2.43% | +3.02 / +2.19 / +2.36 | — |
2.9B, эмбеддинг в 6 бит | 0.024885 (−22%) | +1.86% | +2.33 / +1.66 / +1.82 | +21.0 МБ (+1.13%) |
2.9B, эмбеддинг в bf16 | 0.024539 (−23%) | +1.82% | — | +220 МБ |
1.5B, эмбеддинг в 6 бит | 0.034933 (−2.6%) | +2.82% | шум | +16.8 МБ |
6 бит забирают 95% того, что даёт полный bf16, в десять раз дешевле. Восемь бит для эмбеддинга недоступны: суперблочная раскладка знает только 4, 5 и 6 бит. Обе правки вместе переводят 2.9B с +4.04% до +1.86% ценой примерно 1.6% файла.
Решение: эмбеддинг в 6 бит входит в COMPRESSION всегда. Пересчёт по записанным файлам (реальный путь, 38 окон, прежний файл меряется тем же прибором рядом):
модель | ppl: было → стало | KL: было → стало | ΔCE, 95% ДИ | прирост файла |
|---|---|---|---|---|
0.1B | +8.00% → +7.50% | 0.0828 → 0.0780 | значимо | +6.3 МБ (+4.9%) |
0.4B | +4.28% → +4.20% | 0.0489 → 0.0468 | в шуме | +8.4 МБ (+2.9%) |
1.5B | +2.87% → +2.82% | 0.0359 → 0.0349 | в шуме | +16.8 МБ (+1.7%) |
2.9B | +2.43% → +1.85% | 0.0320 → 0.0249 | значимо | +21.0 МБ (+1.1%) |
Цена правки — только байты файла: в COMPRESSION эмбеддинг разворачивается в плотный fp16 (gather применим лишь к симметричной раскладке), и на каждый токен читается одна строка таблицы.
4.6 Скорость
Скорость декода 2.9B измерена на двух файлах, собранных одним кодом и отличающихся только слоем 0 (bf16 против квантованной матрицы), с чередованием ABBA в одном процессе:
порядок загрузки | разница |
|---|---|
файл без правки первым | −0.40 мс/ток (−1.6%) |
файл с правкой первым | −0.52 мс/ток (−2.2%) |
контроль A/A | −0.02 [−0.13; +0.10] |
Файл с bf16-матрицей не медленнее, а быстрее, хотя читает на 9.4 МБ больше. Механизм не выяснен: одна матрица не должна давать полмиллисекунды, и я не утверждаю объяснения. Вывод, который из этого следует практически: правка слоя 0 не стоит скорости.
5. Что предсказывает вред от квантования матрицы
Раздел 4 показывает, что вред от квантования очень неравномерен между матрицами и что одна матрица с «массивным» входом может быть важнее целой группы. Возникает вопрос, можно ли предсказать такие матрицы заранее, не квантуя каждую по отдельности. Я проверил три естественных признака и все три отвергли.
Признак 1: концентрация энергии входа. Доля энергии в восьми каналах не предсказывает вред: 0.99 у 7.2B (вреда практически нет), 0.77 у 0.1B (вред есть), 0.91 у 0.4B (вреда нет).
Признак 2: диагональная ошибка выхода слоя
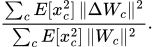
У нулевого слоя она наименьшая во всех пяти проверенных моделях. Причина понятна: AW-поиск минимизирует именно эту величину, то есть признак измеряет качество поиска, а не вред.
Признак 3: честная локальная ошибка впрыска ‖(W−Ŵ)X‖/‖WX‖ на настоящих активациях. На 2.9B максимум у ffn.value слоёв 15–19 (0.16), а o_proj слоя 0 не попадает даже в первую дюжину. Контроль: квантование только blocks.15.ffn.value даёт KL 0.000776 против 0.020290 у o_proj слоя 0, то есть в 26 раз меньше вреда при вчетверо большей локальной ошибке.
Вывод. Локальная ошибка нормирована не на то. Значима ошибка, внесённая в остаточный поток, умноженная на то, насколько последующие слои её усиливают. След ошибки слоя 15 затухает по глубине (4.9% → 2.2%), а след слоя 0 разгоняется (13% → 31%).
Признак, который работает. Ошибка подслоя в остаточном потоке ‖Δx‖²/‖x‖², умноженная на усиление G этой точки, где G измерено прямо: шумом ε = 1% в ту же точку и измерением KL на выходе. Ранговая корреляция с истинным одиночным вредом (KL при квантовании только этой матрицы): 0.977 (0.1B), 0.969 (1.5B), 0.920 (2.9B); верхние три матрицы на 2.9B совпадают. Слабости признака: вклад эмбеддинга через точку x₀ переоценён (изотропный шум не похож на настоящую ошибку), а внутренние матрицы слоя 0 недооценены (v_first не моделируется).
Для практического правила этот признак оказался не нужен. Правило платит за байт (раздел 6), и для него честнее всего прямой замер одиночного вреда каждой матрицы: один проход на матрицу, что по цене сопоставимо с измерением усиления G (2L+1 проходов).
6. Автоподбор битности: правило «вред на байт»
Фиксированный список правок («o_proj слоя 0 в bf16, эмбеддинг в 6 бит») плох тем, что проблемные матрицы у разных моделей разные. Ниже описано правило выбора битности по измерению, работающее в обе стороны.
6.1 Правило
Для матрицы m и шага её битности b → b′ задана величина
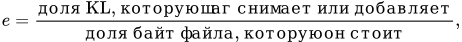
где KL берётся для модели, у которой квантована только эта матрица, против fp32-эталона. Шаг вверх выполняется, если e ≥ τ; шаг вниз — если e < τ. Один порог τ с обеих сторон означает одну цену байта: биты переезжают туда, где окупаются сильнее.
Стоимость матрицы в байтах считается как params·(b + 0.5)/8 (0.5 бита на вес — масштабы sb6) и 2·params для bf16. Лестница уровней — 4, 5, 6 бит и bf16. Шаг вниз допустим только до 4 бит (3-битной раскладки в формате нет); эмбеддинг вниз не идёт никогда. Подъёмы выбираются жадно по убыванию e, пока e ≥ τ. Для заданного бюджета файла (по умолчанию +0.5%) берётся наименьшее τ, при котором прирост байт укладывается в бюджет; оно ищется бисекцией по log τ. Если бюджет недостижим даже при самом большом τ, возвращается выбор при этом τ и пометка «недостижим».
Цель выбора — средний KL по 14 окнам калибровочного корпуса, взятым по языковой квоте en 4 / code 4 / ru 2 / sr 2 / zh 2 (веса языков пропорциональны числу окон; при необходимости веса можно задать явно).
6.2 Кандидаты и понижение
Первая версия ошибалась в выборе кандидатов, а не в признаке. Первоначально проверялись 12 верхних матриц по абсолютному вреду плюс концевые слои. Но правило платит за байт, а мелкие матрицы C×C (att.output и att.value средних и поздних слоёв) при умеренном вреде вчетверо дешевле cmix. Строгая граница снимает вопрос без предположений: шаг вверх не может снять больше одиночного вреда S матрицы, значит
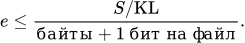
По свипу одиночного вреда за пределами 12 кандидатов матриц с границей ≥ 5 оказалось 47 (1.5B), 61 (2.9B) и 59 (7.2B). Полный выбор при τ = 5 — 33 / 46 / 45 ключей вместо 12.
Вниз три бита не нужны. Лестница вниз (KL одной матрицы на бит ниже) показала, что шаги на 3 бита при e < 5 дают не более 0.9% файла (7.2B), обычно 0.2–0.6%. Дешёвые байты лежат в другом месте: ffn.key 5 → 4 в средних слоях (e = 1.9–3.5), а 4-битная раскладка в формате уже есть. Новая раскладка не нужна.
6.3 Выбор порога τ
Симметричное правило оказывается байт-нейтральным при τ ≈ 5–6: размер пресета был верным, неверным было распределение бит. Ниже — KL файла на 30 окнах, не участвовавших в выборе (но лежащих внутри калибровочного корпуса, раздел 3.4), парно к пресету по окнам; скорость — чередование ABBA в одном процессе на Mac.
Δ размера | ΔKL, отложенные окна | окон хуже | Δ декода | |
|---|---|---|---|---|
1.5B, прежний выбор (12 ключей, только вверх) | +22.6 МБ | −17.0% [−18.2; −15.8] | 0/30 | +1.7% |
1.5B, sym τ=5 | +6.8 МБ | −18.8% [−20.3; −17.4] | 0/30 | в шуме |
1.5B, sym τ=6 | −2.6 МБ | −13.5% [−15.1; −11.7] | 1/30 | −0.5% |
1.5B, sym τ=7 | −24.6 МБ | −0.8% [−2.8; +1.2] | 13/30 | −2.0% |
2.9B, прежний выбор | +55.4 МБ | −24.6% [−26.1; −23.1] | 0/30 | +2.4% |
2.9B, sym τ=5 | +16.9 МБ | −25.7% [−28.4; −22.5] | 0/30 | в шуме |
2.9B, sym τ=6 | −8.5 МБ | −19.2% [−21.6; −16.6] | 0/30 | в шуме |
2.9B, sym τ=7 | −49.2 МБ | −6.5% [−9.0; −3.8] | 6/30 | −2.4% |
7.2B, sym τ=5 | +86.0 МБ | −25.8% [−28.4; −23.6] | 0/30 | не мерено |
7.2B, sym τ=6 | −33.6 МБ | −13.4% [−16.6; −10.2] | 0/30 | не мерено |
7.2B, sym τ=7 | −115.3 МБ | −0.7% [−4.3; +2.8] | 12/30 | не мерено |
τ = 5 даёт качество прежнего выбора за треть байт и без потери скорости; τ = 7 — качество пресета на файле на 2.5% меньше и на 2% быстрее. Скорость здесь не выводится из байт: прежний выбор добавлял 22.6 МБ и замедлял на 1.7%, а sym τ=5 добавляет 6.8 МБ и не замедляет, потому что байты сместились с матриц, читаемых на каждом токене, на другие.
Оговорка, которую данные сделали сами. В этом прототипе выбор делался по 8 окнам (3 ru / 3 en / 2 sr), и английский выигрывает меньше всех (7.2B, τ=6: en −7.7% против sr −19.4%; при τ=7 английский даже на 4.6% хуже пресета). То, что правило минимизирует, — это решение о целевых данных, а не деталь реализации.
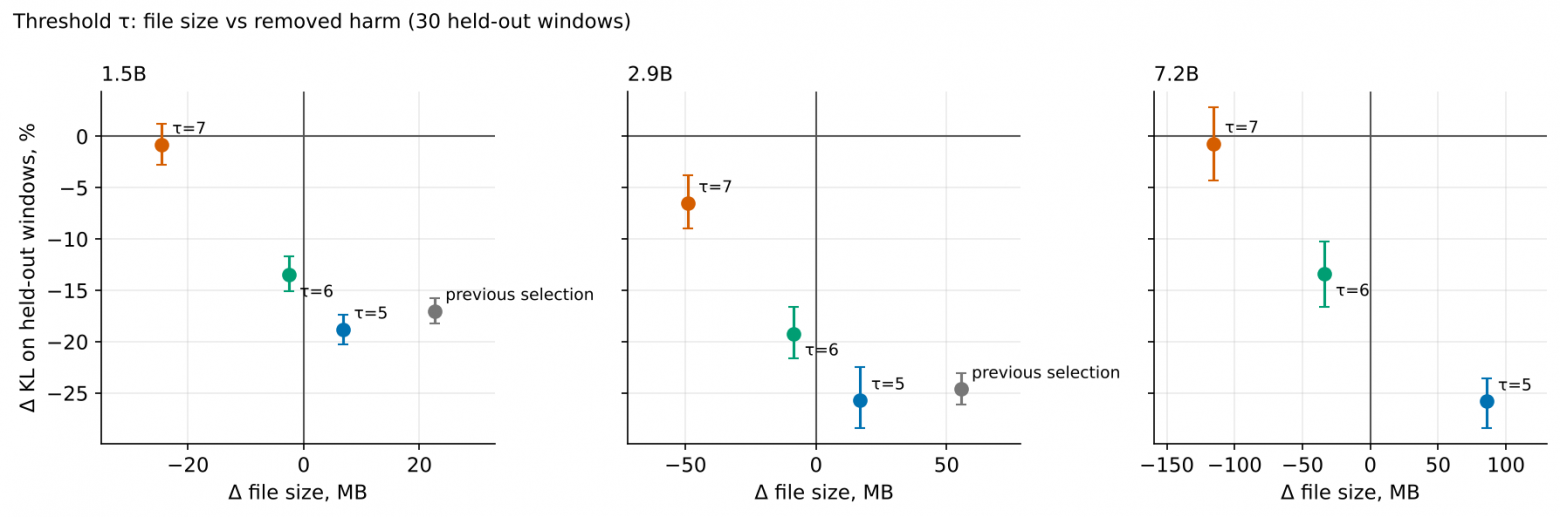
Рис. 5. Выбор порога τ: изменение размера файла и KL на 30 отложенных окнах (парно к пресету, 95% ДИ). Данные таблицы выше.
6.4 Чистая оценка на моделях от 1.5B до 13.3B
Прибор: fake-путь на сервере, 36 окон чистого текста и 24 окна чистого кода, KL к bf16 тем же прибором (для 1.5B — замер на Mac). Бюджет +0.5% файла. Изменение относительно пресета без автоподбора:
модель | KL текст | en | ru | sr | KL код | Δppl текст | Δppl код |
|---|---|---|---|---|---|---|---|
1.5B (Mac) | −17.6% | −17.9 | −16.9 | −18.0 | −13.5% | +3.88 → +3.25% | +3.86 → +3.32% |
7.2B | −20.7% | −25.1 | −16.1 | −20.3 | −13.6% | +1.85 → +1.51% | +1.22 → +0.86% |
13.3B | −21.1% | −23.4 | −17.0 | −22.5 | −17.4% | +1.14 → +0.86% | +1.11 → +0.58% |
С ростом модели выигрыш не падает. Предсказание самого измерения на 13.3B завышено в 1.5 раза: предсказано −32.9%, измерено −21.1% (на 1.5B предсказание было близким). Поэтому, как и выше, результатом считается только замер записанного файла.
Полная таблица с парным бутстрэпом для шести моделей приведена в приложении B.1. Её итог: по KL автоподбор значимо лучше пресета на каждой модели и в каждом срезе; по ppl выигрыш не значим в двух клетках (текст на 0.4B и код на 2.9B). Слабое место — английский на 0.4B: KL −7.5%, три окна из двенадцати хуже пресета, ppl +0.46% [−0.25; +1.14].
6.5 Что выбирает автоподбор
Число матриц, у которых бит повышен или понижен (бюджет +0.5% файла):
модель | вверх | вниз | что вниз |
|---|---|---|---|
0.1B | 47 | 1 | — |
0.4B | 52 | 10 | — |
1.5B | 46 | 16 | — |
2.9B | 59 | 25 |
|
13.3B | 110 | 37 | — |
Наверх идут в основном o_proj и v_proj (5 бит) и ffn.value. Бюджет +0.5% не выбирается целиком: правило упирается в τ, и прирост файла составляет 0.1–0.2% (на 0.4B размер даже уменьшается).
6.6 Измерение без лестниц и его цена
Уровни выше битности пресета измерять не нужно: KL одной матрицы убывает с битом почти одинаково у всех типов матриц и масштабов. Отношение r = KL(b+1)/KL(b) составляет 0.315 (proj), 0.313 (cmix.value), 0.317 (cmix.key) и 0.41 (голова), медианы по 500+ шагам на шести моделях от 0.1B до 13.3B. Выбор по формуле «измеренная база × rᵏ» даёт тот же КПД (процент снятого KL на мегабайт), что выбор по истинным лестницам, на всех проверенных масштабах. Предсказанный выигрыш при этом завышен (1.5B, τ=6: предсказано −19%, измерено −13%), поэтому отчёт правила служит ориентиром.
Цена измерения — один проход на матрицу на битности пресета и один на реализуемый шаг вниз. Проход возобновляется с чистого остаточного потока на входе слоя матрицы: слои до неё квантование не меняет, результат побитно тот же, что у полного прохода (проверено гейтом), а работы в среднем вдвое меньше. Прибор — fp32-модель с весами, хранящимися в bf16: апкаст точен, поэтому это та же fp32-модель при вдвое меньшей памяти; эталон считается тем же прибором в том же процессе, и пол KL равен нулю по построению.
6.7 Что правило не делает
Правило не спасает от отсутствия AW-статистики (раздел 4.3: без неё 2.9B разрушается) и не отменяет фиксированных правок пресета: o_proj слоя 0 и эмбеддинг в 6 бит остаются его стартовой точкой. На больших моделях измерение считается там, где хватает памяти, и переносится как файл со строгой подписью чекпоинта — так же, как imatrix для GGUF.
7. GPTQ на сетке пресета COMPRESSION
Замечание. Таблицы разделов 7.2–7.5 и приложения B получены серверным прототипом GPTQ. Итоговые числа по файлам, которые пишет библиотека, приведены в разделе 9; точечные значения прототипа и библиотеки различаются в пределах разброса реализаций (раздел 7.6). Все измерения этого раздела — на чистых наборах (раздел 3.4).
7.1 Метод
Я переношу GPTQ (Frantar et al., 2022) на асимметричную суперблочную сетку asym_sb6_aw:
масштаб и сдвиг суперблока (256 колонок) вычисляются в его начале, по уже поправленным весам, тем же AW-поиском, что используется при обычной записи (RTN);
колонки квантуются по одной;
ошибка каждой колонки разносится на ещё не квантованные через H⁻¹.
Проход последовательный: вход каждой матрицы снимается с модели, в которой предыдущие матрицы уже квантованы (порядок: r, k, v → o → ffn.key → ffn.value, голова в конце). Эмбеддинг — таблица поиска, GPTQ его не затрагивает. Формат файла, ядра и размер не меняются.
Проверки корректности: при диагональной H коды побитно равны RTN (проверка 0); файл, записанный библиотекой, побитно равен fake-пути GPTQ (гейт).
7.2 Регуляризация важнее размера калибровки
Первая версия: 48 окон корпуса пакета, демпфирование damp = 0.01. KL к RTN, чистый набор:
модель | текст | en | код |
|---|---|---|---|
2.9B | −21.1% | −12.2 | −37.9% |
7.2B | +0.4% | +13.6 | −21.4% |
13.3B | +4.7% | +17.7 | −21.4% |
На больших моделях английский текст стал хуже RTN. Причина — переобучение: 24.5 тыс. токенов на оценку H размером до 16384×16384. Это подтверждается двумя контрольными прогонами на 7.2B: damp 0.1 на тех же 48 окнах даёт −21.0% (en −17.1), а 82 окна при damp 0.01 дают лишь −4.9% (en +6.7). Дело именно в регуляризации, а не в числе окон.
7.3 Калибровочный корпус v2
600 окон по 512 токенов (307 тыс. токенов), собраны из открытых источников:
доля | состав |
|---|---|
en 30% | FineWeb-Edu |
ru 20% | FineWeb-2, русская литература, oasst2 |
код 20% | UltraData-Code, 6 языков, плюс открытый код проекта |
zh 10% | FineWeb-2, novel_text |
sr 10% | кириллица и латиница пополам |
рассуждения 10% | дистилляции двух моделей |
Порядок окон — взвешенный круг между группами, поэтому любой префикс сохраняет доли. Окна, содержащие 16-граммы любого оценочного набора, выброшены.
7.4 Результаты: GPTQ против RTN
KL к RTN-пресету при damp 0.1 на чистых наборах (текст / en / ru / sr / код) и изменение Δppl:
модель | окон | KL | Δppl текст | Δppl код |
|---|---|---|---|---|
0.1B | 150 | −33.6 / −34.7 / −30.6 / −35.8 / −35.8 | +7.80 → +5.12% | — |
1.5B | 150 | −39.6 / −41.3 / −39.8 / −37.7 / −46.7 | +3.91 → +2.63% | +3.84 → +2.18% |
1.5B | 600 | −42.2 / −40.2 / −42.5 / −43.9 / −49.9 | +3.91 → +2.55% | +3.84 → +1.85% |
2.9B | 150 | −38.7 / −37.5 / −38.4 / −40.1 / −43.1 | +2.78 → +1.69% | +2.33 → +1.53% |
2.9B | 600 | −42.5 / −42.2 / −42.6 / −42.7 / −46.4 | +2.78 → +1.49% | +2.33 → +1.04% |
7.2B | 150 | −22.8 / −18.6 / −22.4 / −27.5 / −34.2 | +1.85 → +1.44% | +1.22 → +0.84% |
7.2B | 600 | −28.8 / −25.4 / −27.2 / −33.8 / −38.5 | +1.85 → +1.31% | +1.22 → +0.76% |
13.3B | 150 | −21.0 / −17.3 / −19.9 / −26.4 / −37.3 | +1.14 → +1.13% | +1.11 → +0.45% |
13.3B | 600 | −28.8 / −26.4 / −27.8 / −32.6 / −38.5 | +1.14 → +0.86% | +1.11 → +0.69% |
Ни один язык ни на одной модели не хуже RTN. damp 0.1 оказался лучше 0.01 и на малых моделях: на 1.5B и 2.9B при 150 окнах разница составляет 5–7 п. Большим моделям нужно больше окон: переход 150 → 600 даёт +6–8 п. по тексту на 7.2B и 13.3B и +3–4 п. на 1.5B и 2.9B. Английский выигрывает меньше других языков на всех масштабах.
Парный бутстрэп по окнам (600 окон калибровки; приложение B.2) показывает, что GPTQ значимо лучше RTN по KL и по ppl на каждой модели, по тексту и по коду; хуже RTN по KL оказалось одно окно из 360 (7.2B, текст).
7.5 Вместе с автоподбором
Измеряется KL к пресету без обоих методов, 600 окон калибровки. «Произведение» — ожидание при независимости методов: (1 − выигрыш GPTQ) × (1 − выигрыш автоподбора).
модель | KL текст | произведение | KL код | Δppl текст | Δppl код |
|---|---|---|---|---|---|
0.1B | −62.3% | −59.8% | −63.1% | +7.80 → +2.84% | +6.83 → +2.68% |
0.4B | −45.6% | −47.9% | −42.8% | +4.43 → +2.72% | +4.74 → +2.22% |
1.5B | −52.0% | −52.3% | −55.1% | +3.91 → +2.11% | +3.84 → +1.49% |
2.9B | −45.2% | −53.4% | −51.4% | +2.78 → +1.28% | +2.33 → +1.04% |
7.2B | −42.5% | −43.5% | −44.9% | +1.85 → +1.07% | +1.22 → +0.46% |
13.3B | −41.3% | −43.9% | −47.6% | +1.14 → +0.58% | +1.10 → +0.27% |
На пяти моделях из шести методы складываются почти мультипликативно, в пределах 3 п. Исключение — 2.9B: поверх GPTQ автоподбор добавляет лишь −4.7% по тексту (−9.2% по коду) вместо ожидаемых около −19%. Первая гипотеза (автоподбор на 2.9B тратит байты на o_proj слоя 0, а GPTQ уже чинит эту матрицу) оказалась неверной: o_proj слоя 0 хранится в bf16 в обоих пресетах и автоподбор её не трогает. Объяснение одними понижениями бит тоже неубедительно: доля понижений на 2.9B наибольшая, но на 13.3B лишь немного меньше, а сложение там почти мультипликативно. Затем выяснилось, что аномалия — артефакт пары прогонов прототипа (раздел 7.6): по файлам библиотеки автоподбор поверх GPTQ на 2.9B даёт −11.5% [−14.7; −8.2] и значим.
Важная деталь: измерение автоподбора делается при RTN. Прямая проверка зависимости — снять измерение по модели, в которой остальные матрицы уже прошли GPTQ, и сравнить выбор; она не проведена (раздел 11).
7.6 Воспроизводимость и разброс GPTQ
Детерминизм. Библиотечный GPTQ детерминирован: два прогона на разных картах и файл, собранный quantize() под нагрузкой сервера, побитно совпали (0.4B и 1.5B, REDUCTION, 144 тензора из 144).
Разброс между реализациями. Две численно эквивалентные реализации дают разные коды. Прототип брал верхний множитель Холецкого, библиотека — нижний с транспонированием; разница порядка 1e-15, но GPTQ разносит её по всей матрице. Итог файла библиотеки против прототипа, тем же прибором:
ΔKL, текст / код | Δppl код | |
|---|---|---|
1.5B COMPRESSION | +1.1 / +4.2% | +1.83 против +1.49% |
2.9B COMPRESSION | −5.3 / +0.6% | — |
0.4B COMPRESSION | +0.2 / +0.1% | — |
Знак случайный. Значит, у каждого одиночного GPTQ-числа есть погрешность «реализации» порядка ±5% KL и до ±0.35 п. ppl. Сравнения внутри этого разброса не доказаны.
Реплики. Чтобы измерить разброс, а не оценивать его по трём парам, библиотечный GPTQ повторён с переставленным порядком 600 окон калибровки: окна те же, меняется только порядок суммирования H, то есть возмущение того же рода, что смена множителя Холецкого. Файлы пишет quantize(), оценка — тот же прибор по записанному файлу; код здесь — открытый набор (48 окон). Умолчание COMPRESSION: 0.4B — 6 реплик, 1.5B и 2.9B — по 4; «только GPTQ» на 2.9B — 4 реплики.
модель, плечо | KL текст: sd / размах | KL код: sd / размах | размах Δppl текст / код, п. |
|---|---|---|---|
0.4B, умолчание | 0.6% / 1.6% | 0.8% / 2.2% | 0.38 / 0.37 |
1.5B, умолчание | 1.3% / 2.8% | 1.4% / 2.9% | 0.19 / 0.15 |
2.9B, умолчание | 1.2% / 2.7% | 2.1% / 4.7% | 0.27 / 0.19 |
2.9B, только GPTQ | 0.6% / 1.5% | 1.3% / 2.9% | 0.28 / 0.13 |
Что из этого следует.
Погрешность одиночного GPTQ-числа внутри библиотеки — около ±1.5% KL (одно sd), размах до 3–5%. Это меньше прежней оценки ±5%, сравнивавшей библиотеку с прототипом. Исходный порядок окон из облака реплик не выделяется (отклонение от среднего по перестановкам в пределах ±2%).
По ppl разброс реплик сравним с интервалом по окнам: размах 0.15–0.4 п. при Δppl +1…+2.7%. Различия Δppl между плечами меньше 0.3 п. по одному файлу не доказаны.
Шум отдельного окна — 4–8% KL (медиана sd по репликам). Поэтому счёт «в скольких окнах хуже» при эффектах порядка 10% ненадёжен, а среднее по окнам устойчиво.
Автоподбор поверх GPTQ на 2.9B значим. Среднее по репликам, интервал — совместный бутстрэп по окнам и репликам: текст −11.5% [−14.7; −8.2], код −7.4% [−10.6; −3.8]; все 16 пар реплик дают выигрыш (текст от −12.8 до −9.2%). На 0.4B и 1.5B (одна реплика «только GPTQ») выигрыш по тексту −12…−13% и −12…−14%.
Методы складываются чуть хуже произведения, на 2.9B сильнее всего: отношение измеренного к произведению — 2.9B текст 1.09 [1.05; 1.13], код 1.11 [1.07; 1.16]; 0.4B 1.03–1.05; 1.5B 1.04–1.07 по тексту и около 1.0 по коду. Прежние 1.18 на 2.9B сложились из двух отклонений прототипа в разные стороны: «только GPTQ» у прототипа 0.01560 против 0.01601 у библиотеки (среднее реплик), умолчание — 0.01486 против 0.01417.
7.7 Стоимость
Время GPTQ на RTX 4090 при 600 окнах:
модель | карт | время |
|---|---|---|
1.5B | 1 | 42 мин |
2.9B | 1 | 81 мин |
7.2B | 2 | 2.6 ч |
13.3B | 4 | 4.7 ч |
Активации калибровки держатся на хосте (2 × окна × 511 × D × 4 байта), слои разнесены по картам.
На MacBook Air M4 16 ГБ без вентилятора, пресет REDUCTION, вызов quantize() целиком:
модель | время | пик памяти | своп (изменение за прогон) |
|---|---|---|---|
0.1B | 17 мин | 7.7 ГБ | +0 |
0.4B | 49 мин | 8.9 ГБ | +0 |
1.5B | 2 ч 26 мин | 19.5 ГБ | −1.4 ГБ |
На 1.5B пик превышает объём ОЗУ: macOS сжимает память, время на слой остаётся ровным (около 6 мин). Оценка «модель + активации», по которой библиотека решает, запускать ли GPTQ неявно, занижает пик в 2.4–3.4 раза. Файлы, собранные на Mac (цикл GPTQ на CPU), по реальному пути совпадают с серверными в пределах разброса реализаций (1.5B, Δppl по двум наборам: +0.20 / +0.06% против +0.27 / +0.04%).
8. GPTQ в пресете REDUCTION
REDUCTION хранит проекции, cmix и голову в симметричной раскладке типа Q6_K (раздел 3.2). GPTQ переносится на эту сетку так же, как на асимметричную: сетка суперблока строится в его начале по поправленным весам, дальше идёт тот же цикл. Проверка 0 при диагональной H — побитное равенство RTN на 6 и 8 битах. Калибровка — те же 600 окон, damp 0.1.
KL к RTN-REDUCTION на чистых наборах (текст / en / ru / sr / код) и Δppl. Время — на одной RTX 4090 при совместной загрузке карт другими прогонами, поэтому ориентировочное:
модель | KL | Δppl текст | Δppl код | время |
|---|---|---|---|---|
0.1B | −22.4 / −28.7 / −19.5 / −20.6 / −27.9 | +0.50 → +0.47% | +0.60 → +0.48% | 14 мин |
0.4B | −22.7 / −21.5 / −22.7 / −23.7 / −27.2 | +0.29 → +0.21% | +0.23 → +0.18% | 29 мин |
1.5B | −28.4 / −24.5 / −29.1 / −31.4 / −32.1 | +0.35 → +0.27% | +0.07 → +0.05% | 43 мин |
2.9B | −29.6 / −26.2 / −31.2 / −31.4 / −33.6 | +0.15 → +0.09% | +0.15 → +0.15% | 75 мин |
7.2B | −21.1 / −12.6 / −23.6 / −27.3 / −24.3 | +0.12 → +0.13% | +0.09 → +0.09% | 2.4 ч, 2 карты |
13.3B | −17.1 / −16.2 / −20.0 / −15.2 / −31.6 | +0.07 → +0.07% | +0.10 → +0.09% | 5.2 ч, 4 карты* |
* Время на 4 картах при совместной загрузке сервера другими прогонами.
Ни один язык ни на одной модели не хуже RTN по KL. Относительный выигрыш (−17…−30% по тексту) меньше, чем в COMPRESSION (−34…−42%): для 8 бит это ожидаемо, ошибка округления мала и компенсировать нечего. С размером модели выигрыш не растёт: на 7.2B и 13.3B он наименьший по тексту, а английский на 7.2B выигрывает всего −12.6%. По коду выигрыш держится на всех масштабах (−24…−34%).
Парный бутстрэп по окнам (приложение B.4) подтверждает, что выигрыш по KL значим везде, на каждом языке каждой модели; самая слабая граница — английский на 7.2B, верхний край интервала −4.8%. По окнам GPTQ хуже RTN по KL не более чем в одном окне из 36 (текст) или 24 (код).
Изменение ppl не различимо ни на одной модели: все интервалы накрывают ноль, их ширина ±0.1–0.15%, что сравнимо с самой деградацией REDUCTION (+0.1–0.5%). По знаку ppl чаще лучше: у четырёх моделей из шести точечная оценка по тексту отрицательна, у 7.2B и 13.3B — +0.01%. Два языка, где ppl наклоняется в худшую сторону:
английский на 7.2B: +0.10% [−0.04; +0.24], P(хуже) = 0.92 — не значимо;
русский на 13.3B: +0.11% [+0.03; +0.19], P(хуже) = 0.997 — значимо; KL этого же языка при этом −20.0% [−24.8; −15.6].
Это около 30 парных сравнений (6 моделей × 5 срезов) на уровне 95%. Одно ложное срабатывание в такой серии ожидаемо, поэтому единичный значимый случай не опровергает вывод, но он записан.
Решение: GPTQ включён по умолчанию и в REDUCTION. Довод: REDUCTION служит базой для QLoRA и векторных моделей (эмбеддеров), где важна верность скрытых состояний исходной модели, а не ppl. Сетка в библиотеке та же, упаковка общая с RTN; RTN-файл после рефакторинга побайтно прежний. Библиотечный GPTQ на 0.1B воспроизводит прототип точно: KL и CE совпадают до шестого знака.
Вывод. GPTQ в REDUCTION значимо приближает модель к bf16 по распределению (KL), но на этом наборе не даёт измеримого выигрыша по ppl. Для near-lossless пресета это выигрыш в верности исходной модели, а не в качестве на задаче; чтобы увидеть его по ppl, нужно на порядок больше окон. Байты при этом не меняются.
9. Итоговые результаты по шести размерам
Здесь шесть масштабов измерены так, как результат получит пользователь: файлы пишет quantize() библиотеки, оценка идёт по записанному файлу одним прибором на чистых наборах (36 окон текста и 48 окон открытого кода). Интервалы Δppl — парный бутстрэп по окнам, 95%. Файл GPTQ имеет тот же размер, что RTN-файл той же конфигурации. Автоподбор — бюджет +0.5% файла; GPTQ — 600 окон калибровки v2, damp 0.1. Жирным выделено умолчание библиотеки (quantize(preset="compression") включает автоподбор и GPTQ).
Размеры файлов (МБ и доля от bf16):
модель | bf16 | REDUCTION | COMPRESSION + автоподбор |
|---|---|---|---|
0.1B | 382 | 191 (50.1%) | 134 (35.2%) |
0.4B | 902 | 434 (48.1%) | 299 (33.2%) |
1.5B | 3055 | 1439 (47.1%) | 997 (32.6%) |
2.9B | 5896 | 2743 (46.5%) | 1892 (32.1%) |
7.2B | 14400 | 6648 (46.2%) | 4576 (31.8%) |
13.3B | 26541 | 12178 (45.9%) | 8377 (31.6%) |
Качество:
модель | плечо | МБ | KL текст | KL код | Δppl текст, % | Δppl код, % |
|---|---|---|---|---|---|---|
0.1B | REDUCTION | 191.3 | 0.00550 | 0.00555 | +0.49 [+0.33; +0.65] | +0.75 [+0.60; +0.90] |
0.1B | REDUCTION + GPTQ (умолчание) | 191.3 | 0.00426 | 0.00399 | +0.46 [+0.33; +0.59] | +0.55 [+0.41; +0.69] |
0.1B | COMPRESSION | 133.9 | 0.07420 | 0.06944 | +7.76 [+6.81; +8.73] | +6.61 [+5.84; +7.43] |
0.1B | + автоподбор | 134.4 | 0.04524 | 0.04011 | +5.13 [+4.59; +5.66] | +3.56 [+3.13; +3.98] |
0.1B | + GPTQ | 133.9 | 0.04838 | 0.04082 | +4.95 [+4.33; +5.58] | +3.60 [+3.11; +4.09] |
0.1B | + оба (умолчание) | 134.4 | 0.02864 | 0.02476 | +2.76 [+2.28; +3.25] | +2.47 [+2.18; +2.77] |
0.4B | REDUCTION | 434.1 | 0.00313 | 0.00280 | +0.28 [+0.16; +0.40] | +0.21 [+0.11; +0.32] |
0.4B | REDUCTION + GPTQ (умолчание) | 434.1 | 0.00242 | 0.00205 | +0.20 [+0.10; +0.31] | +0.19 [+0.11; +0.28] |
0.4B | COMPRESSION | 301.2 | 0.04805 | 0.04264 | +4.40 [+3.75; +5.07] | +4.38 [+3.85; +4.90] |
0.4B | + автоподбор | 299.2 | 0.04038 | 0.03757 | +4.19 [+3.67; +4.72] | +3.56 [+3.07; +4.07] |
0.4B | + GPTQ | 301.2 | 0.02956 | 0.02564 | +2.96 [+2.44; +3.48] | +2.45 [+2.02; +2.91] |
0.4B | + оба (умолчание) | 299.2 | 0.02599 | 0.02306 | +2.57 [+2.11; +3.04] | +2.00 [+1.60; +2.42] |
1.5B | REDUCTION | 1439.0 | 0.00239 | 0.00244 | +0.35 [+0.22; +0.47] | +0.13 [+0.02; +0.23] |
1.5B | REDUCTION + GPTQ (умолчание) | 1439.0 | 0.00171 | 0.00162 | +0.27 [+0.17; +0.37] | +0.03 [-0.04; +0.10] |
1.5B | COMPRESSION | 993.4 | 0.03779 | 0.04061 | +3.90 [+3.40; +4.43] | +3.85 [+3.40; +4.30] |
1.5B | + автоподбор | 996.5 | 0.03119 | 0.03597 | +3.29 [+2.86; +3.72] | +3.59 [+3.10; +4.08] |
1.5B | + GPTQ | 993.4 | 0.02135 | 0.02073 | +2.54 [+2.13; +2.94] | +1.76 [+1.44; +2.09] |
1.5B | + оба (умолчание) | 996.5 | 0.01831 | 0.01874 | +1.98 [+1.55; +2.44] | +1.69 [+1.28; +2.13] |
2.9B | REDUCTION | 2743.3 | 0.00177 | 0.00180 | +0.15 [+0.05; +0.26] | +0.05 [-0.04; +0.14] |
2.9B | REDUCTION + GPTQ (умолчание) | 2743.3 | 0.00125 | 0.00120 | +0.09 [-0.01; +0.19] | +0.05 [-0.02; +0.12] |
2.9B | COMPRESSION | 1885.5 | 0.02708 | 0.02976 | +2.77 [+2.33; +3.22] | +2.63 [+2.21; +3.03] |
2.9B | + автоподбор | 1891.8 | 0.02192 | 0.02480 | +2.12 [+1.65; +2.58] | +2.18 [+1.77; +2.59] |
2.9B | + GPTQ | 1885.5 | 0.01610 | 0.01514 | +1.75 [+1.42; +2.08] | +1.30 [+1.02; +1.58] |
2.9B | + оба (умолчание) | 1891.8 | 0.01406 | 0.01394 | +1.32 [+1.09; +1.56] | +1.05 [+0.76; +1.34] |
7.2B | REDUCTION | 6647.8 | 0.00119 | 0.00112 | +0.12 [+0.04; +0.21] | +0.11 [+0.04; +0.18] |
7.2B | REDUCTION + GPTQ (умолчание) | 6647.8 | 0.00093 | 0.00081 | +0.13 [+0.07; +0.20] | +0.08 [+0.02; +0.14] |
7.2B | COMPRESSION | 4555.0 | 0.01682 | 0.01686 | +1.88 [+1.56; +2.20] | +1.51 [+1.23; +1.79] |
7.2B | + автоподбор | 4576.0 | 0.01331 | 0.01437 | +1.52 [+1.17; +1.87] | +1.09 [+0.80; +1.40] |
7.2B | + GPTQ | 4555.0 | 0.01201 | 0.00978 | +1.02 [+0.68; +1.37] | +0.71 [+0.49; +0.94] |
7.2B | + оба (умолчание) | 4576.0 | 0.00992 | 0.00857 | +0.95 [+0.68; +1.22] | +0.67 [+0.48; +0.86] |
13.3B | REDUCTION | 12178.4 | 0.00082 | 0.00090 | +0.07 [+0.00; +0.13] | +0.11 [+0.05; +0.16] |
13.3B | REDUCTION + GPTQ (умолчание) | 12178.4 | 0.00068 | 0.00065 | +0.07 [+0.02; +0.13] | +0.10 [+0.05; +0.15] |
13.3B | COMPRESSION | 8337.1 | 0.01128 | 0.01228 | +1.15 [+0.87; +1.44] | +1.12 [+0.85; +1.39] |
13.3B | + автоподбор | 8377.0 | 0.00889 | 0.01020 | +0.88 [+0.64; +1.12] | +0.75 [+0.53; +0.96] |
13.3B | + GPTQ | 8337.1 | 0.00814 | 0.00705 | +0.83 [+0.59; +1.08] | +0.38 [+0.21; +0.56] |
13.3B | + оба (умолчание) | 8377.0 | 0.00687 | 0.00615 | +0.70 [+0.49; +0.93] | +0.40 [+0.23; +0.57] |
Что видно.
Относительная деградация монотонно падает с размером модели в обоих пресетах. COMPRESSION, KL текста: 0.074 → 0.048 → 0.038 → 0.027 → 0.017 → 0.011. REDUCTION: 0.0055 → 0.0031 → 0.0024 → 0.0018 → 0.0012 → 0.0008. Аномалия 2.9B из раздела 4 после правок пресета (
o_projслоя 0, эмбеддинг в 6 бит) в этой линейке уже не видна. Потери умолчания COMPRESSION падают с размером и по Δppl: +2.76, +2.57, +1.98, +1.32, +0.95, +0.70% по тексту.Сжатие растёт с размером. Доля «неконтролируемых» тензоров (LoRA-ветки, малые тензоры, нормы) убывает: REDUCTION 50% → 46%, COMPRESSION 35% → 31.4%.
Оба метода окупаются сильнее всего на самой малой модели. На 0.1B умолчание снимает 62% KL пресета, на остальных 41–52% (раздел 7.5). Поэтому умолчание COMPRESSION на 0.4B (+2.57%) лучше голого пресета на 1.5B (+3.90%), а умолчание на 2.9B (+1.32%) — голого пресета на 7.2B (+1.88%).
Автоподбор почти не стоит байт. Прибавка составляет 0.1–0.2% файла; на 0.4B размер даже уменьшился. Бюджет +0.5% не выбирается целиком: правило упирается в τ.
О строгости монотонности. Для голых пресетов монотонность по размеру держится с запасом: интервалы KL соседних масштабов не пересекаются ни в REDUCTION, ни в COMPRESSION (по таблице прототипа). Для умолчания COMPRESSION она держится по точечным оценкам, но интервалы соседних масштабов пересекаются (например, KL текста 0.0279 [0.0263; 0.0296] у 0.1B против 0.0260 [0.0242; 0.0278] у 0.4B — по предварительной таблице прототипа — и аналогично у пары 1.5B/2.9B). Интервалы Δppl соседних масштабов в основном перекрываются; строго различимы далёкие масштабы, например 0.1B (+2.76 [+2.28; +3.25]) и 13.3B (+0.70 [+0.49; +0.93]).
Замена закрытого набора кода на открытый ни одного вывода не сдвинула: KL по двум наборам кода расходится в пределах 10%.
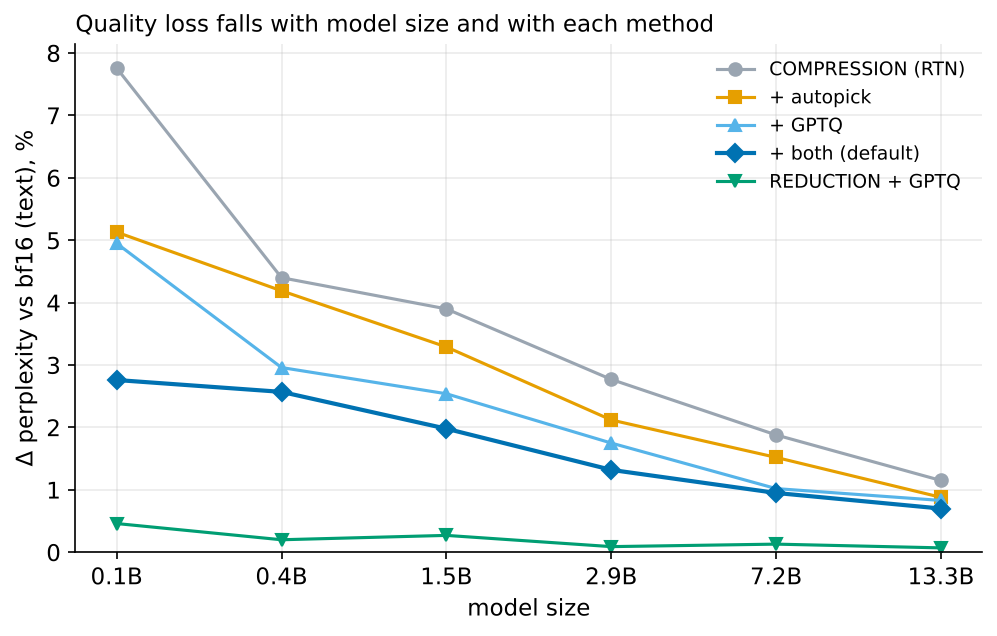
Рис. 6. Δppl относительно bf16 для шести размеров: RTN, автоподбор, GPTQ и их сочетание. Данные из таблицы итогов этого раздела.
10. Сравнение с GGUF и MLX при равном размере файла
Чужие форматы собраны из того же чекпоинта g1j и измерены тем же прибором, что мои файлы: их квантованные веса деквантуются и подставляются в эталонную модель, дальше — те же окна и та же KL к bf16.
GGUF:
llama-quantize, Q4_K_M и Q6_K с imatrix по тем же 600 окнам, что у моего GPTQ; деквантование —gguf-py. В этой сборке Q4_K_M держит голову в Q6_K, а LoRA — в F16.MLX: схема опубликованных файлов (affine, группа 64). int6 — всё в 6 бит; int4 — проекции и FFN в 4 бита, эмбеддинг, голова и LoRA в 6. Коды снимает сам
mx.quantize, деквантование на сервере побитно равноmx.dequantize.Мои файлы равного размера: сетка REDUCTION (симметричная, тип Q6_K) с 6 битами.
sym6— проекции, эмбеддинг и голова в 6 бит (размер int6);sym6h8— только проекции в 6 бит, эмбеддинг и голова в 8 (размер Q6_K). Автоподбора здесь нет: это не оптимизированные точки, а простейшая замена битности.
1.5B
формат | МБ | KL текст | KL код | Δppl текст, % | Δppl код, % |
|---|---|---|---|---|---|
MLX int4 | 970.4 | 0.11642 | 0.12479 | +12.71 [+11.43; +14.03] | +12.14 [+11.14; +13.16] |
GGUF Q4_K_M (imatrix) | 990.1 | 0.03926 | 0.04049 | +4.07 [+3.48; +4.72] | +3.76 [+3.32; +4.21] |
мой COMPRESSION (умолчание) | 996.5 | 0.01831 | 0.01874 | +1.98 [+1.54; +2.44] | +1.69 [+1.28; +2.12] |
мой sym6, без GPTQ | 1272.3 | 0.00375 | 0.00402 | +0.51 [+0.35; +0.67] | +0.29 [+0.15; +0.43] |
мой sym6 + GPTQ | 1272.3 | 0.00260 | 0.00251 | +0.31 [+0.17; +0.45] | +0.16 [+0.04; +0.27] |
MLX int6 | 1272.4 | 0.00901 | 0.00971 | +0.83 [+0.64; +1.03] | +0.54 [+0.34; +0.75] |
GGUF Q6_K (imatrix) | 1336.1 | 0.00406 | 0.00426 | +0.48 [+0.34; +0.61] | +0.27 [+0.15; +0.39] |
мой sym6h8, без GPTQ | 1339.4 | 0.00304 | 0.00329 | +0.41 [+0.27; +0.54] | +0.21 [+0.07; +0.33] |
мой sym6h8 + GPTQ | 1339.4 | 0.00208 | 0.00207 | +0.27 [+0.16; +0.38] | +0.11 [+0.01; +0.22] |
мой REDUCTION (умолчание) | 1439.0 | 0.00171 | 0.00162 | +0.27 [+0.17; +0.37] | +0.03 [-0.04; +0.10] |
2.9B
формат | МБ | KL текст | KL код | Δppl текст, % | Δppl код, % |
|---|---|---|---|---|---|
MLX int4 | 1824.2 | 0.50748 | 0.46978 | +66.14 [+53.11; +81.85] | +55.45 [+47.30; +64.44] |
GGUF Q4_K_M (imatrix) | 1875.8 | 1.37847 | 1.50555 | +304.99 [+203.92; +497.81] | +328.67 [+201.28; +647.98] |
мой COMPRESSION (умолчание) | 1891.8 | 0.01406 | 0.01394 | +1.32 [+1.09; +1.56] | +1.05 [+0.76; +1.34] |
мой sym6, без GPTQ | 2451.4 | 0.00288 | 0.00305 | +0.27 [+0.12; +0.42] | +0.16 [+0.05; +0.26] |
мой sym6 + GPTQ | 2451.4 | 0.00205 | 0.00206 | +0.22 [+0.10; +0.34] | +0.05 [-0.04; +0.15] |
MLX int6 | 2453.4 | 0.01514 | 0.01967 | +1.16 [+0.75; +1.54] | +1.67 [+1.33; +2.02] |
мой sym6h8, без GPTQ | 2535.3 | 0.00223 | 0.00239 | +0.22 [+0.11; +0.34] | +0.15 [+0.05; +0.25] |
мой sym6h8 + GPTQ | 2535.3 | 0.00155 | 0.00153 | +0.20 [+0.10; +0.31] | -0.01 [-0.11; +0.08] |
GGUF Q6_K (imatrix) | 2567.9 | 0.00512 | 0.00714 | +0.33 [+0.11; +0.53] | +0.63 [+0.42; +0.85] |
мой REDUCTION (умолчание) | 2743.3 | 0.00125 | 0.00120 | +0.09 [-0.01; +0.19] | +0.05 [-0.02; +0.12] |
Отношения KL «чужой формат / мой файл» (парный бутстрэп по окнам; значение > 1 означает, что мой файл точнее). В скобках — разница размера моего файла относительно чужого.
1.5B
чужой / мой | размер моего | KL текст | KL код |
|---|---|---|---|
GGUF Q4_K_M (imatrix) / мой COMPRESSION (умолчание) | +0.7% | 2.14 [1.98; 2.30] | 2.16 [2.05; 2.28] |
MLX int4 / мой COMPRESSION (умолчание) | +2.7% | 6.36 [5.84; 6.92] | 6.66 [6.20; 7.14] |
MLX int6 / мой sym6 + GPTQ | -0.0% | 3.47 [3.23; 3.74] | 3.86 [3.72; 4.01] |
MLX int6 / мой sym6, без GPTQ | -0.0% | 2.40 [2.29; 2.53] | 2.42 [2.35; 2.49] |
GGUF Q6_K (imatrix) / мой sym6h8 + GPTQ | +0.2% | 1.95 [1.82; 2.09] | 2.06 [1.95; 2.17] |
GGUF Q6_K (imatrix) / мой sym6h8, без GPTQ | +0.2% | 1.34 [1.27; 1.40] | 1.29 [1.24; 1.35] |
MLX int6 / мой COMPRESSION (умолчание) | -21.7% | 0.49 [0.45; 0.53] | 0.52 [0.48; 0.56] |
GGUF Q6_K (imatrix) / мой REDUCTION (умолчание) | +7.7% | 2.37 [2.18; 2.58] | 2.63 [2.49; 2.76] |
MLX int6 / мой REDUCTION (умолчание) | +13.1% | 5.27 [4.88; 5.71] | 5.98 [5.70; 6.28] |
2.9B
чужой / мой | размер моего | KL текст | KL код |
|---|---|---|---|
GGUF Q4_K_M (imatrix) / мой COMPRESSION (умолчание) | +0.9% | 98.06 [75.72; 129.80] | 108.00 [81.83; 149.56] |
MLX int4 / мой COMPRESSION (умолчание) | +3.7% | 36.10 [29.93; 42.99] | 33.70 [29.72; 38.19] |
MLX int6 / мой sym6 + GPTQ | -0.1% | 7.38 [6.57; 8.42] | 9.57 [8.71; 10.57] |
MLX int6 / мой sym6, без GPTQ | -0.1% | 5.26 [4.72; 5.95] | 6.46 [5.93; 7.05] |
GGUF Q6_K (imatrix) / мой sym6h8 + GPTQ | -1.3% | 3.31 [2.92; 3.76] | 4.65 [4.25; 5.09] |
GGUF Q6_K (imatrix) / мой sym6h8, без GPTQ | -1.3% | 2.30 [2.08; 2.56] | 2.99 [2.75; 3.25] |
MLX int6 / мой COMPRESSION (умолчание) | -22.9% | 1.08 [0.94; 1.26] | 1.41 [1.27; 1.57] |
GGUF Q6_K (imatrix) / мой REDUCTION (умолчание) | +6.8% | 4.10 [3.63; 4.69] | 5.97 [5.45; 6.51] |
MLX int6 / мой REDUCTION (умолчание) | +11.8% | 12.13 [10.62; 14.15] | 16.45 [14.99; 18.18] |
Что из этого следует.
При равном размере мой файл точнее в каждой паре. На 1.5B: против Q4_K_M — в 2.1 раза по KL, против Q6_K — в 2.0, против MLX int6 — в 3.5, против MLX int4 — в 6.4. На 2.9B: против Q6_K — в 3.3 раза, против MLX int6 — в 7.4, против MLX int4 — в 36; Q4_K_M там сломан (п. 4).
Часть отрыва даёт формат, часть — GPTQ. Без GPTQ моя 6-битная сетка уже лучше int6 в 2.4 раза (5.3 раза на 2.9B) и лучше Q6_K с imatrix в 1.34 раза (1.5B). На 4 битах иначе: голый пресет COMPRESSION равен Q4_K_M с imatrix (KL 0.0378 против 0.0393), и весь отрыв там даёт автоподбор вместе с GPTQ.
Разрыв с MLX растёт с размером модели. Причина —
o_projнулевого слоя (раздел 4): affine-схема квантует его наравне со всеми, и на 2.9B int4 разваливается (+66% ppl), а int6 теряет больше, чем мой файл на 23% меньше.Q4_K_M на 2.9B сломан. KL 1.38, +305% ppl по моему прибору. Это не артефакт подстановки весов: сам llama.cpp на том же файле даёт ppl 31.4 против 6.54 у Q6_K (wikitext-2, 12 окон по 512), тогда как на 1.5B та же сборка ведёт себя нормально (10.67 против 10.33). Ошибки весов при этом обычные, около 7.5%; наибольшая — у
o_projнулевого слоя (9.5%). То есть слабое место из раздела 4 воспроизводится в чужом формате и чужом движке, причём сильнее, чем в MLX int4.Оговорки. Отношения сняты на двух моделях одной линейки и на 36 + 48 окнах. imatrix и GPTQ получили одни и те же окна, но используют их по-разному. Точки
sym6не проверены на реальном пути Metal.
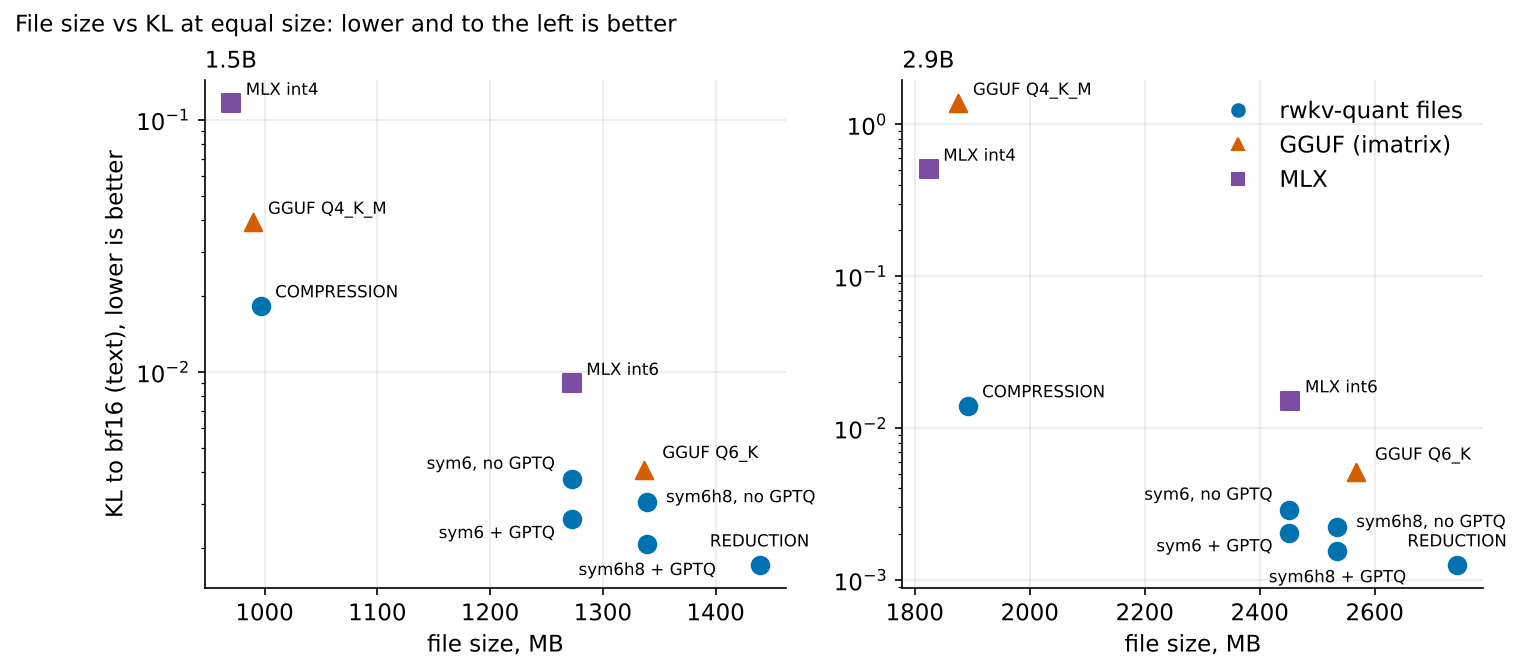
Рис. 7. Размер файла и KL(bf16‖квант) для 1.5B и 2.9B. Точки левее и ниже лучше. Значения KL сравнимы только внутри одного прибора.
11. Обсуждение и ограничения
Что я считаю главным. Качество квантованной модели определяется не равномерной ошибкой, а несколькими матрицами, ошибка которых вносится в остаточный поток в «усиливаемых» местах сети. Локальные метрики (концентрация входа, диагональная ошибка выхода, локальная ошибка впрыска) этого не видят (раздел 5). Практический вывод: битность нужно назначать по измеренному вреду на байт, а не по эвристике, и правило должно работать в обе стороны, иначе оно только раздувает файл.
Ограничения.
Утечка в диагностических разделах. Разделы 4–5 измерены на наборе, лежащем внутри калибровочного корпуса. Направление смещения (в пользу AW) известно, величина — нет. Выводы раздела 4 — сравнительные и при одной статистике; итоговые результаты получены на чистых наборах.
Метрика — KL и ppl, не задачи. Качество на downstream-задачах не измерялось.
Одна линейка чекпоинтов. Итоговые таблицы относятся к серии g1j; диагностика частично использует g1d и g1h.
Разброс GPTQ. У одиночного GPTQ-числа есть погрешность около ±1.5% KL (одно sd) и размах реплик по ppl 0.15–0.4 п.; различия Δppl меньше 0.3 п. по одному файлу не доказаны (раздел 7.6).
Зависимость от целевых данных. Автоподбор минимизирует KL на окнах выбора, и английский выигрывает меньше остальных языков на всех масштабах (раздел 6.3, раздел 7.4). Состав выбора — решение о целевых данных.
Предсказанный выигрыш завышен. Отчёт автоподбора завышает эффект (13.3B: предсказано −32.9%, измерено −21.1%), поэтому доверять следует только замеру файла.
Приборы не взаимозаменяемы. fake-путь и реальный путь дают разные абсолютные KL; перенос измерения между приборами (CUDA/fp64 и MPS/fp32) не проверен. Модели 7.2B и 13.3B на Mac не помещаются и оценены по файлу на сервере.
Измерение автоподбора делается при RTN, а не по модели с уже применённым GPTQ; прямая проверка (снять измерение после GPTQ и сравнить выбор) не проведена.
Не проверены точки
sym6на реальном пути Metal (раздел 10). Квота окон автоподбора (en 4 / code 4 / ru 2 / sr 2 / zh 2) выбрана по замеру на 1.5B g1j: при бюджете +0.5% прицел в один язык почти не давал выигрыша (en: −16.5% против −16.3%), а ручные приоритеты (en 0.4 / code 0.35) проигрывали почти везде; зависимость от модели и от бюджета не исследована.Нерешённое наблюдение о числе голов. Правка слоя 0 помогает ровно там, где число голов не является степенью двойки (12 у 0.1B и 40 у 2.9B против 16, 32 и 64 у остальных). Это совпадение на пяти точках; fake-путь воспроизводит эффект, значит дело не в Metal-ядрах. Проверка на 13.3B (H=64) ничего не решит: она предсказывает «ничего», что совместимо с любой причиной. Я привожу наблюдение как открытый вопрос, а не как результат.
Не выяснен механизм ускорения при хранении матрицы слоя 0 в bf16 (раздел 4.6).
12. Заключение
На примере RWKV-7 я показал, что аномалия «большая модель деградирует сильнее» при 4-битном квантовании объясняется двумя адресами: выходной проекцией нулевого блока и эмбеддингом. Фиксированные правки (одна матрица в bf16 и эмбеддинг в 6 бит) стоят около 1.6% файла и возвращают 2.9B в монотонную линейку. На них строятся автоподбор битности по правилу «вред на байт» и перенос GPTQ на ту же сетку: вместе они снижают потери по перплексии от +2.76% (0.1B) до +0.70% (13.3B) при 31.6–35.2% от размера bf16, а пресет REDUCTION с GPTQ даёт +0.46…+0.07% при 46–50%. При равном размере файла результат точнее GGUF и MLX на двух проверенных масштабах. Я также количественно описал два источника ошибок измерения, которые легко пропустить: утечку калибровочного корпуса в оценочный набор (завышение эффекта в 2.3 раза на GPTQ) и разброс GPTQ между численно эквивалентными реализациями.
Дальнейшая работа. Проверка на downstream-задачах; прямая проверка автоподбора по модели после GPTQ; эксперимент по гипотезе о числе голов на дополнительной точке; дообучение сжатых моделей (верхние слои и state-tuning над REDUCTION) вынесено в отдельную работу.
Литература
Frantar, E., Ashkboos, S., Hoefler, T., Alistarh, D. GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers. 2022. arXiv:2210.17323.
Dettmers, T., Lewis, M., Belkada, Y., Zettlemoyer, L. LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale. 2022. arXiv:2208.07339.
Sun, M., Chen, X., Kolter, J. Z., Liu, Z. Massive Activations in Large Language Models. 2024. arXiv:2402.17762.
Lin, J., Tang, J., Tang, H., Yang, S., Dang, X., Han, S. AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration. 2023. arXiv:2306.00978.
Peng, B. et al. RWKV-7 «Goose» with Expressive Dynamic State Evolution. 2025.
llama.cpp (GGUF,
llama-quantize, imatrix). https://github.com/ggml-org/llama.cppMLX (
mx.quantize). https://github.com/ml-explore/mlx
Приложение A. Четыре инженерные ошибки, исказившие измерения
Запись за границей буфера в
torch.linalg.cholesky(upper=True)(torch 2.13, macOS). Ошибка портила уже упакованные коды и давала segfault в MPSGraph. Замена — нижний фактор с транспонированием, побитно тот же U. На CUDA/MKL бага нет.Точные нули в GPTQ. GPTQ обнуляет почти мёртвые строки точно. На нулевом суперблоке сдвиг
sb6считался как 0/0 и давал NaN. Эталонный гейт упаковки был снят с этим NaN и охранял дефект. Урок: побитный гейт охраняет поведение, а не правильность, поэтому к хешам нужны утверждения о свойствах (например, конечность значений).Слияние словарей.
dict(done, **overrides)отдаёт совпавшие ключи правому словарю. Выбор автоподбора затирал отметку «уже прошло GPTQ», и прямой проход квантовал GPTQ-веса повторно.Деквантование читателя округлялось в bf16. Для 8-битных кодов это вторая ошибка порядка 1/4 шага сетки: +2–3% KL у REDUCTION при чтении файла в PyTorch (на 1.5B +3.1% к fake-пути, при fp16-деквантовании +0.1%). Теперь деквантование идёт в fp16: та же память, в 8 раз точнее. Metal почти не затронут (≤ 0.04 п. ppl): линейные слои декодируются в ядрах, а bf16-округление было только у таблицы эмбеддинга и LoRA. Побочно пришлось поправить гейты, сверявшие упаковку с fake-путём записи: запись округляет fp32 в bf16 один раз, а цепочка fp32 → fp16 → bf16 даёт двойное округление; теперь такие гейты сверяют через
dtype=float32.
Приложение B. Таблицы парного бутстрэпа
Везде 20 000 повторов, окна ресэмплируются вместе для обоих плеч; числа в процентах, 95%-интервал в скобках. Серверный прибор; для 1.5B это отдельный серверный замер, поэтому точечные оценки отличаются от строки «Mac» в разделе 6.4 на доли пункта. Таблицы B.1–B.2 получены до перехода на файлы библиотеки (раздел 7); итоговые числа по файлам — раздел 9.
B.1 Автоподбор против пресета (изменение KL и ppl)
модель | KL текст | KL en | KL код | ppl текст | ppl код |
|---|---|---|---|---|---|
0.1B | −38.8 [−40.5; −37.1] | −35.2 [−38.8; −31.0] | −43.6 [−45.9; −41.1] | −2.46 [−3.20; −1.72] | −3.02 [−3.84; −2.24] |
0.4B | −15.7 [−18.3; −12.9] | −7.5 [−12.2; −3.1] | −8.4 [−11.4; −4.8] | −0.19 [−0.70; +0.31] | −0.65 [−1.31; +0.00] |
1.5B | −17.5 [−19.9; −15.1] | −17.4 [−20.1; −14.8] | −12.9 [−15.9; −9.8] | −0.59 [−0.93; −0.24] | −0.59 [−1.02; −0.15] |
2.9B | −18.9 [−21.7; −16.0] | −18.7 [−23.0; −14.5] | −15.6 [−18.2; −12.8] | −0.62 [−0.94; −0.30] | −0.23 [−0.77; +0.33] |
7.2B | −20.7 [−24.1; −17.5] | −25.1 [−27.8; −22.6] | −13.6 [−16.5; −10.8] | −0.34 [−0.62; −0.05] | −0.36 [−0.63; −0.06] |
13.3B | −21.1 [−23.4; −18.9] | −23.4 [−26.6; −20.0] | −17.4 [−21.4; −13.8] | −0.27 [−0.51; −0.05] | −0.52 [−0.79; −0.25] |
По KL автоподбор значимо лучше пресета на каждой модели и в каждом срезе. По ppl выигрыш не значим в двух клетках: текст на 0.4B и код на 2.9B.
B.2 GPTQ против RTN на сетке COMPRESSION
модель | KL текст | KL en | KL код | ppl текст | ppl код |
|---|---|---|---|---|---|
0.1B | −34.3 [−35.9; −32.8] | −38.7 [−41.1; −36.4] | −37.3 [−40.6; −34.1] | −2.60 [−3.22; −2.00] | −2.40 [−3.44; −1.46] |
0.4B | −38.2 [−40.7; −35.6] | −32.4 [−36.5; −28.5] | −37.2 [−40.5; −33.6] | −1.31 [−1.91; −0.69] | −2.36 [−2.81; −1.87] |
1.5B | −42.2 [−44.9; −39.3] | −40.2 [−45.5; −35.0] | −49.9 [−52.6; −47.0] | −1.31 [−1.71; −0.92] | −1.91 [−2.61; −1.21] |
2.9B | −42.5 [−45.3; −39.5] | −42.2 [−46.2; −38.0] | −46.4 [−50.3; −42.0] | −1.26 [−1.67; −0.85] | −1.26 [−1.84; −0.67] |
7.2B | −28.8 [−32.5; −25.0] | −25.4 [−29.8; −21.2] | −38.5 [−42.0; −34.7] | −0.53 [−0.80; −0.26] | −0.46 [−0.87; −0.06] |
13.3B | −28.8 [−32.1; −25.7] | −26.4 [−31.6; −21.9] | −38.5 [−42.6; −34.0] | −0.28 [−0.53; −0.02] | −0.41 [−0.81; −0.02] |
GPTQ значимо лучше RTN по KL и по ppl на каждой модели, по тексту и по коду.
B.3 Умолчание (автоподбор + GPTQ) против пресета и вклад автоподбора поверх GPTQ
Последний столбец — измеренное отношение KL, делённое на произведение отношений двух методов по отдельности; 1 означает независимость.
модель | умолчание, KL текст | умолчание, KL код | умолчание, ppl текст | автоподбор поверх GPTQ, KL текст / код | измерено / произведение, текст / код |
|---|---|---|---|---|---|
0.1B | −62.3 [−63.5; −61.0] | −63.1 [−65.0; −61.1] | −4.60 [−5.32; −3.88] | −42.6 [−44.8; −40.1] / −41.1 [−43.7; −38.4] | 0.94 [0.91; 0.97] / 1.05 [1.00; 1.10] |
0.4B | −45.6 [−48.7; −42.2] | −42.8 [−46.2; −39.1] | −1.64 [−2.20; −1.08] | −12.1 [−15.5; −8.5] / −8.9 [−11.9; −5.6] | 1.04 [1.01; 1.08] / 1.00 [0.95; 1.04] |
1.5B | −52.0 [−54.4; −49.3] | −55.2 [−57.9; −52.1] | −1.73 [−2.20; −1.27] | −16.9 [−19.8; −14.3] / −10.5 [−13.7; −7.3] | 1.01 [0.97; 1.04] / 1.03 [0.98; 1.08] |
2.9B | −45.2 [−49.4; −40.6] | −51.4 [−55.7; −46.7] | −1.46 [−1.92; −1.01] | −4.7 [−10.4; +2.0] / −9.3 [−14.5; −3.0] | 1.18 [1.11; 1.25] / 1.08 [1.00; 1.16] |
7.2B | −42.5 [−45.9; −39.0] | −45.0 [−47.9; −41.6] | −0.76 [−1.14; −0.39] | −19.2 [−22.6; −15.5] / −10.5 [−13.9; −7.1] | 1.02 [0.96; 1.08] / 1.04 [0.98; 1.09] |
13.3B | −41.3 [−44.7; −37.8] | −47.6 [−51.5; −43.2] | −0.55 [−0.79; −0.31] | −17.5 [−21.2; −13.4] / −14.7 [−18.0; −11.1] | 1.05 [1.00; 1.10] / 1.03 [0.98; 1.10] |
Умолчание лучше пресета по KL на каждой модели, ни одно окно из 360 не хуже; ppl текста значимо лучше везде. Автоподбор поверх GPTQ значим на пяти моделях из шести; на 2.9B по тексту интервал накрывает ноль (в строке прототипа), на 0.4B не значим английский: −2.0% [−8.6; +4.1], 7 окон из 12 хуже. Строка 2.9B — артефакт пары прогонов прототипа (раздел 7.6).
B.4 GPTQ против RTN в пресете REDUCTION
модель | KL текст | KL en | KL код | ppl текст | ppl код |
|---|---|---|---|---|---|
0.1B | −22.4 [−25.1; −19.7] | −28.7 [−32.6; −25.3] | −27.9 [−30.2; −25.8] | −0.03 [−0.16; +0.11] | −0.13 [−0.28; +0.04] |
0.4B | −22.7 [−25.6; −19.6] | −21.5 [−26.1; −17.6] | −27.2 [−30.4; −23.9] | −0.08 [−0.22; +0.06] | −0.04 [−0.15; +0.07] |
1.5B | −28.4 [−32.0; −24.5] | −24.5 [−31.5; −18.0] | −32.1 [−35.0; −28.7] | −0.08 [−0.18; +0.03] | −0.02 [−0.16; +0.10] |
2.9B | −29.6 [−33.0; −26.1] | −26.2 [−32.8; −19.8] | −33.6 [−36.5; −30.0] | −0.06 [−0.16; +0.03] | −0.00 [−0.13; +0.13] |
7.2B | −21.1 [−25.0; −16.9] | −12.6 [−19.6; −4.8] | −24.3 [−30.0; −16.5] | +0.01 [−0.06; +0.09] | −0.00 [−0.10; +0.09] |
13.3B | −17.1 [−20.3; −13.7] | −16.2 [−21.1; −10.4] | −31.6 [−36.2; −27.1] | +0.01 [−0.05; +0.06] | −0.01 [−0.09; +0.07] |
Приложение C. Приборы и вычислительная среда
прибор | что меряет | где работает |
|---|---|---|
| KL(bf16‖квант) на fake-пути (torch), leave-one-out по группам, трассировка остаточного потока | Mac (MPS), сервер (CUDA) |
| то же, но реальная упаковка sb6 и MLX-кернели | только Mac |
| ppl и KL из логитов модели, загруженной из | только Mac |
| скорость декода двух файлов, чередование ABBA в одном процессе | только Mac |
| профиль входа o_proj по слоям (E[x²], концентрация) | Mac, сервер |
| локальная ошибка впрыска на настоящих активациях | сервер |
Общие правила. Корпус eval_corpus_multiling (раздел 3.4) — для разделов 4–5; чистые наборы — для остальных. Эталон — логиты bf16-модели, посчитанные в fp32 и сложенные на диск (5.09 ГБ на модель). Эталон принимается числом, а не размером файла.
Вычислительная среда.
Mac M4 (16 ГБ, без вентилятора): реальный MLX-путь, скорость, ppl с файла. Потолок — 2.9B; 7.2B в fp32 (28.8 ГБ) недостижим.
Сервер 4×RTX 4090, 251 ГБ RAM, 16 ядер, 1.5 ТБ: fake-путь, эталоны, профили. fp32-эталон 2.9B собирается на карте за 4 минуты, 7.2B — на CPU за 25 минут (в 24 ГБ карты fp32 не влезает).
Metal-ядра (исходники Metal через
mx.fast.metal_kernel, 7 файлов вbackends/metal) на CUDA не компилируются, поэтому реальный путь на сервере не воспроизводится.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.