Как правильно загружать и скачивать файлы по HTTP в 2026 году
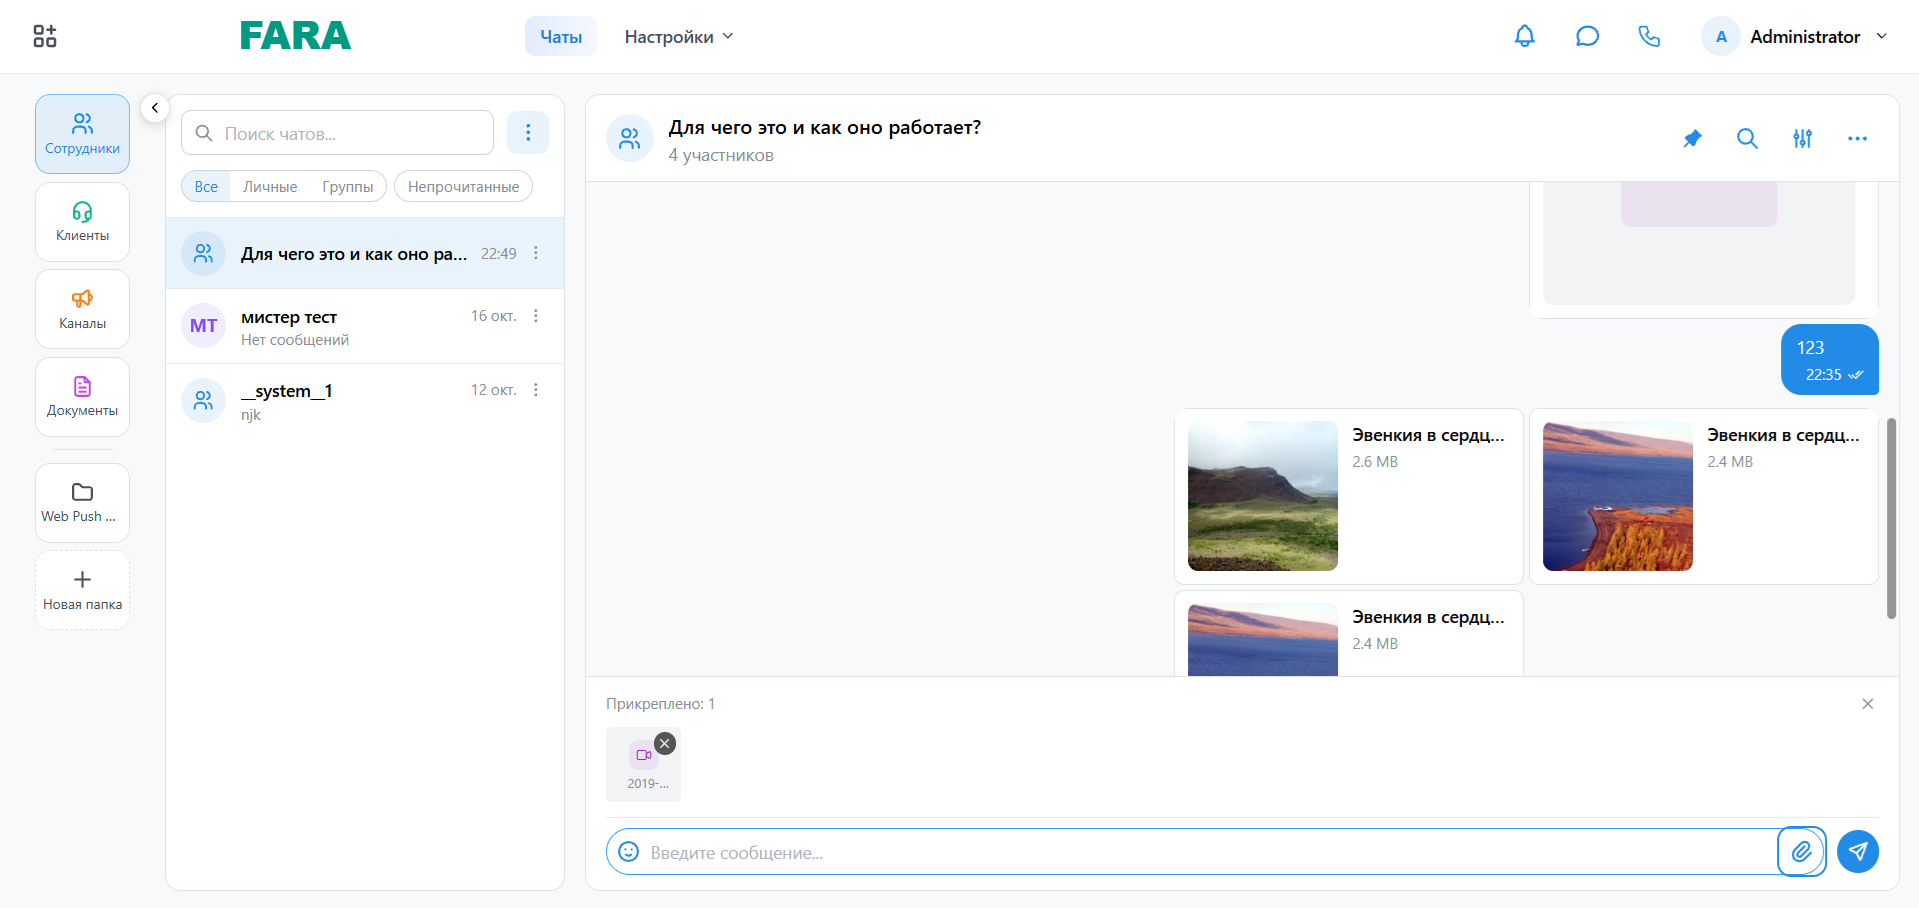
Короткая заметка из блога FARA CRM. Мы недавно переделали работу с файлами и собрали в одном месте, на чём тут обычно спотыкаются.
Кажется, всё просто: делаешь ручку POST и отправляешь файл. Вопрос только — как. Способов три, и у двух самых популярных есть неприятные минусы.
Загрузка (добавление файла)
1. Base64 в JSON
POST /attachments
Content-Type: application/json

{"name": "contract.pdf", "content": "JVBERi0xLjQKJcOkw7zDtsOf..."}
Удобно: файл — просто ещё одно поле. Хорошо стыкуется с орм. Любой JSON-эндпоинт примет его вместе с остальными данными.
Минусы:
файл становится на треть больше: base64 кодирует 3 байта четырьмя символами;
сервер держит его в памяти несколько раз: строка, разобранный JSON, декодированные байты;
весь файл — одним запросом, а прокси режут большие тела. У nginx по умолчанию
client_max_body_size 1m, на проде обычно десятки мегабайт. Видео с телефона на 300 МБ так не отправить;нет ни прогресса, ни докачки: связь моргнула на 90 % — начинай сначала.
Мы так и жили, пока менеджер не попытался прикрепить видео и не получил 413 Request Entity Too Large.
2. multipart/form-data
Классика HTML-форм:
POST /attachments
Content-Type: multipart/form-data; boundary=----x

------x
Content-Disposition: form-data; name="file"; filename="contract.pdf"
Content-Type: application/pdf

<байты файла>
------x--
Лишней трети нет, сервер умеет принимать файл потоком.
Минусы:
это всё ещё один запрос: тот же лимит тела, те же таймауты, обрыв — всё заново;
плохо сочетается с JSON-API: запись с несколькими файлами во вложенных полях в multipart выражается неудобно.
endpoint в отдельном стиле, нет универсальности CRUD
3. Частями
Файл режется на куски (у нас по 8 МБ) и уходит несколькими маленькими запросами. Это не multipart и не JSON: тело запроса — просто сырые байты куска. Протокол — упрощённый tus:
POST   /attachments/uploads       {"name": "video.mov", "size": 314572800}
                                  → {"id": 42, "part_size": 8388608, "offset": 0}

PATCH  /attachments/uploads/42
Upload-Offset: 0
Content-Type: application/offset+octet-stream

<8 МБ байтов>                     → {"offset": 8388608}

GET    /attachments/uploads/42    → {"offset": 8388608, "size": 314572800}
DELETE /attachments/uploads/42    — отмена
Когда все куски дошли, вместо файла передаётся номер загрузки:
POST /attachments
{"name": "video.mov", "upload_id": 42}
Что это даёт:
каждый запрос маленький — лимит прокси больше не мешает, файл может быть хоть гигабайт;
прогресс считается по отправленным кускам;
обрыв сети не страшен: клиент спрашивает у сервера offset (
GET) и продолжает с него;сервер пишет кусок сразу на диск — в памяти не больше одного куска.
Детали, без которых это не работает надёжно:
Позицию ведёт сервер. Кусок принимается, только если
Upload-Offsetсовпадает с тем, сколько уже получено, иначе —409с текущим offset. Так повтор куска после обрыва не запишет данные дважды.Размер проверяется дважды: заявленный — при старте, реальный — на каждом куске.
Брошенные загрузки (вкладку закрыли на середине) удаляет фоновая задача, например через сутки без новых кусков.
Пока идёт загрузка, браузер переспрашивает при закрытии вкладки (
beforeunload).
Цена — временная сущность «загрузка» и четыре ручки. Если файлы должны идти сразу в облако, тот же принцип даёт S3 multipart upload с presigned URL: браузер грузит куски напрямую в хранилище.
Скачивание
Наивно: прочитать файл в память и вернуть ответом. Для документа на мегабайт сойдёт, дальше начинаются проблемы.
Отдавайте потоком
Файл читается и уходит кусками, сервер не держит его целиком. В FastAPI/Starlette это FileResponse, для облака — проксирование потока от провайдера.
Поддерживайте Range
Без него:
видео не перематывается. Плеер просит
Range: bytes=10485760-и ждёт206 Partial Content. Если сервер отвечает200и весь файл, прыгнуть на середину нельзя, а Safari может не начать воспроизведение вовсе;оборвавшееся скачивание большого файла начинается заново.
Правильный ответ:
HTTP/1.1 206 Partial Content
Accept-Ranges: bytes
Content-Range: bytes 10485760-20971519/314572800
Content-Length: 10485760
FileResponse в Starlette делает это сам. Если файл в облаке, передайте заголовок Range провайдеру (Google Drive и Яндекс.Диск его понимают) и верните его ответ как есть.
Имя файла на кириллице
Без filename* вместо «Договор.pdf» пользователь получит кракозябры или download:
Content-Disposition: attachment; filename*=utf-8''%D0%94%D0%BE%D0%B3%D0%BE%D0%B2%D0%BE%D1%80.pdfНе показывайте чужой HTML inline
Если у вас есть превью файлов и оно отдаёт загруженный пользователем .html или .svg с inline на вашем домене — это XSS: скрипт выполнится с куками приложения. Inline — только то, что браузер просто показывает (картинки, видео, PDF). Текст и разметку — как text/plain, остальное — attachment.
Кэш
Отдавайте ETag (например, по контрольной сумме файла) и отвечайте 304 Not Modified на If-None-Match. Превью в списках перестанут скачиваться при каждом открытии.
Ссылки для и
Тег <img src> не умеет передать заголовок Authorization. Для ссылок на файлы удобна авторизация по HttpOnly-куке: браузер подставит её сам и закэширует ответ.
Итог
Загрузка: маленькие файлы можно слать как угодно, но если файл может оказаться больше пары десятков мегабайт — грузите частями: позиция на сервере, 409 при расхождении, докачка, уборка брошенных.
Скачивание: поток вместо памяти, Range и 206 для видео и докачки, filename* для имени, inline только для безопасных типов, ETag для кэша.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.