366 попыток восстановить Linux-сервер: что показала статистика за месяц
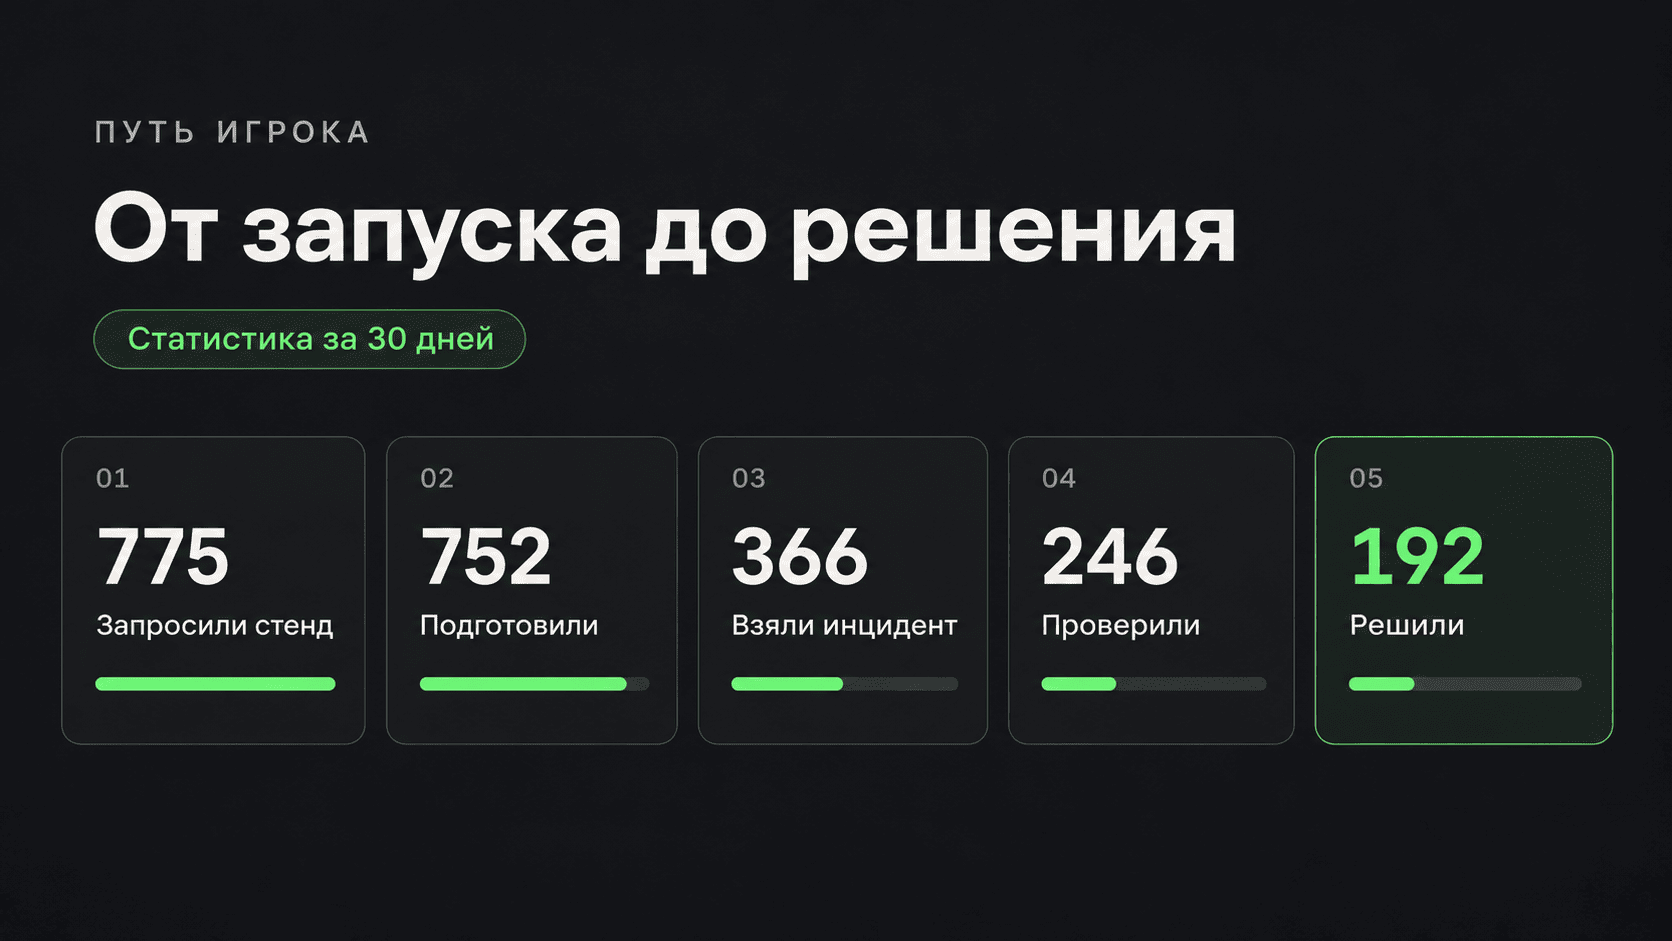
Последний месяц я собирал статистику прохождения инцидентов в учебном Linux-окружении. Идея простая: пользователь получает сервер со сломанным сервисом, открывает терминал в браузере и пытается самостоятельно найти и устранить неисправность.
Никакой заранее заданной последовательности команд нет. Можно смотреть журналы, изучать процессы, проверять сетевые соединения и конфигурацию. Главное - восстановить работоспособность сервиса.
За месяц набралось 366 взятых в работу инцидентов. Из них 192 завершились успешно.
Мне стало интересно, какие проблемы вызывают наибольшие трудности, насколько часто пользователи доходят до проверки результата и что вообще можно понять по такой статистике.
Немного цифр
За период с 10 октября по 8 ноября 2026 года получилось следующее:
Показатель | Значение |
|---|---|
Уникальные игроки | 400 |
Запросы на запуск стенда | 775 |
Подготовленные окружения | 752 |
Взятые инциденты | 366 |
Попытки с проверкой решения | 246 |
Успешные решения | 192 |
Попытки без решения | 174 |
Медианное время успешного решения | 7 мин 49 сек |
Получается, что успешно завершились 52,5% взятых инцидентов.
Важно учитывать, что речь именно о попытках, а не об уникальных пользователях. Один человек мог проходить несколько сценариев или повторно запускать один и тот же.
Самой интересной оказалась воронка прохождения.
Из 775 запросов удалось подготовить 752 окружения. Но до принятия инцидента дошли только 366 попыток, а до проверки решения — 246.
Получается, что значительная часть запусков заканчивается ещё до полноценной диагностики.
Возможно, пользователи просто изучают интерфейс или запускают окружение повторно. Возможно, не сразу понимают, как приступить к заданию. Пока агрегированная статистика не позволяет определить причину.
Зато из 246 попыток, дошедших до проверки, успешными оказались 192 — примерно 78%.
Похоже, те, кто добирается до этапа проверки, часто уже имеют рабочую гипотезу о причине неисправности. Но для уверенного вывода нужно учитывать и повторные проверки внутри одной попытки.
Какие инциденты оказались сложнее
В окружении есть сценарии с неисправностями приложений, PostgreSQL, Nginx, Kubernetes и системных ресурсов Linux.
Вот несколько результатов:
Инцидент | Взяли | Решили | Успешность |
|---|---|---|---|
Приложение не запускается | 136 | 58 | 42,6% |
База данных не отвечает | 53 | 26 | 49,1% |
OOM Killer убивает процессы | 30 | 12 | 40% |
Высокая нагрузка на CPU | 29 | 20 | 69% |
Kubernetes: CrashLoopBackOff | 10 | 9 | 90% |
Сайт отвечает 502 Bad Gateway | 14 | 12 | 85,7% |
Too many open files | 14 | 6 | 42,9% |
Здесь обнаружилось несколько любопытных моментов.
Kubernetes оказался проще обычного приложения?
У сценария с CrashLoopBackOff успешность составила 90%, а у обычного приложения, которое не запускается, — всего 42,6%.
Но делать вывод, что Kubernetes проще, было бы неправильно.
Во-первых, в первом случае всего десять попыток. Во-вторых, до Kubernetes могли дойти более подготовленные пользователи.
К тому же CrashLoopBackOff уже задаёт определённое направление диагностики. Можно начать с состояния пода, событий и журналов контейнера.
А вот сообщение «Приложение не запускается» само по себе почти ничего не объясняет. Причина может находиться в конфигурации, зависимостях, правах доступа или окружении запуска.
OOM Killer и файловые дескрипторы
Инцидент с OOM Killer успешно решили в 40% попыток, а Too many open files — в 42,9%.
Оба сценария требуют понимания механизмов Linux.
Например, при расследовании неожиданного завершения процесса полезно проверить сообщения ядра:
journalctl -k
А при ошибке Too many open files недостаточно просто посмотреть ulimit -n в своей оболочке. Лимиты уже работающего процесса могут отличаться:
cat /proc/<PID>/limits
Конечно, статистика не говорит, что пользователи ошибались именно в этих местах. Но такие сценарии интересно изучать отдельно: здесь важно не просто восстановить сервис, а разобраться, что происходит на уровне операционной системы.
Ошибка 502: высокая успешность, но долгое решение
Сценарий с 502 Bad Gateway успешно завершился в 12 из 14 попыток.
При этом медианное время успешного прохождения составило 13 минут 57 секунд.
Это один из интересных примеров того, что высокий процент решений не обязательно означает простую задачу.
Код 502 указывает на проблему взаимодействия прокси с upstream, но не сообщает её точную причину.
Приходится проверять приложение, доступность порта или Unix-сокета, журналы и конфигурацию проксирования.
Возможно, именно последовательная проверка гипотез занимает основное время.
174 попытки без решения - это плохо?
За месяц система зафиксировала 174 завершённых или сброшенных попытки без успешного восстановления сервиса.
Сначала кажется, что это слишком много. Но в реальной диагностике инженер тоже не всегда находит проблему с первой попытки.
Можно неправильно интерпретировать журнал, проверить неверную гипотезу или исправить симптом, не устранив причину.
Поэтому мне кажется, что процент успешных решений не должен быть единственной метрикой качества подобных тренажёров.
Гораздо интереснее понять, что происходит после неудачи.
Возвращается ли пользователь к инциденту? Пробует ли другое решение? Использует ли подсказки? Становится ли следующая попытка успешнее?
Пока статистика отвечает только на часть этих вопросов.
Что я понял за первый месяц
Главный вывод - технически восстановить сервис и действительно разобраться в причине неисправности не всегда одно и то же.
Система может проверить, что приложение работает, порт доступен, а необходимые процессы запущены.
Но она не всегда может определить, почему пользователь выбрал конкретное исправление.
Возможно, он последовательно проверил несколько гипотез и нашёл причину. А возможно, просто перезапустил нужный сервис и случайно получил рабочее состояние.
Поэтому дальше мне хочется больше внимания уделить повторным попыткам, использованию подсказок и тому, на каком этапе пользователи прекращают диагностику.
При этом важно не превратить обучение в проверку единственно правильного набора команд. В реальной эксплуатации одну проблему нередко можно решить несколькими корректными способами.
За месяц получилось 366 взятых инцидентов и 192 успешных решения. Выборка пока небольшая, но уже позволяет увидеть различия между сценариями и обнаружить ограничения собственной аналитики.
Хотелось бы прочитать ваши комментарии с пожеланиями или критикой.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.