Wolfee‑Watcher новый бесплатный инструмент runtime k8s
Зачем защищать контейнеры после деплоя? Рассказываю о Wolfee‑Watcher
Так всё же, зачем? Существует ряд опасных классов уязвимостей, которые направлены как раз на взаимодействие приложения с контейнерной инфраструктурой. Вот тут и начинается само наблюдение, а куда дальше может продвинуться злоумышленник? А также, если он всё‑таки получил какой‑то токен — не только продуктового приложения, а любого инфраструктурного, у которого уже более широкий круг прав, — векторы атаки мы в данной статье разбирать не будем: думаю, это тема отдельной статьи, особенно о том, чем опасен базовый Kubernetes без настройки.
После RCE злоумышленник может запустить любой код в работающем контейнере, просочить внутрь реверс‑шелл и дальше пробовать продвигаться вглубь. SSRF сама по себе не означает доступ к командной строке, но позволяет заставить приложение обратиться к внутренним адресам или облачным метаданным. Защита и наблюдение за контейнерами стали первым рубежом после прорыва веб‑приложений. Прорыв в кластер через горизонтальное движение из инфраструктуры — тоже критичный сценарий, и обходить его стороной я не хочу, но думаю, что в следующей статье я как раз расскажу о векторах атаки на кластер и о том, как его хотя бы базово защитить. Поэтому хочется увидеть, что происходит дальше — пока ещё можно разобраться в последовательности действий атакующего и успеть принять меры по его выдавливанию из нашей инфраструктуры.
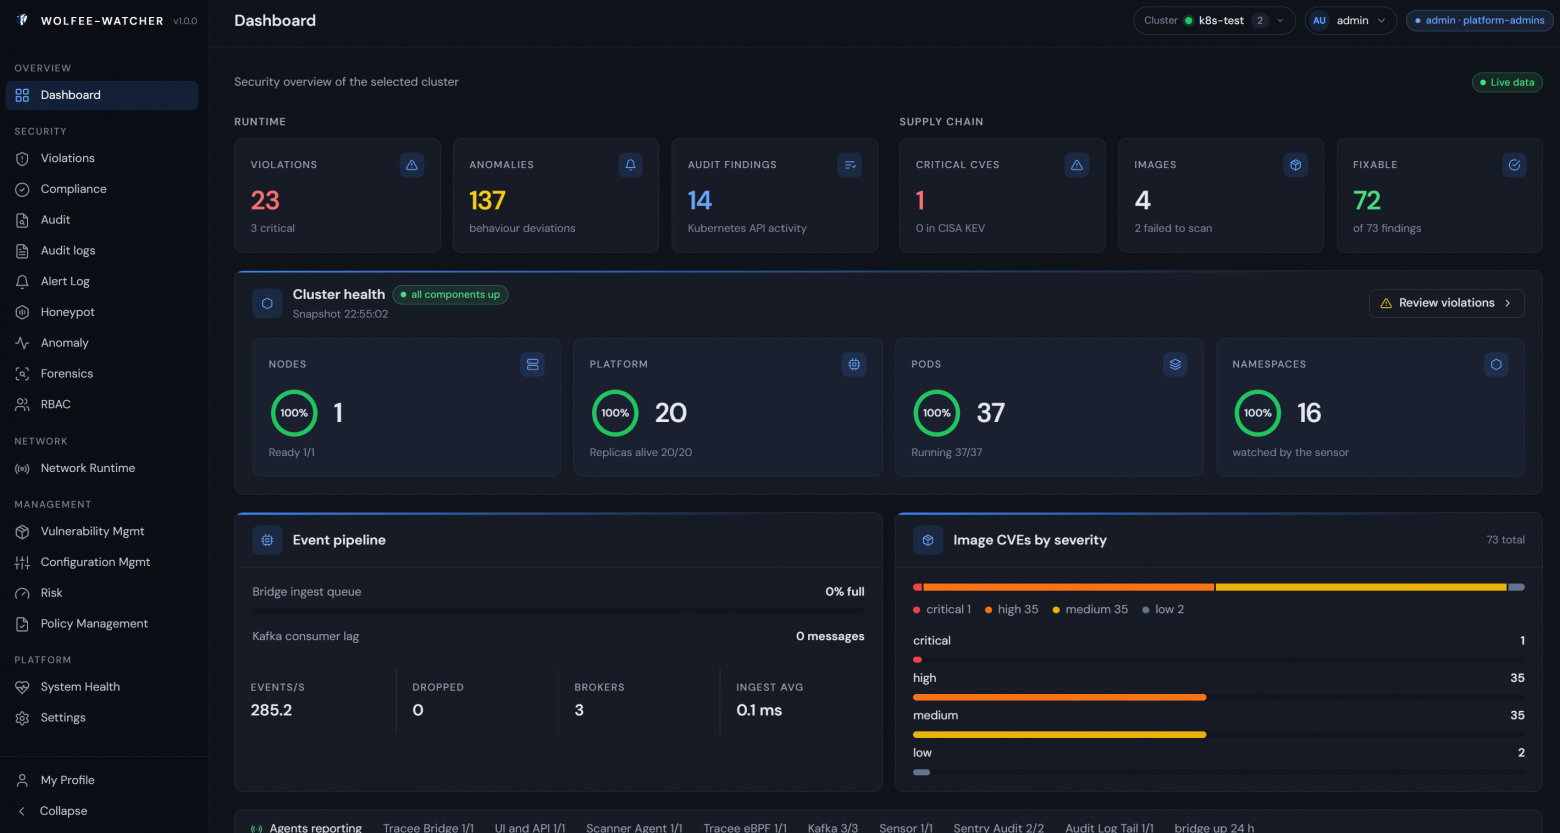
Именно для наблюдения наших кластеров я решил создать Wolfee‑Watcher. До него я попробовал несколько бесплатных инструментов для Kubernetes, в том числе StackRox. Он помогал мониторить процессы и настройки подов, но после тестов мне всё равно не хватало истории и охвата. Также мне очень понравились такие решения, как Falco, Tetragon и Tracee, — именно они подтолкнули меня сделать свой комбайн для мониторинга, чтобы не держать зоопарк из кучи инструментов и видеть единый дашборд с ресурсами, образами и уязвимостями в одной панели — для личного удобства и решил поделиться им с вами.
Почему мониторинг бинарей может быть недостаточен и опасные сисколы
Не обязательно какая‑то подозрительная активность будет именно бинарник, поэтому жестко отслеживать вызовы условно того же nmap и быть спокойным не стоит. Вот тут как раз и может помочь отслеживать такого потенциального опасного сискола как io_uring. По сути это асинхронный интерфейс к ядру, который может выполнять операции минуя обычные сисколы. Для приложения, вызов io_uring серьезный повод проверить, возможно кто‑то уже внутри.
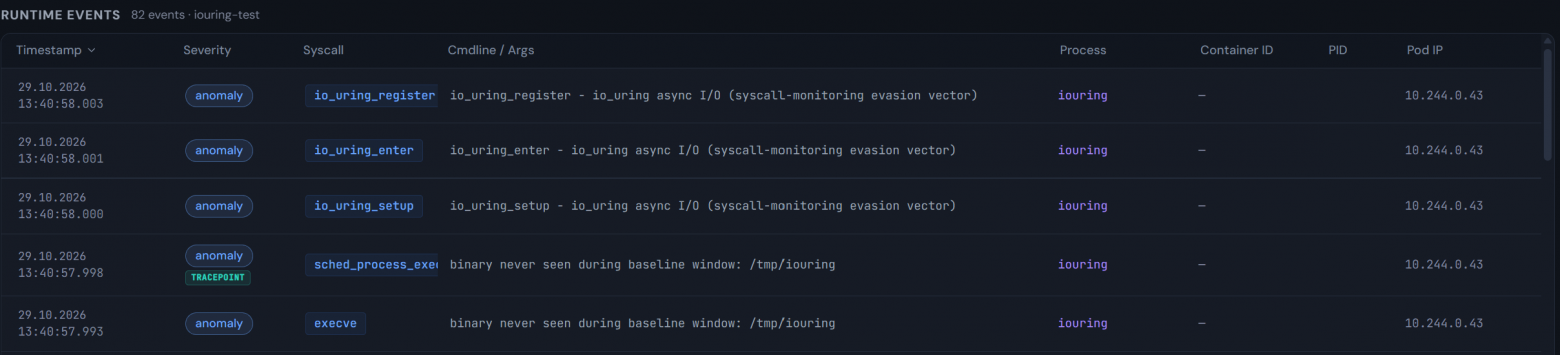
Для статьи я запустил Falco event‑generator + свои тестовые вызовы. Он воспроизводит подозрительные действия внутри контейнера и через Kubernetes API. Потом проверил io_uring отдельным подом и посмотрел, какую историю удастся собрать в Wolfee‑Watcher.
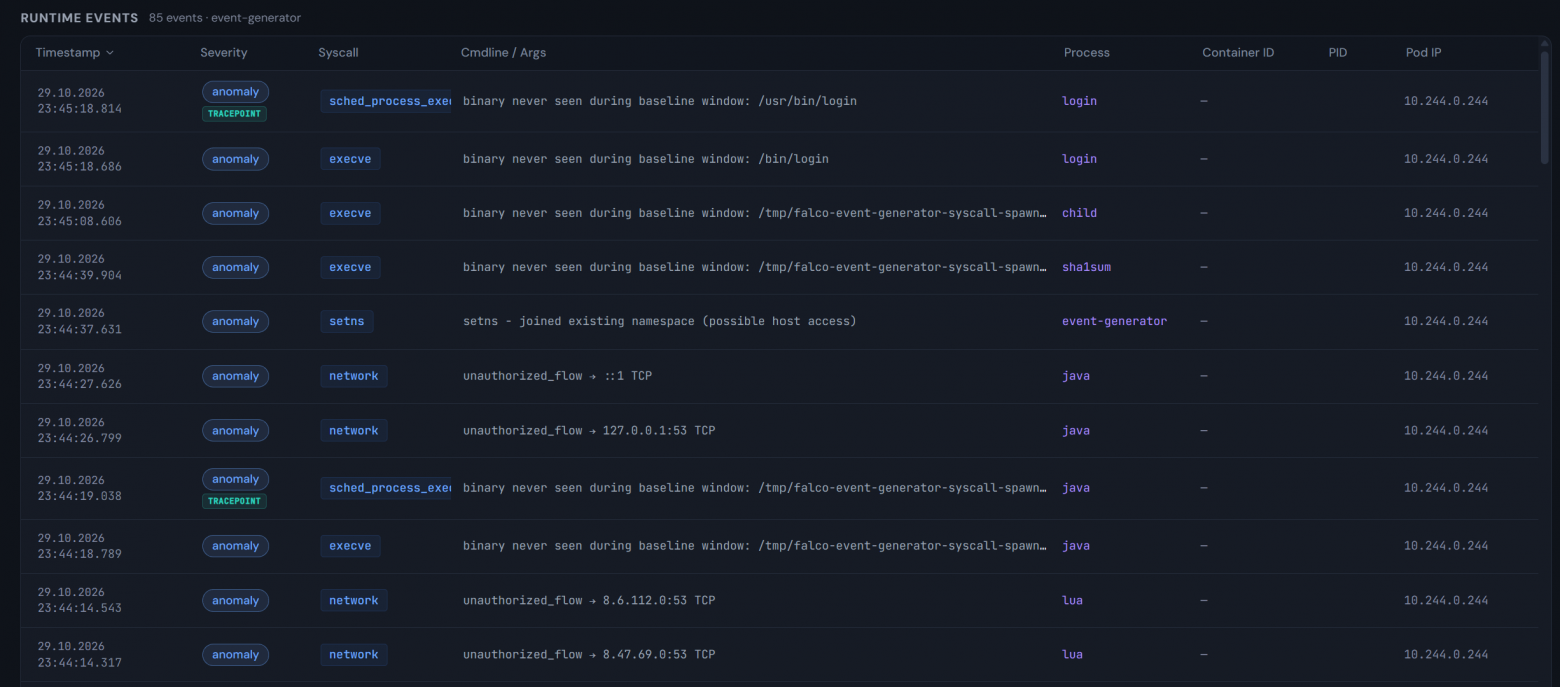
Wolfee‑Watcher обучается на основе запущенных бинарей внутри приложения, поэтому новое поведение будет попадать в аномалии, в форензику пода как аномалия, а так же помечатся меткой, которая мониторит изменение верхнего слоя и выводит это внутри пода.
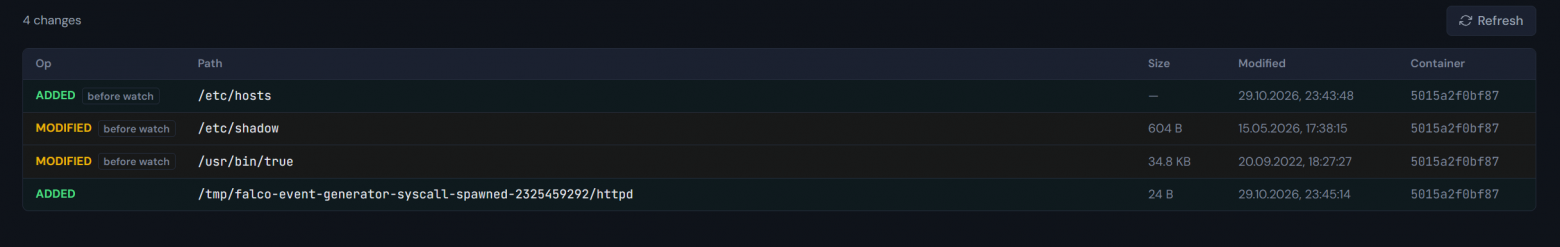
Как мы видим добавление и изменение двух системных файлов /etc/shadow и /etc/hosts. В Violations я вижу, какой процесс его открыл и в каком поде это произошло. Там же лежат срабатывания по действиям в Kubernetes API. Шумное правило можно приглушить, а ошибочное срабатывание пометить ложным.
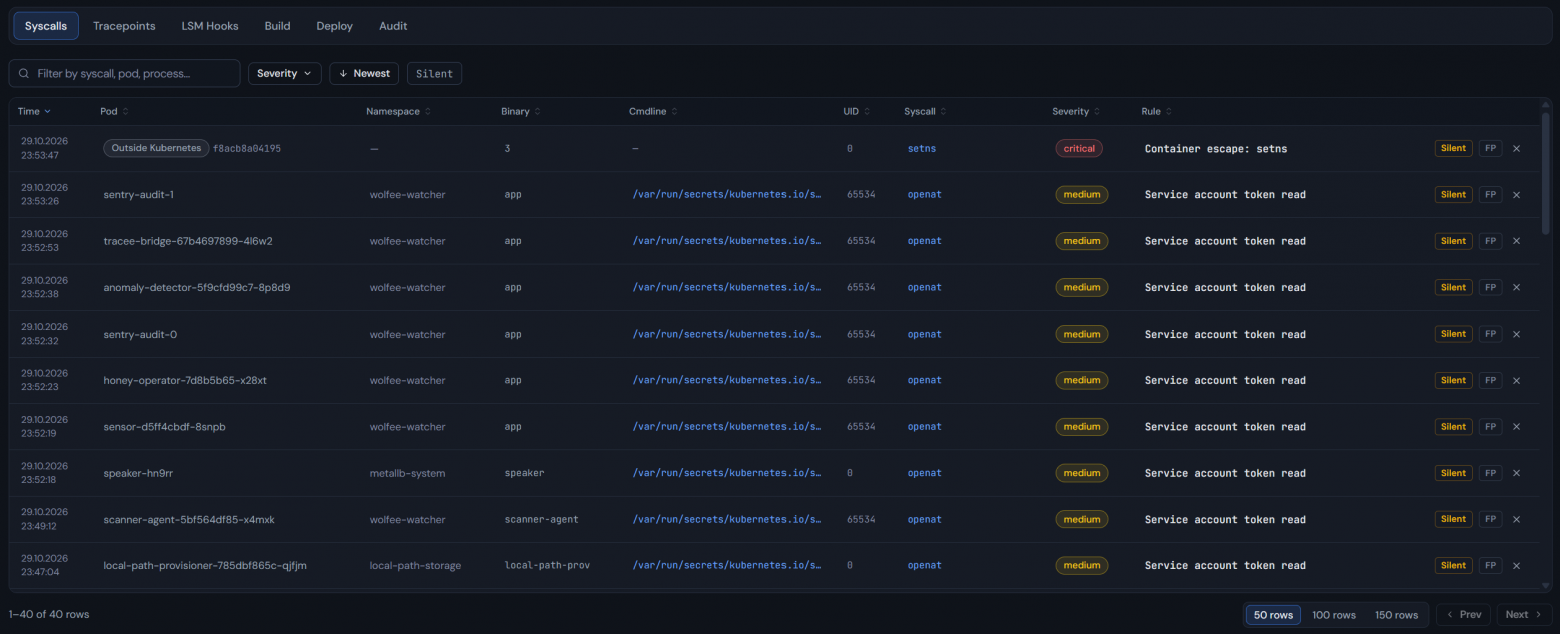
Violations собирает именно нарушения политик, а не весь поток событий. Вкладка Syscalls показывает правила на системные вызовы; Tracepoints и LSM Hooks относятся к событиям ядра. Build и Deploy проверяют образы и настройки запуска, а Audit показывает нарушения правил для Kubernetes API. Когда мне нужно понять, что произошло, я начинаю с конкретного срабатывания, а не листаю все события подряд.
Что изменилось в Kubernetes?
Генератор не ограничился действиями внутри контейнера: он создал несколько ролей и других объектов кластера. На странице аудита я открыл роль wildcard-resources-role. Её создал ServiceAccount генератора. В карточке осталось время запроса, сам объект и запись о действии в Kubernetes API.
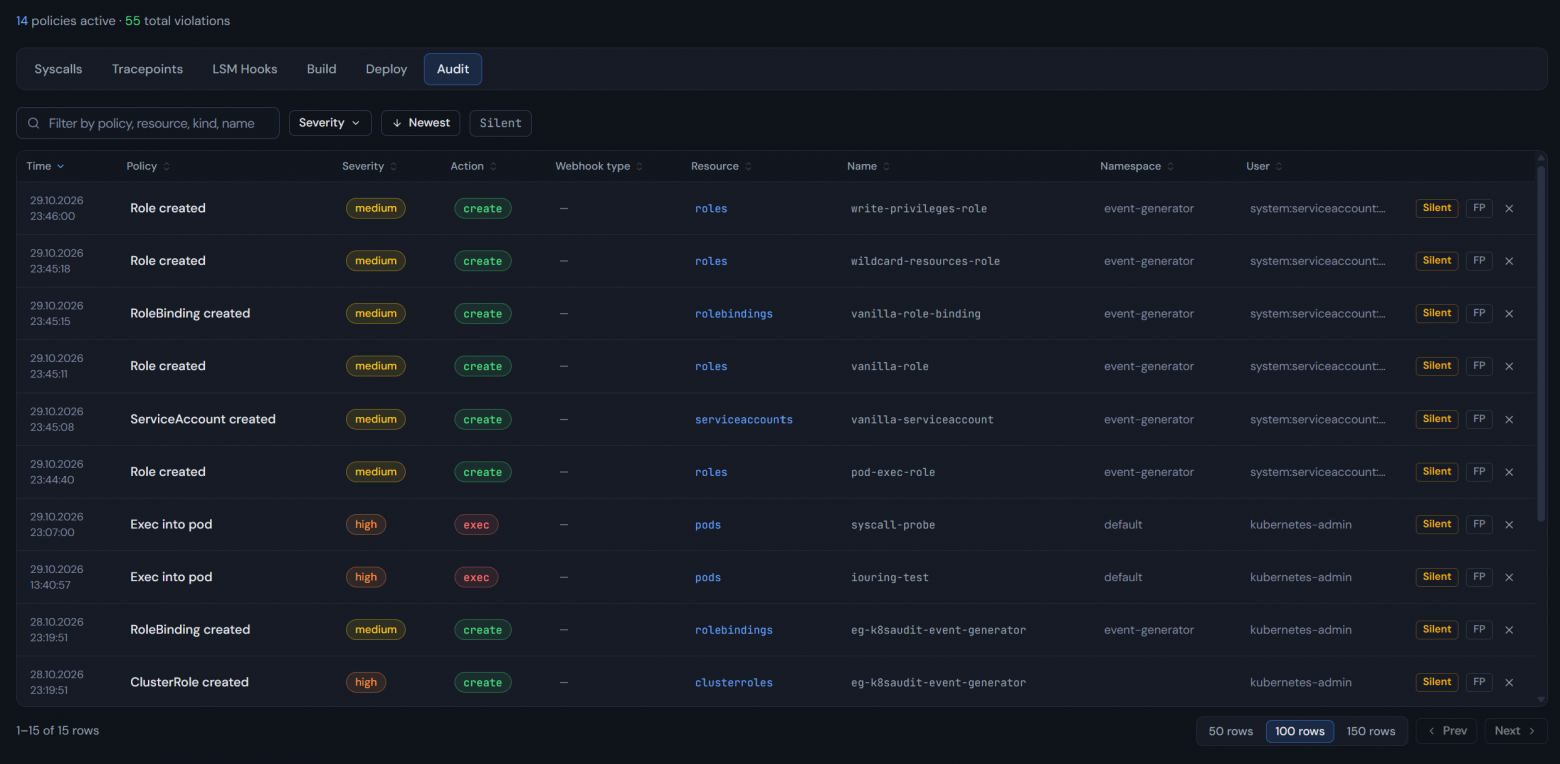
Audit logs так же есть в моем приложении, по сути это стрим из файла аудит лога с мастер ноды
(обратите внимание, что читает именно с файла, с облаком могут быть проблемы из‑за недоступности мастера). В мониторинге идет просто поток всех событий которые идут из файла, но так же можно отфильтровать на опасные, они заранее выставлены. Во вкладке Rules настраиваются правила и уведомления. Silent убирает шум из ленты; правила и алерты при этом продолжают работать.
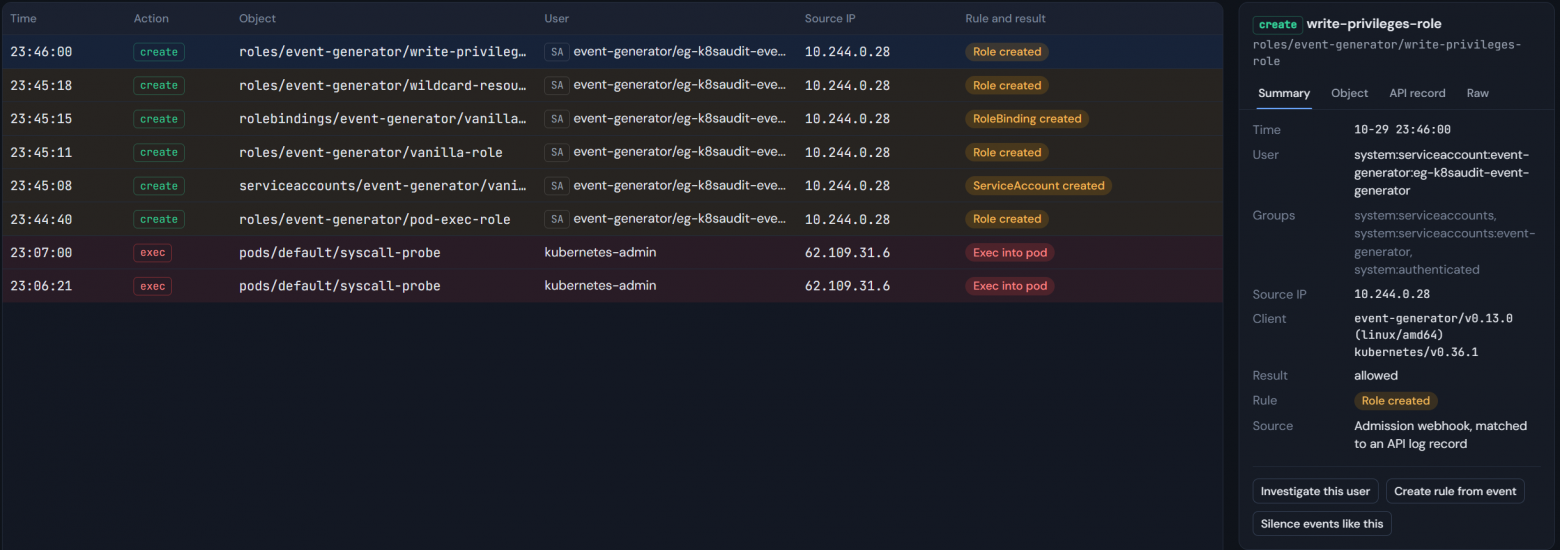
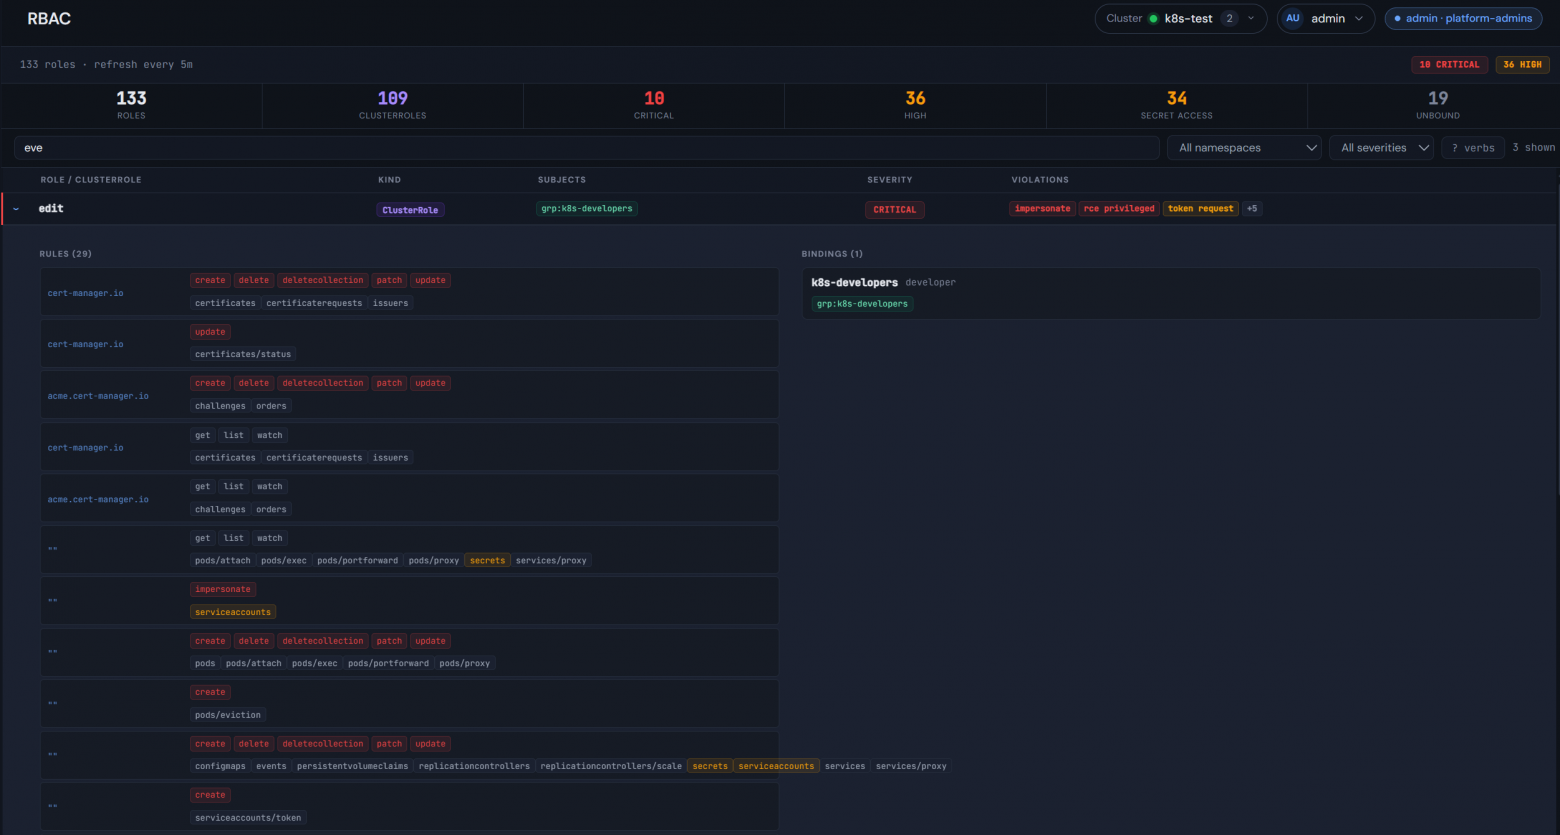
Тут мы видим создание ролей, exec внутрь контейнера. Можно перейти в RBAC и увидеть собственно созданную роль. Там видно, какие из них позволяют читать секреты или выполнять команды в подах, так же они имеют подсветку на особо критичные.
Если под удалили
Часть подов генератор удалил вскоре после создания. На скрине можно увидеть во вкладке forensics, их уже нет в обычном списке работающих подов, но в истории они сохранились с пометкой terminated. Внутри можно увидеть что было выполнено внутри контейнера (можно переключить конкретный контейнер)

Для выгрузки есть отдельная кнопка Upper Dir. Она забирает верхний слой контейнера в tar.gz: новые файлы, изменённые конфиги и скрипты, оставленные после запуска. Список удалённых файлов кладётся в архив как WOLFEE-DELETED-FILES.txt. Сам контейнер останавливать не нужно, но его слой должен ещё быть доступен на ноде. У выгрузки есть пределы: 10 000 записей и 512 МиБ на архив; файлы крупнее 128 МиБ пропускаются. Логи контейнера скачиваются отдельно кнопкой Logs.
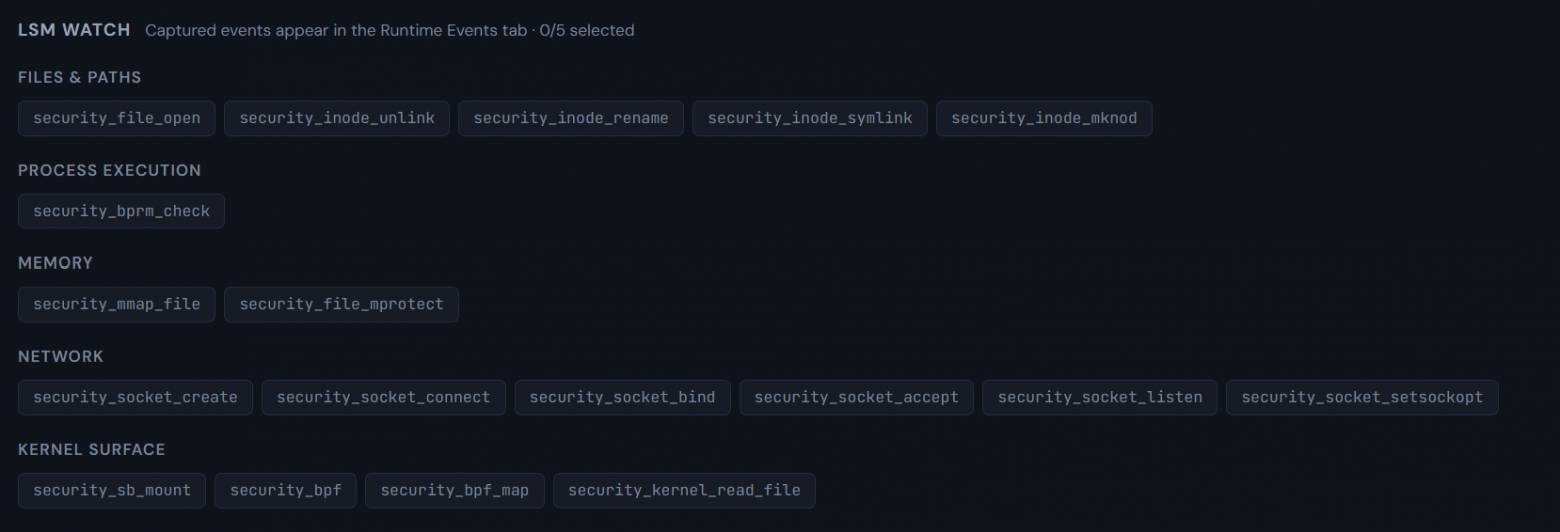
Если общей ленты мало, в карточке пода включаю подробную запись событий ядра. На скриншоте открыт список LSM‑хуков; среди них есть события доступа к файлам. Наблюдение настраивается для выбранного пода, не для всего кластера.
Сетевые политики наблюдение
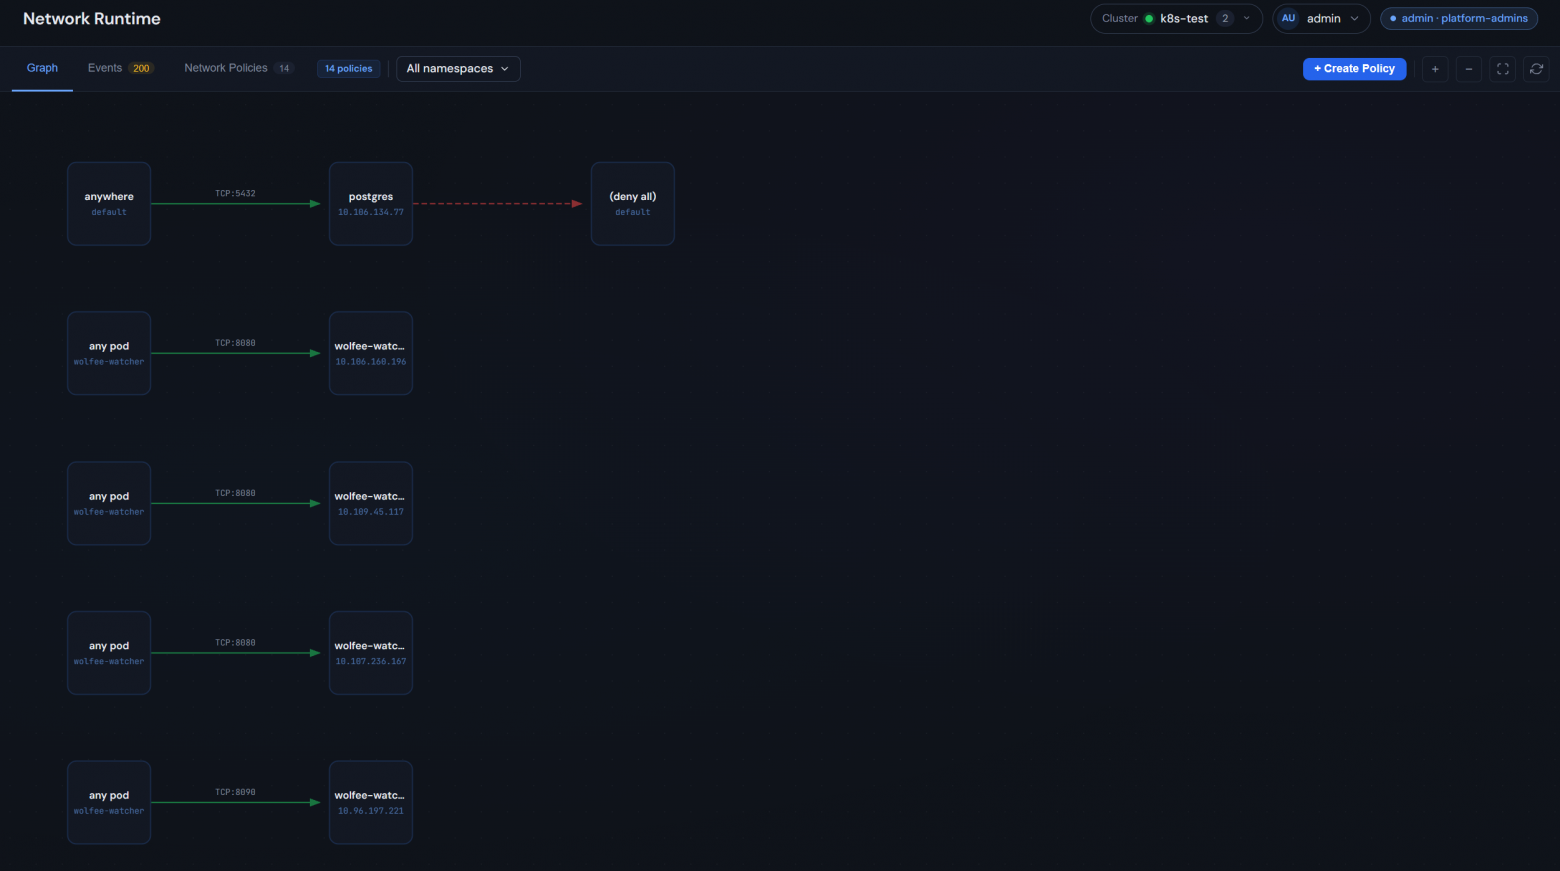
Нужно не забывать что сетевые политики внутри кластера один из основных механизмов защиты, и контроль их нужно осуществлять нужно очень внимательно. В данном примере мы видим все политики внутри моего тестового кластера. А по кнопке можно сгенерировать любую политику, но применять нужно будет руками, так как это все таки лучше доверить человеку после проверки.
Приманки
То, что решил добавить для усиления наблюдения, и то, что я хотел бы увидеть в StackRox это — хонипоты. За основу взял доступный опенсорс и добавил ловушки в свое приложение, схема банальна — контейнер выдает себя за один из предложенных сервисов и ожидает соединения к нему, после чего мы видим это в алертах, на выбор пользователю представлен широкий выбор ловушек, которые помогут в детекте любого злоумышленника который пытается сканировать изнутри.
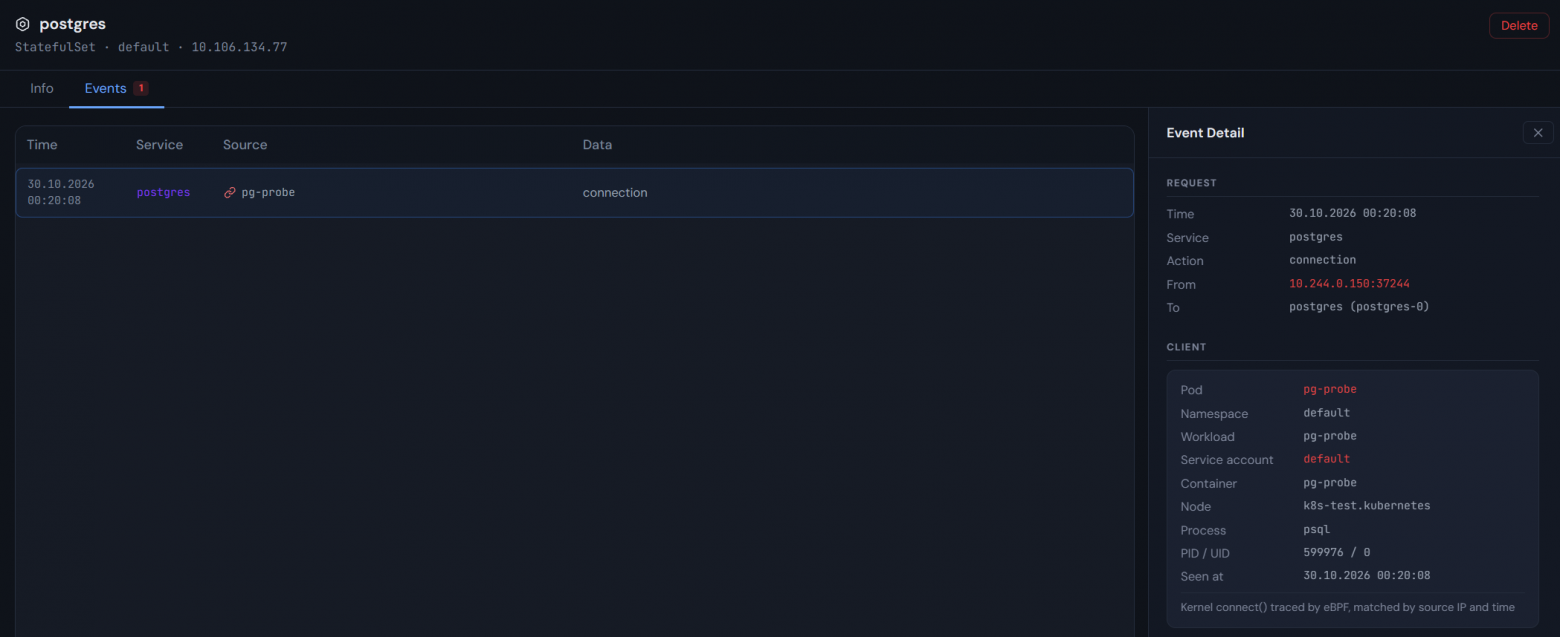
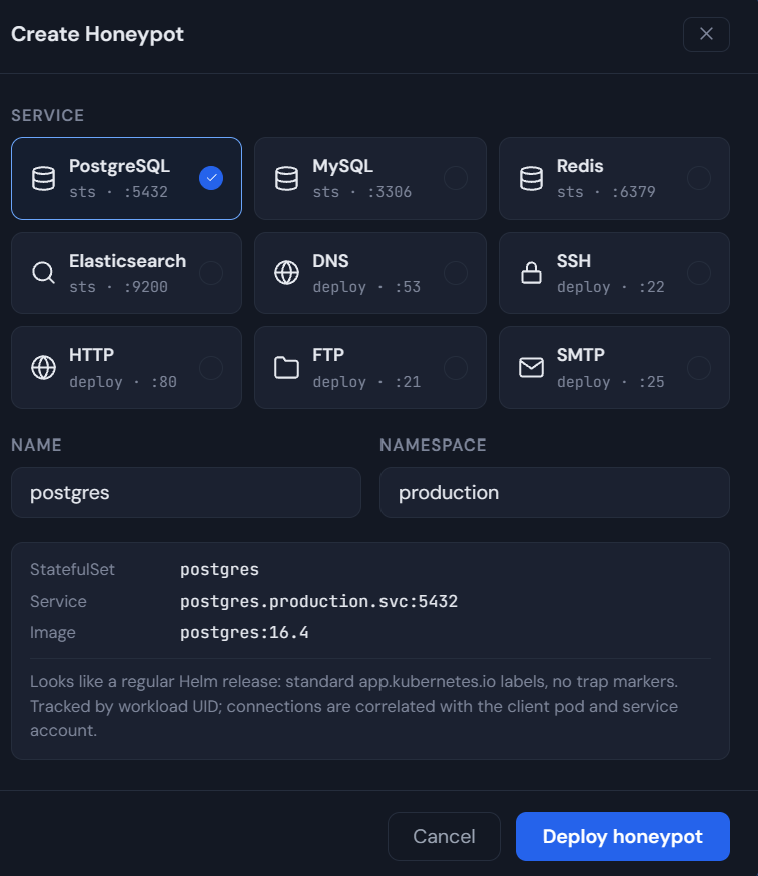
Аудит образов внутри кластера
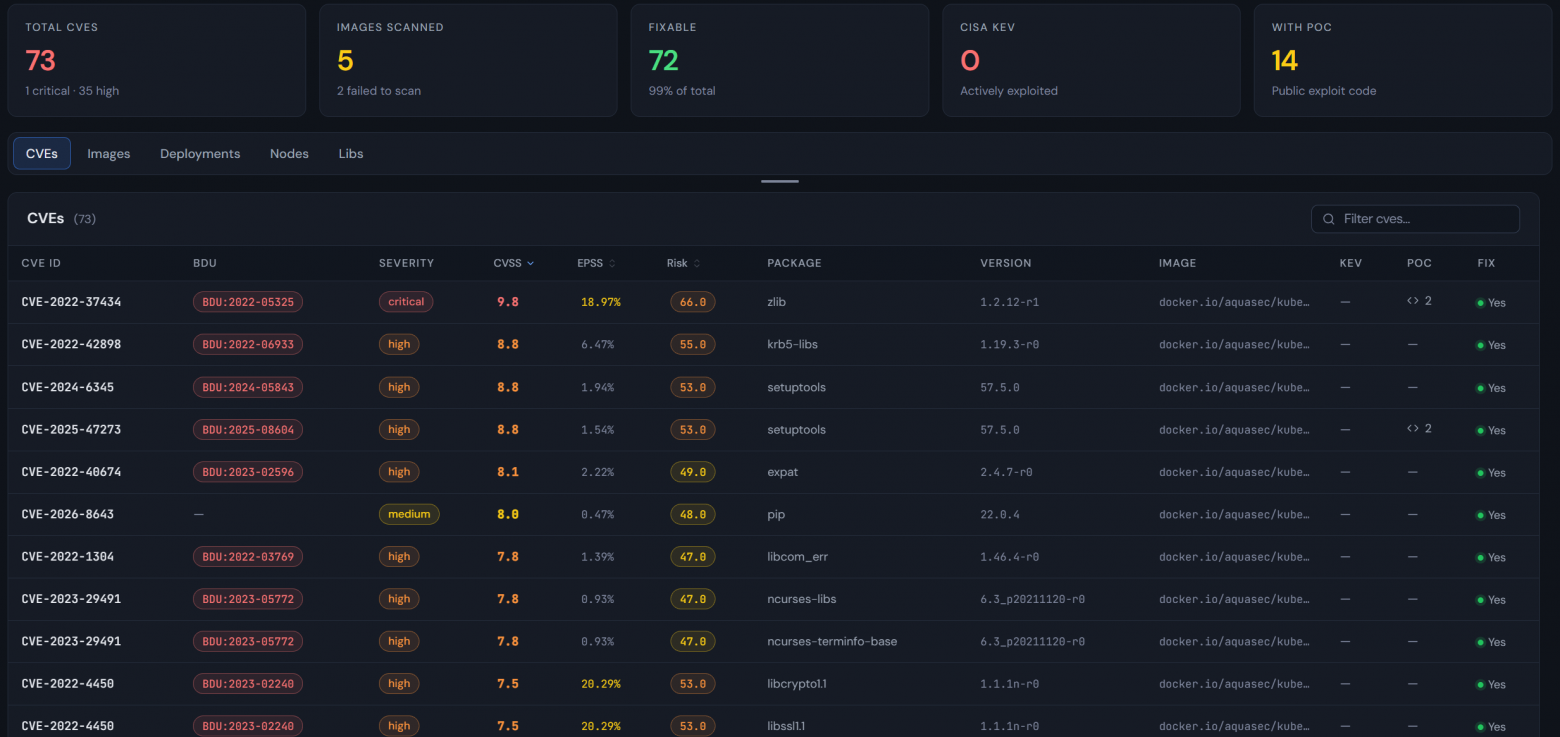
А что если внутри уже работает что то подозрительное, или опасный образ, это тоже необходимо отслеживать и своевременно обновлять. Под капотом сканирования работает Trivy: он находит уязвимости в образах, запущенных в кластере. wolfee‑watcher дополняет находки данными об эксплуатации и исправлениях, а затем сопоставляет CVE с выгрузкой БДУ ФСТЭК. Поэтому рядом с CVE можно увидеть идентификатор БДУ и уровень опасности по этой базе; если совпадения нет, поле остаётся пустым. Неудавшееся сканирование тоже видно, его не спутаешь с чистым отчётом.
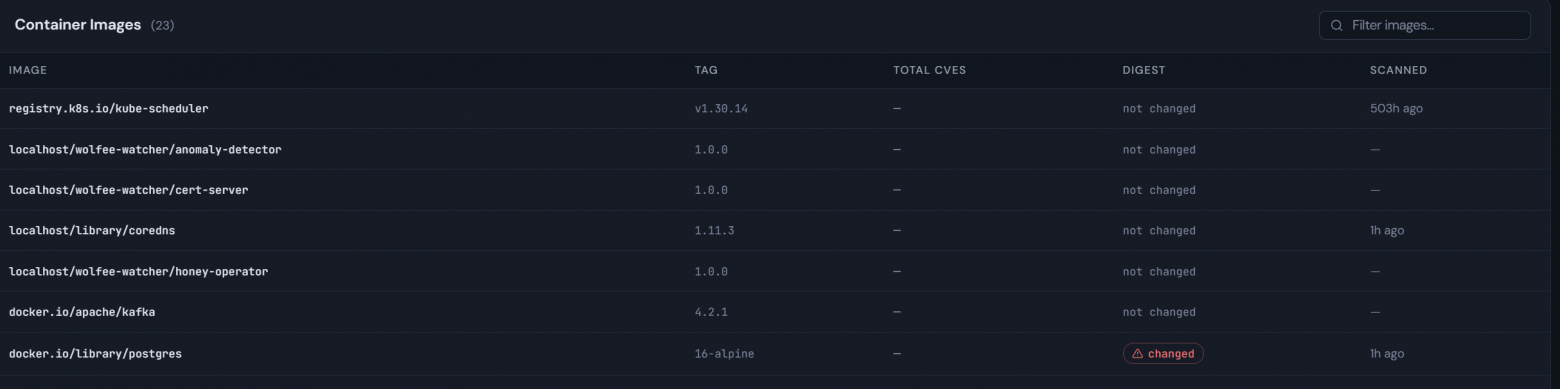
Так же можно увидеть такой столбец как digest, в случае если кто то пытается залить образ с таким же тегом — будет событие в аномалии, один из векторов за которым тоже стоит поглядывать
Compliance кластера на соответствие стандартам
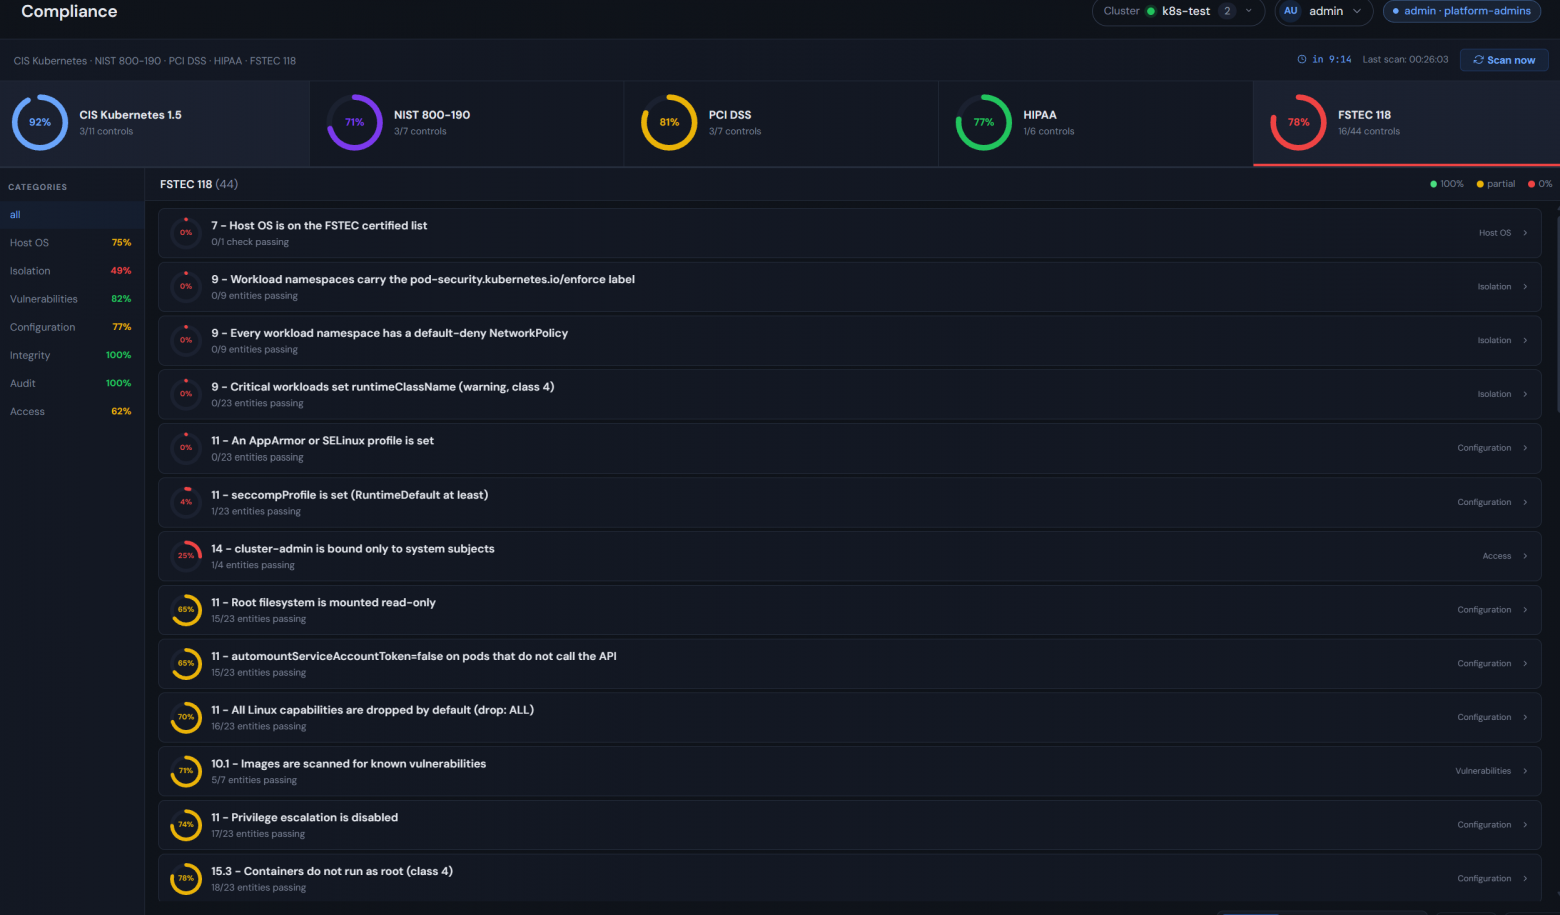
Для этого есть раздел Compliance. Он собирает технические проверки по CIS, NIST, PCI DSS, HIPAA и приказу ФСТЭК № 118. По ФСТЭК здесь 44 контроля: например, видны поды с избыточными привилегиями или пространства имён без сетевой политики. У каждого контроля показано, сколько объектов проходит проверку и где остаются проблемы. Это рабочий список для исправлений, а не заключение об аттестации кластера.
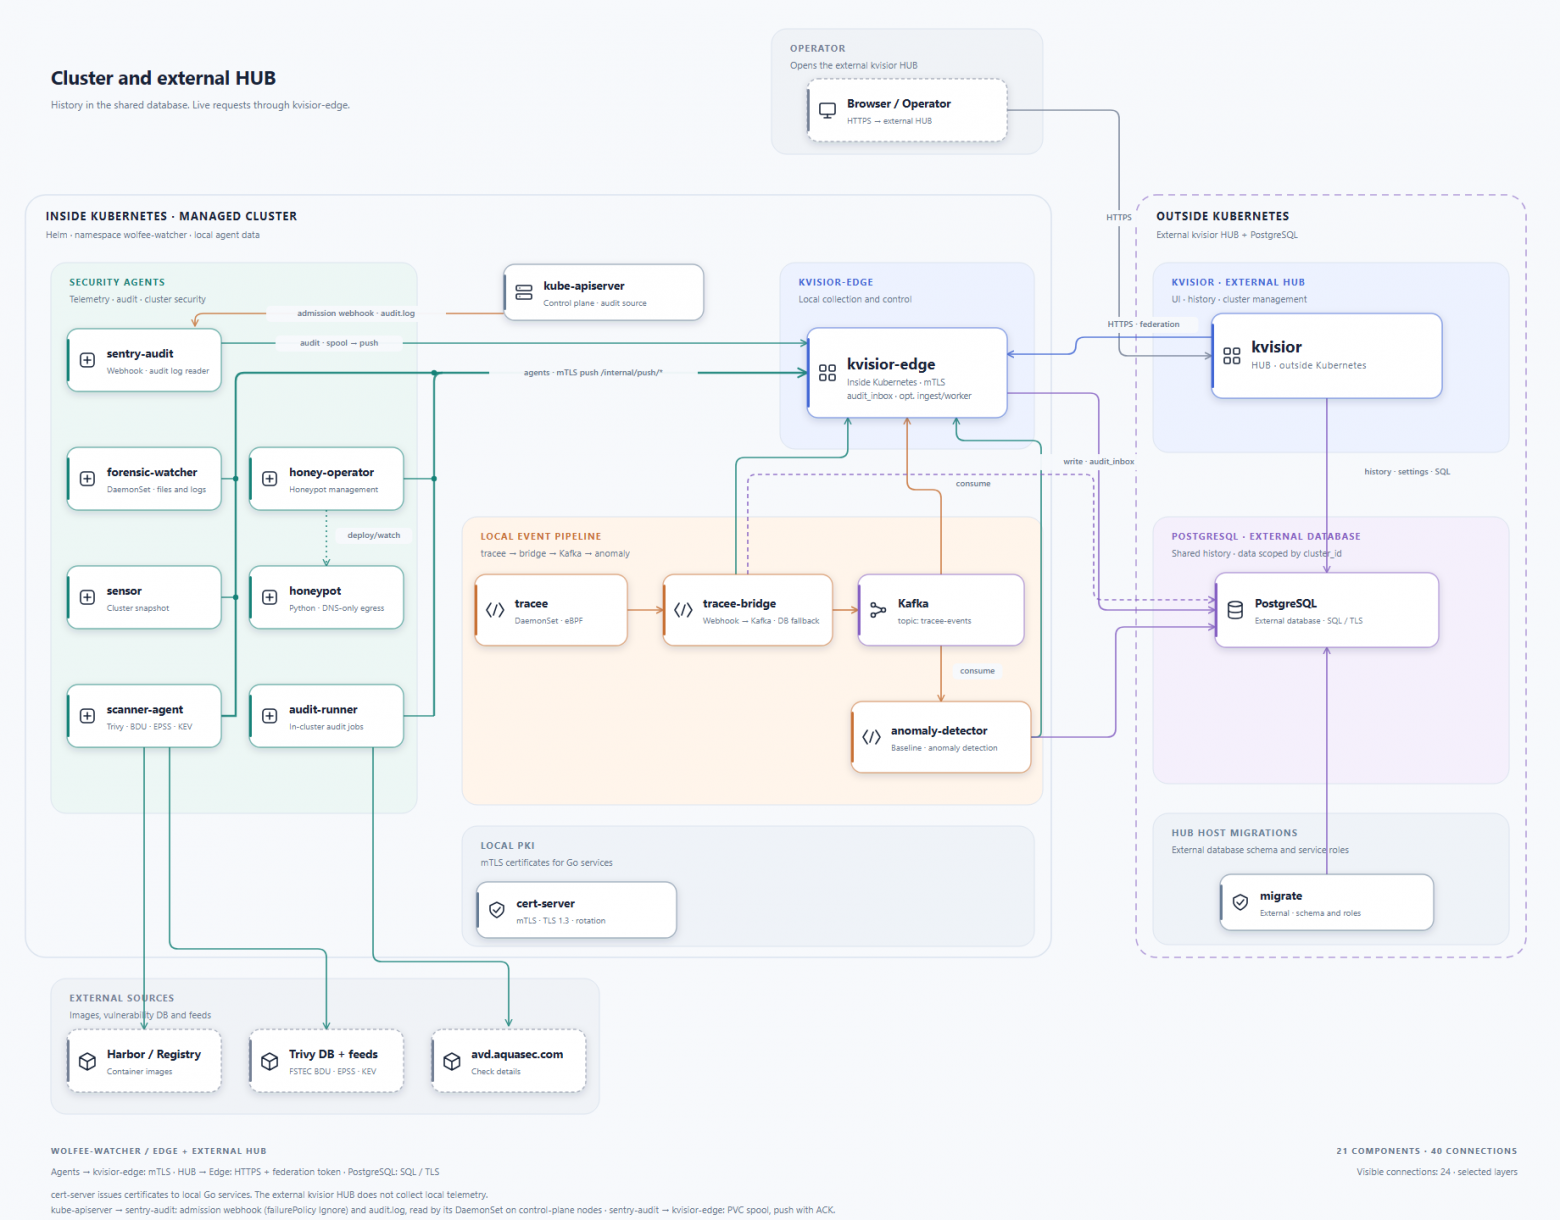
Под капотом всё собирают разные компоненты. Tracee получает события процессов и ядра; через tracee-bridge и Kafka они попадают в обработку. sentry-audit приносит действия из Kubernetes API, scanner-agent отвечает за образы, а forensic-watcher помогает с файлами подов. Для одного кластера консоль работает внутри него, для нескольких можно вынести общий хаб отдельно. Компоненты общаются по mTLS. На схеме видно, где живут агенты и куда идут данные.
Это приложение я делал около года, один, и могут наблюдаться какие‑то проблемы, особенно в юай, я не являюсь разработчиком, а только AppSec / DevSecOps инженером и пытаюсь помочь сообществу для развития опенсорса, спасибо большое, что дочитали до конца, и прошу, не судите строго, моя первая статья:3
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.