От игрушки с рандомными опкодами до 4-битной машины времени: как я собрал настоящий Intel 4004
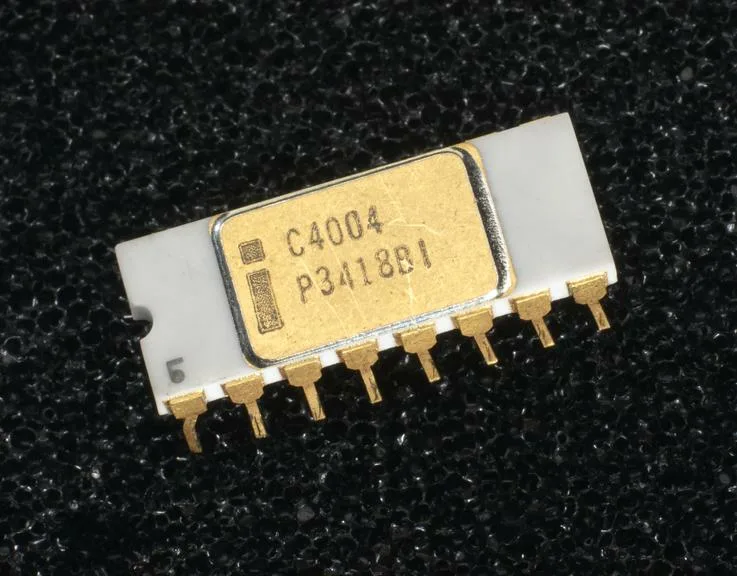
Если вы здесь впервые — рекомендую сначала заглянуть в мои первые две статьи (Часть 1 и Часть 2), где я рассказывал, как начинал свой путь с написания эмулятора Intel 4004. Если коротко: в прошлый раз я собрал нечто, что лишь отдалённо напоминало легендарный 4-битный процессор. Абсолютно рандомные опкоды, инструкции, которых в реальном 4004 отродясь не было и полное отсутствие понимания, что такое настоящая архитектура 1971 года.
Честно говоря, после второй части прошло больше двух лет и я периодически думал: а стоит ли вообще продолжать? В комментариях мне популярно объяснили, что моё творение — это, мягко говоря, «игрушка», а не эмулятор. И я даже с ними согласен. Поэтому в этот раз я вернулся, чтобы сделать что-то совершенно новое и исторически верное, если можно так выразиться.
С чего всё началось
Перечитывая документацию и изучая чужие проекты, я наткнулся на эмулятор пользователя markablov — i40xx. Это JavaScript-эмулятор Intel 4004/4040. Отсюда я выдрал необходимые опкоды, чтобы понять, как должна работать настоящая система команд. Без этого проекта мой эмулятор, скорее всего, так и остался бы набором непойми чего.
Более того, не хочу врать: дизайн интерфейса я по сути скамуниздил у Марка. Вот наглядный пример:
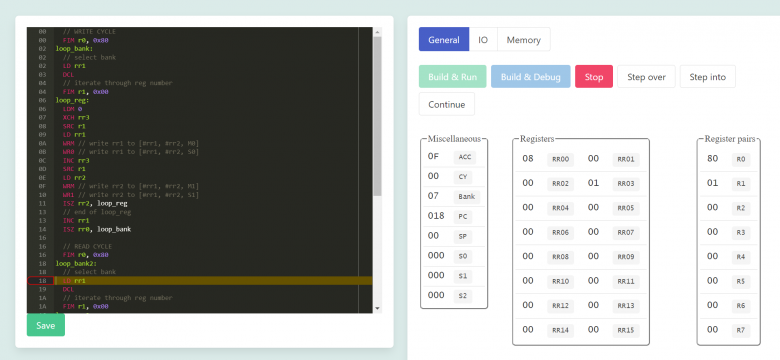
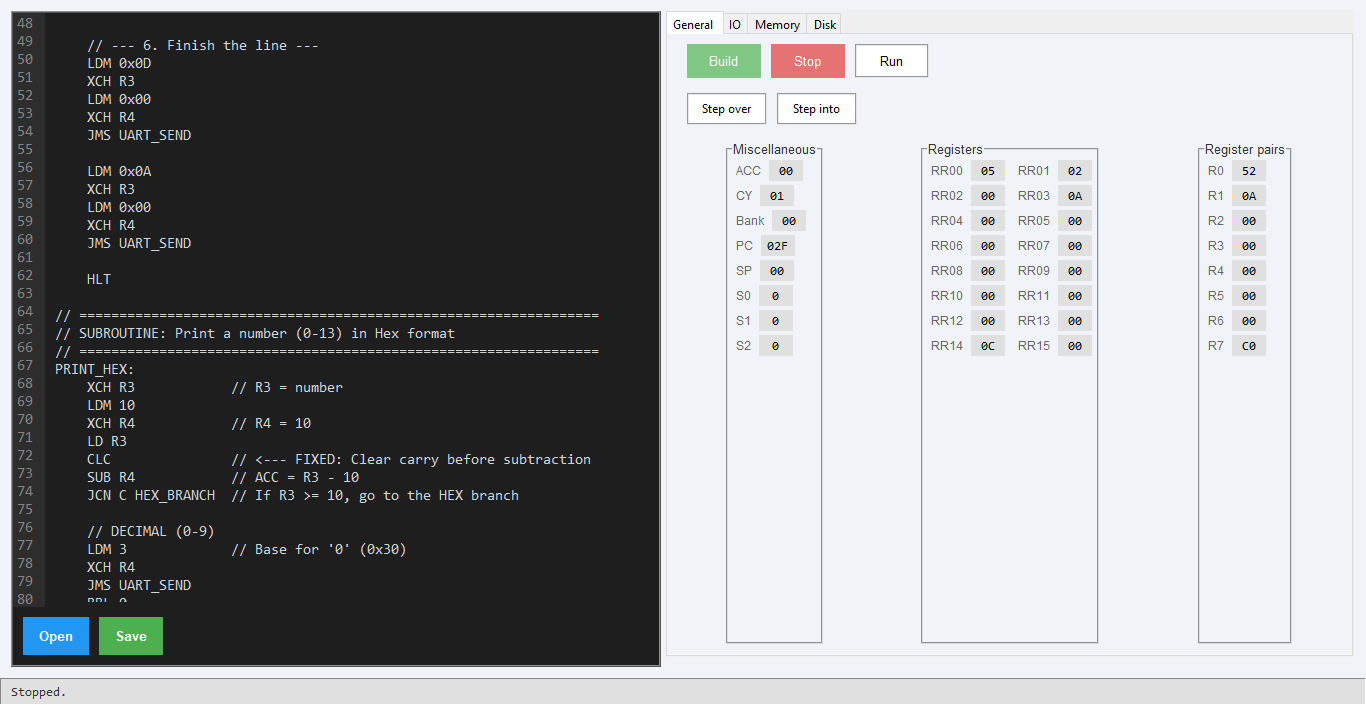
Жирная разница в том, что Марк писал своё творение на JavaScript, а я — на Python. У него — эмулятор, работающий в браузере, у меня — полноценное десктопное приложение. Но идея, структура и даже расположение панелей — это всё оттуда. И я не считаю это чем-то зазорным.
Что изменилось с прошлого раза
Если в прошлых версиях у меня было 7 инструкций из 46 возможных, то сейчас — все 46. Если раньше программа задавалась прямо в коде, то теперь есть двухпроходный ассемблер (с поддержкой исторического и современного синтаксиса), линкер для модульной сборки и даже компилятор BASIC — для тех, кто не хочет сразу погружаться в регистры и нибблы.
Но главное — появилась периферия. Настоящий 4004 в 1971 году не работал с дисководами на 8-дюймовых дискетах или видеочипами от Atari. Эти устройства появились позже. Но раз уж я строю «машину времени», почему бы не скрестить 4-битный процессор с 8-битным миром? Так на свет появился Франкенштейн: дисковод Shugart SA 800-1, телетайп Model 33 ASR, сдвиговый регистр 4003 и даже адаптация TIA от Atari 2600.
И самое главное - всё это чудо работает.
О чём эта статья
Сегодня я проведу вас по пути от пустого окна до запуска полноценной «операционной системы» — System Monitor, написанной на ассемблере 4004. А в конце я покажу Тетрис, который ломается ровно так, как ломался бы на реальном железе 1971 года. Потому что это не баг. Это историческая достоверность.
Поехали!
1. CPU и память, или Как оживить кремний
Прежде всего нужно ответить на один простой вопрос: а что вообще представляет из себя Intel 4004? Если вы читали мои первые статьи, то помните, что там я особо не заморачивался. Сейчас же пришло время посмотреть на реальный процессор 1971 года.
И первое, что бросается в глаза — это его скромность. 2300 транзисторов. Для сравнения, в современном процессоре их миллиарды, но именно эти 2300 транзисторов в своё время доказали, что вычислительную машину можно уместить на одном кристалле. И если вы думаете, что 4 бита — это мало, то вы правы. Это мизерно. Но в этой ограниченности и кроется своя элегантность.
4 бита, 12 бит и два банка регистров
В 4004 есть 16 регистров. Каждый хранит 4 бита — одну шестнадцатеричную цифру от 0 до F. Регистры организованы в два банка по 8 штук, причём регистры R8–R15 общие для обоих банков. Переключение между банками происходит через инструкции SB0 и SB1.
Зачем это нужно? В реальном 4004 банки позволяли быстро переключать контекст. Подпрограмма могла использовать банк 1, не трогая регистры основной программы в банке 0. Это был примитивный, но эффективный способ сэкономить память (как тебе такое, Сэм Альтман?)
Счётчик команд (PC) — 12-битный и это не случайность. 12 бит — это 4096 адресов, максимальный объём памяти программ, который мог адресовать 4004. Всё, что больше — уже за пределами его возможностей.
В коде это выглядит предельно просто:
self.acc = 0          # Аккумулятор, 4 бита
self.carry = 0        # Флаг переноса, 1 бит
self.pc = 0           # Счётчик команд, 12 бит

self.index_banks = [
    [0] * 16,         # Банк 0
    [0] * 16          # Банк 1
]
self.selected_register_bank = 0
Вот и всё состояние процессора. Никаких тебе миллионов транзисторов, никаких конвейеров и кэшей. Только голый кремний.
Гарвардская архитектура: почему код и данные живут отдельно
В 4004 используется гарвардская архитектура. Это значит, что память программ (ROM) и память данных (RAM) — это два физически разных пространства, которые не пересекаются. Код не может выполняться из RAM, а данные не хранятся в ROM.
Почему так? В 1971 году это банально было проще и дешевле. Можно было использовать разные типы памяти для кода и данных, оптимизируя каждую под свои задачи. Современные процессоры чаще используют фон Неймановскую архитектуру (общая память), но 4004 остался в истории как пример гарвардской.
В эмуляторе это разделение отражено в двух отдельных классах — ROM и RAM. И если вы попытаетесь выполнить инструкцию из RAM или записать данные в ROM, ничего не выйдет. Так и задумано.
Магия АЛУ: как вычитать, если нет вычитания
А теперь самое интересное. В 4004 нет аппаратной команды вычитания. Вообще. Нет инструкции SUB (в своём классическом смысле), которая берёт и вычитает одно число из другого. Вместо этого используется классический приём: вычитание через сложение с дополнительным кодом.
Вот как это реализовано в моём эмуляторе:
def _add(self, value, ignore_carry=False):
    result = self.acc + value + (0 if ignore_carry else self.carry)
    self.acc = result & 0xF
    self.carry = 1 if result > 0xF else 0

def _sub(self, value, ignore_carry=False):
    self.carry = 1 if ignore_carry else ((~self.carry) & 0x1)
    self._add((~value) & 0xF)
Смотрите, что происходит. Чтобы вычесть 5 из 8, процессор:
Инвертирует
5в 4-битной системе:~5 & 0xF = 0xA(это10в десятичной).Инвертирует флаг переноса (потому что в 4004 вычитание использует инвертированный перенос как «заём»).
Складывает
8 + 0xA + 1 = 0x13.Маскирует результат до 4 бит:
0x13 & 0xF = 3.Устанавливает флаг переноса в
1, потому что результат больше0xF.
Результат 3 — правильный (8 - 5 = 3). Флаг переноса установлен, что означает «заёма не было».
Этот кусок кода интересен тем, что он объясняет всю философию 4004 в нескольких строчках. Нет команды вычитания — не беда. Есть сложение, есть инверсия, есть флаг переноса. И этого достаточно, чтобы реализовать полноценную арифметику. Именно так думали инженеры в 1971 году: не «чего нам не хватает», а «как использовать то, что есть».
3-уровневый стек
Стек 4004 — это отдельная боль. Он встроен прямо в процессор и состоит всего из трёх 12-битных ячеек. Не в оперативной памяти, как у современных процессоров, а в кремнии.
def _push(self, address):
    self.stack[self.sp] = address
    self.sp = (self.sp + 1) % 3

def _pop(self):
    self.sp = (self.sp - 1 + 3) % 3
    return self.stack[self.sp]
Обратите внимание на % 3. Стек циклический. Если вы вызовете четыре подпрограммы подряд, четвёртый вызов перезапишет адрес возврата первого. Это не баг эмулятора, а историческое ограничение реального чипа. Глубокая вложенность JMS не работает и программы для 4004 проектировались с учётом этого ограничения.
Позже, в разделе про Тетрис, вы увидите, как это ограничение в буквальном смысле ломает игру. И это будет не ошибка, а точное воспроизведение поведения реального железа.
Страничная адресация: ловушка для невнимательных
Ещё одна особенность 4004 — страничная адресация. Инструкции JCN (условный переход) и ISZ (инкремент и пропуск) не могут указать полный 12-битный адрес. Их второй байт содержит только 8 бит., поэтому они работают в пределах текущей страницы — области 256 байт, определяемой старшими 4 битами PC.
Вот как эмулятор вычисляет полный адрес:
def _get_full_address(self, page_byte):
    ph = (self.pc & 0xF00) + (0x100 if (self.pc & 0xFF) == 0xFF else 0)
    return ph | (page_byte & 0xFF)
Этот кусок кода показывает неочевидную ловушку. Если вы пишете программу и используете JCN или ISZ для перехода на метку, убедитесь, что метка находится в той же странице, что и инструкция. Иначе переход будет неверным. Ассемблер и линкер не проверяют это автоматически — ответственность лежит на программисте.
Именно такие детали отличают «игрушку» от настоящего эмулятора. В игрушке вы просто прыгаете по адресу. В настоящем эмуляторе вы воспроизводите поведение кремния, включая все его ограничения.
Вот таким является фундамент. 4-битный, 12-битный, с тремя уровнями стека и вычитанием через сложение. На этом фундаменте строится остальное: ассемблер, линкер, периферия и даже подобие операционной системы.
Что ж, едем дальше.
2. Ассемблер и линкер: как заставить процессор понимать человека
Итак, процессор готов. Он умеет выполнять 46 инструкций, у него есть регистры, стек и даже вычитание через сложение. Но есть одна проблема: писать программы в машинных кодах — это, мягко говоря, неудобно. Представьте, что вам нужно вручную посчитать, что LDM 5 — это 0xD5, а XCH R0 — это 0xB0 и так для каждой строчки. Удовольствие ниже среднего.
Поэтому первым делом я прикрутил сюда ассемблер — инструмент, который превращает человекочитаемый текст в машинные байты.
Двухпроходный ассемблер: почему нужно два прохода
Ассемблер работает в два прохода. Это классическая схема и она не случайна.
Первый проход (pass1) нужен для того, чтобы вычислить адреса всех меток. Представьте, что вы прокладываете маршрут, но пока не знаете, где находятся промежуточные станции. Вы просто считаете, сколько байт занимает каждая инструкция, и запоминаете: «вот здесь будет метка loop».
Второй проход (pass2) генерирует машинные байты. Теперь, когда все адреса известны, ассемблер снова проходит по тексту и для каждой инструкции берёт базовый опкод, добавляет к нему номер регистра или значение операнда и записывает результат в выходной массив.
Зачем так всё усложнять? Всё из-за прыжков вперёд. Если программа прыгает на метку loop:, которая находится в конце файла, ассемблер должен заранее знать её адрес. Без первого прохода он просто не сможет сгенерировать правильную инструкцию JUN.
Сердце ассемблера: словарь опкодов
В основе ассемблера лежит словарь opcodes. Это, пожалуй, самая важная структура данных во всём проекте.
self.opcodes = {
    'NOP': (0x00, 'N'), 'HLT': (0x01, 'N'),
    'LDM': (0xD0, 'D'), 'XCH': (0xB0, 'R'),
    'JUN': (0x40, 'A12'), 'JMS': (0x50, 'A12'),
    'JCN': (0x10, 'COND'), 'ISZ': (0x70, 'ISZ'),
    # ... и так далее, всего 46 инструкций
}
Ключ — это мнемоника (например, LDM). Значение — кортеж из базового байта и формата операнда. Формат говорит ассемблеру, как интерпретировать операнд: N — нет операндов, R — регистр, D — 4-битное значение, A12 — 12-битный адрес, P — пара регистров, COND — условие для JCN, ISZ — специфичный формат для цикла.
В этом и кроется вся прелесть — вся система команд Intel 4004 умещается в один словарь. И если вы захотите добавить новую инструкцию, вам достаточно добавить одну строчку сюда и написать обработчик в cpu.py. Всё остальное — дело техники.
Историческая точность: три способа оставить комментарий
Одна из особенностей моего ассемблера — поддержка трёх стилей комментариев. В оригинальном Intel 4004 Toolkit комментарии начинались с /. В современных ассемблерах это ; или //. Метод cleanline() ловко вырезает все три варианта, позволяя программисту использовать любой удобный стиль.
def _clean_line(self, line):
    line = line.split('//')[0]
    line = line.split(';')[0]
    line = line.split('/')[0]
    return line.strip()
Проект балансирует между исторической точностью и современным удобством. Старые программы из мануалов 1970-х годов собираются «как есть», а новые можно писать с комфортом. Это не просто «поддержка двух синтаксисов» — это уважение к истории.
Два синтаксиса: исторический и современный
Кстати, о синтаксисах. Ассемблер поддерживает два стандарта:
Исторический: регистры как 0R–15R, пары как 0P–7P, комментарии через /, ORG через =. Так писали в 1971 году.
Современный: регистры R0–R15, пары P0–P7, комментарии //, ORG 0x000. Так удобнее нам.
Оба варианта работают. Более того, их можно смешивать в пределах одного файла (хотя для читаемости лучше придерживаться одного стиля). Это делает ассемблер идеальным инструментом для ретро-вычислений: старые программы собираются без изменений, а новые пишутся с комфортом.
Линкер: как склеить модули в единый ROM-образ
Ассемблер — это хорошо. Но что, если программа большая? Держать всё в одном файле неудобно: он становится огромным и в нём легко запутаться. Поэтому я написал линкер — инструмент, который собирает несколько модулей в единый ROM-образ.
Линкер работает по той же двухпроходной схеме. Первый проход размещает модули в памяти и собирает символы. Второй проход патчит релокации — то есть подставляет реальные адреса вместо заглушек.
Но самое интересное — это метод patchrelocation(). Вот где начинается настоящая магия.
Магия patch_relocation: как впихнуть 12 бит в два байта
У 4004 нет 16-битных регистров, чтобы хранить полный адрес в одной инструкции. Поэтому ассемблер, когда видит JUN LABEL, ставит заглушку (0x40, 0x00) и создаёт запись о релокации. Линкер позже «вклеивает» старшие 4 бита в первый байт, не затирая опкод.
def _patch_relocation(self, address, value, fmt):
    if fmt == 'A12':
        if value > 0xFFF:
            raise ValueError(f"Address 0x{value:X} exceeds 12-bit limit")

        # Старшие 4 бита — в младший ниббл предыдущего байта
        self.total_code[address - 1] = (
            (self.total_code[address - 1] & 0xF0) | ((value >> 8) & 0x0F)
        )
        # Младшие 8 бит — в текущий байт
        self.total_code[address] = value & 0xFF
Следите за руками. Линкер берёт 12-битный абсолютный адрес (например, 0xABC). Младшие 8 бит (0xBC) пишет во второй байт инструкции. А старшие 4 бита (0xA) аккуратно вписывает в младший полубайт первого байта, не затирая сам опкод: (0x40 & 0xF0) | (0xA & 0x0F) = 0x4A.
Для команд типа ISZ и JCN (условные переходы) используется только младший байт адреса, потому что они работают в пределах страницы. Линкер просто пишет 8 бит и всё.
Это всё выглядит как какой-то фокус, но на самом деле — точная инженерия. У 4004 нет 16-битных регистров, поэтому адрес приходится «размазывать» по двум байтам. И линкер делает это виртуозно: сохраняет опкод, вписывает старшие 4 бита, не забывает про младшие 8. Одна ошибка в маске — и процессор прыгнет не туда. Именно такие детали отличают работающий эмулятор от «почти работающего».
История из практики: Фибоначчи и «фантомная единица»
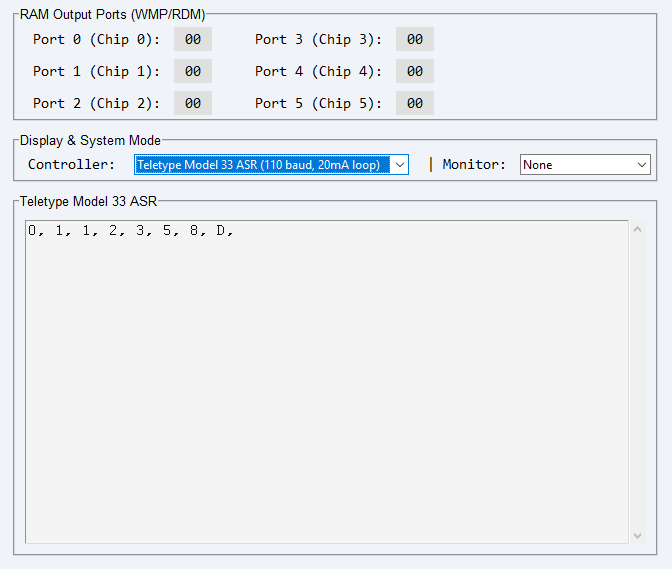
А теперь обещанная история про грабли. Когда я писал программу для вычисления чисел Фибоначчи на ассемблере, всё шло хорошо. Ряд получался красивым: 0, 1, 1, 2, 3, 5, 8, 13. А потом я решил вывести результат на телетайп — и получил не D (13 в hex), а C (12).
Я долго смотрел на код и не понимал, что происходит. Числа-то правильные! В регистрах лежит 13, а на экране — 12. Как так?
Ответ оказался в одной строчке. Вот как выглядел главный цикл:
LOOP:
    LD R1       ; ACC = текущее число
    ADD R0      ; ACC = R1 + R0 + CY
    XCH R1      ; R1 = новое число
    XCH R0      ; R0 = старое R1
Проблема в том, что команда ADD в 4004 всегда прибавляет флаг переноса. А перед этим, при выводе числа на экран, я использовал SUB, который этот флаг менял. И если флаг был установлен в 1, к числам прибавлялась «фантомная» единица. Математика ломалась.
Решение — одна строчка:
LOOP:
    LD R1
    CLC         ; Сбросить флаг переноса!
    ADD R0
    XCH R1
    XCH R0
CLC (Clear Carry) сбрасывает флаг в ноль и после этого ADD складывает всё, как надо.
Этот пример наглядно показывает, насколько 4004 «голое» железо. Здесь нет абстракций, которые скрывают побочные эффекты. Флаг переноса — это глобальное состояние, которое влияет на арифметику. Забыли сбросить — получили неверный результат. Таких ловушек в 4004 много. Именно поэтому программы для него писались с оглядкой на каждую инструкцию.
Ассемблер и линкер — это фундамент инструментария. Но писать на ассемблере всё равно больно. Поэтому в следующем разделе мы поднимемся на уровень выше и посмотрим на компилятор BASIC — язык, который превращает LET A = A + 1 в пять инструкций ассемблера и позволяет программисту думать о логике, а не о регистрах.
А заодно я расскажу, почему PRINT в моём BASIC выводит только один hex-символ и почему FOR не видит переменную цикла. Спойлер: это не баги, а осознанные ограничения.
3. От ассемблера к BASIC, или Язык для тех, кто не любит регистры
Писать на ассемблере — это, конечно, сурово и почётно. Но давайте честно: когда вам нужно просто сложить два числа и вывести результат, возиться с LDM, XCH и ADD как-то не хочется. Хочется чего-то попроще. Например, LET A = A + 1. И чтобы оно само превратилось в машинный код.
Именно для этого я написал компилятор BASIC. Не тот классический BASIC из 70-х, а учебный диалект, который понимает только самое необходимое: переменные, присваивание, PRINT, GOTO, IF, FOR и GOSUB. Но этого достаточно, чтобы почувствовать разницу между «жонглированием регистрами» и «нормальным программированием».
Как текст превращается в ассемблер
Компилятор работает в три стадии, как и положено любому уважающему себя учебному компилятору.
Лексер (basic_lexer.py) режет исходник на токены: числа, ключевые слова, переменные, операторы, строки. Парсер (basic_parser.py) собирает из токенов дерево разбора (AST), в котором каждая строка BASIC представлена объектом-узлом. Кодогенератор (basic_codegen.py) проходит по этому дереву и печатает строки ассемблера.
исходник BASIC
    │
    ▼
BasicLexer.tokenize()       → список токенов
    │
    ▼
BasicParser.parse()         → словарь {номер_строки: AST-узел}
    │
    ▼
BasicCodeGen.generate()     → текст ассемблера
    │
    ▼
ассемблер / эмулятор 4004
Никакого промежуточного представления, никаких оптимизаций, никакого распределения регистров. Всё максимально прямолинейно. Именно поэтому кодогенератор можно прочитать целиком и понять, что происходит.
Эта схема объясняет всю архитектуру компилятора за десять секунд. Три файла — три стадии. Если вы захотите добавить новую конструкцию языка, вы точно знаете, в какой файл идти: в лексер (если это новое ключевое слово), в парсер (если это новая структура) или в кодогенератор (если это новая инструкция).
Переменные — это регистры
Самое элегантное решение в компиляторе — это отображение переменных на регистры процессора. В BASIC переменные — это одна буква от A до H. Каждая буква соответствует регистру:
self.var_map = {
    'A': 'R0', 'B': 'R1', 'C': 'R2', 'D': 'R3',
    'E': 'R4', 'F': 'R5', 'G': 'R6', 'H': 'R7'
}
То есть переменная A — это R0, переменная B — это R1, и так далее. Просто, наглядно и идеально подходит для 4-битного процессора, у которого всего 16 регистров.
Это показывает, как язык высокого уровня может быть «тонкой обёрткой» над железом. Здесь нет никакой магии: LET A = 5 превращается в LDM 5 и XCH R0. Вы всегда можете посмотреть на регистры и увидеть, что происходит. Это не абстракция, которая скрывает детали, а удобный синтаксис, который делает код понятнее.
Конечно, у этого решения есть обратная сторона: переменных всего восемь. I, J, K и остальные буквы не поддерживаются, потому что R8–R12 заняты под временные нужды кодогенератора, а R14–R15 — под порт телетайпа. Но для учебного языка этого достаточно.
Как LET A = A + 1 превращается в пять инструкций
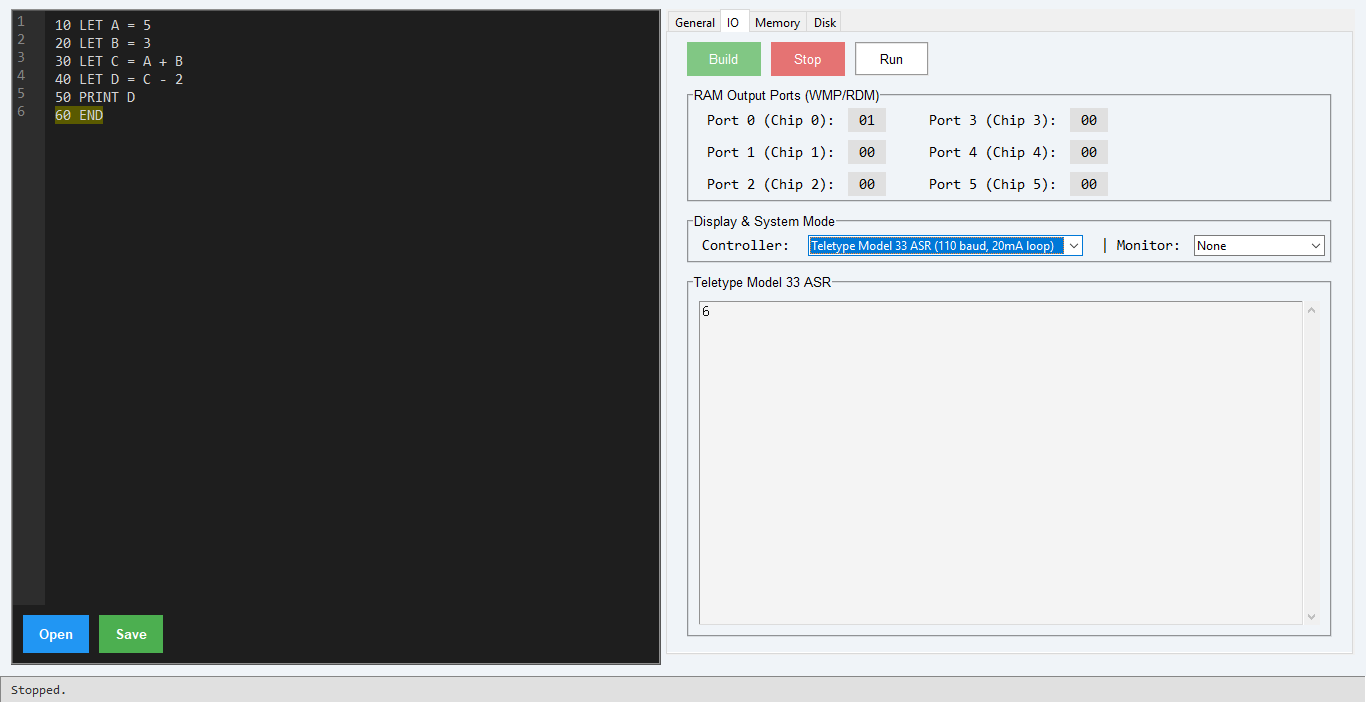
Давайте посмотрим на конкретный пример. Вот простая программа на BASIC:
10 LET A = 5
20 LET A = A + 1
30 PRINT A
40 END
А вот что генерирует кодогенератор для строки 20:
    LD R0       ; Загрузить A в аккумулятор
    XCH R8      ; Сохранить левый операнд в R8
    LDM 1       ; Загрузить 1 в аккумулятор
    ADD R8      ; Сложить: ACC = ACC + R8
    XCH R0      ; Сохранить результат обратно в A
Пять инструкций на одну строчку BASIC и это ещё не самое плохое решение.
Этот фрагмент кода показывает цену абстракции. В современном языке A = A + 1 — это одна операция. Здесь — пять инструкций, потому что у процессора только один аккумулятор, и чтобы вычислить правый операнд, левый нужно куда-то сохранить. R8 выступает в роли «временной переменной», но её никто не выделяет — она просто всегда используется для этой цели.
Честные ограничения: что BASIC не умеет
Я не пытался сделать полноценный язык. BASIC в моём эмуляторе — это учебный инструмент и у него есть ограничения, о которых стоит знать.
PRINT выводит только один hex-символ. Если вы напишете PRINT A, где A = 15, на телетайпе появится F, а не 15. Полноценный десятичный вывод потребовал бы гораздо более сложного кодогенератора.
FOR не видит переменную цикла. Цикл FOR I = 1 TO 5 использует R8 как счётчик и R9 как границу, но тело цикла не может обратиться к I. Если вы напишете PRINT I, кодогенератор выдаст ошибку, потому что I не отображена на регистр.
* и / разбираются, но не генерируются. Парсер понимает эти операторы, но кодогенератор для них ничего не делает. Результат будет неверным. Если нужно умножение — придётся реализовать его через сложение в цикле.
Комментарии удаляются до разбора. Строка PRINT "A;B" обрежется по ; и программа сломается. Это следствие того, как устроен лексер.
Все эти ограничения — не баги, а осознанные компромиссы. Я хотел, чтобы компилятор был понятным, а не полным. И как по мне, для учебного языка этого вполне достаточно.
4. Периферия, или Франкенштейн из 70-х
Вот тут начинается самое интересное. У нас есть процессор, который выполняет инструкции. У нас есть ассемблер и линкер, которые превращают текст в машинный код. Но пока всё это работает в вакууме: процессор считает, но результат никуда не выводится. Он слепой и глухой.
И вот тут я решил сделать то, что в реальной истории никто не делал. Я подключил к 4004 периферию, с которой он никогда не встречался. Дисковод на 8-дюймовых дискетах? Пожалуйста. UART, который использовался в терминалах 70-х? Легко. Видеочип от Atari 2600? Почему бы и нет.
Настоящий Intel 4004 в 1971 году работал с калькулятором Busicom и всё. Дисководы Shugart SA 800 появились в 1973-м. UART AY-5-1013 — примерно тогда же. Atari TIA — вообще в 1977-м, для игровой консоли, которая работала на совершенно другом процессоре (MOS 6507). Эти устройства никогда не были частью одной системы с 4004.
Но раз уж я строю «машину времени», почему бы не скрестить 4-битный процессор с 8-битным миром? Так на свет появился Франкенштейн и спешу всех обрадовать, он работает.
Дисковод Shugart SA 800-1: как медленный процессор заставил придумать гениальное решение
Начнём с дисковода. Shugart Associates выпустила SA 800 в 1973 году и он быстро стал отраслевым стандартом для 8-дюймовых дисководов. Формат IBM 3740, который он использовал, был жёстко зафиксирован: 77 дорожек, 26 секторов на дорожку, по 128 байт в секторе. Итого — 256 256 байт на дискету.
Но вот в чём проблема. Дискета вращается со скоростью 360 оборотов в минуту. Один оборот занимает около 166 миллисекунд. За это время головка проходит над всеми 26 секторами. И если контроллер читает сектор 0, а следующим физическим сектором будет сектор 1, то процессору нужно успеть обработать 128 байт данных до того, как головка окажется над следующим сектором. Иначе сектор будет пропущен.
Для 4004 с его 740 кГц это практически невозможно. Он слишком медленный.
Решение, которое придумали в CP/M (и которое я воспроизвёл), — это программное чередование секторов. Сектора читаются не по порядку (0, 1, 2, 3…), а с пропуском:
self.skew_table = [
    0, 6, 12, 18, 24, 4, 10, 16, 22, 2, 8, 14, 20,
    1, 7, 13, 19, 25, 5, 11, 17, 23, 3, 9, 15, 21
]
Прочитали сектор 0 — следующим читаем физический сектор 6. За это время процессор успевает обработать данные. Потом сектор 12, 18, 24… и только потом, на втором обороте, сектор 1.
Это хорошая история про то, как ограничения железа рождают элегантные программные решения. Таблица из чисел выглядит скучно, но за ней стоит драма: медленный процессор, быстрая дискета и необходимость как-то их подружить. И именно эту таблицу использовала CP/M 1.4/2.2 — операционная система, которая на долгие годы стала стандартом для 8-битных машин.
Кстати, Гэри Килдалл разрабатывал CP/M как раз на дисководе SA800 в 1974 году. Так что мой эмулятор, в каком-то смысле, воспроизводит ту же связку, только с 4004 вместо 8080.
UART AY-5-1013: мост между 4 и 8 битами
Следующая проблема — как вывести текст на терминал. У 4004 нет встроенного UART. В реальных системах 70-х для этого использовали внешний чип, например General Instrument AY-5-1013.
Этот UART был разработан примерно в 1971 году. Он умел работать на скорости до 40 кбод, поддерживал формат кадра с 5–8 битами данных, опциональной чётностью и 1–2 стоп-битами. Его использовали в терминалах, в том числе в Elekterminal (1978).
Но вот незадача: 4004 — 4-битный. А UART работает с 8-битными байтами. Как передать байт через 4-битную шину?
Ответ: по нибблам. Сначала младшие 4 бита, потом старшие. В коде эмулятора это выглядит так:
def write_data(self, nibble):
    if self.data_in_phase == 0:
        self.data_in_low = nibble
        self.data_in_phase = 1
    else:
        data_byte = (nibble << 4) | self.data_in_low
        self.data_in_phase = 0
        self.set_transmit_data(data_byte)
Первый вызов write_data() сохраняет младший ниббл. Второй — склеивает его со старшим и отправляет в буфер передачи. UART сам «выстреливает» биты в нужном порядке и с нужными интервалами.
И вот таким макаром 4-битный процессор общается с 8-битным миром. Нет никакой магии: просто две операции записи вместо одной. Но за этой простотой стоит понимание того, что байт — это не атомарная единица, а два кусочка по 4 бита.
Teletype Model 33 ASR: механический терминал, который не любит спешки
Teletype Model 33 ASR — это электромеханический терминал, который появился ещё в 1963 году. Он работал на скорости 110 бод, что примерно соответствует 10 символам в секунду. Использовал 20 мА токовую петлю и кодировку ASCII.
В эмуляторе teletype.py реализует конечный автомат, который собирает биты в байт и проверяет стоп-биты. Но есть важное упрощение: тайминги игнорируются. В реальном телетайпе процессор должен был ждать, пока механика «прожуёт» символ. В эмуляторе это ожидание не моделируется.
Да, эмулятор получается быстрый, но не точный до микросекунд. И в этом есть своя прелесть. Вы можете запустить программу, которая выводит текст и увидеть результат мгновенно, а не ждать, пока телетайп пропечатает каждую букву.
Atari TIA: видеочип, который «гнался за лучом»
А теперь самое безумное. Atari TIA (Television Interface Adaptor) — это чип из Atari 2600, выпущенной в 1977 году. Он генерировал изображение и звук, но у него не было кадрового буфера. Программа должна была успевать записывать данные в регистры TIA синхронно с электронным лучом телевизора. Этот процесс назывался «racing the beam».
В эмуляторе я использую буферизованную модель: программа записывает регистры, а потом вызывается render(), который рисует кадр целиком. Это единственно возможный путь для 4004, который не может «гнаться за лучом» из-за низкой тактовой частоты.
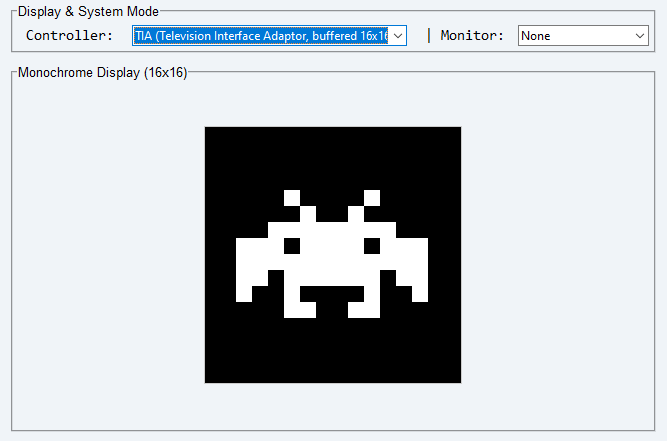
Да, это адаптация, а не эмуляция. Я не пытаюсь воспроизвести TIA пиксель в пиксель. Я беру его идею — регистровую модель спрайтов и фона — и реализую её так, чтобы 4004 мог с ней работать. Это не историческая реконструкция, а творческое переосмысление.
Intel 4003: сдвиговый регистр, который был рядом
Из всей периферии только Intel 4003 был реальным компаньоном 4004. Это 10-битный сдвиговый регистр с последовательным входом и параллельным выходом, который использовался как расширитель портов. Процессор отправлял биты по одному, а 4003 собирал их в параллельное значение.
В эмуляторе sr4003.py реализует эту логику: set_data() устанавливает бит на входе, clock_pulse() сдвигает регистр, get_parallel_out() возвращает результат.
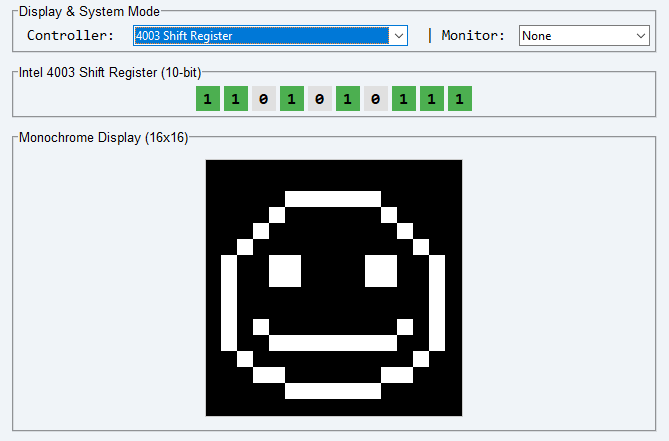
По сути, 4003 — это единственное устройство из всех, которое действительно существовало вместе с 4004 в одной системе и оно показывает, как процессор мог управлять дисплеем или клавиатурой, не имея видеовыхода как такового.
Эмулятор не обязан быть исторической реконструкцией. Он может быть исследовательской песочницей. Я взял устройства из разных эпох и разных систем, подключил их к 4004 и посмотрел, что получится и получилось что-то работающее: процессор печатает текст, читает дискеты и даже рисует картинки.
Это не «как было». Это «как могло бы быть». И, честно говоря, в этом есть свой шарм :-)
Теперь нужно заставить всё это работать вместе. В следующем разделе мы напишем System Monitor — маленькую «операционную систему» на ассемблере 4004, которая умеет управлять памятью, дисководом и терминалом. А заодно я расскажу, как заменил перфоленту на дискету и почему диспетчеризация команд по старшему нибблу — это гениально.
5. System Monitor: операционная система на 46 инструкциях
Вот мы и добрались до момента, когда все детали на месте: процессор работает, ассемблер собирает код, периферия подключена. Осталось заставить это работать вместе. Для этого я написал System Monitor — маленькую «операционную систему» на ассемблере 4004, которая живёт прямо в эмуляторе.
Назвать её «операционной системой» — это, конечно, смело. Но по сути она делает то же, что и первые мониторы 70-х: выводит приглашение, принимает команды, показывает память, правит байты и запускает программы. Только вместо перфоленты у меня дискета, а вместо телетайпа — виртуальный терминал.
Как это было в оригинале: MON4 и перфолента
Прежде чем рассказывать про свою реализацию, стоит вспомнить, как это выглядело в реальности. У Intel был Intellec 4 — система разработки на базе 4004, ПЗУ которой прошивался монитор MON4. Он умел немного, но по тем временам — этого хватало с головой.
Оригинальный MON4 работал с перфолентой. Загрузка программ шла через команды R (Read) и L (Load), которые читали данные с бумажной ленты в форматах BPNF или Intel HEX. Были и другие команды: D для дампа памяти (с указанием начального и конечного адреса), S для просмотра и редактирования байта, M для копирования блоков памяти, I для инвертирования, P для программирования ПЗУ. И это не считая команд для работы с перфоратором и высокоскоростным считывателем.
В общем, полноценный инструмент для разработчика 1971 года. Только вместо привычного нам диска — бумажная лента, которую нужно было аккуратно заправлять в считыватель.
Что я сделал иначе
Я не стал копировать MON4 один в один. Во-первых, потому что перфоленты у меня нет. Во-вторых, потому что 4004 — не та машина, где можно развернуться с полноценным монитором. Поэтому я взял ту же идею, но адаптировал её под свои условия.
Замена перфоленты на дискету. Вместо команд R и L для чтения бумажной ленты я сделал команды R (Read) и W (Write), которые работают с сектором дискеты. Это логичное развитие: у меня уже был эмулированный дисковод Shugart и формат IBM 3740, почему бы не использовать их для загрузки программ? Конечно, это не историческая реконструкция, но зато работает.
Упрощение команд. Я оставил только самое необходимое: D (дамп памяти), S (редактирование), X (просмотр регистров), G (запуск), R (чтение сектора) и W (запись сектора). Команды для работы с перфолентой (J, K, L), копирования памяти (M) и инвертирования (I) я не реализовывал — для учебных задач они не нужны, а место в ROM ограничено.
Вывод по нибблам. Оригинальный MON4 выводил дамп по 16 байт в строке. Мой MON_PUT_HEX_NIB выводит по одному нибблу за раз, и это осознанное упрощение. На 4004 каждый лишний цикл на счету, а полноценное форматирование строки потребовало бы гораздо больше кода.
Главный цикл и гениальная диспетчеризация
Сердце монитора — это главный цикл. Он выводит приглашение >, читает символ с телетайпа и решает, что с ним делать. Но вот проблема: как сравнить введённый символ с командами, не написав кучу кода?
Вот тут начинается самое интересное. Вместо того чтобы сравнивать символ с каждой командой по очереди (что заняло бы много места и времени), я использовал каскадное сравнение старших нибблов.
Следите за кодом:
MON_LOOP:
    JMS MON_PUT_PROMPT
    JMS MON_GET_CHAR

    ; Проверяем старший ниббл (R3)
    LD R3
    XCH R4
    LDM 4
    XCH R5
    LD R4
    CLC
    SUB R5
    JCN Z MON_DISP_4    ; Если старший ниббл = 4 (D, G)

    LDM 5
    XCH R5
    LD R4
    CLC
    SUB R5
    JCN Z MON_DISP_5    ; Если старший ниббл = 5 (S, X, R, W)

    JUN MON_BAD         ; Иначе — ошибка
Логика простая. Сначала проверяется, к какой группе относится команда: D/G (старший ниббл 4) или S/X/R/W (старший ниббл 5). Затем внутри группы проверяется младший ниббл. Это классический метод ветвления, идеально подходящий для 4-битных данных.
Этот код показывает, как ограничения архитектуры рождают элегантные решения. На современном процессоре я бы просто написал switch или цепочку if. На 4004 каждая инструкция на счету и приходится экономить. Каскадное сравнение нибблов — это не просто «один из способов», это способ, который идеально ложится на 4-битную архитектуру.
Команды, которые умеет монитор
Вот что можно сделать с помощью моего монитора.
D (Dump) — выводит 16 последовательных нибблов из памяти. Вы вводите адрес (два hex-символа) и монитор показывает, что там лежит. Например, D 00 выведет содержимое памяти с адреса 0x00 по 0x0F.
S (Substitute) — изменяет один ниббл в памяти. Вы вводите адрес, затем новое значение. Монитор записывает его и выводит подтверждение.
X (Examine) — показывает содержимое всех 16 регистров процессора. Полезно, когда нужно понять, что происходит внутри.
G (Go) — передаёт управление по указанному адресу. Использует JIN P0 — классический способ косвенного перехода на 4004.
R (Read) — читает сектор 0 с текущей дорожки дискеты в память, начиная с 0x00. Это моя замена перфоленте.
W (Write) — записывает 128 байт из памяти на дискету. Зеркальная операция для R.
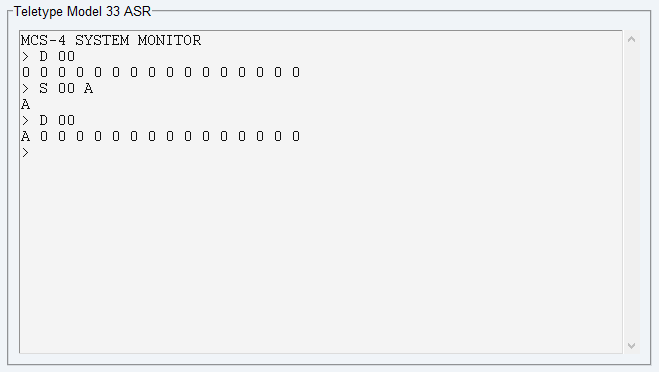
Как это работает под капотом
Монитор разбит на несколько модулей. monitor.asm — главный цикл и диспетчеризация. console_io.asm — ввод/вывод через UART: MON_SEND_CHAR, MON_GET_CHAR, MON_PUT_HEX_NIB. memory_cmd.asm — команды D и S. disk_cmd.asm — команды R и W. system_cmd.asm — X и G.
Такая модульность — это не просто «красиво». Это позволяет заменять или расширять части монитора, не трогая остальные. Захотел добавить новую команду — добавил подпрограмму и прописал её в диспетчере. Всё, как в большой системе, только масштаб меньше.
Монитор — это, пожалуй, максимум, что можно выжать из 4004 в жанре «операционная система». У него нет файловой системы, нет многозадачности, нет защиты памяти. Но у него есть командная строка, работа с памятью и дисководом и он написан на ассемблере 4004, который сам себя обслуживает.
И это доказывает главное: даже с 4-битным процессором, 12-битной адресацией и стеком на три уровня можно построить работающую интерактивную систему. Пусть она умеет немного, но она работает. А для 1971 года — это уже немало.
Монитор — это инструмент. Но инструмент скучный. В следующем разделе мы запустим на нём Тетрис — и посмотрим, как 4-битный процессор справится с игрой, у которой нет видеопамяти, нет спрайтов и всего три уровня стека. Спойлер: он не справится. И это будет самое интересное.
6. Тетрис, или Как сломать 4-битный процессор правильно
Тетрис на 4004 — это не просто игра. Это тест на выживание. И процессор его, честно говоря, не проходит. Но то, как именно он не проходит, — это отдельная история, которая объясняет про 4004 больше, чем любая документация.
Немного истории: где и когда появился Тетрис
Для начала — короткая справка. Тетрис придумал Алексей Пажитнов в 1984 году, работая в Вычислительном центре Академии наук СССР. Ему было 29 лет и он, заскучав на работе, решил найти своим математическим навыкам новое применение. Первая версия была написана на советском компьютере «Электроника-60» — это был терминал с зелёным монохромным дисплеем, который не умел отображать графику в привычном нам виде. Фигуры там рисовались символами. Тем не менее, игра получилась настолько удачной, что её начали копировать с одной машины на другую и очень скоро она вышла за пределы Союза.
Я упоминаю об этом потому, что «Электроника-60» — это тоже очень ограниченная машина. Но по сравнению с 4004 она просто гигачад. У неё был полноценный текстовый дисплей, нормальная оперативная память и 16-битный процессор. А у меня — 4 бита, 12-битная адресация и стек на три уровня.
Как рисовать без видеопамяти
Первая проблема, с которой я столкнулся, — это отсутствие видеопамяти. У 4004 её нет ВООБЩЕ. В эмуляторе есть экран 16×16 пикселей, но процессор об этом не знает. Он не может «записать пиксель в память» — такой памяти просто не существует.
Решение, которое я использовал, — это прямой доступ к пикселям через порты сдвигового регистра 4003. В моём Tetris нет понятия «спрайт» или «видеопамять». Есть только подпрограммы DRAW_PIXEL и CLEAR_PIXEL, которые работают с портами 0, 1 и 2:
; R6 = X, R7 = Y
DRAW_PIXEL:
    FIM P0 0x00     ; R0 = 0 (порт X)
    SRC P0
    LD R6
    WMP             ; Отправить X в порт 0

    FIM P0 0x10     ; R1 = 1 (порт Y)
    SRC P0
    LD R7
    WMP             ; Отправить Y в порт 1

    FIM P0 0x80     ; R8 = 8 (данные)
    SRC P0
    LDM 1
    WMP             ; Зажечь пиксель
    BBL 0
Стенки и дно рисуются циклами: стенки — от Y=7 до Y=15 по X=5 и X=10, дно — от X=5 до X=10 на Y=15. Игровое поле получается всего 6×9 пикселей. Из 16×16 доступных — это всё, что я смог себе позволить.
Здесь рисование превращается в последовательность портовых операций. Нет никакой «графической библиотеки». Есть три порта, которые нужно дёргать в правильном порядке. И если ошибиться с координатами, пиксель улетит не туда.
«Иллюзия стакана»: почему в игре только один упавший блок
А теперь самое смешное. В моём Tetris нет двумерного массива для хранения упавших блоков. Вообще нет. Потому что для него нет памяти.
Вместо этого в регистрах R12 (Y) и R13 (X) хранятся координаты только последнего упавшего блока. Если упадёт второй блок, координаты первого затрутся. Игра больше похожа на «избегание препятствий», чем на классический Тетрис. Полноценная башня из фигур на 4004 в таком виде невозможна.
Это ограничение архитектуры диктует геймдизайн. Вы не можете сделать «настоящий» Тетрис, потому что у вас нет места для хранения состояния. Приходится придумывать «иллюзию». И это, пожалуй, самый наглядный пример того, как железо влияет на игры.
Критический баг (и почему это не баг)
А теперь — кульминация. Если вы запустите мой Tetris и нажмёте «Влево» или «Вправо» в момент, когда блок падает, игра сломается. Не «зависнет», не «вылетит с ошибкой», а именно сломается: процессор прыгнет не туда, и выполнение пойдёт по случайному адресу.
Выглядит это как жуткий баг. Но на самом деле это точное воспроизведение поведения реального 4004. И вот почему.
Давайте посчитаем вложенность вызовов при обработке нажатия клавиши:
; Упрощённая схема вызовов
FALL_LOOP:          ; главный цикл падения
    JMS CHECK_INPUT ; Уровень 1
    ; ...

CHECK_INPUT:
    JMS MOVE_LEFT   ; Уровень 2
    ; ...

MOVE_LEFT:
    JMS CLEAR_BLOCK ; Уровень 3
    ; ...

CLEAR_BLOCK:
    JMS CLEAR_PIXEL ; Уровень 4 — СТЕК ПЕРЕПОЛНЕН!
    ; ...
Стек 4004 имеет глубину всего три уровня (плюс текущий PC). Когда CLEAR_BLOCK вызывает CLEAR_PIXEL, это уже четвёртый уровень вложенности. Адрес возврата для первого вызова затирается. И когда CLEAR_PIXEL выполняет BBL (возврат), процессор возвращается не туда, откуда его вызвали, а по адресу, который остался в стеке от какого-то предыдущего вызова. Программа уходит в «случайное плавание».
Это не ошибка эмулятора. Это архитектурное ограничение, которое в реальном 4004 привело бы к точно такому же поведению. Многие эмуляторы «сглаживают» такие углы, делая стек больше, чем в оригинале. Я этого не делаю. Мой эмулятор строго воспроизводит трёхуровневый стек и поэтому Tetris ломается ровно так, как ломался бы на реальном железе. Это не баг, а фича.
Почему я оставил это «сломанным»
Вы наверное спросите: «Почему ты не починишь игру? Почему не сделаешь стек больше?» Ответ простой: потому что тогда это будет не 4004. Это будет «процессор, похожий на 4004, но с более удобным стеком». А я строю машину времени, а не удобную игрушку.
Этот «сломанный» Tetris — это образовательный артефакт. Он показывает, что на Intel 4004 архитектурные ограничения (мало памяти, нет умножения, трёхуровневый стек) диктуют свои правила игры. Этот код - идеальный пример того, как выжать максимум из 4-битного процессора.
Tetris на 4004 — это не про игру. Это про то, как далеко можно зайти, имея всего 4 бита, 12-битную адресацию и стек на три уровня. Можно нарисовать что-то на экране. Можно обработать ввод. Можно даже сделать что-то, что отдалённо напоминает Тетрис. Но нельзя сделать полноценную игру, потому что железо не позволяет.
И в этом есть своя прелесть. Современные игры могут всё, а 4004 — только то, что помещается в его ограничения. И именно это делает его интересным.
Заключение
На этом как бы всё.
Я прошёл долгий путь. От игрушки с рандомными опкодами до полноценной среды, где 4-битный процессор из 1971 года печатает текст, читает дискеты, рисует смайлики и даже играет в Тетрис (пусть и ломанный). Если честно, я не ожидал, что доведу этот проект хоть до какой-то юзабельной стадии.
Знаете, есть такая поговорка: «Раз в год и палка стреляет». Вот это примерно про меня. Я не программист по специальности. У меня образование, кардинально противоположное компьютерному. Раньше программирование было моим основным хобби, сейчас — уже нет. Но иногда я что-то этакое берусь делать. По большей части я довожу свои уже существующие пет-проекты до приемлемого состояния и этот эмулятор — как раз из такой серии.
Я не пытаюсь конкурировать с профессиональными эмуляторами. Я не пишу статьи в научные журналы. Я просто делаю то, что мне интересно и рассказываю об этом. И если у меня получилось сделать что-то, что работает, — это уже маленькая победа.
В общем, если вы захотите потыкать исходный код эмулятора или поиграться с ним, исходный код лежит на GitHub.
С вами был Yura_FX. Спасибо, что дочитали эту статью до конца. Не забывайте делиться своим мнением в комментариях :)
Если эта публикация вас вдохновила и вы хотите поддержать автора — не стесняйтесь нажать на кнопку
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.