Фильтр Калмана в цикле правок ИИ: что он меняет и как это проверить
Глядя на то, как современные вайбкодеры обращаются с роями агентов, возникает ощущение, как будто все разом забыли про существование теории управления. В самом деле, как можно строить все эти циклы с исполнителями и критиками просто наугад?
Агент исправил работу, но очередной отзыв критика требует исправить еще. Итерации могут не сходиться или сходиться слишком медленно, возникает проблема «шумного критика» — это все давно известно для систем вида предиктор+корректор.
Один из инструментов для работы с шумными измерениями — фильтр Калмана.
Я сначала проверил его на простой численной модели, а затем построил стенд с настоящими ИИ-агентами. Результаты получились разными: в учебной симуляции фильтр улучшил оценку состояния и уменьшил величину правок, а в реальном пилоте дополнительного преимущества Калмана обнаружить не удалось.
Ниже я подробно разбираю обе постановки и границы полученных выводов. Начинаю с простой учебной модели и сравнения при одинаковых условиях, затем перехожу к практике: проверке замечаний, выбору правок по нескольким критериям и организации агентского цикла.
В эксперименте на реальной задаче я сравнил четыре способа принятия изменений в цикле «автор — критик» на базе языковой модели gpt-6.1-sol: по рекомендации критика, по фиксированному статистическому правилу, со сглаживанием и с фильтром Калмана.
ИИ-агент пытался ускорить работу функций, написанных на Python. На стенде проверялись корректность, время выполнения и память.
Всего было получено 720 ответов модели: 144 для калибровки и 576 для оценки.
Оценочная часть стенда состоит из 48 траекторий: 6 задач × 2 повтора × 4 режима.
В каждой траектории содержится шесть последовательных попыток улучшения кода — шесть ответов автора и шесть ответов критика. Подробности и результаты приведены в разделе 8.
Фильтр Калмана соединяет прогноз и новый отзыв, учитывая, насколько каждому можно доверять.
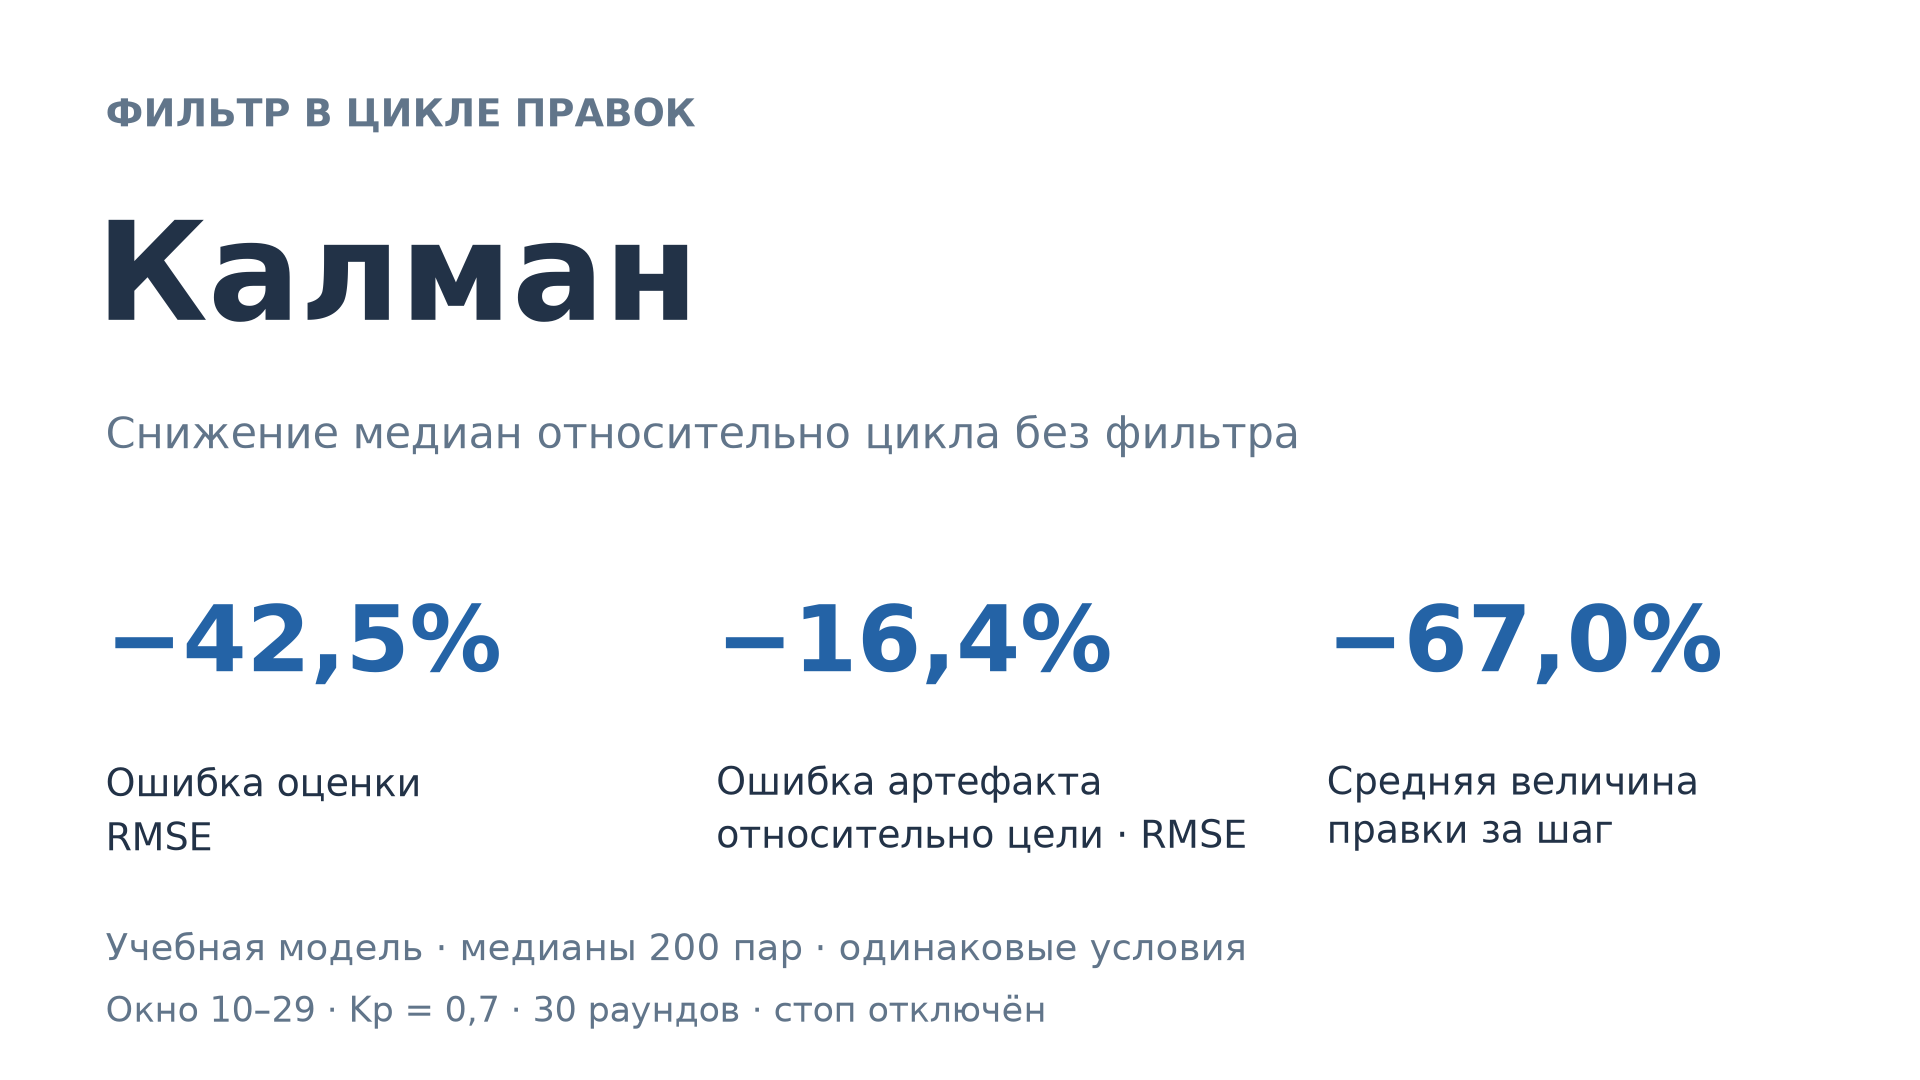
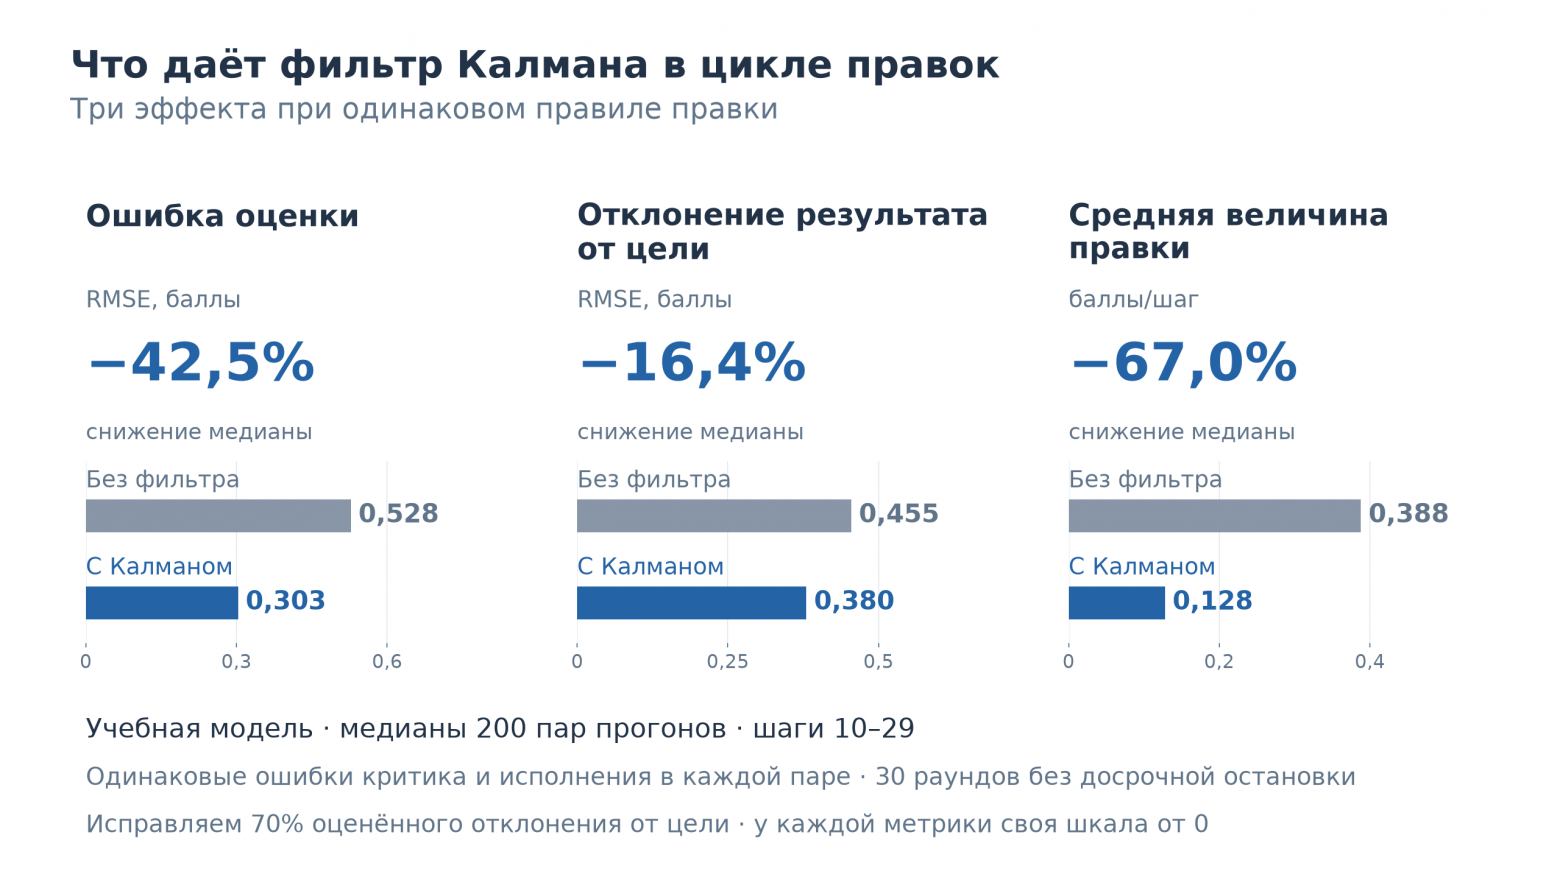
Результаты на слайде получены в учебной симуляции.
Код и сохранённые результаты учебной симуляции доступны в Jupyter-ноутбуке. Полный комплект учебной симуляции включает также исходники, зависимости, таблицы, рисунки, анимации и инструкции запуска.
Для собственного опыта с настоящими агентами скачайте отдельный пакет запуска через OpenAI API. В разделе 9 объясняю, как начать с демонстрации, выбрать объём опыта и сохранить прогресс.
Оглавление
Введение. Как отзыв критика превращается в команду для исполнителя
Когда оценка критика сразу определяет следующую правку, ИИ-агент очень легко попадает в цикл избыточных правок. Поправил вступление — критик доволен.
Переписал середину, слегка сломав вступление, — критик просит вернуть прежнее.
ИИ-агент возвращает вступление и заново ломает середину.
Версии сменяют друг друга, бюджет токенов убывает. Теория управления помогает разобраться, почему такой цикл может колебаться вместо достижения цели.
Что здесь происходит с научной точки зрения? ИИ-агент правит работу, критик оценивает результат, отзыв критика определяет следующую правку.
В теории управления это называется обратной связью. Шумные правки могут возникнуть как из-за слишком сильных правок исполнителей, так и из-за неточных отзывов критиков.
Как отличить действие этих причин друг от друга?
Используем парное контролируемое сравнение: сохраняем остальные условия и меняем только способ обработки измерений. Сначала закрепим простое правило правки, затем проверим вклад обработки отзывов критика.
Похожий порядок работы Мэтт Шумер (Matt Shumer) назвал Gauntlet Loop при работе над Claude of Duty: Исполнитель исправляет результат, Критик со свежим контекстом сравнивает его с заданным образцом, после чего цикл повторяется.
Я взял его подход как основную схему для учебного эксперимента.
Человек задаёт цель и критерии, а задача заключается в том, чтобы показать, что же происходит между оценкой и следующей правкой, и как это оптимизировать.
1. Минимальная модель: эталон, артефакт, критик
Я представил состояние результата работы ИИ-агента одной точкой на числовой оси.
Одна точка показывает текущее состояние результата, другая — нужное.
Правка сдвигает первую точку, а критик сообщает её положение с ошибкой.
Эта точка движется после каждой итерации. Она может приближаться к цели, метаться вокруг неё или уходить в сторону. Цель заключается в том, чтобы понять, как этим управлять.
Такая модель удобна тем, что можно по отдельности включать ошибку критика, неточность исполнения или задержку. А затем дать двум вариантам цикла одинаковые последовательности ошибок и проверить, что изменяют разные подходы.
Смысл такого опыта гораздо шире задачи редактирования текста, или решения простейшего дифференциального уравнения. В первую очередь он важен для задачи генерации кода.
Код, план или статья проходят один и тот же путь правок: сделать → оценить → переделать. Исследуемая ниже модель помогает понять, как сама организация этого цикла порождает метания или помогает их уменьшить.
Одна правка глазами агента и критика
Прежде всего разберёмся, откуда и как именно возникает ошибка.
Пусть нужный результат находится на отметке 10, текущий — на 8,1. Агент решил прибавить 1,2 балла. Правка сработала чуть сильнее: добавилось ещё 0,05. Получилось 9,35. Но критик сегодня строг: занизил оценку на 0,25 и сообщил 9,1.
Что мы хотим узнать | Ответ в этом примере |
|---|---|
Что получилось после правки? | 8,1 + 1,2 + 0,05 = 9,35 |
Что сообщил критик? | 9,35 − 0,25 = 9,1 |
Сколько осталось до цели на самом деле? | 10 − 9,35 = 0,65 |
Сколько осталось, по мнению агента? | 10 − 9,1 = 0,9 |
Агент выбирает следующую правку по последней строке.
Например, если исправлять 70% замеченной ошибки, он добавит ещё 0,63 балла. Мы уже видим источник проблем: действие рассчитывается по оценке критика, а меняет реальный артефакт. Эти две величины могут расходиться.
Что фиксируем в модели
Зафиксируем правила этой числовой шкалы.
Мы хотим попасть близко к десяти; перелёт выше цели тоже будем считать ошибкой.
У нас два источника случайности.
Исполнитель может выполнить правку чуть сильнее или слабее, чем задумал.
Критик может завысить или занизить результат.
В базовом опыте оба источника дают случайные ошибки без систематического смещения. Зададим типичный разброс ошибок критика — 0,55 балла, а исполнения — около 0,22.
Точное значение знает только симулятор: оно понадобится нам для оценки качества.
Разность «цель минус оценка критика» будем называть невязкой.
Если она положительная — нужно прибавить, отрицательная — убавить.
Правило, которое по этой невязке выбирает правку, называется регулятором.
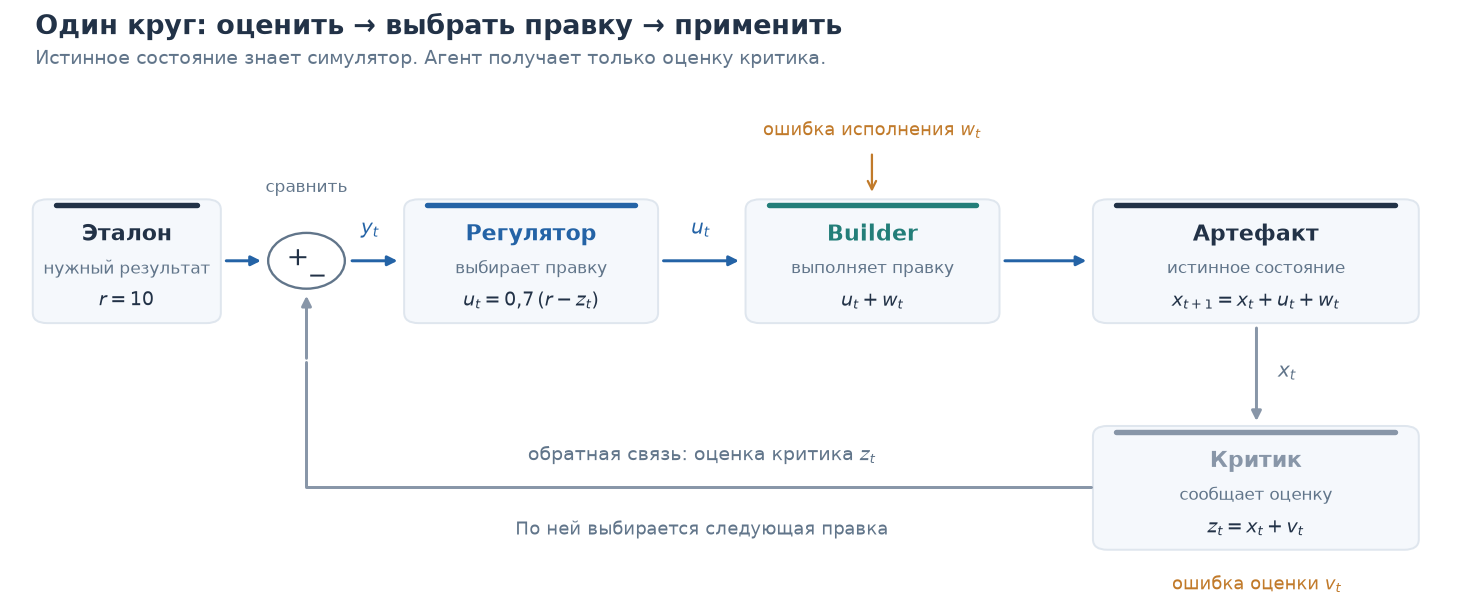
Теперь весь цикл можно прочитать без формул:
измерить → сравнить с целью → выбрать правку → применить её → повторить.
На рисунке 1 показан тот же самый маршрут. Будем менять отдельные части этого цикла и смотреть, что происходит.
Как из оценки получается правка
Для основного опыта хватит одного правила: исправлять 70% оценённой ошибки.
Не хватает двух баллов — добавляем 1,4; не хватает половины — добавляем 0,35. Перебрали полбалла — убавляем 0,35. Возле цели правка становится меньше.
Это так называемый пропорциональный, или P-регулятор; долю называют усилением и обозначают  . У нас она равна 0,7.
Теперь остаётся выбрать, от какого именно числа считать ошибку:
Можно взять свежий отзыв критика.
Можно сначала уточнить состояние по прогнозу и отзыву.
Именно эти два варианта далее сравниваются.
Как настраивать P и зачем добавлять к нему реакцию на изменение ошибки или память о прошлых недолётах, разберём в дополнении в конце. Для всех опытов с фильтром в основной части хватит этого правила 70%.
Уравнения модели и обозначения: что именно считает симулятор
Обозначим цель через  , истинное состояние артефакта — через
 , измерение критика — через
 . Индекс
 здесь означает номер шага. Базовая модель выглядит так:

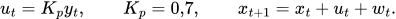
Здесь  — ошибка критика,
 — ошибка исполнения,
 — заданная правка.
Шумы критика и исполнителя независимы между собой по времени, имеют нормальное распределение с нулевым средним. В базовых прогонах:
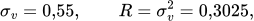
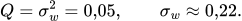
Стандартное отклонение  выражает разброс в баллах.
Символ | Смысл |
|---|---|
цель, обычно 10 | |
истинное состояние; шкала не ограничена сверху или снизу | |
измерение критика | |
| невязка, по которой рассчитывается правка |
правка; ограничение ±3 появится только в опыте с PID | |
, | шум критика и шум исполнения |
| дисперсии этих шумов |

 ,

В следующем разделе вместо свежего измерения регулятор получит оценку наблюдателя  . Тогда невязка станет
 .
Там же ввожу  — расчётную дисперсию ошибки оценки, и
 — вес нового измерения в фильтре Калмана. Усиление регулятора и вес измерения решают разные задачи: первое задаёт размер правки, второй — уточнение оценки.
В базовой модели нет ни инерции, ни насыщения: правка просто прибавляется. Постоянные потери, задержку, выбросы и другие нарушения далее включаются отдельно.
2. Фильтр Калмана: как не начинать с нуля после каждого отзыва ИИ-критика
Что можно узнать из оценки критика?
Разбираем в нашем игрушечном примере на конкретных числах.
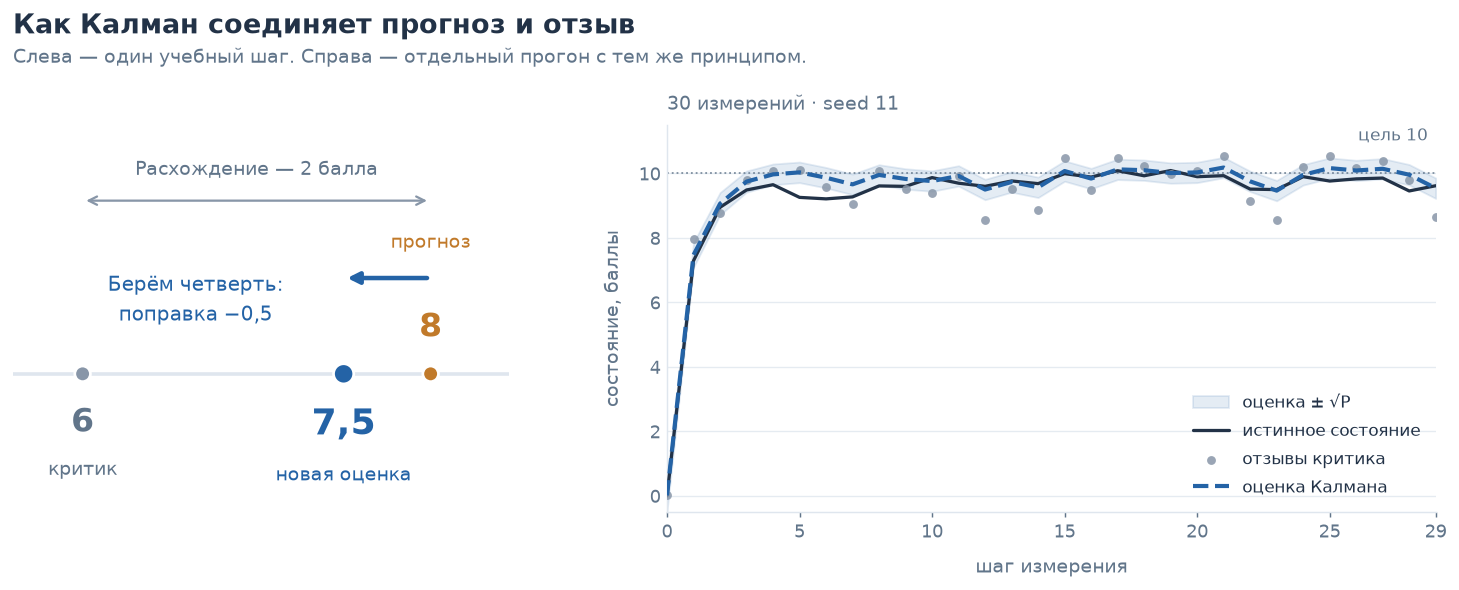
Прежняя оценка была шесть, ожидаемая прибавка от правки — два, новый отзыв — опять шесть. Прогноз и критик расходятся на два балла.
Если критик занизил состояние, регулятор, принявший его оценку как есть, подготовит слишком большую правку.
Но у нас осталась полезная информация: прежняя оценка и сведения о том, что уже изменилось. Критик мог ошибиться. Правка тоже могла сработать слабее ожидаемого.
Задача заключается в том, чтобы правильно учесть обе возможности.
Фильтр Калмана хранит оценку состояния, предсказывает её изменение после правки и уточняет прогноз по новому измерению.
В теории управления такой помощник называется наблюдателем. Его роль в том, что он отвечает регулятору на вопрос «где мы сейчас, насколько можем судить по данным?».
Ниже разбираю специально подобранный учебный шаг обычного фильтра, пока без защиты от выбросов. Сравнение на случайных прогонах будет дальше.
Что происходит | Число и его смысл |
|---|---|
Помним прошлый результат | наша оценка — 6 баллов |
Учитываем применённую правку | ожидаем прибавку 2, получаем прогноз 8 |
Читаем новый отзыв | критик сообщил 6, на два балла ниже прогноза |
Учитываем надёжность источников | в этом примере берём четверть расхождения |
Уточняем оценку | отступаем от 8 на половину балла: получаем 7,5 |
Число 7,5 лежит ближе к прогнозу, потому что в этом примере неопределённость прогноза меньше неопределённости нового измерения критика. Неопределённость прогноза включает и ошибку предыдущей оценки, и шум выполнения правки.
При равных неопределённостях прогноза и измерения оценка оказалась бы посередине — на семи. Если бы надёжнее оказалось измерение критика, результат сдвинулся бы ближе к шести. Коэффициент 0,25 здесь был получен из соотношения этих неопределённостей.
Теперь вернём оценку регулятору.
До цели 10 по свежему отзыву не хватает четырёх баллов, а по оценке фильтра — двух с половиной. При нашем правиле 70% следующая правка составит 1,75 вместо 2,8.
Фильтр Калмана изменил сведения о состоянии, размер правки по ним выбрал всё тот же P-регулятор.
Следующий раунд
Теперь в памяти остаются 7,5 и величина неопределённости этой оценки.
После очередной правки мы переносим оценку вперёд на ожидаемую прибавку. Заодно увеличиваем неопределённость: правка могла сработать не совсем так, как задумано. Приходит новый отзыв — снова уточняем прогноз.
Это объясняет, зачем здесь модель изменения состояния, а не простое среднее последних оценок. Старые отзывы относятся к старым версиям работы. Усредняя их напрямую, мы смешали бы качество до правки и после неё. Наблюдатель сначала учитывает изменение, а уже потом сопоставляет прогноз со свежим отзывом.
В журнал записываем
версию → прогноз эффекта → выполненную правку → повторную оценку.
Повторные оценки неизменной версии помогут измерить случайный разброс критика.
Для проверки прогноза и систематического перекоса нужен внешний ориентир, например оценка человека по той же шкале, или какая-то объективная метрика качества, потому что по одной разнице двух отзывов отделить эффект правки от ошибки критика нельзя.
На правом графике ниже показан один прогон симулятора. Серые точки — отзывы критика, синяя линия — оценка фильтра. Чёрная линия показывает истинное состояние: в учебной модели мы его знаем и можем проверить результат.
В реальной работе такого удобного ответа обычно нет. Посмотрите, как фильтр реагирует на очередную точку с учётом уже накопленной информации.
Остаётся проверить, стала ли меньшая правка полезнее.
В следующем опыте оба контура будут работать одинаковое число раундов, без досрочной остановки. Так вклад фильтра не смешается с выигрышем от раннего завершения работы.
После рисунка есть необязательный разбор формул — его можно пропустить и перейти к сравнению в разделе 3. Для более подробного изучения и перехода к многомерному случаю рекомендую статьи:
«Фильтр Калмана» — последовательный вывод формул для одномерного случая.
«Фильтр Калмана — Введение» — матричная запись алгоритма, смысл его параметров и пример реализации.
«Фильтр Калмана: от простого к сложному» — примеры многомерных моделей и настройки параметров фильтра.
Формулы фильтра Калмана и карта весов — необязательный разбор
Если хочется проверить формулы
Этот подраздел объясняет веса из примера и связывает их с кодом.
Обозначим прогноз качества через  , его дисперсию ошибки — через
 . Верхний минус означает «до нового измерения», верхний плюс — «после».
Критик сообщает  , дисперсия его ошибки — . Дисперсия измеряется в квадратных баллах; её корень — стандартное отклонение в баллах.
Откуда взялась четверть
Возьмём долю расхождения и сдвинем прогноз в сторону измерения:
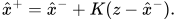
Скобка — это разница между сообщением критика и прогнозом. Её называют инновацией. В нашем примере это  . Число определяет, какую долю этой разницы учесть.
Пусть ошибки прогноза и текущего измерения несмещённые и независимые.
Тогда дисперсия ошибки получившейся оценки равна
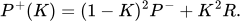
Первое слагаемое — оставшаяся ошибка прогноза, второе — ошибка, внесённая измерением. Это квадратичная функция . Минимум достигается при
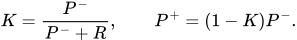
Теперь можно проверить пример: мы задали  ,
 .
Получаем 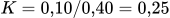 и
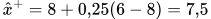 .
Новая дисперсия —  . Эти же действия выполняет код примера в ноутбуке.
При гауссовых ошибках можно получить тот же результат, умножив плотность прогноза на правдоподобие измерения:
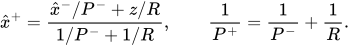
Обратная дисперсия здесь играет роль точности. Суть в том, что независимые сведения увеличивают её. Слово «независимые» существенно — два критика с общей ошибкой нельзя считать двумя независимыми измерениями.
При произвольных распределениях вывод через квадратичную ошибку даёт оптимальное линейное смешивание.
Один раунд в обозначениях кода
Сначала переносим прежнюю оценку на ожидаемую величину фактически применённой правки  . Дисперсию увеличиваем на — дисперсию ошибки исполнения:
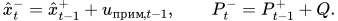
Затем рассчитываем и обновляем оценку по формулам выше. Регулятор использует невязку  , где — цель. Сам фильтр величину правки не выбирает.
В симуляторе  , а
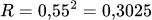 . Для ручного счёта удобно округлить до
 . При начальном
 первый прогноз даёт
 , первое измерение —
 и
 .
Начальная единица — это принятая фильтром неопределённость.
Сам симулятор начинает каждый прогон точно с  , а код добавляет уже перед первым измерением. Поэтому в начале расчётная не совпадает с фактической дисперсией ошибок по прогонам. Полоса на рисунке показывает именно расчёт фильтра.
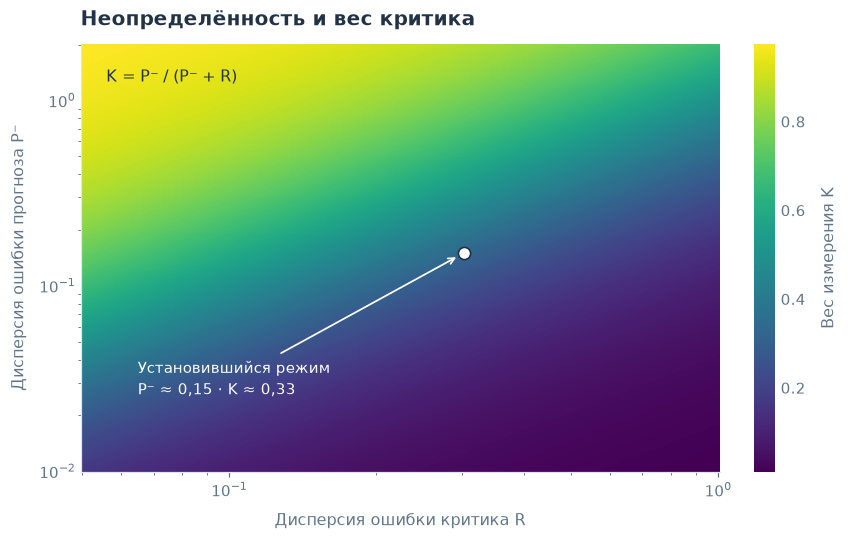
С повторением циклов влияние начальной настройки затухает, и приближается к стационарному значению. Для него
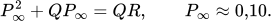
Это дисперсия после измерения. Перед следующим измерением она снова вырастет примерно до  , поэтому установившийся вес критика — около трети.
Стандартное отклонение оценки получается около  балла при согласованной модели.
В сравнении раздела 3 досрочный стоп отключён. Позже, в конфигурации C раздела 5, будем проверять  и
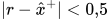 .
Там сначала выполняется очередная правка, затем по оценке, полученной до неё, решается, будут ли ещё раунды.
Финальное качество проверяем отдельно по истинному состоянию симулятора. Именно поэтому расчётный стоп и попадание в заданный коридор — разные показатели.
Для защиты от необычных отзывов в разделе 6 сравним модуль инновации с  . Там складываются дисперсии ошибки прогноза и ошибки измерения.
Более общий вывод и матричная запись есть в учебном отчёте Грега Уэлча и Гэри Бишопа, An Introduction to the Kalman Filter.
Здесь достаточно одного состояния и приведённых скалярных формул.
3. Что даёт сам фильтр Калмана? Сравним в одинаковых условиях
Самое интересное начинается тогда, когда работа уже приблизилась к своей цели.
Один отзыв требует немного дописать, следующий — убрать примерно столько же.
Агент исправно слушается, но часть этой суеты вызвана шумом критика и является лишней.
Фильтр Калмана позволяет смешать новый отзыв критика с прогнозом и бороться с этим шумом. Давайте проверим на практике, что же это меняет в работе всего цикла.
Поставим рядом два одинаковых P-регулятора: каждый исправляет 70% оценённого недобора до цели. Первый верит свежей оценке критика, второй — оценке фильтра Калмана.
Стартовые условия, цель, последовательности ошибок и правило правки одинаковы. Меняем только способ оценки текущего состояния, чтобы отдельно проверить вклад фильтра.
Проведём 200 пар прогонов по 30 раундов.
Первые десять правок были отведены на подход к окрестности конечной цели, а показатели были рассчитаны на шагах 10–29.
Что проверяем | Что измеряем в каждом прогоне |
|---|---|
Лучше ли агент понимает, где находится | Ошибку оценки: свежего отзыва без фильтра или оценки Калмана — относительно истинного состояния |
Лучше ли получается сам артефакт | Отклонение истинного состояния от цели 10 |
Меньше ли агент переписывает | Средний модуль фактически применённой правки |
Для первых двух строк далее использую RMSE: это среднеквадратическое отклонение. Результат снова измеряем в баллах, а большие промахи получают больший вес.
Третья строка здесь измеряет активность правок; сама по себе маленькая правка ещё не означает хороший результат, поэтому смотрим на неё вместе с ошибкой артефакта.
Затем для каждого показателя возьмём медиану по 200 прогонам.
Но на рисунке оставим и все отдельные результаты, чтобы медиана не скрыла разброс.
Три метрики, одинаковые шумы и точные условия опыта
В обоих режимах  ,
 ,
 .
Работает один критик.
Дисперсия ошибки исполнения , стандартное отклонение ошибки критика  , поэтому
 .
Нет задержки, постоянной потери качества, выбросов, смещения критика и досрочной остановки. Начальная настройка фильтра та же, что в предыдущем подразделе:
 ,
 .
Пусть  без фильтра и
 с фильтром.
Для каждого прогона считаем
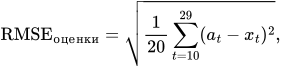
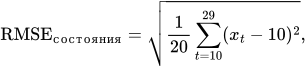
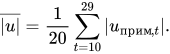
Здесь — состояние после правок, до текущего измерения;  — следующая применённая правка.
Чтобы проверить условия парного опыта, восстанавливаем шумы из сохранённых траекторий:
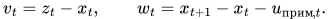
Во всех 200 парах обе последовательности совпадают с точностью до округления при вычитании чисел с плавающей точкой; проверка использует допуск  .
Один и тот же начальный seed сам по себе этого не гарантирует, если разные ветки программы по-разному расходуют случайные числа.
Медианы считаем после расчёта метрик каждого прогона. Процент снижения в таблице ниже показывает относительное уменьшение этих медиан.
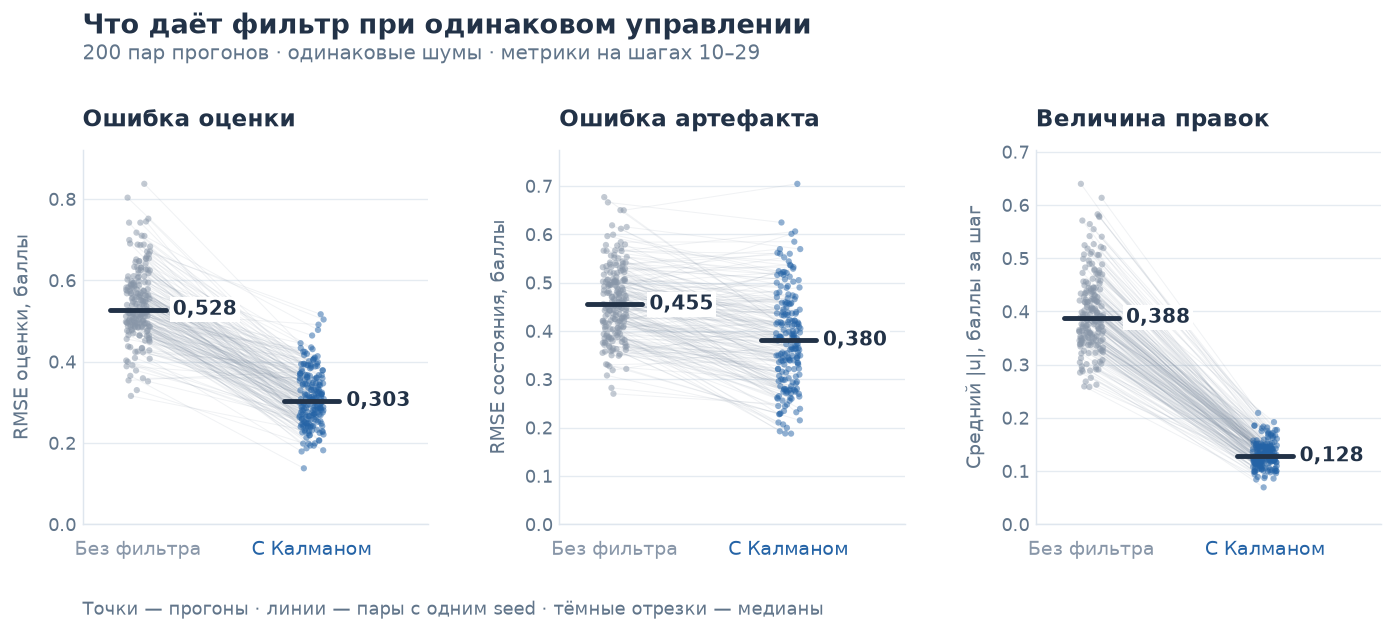
Показатель: медиана по 200 прогонам | Без фильтра | С Калманом | Снижение медианы |
|---|---|---|---|
RMSE оценки, баллы | 0,528 | 0,303 | 42,5% |
RMSE состояния относительно цели, баллы | 0,455 | 0,380 | 16,4% |
Средний модуль правки, баллы за шаг | 0,388 | 0,128 | 67,0% |
Фильтр заметно улучшил оценку, но в самом артефакте выигрыш скромнее. Средний модуль правки сократился примерно втрое: цикл слабее реагировал на шум свежего отзыва.
По парным результатам на рис. 3 ошибка состояния уменьшилась в 168 из 200 пар (84%), а в остальных 32 выросла.
Здесь мы измеряли ошибки и величину правок при одинаковом числе раундов. Токены и вычислительные затраты в этой модели не учитывались, поэтому трёхкратное уменьшение правки нельзя переводить в трёхкратную экономию ресурсов.
Результат относится к заданным шумам и конкретной модели исполнения. Интервалы для снижения трёх показателей таблицы собраны после раздела 5.
4. Почему одного фильтра недостаточно
В парном опыте я заранее закрепил цель, выбрал правило правки и дал обоим контурам одинаковое время. Теперь надо посмотреть на все эти решения по отдельности.
Дело в том, что даже точная оценка состояния не может определить, куда идти, как сильно править и когда закончить. Ниже проверю три распространённых упрощения: фиксированное число попыток, цель из последних замечаний и усреднение нескольких критиков.
«Сделай три итерации и отдай»
Начнём с очень простого правила, которое легко запрограммировать: три раунда правок и готово.
Здесь заодно заменим пропорциональную правку фиксированной: прибавляем или убавляем по два балла в зависимости от знака невязки. Такое правило называют реле.
Убираем временно шум. Если начинать с нуля и прибавлять по два балла, получится
0 → 2 → 4 → 6.
Цель — десять, но цикл уже закончен. Таймер ограничивает затраты, но сам по себе не проверяет, выполнена ли задача.
При выбранном старте трёх правок не хватит.
Дрейф цели
Представьте себе лендинг. Сначала требовалось кратко объяснить продукт.
После первого ревью добавили подробности.
После второго добавили больше эмоциональности.
После третьего ревью добавили ещё один призыв к действию.
В итоге каждая правка отвечает последнему замечанию, но исходная просьба о краткости уже потерялась. Такое часто происходит, когда итеративно что-то улучшаешь через ИИ.
В модели позволим цели понемногу сдвигаться в случайную сторону каждый раунд. Даже если агент хорошо следует за текущей целью, это не гарантирует близости к исходной цели.
При этом случайные сдвиги не обязаны всё время идти в одну сторону: отдельная траектория может вернуться назад, но разброс возможных целей со временем растёт.
Проверим это отдельно: вернём уже знакомый P-регулятор с усилением 0,7 и фильтр Калмана, дадим им 30 раундов без ранней остановки.
Между двумя режимами изменим только поведение цели — закреплённая или блуждающая.
Ошибку посчитаем относительно исходного заказа, чтобы не перепутать следование за новой целью с выполнением старой.
Почему разброс блуждающей цели растёт как корень из времени
Пусть каждый шаг добавляет независимый сдвиг с нулевым средним:

За  шагов складываются таких сдвигов. Их дисперсии складываются, поэтому стандартное отклонение итогового ухода равно
 . Для нормальной величины медиана её модуля составляет примерно
 стандартного отклонения:
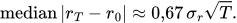
В опыте  . За 30 шагов получаем прогноз масштаба ухода цели:
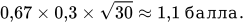
Это расчёт для самой цели. Ошибка конечного артефакта дополнительно зависит от того, насколько точно контур за ней следовал.
Рой ИИ-агентов: согласие критиков ещё не означает точность
Теперь попробуем улучшить измерение: спросим пятерых критиков и усредним ответы.
Если один завысил оценку, а другой занизил, ошибки частично сократятся. Но представьте себе, что артефакт находится на восьми баллах, а все пятеро дружно ставят девять. Среднее тоже будет девять. Единодушие арифметику не исправило.
Возможная причина — общая часть ошибки.
Критики могут опираться на одни и те же признаки и вместе пропускать один недостаток. В нашем опыте это общий случайный шум: в одном раунде он тянет всех вверх, в другом — вниз. Постоянного завышения шкалы здесь пока нет.
Сравним два роя из пяти критиков: с независимыми ошибками и со скоррелированными.
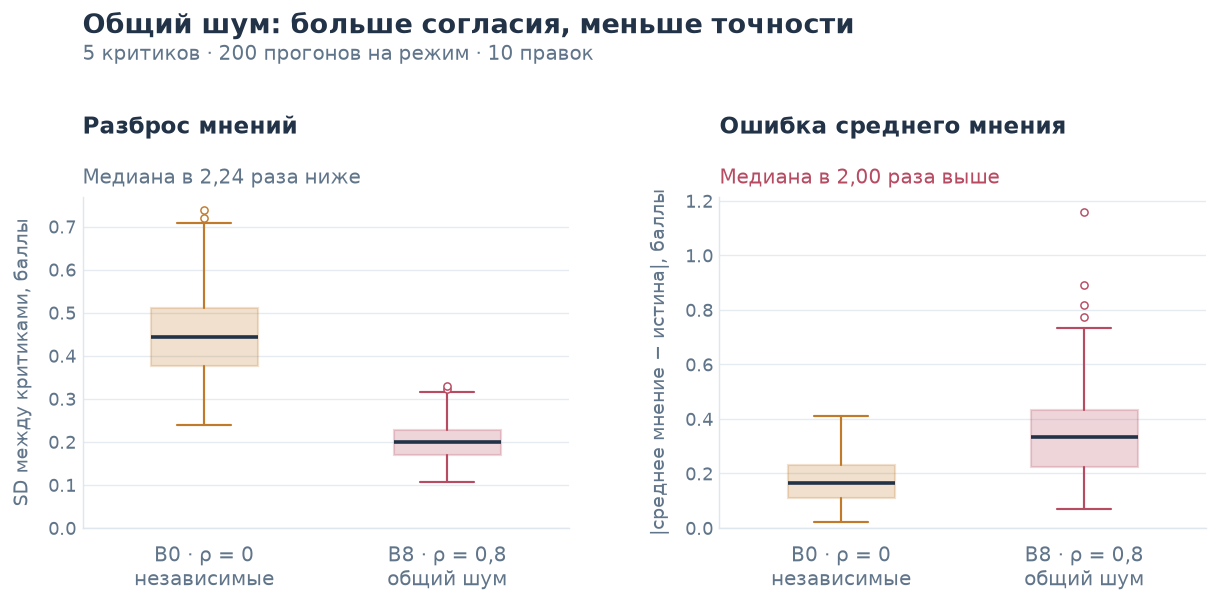
На рисунке сила связи (корреляция) обозначена буквой ρ: ноль соответствует независимым ошибкам, 0,8 — сильной общей части шума. Измерим отдельно разброс их мнений и ошибку среднего мнения относительно истины.
Первое говорит, насколько критики согласны; второе — насколько им можно верить.
Рисунок 4 показывает, почему эти показатели нельзя подменять друг другом.
Что усреднение убирает из независимого и общего шума
У каждого критика дисперсия ошибки  .
Если ошибки независимы друг от друга, то у среднего из  оценок дисперсия в раз меньше, а стандартное отклонение — в
 раз. Для пяти критиков это выигрыш примерно в 2,24 раза в единицах стандартного отклонения.
Введём одинаковую попарную корреляцию  . В нашей реализации она задаёт долю дисперсии, приходящуюся на общий для всех критиков шум. При усреднении остаётся
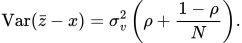
Независимая часть уменьшается с числом критиков; общая остаётся.
При  и
 усреднение сохраняет
 исходной дисперсии — большой прибавки точности ждать не приходится.
Одновременно разброс между критиками становится меньше: общий сдвиг не создаёт разногласий. При переходе от  к масштаб этого разброса сокращается в
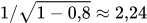 раза.
Итак, у нас три отдельных проверки:
хватило ли таймера,
сохранилась ли цель
стало ли среднее мнение точнее.
На анимации 1 — отдельные иллюстрации метаний, дрейфа и общей ошибки критиков. Затем посмотрим на количественные сравнения — по 200 прогонов на режим.
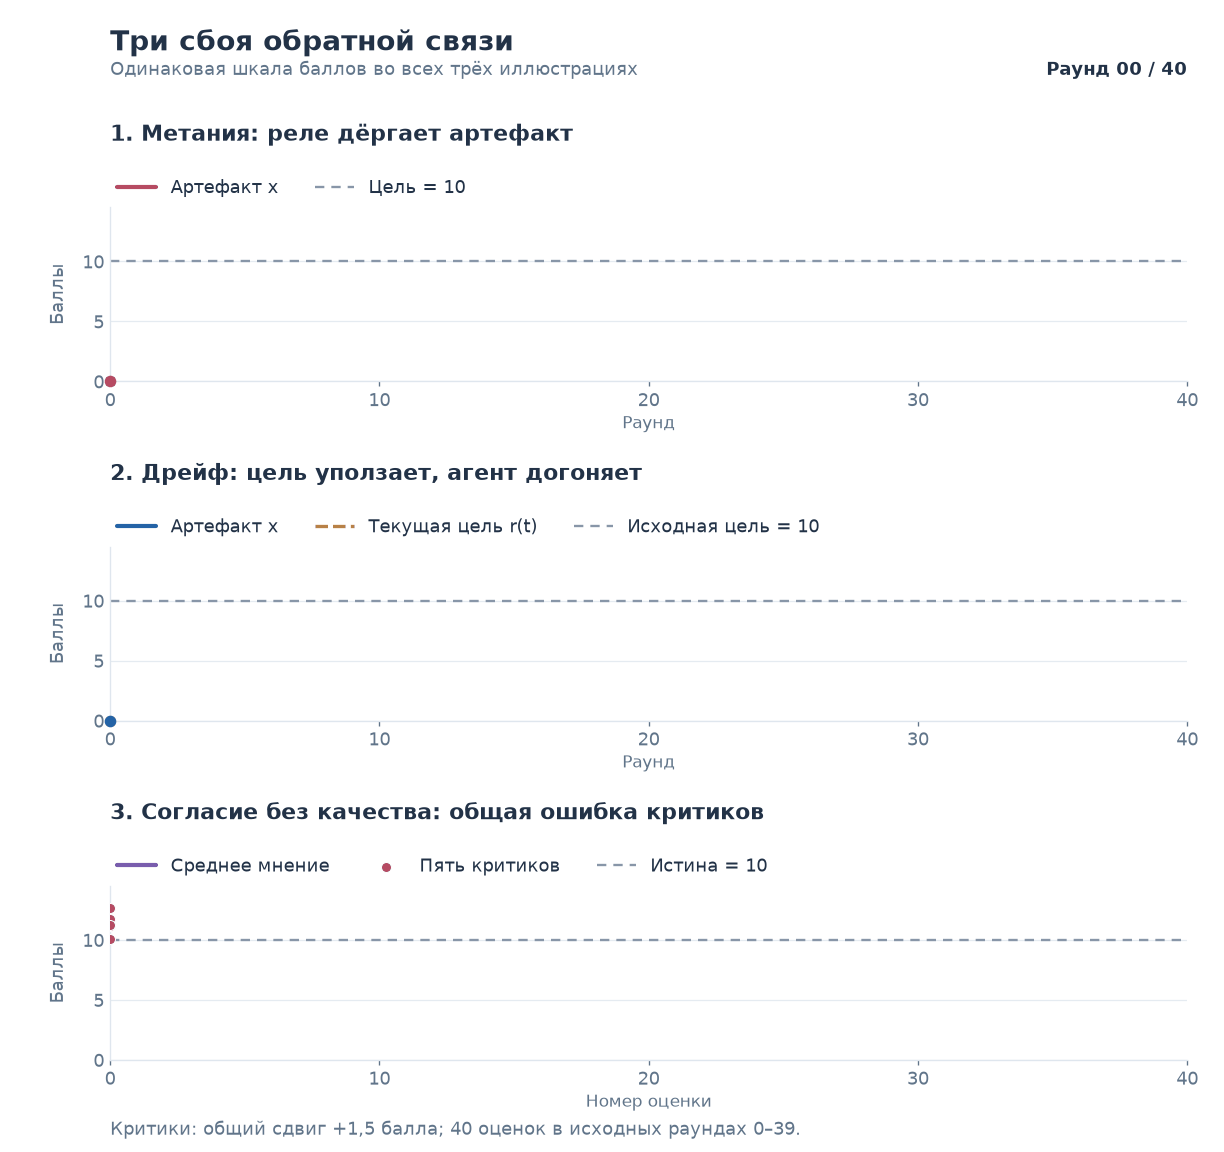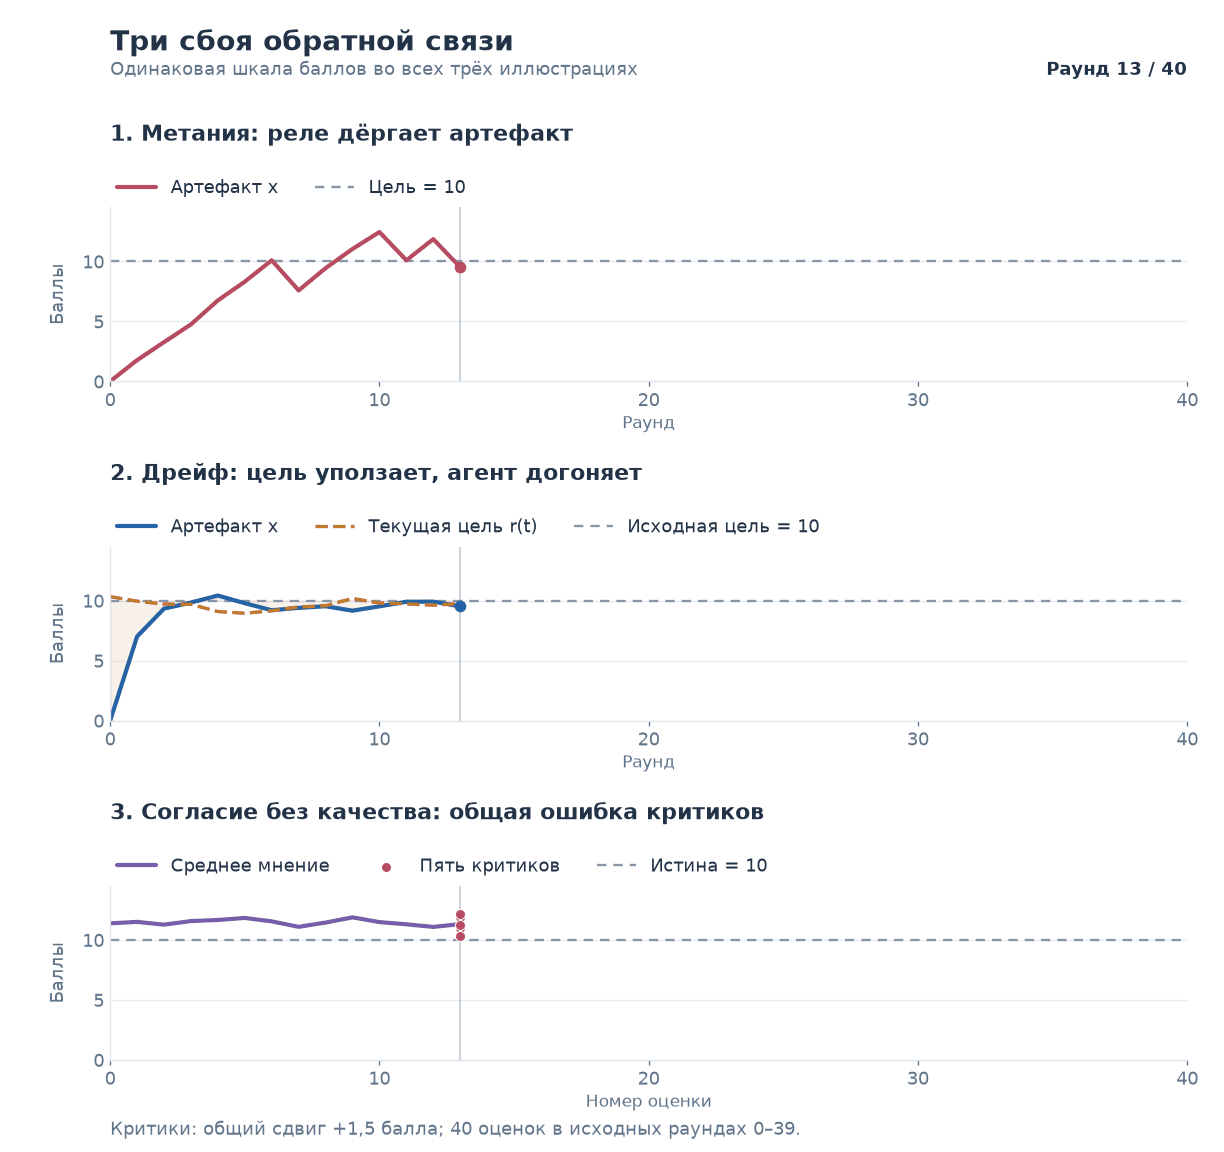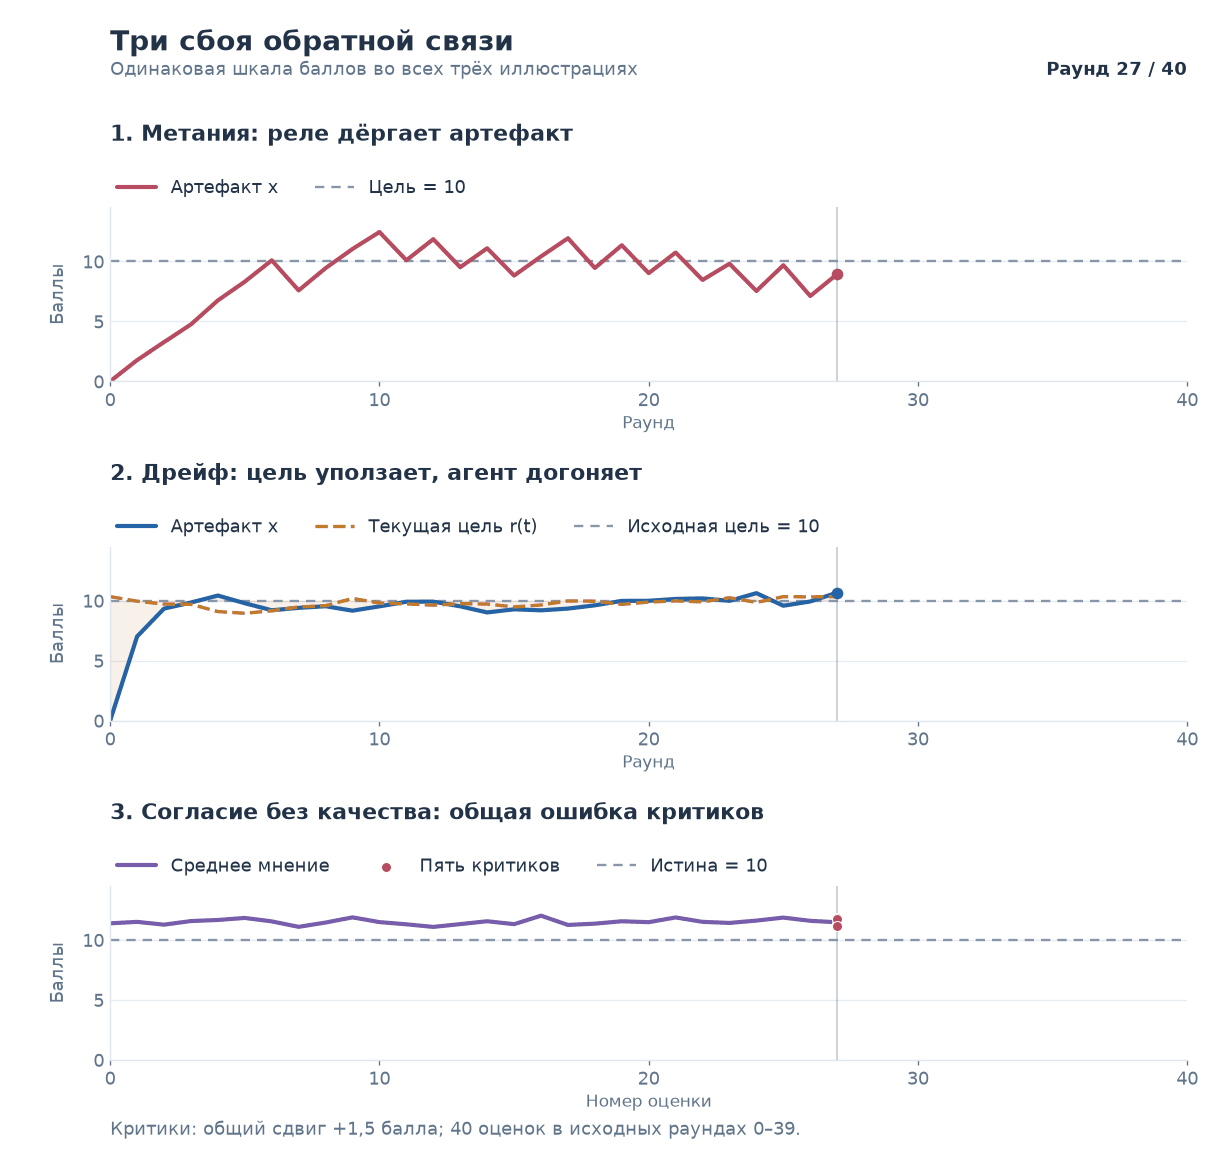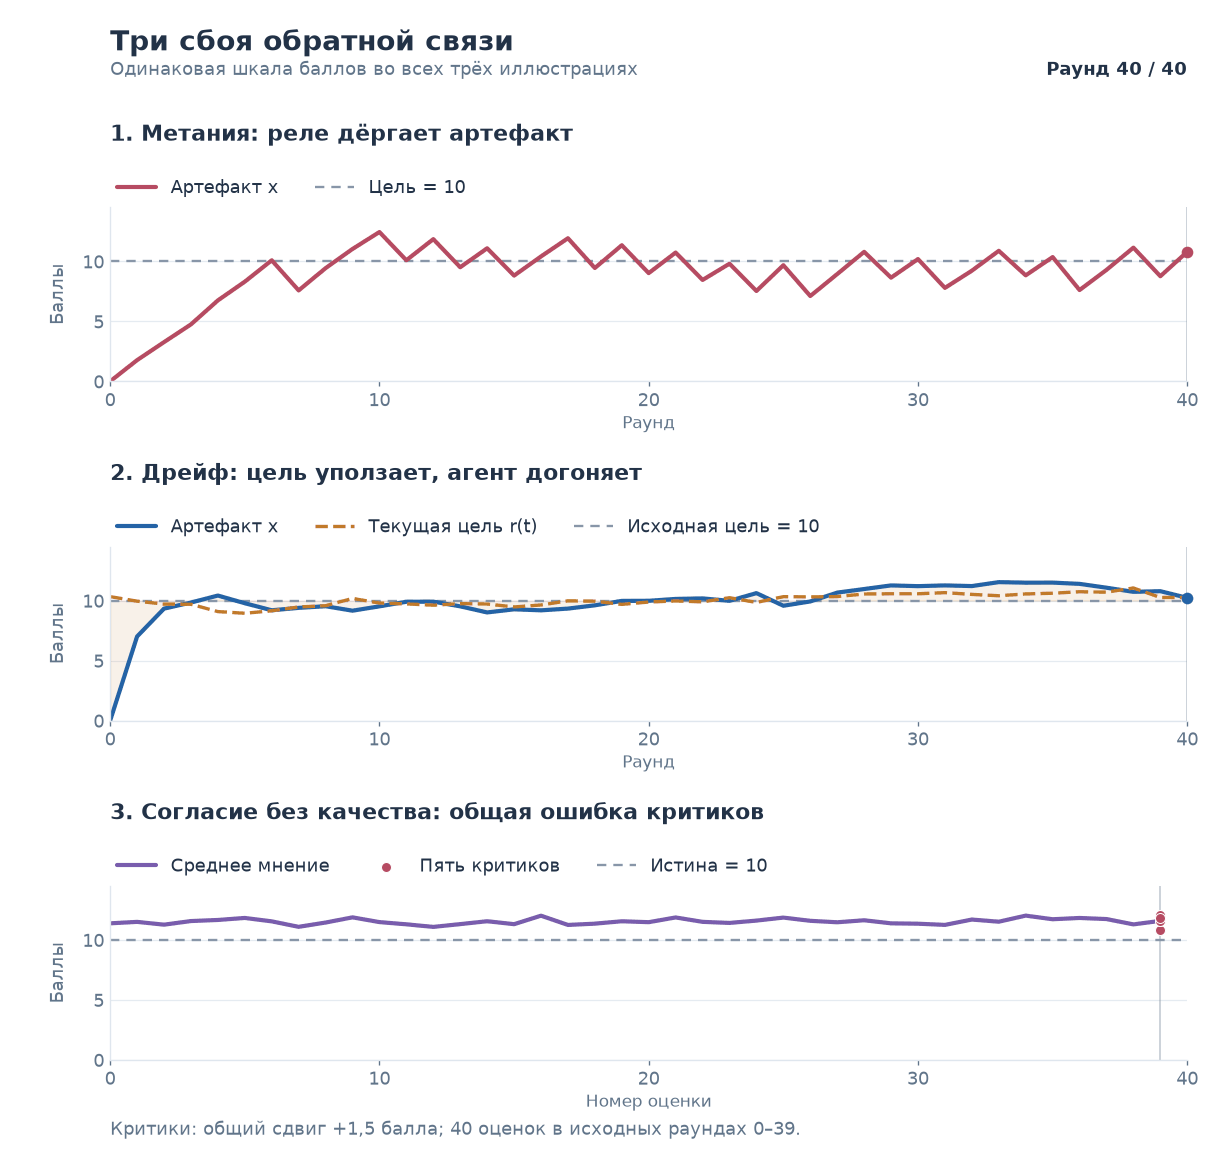
Что показали прогоны
Блуждающая цель увела от исходного заказа.
После 30 раундов медианная ошибка артефакта относительно первоначальной цели составила 1,1 балла, девяностый перцентиль — 2,66: около 90% результатов оказались ниже этого порога.
При закреплённом эталоне тот же контур дал медиану 0,29.
Здесь была измерена ошибка артефакта относительно исходной цели.
В рое ИИ-агентов стало больше согласия, но точность снизилась.
Сравнение двух режимов на рисунке 4:
Что измеряем | Независимые ошибки | Корреляция 0,8 |
|---|---|---|
разброс мнений между критиками | 0,44 | 0,20 |
ошибка среднего мнения относительно истины | 0,17 | 0,33 |
Для каждого прогона брали медиану по раундам после первых пяти, затем — медиану по 200 прогонам. Для ориентира: у одиночного критика с таким шумом медианная абсолютная ошибка одного измерения — около 0,37 балла.
Общий шум резко уменьшил пользу усреднения: медианная ошибка среднего выросла с 0,17 до 0,33 балла. При этом она осталась немного ниже ориентира для одиночного критика — около 0,37. Согласие критиков само по себе не подтверждает точность их оценки.
5. Четыре конфигурации на полигоне: фильтр, правка и остановка
Сравниваем результаты
Давайте проверим две вещи: насколько близко цикл попал к цели и сколько правок ИИ-агентов он на это потратил.
На стенде у всех одинаковый старт — ноль, цель — отметка 10.
В базовой модели нет постоянных потерь и ограничений правки.
Каждую конфигурацию запускаем 200 раз.
На каждой итерации цикла изменялись случайный шум критика и исполнения, а правила работы оставались одними и теми же.
Конфигурация | Как правит | Как оценивает | Когда заканчивает |
|---|---|---|---|
A. Таймер | по два балла в нужную сторону | один критик | после трёх правок |
B0. Независимый рой | так же, как A | среднее пяти независимых критиков | после 9, 10 или 11 правок |
B8. Похожий рой | так же, как A | среднее пяти критиков с общей частью шума | после 9, 10 или 11 правок |
C. Наблюдатель | исправляет 70% оценённой ошибки | один критик и фильтр Калмана | когда оценка близка к цели и достаточно определённа; не позднее 30 правок |
Для каждого роя были проверены три соседних срока остановки.
Между ними изменялся только таймер.
Финальная ошибка — расстояние между полученным результатом и десяткой.
Ошибку больше одного балла считаем провалом; отдельно посмотрим на более строгий коридор ±0,5.
Усилие — весь объём правок: шаг на два балла вперёд и два назад стоит четыре балла усилия, даже если в итоге мы остались на месте.
Контур C использует тот же фильтр и правило 70%, что в парном опыте, но теперь может закончить работу раньше.
Для остановки проверяем две вещи: оценка близка к цели, а её расчётная неопределённость достаточно мала. Порядок такой: получили оценку, выполнили рассчитанную по ней правку и решили, нужен ли ещё раунд.
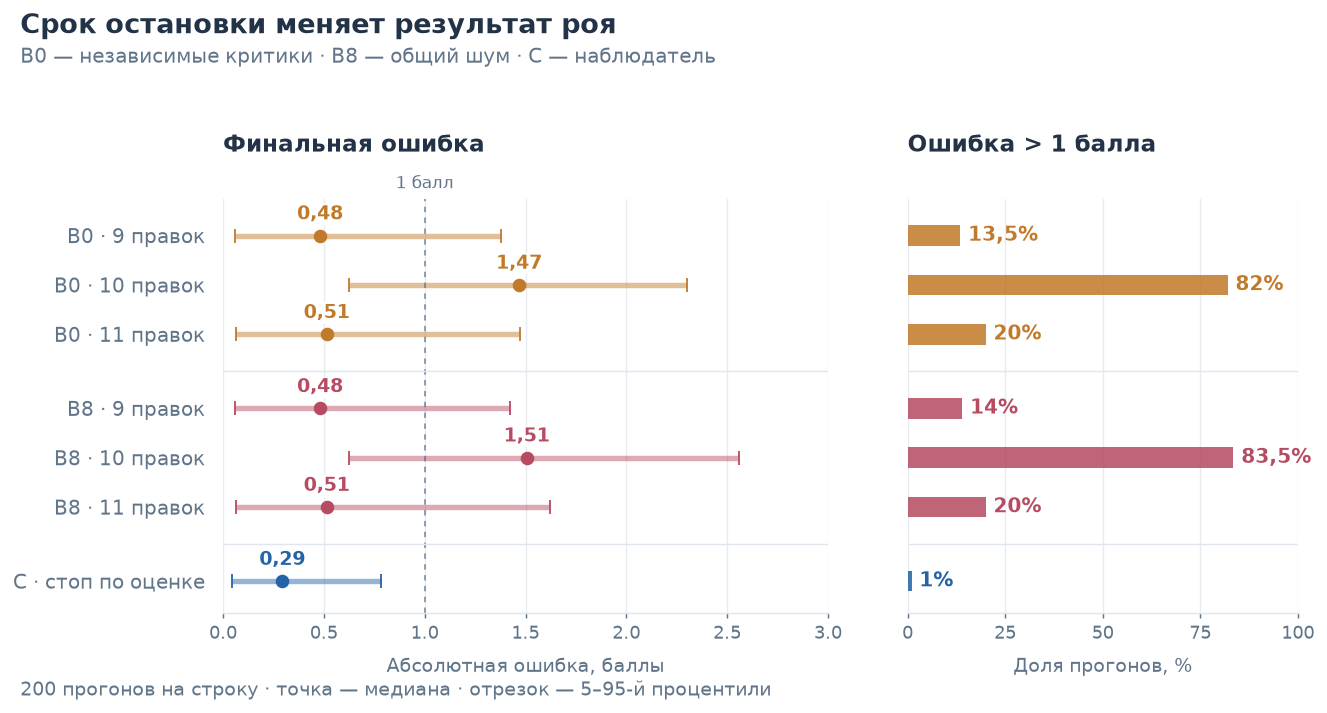
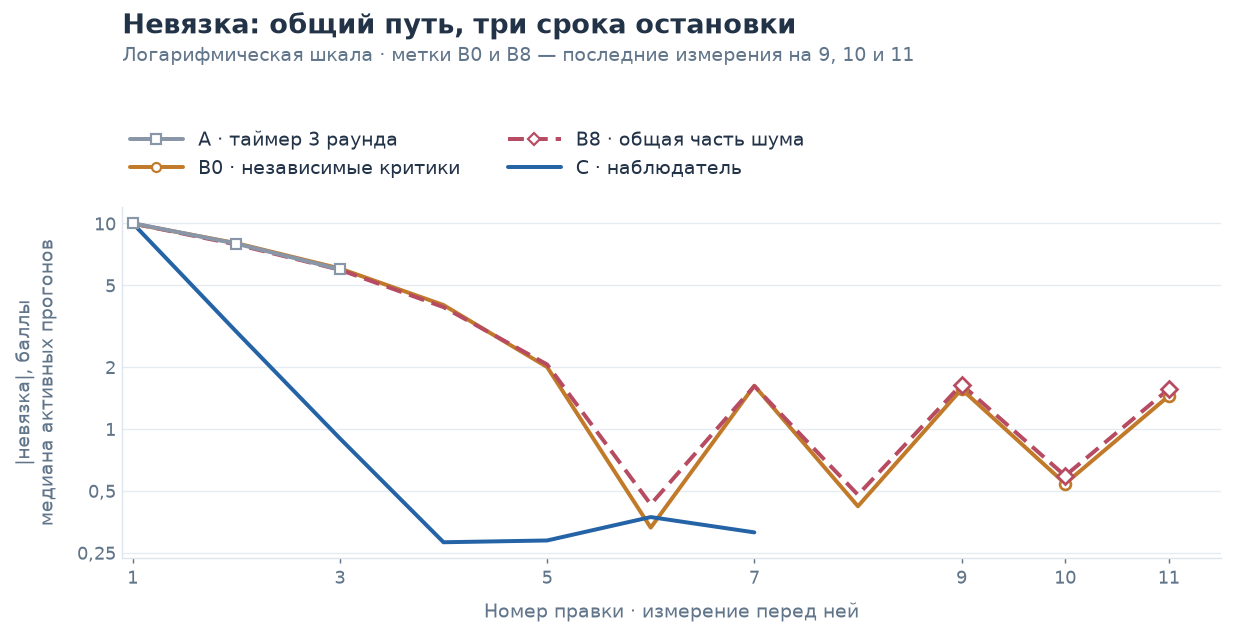
На рис. 5 сравним все три срока остановки роя с контуром C: слева — типичную ошибку и разброс результатов, справа — долю провалов. На рис. 6 увидим невязку, по которой цикл выбирает действие, и отметим последние измерения перед каждой из трёх остановок.
Все пять метрик и условия сравнения
Здесь собраны определения для сверки с кодом и полной таблицей ниже.
Метрика | Что считает код |
|---|---|
|
|
| среднее |
| число смен знака невязки после скользящего усреднения по трём точкам |
|
|
| число выполненных правок до первого состояния, начиная с которого |
 : абсолютная ошибка финального состояния
 после первых пяти раундов; после остановки архивный хвост заполнен истинной финальной ошибкой
 : сумма модулей фактически применённых правок
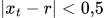 до конца прогона; поиск с начала
flips считает смены знака невязки после её скользящего усреднения по трём точкам.
mean_abs_y включает замороженный участок после остановки.
Настройки B0 и B8: пять критиков, корреляция ошибок и .
В C используется . Стоп проверяет  и
 .
При наших шумах первое условие выполняется уже после первого измерения, поэтому время остановки фактически задаёт близость оценки к цели.
Числа в таблицах — медианы по 200 прогонам.
SD — стандартное отклонение ошибок между прогонами.
Доли провалов и попаданий рассчитаны по всем 200 прогонам.
Полная таблица метрик и точные определения
Конфигурация | Финал: медиана (SD) | Среднее |y| после прогрева | Смены знака сглаженной невязки | Усилие, баллы | Провалов, % | Остановка, правок | Строгий коридор ±0,5 |
|---|---|---|---|---|---|---|---|
A: таймер 3 раунда | 4.01 (0.37) | 4.01 | 0 | 6.0 | 100.0 | 3 | 0% |
B0: рой, ρ=0, 9 раундов | 0.48 (0.39) | 0.58 | 2 | 18.0 | 13.5 | 9 | 51.5% (с 9) |
B0: рой, ρ=0 | 1.47 (0.49) | 1.36 | 2 | 20.0 | 82.0 | 10 | 3.5% (с 10) |
B0: рой, ρ=0, 11 раундов | 0.51 (0.43) | 0.64 | 2 | 22.0 | 20.0 | 11 | 48.0% (с 11) |
B8: рой, ρ=0.8, 9 раундов | 0.48 (0.48) | 0.59 | 2 | 18.0 | 14.0 | 9 | 51.5% (с 9) |
B8: рой, ρ=0.8 | 1.51 (0.57) | 1.41 | 2 | 20.0 | 83.5 | 10 | 3.5% (с 10) |
B8: рой, ρ=0.8, 11 раундов | 0.51 (0.52) | 0.68 | 3 | 22.0 | 20.0 | 11 | 48.0% (с 11) |
C: наблюдатель | 0.29 (0.24) | 0.29 | 0 | 9.9 | 1.0 | 4 | 80.5% (с 3) |
SD — стандартное отклонение ошибок по прогонам.
Невязка сглаживается средним по трём точкам.
После остановки её архивный хвост — истинная ошибка; новых измерений критика там нет.
Строгий коридор означает  до конца, а провал — финальную ошибку больше 1.
В скобках в колонке коридора — медиана числа выполненных правок до входа среди вошедших прогонов.
Что показал полигон
Конфигурация | Правок до стопа | Финальная ошибка | Провалов, % | Объём правок |
|---|---|---|---|---|
Таймер A | 3 | 4,01 | 100 | 6 |
Рой B0 | 9 | 0,48 | 13,5 | 18 |
Рой B0 | 10 | 1,47 | 82 | 20 |
Рой B0 | 11 | 0,51 | 20 | 22 |
Рой B8 | 9 | 0,48 | 14 | 18 |
Рой B8 | 10 | 1,51 | 83,5 | 20 |
Рой B8 | 11 | 0,51 | 20 | 22 |
Контур C | 4 | 0,29 | 1 | 9,9 |
Таймер остановил работу по расписанию.
Три шага по два балла привели примерно к шести при цели десять. На этой дистанции ему не помогла бы более точная оценка: шагов просто не хватило.
Один лишний раунд может испортить результат.
После девяти правок оба роя заметно ближе к цели, чем после десяти; одиннадцатый снова уменьшает ошибку. Причина видна даже без шума исполнения: за десять полных шагов ±2 из нуля до отметки 10 вообще не добраться — ближайшие доступные состояния будут 8 и 12. После девяти или одиннадцати шагов десятка доступна.
Контур C дошёл и остановился с меньшим объёмом переписывания.
В 165 из 200 прогонов стоп наступил после четвёртой правки.
Ошибка больше балла осталась в двух прогонах; в строгий коридор ±0,5 попал 161 результат, то есть 80,5%.
При этом траектория не обязана быть монотонной: хотя бы один выход выше цели случился в 45% прогонов.
Выводы
В этой выборке из трёх проверенных сроков рою выгоднее закончить после девятой правки. Но и по сравнению с этим вариантом у C ниже медианная финальная ошибка и доля провалов, а объём правок меньше. Преимущество C по этим показателям сохранилось при всех трёх сроках.
В C одновременно изменились регулятор, обработка измерений и правило остановки. Поэтому здесь сравниваются конфигурации целиком. Отдельный вклад фильтра проверялся в парном опыте раздела 3, где остальные условия были одинаковыми.
Насколько точны проценты: интервалы по 200 прогонам
Проценты изменятся на другом наборе шумов. Эти приближённые 95% доверительные интервалы уточняют снижение метрик раздела 3 и доли провалов раздела 5.
Что дал сам фильтр (раздел 3).
Показатель | Снижение, % | 95% интервал, % |
|---|---|---|
RMSE оценки | 42,5 | 40,3–45,8 |
RMSE состояния | 16,4 | 13,8–20,7 |
Средний модуль правки | 67,0 | 66,1–67,8 |
Как часто цикл заканчивается провалом (раздел 5). Порог прежний: финальная ошибка больше балла.
Конфигурация | Провалов из 200 | Доля, % | 95% интервал, % |
|---|---|---|---|
Таймер A, 3 правки | 200 | 100,0 | 98,1–100,0 |
Рой B0, 9 правок | 27 | 13,5 | 9,4–18,9 |
Рой B0, 10 правок | 164 | 82,0 | 76,1–86,7 |
Рой B0, 11 правок | 40 | 20,0 | 15,0–26,1 |
Рой B8, 9 правок | 28 | 14,0 | 9,9–19,5 |
Рой B8, 10 правок | 167 | 83,5 | 77,7–88,0 |
Рой B8, 11 правок | 40 | 20,0 | 15,0–26,1 |
Контур C | 2 | 1,0 | 0,3–3,6 |
У C всего два провала: частоту столь редкого события по 200 прогонам трудно определить точно. Интервалы описывают неопределённость оценок; отрезки на рис. 5 — разброс отдельных прогонов.
Как посчитано.
Для фильтра использовался парный percentile bootstrap: 10 000 раз выбирались с возвращением 200 пар, не разрывая пары с одинаковыми шумами.
Каждый раз считалось прежнее снижение 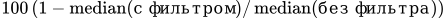 ; границы — процентили 2,5 и 97,5. Seed — 20261022, участок — 10–29.
Для долей провалов — двусторонний интервал Уилсона.
6. Что будет, если сломать допущения: добавим выбросы, задержки и смену шкалы
Теперь давайте по очереди испортим отзыв критика, момент применения правки и саму шкалу оценок. Оставим знакомые фильтр Калмана и P-регулятор с усилением 0,7.
Во всех опытах этого раздела остановка отключена: каждый прогон длится 30 раундов.
Иначе контур обычно закончил бы работу после четвёртой правки, и мы не увидели бы поздние сбои — например, смену шкалы на шаге 15.
Что происходит, когда один отзыв требует переписать почти всё
Представьте себе такую ситуацию: работа уже близка к цели, и вдруг критик ставит на четыре балла меньше ожидаемого. Регулятор видит большой недобор и готовит большую правку. Но что именно испортилось — сама работа или сам новый отзыв?
Обычный фильтр Калмана смягчает такой скачок, но всё же сдвигает оценку вслед за критиком. В нашем установившемся режиме он берёт примерно треть расхождения. Если измерение ошибочно упало на 4,4 балла, оценка сдвинется примерно на полтора — достаточно для того, чтобы агент начал чинить то, что не ломалось.
Давайте добавим перед обновлением оценки простую проверку. Сравним отзыв с прогнозом и спросим, насколько их расхождение необычно при знакомом нам шуме.
Напомню, что саму разность между измерением и прогнозом называют инновацией.
Слишком далёкую точку пока не используем: фильтр оставит прогноз без коррекции.
Такая проверка называется гейтом. Она позволяет переждать подозрительное измерение, не превращая его сразу в команду на переделку.
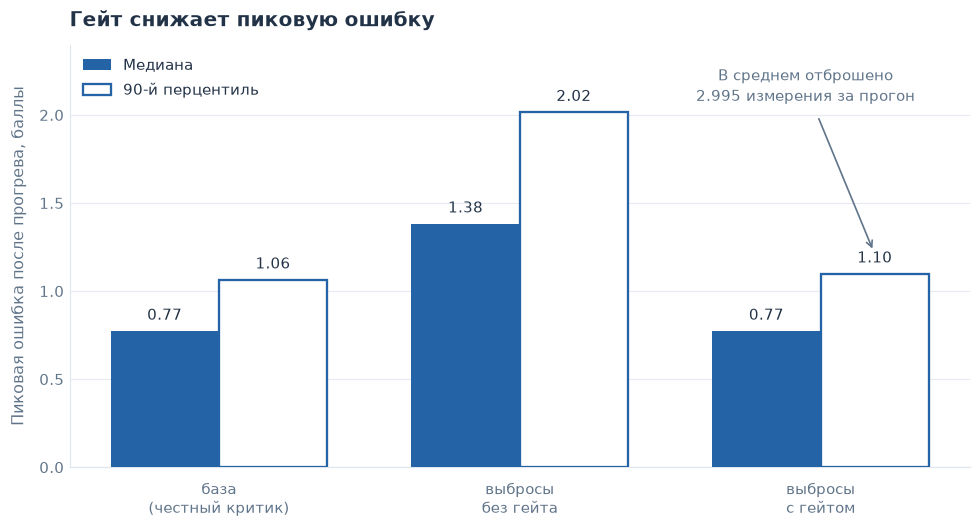
В опыте каждый отзыв независимо получал выброс с вероятностью 10%: к обычному шуму добавили сдвиг на 4,4 балла вверх или вниз. Я сравнил три режима на 200 прогонах каждый. Для каждого прогона взял максимальную истинную ошибку после десятой правки и разброс качества в последних десяти состояниях.
В таблице собраны медианы этих величин; отдельно показан 90-й перцентиль пика ошибки.
Режим | Медиана пика ошибки | 90-й перцентиль пика | Медиана разброса в конце |
|---|---|---|---|
Без выбросов | 0,77 | 1,06 | 0,27 |
Выбросы, без гейта | 1,38 | 2,02 | 0,43 |
Выбросы, с гейтом | 0,77 | 1,10 | 0,27 |
Без защиты медианный пик вырос примерно в 1,8 раза, разброс в конце вырос в 1,6.
С гейтом значения вернулись близко к базовым: отдельный странный отзыв перестал так сильно раскачивать артефакт.
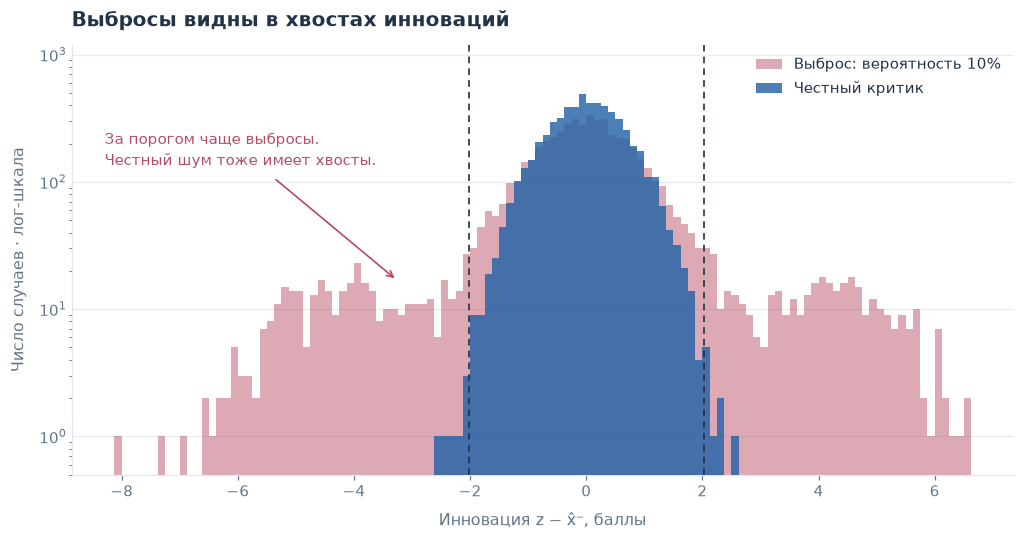
На рис. 7 видны хвосты распределения инноваций.
На рис. 8 показана разница между этими тремя режимами.
В среднем гейт отбросил 3,00 измерения за прогон при округлении до сотых. Это близко к ожидаемым трём выбросам за 30 раундов, но по одному совпавшему числу нельзя судить о качестве распознавания. Оказалось, что гейт иногда отвергает и нормальный отзыв критика.
Отказ приводит также к тому, что без свежего измерения оценка опирается только на прогноз, и вследствие этого её неопределённость растёт. Один пропуск переносится легко, но серия пропусков может значительно увеличить неопределенность оценки. Поэтому в рабочем процессе полезно сохранять отвергнутые отзывы для разбора и следить за сериями отказов.
Как часто появятся выбросы за несколько раундов
При независимой вероятности выброса  в каждом из раундов проще сначала посчитать шанс, что ни одного выброса не случится:
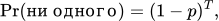
поэтому
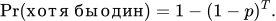
За тридцать раундов нашего опыта получаем
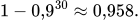
То есть хотя бы один выброс ожидается примерно в 96% прогонов.
Среднее число выбросов равно 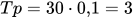 .
Откуда берётся порог гейта и почему он иногда отсекает честный шум
Используем инновацию — разность между новым измерением и прогнозом до коррекции:
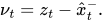
Если ошибки прогноза и текущего измерения независимы, их дисперсии складываются:
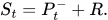
В рассматриваемой реализации измерение не используется для коррекции, когда

После прогрева  , , поэтому порог составляет около 2,0 балла.
Сдвиг на восемь стандартных отклонений шума критика — 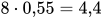 балла.
При пропуске коррекции дисперсия прогноза продолжает расти, так что фактический порог на следующем шаге тоже может увеличиться.
У обычного фильтра Калмана с согласованной гауссовой моделью нормированная инновация  имеет стандартное нормальное распределение.
Вероятность выйти за три стандартных отклонения составляет около 0,27% на одно измерение. Даже нормальный шум иногда пересекает этот порог.
После отбора по гейту распределение ошибки меняется, а наш простой фильтр этого изменения полностью не учитывает. Поэтому 0,27% — лишь приблизительный ориентир для выбора порога. Лучший выбор порога нужно проверять на отдельных прогонах без выбросов.
Задержка отклика: к чему это приводит
Предположим, до цели не хватает четырёх баллов.
При усилении 0,7 получаем прибавку 2,8. Но правка ещё не применена, а следующий отзыв уже пришёл: всё те же четыре балла недобора. Тогда агент заказывает ещё 2,8.
Обе правки исправляют одну и ту же старую проблему — вместе они добавят 5,6 вместо недостающих четырёх. Даже без всякого шума возникла проблема.
Такое случается, когда новые решения принимаются быстрее, чем прежние успевают изменить артефакт. Первая пачка правок наконец приходит, контур видит перелёт и отправляет пачку в обратную сторону. Чем длиннее очередь, тем сильнее запаздывает реакция. Такое случается в работе роя ИИ-агентов.
В тренировочном симуляторе ниже задержка означает вполне конкретную вещь: команда, выданная сейчас, применяется через заранее заданное число раундов.
Давайте сохраним усиление 0,7 и сравним четыре задержки, по 200 прогонов на каждую.
Рядом с результатами зададим расчётный ориентир для более простого случая: P-регулятор точно знает состояние, шума и фильтра нет.
Во втором столбце — верхняя граница усиления: при положительном коэффициенте ниже неё ошибка со временем затухает; на самой границе затухание исчезает.
Задержка, раундов | Граница усиления для чистого P-контура | Медианная финальная ошибка | Разброс: середина → конец |
|---|---|---|---|
0 | 2,00 | 0,29 | 0,26 → 0,27 |
1 | 1,00 | 0,40 | 0,88 → 0,40 |
2 | 0,62 | 31,89 | 12,6 → 19,8 |
3 | 0,45 | 31,17 | 25,6 → 63,6 |
Аналогично прошлым экспериментам разброс оцениваем через стандартное отклонение, а для оценки значения берем медиану по 200 прогонам.
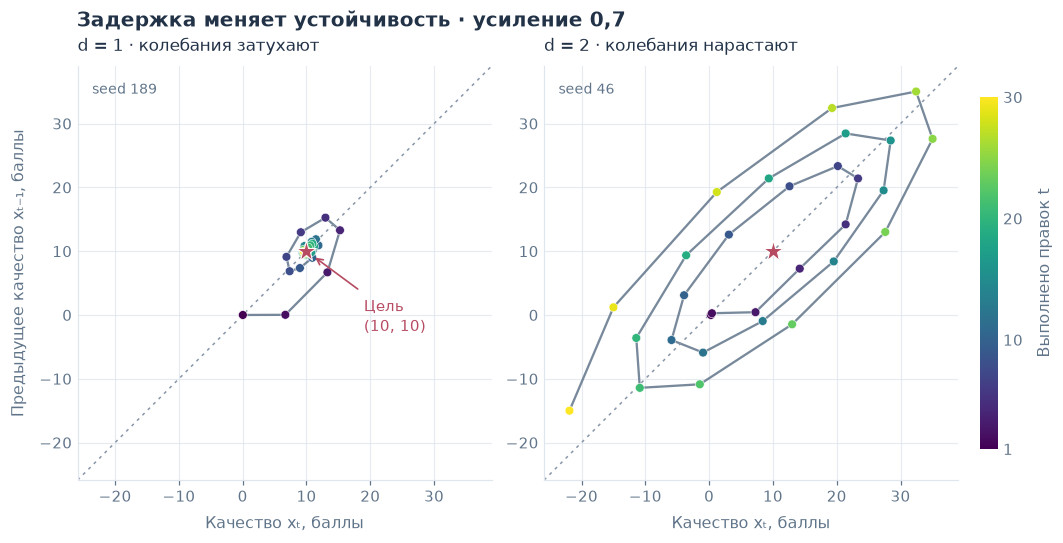
При задержке в один раунд колебания от середины к концу уменьшаются. При двух и трёх — растут, а финальная ошибка измеряется уже десятками баллов.
На рис. 9 это видно по паре соседних состояний: по одной оси отложено текущее качество, по другой — предыдущее. В показанном прогоне с задержкой в один раунд траектория стягивается к окрестности цели; с задержкой в два — раскручивается наружу.
Добавили очередь — заново проверьте усиление.
В симуляции при задержке в два раунда значение 0,7 оказалось слишком большим.
Можно уменьшить размер очередной правки или сократить задержку.
Можно дождаться результата уже выданной команды перед новым решением.
Это изменяет темп работы, зато не позволяет нескольким правкам независимо исправлять один и тот же недобор.
Почему задержка уменьшает допустимое усиление: вывод через корни уравнения
Для расчётов уберём шум и наблюдателя, оставим постоянную цель и чистый P-регулятор. Обозначим истинную ошибку через  . Команда, выданная
 шагов назад, равна
 и применяется сейчас. Тогда
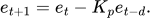
Ищем решение в виде  . Получаем характеристический многочлен
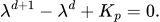
Колебания затухают, если все его корни лежат внутри единичного круга: тогда степени каждого корня со временем уменьшаются. При малом положительном это условие выполняется. Найдём границу, на которой корень впервые выходит на единичную окружность.
Подставим  и перенесём члены:
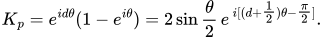
Усиление должно быть положительным вещественным числом.
Для первого пересечения аргумент справа равен нулю:
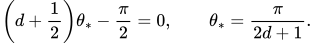
По модулю получаем границу
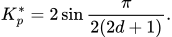
Следовательно, область асимптотической устойчивости этого линейного уравнения —
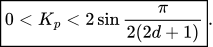
При  получаем условие
 для контура без задержки. Для задержек
 ,
 и
 верхние границы равны соответственно
 ,
 и
 . При больших задержках можно использовать
 :
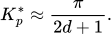
Отсюда почти обратная зависимость допустимого усиления от задержки.
Равенство на границе не даёт затухания, поэтому запас имеет практический смысл.
Критик стал добрее, а работа — хуже
Представьте себе, что критика заменили на более дружелюбного.
Тот же артефакт без единой правки получает на три балла больше. Нам приятно, но регулятор видит перелёт относительно цели и начинает уменьшать качество.
Регулятор принимает завышенную оценку за реальное превышение цели и заказывает ненужные правки вниз.
Введем в симуляции такую прибавку, начиная с шага 15.
Наблюдатель поднимает оценку состояния, регулятор правит артефакт вниз, и спустя несколько раундов показания снова оказываются около десяти.
Истинное качество при этом находится около семи.
Медианная финальная ошибка — 3,00 балла.
Фильтр объясняет новые отзывы доступным ему способом — изменением состояния.
В модели фильтра нет переменной, описывающей сдвиг шкалы критика. Поэтому наблюдатель приписывает этот сдвиг изменению артефакта, а регулятор на основании смещённой оценки вносит ненужные правки.
После адаптации расхождения между прогнозом и измерениями снова выглядят обычными, хотя оценка и истина теперь разделены примерно тремя баллами.
При этом одного этого потока отзывов критика явно недостаточно, чтобы уверенно отличать смену шкалы от реального изменения артефакта.
Замечаем смену режима, пока фильтр к ней не привык
Сразу после сдвига остаётся лишь короткая подсказка: несколько измерений подряд приходят выше прогноза. Чтобы решить проблему, нужно следить за такими сериями.
Одна высокая оценка может быть случайностью; три последовательных отклонения в одну сторону, достаточно большие в сумме, уже повод проверить, что же изменилось.
Добавим детектор, который записывает тревогу при такой серии.
Проверим его в 200 прогонах со сдвигом и отдельно в 200 прогонах без сдвига, чтобы узнать долю ложных сигналов.
Настройка детектора | Обнаружен сдвиг | Медианная задержка обнаружения | Ложные срабатывания без сдвига |
|---|---|---|---|
Основная | 95,5% | 2 раунда | 1% |
Более строгая | 94,5% | 2 раунда | 0% |
Основная настройка обнаружила сдвиг в 191 из 200 прогонов.
Более строгая пропустила ещё два случая, зато в контрольной выборке ложных тревог не было. Задержка в таблице посчитана среди прогонов, в которых сработал детектор.
В рабочем процессе такой сигнал можно использовать, чтобы приостановить автоправки и проверить рубрику на сохранённых артефактах или запросить независимую оценку.
По самой серии инноваций мы ещё не знаем причину: мог измениться критик, артефакт или точность нашей модели правок.
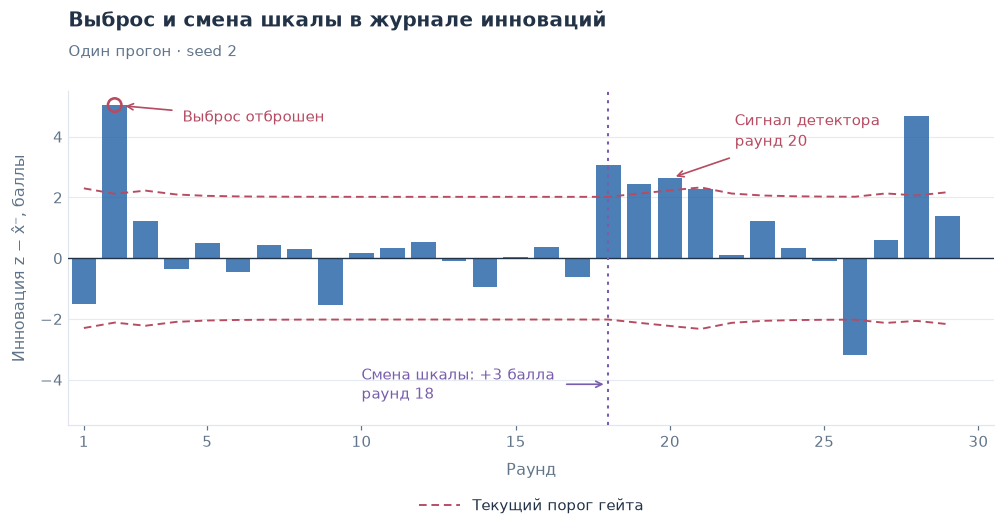
На рис. 10 показан отдельный прогон, где есть и одиночные выбросы, и сдвиг шкалы.
Здесь сдвиг введён на шаге 18 и включён гейт; это иллюстрация двух механизмов вместе, а не один из опытов таблицы. Ранний подозрительный замер гейт отбрасывает.
После смены шкалы появляется серия отклонений одного знака, и детектор подаёт сигнал.
Пунктир показывает текущий порог гейта: без коррекции неопределённость растёт, поэтому меняется и порог. Такая запись помогает выбрать, что проверять дальше, но сама по себе не исправляет шкалу критика.
Как устроены сдвиг шкалы и правило тревоги по трём инновациям
Измерение в опыте имеет вид
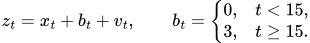
После приспособления к новой шкале оценка фильтра оказывается около  .
Поэтому регулятор, стремящийся удерживать оценку около цели , приводит истинное состояние примерно к  . Шум сохраняется, так что речь идёт об окрестности этого значения, а не о точном положении каждого прогона.
Для детектора использовались инновации до обновления фильтра:
Сигнал возникает, если последние три инновации имеют один строгий знак и одновременно
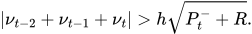
В основной настройке  , в более строгой —
 .
После прогрева 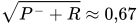 , поэтому основной порог для суммы трёх инноваций составляет около четырёх баллов. Проверка знака требует, чтобы все три значения были положительными либо все три отрицательными.
В коде хранится момент первого сигнала. Детектор не добавляет в фильтр оценку смещения  , не исправляет измерения и не останавливает регулятор. Для этих действий требуется отдельное решение о том, что именно изменилось.
7. Рабочая инструкция: симптом → что проверить → что попробовать
Допустим, в журнале видно: агент уже отправил следующую правку, хотя предыдущая ещё не применена. Начинать со смены критика рано — сначала нужно разобрать очередь действий.
Если же правки применяются вовремя, но оценки внезапно выросли без изменений артефакта, проверять придётся саму шкалу критика.
Одинаковое внешнее «агент опять сделал хуже» может иметь разные причины.
Соберём вопросы из проделанных модельных экспериментов в одну таблицу.
Что наблюдаем | Что проверить | Что попробовать |
|---|---|---|
Раунды кончились, цель не достигнута | Стоп задан числом попыток или состоянием результата? | Добавить проверку качества, сохранив предел раундов как страховку |
Выполнены последние замечания, исходный заказ потерян | Кто и когда менял эталон? | Хранить исходный заказ отдельно; изменения требований версионировать |
Критики единодушны, реальный тест провален | Не пропускают ли они одну и ту же ошибку? | Проверить их на известных примерах; добавить другой канал проверки |
Агент дёргается между версиями | Не слишком ли велика правка возле цели? | Снизить усиление, уменьшать шаг вместе с ошибкой, проверить пользу наблюдателя |
Один отзыв вызывает резкий скачок | Насколько он расходится с прогнозом? | Проверить подозрительное измерение; при обоснованном пороге пропустить коррекцию |
Асинхронные правки раскачивают цикл | Какие действия уже применены, а какие ещё в очереди? | Сократить задержку или снизить усиление; учитывать применённые действия |
Оценка у цели, а работа плоха | Не сменились ли рубрика и шкала критика? | Приостановить автоправки, сверить оценки с независимым эталоном |
Для такого разбора нужно сохранять два сигнала.
Расстояние до цели по оценке объясняет, почему выбрана очередная правка.
Расхождение с прогнозом, сопоставленное с ожидаемым шумом, показывает, насколько свежий отзыв является неожиданным.
Как перенести это в работу с ИИ
Шпаргалка помогает найти причины метаний.
Теперь соберём из этих наблюдений рабочий порядок: что поручить ИИ, что проверить самим и кому разрешить следующую правку.
спорное впечатление → проверяемый вопрос → свидетельство → локальная правка.
Что может сделать пользователь без собственного оркестратора
Всё это можно сделать и в самом обычном чате с ИИ, без агентной среды. Для этого достаточно разделить проверку и переписывание.
Отправляем первый запрос:
Проверь инструкцию по исходным требованиям. Для каждого замечания укажи конкретное место, затруднение пользователя и способ проверить исправление. Отдели обнаруженную ошибку от предположения и вкусового пожелания. Если можешь выполнить команды, приложи результат проверки; если не можешь — прямо укажи, что ещё не проверено. Предложи минимальную правку; пока не переписывай весь текст.
Получили замечание про каталог — проверили его сами или передали исполнителю с доступом к окружению. Теперь можно дать второй запрос:
Возьми сохранённую версию V и исправь только подтверждённый пропуск рабочего каталога. Сохрани остальной текст и мой стиль. Покажи изменённый фрагмент как кандидат V+1. Проверь, что исходная ошибка устранена и инструкция по-прежнему соответствует исходному заказу. Укажи, какие проверки действительно выполнены, а какие ещё нужны. Если проверить запуск нельзя, не объявляй его успешным.
После проверки принимаем V+1 или оставляем V и разбираем неудачную правку.
Такой алгоритм сам по себе ещё не фильтр Калмана.
Здесь используется общий принцип обратной связи: отдельно задать цель, получить свидетельства о состоянии результата и выбрать следующее действие. Наблюдателя с количественной моделью изменения состояния и расчётом неопределённости пока нет. Такой порядок помогает проследить основания каждой правки; его влияние на качество и затраты нужно проверять отдельно.
Как распределить работу между ИИ-агентами или разными чатами с ИИ
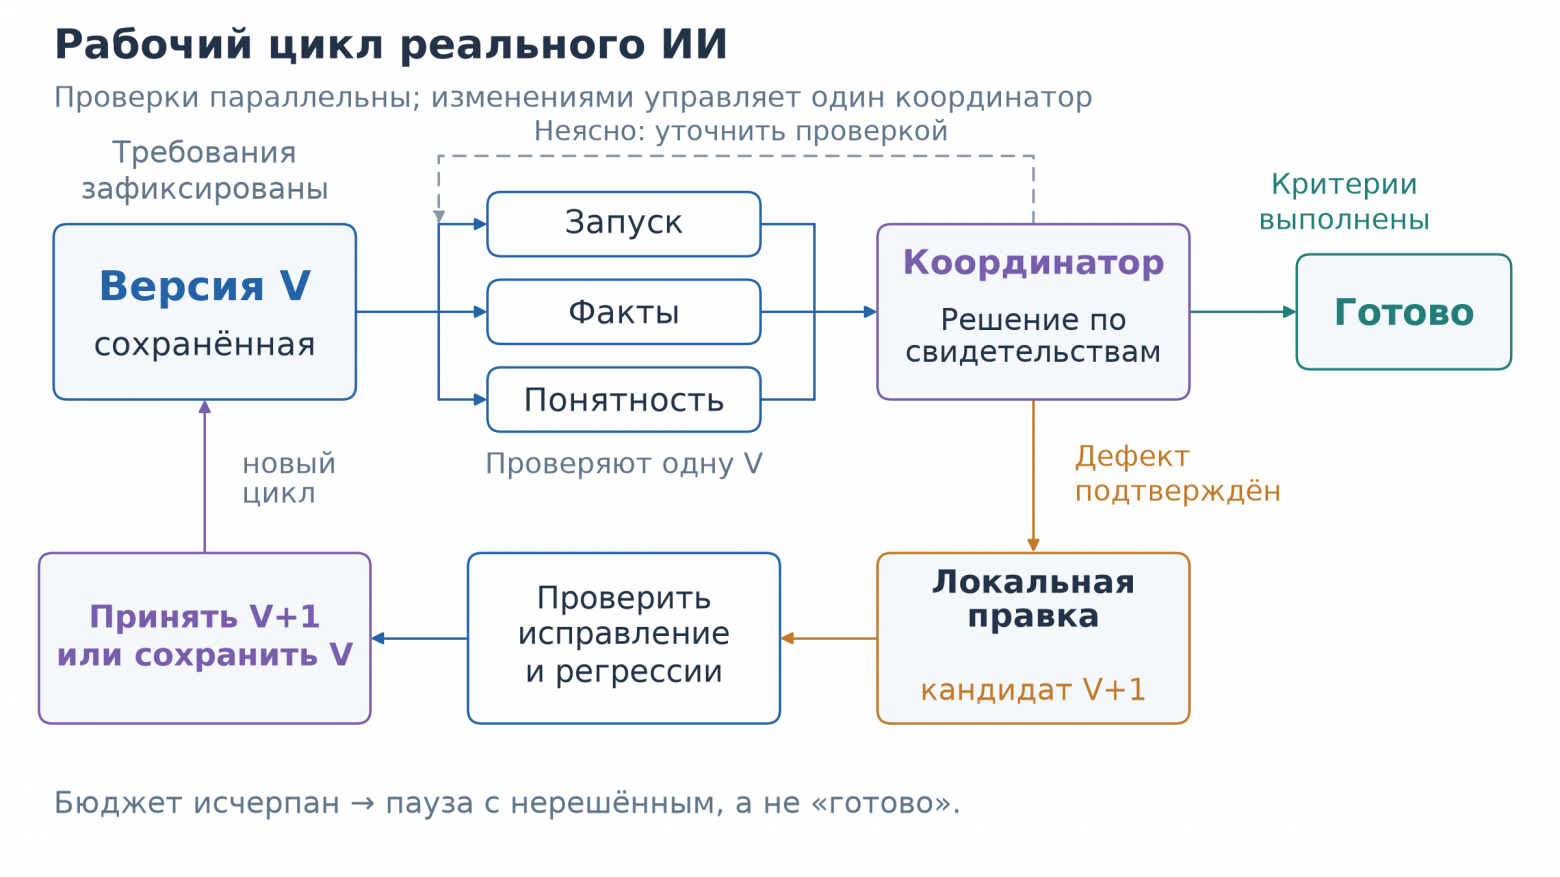
Ту же самую инструкцию можно проверять и параллельно. Важно выдать проверяющим одну и ту же версию V и исходный заказ, а каждому поручить определённый вопрос.
Роль | Что делает в нашем примере | Что возвращает |
|---|---|---|
Проверяющий запуск | Проходит команды в чистом заявленном окружении | Журнал выполнения и точное место сбоя |
Проверяющий факты | Сверяет зависимости, версии и параметры с проектом и документацией | Несоответствие и источник для проверки |
Редактор | Ищет непонятные новичку шаги | Конкретный пропуск или неоднозначность, отдельно — пожелания к стилю |
Автор | Исправляет подтверждённый дефект | Кандидат V+1 и список изменений |
Координатор | Сопоставляет свидетельства с заказом и организует повторную проверку | Принять версию, отклонить правку или проверить спорное место |
Оркестратором тут может быть сам человек, а проверкой запуска — обычный скрипт. Противоречащие друг другу изменения одного фрагмента требуют общего решения.
В отзыве должно быть указано, какую версию проверяли. Если замечание к V пришло после принятия V+1, сначала выясняем, сохранилась ли проблема. Иначе запоздалое замечание может вызвать уже ненужную правку.
Новый контекст и разные роли полезны для организации проверки, но не гарантируют независимости ошибок. Поэтому здесь рядом с отзывами стоит запуск команд: он проверяет конкретное свойство результата другим способом.
На схеме собран весь цикл. Неясное замечание ведёт к дополнительной проверке, подтверждённый дефект — к кандидату на исправление.
Успех здесь означает выполнение заданных критериев.
Как выбирать, если критериев несколько
Оркестратору нужно знать не только, что изменилось, но и какой компромисс допустим.
Это стоит закрепить до первых правок.
Сначала задаём обязательные условия: например, пройти функциональные проверки и уложиться в предел памяти. Затем выбираем, что улучшать среди допустимых вариантов.
Возьмём для наглядности три версии одной функции.
Числа условные: это пример выбора, а не результаты пилота с агентами.
Время и пиковая память относятся к одной и той же нагрузке и окружению; меньше — лучше.
Версия | Функциональные проверки | Время выполнения | Пиковая память |
|---|---|---|---|
А | Пройдены | 90 мс | 80 МБ |
Б | Пройдены | 75 мс | 150 МБ |
В | Найдена ошибка | 50 мс | 60 МБ |
При лимите памяти 100 МБ из этих трёх вариантов остаётся А.
Б выходит за лимит, В отбрасываем из-за ошибки.
Если ограничения памяти нет, А и Б представляют разные компромиссы: А экономнее, Б быстрее. Ни одна из них не лучше другой сразу по обоим показателям.
Так приходим к отбору по Парето: среди допустимых вариантов оставляем те, для которых нет другого, не хуже по всем выбранным критериям и лучше хотя бы по одному.
Конкретный пример такой постановки есть в руководстве Optuna по многокритериальной оптимизации.
Нужен приоритет заказчика: скажем, минимальное время при заданном пределе памяти.
Можно задать взвешенную сумму критериев.
В реальных замерах к таблице добавляется неопределённость.
Разница в одну миллисекунду при заметном разбросе ещё не подтверждает улучшение.
Нужны повторные измерения в сопоставимых условиях и заранее выбранная величина полезного изменения. Калман может уточнить оценки, если для них подходит модель. Точность этих оценок проверяем отдельно от качества итоговой версии.
Сколько памяти допустимо отдать за ускорение, определяет сам заказчик.
Для журнала агентского цикла надо разделить четыре группы метрик:
Результат:
выполнены ли обязательные условия, как изменились время и память относительно исходной версии. При сравнении нескольких запусков — доля тех, где одновременно выполнены все условия успеха. Неудачные запуски остаются в знаменателе.
Решения цикла:
сколько принятых правок при отдельной перепроверке оказались ухудшением и сколько отклонённых действительно помогали. «Ухудшение» определяем по тем же ограничениям и приоритетам: дополнительная память сама по себе ещё не делает ускорение неудачным. Для такой оценки придётся сохранять и перепроверять также отклонённые кандидаты.
Оценщик:
насколько его оценка ускорения и расчётная неопределённость согласуются с отдельной длинной серией замеров. Перепроверка тоже шумит и не даёт точного знания истинного времени.
Цена процесса:
токены, деньги, время работы агентов и проверок, число попыток и откатов.
Итог реальной работы стоит проверять отдельно от измерений, по которым принимались правки: для функции — на отложенных входных данных и новой серии замеров.
Где здесь настоящий Калман
Если такие задачи повторяются, можно проверить, поможет ли нам наблюдатель, использующий количественные оценки, как это делается в фильтре Калмана.
Для Калмана сначала понадобится характеристика с осмысленной числовой шкалой, повторяемые измерения и проверяемая модель её изменения.
Что нужно подготовить для наблюдателя с количественными оценками
Определить состояние и измерение.
Какую величину хотим оценивать, в каких единицах и как получаем наблюдение?
Оценить шум измерения.
Повторные проверки неизменной версии дают сведения о случайном разбросе. Сверка с внешним ориентиром нужна, чтобы обнаружить общий сдвиг. Если объединяем несколько критиков, учитываем и совместные ошибки (скоррелированность критиков между собой).
Проверить прогноз после действия.
По истории похожих изменений строим прогноз, а на новых примерах проверяем, насколько он ошибается. Разброс остатков содержит и ошибку модели, и шум измерения.
Привязать состояние к версии.
Прогноз для V+1 строится от V с учётом выполненного изменения. Если кандидат отклонён, его измерение нельзя оставить в качестве оценки сохранённой V. Для возвращённой версии восстанавливаем соответствующую оценку; после смены требований или шкалы нужна новая проверка модели.
Проверить пользу на новых задачах.
Сравниваем качество результата и решения цикла, а не только гладкость оценок. Если обычные проверки решают задачу без наблюдателя с количественными оценками, усложнять цикл незачем.
Настройку делаем на одних задачах, проверку — на других, с повторными запусками. Устройство таких проверок отдельно разобрано в материале Anthropic об оценивании агентов.
Такой порядок делает решения агентского цикла проверяемыми: видно, на основании каких данных принята или отклонена правка. Помогает ли он улучшить результат и сократить расход токенов, нужно измерять. Отдельный вопрос — даёт ли дополнительный выигрыш фильтр Калмана. Ниже проверим это на конкретном пилоте оптимизации кода.
8. Реальный пилот: 720 ответов модели
Чтобы проверить эти идеи на реальных ответах языковой модели, я построил стенд оптимизации небольших Python-функций и провёл пилот с четырьмя правилами принятия правок. Работа шла с паузами; доступный учёт токенов приведён ниже.
Суть эксперимента в том, что ИИ-агент пытается ускорить небольшую Python-функцию, переписав ее код. Этот пример хорош тем, что можно легко задать числовые метрики качества. Тесты проверяют ответы, измеритель — время выполнения, отдельная проверка — расход памяти.
ИИ-агент исполнитель предлагает новую версию функции, критик разбирает изменение, оркестратор принимает правку или оставляет прежнюю.
Какие функции оптимизировались
В оценочной части стенда использовались шесть задач. Каждая была оформлена как небольшая Python-функция solve(data), которая получает данные и возвращает результат, не изменяя вход:
Скользящие суммы: вычислить сумму элементов каждого окна заданной ширины в списке.
Суммы расстояний: для каждого числа-запроса найти сумму абсолютных расстояний до всех элементов списка.
Покрытие интервалами: для каждой точки посчитать, сколько интервалов её содержат.
Частоты слов: подсчитать слова с нормализацией регистра и вернуть отсортированный результат.
Обработка событий: сопоставить события со счетами и вычислить суммы с учётом индивидуальных множителей.
Суммы прямоугольников: для каждого запроса найти сумму элементов заданной прямоугольной области матрицы.
Исходные реализации были корректными, но простыми и оставляли возможности для ускорения. Например, функция скользящих сумм заново складывала все элементы каждого окна, хотя соседние окна почти полностью совпадают. В задаче с прямоугольниками исходный код перебирал все ячейки каждой запрошенной области.
Что сравнивалось
В протоколе четыре режима:
Режим | Как принимается правка после обязательных проверок |
|---|---|
Обычный цикл | Координатор следует рекомендации критика по проверкам и текущим измерениям |
Фиксированный протокол | Решение задаёт статистическое правило по парным замерам |
Сглаживание | То же условие принятия, оценка уточняется с постоянным коэффициентом |
Калман | То же условие принятия, вес измерений рассчитывается по неопределённости |
Задачи, роли, проверки корректности, ограничения памяти и лимиты были одинаковы.
Здесь шумят замеры времени, а критик лишь рекомендует решение.
Калман уточняет оценку ускорения по пяти парным замерам одной и той же версии относительно принятой. Следующий кандидат оценивается заново.
Перенос оценки состояния и её неопределённости от одной LLM-правки к следующей здесь пока не проверяется. Параметры шума и начальный прогноз эффекта получают на отдельных калибровочных задачах.
В пилоте проверялось, помогает ли такой оценщик принимать полезные оптимизации и получать лучший итоговый код при тех же ограничениях. Исходники стенда, протокол и результаты завершённого запуска приложены в разделе «Материалы и воспроизведение». Там же доступен отдельный пакет для собственного эксперимента через API.
План пилота
Исполнитель и критик работали на одной языковой модели gpt-6.1-sol с настройкой рассуждений medium. Каждый ответ получался в отдельном свежем контексте.
Одна траектория состояла из шести последовательных попыток улучшения кода: шести ответов автора и шести ответов критика.
Всего получено 720 ответов модели:
144 ответа для калибровки на четырёх отдельных задачах;
576 ответов для оценки на шести перечисленных выше задачах.
Оценочная часть здесь — это 48 траекторий: 6 задач × 2 повтора × 4 режима, по 12 ответов в каждой.
Результаты
Пилот завершён полностью. Все 720 ответов учтены, итоговые аудиты пройдены, сохранность исходных данных и файлов подтверждена.
Успешной считалась траектория, в которой итоговый код отличался от исходного, проходил закрытые проверки, расходовал не более 110% исходной памяти и выполнялся как минимум на 10% быстрее исходной реализации.
Порог ускорения проверялся по точечной оценке итогового времени; это не утверждение о статистически доказанном ускорении минимум на 10%.
Режим | Успешные траектории | Медиана отношения времени итогового кода к исходному |
|---|---|---|
Обычный цикл | 12 из 12 | 0,028 |
Протокол | 12 из 12 | 0,029 |
Сглаживание | 12 из 12 | 0,032 |
Калман | 12 из 12 | 0,039 |
В последнем столбце меньше — лучше: например, 0,028 означает примерно 2,8% времени исходной реализации. Это медиана отношений времени на конкретных задачах пилота, а не обещание такого ускорения произвольного Python-кода.
По основному критерию все четыре режима достигли одинакового результата — 12 успешных траекторий из 12. У Калмана медиана отношения времени выше, чем у остальных режимов, но само по себе сравнение медиан не устанавливает устойчивого различия методов.
Ограничения выводов и возможности для расширения экспериментов
Выборка небольшая: шесть задач и два повтора. Простые исходные реализации оставляли широкие возможности для ускорения, и все режимы преодолели заданный порог успеха. Это потолок выбранного критерия, а не достижение максимально возможного качества кода.
В сравнениях «Калман − протокол» и «Калман − сглаживание» разность долей успеха равна нулю. Bootstrap-интервалы [0; 0] получились из-за одинаково успешных наблюдений: они не доказывают эквивалентность методов и не устраняют неопределённость за пределами этой выборки.
Проверялась конкретная реализация: фильтр уточнял оценку внутри пяти пар измерений одного кандидата. Перенос состояния между последовательными агентскими правками в этот опыт не входил.
Калибровка была смешанной: первые 132 ответа получены через Codex CLI 0.163.0-alpha.10.2. После отдельно одобренной смены клиента следующие 12 калибровочных и все 576 оценочных ответов получены через 0.163.0-alpha.11.2. Равенство встроенных инструкций этих версий не установлено, поэтому переносимость калибровки между ними остаётся ограничением опыта.
После 288 и 512 принятых ответов потребовались отдельно согласованные технические изменения проверки сетевых событий. Уже полученные ответы №289 и №513 восстановлены из исходных журналов без повторного обращения к модели, нового резерва или замены идентификатора запроса.
Были также две пользовательские паузы и изменение фоновой нагрузки после закрытия приложений. Паузы и ожидание согласований относятся к календарному времени опыта, а не к задержке модели; влияние фоновой нагрузки отдельно не измерялось.
По сохранённому учёту использовано 6 237 378 входных и 274 631 выходной токен. Фактически списанные кредиты и денежная стоимость неизвестны; работа оркестратора и аудитора в эти числа не входит.
Что это говорит о Калмане
Преимущество фильтра Калмана в этом пилоте не обнаружено.
Все четыре режима успешно оптимизировали выбранные функции, а дополнительная сложность калмановского оценщика не дала выигрыша по доле успешных траекторий.
Это разведочный результат для конкретных задач, модели и правил измерения.
Учебные примеры объясняют механизм работы наблюдателя, но его практическую пользу нужно устанавливать отдельными экспериментами.
Для следующей проверки потребуются новые задачи, на которых исходы лучше различаются между режимами, и заранее зафиксированный план сравнения.
9. Материалы и воспроизведение
Учебная симуляция
Чтобы повторить учебные опыты, откройте приложенный Jupyter-ноутбук, перезапустите ядро и выполните все ячейки сверху вниз. Внутри находятся и текст, и код, и результаты. Рисунки и анимации пересоздадутся; случайные последовательности закреплены seed’ами, поэтому численные результаты можно сверить.
Сводные таблицы и результаты парного сравнения сохраняются в results/, рисунки и GIF — в assets/. Ядро симулятора sim_core.py встроено целиком, остальные ячейки задают опыты и строят графики. Дополнительный разбор P, D и I находится в конце статьи; его ячейки тоже входят в полный запуск. Для правки отдельных настроек ниже собран паспорт учебной симуляции.
Архив завершённого пилота
Для проверки данных статьи опубликован архив результатов и исходников пилота на 720 ответов. В архиве находятся итоговый отчёт и графики, таблицы CSV и JSON, сохранённые измерения и версии кода 60 траекторий — 12 калибровочных и 48 оценочных, параметры калибровки, исходники стенда с промптами и обезличенные копии аудитов.
Описание протокола, результатов и ограничений компактного пилота доступно также отдельным текстовым файлом.
По сохранённым данным можно проверить опубликованные сводные показатели. Это архив уже проведённого исследования; приватных журналов CLI-сессий и учётных данных в нём нет. Для нового опыта используйте пакет запуска ниже.
Jupyter-ноутбук пересчитывает только численные опыты и не запускает агентов. Включённый в комплект учебной симуляции ранний шаблон пилота сохранён как исторический материал.
Запустить свой эксперимент с агентами
Для нового запуска подготовлен отдельный пакет сравнения четырёх режимов через OpenAI API. Внутри — исходные функции всех шести оценочных и четырёх калибровочных задач, промпты автора и критика, правила принятия правок, проверки, измеритель и построение отчёта. Пошаговые инструкции для Windows, Linux и WSL находятся в README.md.
Распакуйте архив целиком. На компьютере нужен Python 3.12+; рекомендуется 3.14. После установки зависимостей по инструкции можно посмотреть задачи и выполнить демонстрацию из корня пакета:
python -m pilotbench tasks
python -m pilotbench demo --out runs/demo
demo не обращается к модели и не требует ключа или Docker. Он использует искусственные ответы и измерения, чтобы показать работу цикла и отчёта; его графики не являются результатом реальной оптимизации.
Для настоящего опыта нужны Docker с Linux-контейнерами и Python 3.14 внутри контейнера, собственный ключ OpenAI API и доступная вашему API-проекту модель. В README.md приведены команды подготовки образа, выбора модели, задания тарифов и предела расходов, проверки конфигурации и запуска с явным флагом --allow-api.
Есть два заранее заданных профиля:
small— максимум 56 вызовов ролей: 8 калибровочных и 48 оценочных. Это техническая проба на вашей машине: по одному раунду на траекторию.full— максимум 720 вызовов ролей: 144 калибровочных и 576 оценочных. Оценочная часть содержит 48 траекторий: 6 задач × 2 повтора × 4 режима, по шесть раундов «автор — критик».
Это пределы плана, а не гарантированное число полученных ответов: бюджет, пауза или ошибка могут остановить опыт раньше. Каждый новый опыт начинает с собственной калибровки. Для перехода от small к full создайте отдельный запуск, заранее выбрав его план.
Прогресс сохраняется по ходу работы. Команда pause даёт текущей операции завершиться; перед отключением сети нужно дождаться состояния paused. Продолжение выполняется командой resume в том же окружении. Завершённые операции используются из сохранённых данных, а запрос с неопределённым исходом автоматически не повторяется. После полного завершения создаются HTML- и Markdown-отчёты, график и таблицы CSV/JSON.
Это новый эксперимент через API. Исходный пилот статьи выполнялся через Codex CLI; сохранённые ответы и калибровка того пилота в пакет запуска не подставляются. Совпадение встроенных инструкций клиентов и результатов не предполагается. Реальные API-вызовы оплачиваются через ваш API-проект; показываемая пакетом стоимость — оценка по введённым тарифам, а не подтверждённое списание провайдера. Малый профиль проверяет работоспособность стенда и сам по себе не даёт оснований для вывода о преимуществе Калмана.
Параметры учебной симуляции и где они заданы
Базовые шумы и цель находятся в начале ядра; настройки регуляторов и сценариев — в соответствующих ячейках экспериментов.
Параметр | Значение | Что означает |
|---|---|---|
10 | цель цикла | |
| 0,55; | стандартное отклонение и дисперсия шума критика |
| 0,05; | шум исполнения правки |
| 3 | предел действия только в опыте с PID |
0,7 | усиление основного P-регулятора, включая парное сравнение и контур C | |
Сравнение фильтра | 200 пар, 30 раундов, стоп отключён | совпадающие шумы в паре; отличается только наличие Калмана |
Стоп C | и | неопределённость и близость оценки к цели |
Гейт |
| пропуск коррекции по подозрительному измерению |
Детектор | три инновации одного знака; модуль суммы | сигнал о возможном изменении модели |
Выбросы E2a | вероятность 10% на раунд, сдвиг | искусственные ошибки критика |
Задержка E2b |
| число шагов ожидания применения правки |
Сдвиг E2c | +3 с | изменение шкалы критика |
Рой B0/B8 | пять критиков, или | независимые и коррелированные ошибки; между сроками меняется только таймер |
Горизонт | 30–40 раундов | длина опыта |
Повторения | seed’ы 0…199 | 200 прогонов на конфигурацию |

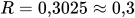


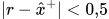
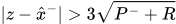
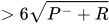


 , нумерация с нуля
 ; стоп после 9, 10 или 11 правок
После стопа состояние заморожено. Само решение принимается по оценке, полученной до последней уже выполненной правки; повторного измерения финального артефакта нет. В парном сравнении раздела 3 и опытах раздела 6 остановка отключена. На рис. 10 объединены выбросы, гейт и сдвиг с шага 18 — это отдельная иллюстрация, а не тот же режим, что в таблице E2c.
Окружение учебной симуляции и запуск скриптами
Для расчётов нужны Python 3.10+, numpy, matplotlib ≥ 3.9 и pillow. Для запуска ноутбука — Jupyter; приложенный исполнитель использует nbformat, nbclient и ipykernel. Анимации собираются через PillowWriter, без ffmpeg.
Эталонное окружение — Windows 11 x64 и Python 3.14.3. Точные версии всех зависимостей закреплены в requirements-lock.txt; команды чистой установки и полного запуска находятся в README.md. Исполнитель проверяет, какой Python действительно использует ядро, и сохраняет версии пакетов и время работы в проверка/execution_report.json.
Дополнительный разбор: P, D, I и защита от накопления ошибок
Дополнительный разбор: P, D и I
В основном опыте с Калманом мы использовали P-регулятор с усилением 0,7, без D- и I-звеньев и без постоянной потери. Теперь отдельно разберём само управление: почему полная правка раскачивает цикл, когда маленькой не хватает и что дают ещё две ручки настройки.
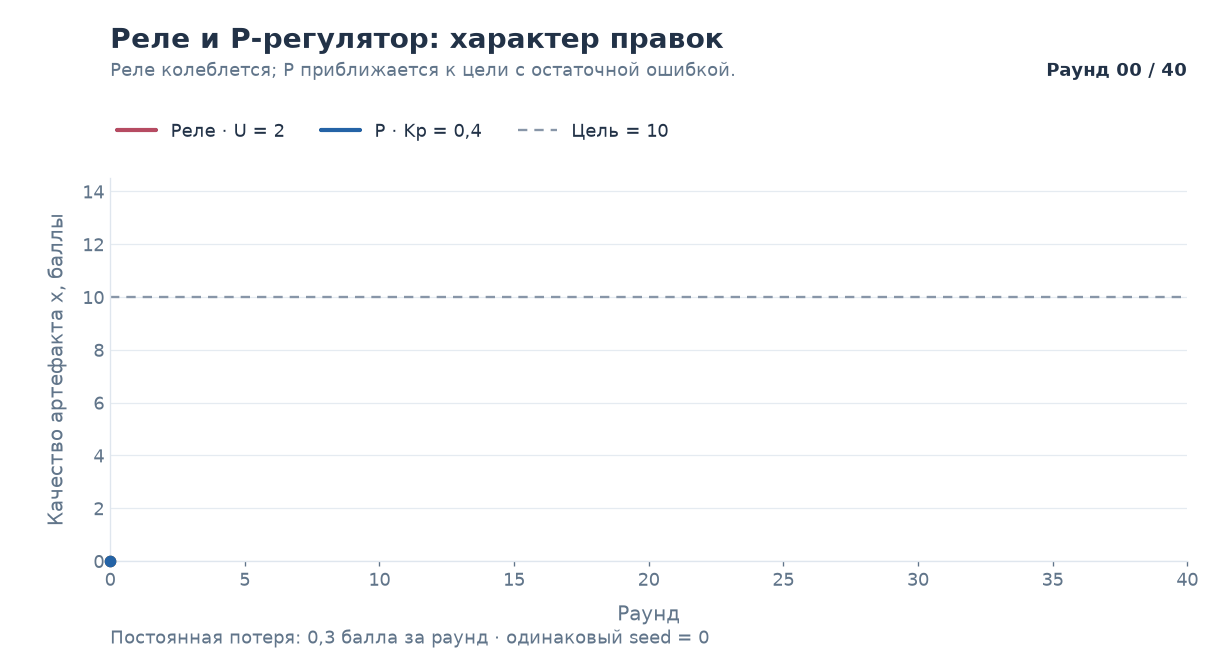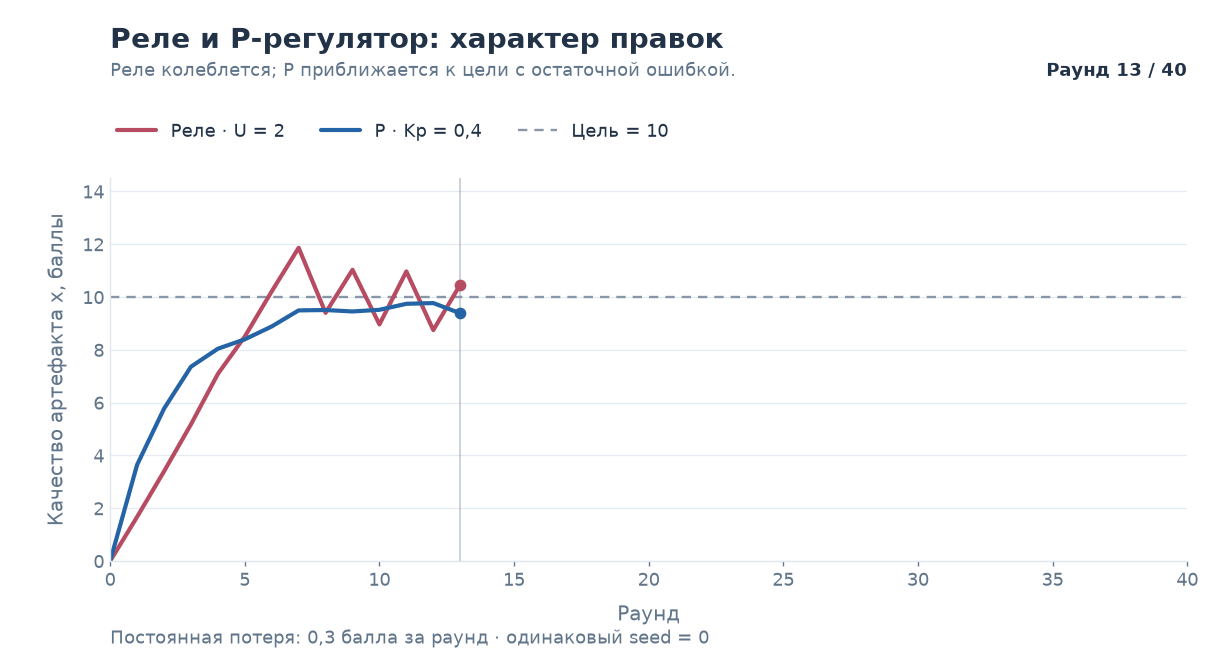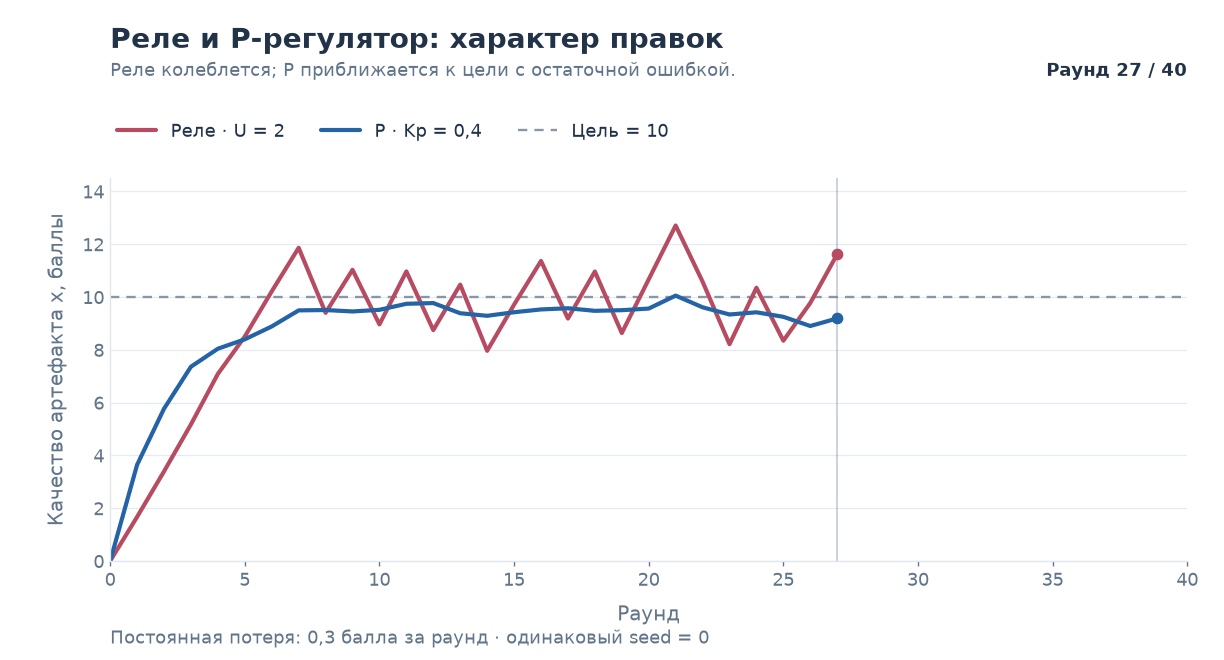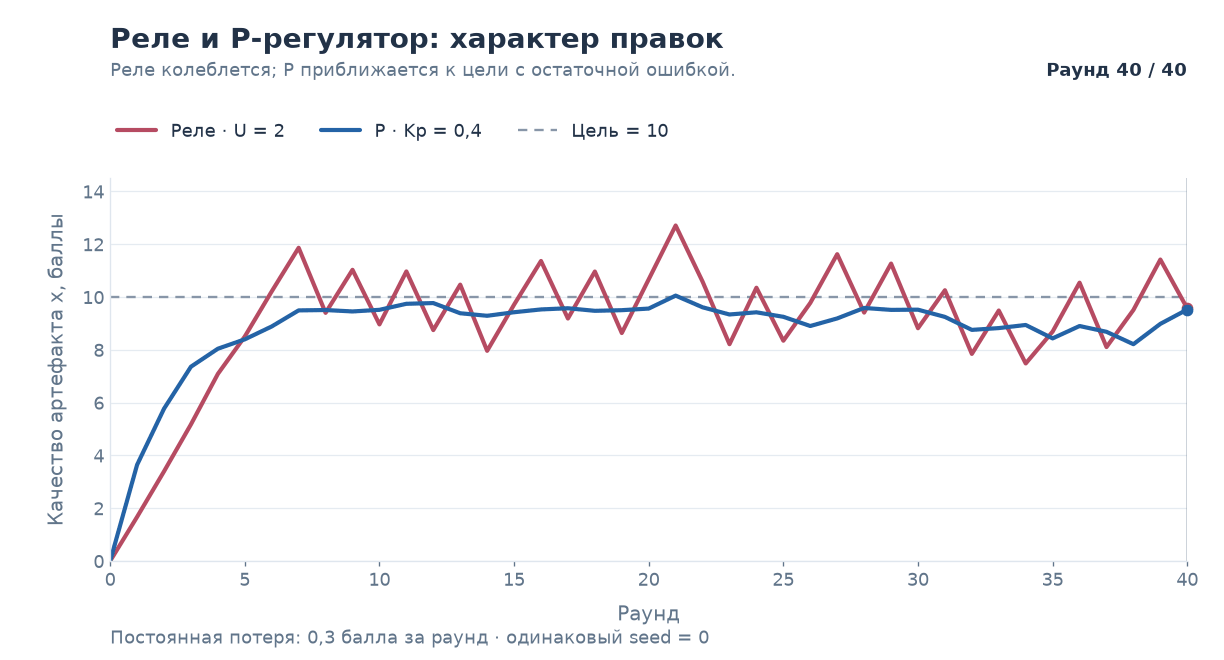
Для этого возьмём один показательный прогон: 40 раундов, seed 0 — номер, задающий случайную последовательность. Цель по-прежнему 10, начальное состояние — 0. Добавим постоянную потерю 0,3 балла за раунд и сохраним одинаковые последовательности случайных ошибок во всех сравнениях ниже. Фильтр и остановка здесь отключены: регуляторы работают со свежим отзывом критика.
Реле: критик едва изменил мнение — агент переделал всё
Цель — десять. При оценке критика 9,9 агент прибавляет два балла. При оценке 10,1 — убавляет два. Изменение оценки небольшое, а реакция каждый раз полная. Так работает наше реле: оно учитывает только знак невязки, то есть направление правки.
Реле потратило 80 баллов усилия — сорок правок по два. Артефакт поднимался до 12,7 при цели 10. Финальная ошибка оказалась всего 0,43, но по последней точке нельзя понять, сколько раз перед этим пришлось переделывать работу.
Для сравнения колебаний используем показатель flips: усредняем невязку по трём соседним раундам и считаем смены её знака. У реле их 13. Это условный показатель колебаний, а не число реальных разворотов правки или пересечений цели.
P-звено: маленькой ошибке — маленькая правка
Не хватает двух баллов — добавляем 0,8. Не хватает половины балла — добавляем 0,2. В обоих случаях исправляем 40% замеченной ошибки. Именно это делает пропорциональный, или P-регулятор. Долю называют усилением и обозначают ; здесь она равна 0,4.
Без шума и постоянных потерь после каждой такой правки остаётся 60% прежней ошибки. Получается постепенное приближение. Если брать 120%, правка перескочит цель, но следующий шаг вернёт нас ближе к ней. Однако увеличивать долю бесконечно нельзя: в этой модели без задержки ошибка затухает только при усилении между нулём и двумя. На границе затухание исчезает, выше неё колебания растут.
Почему осторожность тоже имеет цену
Вернём постоянную потерю 0,3 балла. Если до цели не хватает 0,75, регулятор с долей 40% добавляет ровно 0,3 — столько же, сколько тут же теряется. Даже без шума цикл застрянет ниже цели. Это статическое смещение: каждый шаг что-то исправляет, но накопленного результата больше не становится.
Большая доля уменьшит такое смещение, зато сильнее передаст шум критика в правки. Поэтому настройка — компромисс между скоростью, чувствительностью к шуму и реакцией на постоянные потери. На анимации 2 сравните полные шаги реле с более спокойным, но медленным P при 0,4. Прогон с P при 1,2 оставим ещё и для следующего сравнения — с D-звеном.
Границы P-регулятора: когда ошибка затухает и откуда берётся смещение
Реле выбирает фиксированную по модулю правку, P-регулятор — пропорциональную невязке:
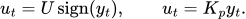
Здесь  — шаг реле;
 возвращает направление невязки. Для расчёта устойчивости уберём шум и постоянные потери. Тогда критик точен,
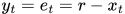 , и
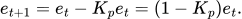
Ошибка затухает, если множитель по модулю меньше единицы:

При  остаётся 60% ошибки. При
 остаётся 20%, но знак меняется: состояние переходит на другую сторону цели. При
 модуль ошибки сохраняется; при большем усилении растёт.
Теперь добавим постоянную потерю за шаг:
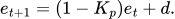
В равновесии 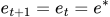 , поэтому
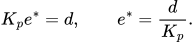
Для  и получаем
 . Это равновесие без шума; шумный прогон будет отклоняться от него. Постоянная потеря и случайная ошибка исполнения с нулевым средним — разные воздействия.
Мы пока смотрели только на оставшееся расстояние. Следующая идея — учитывать ещё и то, насколько быстро оно меняется: если цель уже приближается, не пора ли ослабить правку?
D-звено: попробовать притормозить заранее
В прошлом раунде до цели не хватало двух баллов, теперь — одного. Обычный P-регулятор при усилении 1,2 предложит добавить ещё 1,2. Но расстояние уже быстро сокращается. Давайте вычтем из следующей правки четверть этого изменения: она уменьшится на 0,25 и составит 0,95.
Такова идея D-звена: учитывать изменение невязки, а не только её нынешнюю величину. Пока мы приближаемся к цели с одной стороны, добавка притормаживает действие; если удаляемся — подталкивает обратно. Коэффициент этой добавки обозначают  ; в нашем примере он равен 0,25.
Беда в том, что разница соседних отзывов содержит и изменение артефакта, и ошибки двух измерений. Критик сегодня строже, чем вчера, — а регулятор уже принял это за движение. Кроме того, новый коэффициент меняет границу устойчивости. Дополнительную ручку настройки получили; бесплатного улучшения к ней не приложили.
Что получилось на нашем объекте
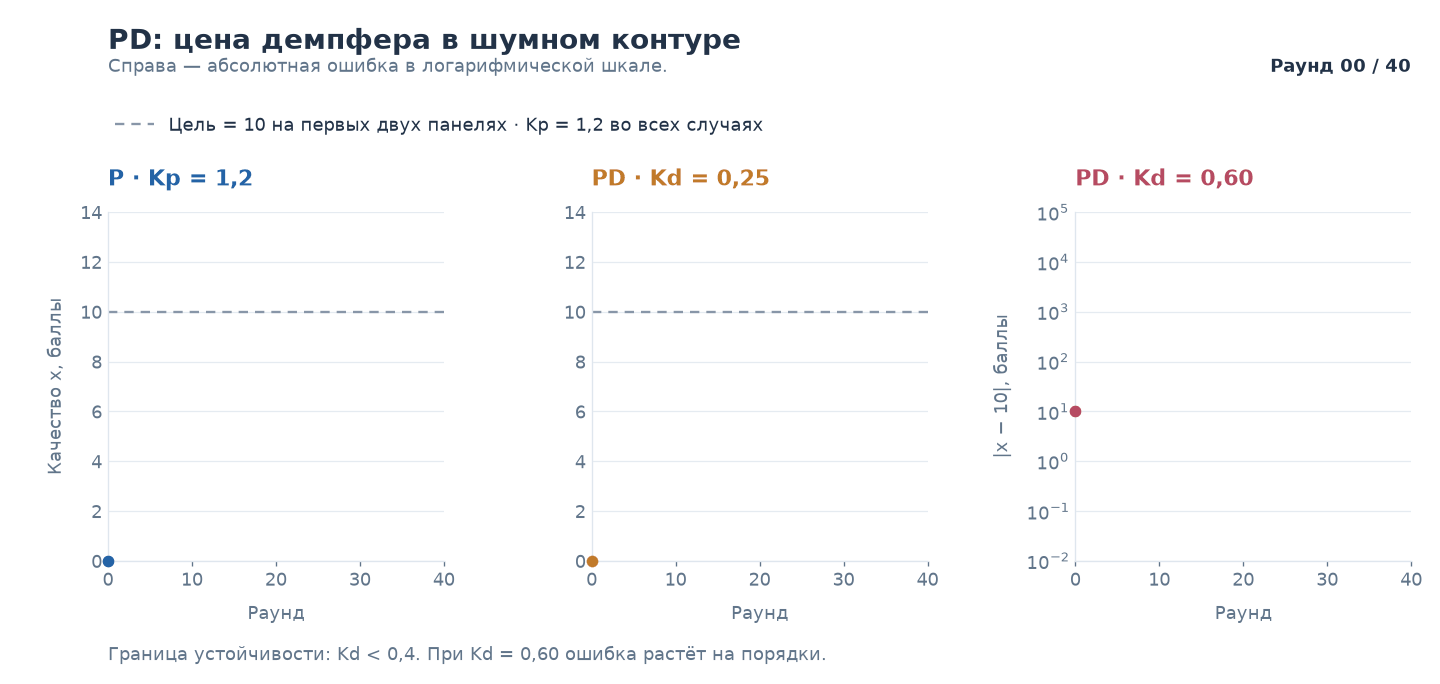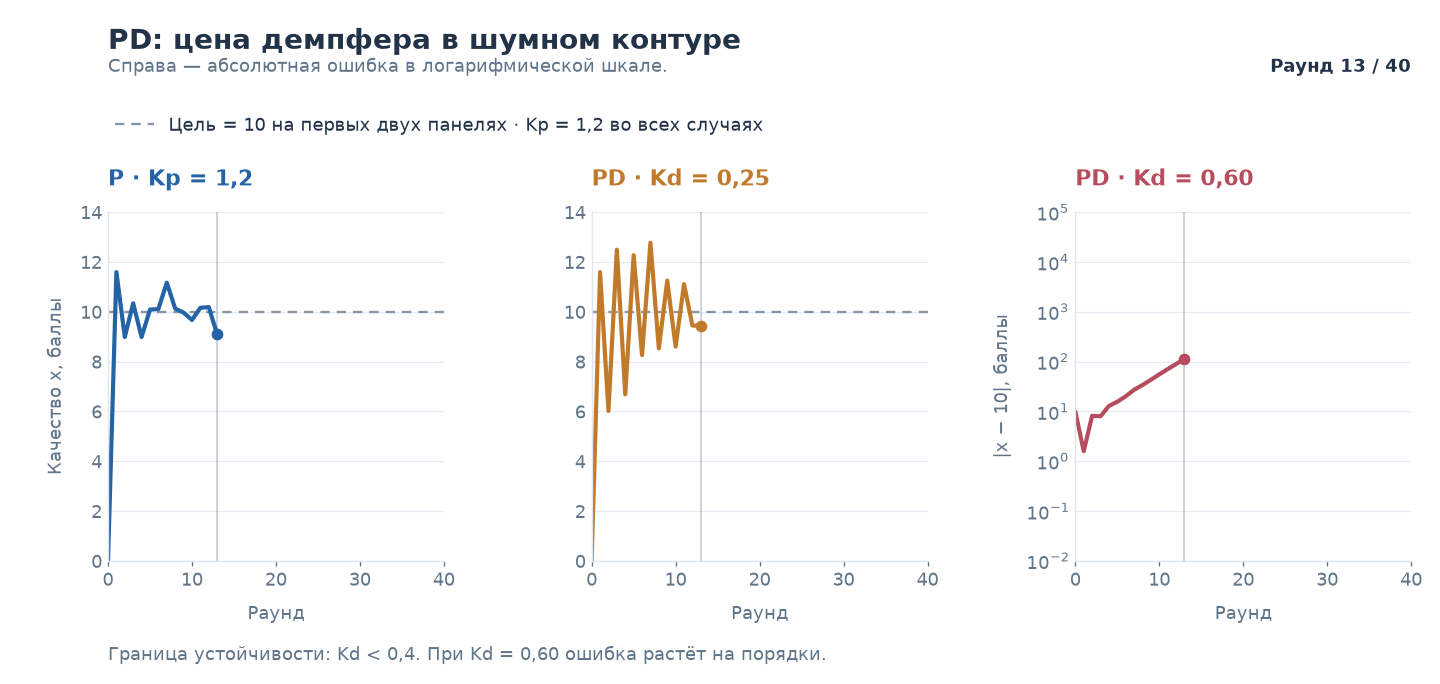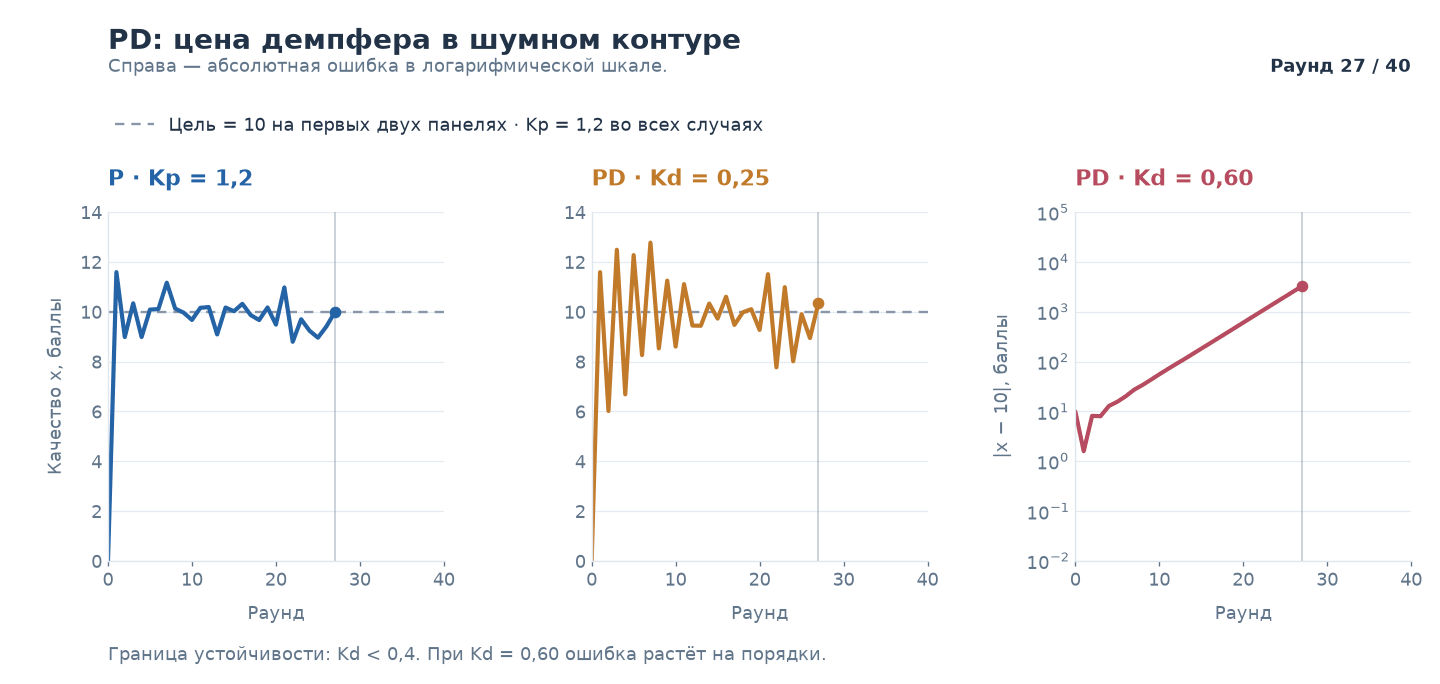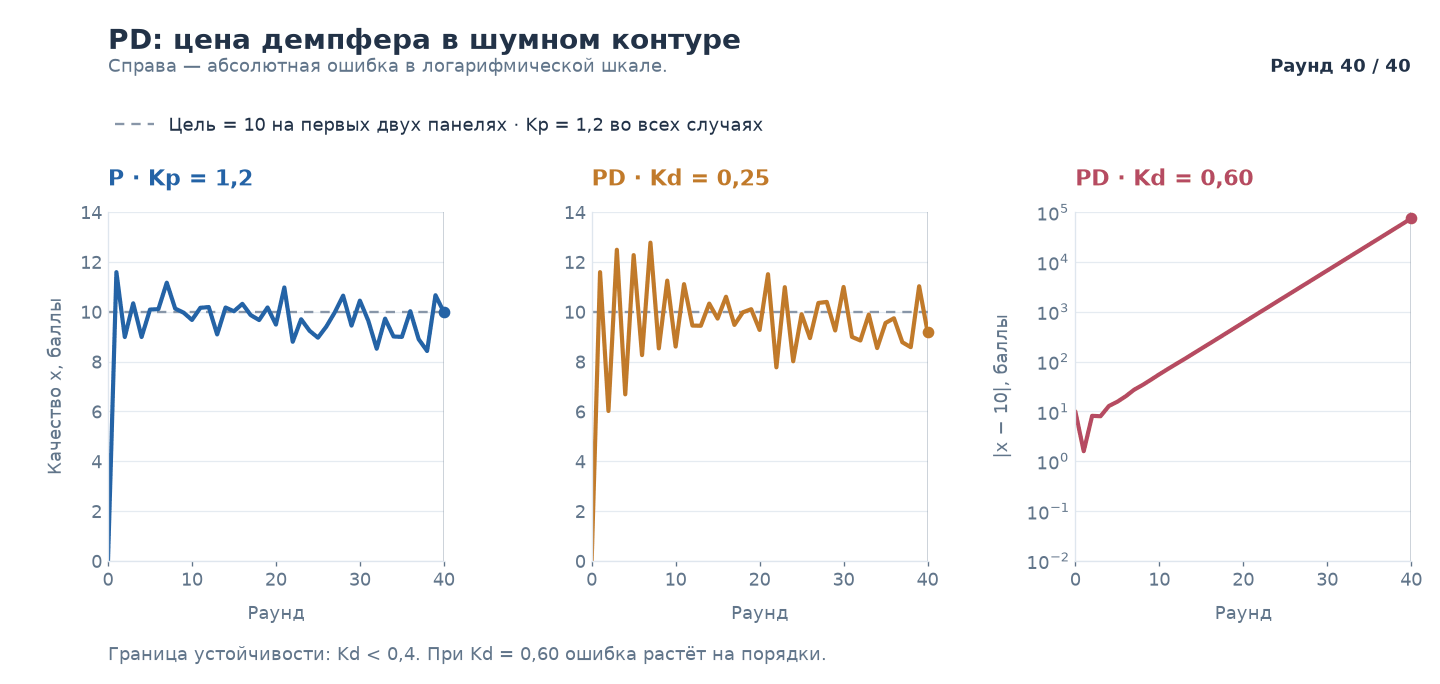
В том же прогоне сравним P с усилением 1,2 и такой же P с D-добавкой. При добавке D с коэффициентом 0,25 показатель flips вырос с 10 до 16: сглаженная невязка стала чаще менять знак. Максимальное состояние достигло 12,8. В этом сравнении ожидаемого уменьшения колебаний не получилось.
Увеличим D до 0,6. Финальная ошибка теперь 74 212 баллов. Это уже потеря устойчивости, а не чуть более шумная работа. Для выбранного P граница D проходит по 0,4: первая настройка ниже неё, вторая — выше.
В нашей модели нет инерции, которую требовалось бы гасить. Поэтому перенос привычной идеи «добавим демпфер» без проверки динамики оказался неудачным. Это вывод о данном объекте и настройках, а не запрет на D-звено вообще.
На анимации 3 сравните три панели: P держится около цели, PD при 0,25 колеблется сильнее, PD при 0,6 расходится. Для последнего нужен уже логарифмический масштаб.
Почему D чувствительно к шуму и где проходит граница устойчивости
Закон управления с разностью соседних невязок:
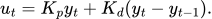
В шумовую часть разности входит разность двух ошибок критика. Для независимых ошибок с одинаковой дисперсией
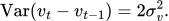
Удваивается дисперсия этой шумовой части; её стандартное отклонение увеличивается в  раза. Затем разность умножается на и попадает в управление.
Для проверки устойчивости снова возьмём идеального критика и уберём внешние воздействия. Подставим  :
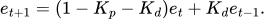
Ищем решение вида . Получаем характеристический многочлен
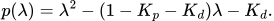
Для затухания оба корня должны иметь модуль меньше единицы. Для этого многочлена критерий Джури даёт
 ,
 и
 . При неотрицательном условия записываются так:
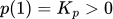 ;
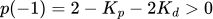 ;
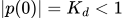 .
В результате рабочая область:
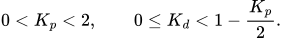
Чем больше P, тем меньше допустимая добавка D. При верхняя граница равна 0,4. Коэффициент 0,25 сохраняет устойчивость, а 0,6 выводит за её пределы. Это расчёт для нашей дискретной модели с прямым прибавлением правки; для другого объекта границу нужно выводить заново.
I-звено: помнить о недоделанном
Вернёмся к примеру P-регулятора с усилением 0,4. После очередной правки снова не хватает тех же 0,75 балла. Регулятор отвечает так же, как раньше, и его прибавку опять съедает постоянная потеря. Он не различает замечание, которое услышал впервые, и замечание, повторившееся десять раз.
Давайте сохраним остатки ошибок и будем понемногу добавлять их сумму к правке. Если недолёт повторяется, накопленная добавка растёт. Со временем она может взять на себя компенсацию постоянной потери, а P-часть снова будет отвечать за приближение к цели. Это интегральное, или I-звено. Соединив P, I и D, получаем PID-регулятор.
При устойчивой настройке оно устраняет статическое смещение от постоянного возмущения. Но память полезна лишь до тех пор, пока регулятор учитывает собственные возможности.
Когда накопитель требует невозможного
Добавим ограничение: в опыте с PID правка не может быть больше трёх баллов за раунд по модулю. Это ограничение относится только к двум PID-прогонам ниже.
На старте до цели десять баллов. P-часть с усилением 1,2 уже требует прибавить двенадцать, но исполнить можно только три. Для простоты пока уберём шум и потери: следующие остатки ошибки будут семь, затем четыре. Накапливать их в такой ситуации бесполезно — команда и без того упёрлась в ограничение.
Обычный интегратор об этом не знает и продолжает суммировать: десять, ещё семь, ещё четыре… Когда артефакт доберётся до цели, накопленная добавка всё ещё будет толкать его выше. Этот эффект называют windup — избыточным накоплением интеграла при насыщении.
Исправление короткое: не накапливать очередную ошибку, если правка уже ограничена и ошибка требует ещё больше в ту же сторону. Если же ошибка помогает выйти из насыщения, накопление разрешаем. Это наш вариант анти-виндапа.
Что изменилось в прогоне
Вернём шум и постоянные потери и сравним два PID-регулятора на тех же 40 раундах, seed 0. Без анти-виндапа артефакт поднялся до 13,99 при цели 10; примерно четверть поздних состояний оказалась выше 11. С анти-виндапом максимум снизился до 12,24, финальная ошибка составила 0,52.
Защита уменьшила большой перелёт, но не убрала все колебания. Анимация 4 показывает именно это различие. По одному шумному финалу нельзя доказать способность интегратора устранять смещение; здесь наглядно проверяем влияние ограничения и накопления.
Формула PID и точное правило накопления в коде
В накопителе  хранятся невязки предыдущих раундов. Сначала вычисляем желаемую правку:
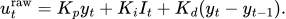
Ограничиваем её по амплитуде:
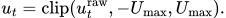
Здесь  оставляет число внутри интервала как есть, а выходящее за границу заменяет этой границей. В первом раунде, когда предыдущей невязки ещё нет, D-добавка равна нулю.
Без анти-виндапа после расчёта правки всегда добавляем текущую невязку:
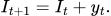
Поэтому в формулу управления входит сумма прошлых, а не текущей и прошлых ошибок. При включённой защите обновляем накопитель только тогда, когда насыщения нет или знак текущей невязки противоположен знаку желаемой правки. В остальных случаях оставляем  .
Параметры двух сравниваемых PID одинаковы:

Отличается только разрешение на накопление при насыщении. Чтобы понять компенсацию постоянной потери, рассмотрим равновесие без шума: при нулевой невязке P- и D-части равны нулю, а интегральная добавка может сохранять ненулевое значение  . Она и восполняет потерю каждого раунда. Это рассуждение требует устойчивости контура и достаточного диапазона управления.
Наблюдатель и регулятор решают разные задачи
В этом разборе мы меняли реакцию на отзыв: соразмеряли правку ошибке, учитывали её изменение и помнили прошлые недолёты. Даже на одном объекте разные настройки дали спокойное приближение, колебания или потерю устойчивости.
Калман из основной части помогает оценить состояние по шумным данным. P, D и I определяют, что с этой оценкой делать. Хорошая оценка не отменяет границ устойчивости и ограничения на правку; удачная настройка регулятора не делает критика точнее. Поэтому работу наблюдателя и работу регулятора мы проверяем отдельно.
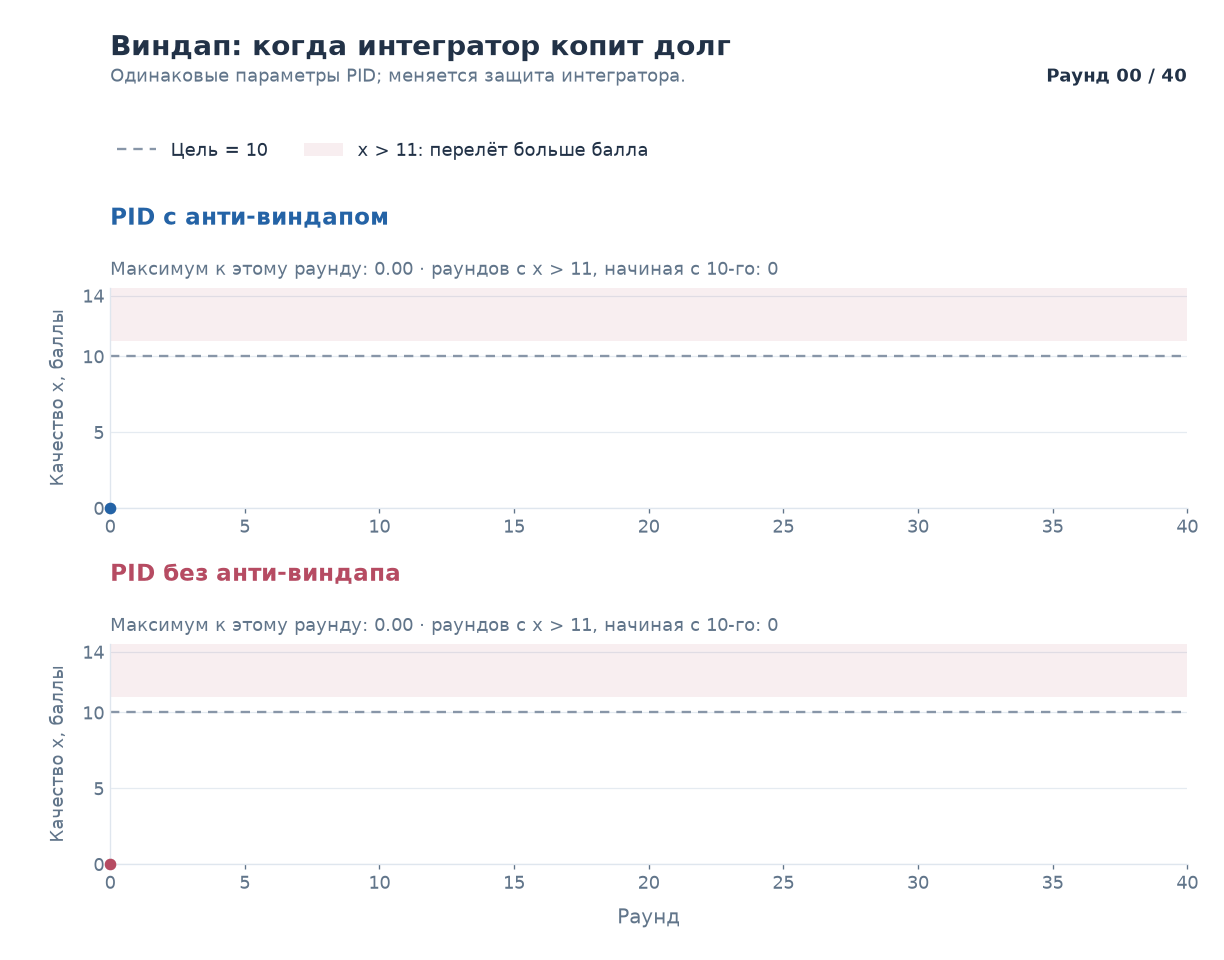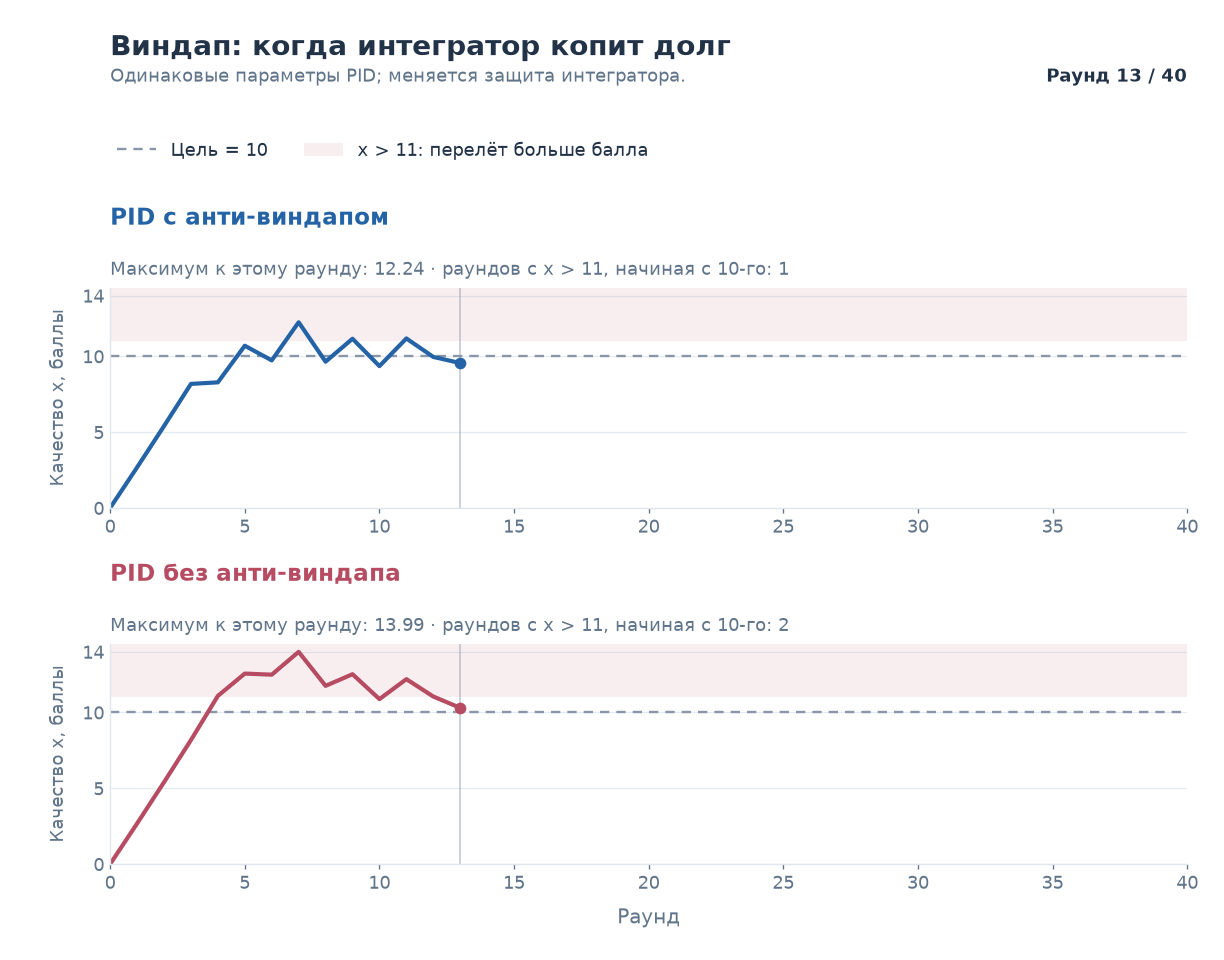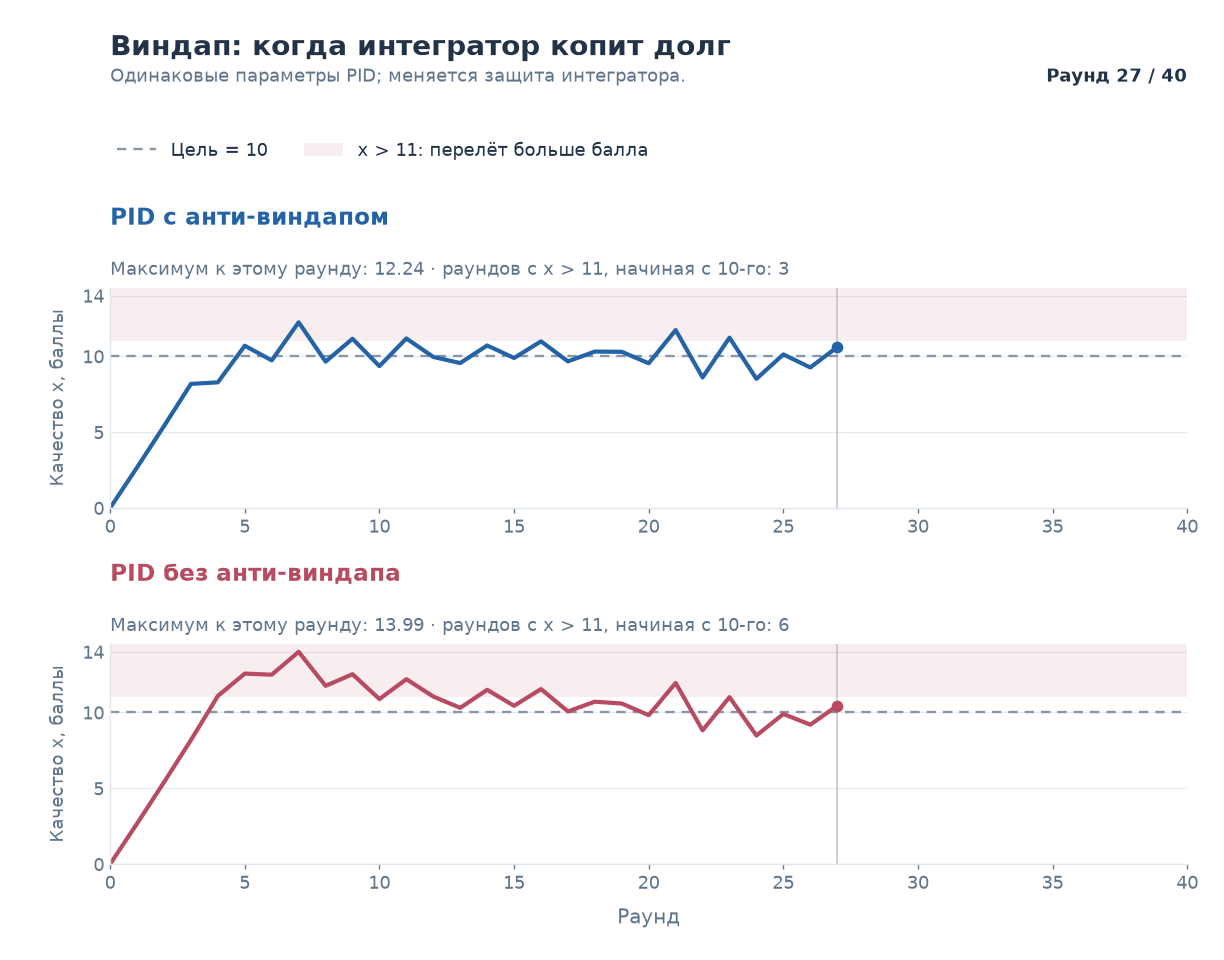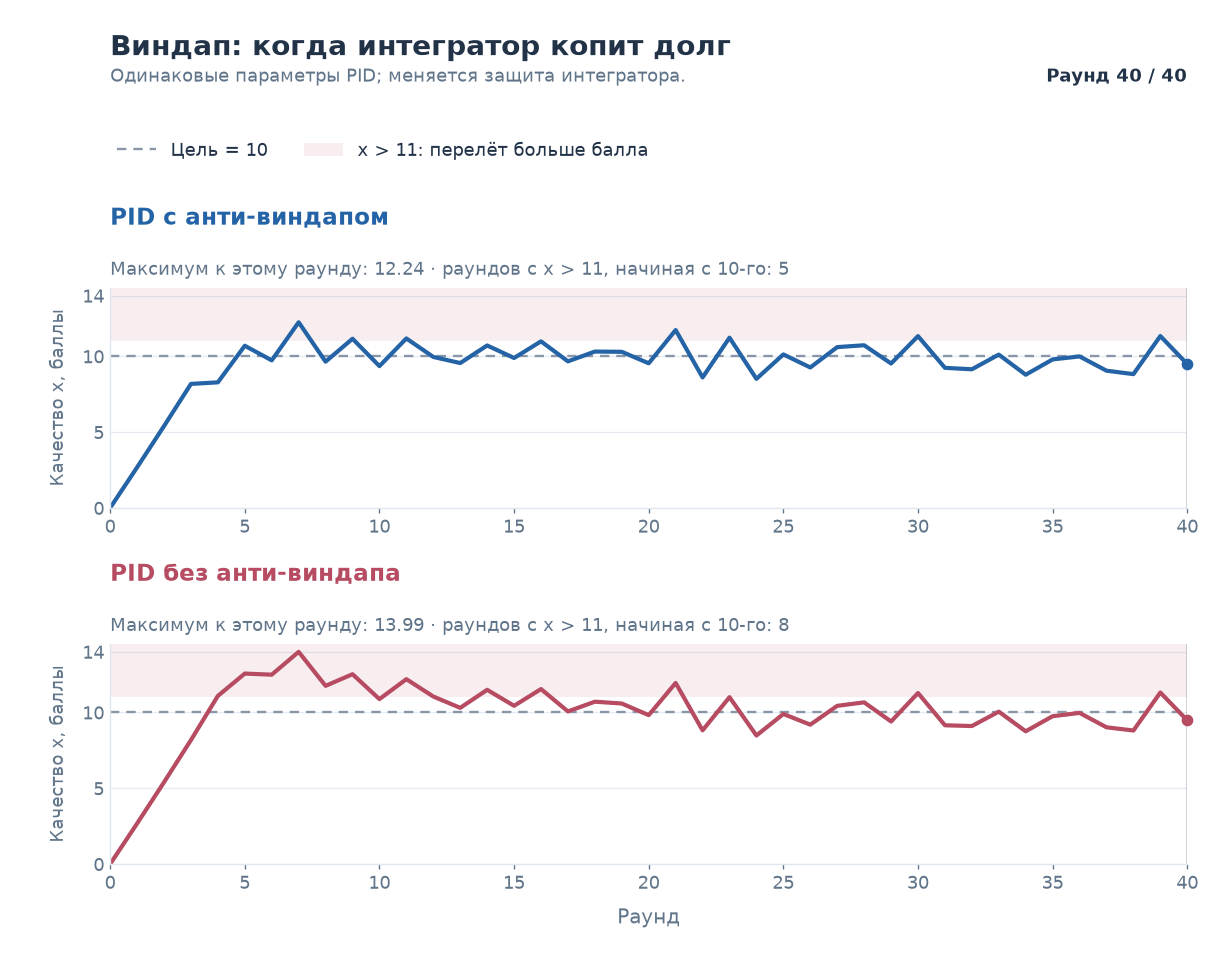
Если эта публикация вас вдохновила и вы хотите поддержать автора — не стесняйтесь нажать на кнопку
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.