Правда ли нейросети выдумывают ссылки и почему в их ответах остаются удалённые статьи
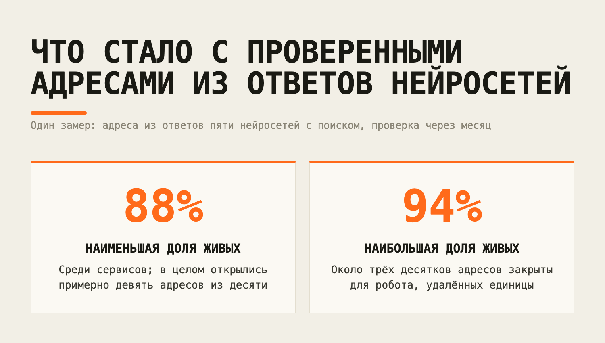
Под ответом нейросети стоит ссылка, она не открывается, и первая мысль — адрес выдуман. Я проверил около шестисот адресов из ответов пяти нейросетей с поиском примерно через месяц после того, как их собрал. Открылись примерно девять из десяти. Мёртвых, с кодами 404 и 410, единицы. Это адреса обычных материалов на живых площадках, а не случайный набор символов, поэтому скорее всего это удалённые статьи, а не выдумка. Когда именно их удалили, неизвестно. Поэтому риск для сайта другой: ссылка на удалённую страницу может остаться в источниках и вести в пустоту.
Если ссылка из ответа нейросети не открылась, значит ли это, что её выдумали
В этой проверке нет: выдуманных адресов среди неоткрывшихся я не нашёл, хотя ждал больше. Выдуманная ссылка — это галлюцинация: ИИ-модель собирает правдоподобный адрес страницы, которой никогда не было. Нейросеть придумывает источники там, где не ищет в интернете: в исследовании Walters и Wilder без поиска выдуманными оказались 55% научных ссылок у GPT-3.5 и 18% у GPT-4.
Адреса я брал из одного замера видимости в ответах ИИ-моделей и открывал каждый запросом. Среди неоткрывшихся есть две группы, которые нельзя путать. Около трёх десятков адресов не отдали страницу роботу: это защита сайтов. Мёртвых единицы: подборки агентств на vc.ru и DTF и блог на Tilda. Это обычные материалы живых площадок, а не случайный набор символов, поэтому скорее всего это удалённые статьи. Когда страницы пропали, я не знаю. Ни один сервис заметно не выделился: доля живых ссылок по сервисам близкая, от 88% до 94%.
Какой код ответа значит, что страницы нет, и какой — что сайт не пустил робота
Страницы больше нет, когда сервер отвечает 404 или 410. Коды 401, 403, 429 и 503 говорят о другом: сервер не отдал страницу роботу, хотя сама она может существовать.
Код | Что значит | Выдумана ли ссылка | Категория |
|---|---|---|---|
200 | страница отдалась | нет | жива |
301, 302 | страница переехала, скрипт идёт по новому адресу | нет | жива, если в конце 200 |
404 | по этому адресу ничего нет | в этой проверке нет, это удалённые статьи; по одному коду выдумку от удаления не отличить | удалена |
410 | страницу удалили намеренно и насовсем, адреса переадресации нет | нет, она существовала | удалена |
401, 403 | сервер не пускает робота | нет, страница может существовать | закрыта для робота |
429 | с одного адреса пришло слишком много запросов за короткое время | нет, страница может существовать | закрыта для робота |
503 | сервис временно недоступен | нет | закрыта для робота |
410, по MDN, значит, что содержимое удалили окончательно и адреса для переадресации нет. 403 значит, что у клиента нет прав на доступ и сервер отказывает. 429 — ограничение частоты запросов, страница при этом может быть цела. 503 — временное состояние, срок восстановления сервер может указать в заголовке Retry-After. 401 бывает штатным ответом защитной проверки Cloudflare: посетителя при этом никто не заблокировал. Скрипт, который считает мёртвой любую страницу с ошибкой, на этих данных записал бы в мёртвые лишние три десятка адресов.
Как проверить ссылки из ответа нейросети скриптом на Python
Скрипт раскладывает адреса по тем же категориям, что и таблица кодов, плюс две служебные: нет ответа и разобрать вручную. Сохраните код в файл check.py, адреса — в файл urls.txt по одному на строку, установите библиотеку requests и запустите в терминале из этой папки: python3 check.py urls.txt.
import sys
import requests

s = requests.Session()
s.max_redirects = 10
s.headers["User-Agent"] = "link-check/1.0 (checking links from AI answers)"

def check(url):
    try:
        r = s.get(url, timeout=(5, 15), allow_redirects=True, stream=True)
        r.close()
    except requests.exceptions.RequestException as e:
        return "нет ответа", type(e).__name__, url
    code = r.status_code
    if 200 <= code < 300:
        return "жива", code, r.url
    if code in (404, 410):
        return "удалена", code, r.url
    if code in (401, 403, 429, 503):
        return "закрыта для робота", code, r.url
    return "разобрать вручную", code, r.url

for url in open(sys.argv[1]).read().split():
    print(url, *check(url), sep="\t")
GET вместо HEAD. HEAD отдаёт только заголовки без тела, и текста страницы скрипт с ним не увидит. GET оставляет возможность дописать проверку содержимого; в скрипте выше тело я не читаю.
По редиректам до 10 переходов. Ссылка, которая через переадресацию приводит на статью, для читателя жива. Число 10 взято у краулеров Google: они по умолчанию идут по цепочке до 10 переходов. Если перейдёте на HEAD, в Requests редиректы придётся включить явно параметром allow_redirects.
Тайм-аут 5 секунд на соединение и 15 на чтение. Без него Requests может ждать ответа бесконечно. О тайм-ауте и слишком длинной цепочке редиректов библиотека сообщает исключениями, кода ответа у них нет, поэтому скрипт ловит их отдельно и пишет: нет ответа. Сами числа мои, их можно оспорить.
Свой User-Agent. Скрипт представляется проверкой ссылок и под браузер не маскируется. Защитную проверку Cloudflare он не пройдёт: она работает на JavaScript, и вместо страницы скрипт получит саму проверку. Адреса из категории закрытых для робота стоит открыть в браузере.
Конечный адрес в последнем столбце. Если он отличается от исходного, страницу перенесли или отправили на главную, а скрипт в обоих случаях запишет её в живые. Такие строки стоит прочитать глазами.
Почему нейросеть с поиском ссылается на удалённую статью
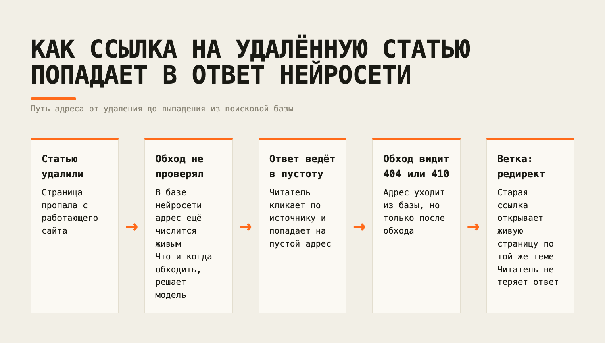
Скорее всего, потому что поисковая база нейросети отстаёт от сайтов: статью уже удалили, а обход до неё ещё не добрался. Удаляют страницы постоянно. По Pew Research Center, четверть страниц, существовавших в 2013–2023 годах, к октябрю 2023-го стала недоступна, и чаще всего удалили отдельную страницу на работающем сайте. Perplexity пишет, что часто переиндексировать каждый адрес невозможно, и что и когда обходить, решает модель машинного обучения. Поэтому удалённая страница может оставаться в его базе, пока обход до неё не дошёл. OpenAI публикует срок только для изменений robots.txt, около 24 часов, а срока удаления страниц из поиска ChatGPT не называет.
Обычные поисковики хотя бы описывают, что делают с удалённой страницей. Google на ответы 4xx, кроме 429, сообщает дальше, что содержимого нет, а проиндексированные раньше адреса со временем перестают использоваться. Яндекс убирает страницу с ответом 404, 403 или 410 из поисковой базы в течение недели после того, как робот это обнаружил, но до обхода может пройти время. В списке Яндекса есть и 403: страницу, закрытую от робота, он тоже убирает из базы.
Что сделать со своей страницей перед удалением: поставить редирект на страницу по той же теме
Ссылка на удалённую страницу может остаться в ответах нейросети, поэтому перед удалением стоит поставить с неё редирект на актуальную страницу по той же теме. Поручение тому, кто ведёт сайт, такое: настроить постоянное перенаправление со старого адреса на выбранный новый и проверить в браузере, что старая ссылка открывает новую страницу. Тогда человек, который кликнет по старой ссылке из ответа, попадёт на живой текст. Редирект на главную скрипт тоже покажет живым, но читатель из ответа нейросети не найдёт там того, что ему обещали. Если замены нет, отдавайте 410: по MDN это явный сигнал, что содержимое удалено насовсем.
В моей проверке около шестисот адресов из одного замера, и выдуманных среди них нет. Страх, что нейросеть выдумывает ссылки, для сервисов с поиском устарел: они ссылаются на реальные страницы, которые когда-то существовали. Настоящая проблема — устаревший индекс: удалённая страница продолжает работать источником. Поэтому проверять надо не то, существует ли адрес, а жив ли он и говорит ли страница то же, что пересказала нейросеть.
Ограничения: один замер и проверка только того, открывается ли страница
Это один замер: около шестисот адресов из ответов пяти нейросетей, проверка через месяц. Когда удалили мёртвые статьи, до ответа нейросети или за этот месяц, одна проверка не различает. На других данных картина бывает хуже: Tow Center на цитировании новостей нашёл у Gemini и Grok 3 выдуманные или битые адреса больше чем в половине ответов. Говорит ли открытая страница то же, что пересказала нейросеть, я не проверял, а живой источник может оказаться недостоверным: в препринте на arXiv выдуманное понятие на легко доступных площадках за неделю попало в цитаты 8 из 10 ИИ-поисковиков. Сколько вообще живёт ссылка в ответе нейросети, я сравнивал на трёх замерах по 20 вопросам. А вот сколько в ответах держится уже удалённая страница, есть ли у кого-то такие замеры?
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.