Deep Research и MCP Mobbin — нитро для поиска референсов
Привет, Хабр! Я Женя Горбач, продуктовый дизайнер в Альфа-Метрике, аналитическом продукте Альфа-Банка. Найти рефы для авторизации, оформления заказа или перевода — задача вполне понятная. Но что делать, если проектируешь сценарий, который редко встречается в других продуктах, а решения прямых конкурентов тебе не подходят?
Недавно я столкнулся именно с такой задачей во время редизайна одного из разделов нашего сервиса — каталога событий: 70% пользователей бросали загрузку событий, и нам предстояло выяснить, почему, и помочь им. Спойлер: более удобное решение получилось благодаря тому, что мы выпилили часть интерфейса. В этой статье расскажу, как с помощью ChatGPT, Deep Research и Mobbin через MCP я не только ускорил, но и качественно улучшил процесс поиска решения.
Как устроена аналитика?
Альфа-Метрика — внутренняя аналитическая платформа, в которой команды банка собирают данные о поведении пользователей и строят по ним отчёты.
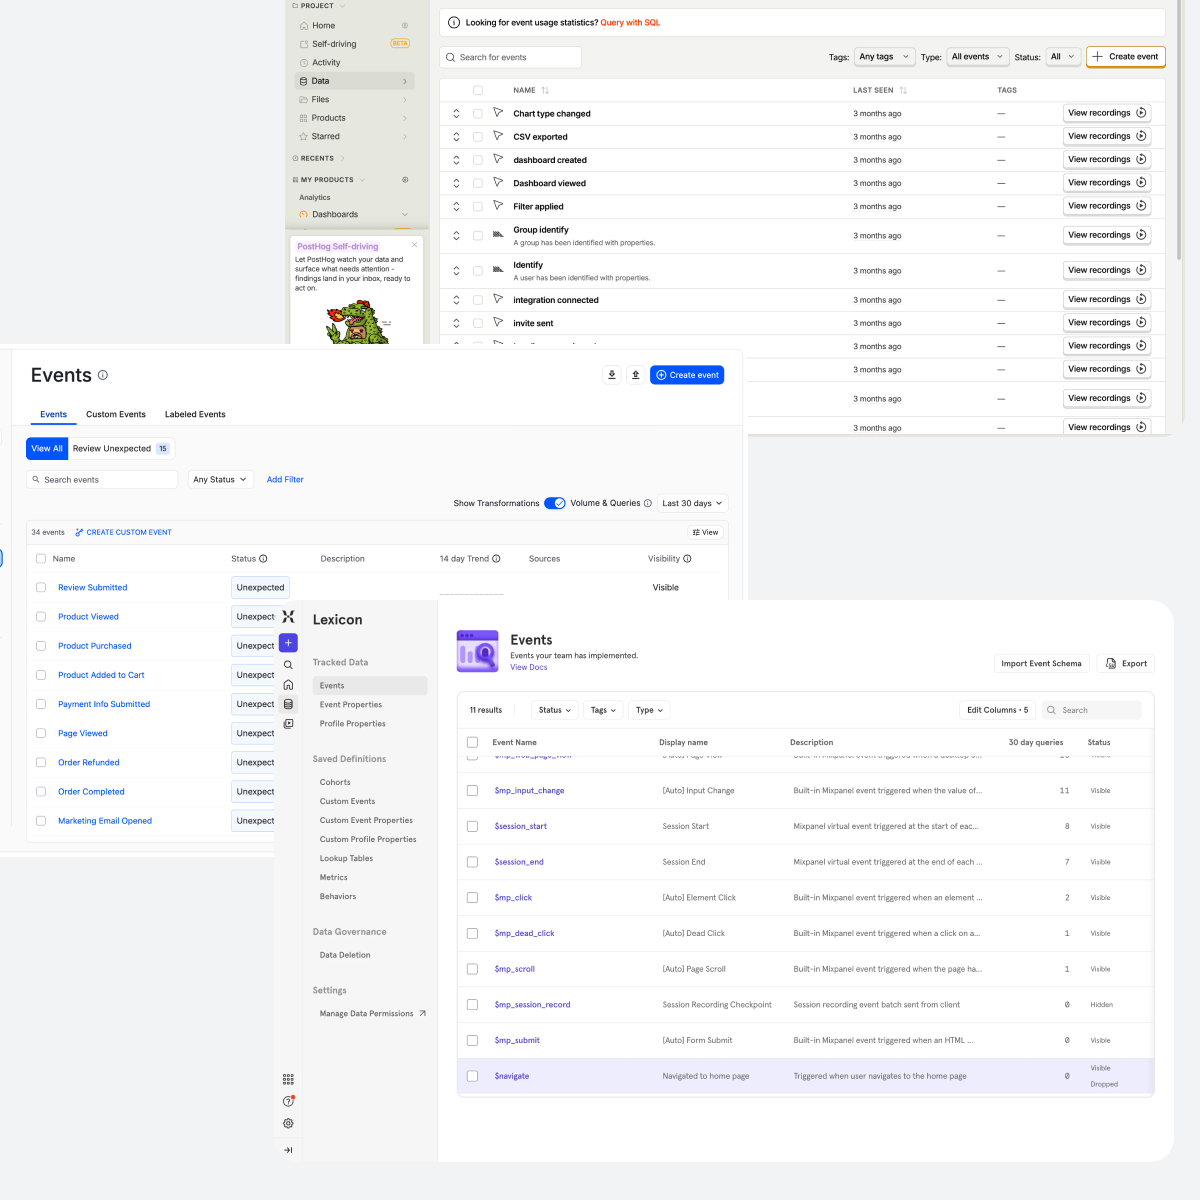
Чтобы строить отчёты, необходимо иметь данные о том, что пользователи делают у вас в продукте. Для этого в интерфейсе размечают действия пользователей: нажатия на кнопки, переходы по баннерам и другие взаимодействия. Каждое зафиксированное действие называется событием. Все события команд Альфа-Банка собраны в одном месте — Каталоге событий.
Где была проблема?
Чтобы увидеть данные по своим событиям, необходимо предоставить сведения о том, что и откуда считывать. Для этого пользователь заполняет таблицу в Excel и загружает её в систему. Для каждого события нужно указать техническую разметку (откуда получать данные), название (как его интерпретировать) и при необходимости дополнительные атрибуты (регион, устройство, возраст).
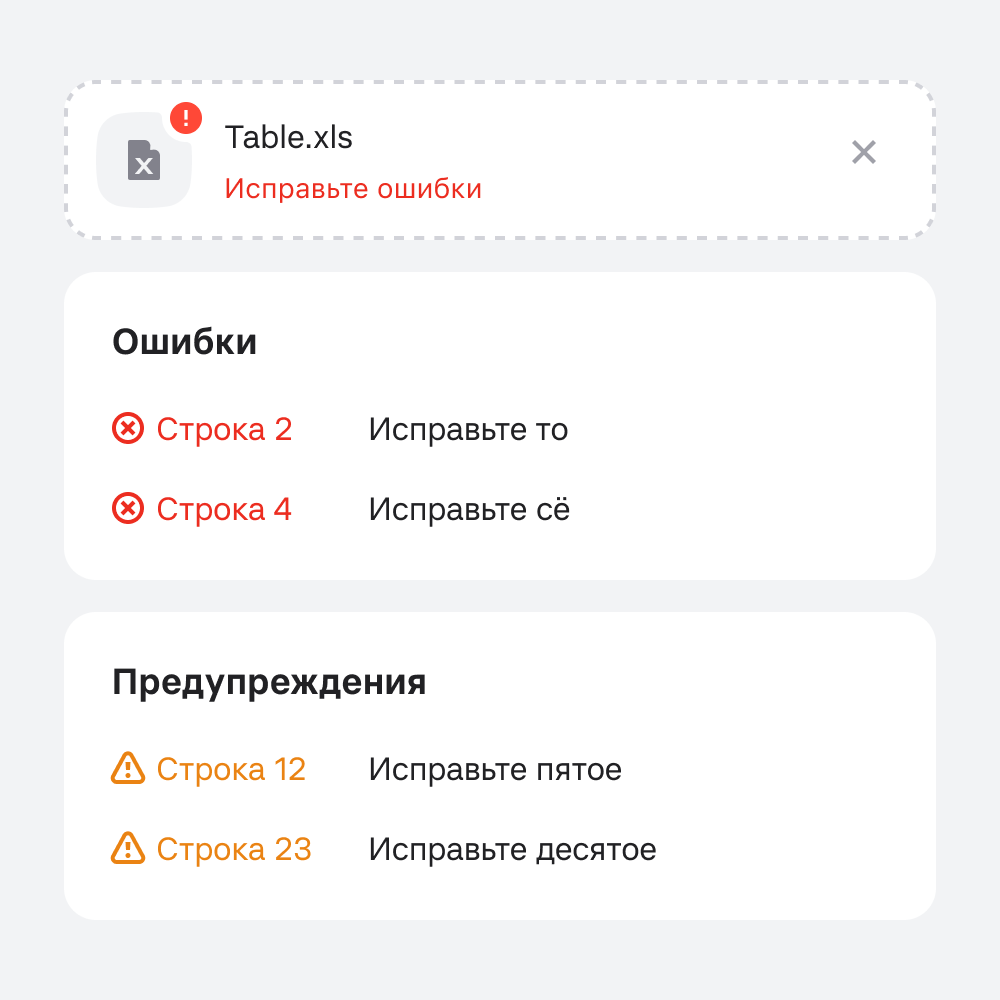
После загрузки мы проверяем заполненные поля и показываем ошибки и предупреждения прямо в интерфейсе. Чтобы их исправить, пользователю приходится возвращаться к исходному файлу и вручную вносить изменения, сверяясь с замечаниями в интерфейсе.
В Альфа-Метрике мы регулярно анализируем пользовательские пути и следим за тем, как люди взаимодействуют с продуктом. По нашим данным, около 70% пользователей не завершали сценарий добавления событий.
В причинах помогли разобраться интервью: одни пользователи путались в требованиях к шаблону, другие подолгу его заполняли, отвлекались и, возвращаясь к задаче, уже не помнили, на чём остановились. В итоге кто-то откладывал добавление событий, кто-то обращался за помощью к коллегам или передавал задачу аналитикам. А те, кто смог дойти до конца, даже составляли собственные инструкции для команды.
Добавление событий — один из ключевых сценариев Альфа-Метрики. Ведь без событий не будет данных, а без данных — аналитики. Пора сделать этот процесс понятнее!
У конкурентов всё устроено иначе
Идём изучать, как сценарий массовой загрузки событий устроен в топовых аналитических сервисах — Amplitude, Mixpanel и PostHog. С ходу получить представление не получится — чтобы проверить подход, нужно настроить правила разметки, а затем загрузить таблицу с событиями, которые их нарушают. Здесь помогает ChatGPT: разбирается вместе со мной в настройках и генерирует для каждого сервиса свою таблицу с событиями.
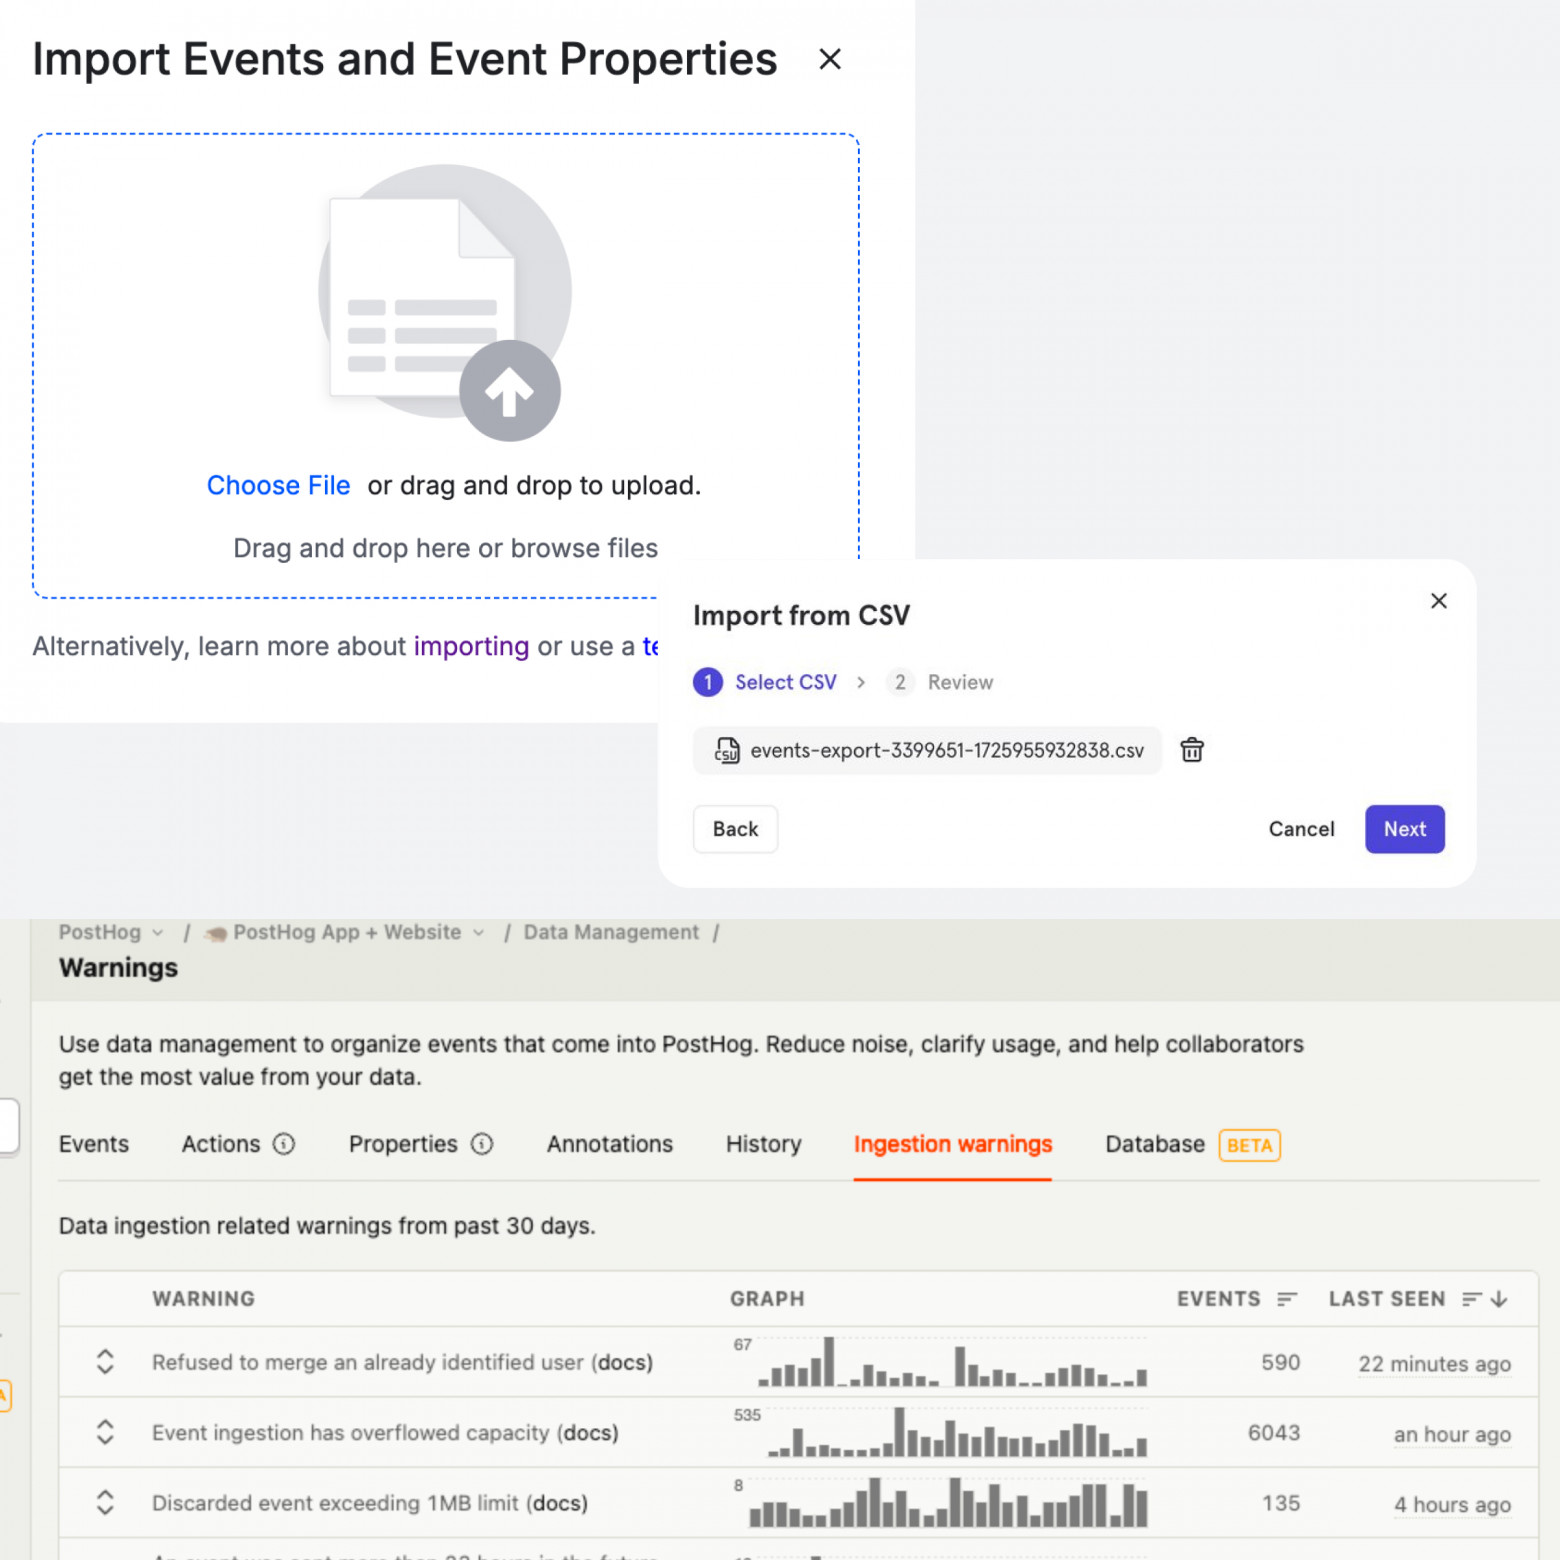
На то, чтобы подготовить таблицы и разобраться, куда и что загружать, уходит около 30 минут вместо нескольких часов. Но после загрузки появляется важный инсайт: в исследуемых сервисах проблемы с разметкой выявляются уже после добавления событий. У нас же все ошибки нужно исправить заранее — до того, как событие попадёт в каталог. Значит, этот сценарий нам не подходит, и референсы придётся искать дальше.
Deep Research — расширяем границы исследования
Так как исследование прямых конкурентов не дало нужного результата, самое время повысить уровень абстракции. Теперь будем искать не только массовую загрузку событий, а массовую загрузку чего угодно — главное, чтобы в сценарии были загрузка данных, проверка и работа с ошибками.
Но здесь появляется другая проблема: где вообще искать такие флоу, чтобы не перебирать сервисы вручную и не тратить на это часы? Подобные механики часто не лежат на поверхности интерфейса: массовая загрузка, валидация данных и обработка ошибок могут быть спрятаны в документации, Help Center или инструкциях для пользователей.
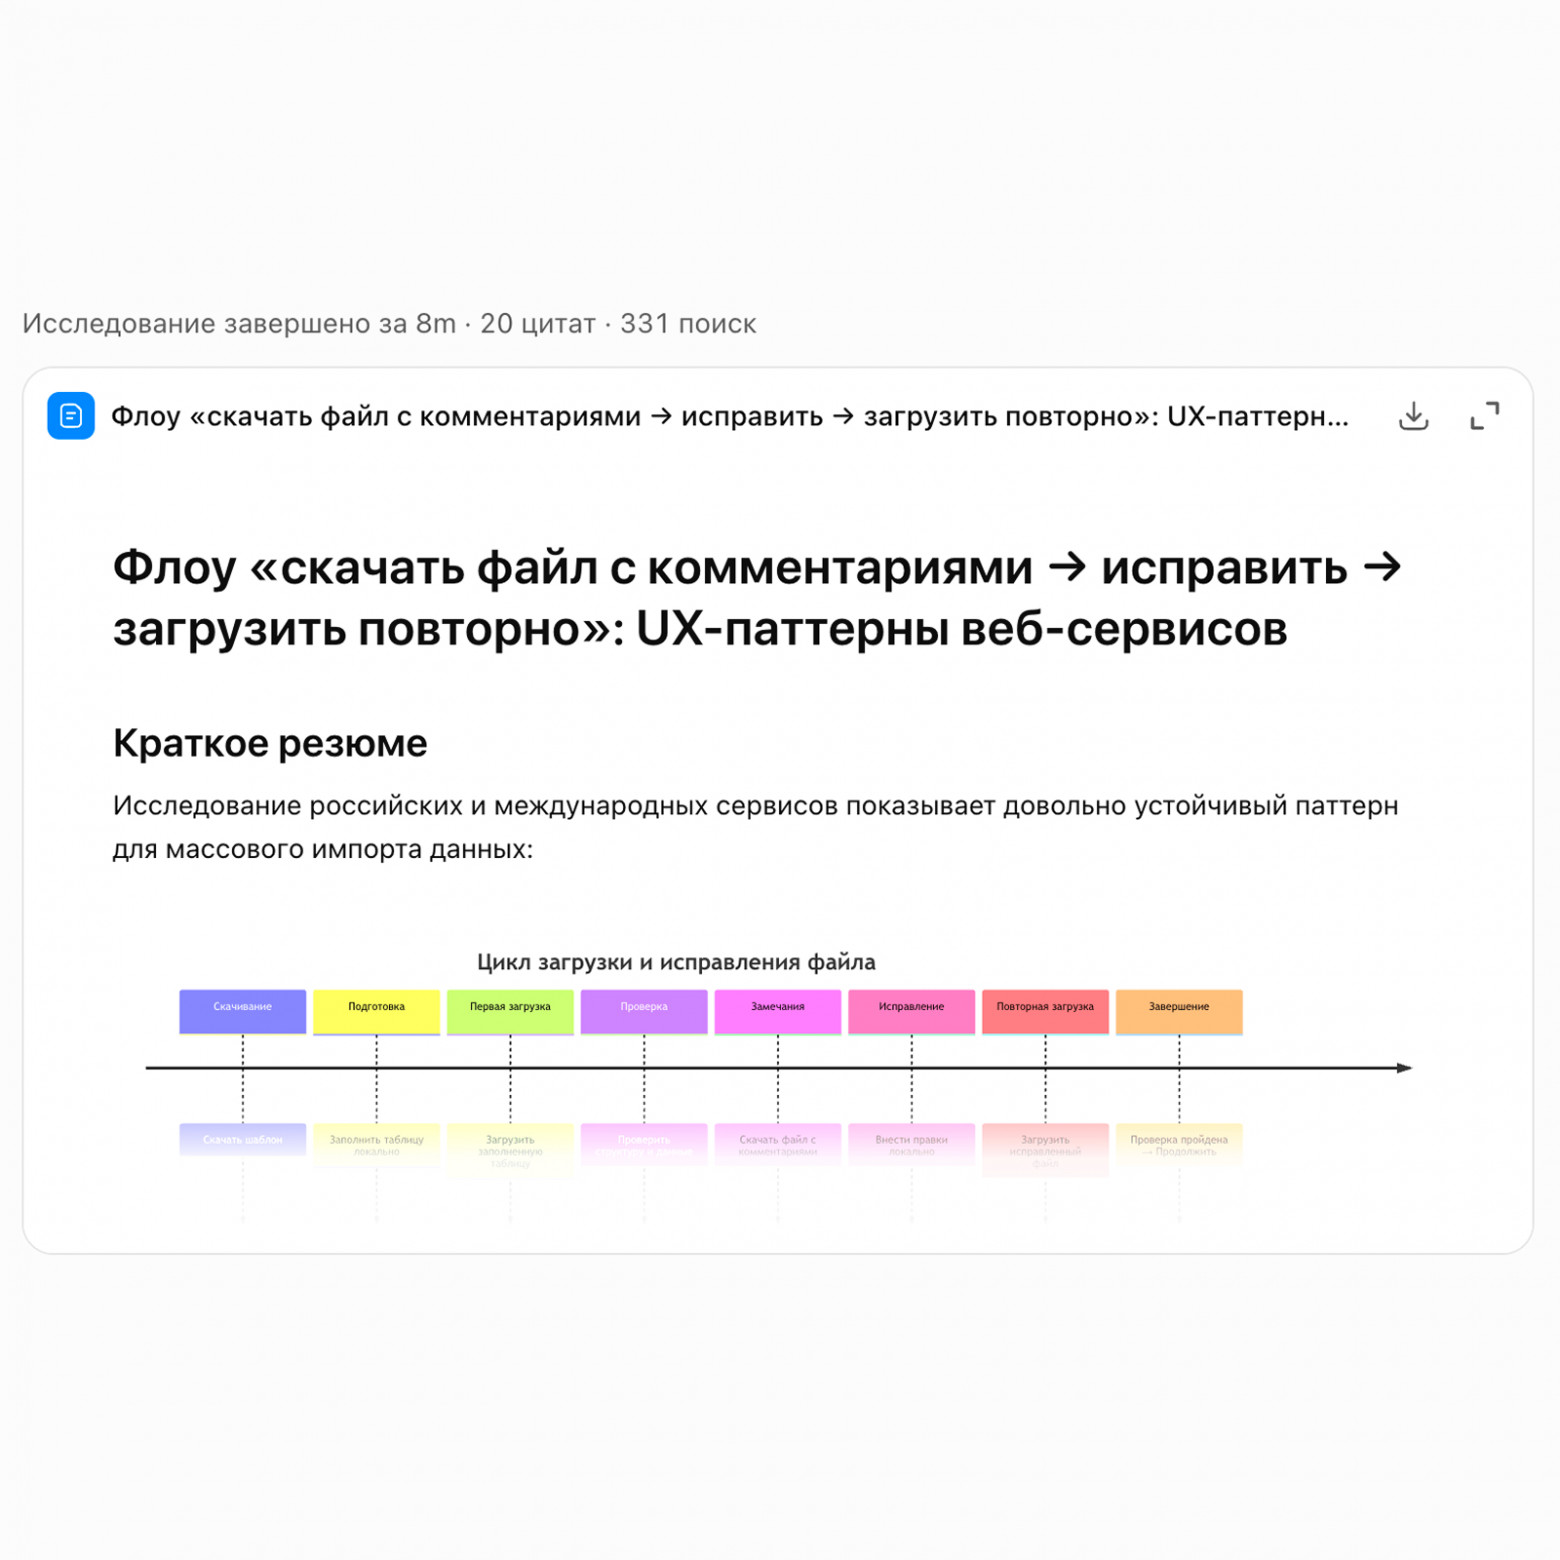
Поэтому подключаю ChatGPT с Deep Research. Расширяю запрос: теперь меня интересуют любые продукты, где пользователь массово загружает данные через CSV/XLSX и затем разбирается с ошибками.
Главное здесь — подробно описать задачу и заранее определить, что хочется получить на выходе. Перед исследованием прошу ИИ задать мне вопросы, если ему не хватает контекста. Конкретизирую желаемый результат: хочу получить подробное описание процесса исследования и сравнительную таблицу, которая покажет, какие подходы используют разные сервисы, что происходит на каждом этапе массовой загрузки, как устроены валидация и работа с ошибками. Для каждого примера — ссылка на конкретный флоу и краткое описание решения. В конце — выводы: какие паттерны встречаются чаще всего и что из этого можно применить в нашем сценарии. Отправляем Deep Research на поиски и идём заваривать чай ☕
Подходящий паттерн в неожиданном месте
В результате исследования находим гораздо более близкий к нашей задаче сценарий — массовую загрузку карточек товаров на маркетплейсах: Магнит, Ozon, Яндекс Маркет и Wildberries. Подходы к обработке ошибок немного отличаются, но есть общий паттерн: если загрузка не удалась, сервисы предлагают скачать файл с ошибками, исправить их и загрузить таблицу заново.
При этом ошибки показывают по-разному: где-то для них создают отдельный лист в Excel, а где-то добавляют столбец с комментариями к каждой строке.
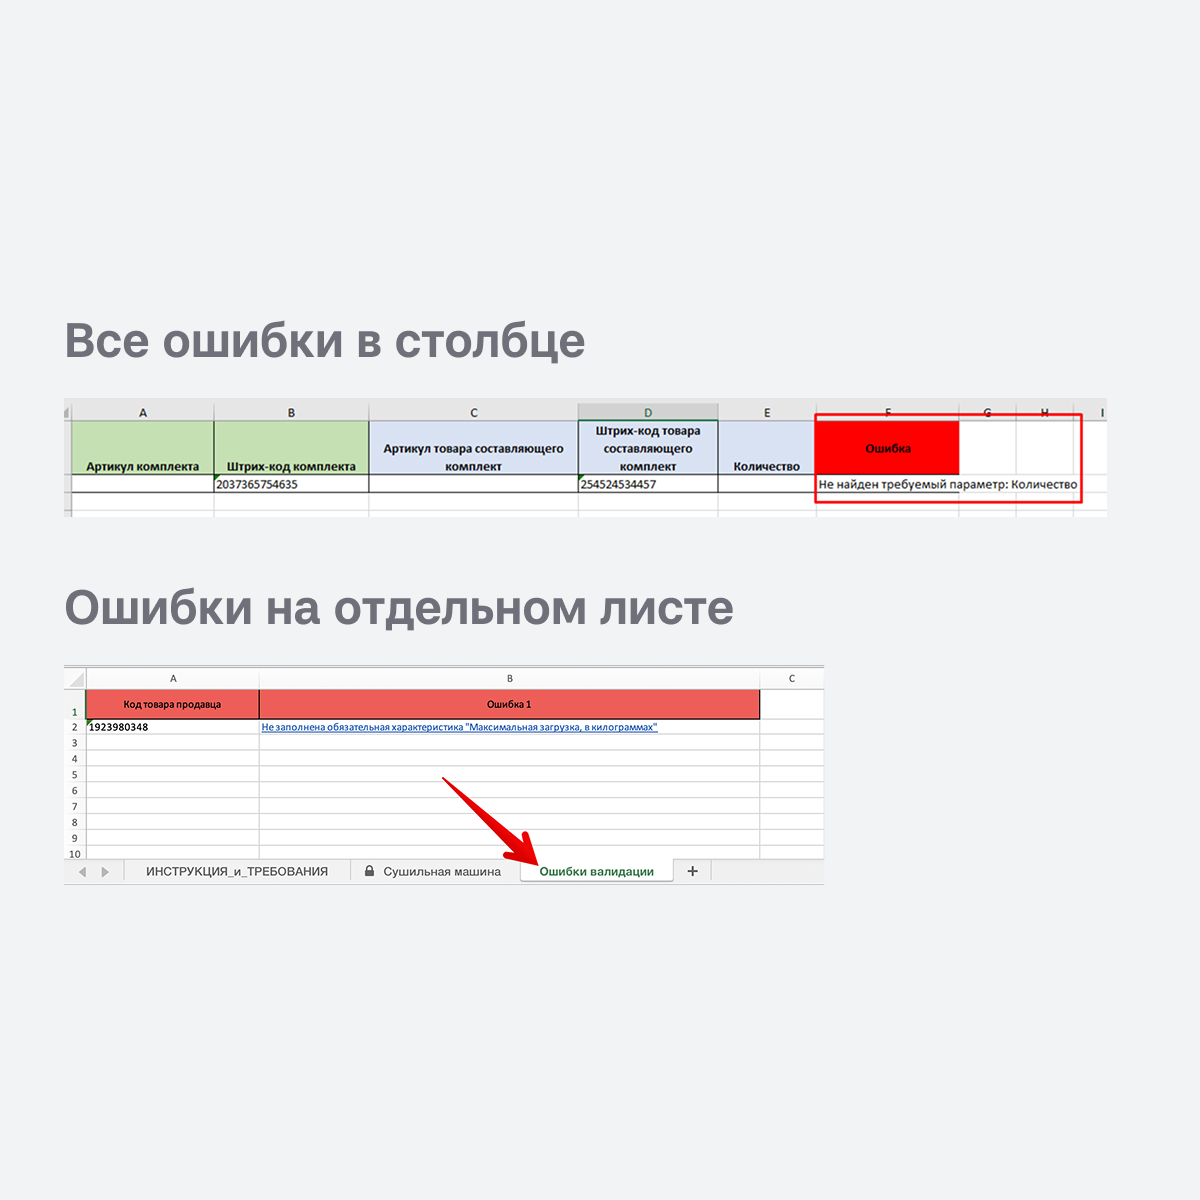
Оба варианта выглядят перспективно: пользователю больше не нужно переключаться между файлом и интерфейсом, чтобы найти и исправить ошибки. Это может сократить количество действий и повысить вероятность успешной загрузки. Берём этот подход в проработку. Но можно ли сделать его ещё удобнее?
Включаем нитро
С общей механикой определились — будем показывать ошибки прямо в таблице. Но как именно? Хочется посмотреть, какие ещё существуют подходы к отображению ошибок в табличных интерфейсах. Здесь на помощь приходит Mobbin — библиотека экранов и пользовательских сценариев из разных продуктов. Но искать вручную не хочется: непонятно даже, как сформулировать запрос. Ошибки в таблице? Валидация данных? Ошибки при массовой загрузке? Чтобы не перебирать десятки вариантов, подключаю Mobbin к ChatGPT через MCP.
MCP (Model Context Protocol) — открытый протокол, который позволяет ИИ-приложениям взаимодействовать с внешними сервисами. Благодаря MCP ChatGPT может обращаться к библиотеке Mobbin, искать подходящие экраны и показывать их прямо в беседе.
Главное преимущество — не нужно переключаться между сервисами и каждый раз объяснять задачу заново. ChatGPT уже знает контекст нашего исследования, требования и ограничения, поэтому может учитывать их при поиске. Остаётся сформулировать запрос. Здесь я снова стараюсь не ограничивать поиск конкретным решением, а описать задачу и то, что хочу получить.
Мой запрос выглядит так: Используй @Mobbin и найди примеры интерфейсов, в которых пользователю показывают ошибки при работе с таблицами и массовой загрузке данных. Меня интересует, как разные сервисы помогают находить ошибки, понимать их причины и исправлять данные. Не ограничивайся аналитическими продуктами и загрузкой CSV/Excel — рассматривай любые похожие сценарии в сложных веб-сервисах. Подбери 5–7 наиболее подходящих примеров. Кратко объясни, как устроено каждое решение. Если точных совпадений нет, найди близкие по механике примеры.
После этого ChatGPT обращается к Mobbin и находит конкретные экраны и пользовательские сценарии, которые можно изучить подробнее.
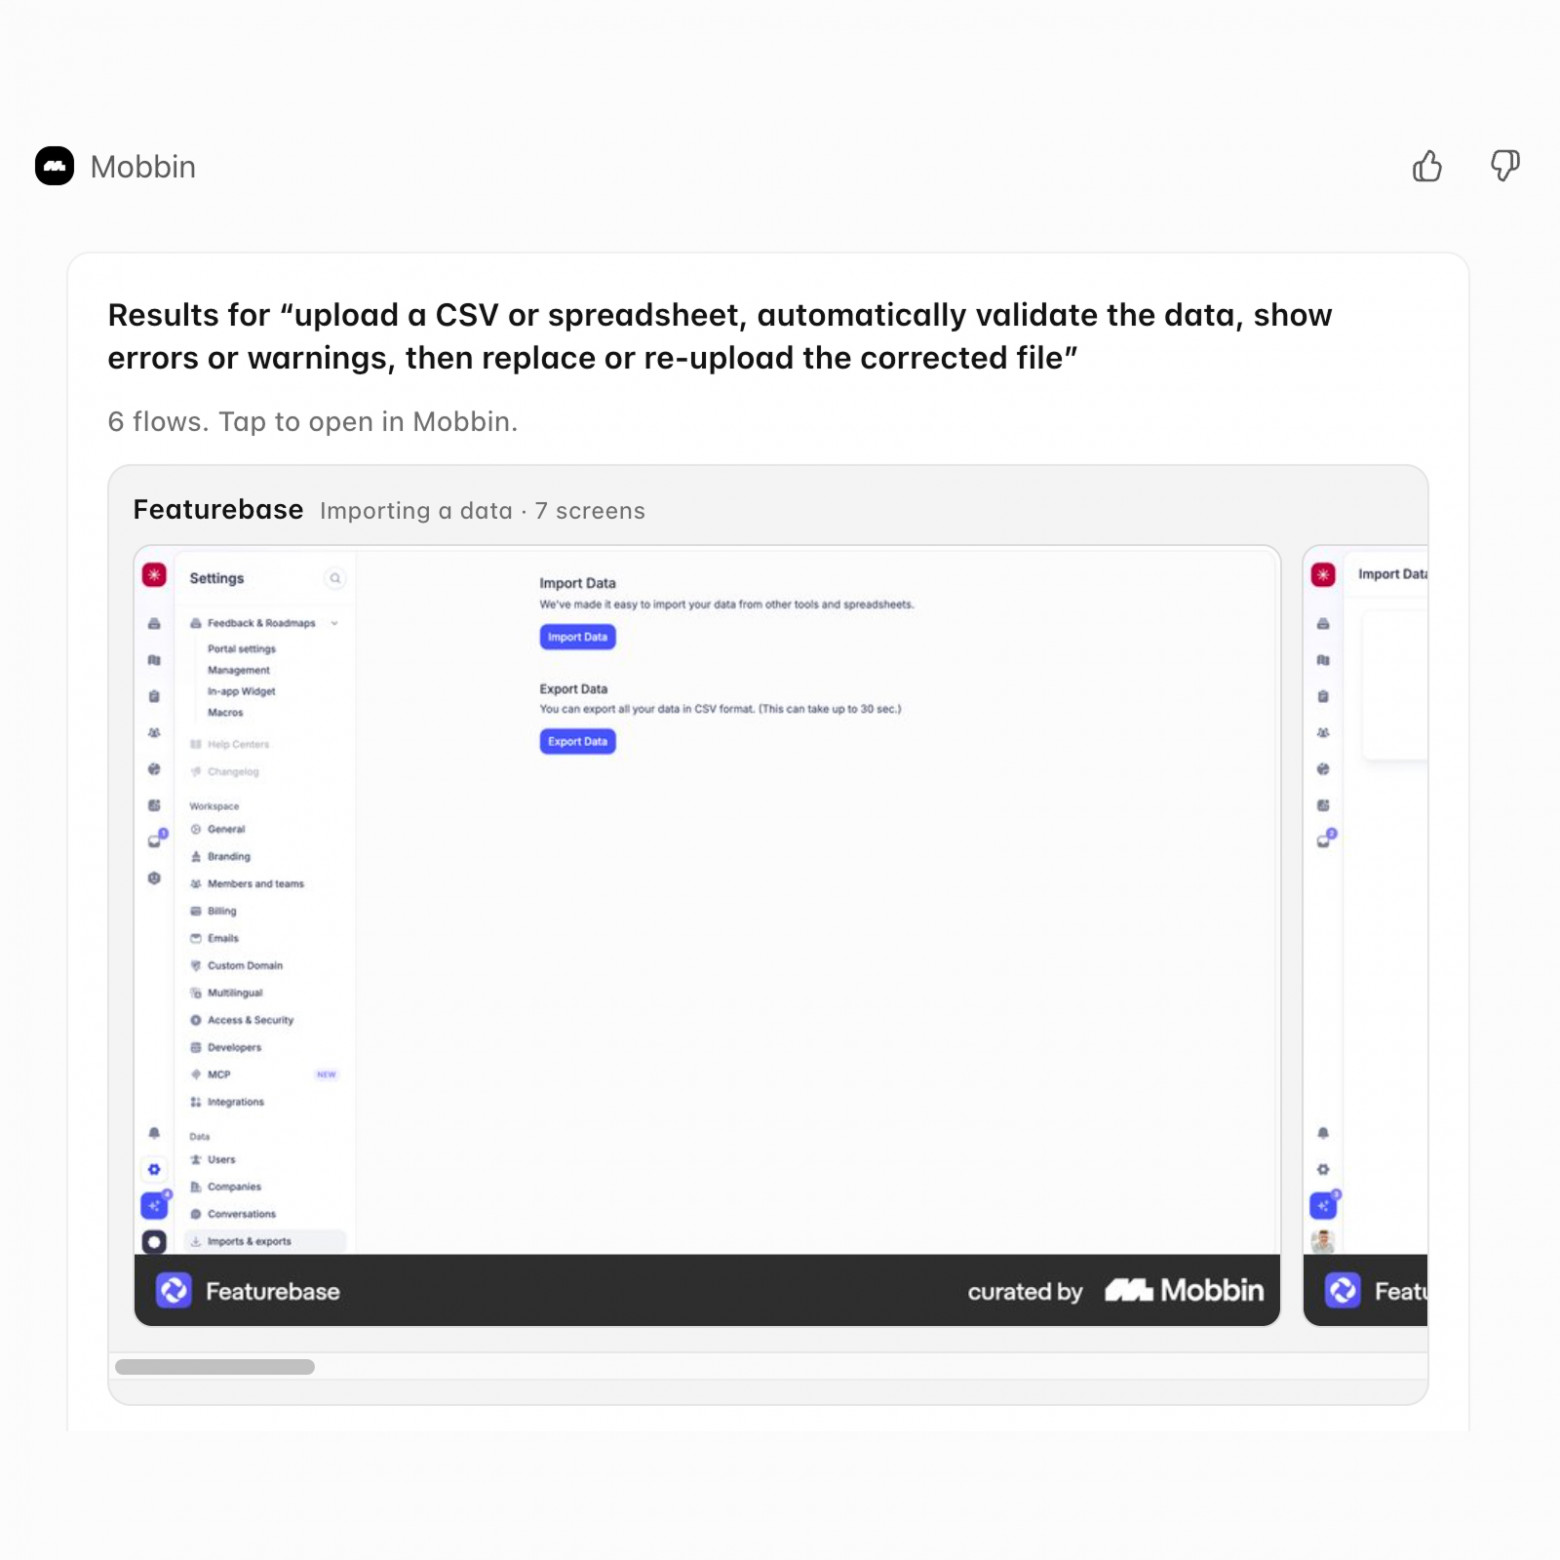
Остаётся сравнить найденные решения с нашими требованиями и выбрать подходящие паттерны. Среди референсов нахожу интересный вариант: подсвечивать ячейки с ошибками цветом, а пояснения к ним показывать в комментариях. Так пользователь сразу видит, где возникла проблема и что нужно исправить.
Сравниваем концепты
Чтобы понять, какой вариант действительно удобнее, мы сравнили несколько концептов и замерили, сколько времени требуется пользователю на поиск и исправление ошибки. Лучше всего показало себя решение с подсветкой ячеек и комментариями прямо в таблице — в среднем 11 секунд. Для сравнения: с ошибками на отдельной странице пользователи справлялись за 18 секунд, а с комментариями в отдельном столбце — за 23 секунды.
Но самая заметная разница получилась с первоначальным вариантом, где мы показывали ошибки в интерфейсе, а исправлять их приходилось в исходном файле. На ту же задачу уходило уже 32 секунды.
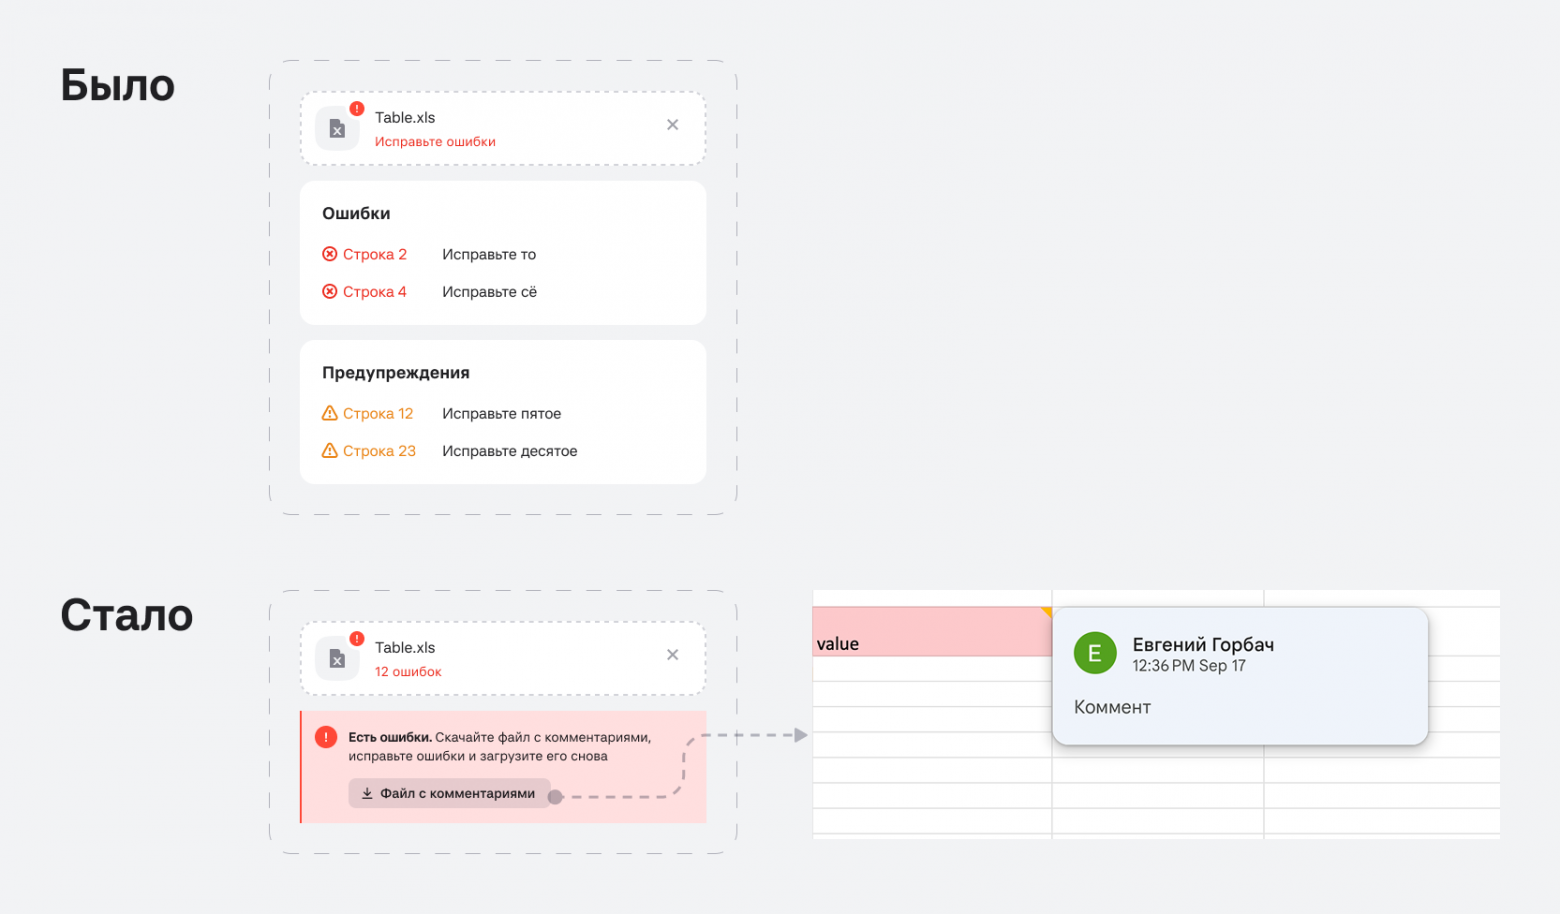
Рассчитываем, что после редизайна Каталога событий и переработки массовой загрузки пользователям станет проще добавлять события и работать с ними, а значит, и использовать Альфа-Метрику для анализа своих продуктов. Насколько наши ожидания оправдаются, узнаем уже после релиза, когда сможем оценить результаты по реальным продуктовым метрикам.
Что в итоге?
Получается довольно удобный подход к поиску сложных рефов. Если нужного сценария в готовом виде просто нет, не стоит пытаться найти его один в один. Гораздо полезнее разложить задачу на механику, понять, где ещё встречается похожий паттерн, даже в совсем другой предметной области, а уже потом через MCP быстро добрать конкретные визуальные примеры.
На этом всё. Надеюсь, этот подход пригодится вам в следующий раз, когда нужного референса не окажется под рукой.
Заглядывайте в мой телеграм-канал «Тултип». Там я делюсь тем, что сам пробую и использую в работе: разбираю кейсы, собираю полезные материалы, фреймворки и инструменты. Увидимся там!
А как вы ищете рефы для нестандартных задач? Делитесь своими секретными приёмами в комментах ✍️
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.