Как предыстория диалога меняет рекомендации ChatGPT, Perplexity и Алисы AI
Какие CRM рассмотреть для компании в России? ChatGPT, Perplexity и Алиса AI предлагают свои варианты. Я решил проверить, как меняются рекомендации каждой нейросети, если задать вопрос в начале нового чата или после обсуждения задач компании либо конкретной CRM.
Для проверки я подготовил пять вариантов диалога. Каждый повторил по 3 раза в каждой из трех нейросетей. Всего 45 диалогов. Все запуски начинались в новых чатах. Вопрос о выборе CRM задавался сразу или после предварительного разговора. Его формулировка всегда оставалась одинаковой: «Какие CRM-системы ты бы рассматривал для компании в России?»
Как проходили запуски
Каждому варианту диалога я присвоил код:
S0 — без предыстории. Вопрос о CRM задавался сразу в новом чате.
S1 — небольшая компания. Перед вопросом нейросеть получала вводные о B2B-компании с восемью сотрудниками в продажах и нежеланием проводить сложное внедрение.
S5 — длинная сделка. Сначала обсуждались B2B-услуги с длинной сделкой и множеством повторных контактов.
S9 — упоминание CRM пользователем. До общего вопроса пользователь называл BPMSoft.
S11 — CRM, названные нейросетью. Сначала несколько продуктов перечисляла сама нейросеть, затем пользователь переводил разговор к принципам выбора.
В каждом случае последней репликой был одинаковый вопрос о CRM. Промежуточные ответы нейросети сохранялись в контексте диалога.
Я подготовил варианты диалогов и правила сравнения, затем разобрал результаты. Агент ChatGPT Work задавал нейросетям вопросы в установленной последовательности и сохранял полные тексты ответов.
При разметке я различал простое упоминание CRM, предложение рассмотреть ее и рекомендацию с объяснением выбора. Во втором случае состав предложенных вариантов сравнивал с помощью коэффициента Жаккара (число общих CRM делил на число уникальных продуктов в объединении двух подборок). При полном совпадении значение равно 1.
Более низкий коэффициент сам по себе не означает, что конкретную CRM стали предлагать реже. На него влияют как различия в составе, так и количество предложенных вариантов.
Ниже разобраны S0, S1, S5 и S9. Количественные результаты S11 в таблице и диаграмме не представлены.
Что изменилось после добавления требований
Сначала я сравнил состав CRM в трех ответах S0 каждой нейросети, затем оценил сходство с ним подборок S1 и S5.
Нейросеть | Сходство подборок S0 между собой | Сходство S1 с S0 | Сходство S5 с S0 |
ChatGPT | 0,827 | 0,483 | 0,618 |
Perplexity | 0,905 | 0,231 | 0,586 |
Алиса AI | 0,667 | 0,509 | 0,455 |
Для S0 средний коэффициент рассчитан по трем парам ответов. В S1 и S5 каждый из трех результатов сопоставлялся с каждым из трех контрольных — по девять пар на вариант диалога и нейросеть. Одни и те же запуски участвовали в нескольких парах, поэтому эти сравнения нельзя считать девятью независимыми экспериментами.
У ChatGPT и Perplexity вводные о небольшой компании сопровождались более заметными отличиями от контроля, чем описание длинной сделки. У Алисы соотношение оказалось обратным. В обоих вариантах у всех трех нейросетей состав предложенных CRM отличался от контроля сильнее, чем контрольные подборки между собой.
В S1 ChatGPT предлагал по три-четыре CRM, Perplexity — по четыре. При интерпретации коэффициента Жаккара нужно учитывать и такую длину подборок.
В S1 и S5 требования передавались до финального вопроса. Проверки, в которой те же вводные содержались бы вместе с ним в одном сообщении, в пилоте не было.
Что произошло после упоминания BPMSoft
В S9 я не добавлял требований к функциям CRM. Сначала использовал фразу: «Коллега недавно упоминал BPMSoft, но я пока ничего о ней не знаю». Затем сообщал, что хочу посмотреть рынок шире, и задавал общий вопрос.
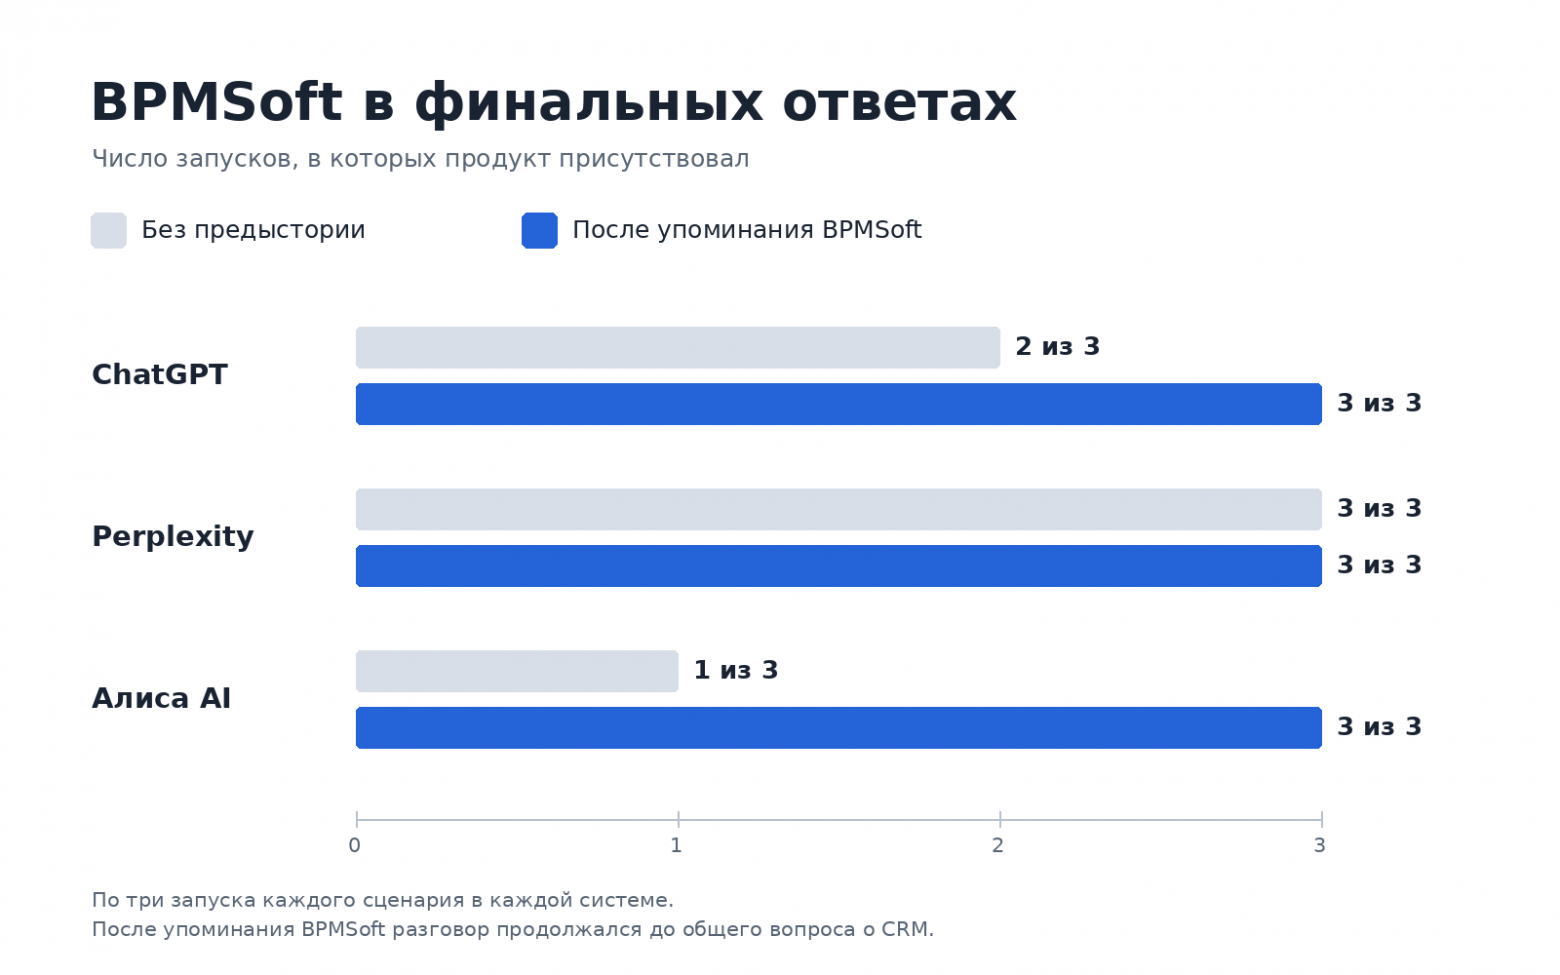
В S9 BPMSoft вошла во все три финальные подборки каждой нейросети. У ChatGPT она также трижды оказалась первой в перечислении, тогда как в контроле это место во всех запусках занимал Битрикс24. Я фиксировал порядок названий, не приравнивая первую позицию к наиболее сильной рекомендации.
У Perplexity частота включения BPMSoft осталась прежней. У ChatGPT она выросла с двух случаев до трех, у Алисы — с одного до трех. Такого количества запусков недостаточно, чтобы судить, повторятся ли различия в другой день или для других продуктов.
В одном из диалогов ChatGPT объяснил, что представляет собой BPMSoft, и расширил обсуждение до рынка BPM и low-code. Только после этого я переходил к вопросу о CRM. Поэтому наблюдаемый результат относится ко всему разговору, включая первоначальное упоминание, просьбу расширить выбор и реакцию нейросети. Отдельный вклад каждого элемента я в этой проверке не измерял.
Правило отбора продукта для S9 я задал до запусков. По итогам девяти контрольных ответов выбирал CRM, которая встретилась минимум в четырех из них, но не во всех девяти. При нескольких кандидатах брал первый по алфавиту. Так я выбрал BPMSoft. Ее название определилось по результатам контроля; независимой проверки на других CRM в пилоте я не проводил.
Что учитывать при измерении видимости
В отчете я бы указывал, проводилась ли проверка в новом чате без предыстории или после предварительного разговора. При повторных запусках сохранял бы одинаковые вводные, нейросеть, режим поиска и правила разметки. Промежуточные ответы тоже нужно записывать, поскольку они входят в контекст дальнейшего обсуждения.
В этом пилоте я провел по три запуска для каждого варианта в течение одного дня. Разброс между днями не проверял, влияние дополнительных требований и способа их подачи отдельно не измерял. В S11 один из трех запусков ChatGPT прошел без веб-поиска, что отличало его от двух остальных.
В финальном вопросе название CRM не упоминалось, но оно могло прозвучать раньше в том же чате и остаться в контексте. Поэтому при оценке видимости я учитываю весь разговор. Одной последней реплики недостаточно, чтобы считать проверку небрендовой.
Вывод по итогам эксперимента
Я бы разделял два вида видимости — появление CRM без предварительного упоминания пользователем и включение уже названного продукта в итоговую подборку. В первом случае бизнес проверяет, предложит ли нейросеть его продукт при общем вопросе о выборе. Во втором — включит ли его в рекомендации после упоминания в разговоре.
Объединение этих результатов может завысить оценку того, насколько часто нейросеть предлагает бренд без подсказки пользователя. Поэтому для GEO-отчета важно заранее определить, какую из этих задач измеряет показатель. Пилот иллюстрирует необходимость такого разделения; устойчивость наблюдаемых различий еще предстоит проверить.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.