Как заставить робота-уборщика проверять ценники: OrangePi, две камеры и немного “нечистых путей”
Привет, хабр! Решил поделиться интересным опытом по взаимодействию с роботом-уборщиком вместе с технологиями компьютерного зрения.
Представьте обычный продуктовый магазин. Несколько рядов стеллажей, тысячи товаров и примерно столько же ценников. Цены регулярно меняются, и после очередного обновления админ магазина должен убедиться, что на полке действительно висит та цена, которая сейчас находится в учётной системе. Но есть нюанс - проверять всё вручную долго, муторно и скучно.
Отсюда возникает довольно очевидная идея: а что, если пустить по магазину робота, который этот процесс автоматизирует?
Он едет вдоль стеллажа, останавливается, фотографирует полку, перемещается дальше. На сервере фотография обрабатывается, система находит ценники, OCR считывает информацию, после чего результат сравнивается с товарной матрицей магазина. Выглядит довольно просто. Оставалось только найти робота, который умеет всё это делать.
К нам на огонек заглянул Дикси и предложил своего робота PUDU CC1. Вообще-то это робот-уборщик, но для пилота решили использовать то, что было в магазине, и проверить, получится ли превратить его в мобильную платформу для съёмки стеллажей. Да и потом, если случится успех, не надо будет покупать нового четырехколесного “друга”. На момент нашего знакомства он, правда, находился на ответственном техобслуживании и был лишен нескольких важных для уборки частей (что не мешало ему просто перемещаться и имитировать бурную уборочную деятельность). Так начался наш совместный пилот с магазином «Дикси».
Первый подход к снаряду
Сразу оговоримся: целью пилота не было за несколько недель построить промышленного робота-мерчандайзера, готового автономно работать в тысячах магазинов. Мы хотели проверить более фундаментальную гипотезу: можно ли использовать автономную мобильную платформу как источник данных для автоматического аудита торгового пространства?
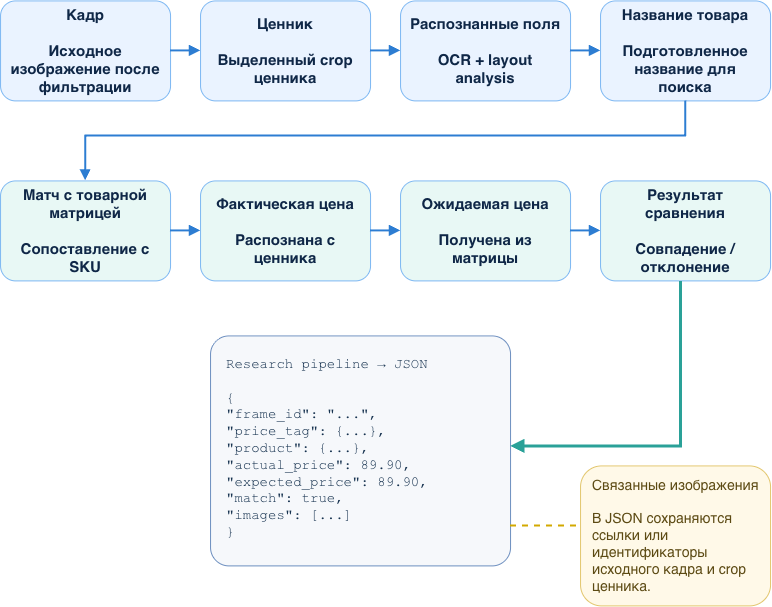
В нашем случае задача была сфокусирована на ценниках. В идеальном мире вся цепочка выглядела бы так:
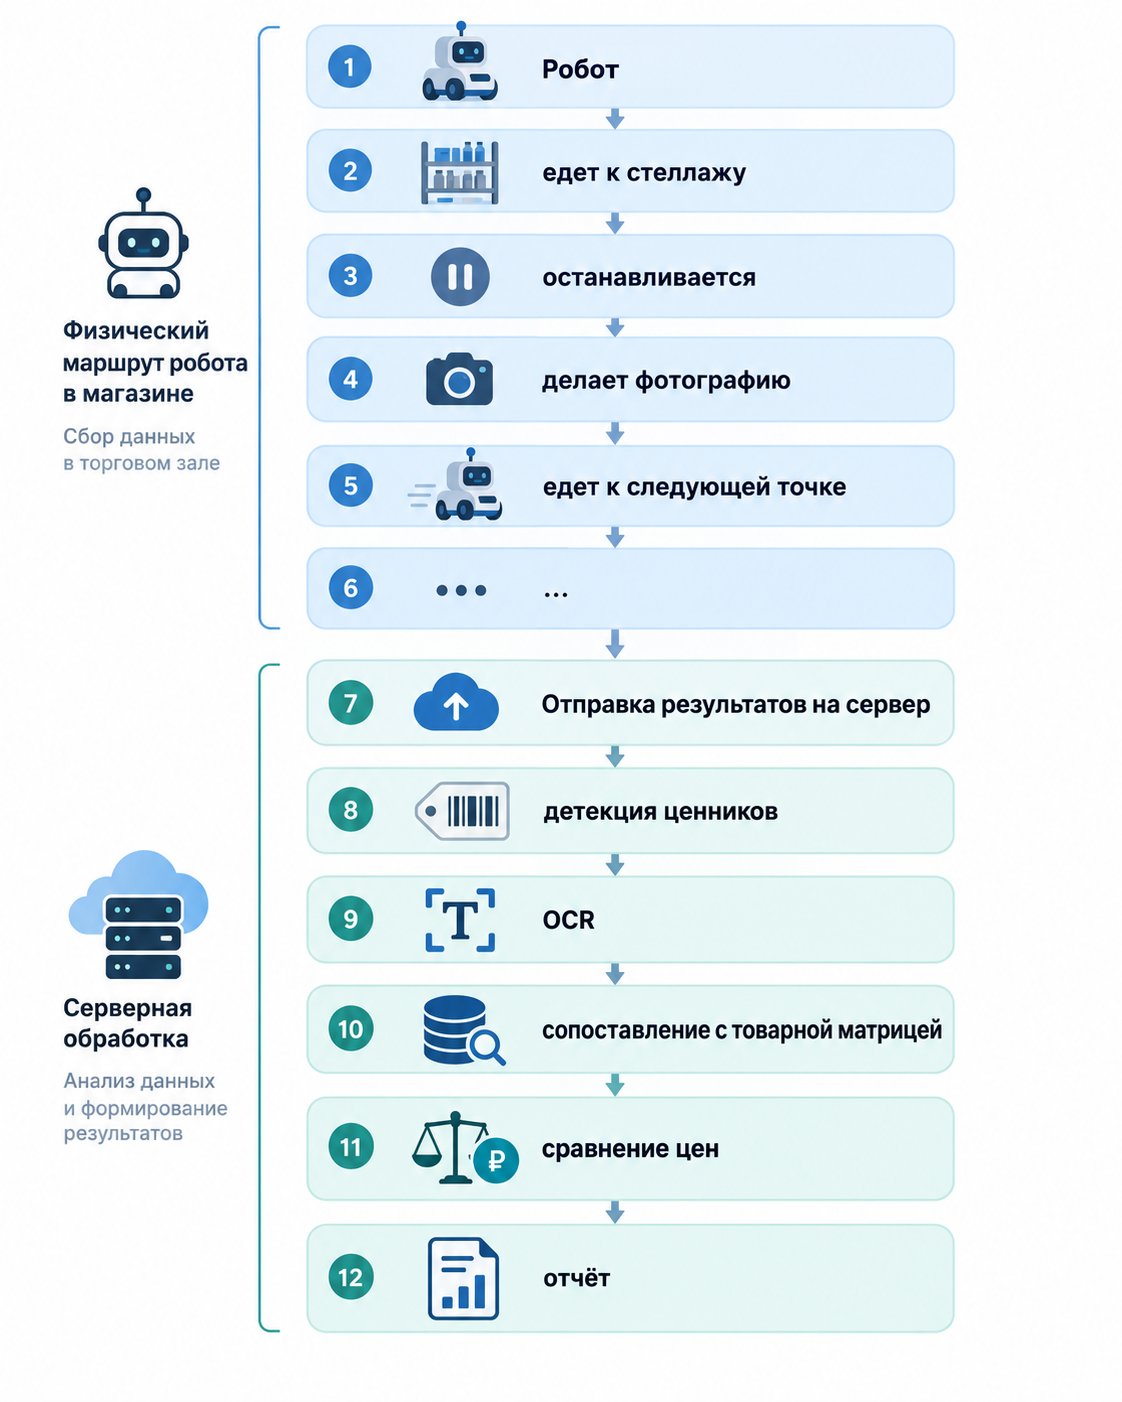
То есть робот должен был:
перемещаться между стеллажами по заданной нами траектории;
останавливаться в нужных точках;
получать качественные фотографии полок;
передавать их дальше на обработку.
Дальше начиналась уже наша привычная работа: компьютерное зрение, OCR и сопоставление результата с данными заказчика.
Проблема №1. Робот не очень хотел быть тем роботом, который нам нужен
Нам достался PUDU CC1 - в целом, для своих дней хороший робот, правда разрабатывался он не для нашего сценария. Это робот-уборщик, а не универсальная роботизированная платформа с API, на которой предполагается писать что-нибудь такое:
for shelf in shelves:
    robot.move_to(shelf.position)
    await robot.wait_until_stopped()
    camera.take_photo()
Если бы всё выглядело именно так, эта статья, скорее всего, закончилась бы через несколько абзацев. Но штатная логика CC1 устроена иначе. Ему гораздо привычнее сценарий:
Вот карта помещения -> Вот область -> Езжай и убирай
А нам хотелось:
Прокатись полметра к точке “А”, остановись, закинь по API в наш локальный сервис запрос на фото, дождись 200ОК и ползи дальше. Через полметра повтори еще раз. И так много раз подряд, пока не проедешь мимо всех стеллажей.
Причём желательно останавливаться именно напротив нужных частей стеллажа. И тут начались эксперименты с картой и маршрутами. До этого времени с таким классом роботов я дела еще не имел, поэтому пришлось познавать его богатый (нет) внутренний мир.
Немного "нечистых путей"
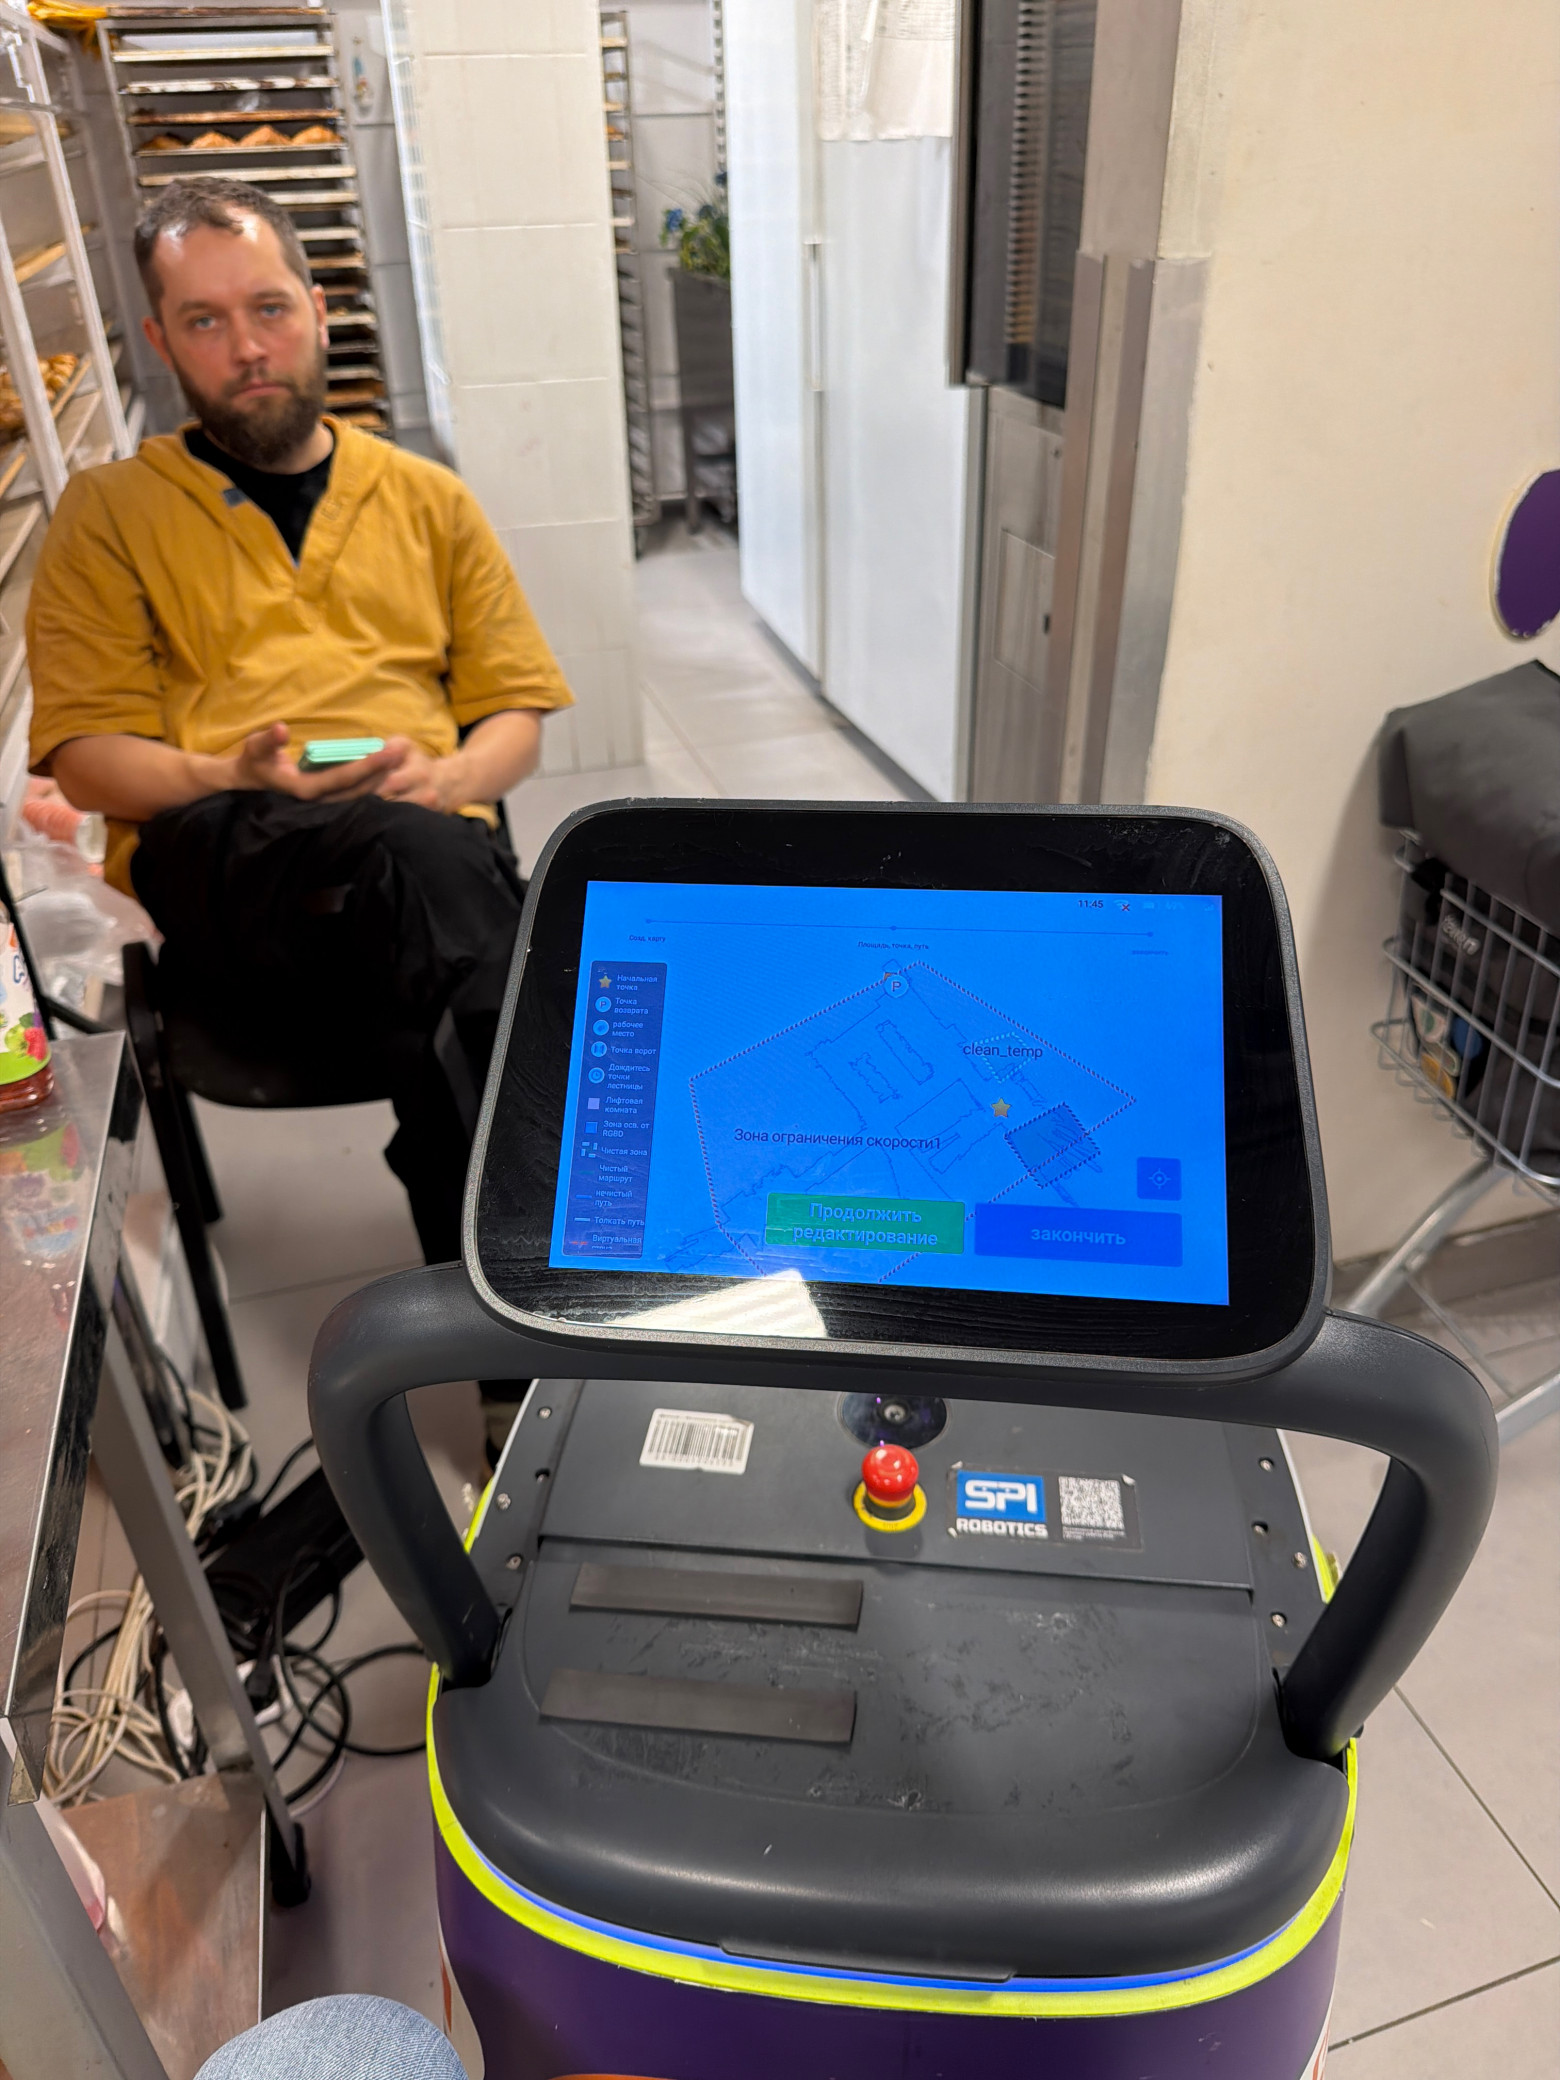
Начнем с того, что нам надо было ответить на вопрос - как этим роботом можно управлять. У меня дома есть классический домашний робот пылесос и у него нет возможности задать маршрут по линии. Но в случае с PUDU нам немного повезло - в интерфейсе есть разные типы маршрутов для уборки и перемещения. Нужный нам вариант в русской локализации назывался прекрасно: “Нечистый путь”.
Это тот случай, когда перевод интерфейса практически сам пишет за тебя заголовки для статьи. Нет, это не маршрут по особенно грязному участку магазина, в этом режиме робот просто следует по заданной траектории, не используя обычный сценарий уборки и по факту даже не убираясь за собой. И это именно то, что нам требовалось.
Но проблема с этим типом передвижения была в другом: если задать длинный маршрут вдоль стеллажа, робот его просто проезжал от точки А до точки Б. А нам нужны были остановки, поэтому маршрут пришлось нарезать на большое количество коротких отрезков.
Процесс выглядел примерно так:
Нажимаем «Создать путь».
Передвигаем робота примерно на 0,5 метра.
Нажимаем «Завершить».
Выбираем тип “нечистый путь”.
Сохраняем.
Создаём следующий.
Повторяем.
И повторяем… И ещё немного повторяем… В итоге участок вдоль стеллажа выглядел примерно так:
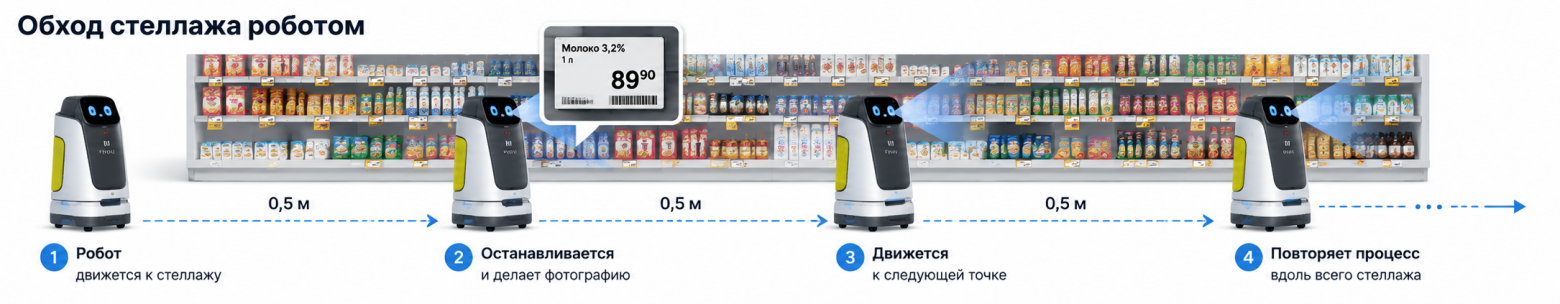
Таким способом мы добились нужного характера движения - робот перед каждым новым отрезком останавливался на секунду-две, а ведь это нам и надо для того, чтобы успеть сделать фото. Но оставалась ещё одна особенность - PUDU всё-таки помнил, что он уборщик и ему для успешного создания задания на такой проезд по магазину требуется настоящая заданная зона уборки. Без этого задание не создать. Пришлось добавить такую область на карту, причем сделать ее максимально небольшой (тут еще надо приноровиться и задать такую область, чтобы и роботу понравилось и, в то же время, он не залипал на уборку надолго).
Проблема №2. Робот остановился. А камера об этом не знает
Маршрут мы победили, но теперь возник следующий вопрос - как сделать фотографию именно тогда, когда робот стоит? Самое правильное, это интегрироваться с роботом так, чтобы он по API отправлял в наш сервис событие останова или перехода к следующему участку пути. Конечно, совсем по-правильному было бы реализовать полноценную интеграцию с этим роботом и управлять как перемещением, так и остановками. Но имеем что имеем. К сожалению, время на пилот было ограничено и пришлось дейстовать по ситуации.
Сначала был написан небольшой скрипт для OrangePI с камерой (про железки и ПО в пилоте речь пойдет чуть дальше), “модель для сборки” прикрепили на синюю изоленту (только ее надо использовать) к роботу и попробовали делать фото 4 раза в секунду, проезжая мимо стеллажа. Движение робота плюс выдержка камеры дают motion blur, а мелкий текст на ценнике довольно быстро превращается из OCR-задачи в тест Роршаха. Поэтому на данном этапе мы для себя подтвердили гипотезу, что фотографировать в движении - идея плохая. Ок, едем дальше (в случае с нашим роботом едем с остановками).
Можно было продолжить исследовать внутренности PUDU и пытаться каким-то способом достать информацию о его состоянии, добиться доступа по API, но мы вспомнили, что делаем пилот и решили максимально упростить задачу. Было решено написать скрипт/решение так, чтобы камера делала фотографии с заданной периодичностью независимо от того, что делает робот. Да, это супер избыточно, большая часть кадров гарантированно бесполезна. Но зато такой подход практически невозможно сломать. Приблизительная оценка в пилоте на 1 прогон робота по заданному маршруту - около 500 фотографий, из которых:
робот стоит
на каких-то уже тронулся
где-то камера смотрит прямо на стеллаж
где-то попала на переход между секциями
Дальше задача была уже интереснее - выбрать нужные фото и отправить на распознавание. Но обо всем по порядку.
Роботу нужны собственные глаза
Использовать камеры самого PUDU для нашей задачи мы не могли (качество, расположение, доступ), поэтому решили собрать отдельный модуль. В качестве платформы выбрали OrangePi 5B, к которой нужно было подключить камеру, питание и каким-то образом закрепить всю конструкцию на чужом роботе. Минимальный комплект выглядел так: OrangePi, powerbank для питания, камера (тут предстояло еще решить, использовать готовые решения или купить модуль камеры и играться с ним).
MIPI CSI 30PIN. Что могло пойти не так?
Первыми мы купили две камеры на матрице IMX415 с интерфейсом MIPI CSI 30PIN с разными характеристиками, чтобы выбрать более подходящую. На бумаге идея выглядела логично: Orange Pi + IMX415 по MIPI CSI = рабочий прототип с камерой, но реальность предложила другую формулу: Orange Pi + IMX415 по MIPI CSI = ничего.
OS OrangePi камеры просто не видела. Я попробовал сначала один модуль, затем второй. Проверял подключение и настройки, причем родная камера OrangePi нормально отрабатывала. Тут я перечитал несколько десятков страниц разных форумов, попробовал разные предложенные варианты с драйверами и “пропиской” модулей в Linux. Результат оставался прежним. Конечно, можно было продолжить погружение в драйверы, device tree, конкретную распиновку платы, поддержку сенсора ядром и особенности конкретной ревизии OrangePi. И это вполне могло стать отдельным инженерным исследованием, но у пилота была дата начала и, что самое примечательное, срок :)
Поэтому вместо того, чтобы обязательно победить MIPI CSI, я решил убрать этот вариант из прототипа (оставил на “потом разобраться”) и заказал ещё две таких же камеры, но на этот раз с USB подключением. И, конечно же, они заработали.
Наверное, здесь сформулировался один из главных принципов подобных пилотов:
Цель пилота — проверить гипотезу, а не выиграть каждую техническую войну, которая встретилась по дороге.
В серийном устройстве команда и я, возможно, продолжили бы разбираться с CSI. Здесь же было важнее получить фотографии из магазина как можно быстрее и дешевле.
8 Мп против 12 Мп
В итоге у нас оказалось две USB-камеры с немного отличающимися характеристиками - 8 Мп и 12 Мп. У камер отличалась в том числе и оптика, поэтому в тестовых прогонах использовали обе и это оказалось достаточно полезно. Для задачи распознавания мелкого текста количество мегапикселей само по себе ещё мало что гарантирует. Здесь важны: расстояние до полки, угол обзора, оптика, размер ценника в пикселях, экспозиция, резкость. Я менял параметры камеры, смотрел реальные фотографии, снова менял настройки и запускал следующий проход. Особенно внимательно смотрел на мелкий текст - кадр мог выглядеть для человека абсолютно нормальным, но стоило приблизить ценник, и становилось понятно: алгоритму там уже практически нечего читать. Дополнительно, я решил пойти в реальный магазин и сделать несколько десятков фото в “реальных” условиях. Собрал прототип и почувствовал себя Джеймсом Бондом - отдельная задача была в фотографировании так, чтобы тебя не "приняли" охранники.
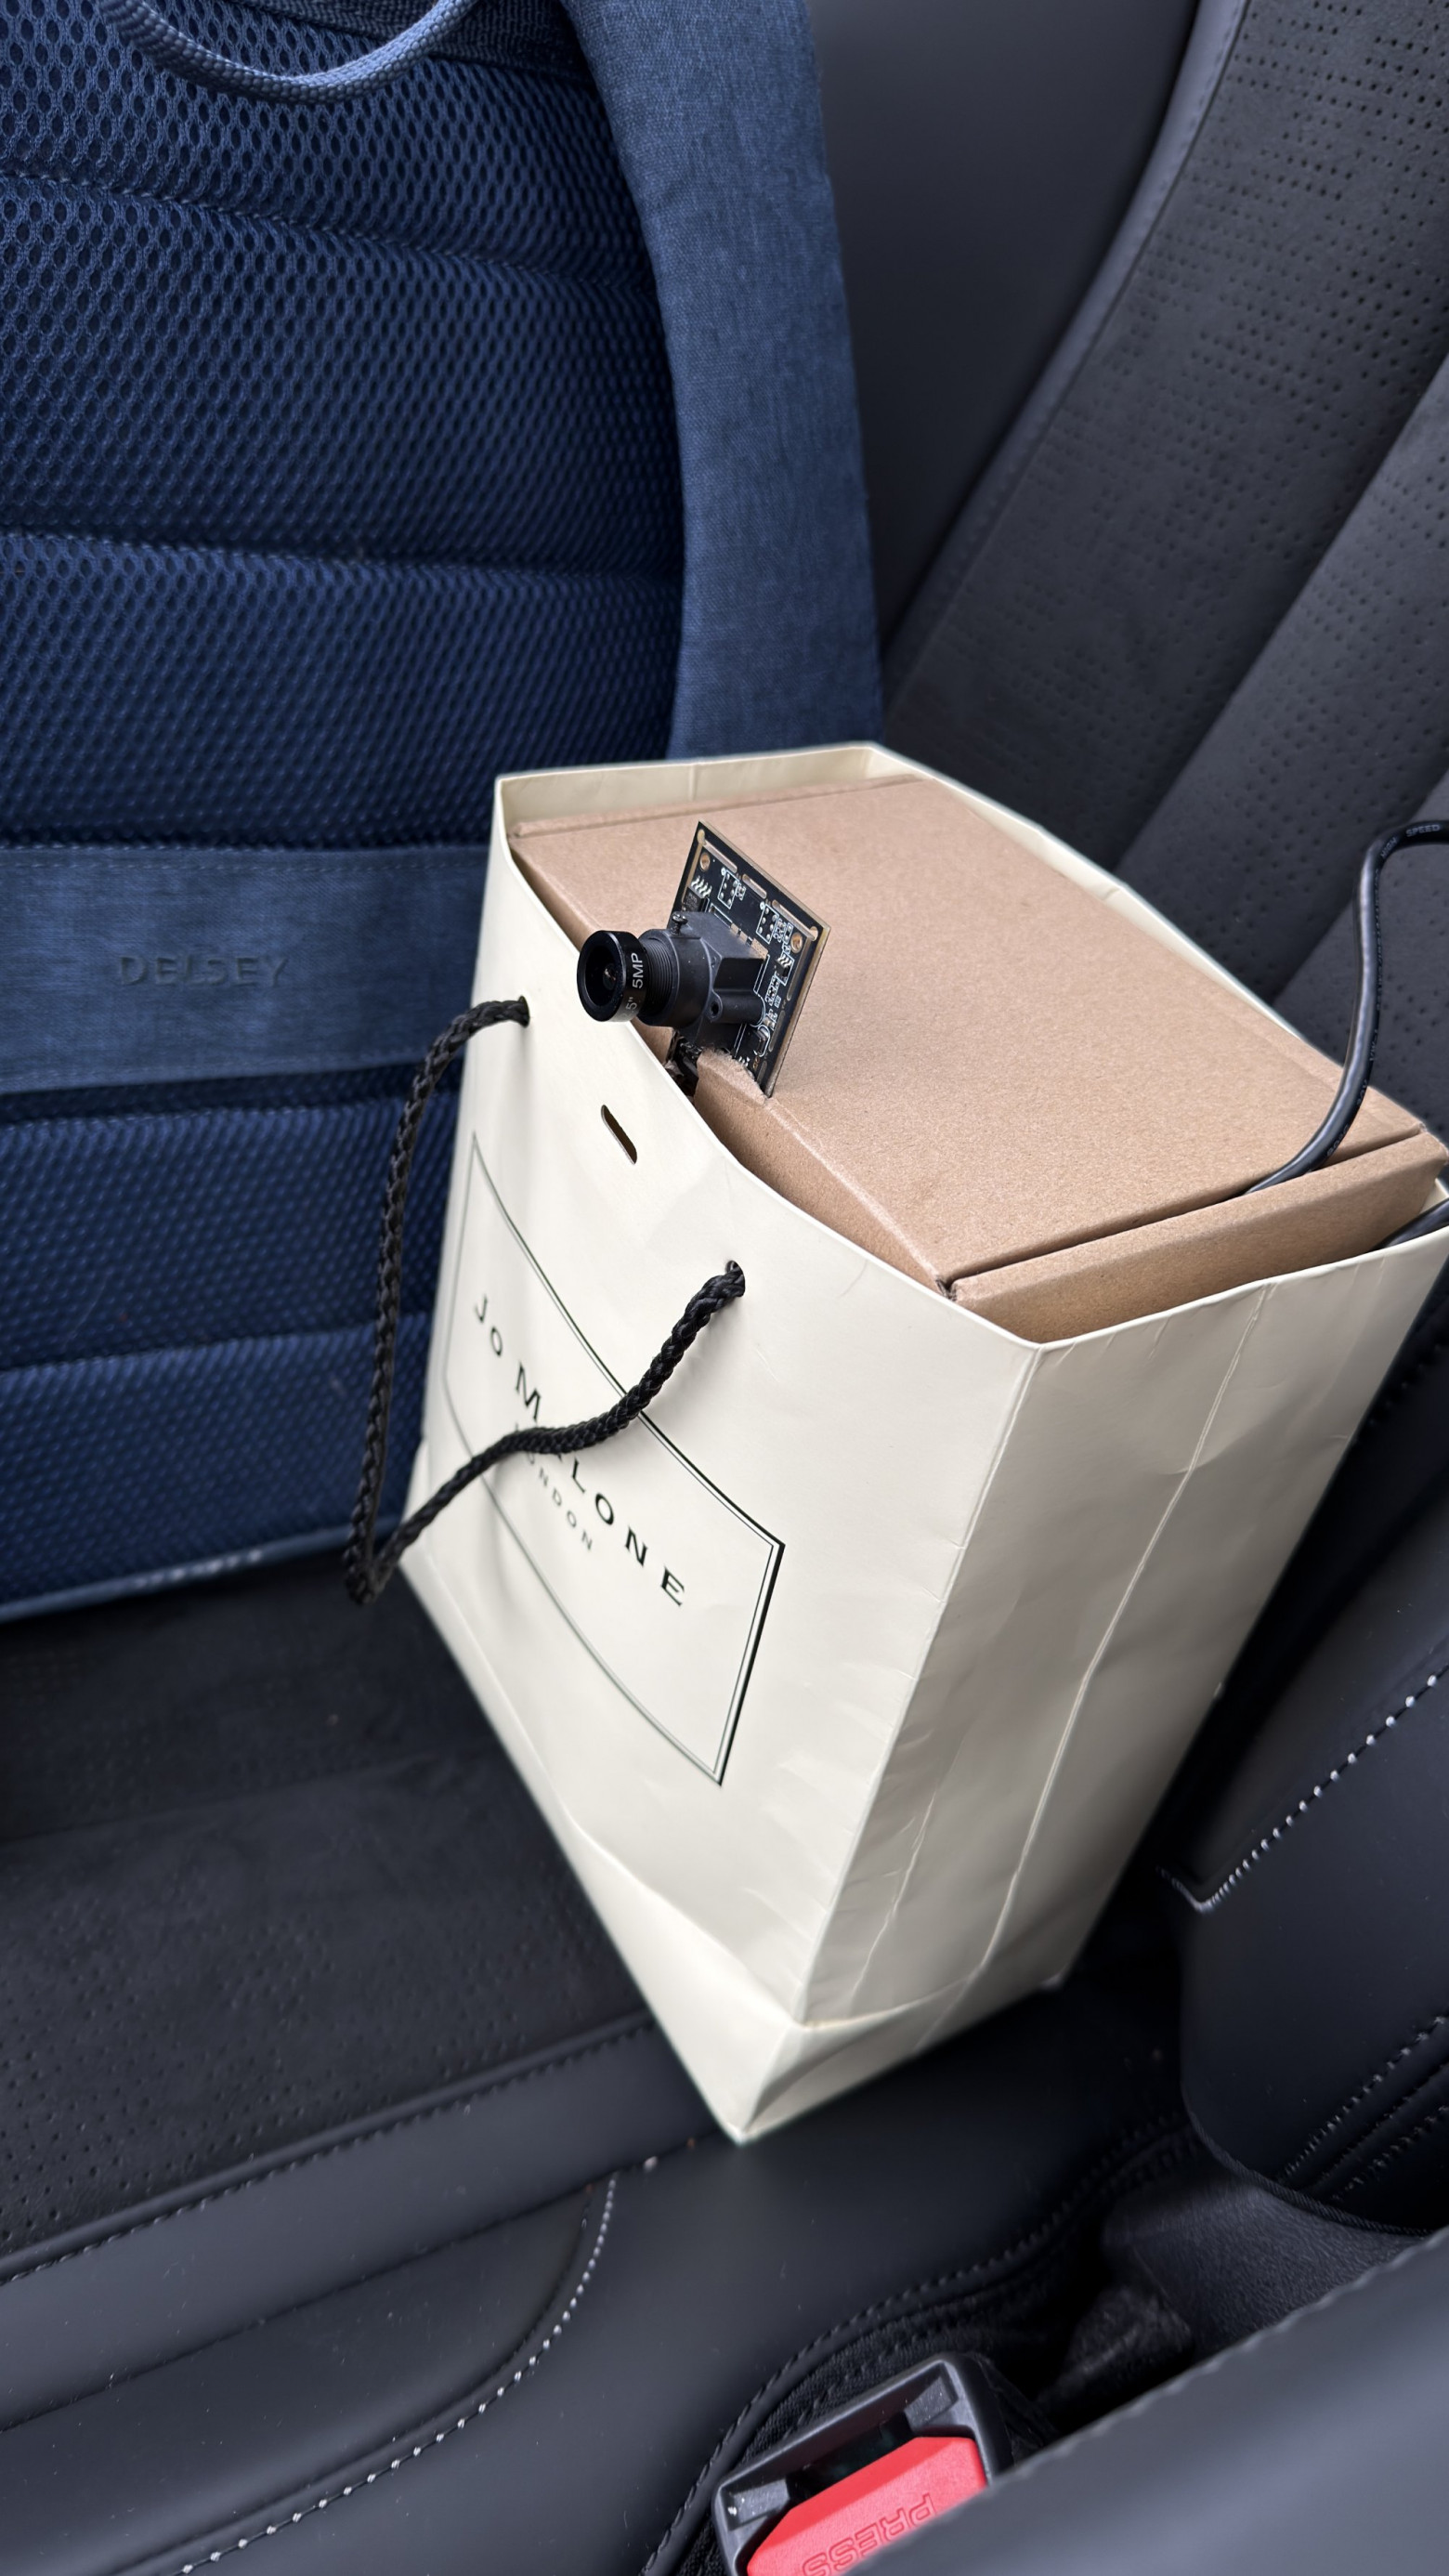
Прогон в офисе - это прогон в офисе, а запуск в магазине - “это другое” (офисный потолочный свет и освещение торгового зала - две совершенно разные среды), поэтому окончательно настройки камеры всё равно пришлось подбирать уже непосредственно на месте.
По итогам тестов в офисе и магазине 12-мегапиксельная камера показала себя лучше, хотя с точки зрения настройки самих параметров камеры именно у этой оказался какой-то баг, при котором выставляя, например, яркость, менялась выдержка (привет китайцам 🙂).
Делаем своего собственного Франкенштейна
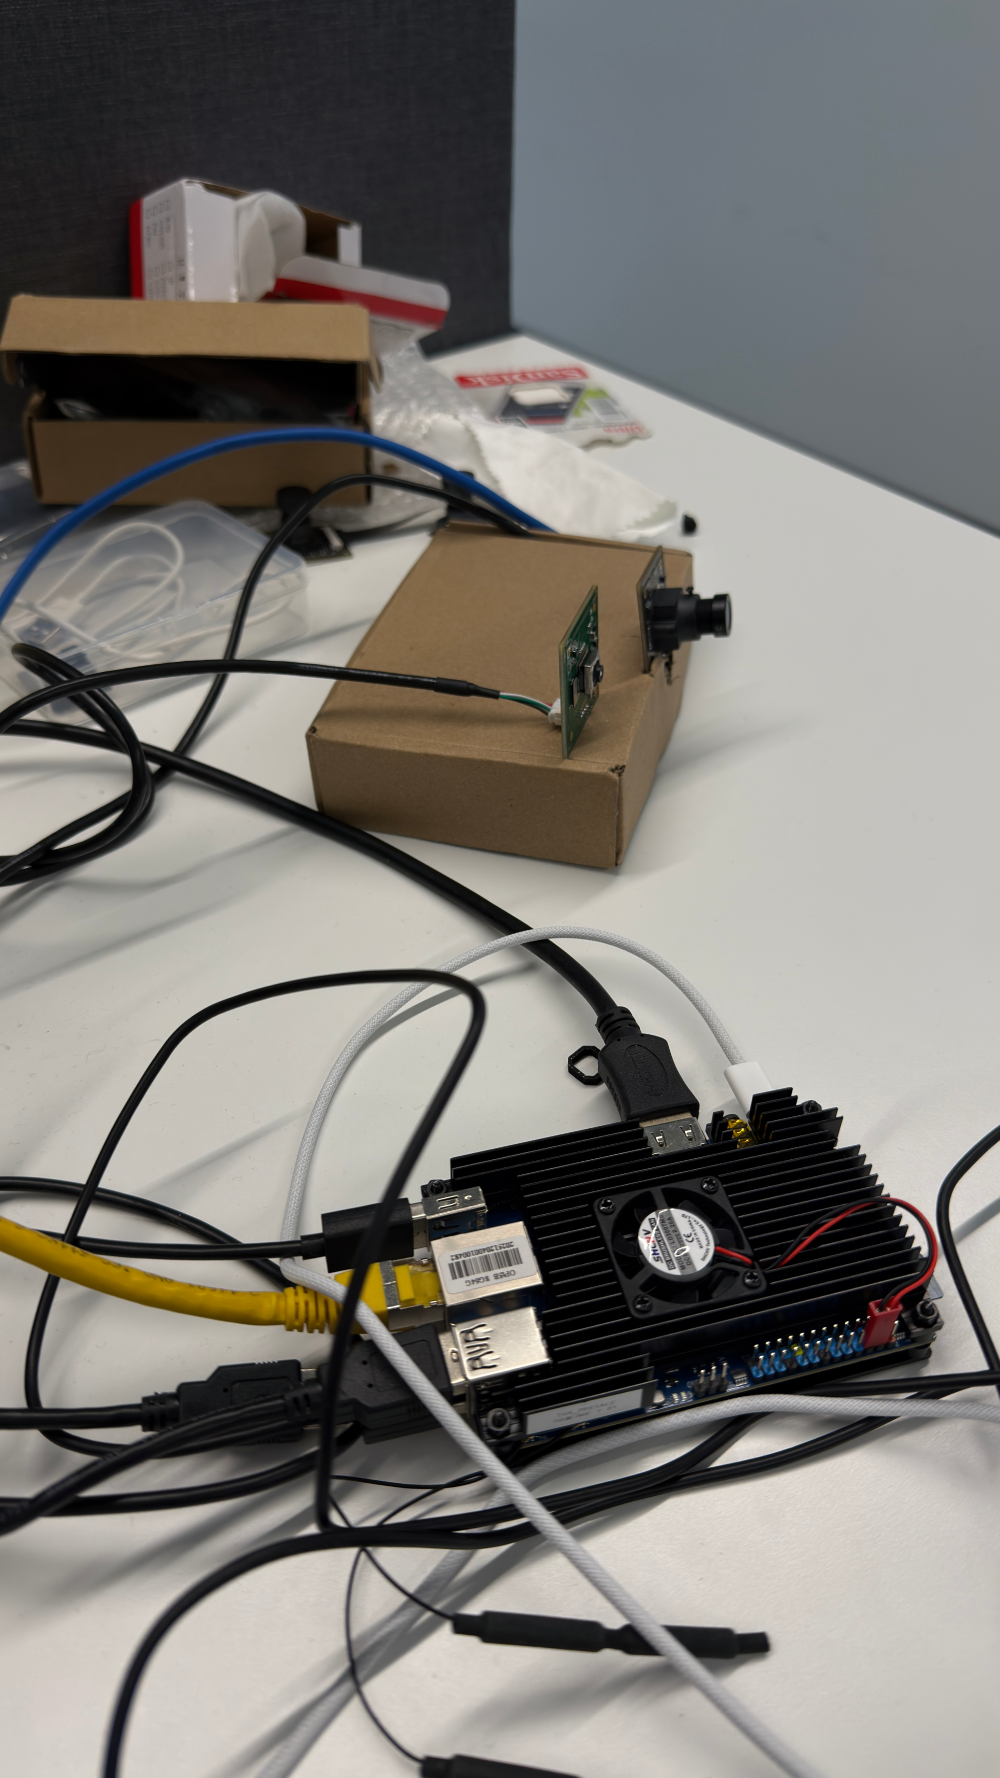
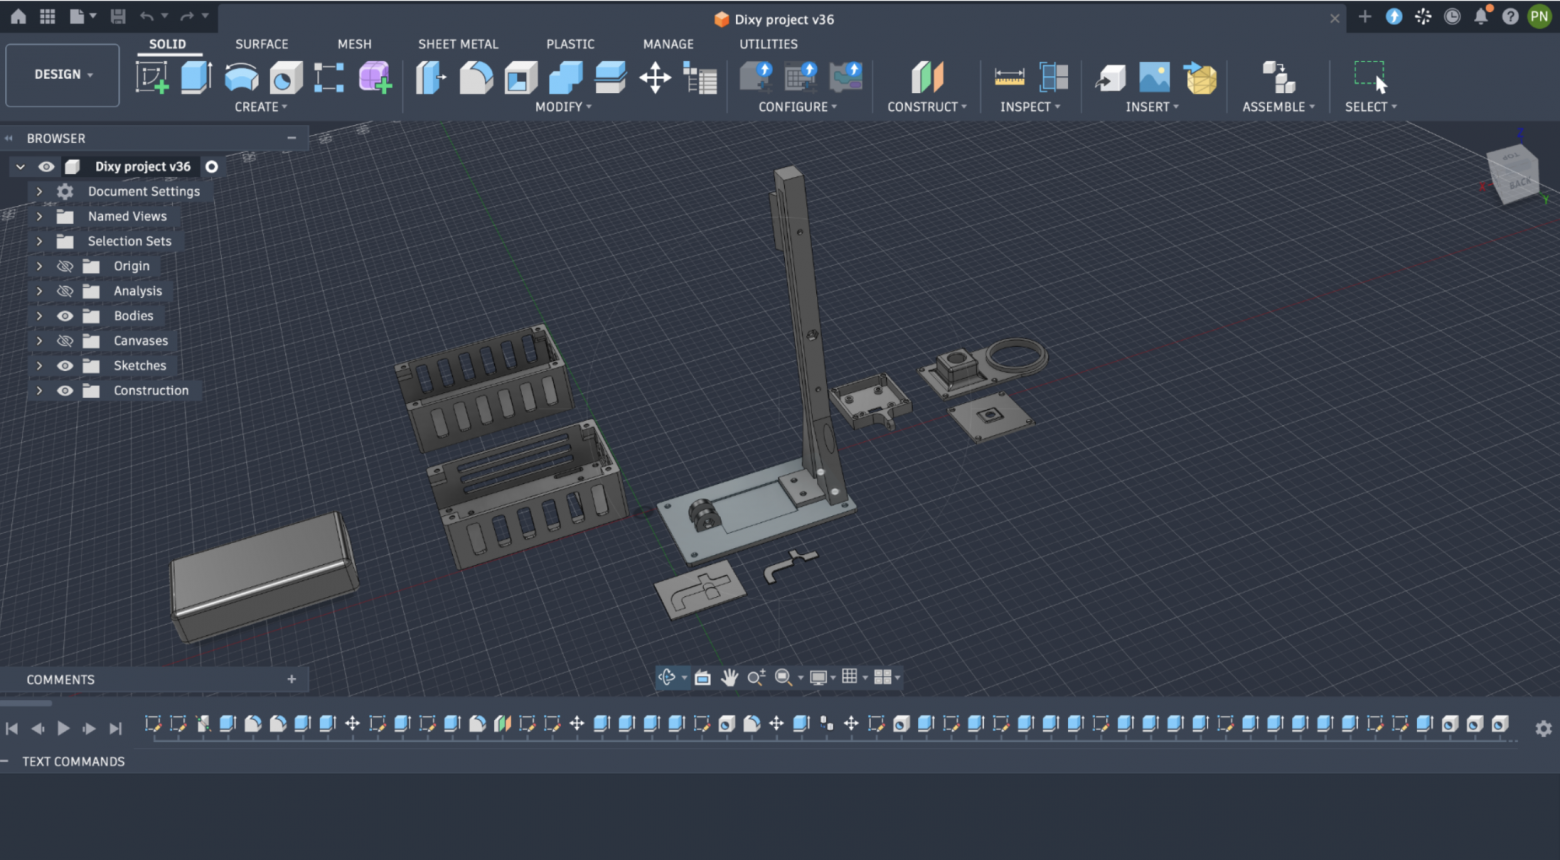
Хотелось, чтобы “девайс” всё-таки напоминал устройство, а не лабораторный стенд из плат, проводов и изоленты, поэтому для него отдельно пришлось спроектировать корпус.
Внутри нужно было разместить:
Orange Pi;
powerbank;
камеры;
соединительные кабели.
Сначала появилась 3D-модель (тут описывать процесс не буду, там все достаточно просто по геометрии и проектированию - штангенциркуль, размеры с китайских сайтов), потом корпус напечатал (благо у меня есть домашний 3D принтер Artillery Sidewinder X1), пару раз подгонял и модернизировал различные элементы корпуса, и в самом конце это все собрали.
После печати все детали в лучших традициях разложил на столе, чтобы сделать то самое красивое фото:
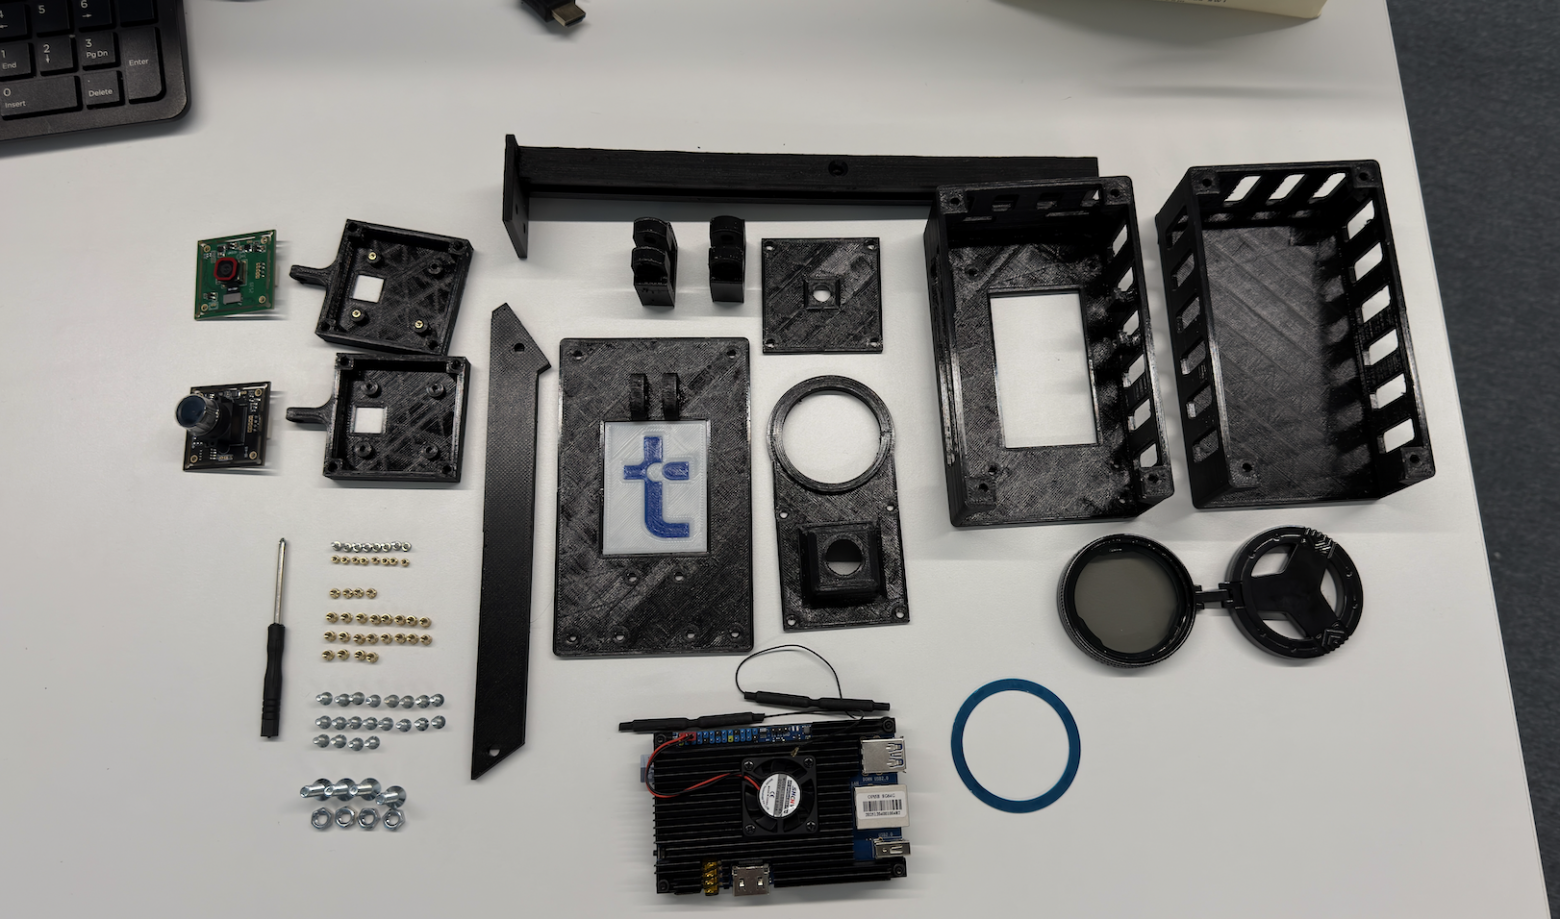
А в сборе девайс уже выглядел именно так:
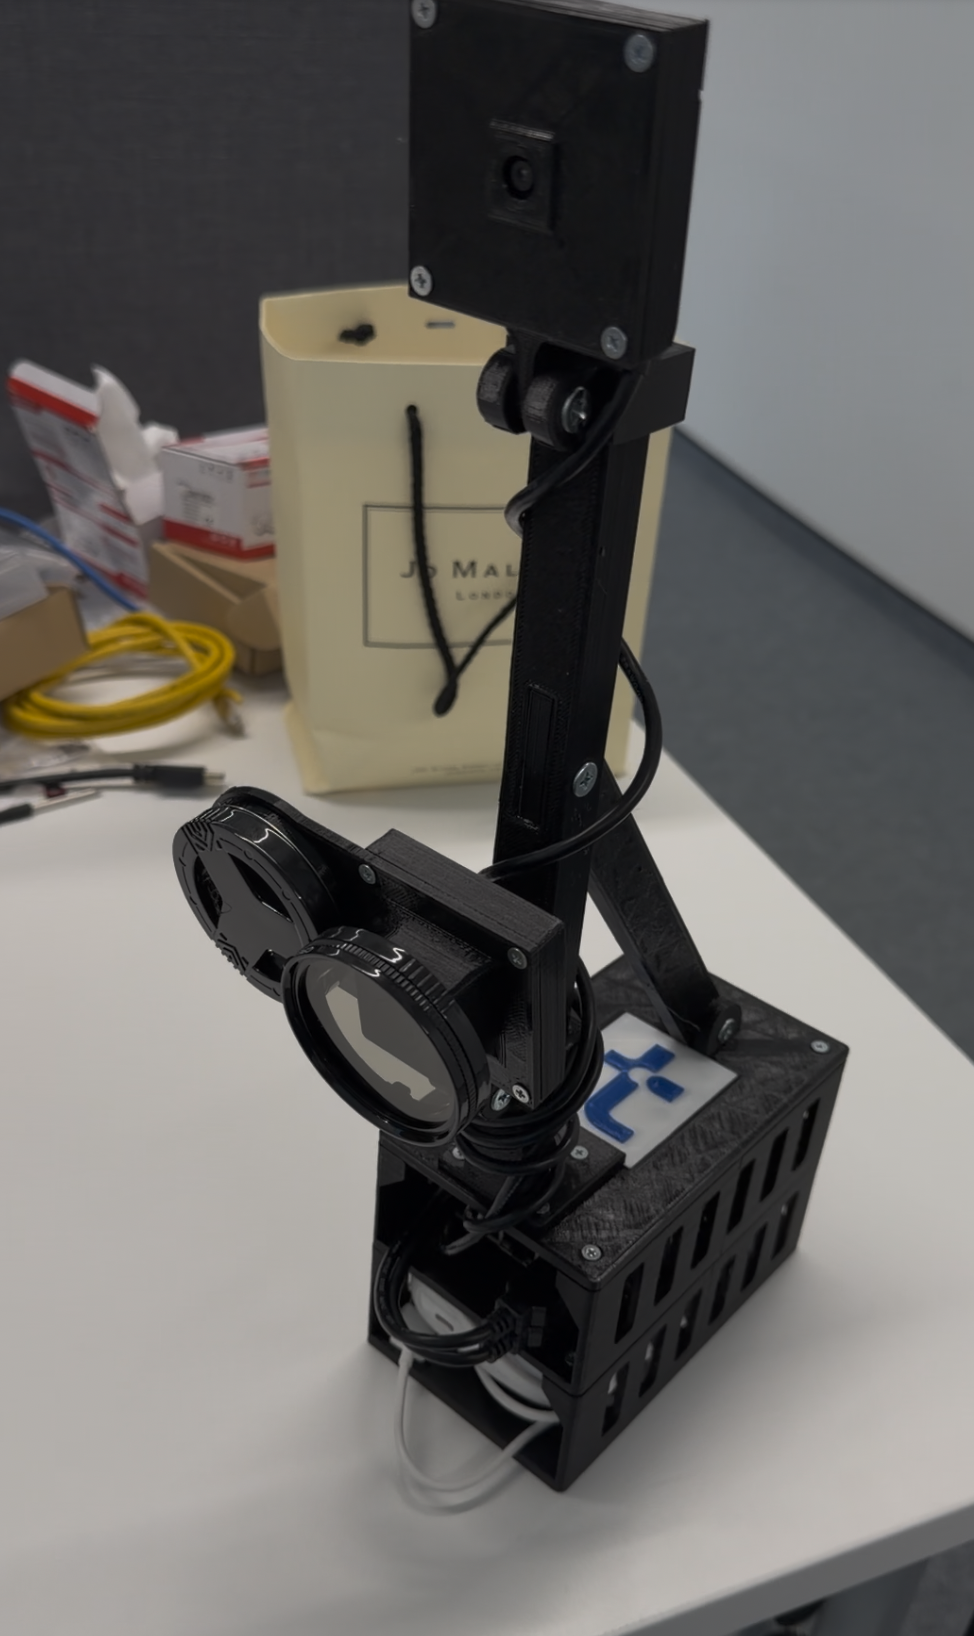
Python, Docker и OrangePi
Сначала концепция - я думал сделать микросервис, который локально делал бы пачку фотографий и затем, принудительно, при хорошем интернете отправлял бы их в другой сервис, находящийся в ЦОД нашего офиса, для дальнейшей обработки. Как известно, в магазинах сотовая связь может сбоить, 4g свистки плохо ловить, поэтому такой концепт казался надежным. Но удалось совсем упростить себе жизнь на данном этапе именно этого пилота и просто сделать микросервис, который делает много фотографий с определенными настройками (естественно, договорившись предварительно с Заказчиком). Как результат, получился небольшой микросервис на Python (куда же тут без легкого вайбкода), который имеет небольшой пул настроек и использует v4l2 для работы с кадрами с камеры. Фотографии автоматически сохраняются на ssd OrangePi с уникальными именами и распределением по каталогам. Для удобства мониторинга работы сервиса реализовал морзянку (шутка) - научил сервис управлять встроенным в OrangePi диодом для индикации работы сервиса и текущего шага. Условно - мигает раз в секунду красным, значит что-то пошло не так; мигает зеленым 1 раз коротким 1 раз длинным - все нормально, и т.д. При запуске сервиса его задача была максимально прагматичной:
подключиться к USB-камере;
получить изображение;
сохранить фотографию;
подождать заданный интервал;
повторить.
Если сильно упростить:
while True:
    frame = camera.read()
    if frame is not None:
        save_frame(frame)
    time.sleep(CAPTURE_INTERVAL)
Завернув сервис в docker (для пилота это оказалось особенно удобно), закинул его на плату и начал тестировать. В итоге Docker дал мне:
воспроизводимую среду;
простой запуск;
одинаковое поведение после перезагрузки;
понятную конфигурацию;
доступ к USB-камере через /dev/video*;
сохранение фотографий в примонтированный каталог.
Это был небольшой сервис, но он выполнял одну из ключевых функций всего пилота: превращал движущегося по магазину робота в источник последовательности фотографий.
Репетиция в офисе
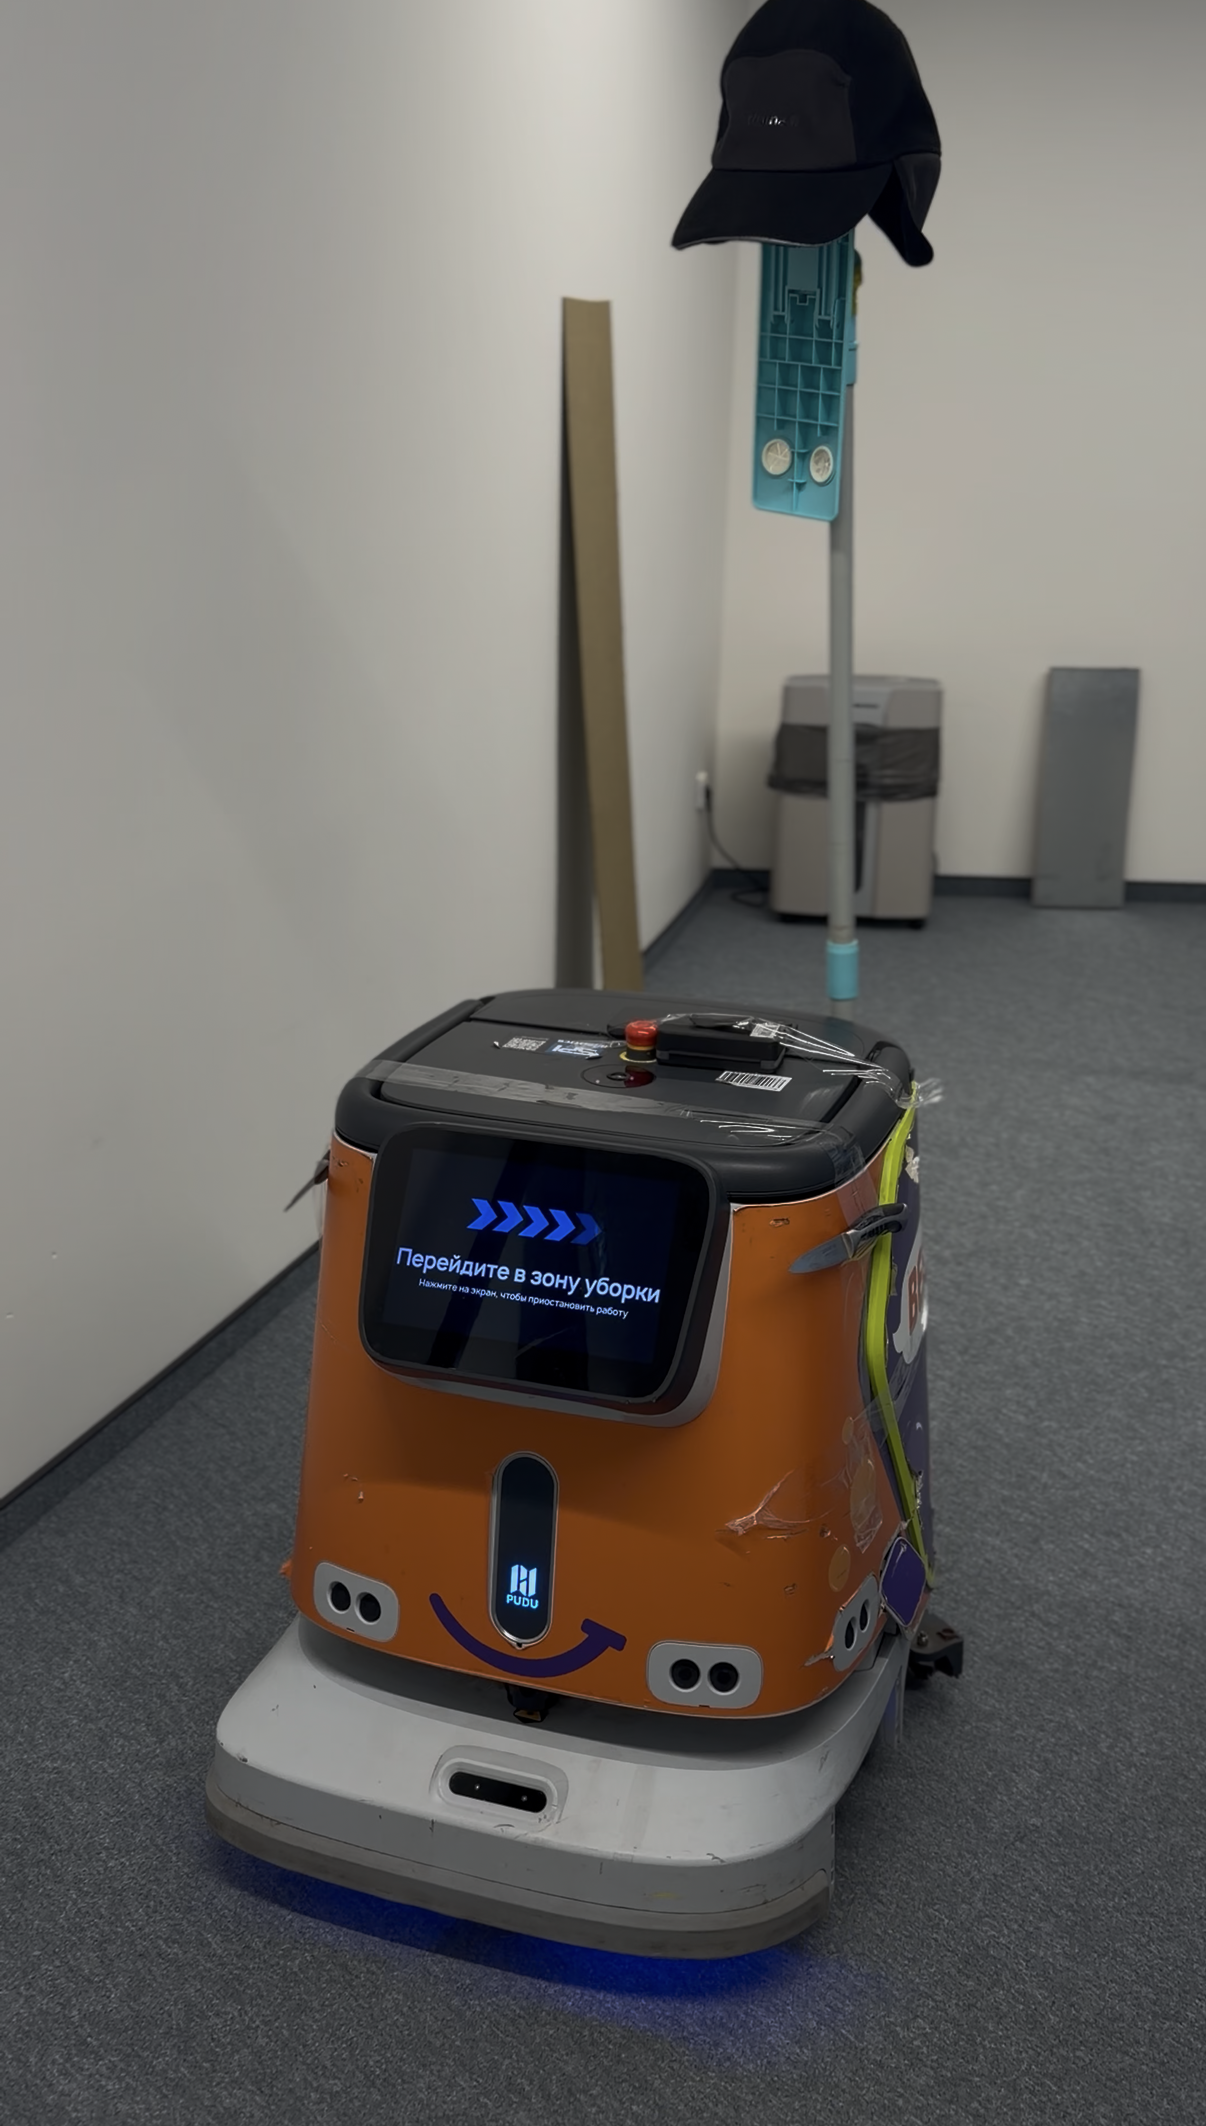
До поездки в «Дикси» мы, конечно, гоняли конструкцию в сборе в офисе. Увы, фоток в офисе не делал, зато с коллегами “прокачал” робота на проигрывание во время движения Имперского марша из Звездных воин и немного навесного оборудования накинули (естественно, все это мы сняли перед отправкой робота домой в магазин, а музыку заменили на звуки R2D2)
Проверяли всё сразу:
как PUDU проходит маршрут;
где именно останавливается;
сколько длится остановка;
что попадает в объектив;
не отваливается ли USB;
хватает ли powerbank и на сколько;
насколько стабильно работает сервис;
сколько фотографий получается;
что происходит с изображением во время движения;
насколько хорошо держится корпус.
Кстати, прикрепили распечатанный девайс на магнитную ленту 3М. Для пилота сойдет.
Офисная мебель честно пыталась изображать стеллажи супермаркета. Но настоящий магазин довольно быстро показал, что лабораторный стенд - всё-таки лабораторный стенд.
Welcome to production
В магазине появились факторы, которых в офисе почти не было: покупатели, тележки, разные расстояния до стеллажей, блики, неравномерное освещение, перекрытия, разная высота полок, захламленные местами проходы. Но обо всем по порядку. Сначала надо было робота распаковать после возвращения на базу.
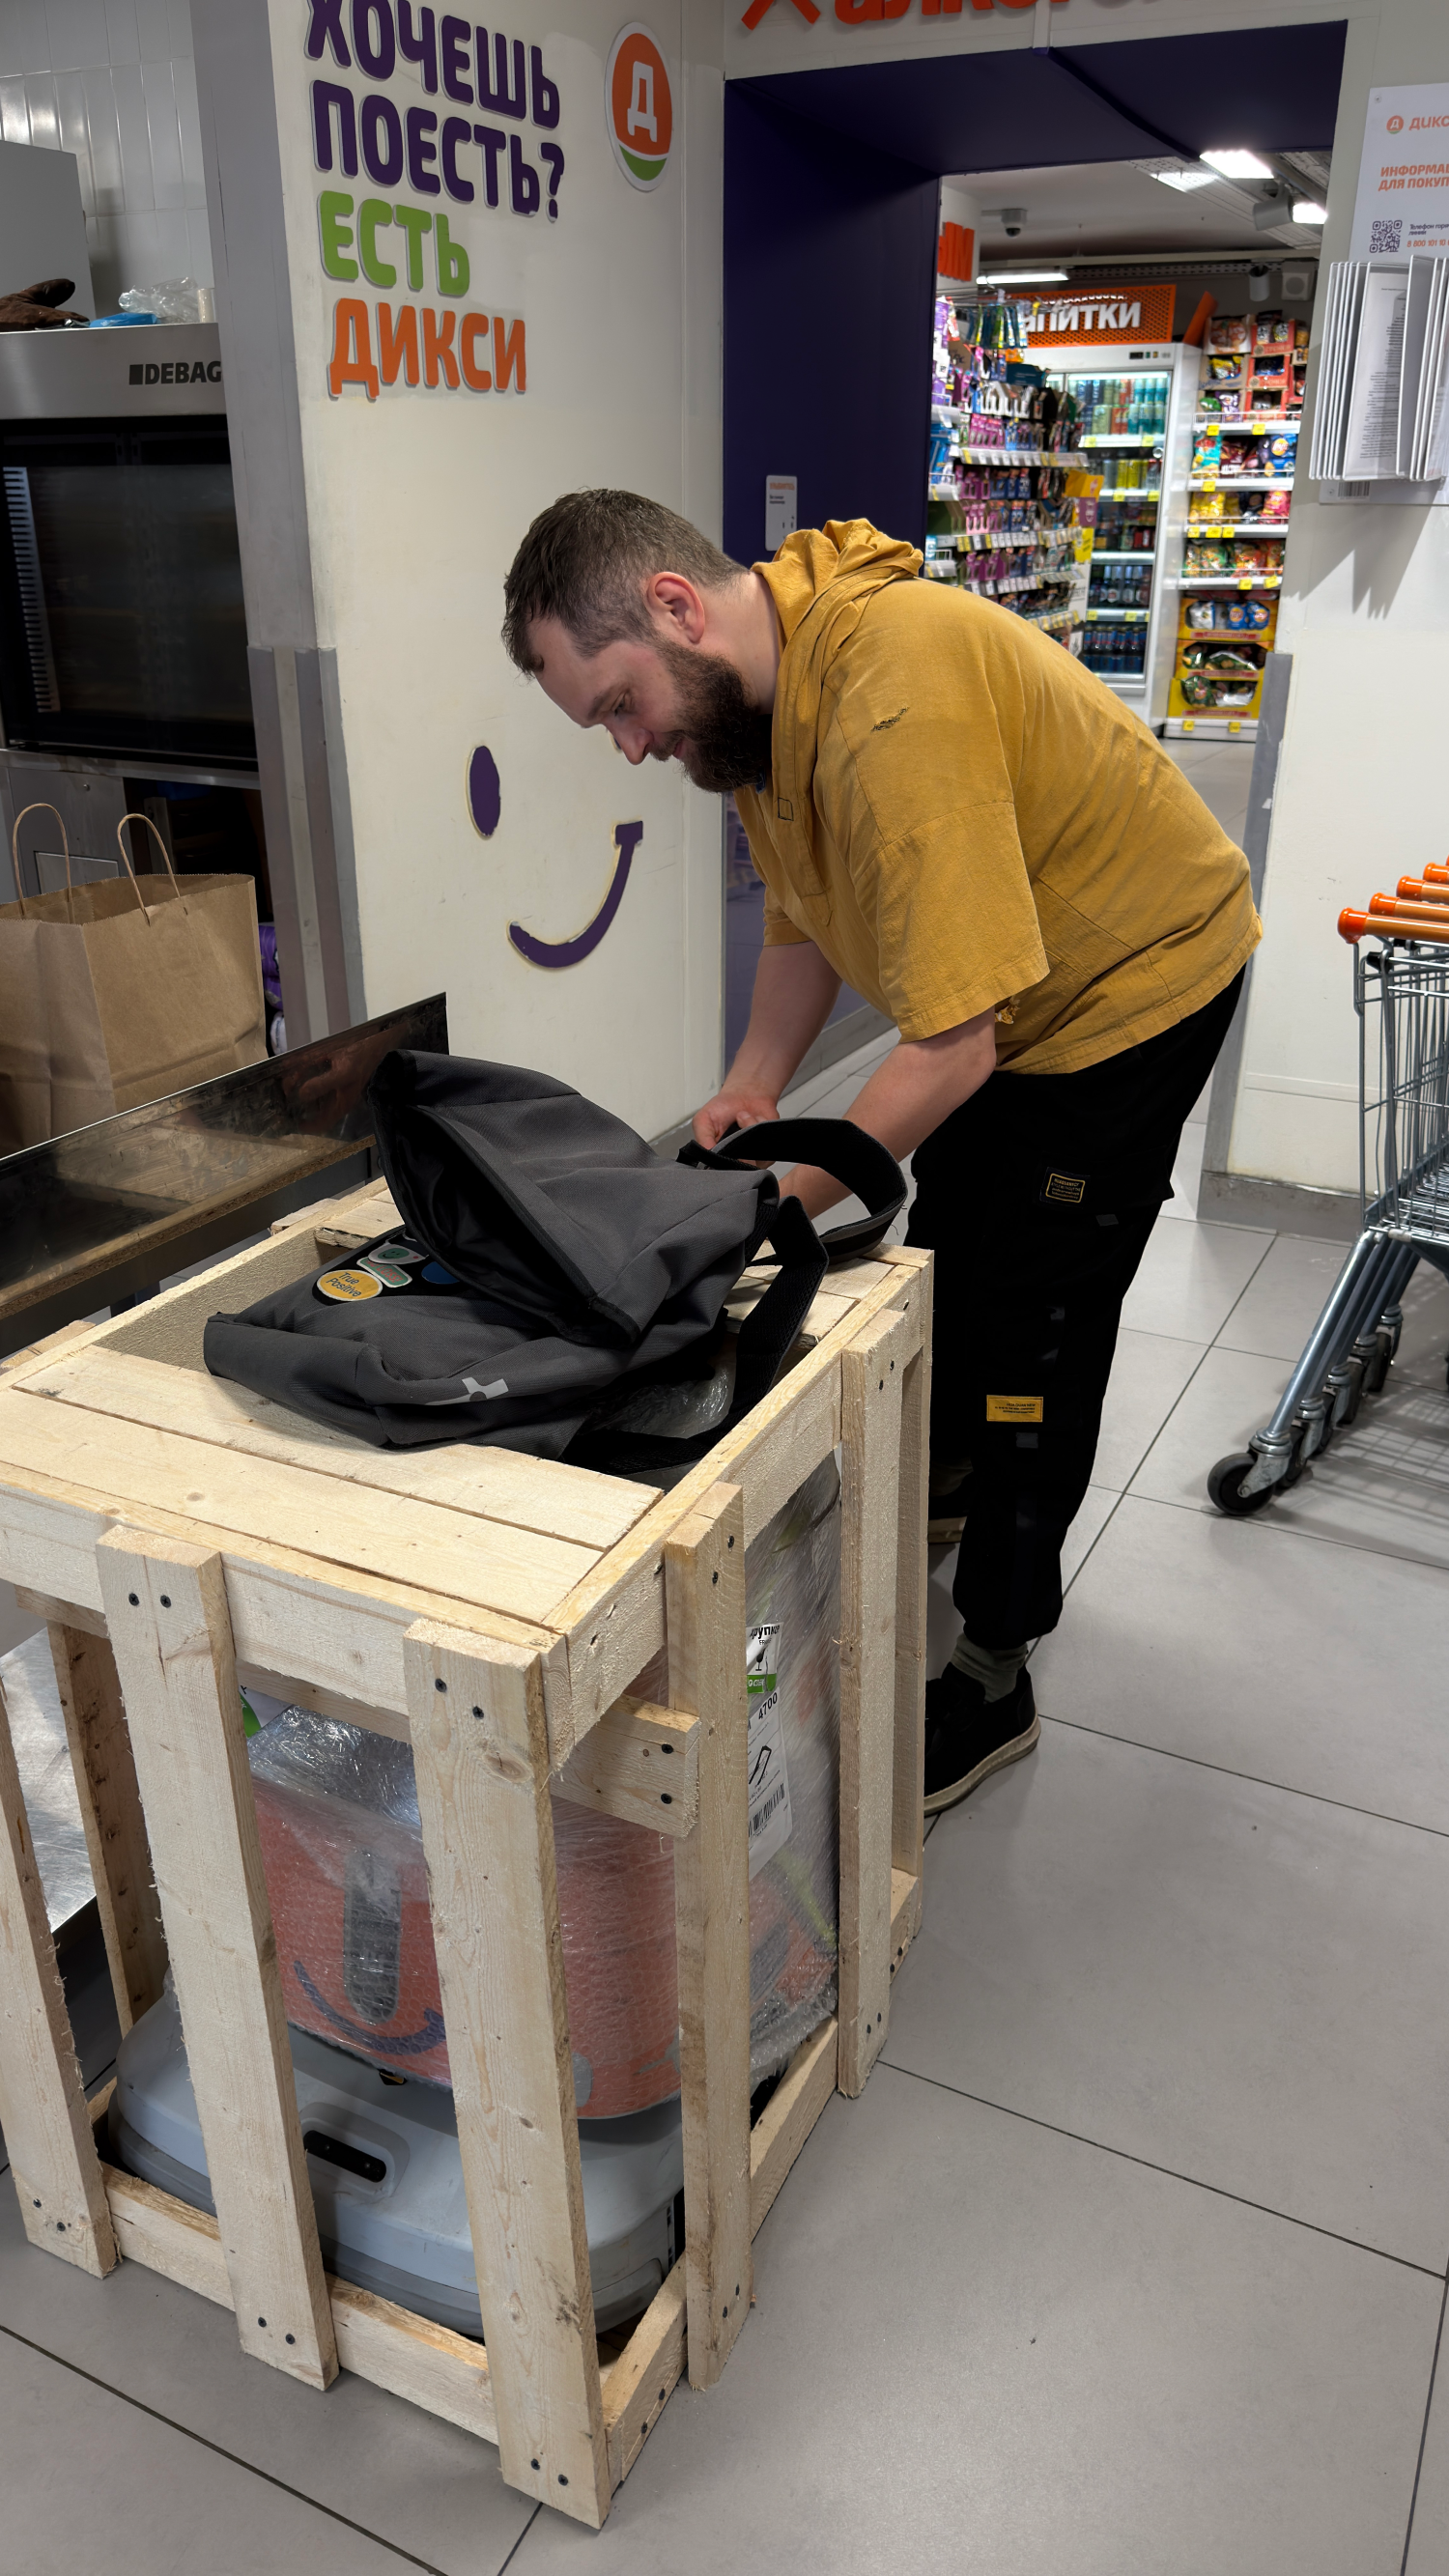
Вместе с коллегой Дмитрием мы успешно преодолели распаковку и нам предстоял впереди самый “классный” этап - создание “нечистых путей” и калибровка камеры под существующие реалии.
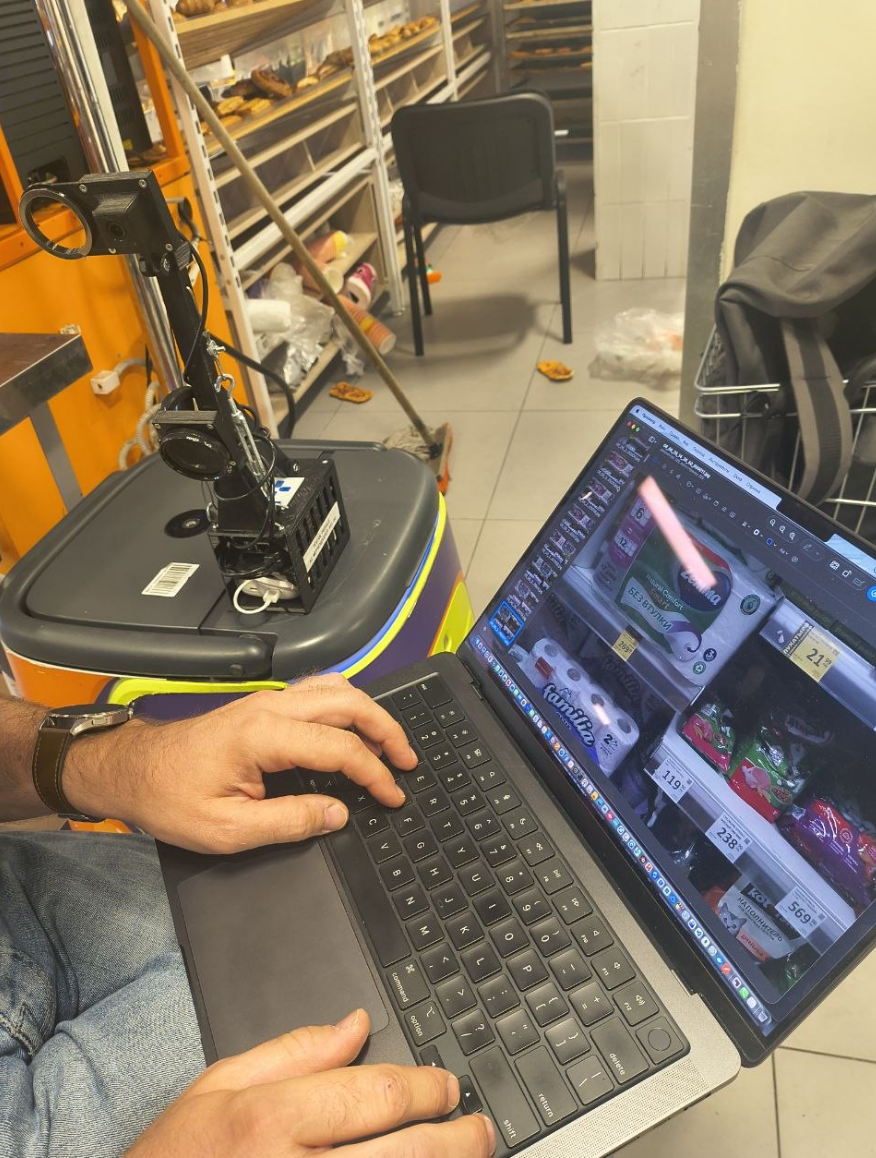
Тут проверяю, подходят ли настройки камеры под освещение магазина.
Отрисовав карту по месту, мы не забыли и про зону уборки (напомню, без нее нельзя создать задание на прогон). В качестве “подопытной зоны” выбрали небольшой участок около стула охранника. То есть, бОльшую часть своего маршрута робот ездил по нашим “нечистым путям”, фотографировал магазин, а где-то в конце честно выполнял свою основную роль и немного убирался (насколько мог). После мы запустили пару тестовых прогонов. Очень быстро подтвердилось, что снимки в движении значительно хуже подходят для распознавания (я думал, что освещение в реальном магазине может заролять как-то, но увы). На одних фотографиях ценники читались прекрасно, а на других робот уже начал двигаться, и мелкий текст превращался в размытую или полуразмытую полосу. Поэтому один из вполне практических результатов пилота сформулировался довольно быстро:
“В нормальной промышленной системе снимать стеллаж нужно именно после подтверждённой остановки робота”
Но в нашем случае проблему решали количеством фотографий. И вот здесь заканчивалась робототехника и начиналась другая половина эксперимента - получится ли из этого успешно считать/распознать текст и цены и потом сопоставить с матрицей?!
Что Research делал с 500 фотографиями
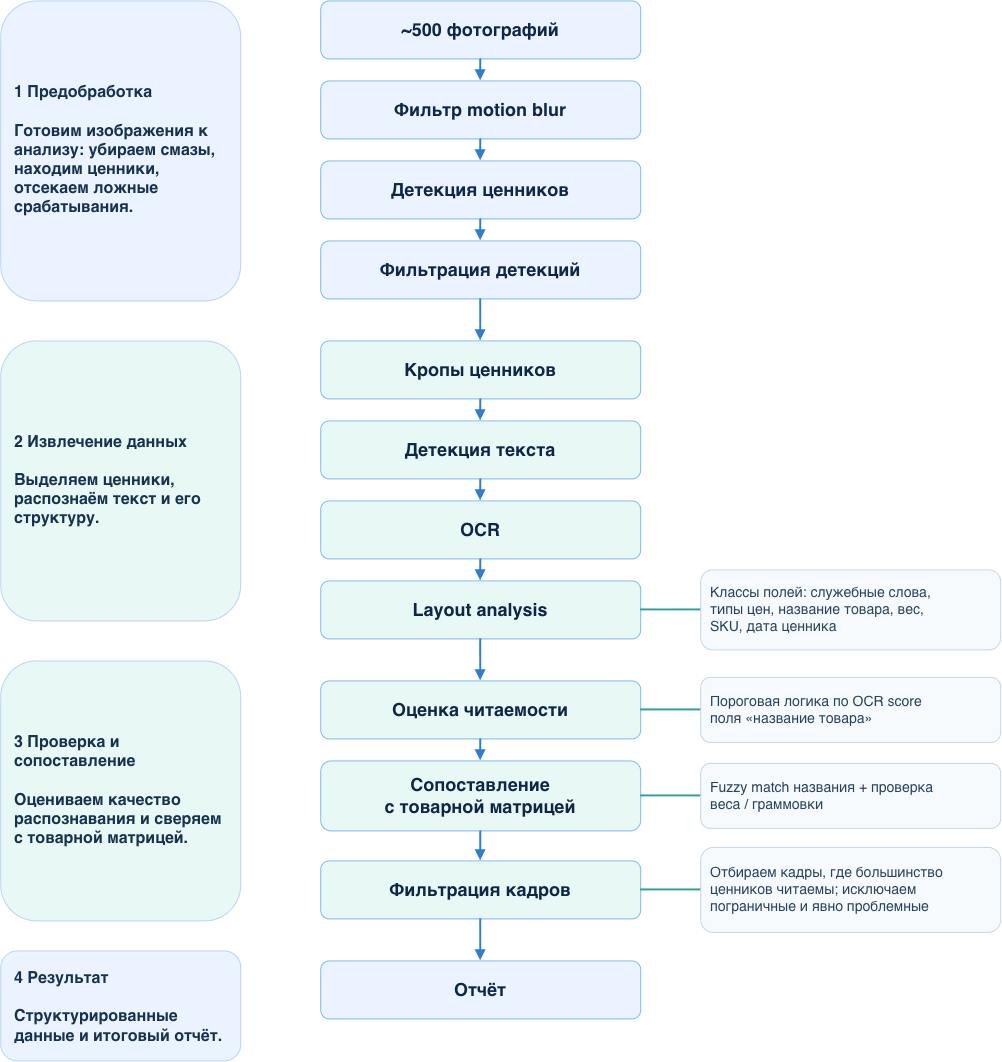
Пятьсот фотографий нельзя просто отправить в OCR и ожидать на выходе хорошие данные. Среди них были кадры, снятые во время движения, фотографии под плохими углами, изображения с бликами и просто кадры, на которых отдельные ценники физически невозможно было нормально прочитать.
Motion blur
Первым этапом изображения проверяли на наличие motion blur. Это напрямую следовало из архитектуры сбора данных. Камера фотографировала N раз в 1 секундy и не знала, в какой именно момент робот начал двигаться. Следовательно, часть изображений неизбежно была снята в движении. Для человека некоторые из них ещё выглядели относительно нормальными, но на ценнике нас интересует мелкий текст, поэтому даже небольшой смаз может сильно ухудшить результат OCR. Очевидно, что плохие изображения отбрасывали уже на этом этапе.
Детектируем ценники
На оставшихся кадрах запускали детектор ценников (наша собственная моделька, которая используется в проектах с продуктом Tevian Shelf Audit). После этого детекции фильтровались по заданному порогу уверенности. Если модель недостаточно уверена, что найденная область вообще является ценником, нет большого смысла отправлять её дальше по более тяжёлому pipeline.После этого работа уже шла не со всей фотографией, а с отдельными кропами ценников.
Ценник — это не просто цена
На каждом кропе последовательно запускалось несколько моделей. Сначала - детектор всего текста, затем - OCR всего найденного текста. Но получить просто набор распознанных строк недостаточно. Обычный ценник содержит довольно много информации:
название товара;
цену;
иногда несколько разных цен;
вес;
внутренний SKU;
дату;
служебные надписи;
информацию об акции.
Поэтому следующим этапом запускался layout analysis - система определяла смысловой класс каждого найденного поля. В частности, выделялись:
название товара;
различные типы цен;
вес или граммовка;
внутренний номер / SKU;
дата ценника;
служебные или неинтересующие нас слова.
С ценами всё оказалось особенно интересно. Интуитивно кажется, что на ценнике есть товар и его цена. Но retail быстро объясняет, насколько эта модель мира упрощённая. Цена может зависеть от карты лояльности, от количества товара, от даты, от акции. Поэтому задача «прочитать цену» довольно быстро превращается в: найти все числа, понять структуру ценника и определить, какое именно из них является нужной нам ценой и при каких условиях она действует.
В нашем случае нам надо было находить основную цену и ее сравнивать с матрицей. Но в голове всегда держим, что может потребоваться что-то большее.
Можно ли этому OCR вообще доверять?
Отдельным этапом оценивалась читаемость ценника. Можно было бы просто считать ценник успешным, если OCR что-нибудь распознал, но OCR практически всегда что-нибудь распознает 🙂. Вопрос в том, насколько полученный текст похож на настоящую цену и название товара. Для оценки читаемости наш ресерч использовал в том числе confidence scores OCR для поля «название товара». Если название товара распознано совсем неуверенно, то пытаться потом надёжно сопоставить его с товарной матрицей большого смысла нет, и мы такой ценник пропускаем. И здесь проявилась интересная разница между человеком и алгоритмом - человек обладает контекстом и он может увидеть в распознаном тексте “ШОК.МОЛ.А”, потом посмотреть на картинку товара и быстро догадаться, о чем идет речь. Для алгоритма такой роскоши нет. Конечно, можно тут еще и товар распознавать (мы это прекрасно умеем, но не в рамках данного пилота), но тогда начнутся вопросы “а точно ли ценник относится к этому товару”, “точно ли ценник под нужным товаром” и т.д.
Иногда даже человеку нужно несколько секунд, чтобы понять, что именно написано на ценнике, что уж тут говорить про модель.
Теперь найдём товар в матрице
Следующая задача - сопоставить распознанное название с товарной матрицей «Дикси». Точное сравнение строк здесь практически бесполезно, на ценнике и в учётной системе один и тот же товар может быть записан по-разному (такое бывает, да). Условно - в матрице “Напиток газированный Coca-Cola Zero Sugar 1,5 л”, а на ценнике “НАП.Г.COCA COLA ZERO 1.5Л”. А если добавить одну-две ошибки OCR - и точного строкового совпадения уже не будет вообще. Поэтому сначала название разделялось на:
основной текст;
вес / объём / граммовку, которые часто находятся в конце.
После этого основной текст сопоставлялся с матрицей с помощью fuzzy search. То есть искалось не строгое равенство строк, а наиболее похожие варианты с заданным порогом похожести. Это позволяет частично нивелировать:
сокращения;
различия в написании;
перестановку слов;
варианты ru/en;
небольшие ошибки OCR.
После появления кандидатов по названию, в сопоставление дополнительно включалась граммовка или вес. Это важно, потому что условные “Молоко 930 мл” и “Молоко 1 л” могут иметь почти одинаковые названия, но являются совершенно разными SKU.
Хороший ценник ещё не означает хороший кадр
Был и ещё один уровень фильтрации. Допустим, на фотографии находится десять ценников, восемь из них плохо читаются, два каким-то образом распознаны хорошо. Формально два успешных результата есть, но само изображение явно неудачное. Для тестирования нам хотелось работать с кадрами, которые в целом являются достаточно качественными. Поэтому дополнительно оставляли изображения, на которых большинство найденных ценников признавались нормально читаемыми. Так мы не строили итоговую оценку на нескольких случайно успешных детекциях внутри плохого кадра. Также исключались ценники, расположенные совсем близко к границам фотографии (они либо размыты, либо есть нюанс, о котором дальше).
Мегапиксели есть, резкости нет
В какой-то момент мы столкнулись с тем, что даже абсолютно неподвижный робот и хорошее разрешение камеры не гарантируют одинакового качества по всей фотографии. Ценники в центральной части кадра могли быть идеально резкими. А по краям — заметно хуже.
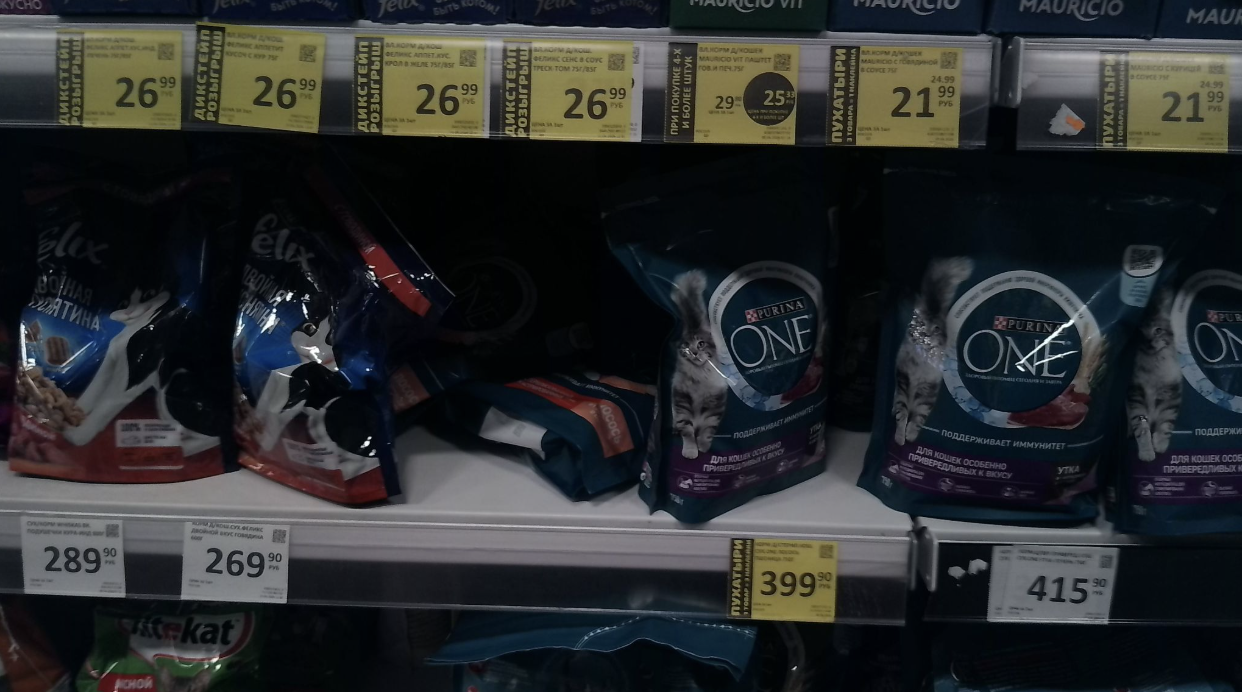
И это уже не motion blur, тут робот стоит, освещение нормальное, разрешение высокое, но конкретная камера и объектив дают ограниченную глубину резкости, и часть ценников оказывается не в оптимальном фокусе. Для обычной фотографии это может почти не бросаться в глаза, но для OCR мелкого текста - вполне критично. Это был ещё один хороший пример того, почему параметр “12 мегапикселей” сам по себе почти ничего не говорит о пригодности камеры для конкретной CV-задачи.
Магазин против компьютерного зрения
Во время экспериментов постепенно набрался целый список вполне бытовых вещей, которые значительно усложняют распознавание - например, блики. Ценник в магазине обычно расположен так, чтобы на него удобно было смотреть человеку с обычного роста. Но наша камера установлена на роботе и смотрит на ту же поверхность с другой высоты и под другим углом. В итоге потолочное освещение, которое покупателю совершенно не мешает, может отражаться прямо в область цены. Тут, конечно, я попробовал смоделировать крепление камеры так, чтобы можно было ее наклонять и фиксировать, чтобы нивелировать этот момент.
Ещё немного разных не очень приятных моментов:
ценники, перекрывающие друг друга;
Ценники кучкой;
мятые ценники;
плохо пропечатанный текст;
криво закреплённые держатели;
мелкие шрифты;
нестандартные сокращения.
И становится понятно, почему решение задачи выглядит не совсем так, как “text = ocr(image)”. Отдельная вселенная - акционные ценники. Кроме того, в retail встречаются двойные и тройные ценники, а также электронные. В рамках этого конкретного пилота нам с ними не пришлось сталкиваться. Иначе этот раздел статьи, возможно, был бы раза в три длиннее.
Но такой формат не супер классно подходит для любого, кто хочет проверить работу пайплайна (если, коенчно, нет особо горячих любителей почитаь json на ночь), особенно если перед тобой несколько сотен результатов и хочется быстро понять:
где всё хорошо;
где модель ошиблась;
где проблема в OCR;
где просто плохой исходный кадр.
Поэтому JSON довольно быстро обзавёлся двумя представлениями, которыми мы и делились с Заказчиком.
HTML для глаз, Excel для анализа
Первое - простой HTML-отчёт. Тут спасибо нашему ресерчу, они с радостью сопровождают результаты прогона пайплайна визуализацией.
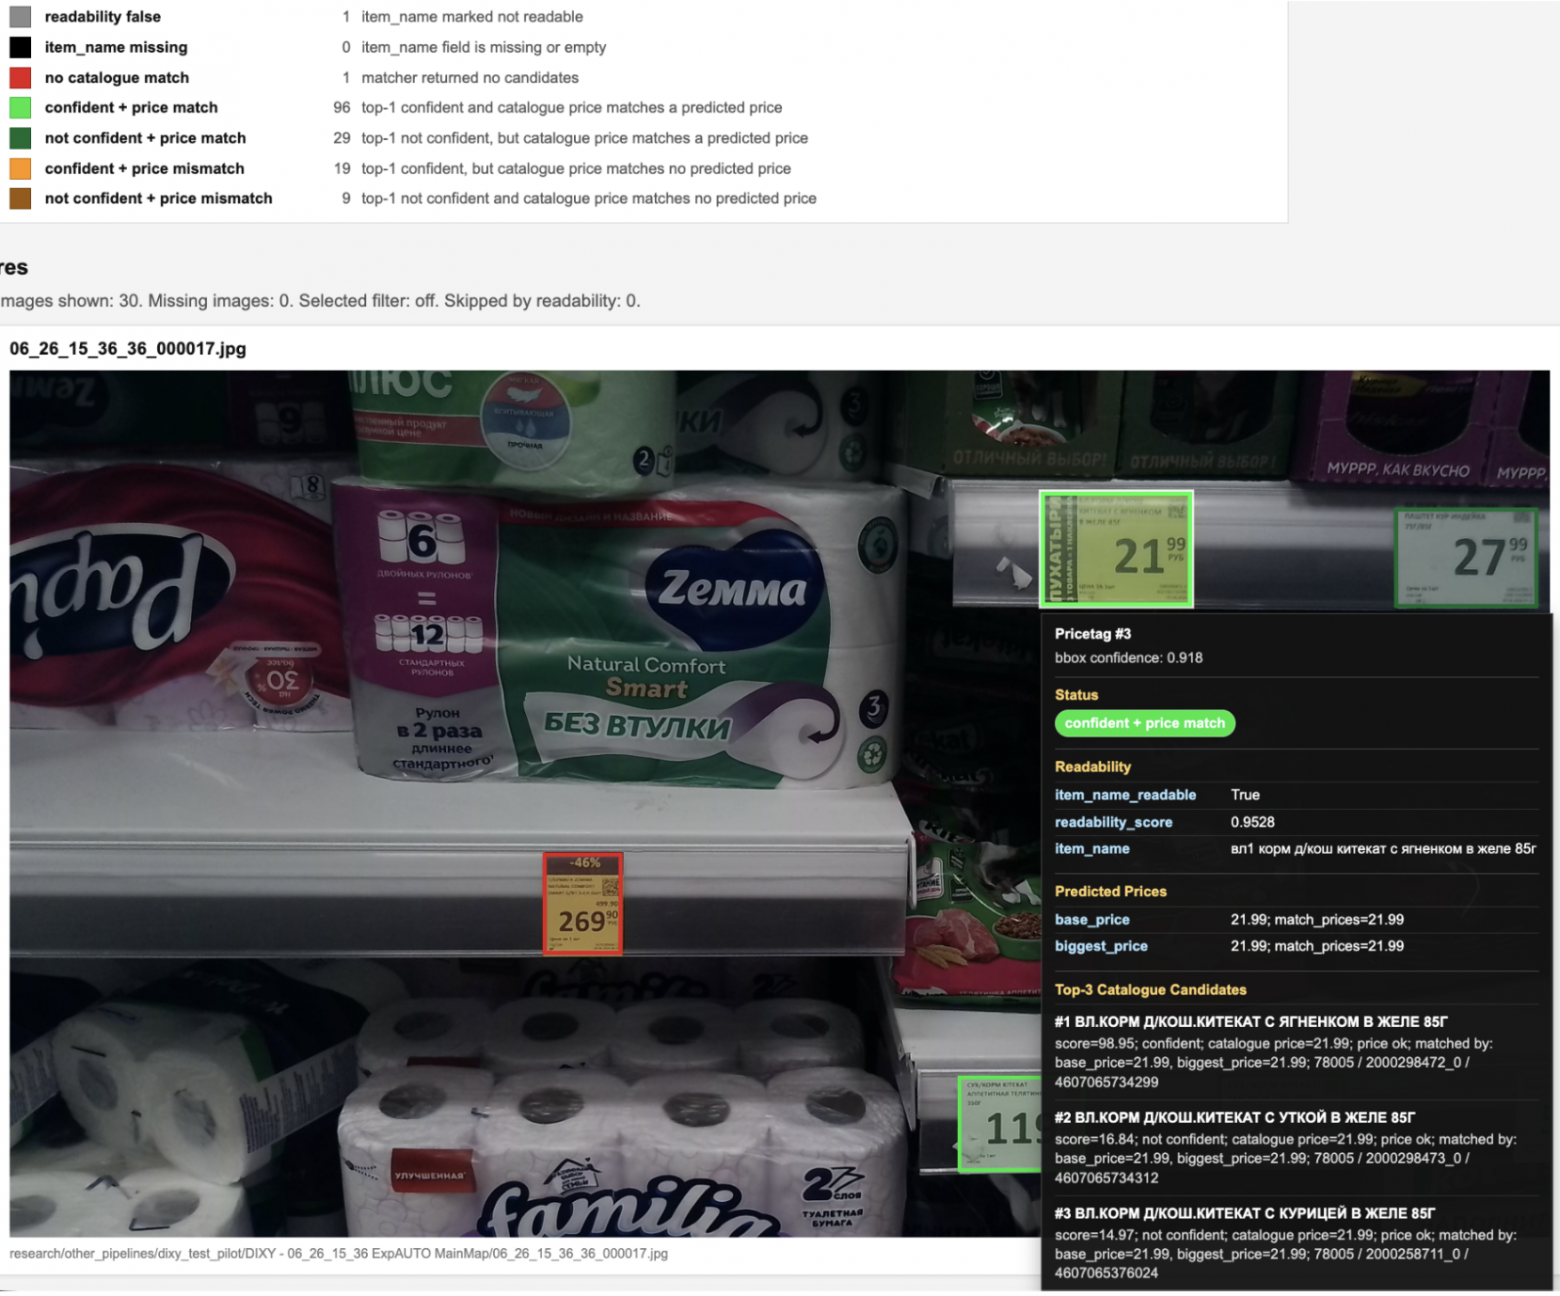
Для быстрого визуального анализа это оказалось очень удобно - наводишь мышку на ценник и видишь, что пайплайн распознал, нашел и сопоставил. И куда же без “цветовой дифференциации штанов” - визуально показать, что совпало с матрицей, а что нет.
А вот если хотелось уже сортировать данные, фильтровать результаты и оценивать их более вдумчиво, HTML переставал быть оптимальным вариантом. Тут на арену вышел “его величество Excel”. Легкая магия и пара запросов к GPT и готов скрипт, который из предоставленных данных собирает хороший Excel.
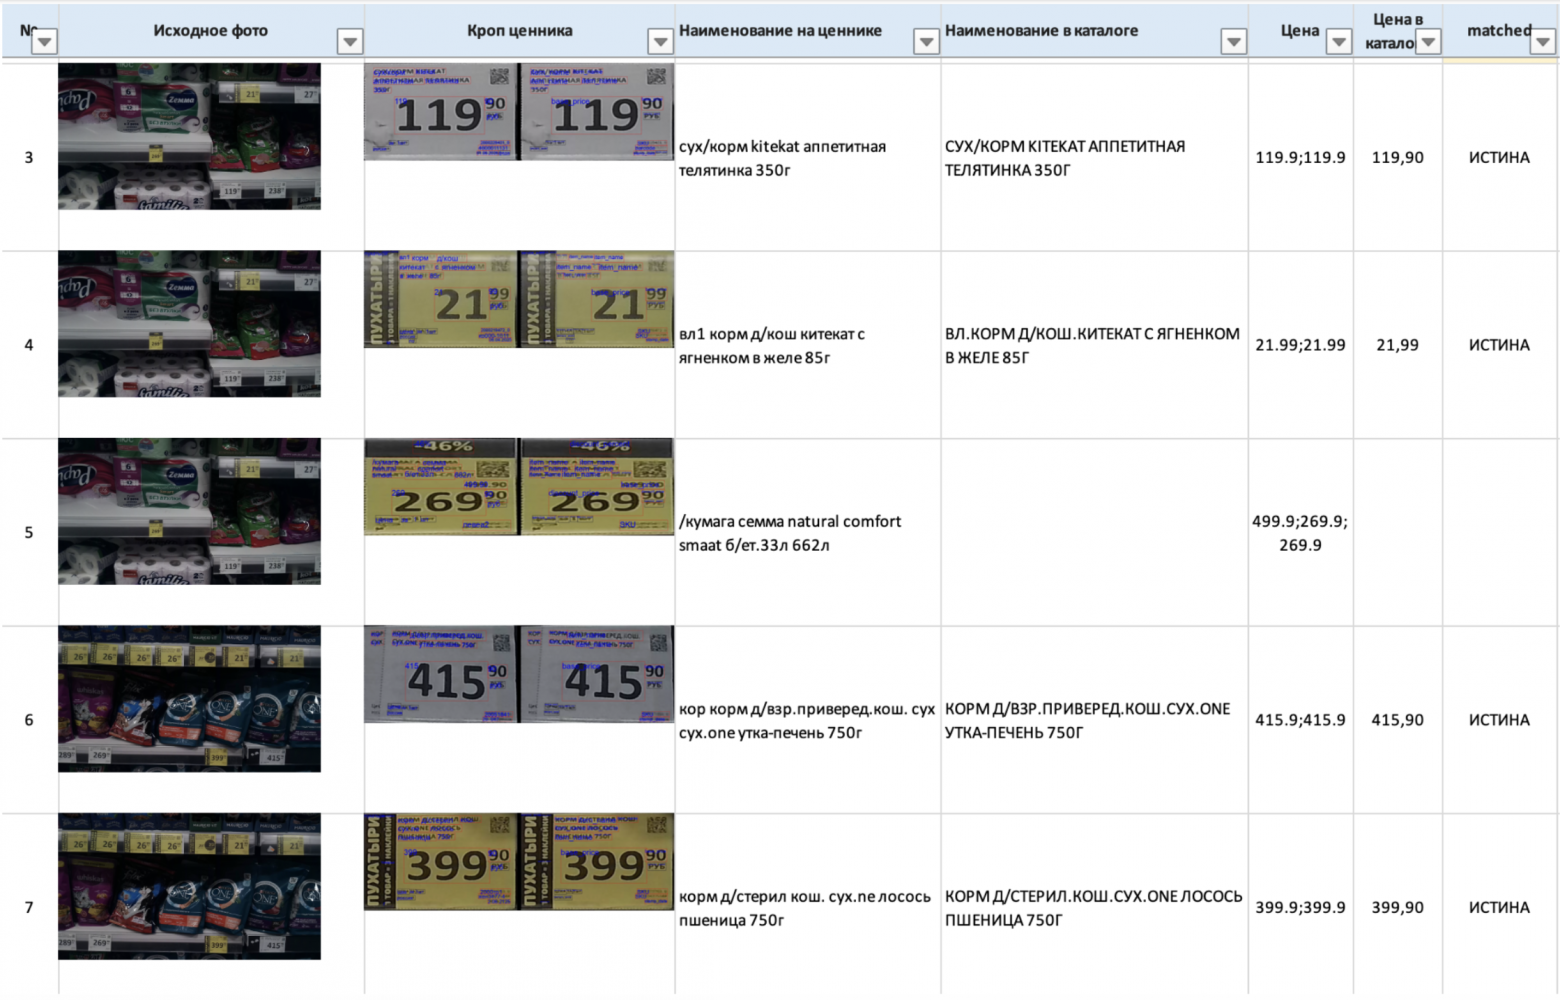
Отдельный большой dashboard для пилота мы намеренно не строили. Нам нужно было быстро понять, где технология работает хорошо, где ошибается и почему. Для этого прозрачный JSON плюс два небольших представления оказался гораздо полезнее красивой аналитической системы, которая сама стала бы отдельным проектом (это совсем другая история).
Что в итоге показал пилот
После этапа с Research у нас впервые сошлась вся цепочка целиком - полный путь от движения робота по реальному магазину до результата, который можно открыть в HTML или Excel. Именно это и было главным результатом пилота. Мы не пытались доказать, что уже получили промышленную систему с идеальной точностью. Нам нужно было понять, работает ли сам технологический подход и где находятся его реальные ограничения. Ответ получился положительным как для нас, так и для Заказчика.
Робот может быть источником изображений торгового зала, и на этих изображениях можно находить ценники, распознавать их содержимое, сопоставлять товары с матрицей и автоматически искать расхождения.
А дальше — уже не только ценники
При этом сам сценарий довольно быстро начинает выходить за рамки проверки цен. Если робот всё равно регулярно проходит вдоль стеллажей и получает качественные изображения, использовать их только для OCR ценников немного расточительно. На тех же фотографиях находятся сами товары (привет нашему Shelf Audit). Значит, поверх той же инфраструктуры можно развивать уже более широкий спектр задач:
определять наличие товара;
находить пустые места;
распознавать SKU;
проверять соответствие товара расположенному рядом ценнику;
анализировать фактическую выкладку;
сравнивать её с планограммой.
Получается уже не специализированный «робот для проверки ценников», а мобильный источник данных о состоянии торгового зала. И, пожалуй, именно это оказалось самым интересным результатом эксперимента. Мы начинали с довольно конкретного вопроса: “Можно ли заставить робота проехать по магазину и проверить цены?”, а закончили вопросом немного другого масштаба: “Если робот способен регулярно и автономно собирать качественные изображения всего магазина, что ещё мы можем по ним узнать?”. Но до промышленной версии оставалась ещё как минимум одна проблема. Причём обнаружила её не нейросеть.
Последний тестовый сценарий
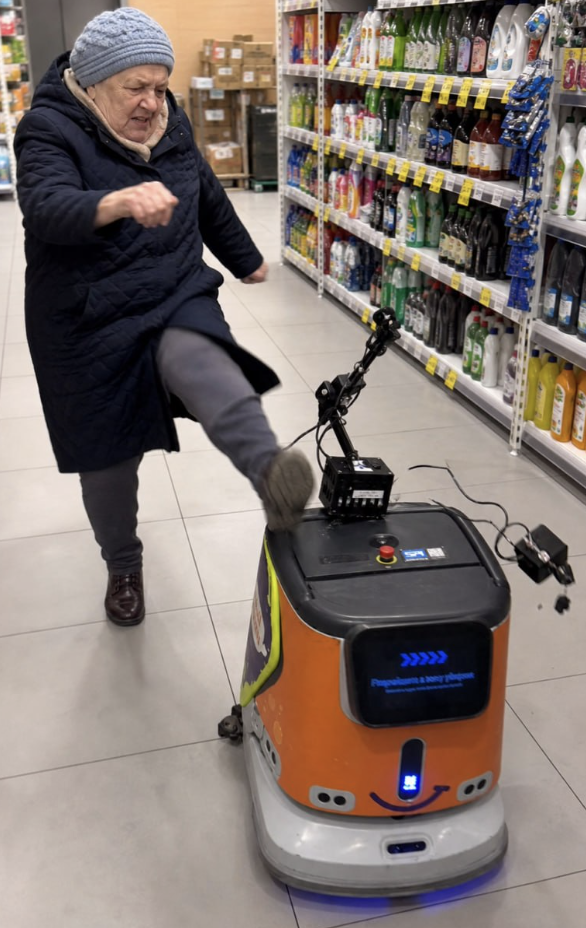
Робот был не наш. Вот совсем. И поэтому очевидный способ установки оборудования через сверление, модернизацию и адаптацию корпуса текущего робота даже не рассматривался. Напомню, что для пилота наш напечатанный модуль с OrangePi и камерами закрепили на роботе с помощью магнитного крепления 3M. Для офисных тестов и большей части пилота этого было более, чем достаточно. Но тут… Под конец дня в магазине появилась пожилая покупательница. И представьте картину маслом - робот стоит в проходе, фотографирует, собирается проехать дальше, как появляется обычная питерская бабушка, которой “эти ваши технологии…”. С её точки зрения ситуация, видимо, выглядела примерно так: “Стоит какая-то штука и мешает пройти”. Перестраивать маршрут она не стала и пошла напрямую сквозь робота. Сумка зацепила наш напечатанный блок с камерами, и система компьютерного зрения отправилась тестировать уже не OCR, а закон всемирного тяготения.
К счастью, оборудование пережило этот незапланированный crash test. Зато история довольно хорошо подвела итог всему пилоту: промышленная система существует не только в коде.
У неё должны быть:
нормальное штатное крепление;
защищённый корпус;
правильная укладка кабелей;
защита камеры;
отсутствие выступающих элементов;
устойчивость к столкновениям;
и вообще понимание того, что вокруг робота продолжают ходить обычные люди.
Потому что какие бы сценарии мы ни придумали в офисе, реальный магазин обязательно добавит свои. Иногда - с авоськой.
Вместо заключения
В этом пилоте было довольно много решений, которые мы точно не стали бы переносить в серийную систему:
Робот не сообщает об остановке - фотографируем каждые N секунд.
CSI-камера не заводится - берём USB.
Нельзя нормально запрограммировать нужный маршрут - собираем его из десятков коротких “нечистых путей”.
Нельзя сверлить чужого робота - печатаем корпус и придумываем временное крепление.
Получается несколько сотен фотографий разного качества - строим вокруг них систему фильтрации.
На самом деле с точки зрения архитектуры и технологических решений все это можно долго критиковать, но у пилота была другая задача: не построить идеальную систему с первого раза, а как можно быстрее ответить на вопрос “имеет ли смысл вообще строить её дальше?”
После этого эксперимента наш ответ “твердо и четко” - да.
Мы прошли весь путь от движения робота между стеллажами до автоматически сформированного отчёта по ценникам и увидели, где находятся реальные ограничения технологии. Следующий шаг теперь выглядит гораздо понятнее: робот с API, управляемые точки съёмки, контроль качества кадра непосредственно во время прохода и дальнейшее расширение анализа с ценников на весь стеллаж. Тогда вместо пятисот случайных фотографий можно будет получать несколько десятков нужных.
А эксперимент с роботом-уборщиком постепенно превратится в систему автоматического мониторинга торгового пространства. Ну и крепление в следующий раз точно сделаем с учётом бабушек внешних факторов.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.