Heap умер? Или как IOT вместо heap ускорил PostgreSQL в 2Х
Привет, Хабр! На связи Михаил Семёнов, владелец продукта СУБД Platform V Pangolin DB.
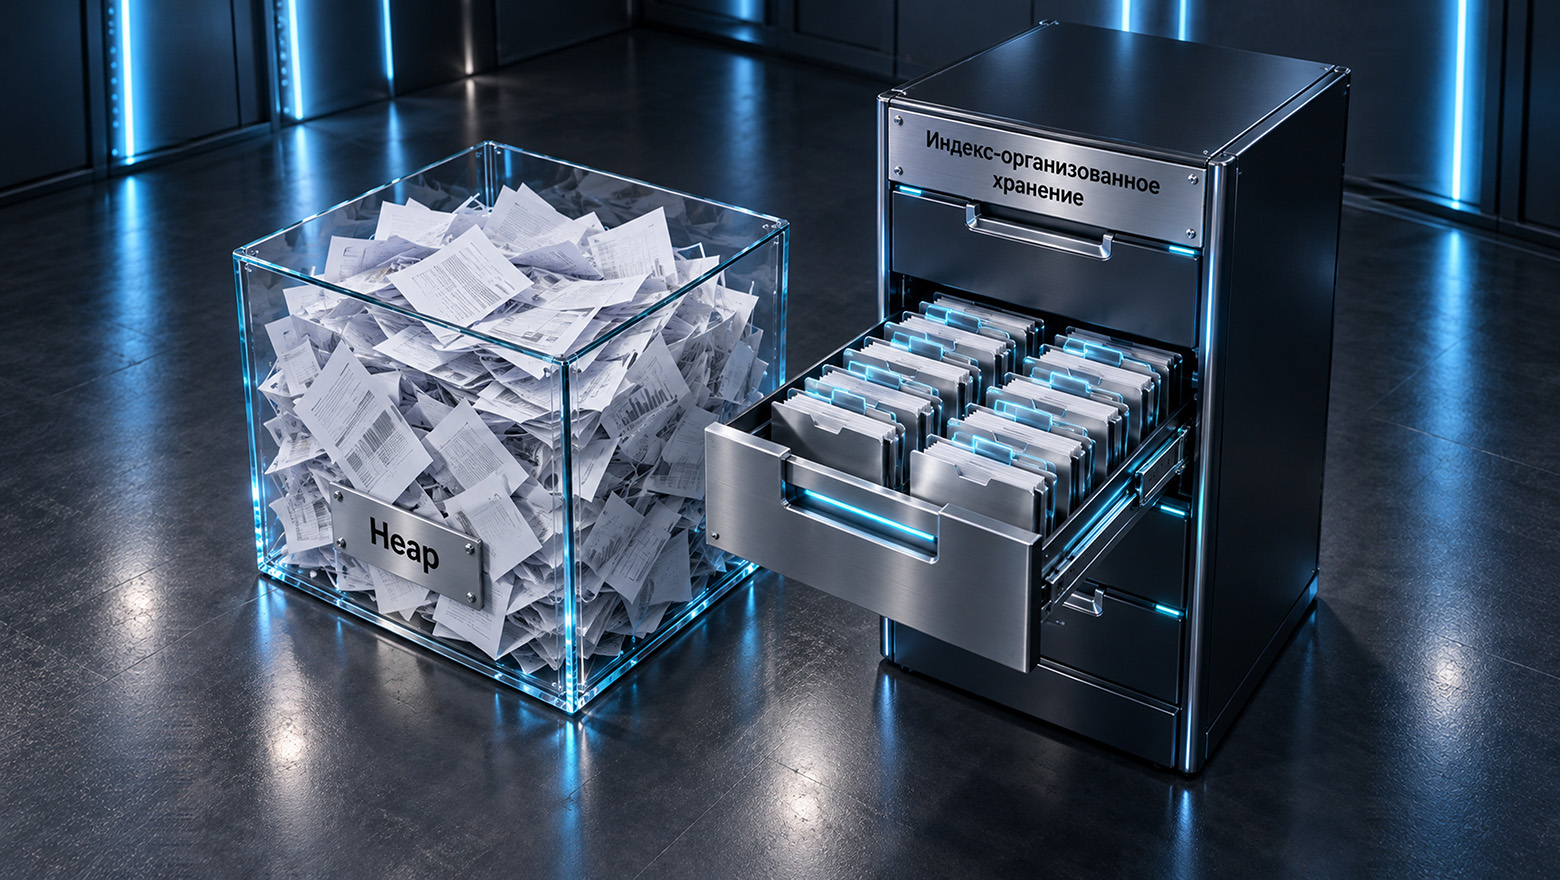
Высокая нагрузка OLTP? VACUUM необходим, но нагружает базу? Непрерывный bloat и отстающая реплика? Мы привыкли списывать это на характер нагрузки, но давайте критически посмотрим на классический heap и поддержание целостности и многозначности данных.
В статье разберу альтернативу — индекс‑организованное хранение (IOT). Покажу, как IOT решает эти проблемы, ускоряет работу с данными, не меняя интерфейса (прозрачно для клиента).
В Pangolin мы добавили новый вариант хранения (индекс-организованный), который, помимо оптимизации хранения, более чем вдвое ускорил работу с данными без изменения интерфейса PostgreSQL.
Статья будет полезна DBA, тимлидам, СТО и архитекторам Enterprise-компаний и поможет решить проблемы масштабируемости PostgreSQL без смены стека технологий и эффективно использовать бюджет на инфраструктуру.
Что не так с классическим heap?
Классический механизм хранения (heap) создавали десятилетия назад. Сегодня приложения работают на многопроцессорном оборудовании под высокой конкурентной нагрузкой, и начинают проявляться пределы масштабируемости. При интенсивных операциях записи таблицы часто бесконтрольно растут из-за накопления мёртвых версий строк, индексы могут занимать больше места, чем сами данные, а фоновый процесс очистки потребляет IOPS и время администраторов. Отсюда — непредсказуемые задержки при выполнении запросов.
Мы искали способ устранить эти узкие места архитектурно, не отказываясь от привычного SQL-стека.
Решение проблем с heap: переход на таблицы с индекс-организованным хранением
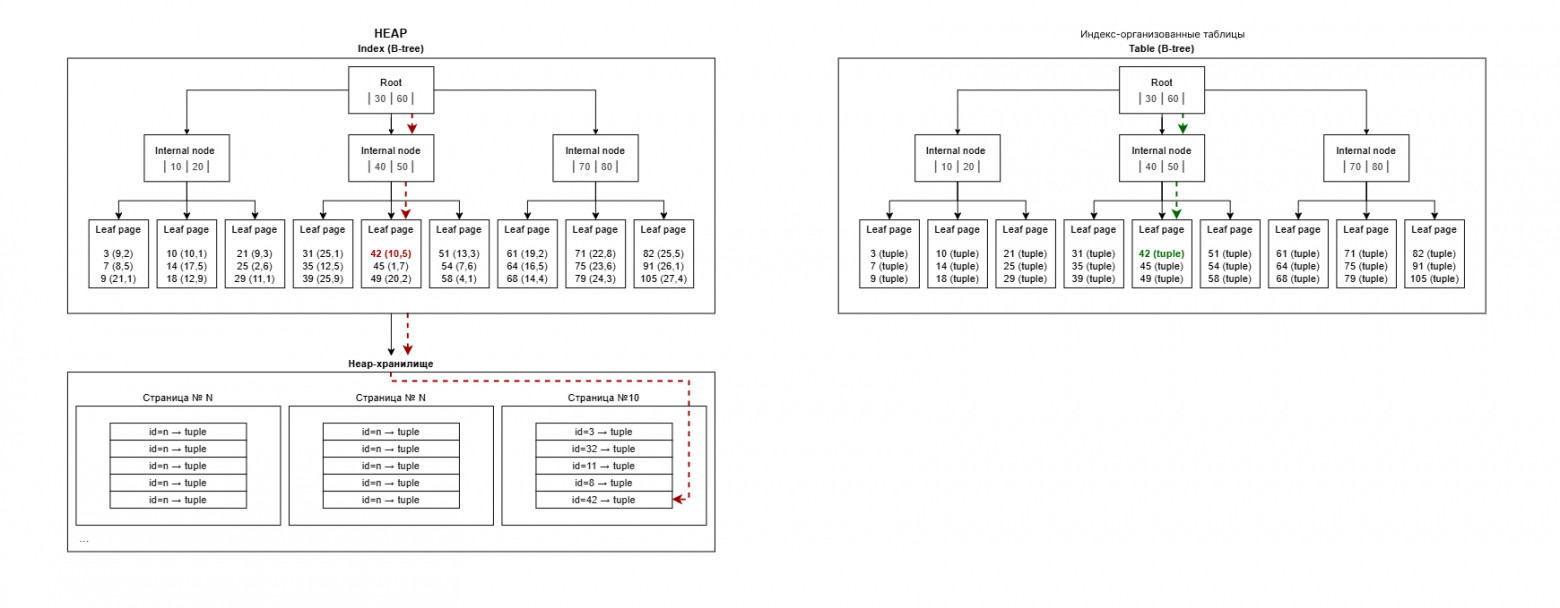
Мы рассмотрели архитектурные ограничения классического heap на современном железе и остановились на подходе с использованием нового метода доступа к таблицам. Он основан на поддержке индекс-ориентированного хранения: данные хранятся в виде B+-дерева, которое объединяет в себе таблицу, физический слой хранения и первичный индекс. Это избавляет от необходимости в отдельной структуре heap при поиске по первичному ключу. Внутренние узлы дерева — корневые и промежуточные страницы — содержат только ключи и указатели на дочерние ветви для маршрутизации поиска. Полные версии строк физически располагаются исключительно в «листовых» страницах, упорядоченных по значению первичного ключа.
На схеме показан пример поиска строки по первичному ключу (SELECT * FROM table1 WHERE id = 42;). Видно различие в организации хранения данных между heap и индекс-организованной таблицей.
UNDO-лог
На страницах B+-дерева в индекс-организованной таблице находятся только актуальные версии строк. При обновлении или удалении записи новая версия пишется на место старой, а данные для отката (предыдущее состояние строки) уходят в журнал отмены — UNDO.
Прямые ссылки вместо buffer mapping
В индекс-организованной таблице страницы данных в оперативной памяти связываются с узлами индексной структуры через прямые указатели. Поэтому не нужно искать страницы в глобальной таблице соответствий буферов (buffer mapping) и использовать связанные с ней механизмы синхронизации. Если страницы нет в памяти, то она считывается с диска в буферный пул. После этого узел дерева обновляется, сохраняя прямую ссылку. Далее обращения используют уже установленный указатель без повторного поиска.
Copy-on-Write для контрольных точек
При создании контрольных точек индекс-организованная таблица использует механизм Copy-on-Write. При изменении данных страницы B+-дерева записываются в новое свободное пространство хранилища, а не поверх существующих на диске.
Одновременно создаются новые версии всех родительских узлов по пути от изменённой страницы до корня дерева, а предыдущая версия дерева остаётся на диске неизменной. После записи атомарно обновляется единственная корневая ссылка таблицы — она начинает указывать на новую версию дерева.
Логический строчный WAL
Индекс-организованные таблицы меняют работу WAL: журналирование происходит на уровне строк, а не блоков данных. В журнал предзаписи попадают логические изменения строк, включая значения первичного ключа и TOAST-данные при необходимости.
Пользовательские данные лежат непосредственно в листьях первичного B-дерева, поэтому вторичные индексы можно восстановить по изменениям первичного ключа. И изменения вторичных индексов не журналируются отдельно, а это сокращает объём записываемых данных.
Сжатие данных на уровне блоков
В индекс-организованной таблице можно использовать встроенную библиотеку ZSTD для сжатия на уровне блоков. Перед сбросом на диск содержимое страницы целиком упаковывается, и в файл записывается уже результирующий поток байтов.
В отличие от heap, где страница занимает фиксированные 8 КБ, даже если заполнена наполовину, индекс-организованная таблица записывает на диск уже сжатый блок. Его размер определяется только результатом работы алгоритма сжатия.
Размещение в файловой системе
При создании индекс-организованной таблицы СУБД регистрирует отношение в системных каталогах и назначает ему идентификатор relfilenode. На его основе в каталоге базы данных создаётся пустой файловый объект. Это лишь служебный файл, он обеспечивает совместимость с внутренними механизмами ядра СУБД, остаётся пустым и не используется для хранения пользовательских данных. Фактически данные хранятся в собственном файловом пространстве индекс-организованной таблицы с использованием собственного формата.
Функциональность доступна только в редакциях Platform V Pangolin DB Enterprise.
Преимущества нового подхода
Физическое упорядочивание данных. Строки хранятся в листьях B+-дерева по первичному ключу. Данные можно читать напрямую, без обращения к отдельному heap-хранилищу.
Отсутствие bloat. Неактуальные версии строк живут в журнале UNDO. Таблицы не раздуваются и снижается потребность в VACUUM и VACUUM FULL для основных данных.
Эффективность на многопроцессорных системах. Прямые ссылки на страницы памяти вместо глобальной таблицы buffer mapping уменьшают накладные расходы на синхронизацию.
Мгновенные снимки и бэкапы. Механизм Copy-on-Write позволяет быстро создавать физически согласованные снимки данных — они сразу готовы для резервного копирования или репликации.
Легкий WAL и быстрое восстановление. Строчное журналирование сокращает объём записи на диск и ускоряет параллельное восстановление после сбоя, а также применение изменений на репликах без ущерба для устойчивости.
Экономия дискового пространства. Сжатие страниц и запись блоков переменной длины уменьшают размер файлов БД и снижают нагрузку на подсистему ввода-вывода.
Результаты тестирования
Мы прогнали тесты на pgbench и go-tpc в условиях дефицита ресурсов (ограниченная память, высокие задержки дисков) на матрицах конфигураций от 4 до 8 ядер. Так выглядела картина нагрузки:
Дефицит IOPS. Когда системе тесно (низкая пропускная способность дисковой подсистемы), отсутствие
bloatи эффективный WAL дают прирост TPS до +90% (кластерныйpgbenchс синхронной репликацией).Сбалансированные production-системы. На кластерном
pgbenchс синхронной репликацией без ограничений железа мы видим стабильные плюс 15-20% к TPS. Для тестов TPC-C (go-tpc) этот показатель составляет +5-10% tpmC, в зависимости от конкурентности соединений.Занимаемое место на диске (без сжатия). До х2 экономии достигается только в специфических сценариях с массовыми UPDATE-запросами за счёт отсутствия дублирования heap и PK. При массированной вставке размер данных примерно одинаков.
Занимаемое место на диске (со сжатием ZSTD). Экономия достигает восьми раз на первом уровне сжатия.
Важное уточнение: числа сильно зависят от сценария использования. Архитектура undo-журналов даёт улучшение именно на write-intensive нагрузках, как показывают результаты go-tpc с ограничением IOPS — до +250%. Но для тяжёлых аналитических запросов (OLAP) или массового чтения больших таблиц старый добрый heap может оказаться эффективнее из-за особенностей работы страничного кеша ОС.
Миграция без остановки бизнеса: возможность совместного использования heap и индекс-организованных таблиц
Одна из ключевых особенностей решения, упрощающих начало работы, — возможность плавного перехода. Благодаря интерфейсу методов доступа (Table Access Method API) в одной базе данных могут одновременно сосуществовать таблицы на классическом heap и новые индекс-организованные таблицы.
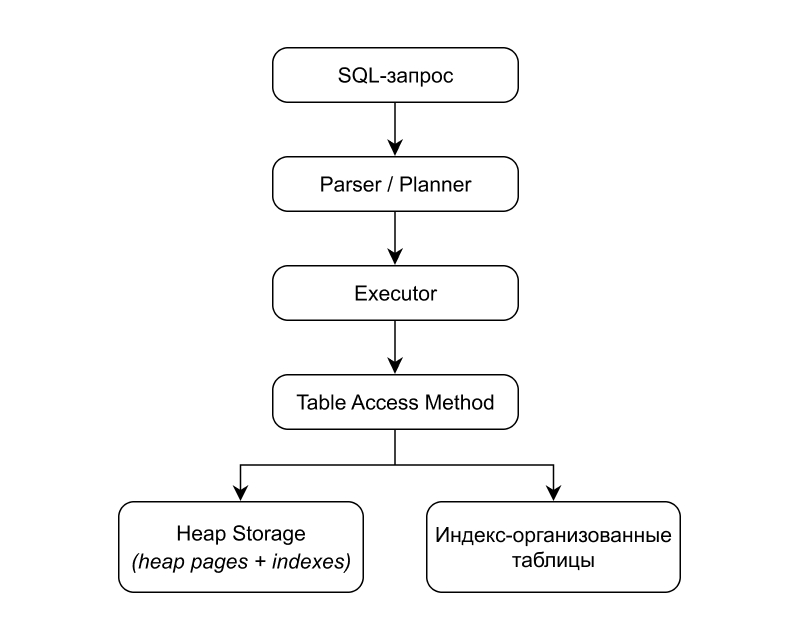
Для миграции не нужна доработка приложения. Вы можете переносить таблицы одну за другой простым пересозданием: CREATE TABLE … USING orioledb AS SELECT * FROM old_table;.
Приложение продолжает работать через стандартный SQL и видит единую логическую модель данных — менять код, пересоздавать кластер или обновлять настройки клиентов не нужно.
Настройка самого движка тоже занимает пару минут: установка пакета, добавление orioledb в shared_preload_libraries и выполнение CREATE EXTENSION.
Если вы хотите целиком перевести базу на новую архитектуру, то достаточно выставить параметр default_table_access_method = 'orioledb'.
Важное ограничение: глобальная установка метода доступа по умолчанию не рекомендуется для систем со сторонними расширениями. Многие расширения создают свои служебные таблицы, явно рассчитывая на классическую heap-архитектуру и наличие скрытых системных столбцов (ctid, xmin). Использование индекс-организованных таблиц для таких объектов может привести к ошибкам при создании таблиц или снижению производительности из-за эмуляции отсутствующих механизмов. Для миграции существующих данных используйте точечный перенос через CREATE TABLE ... USING orioledb.
Итоги
Индекс-организованные таблицы позволили нам решить ряд архитектурных проблем open source PostgreSQL. При этом экосистема, гибкость SQL и весь накопленный стек расширений остались на месте.
Главное, что мы получили:
Предсказуемая производительность. Мы устранили проблему распухания таблиц (
bloat) и зависимость от фоновых процессов очистки. База данных сохраняет время отклика даже при интенсивных операциях записи.Эффективное использование бюджета на инфраструктуру. Более эффективное использование бюджета на инфраструктуру хранения за счёт устранения распухания файлов таблиц данных и поддержки эффективного сжатия данных ZSTD.
Сохранение инвестиций в стек. Технология полностью совместима с SQL-диалектом Postgres и экосистемой расширений. Это позволяет масштабировать существующие системы без дорогостоящего рефакторинга приложений.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.