Антипаттерны проектирования БД: как нормализовать таблицу и потерять данные, не удалив ни одного значения
Покажите мне ваши блок-схемы, но спрячьте ваши таблицы, и я по-прежнему буду в недоумении. Покажите мне ваши таблицы, и ваши блок-схемы мне обычно не понадобятся.
— Фредерик Брукс, “Мифический человеко-месяц”
Мы в Modus делаем ETL и BI, и видим чужие базы данных изнутри: на каждом внедрении, на техническом консультировании, на разборах кейсов и на каждой миграции. Навидались всякого. Но одна ошибка попадается так часто и прячется так ловко, что заслуживает отдельного разбора… и почётного звания антипаттерна. Начинаем цикл статей, посвящённых антипаттернам проектирования баз данных именно с неё.
Представьте: миграция позади. Заказы, товары и склады на месте. Число строк сошлось, проверки горят зелёным, можно закрывать задачу. Но только никто — ни аналитик, ни разработчик, ни самый хитрый SQL-запрос, — уже не скажет, с какого склада уехал конкретный товар.
Не удалено ни одного значения. А данные протеряны.
Это сбой миграции? Ошибка в запросе? Нет!
Это ошибка проектирования, которая очень похожа на безобидную нормализацию. Давайте разберём, откуда она берётся, почему стандартные проверки её не видят и почему исправить её задним числом уже нельзя. Не «дорого и сложно», а вообще невозможно математически.
А в конце — задачка для тех, кто (как и мы когда-то) уверен, что опыт и знания надёжно ограждают его от таких новичковых ошибок.
Все примеры — для PostgreSQL, на временных таблицах. Запускайте их по порядку и в одной сессии: каждый следующий опирается на таблицы из предыдущих.
Содержание
Как мы всё сломали
Всё началось вполне стандартно, вот с такой таблицы. В ней жили отгрузки товаров по складам. Каждая строка утверждает простую вещь: этот товар уехал с этого склада по этому заказу.
CREATE TEMP TABLE original (
    order_id     integer NOT NULL,
    product_id   text    NOT NULL,
    warehouse_id text    NOT NULL,
    PRIMARY KEY (order_id, product_id, warehouse_id)
);

INSERT INTO original VALUES
(42, 'laptop', 'north'),
(42, 'mouse',  'south');
Ноутбук уехал с северного склада, манипулятор типа “Мышь” — с южного. Пока отгрузок было немного, таблица никого не смущала. Потом на неё взглянул архитектор и что-то заподозрил. А как посмотрел на ER-диаграммы, то и вовсе заподозрил по-крупному.
— Что у нас есть?
— Заказ!
— Что в заказе?
— Товары!
— Откуда заказ отгружается?
— Со складов!
Две связи «многие ко многим» — значит, две таблицы. Звучит как план.
И ведь каждая связь по отдельности верна. Ноутбук и мышка в заказе 42 точно есть, а северный и южный склады его действительно отгружали. Придраться не к чему.
Сказано — сделано:
CREATE TEMP TABLE order_product AS
SELECT DISTINCT order_id, product_id
FROM original;

CREATE TEMP TABLE order_warehouse AS
SELECT DISTINCT order_id, warehouse_id
FROM original;
Новая схема выглядит опрятно, приложения работают, данные пишутся. Все сущности на месте — товары, склады, их привязка к заказам. Казалось всё отлично… пока не пришел BI-разработчик — ему нужна витрина, где видно, какой товар уехал с какого склада в каждом заказе. Без проблем — быстро пишем запрос, встраиваем в ETL-процесс, зовём полюбоваться.
SELECT order_id, product_id, warehouse_id
FROM order_product
JOIN order_warehouse USING (order_id)
ORDER BY order_id, product_id, warehouse_id;
Наутро тот же BI-разработчик вернулся — уже не один, а с подкреплением в виде аналитика данных (что для дата-инженера обычно плохой знак). Они просят разобраться, почему за ночь отгрузок по складам ВНЕЗАПНО стало в два раза больше. Не верилось, что мы накосячили в простейшем запросе, поэтому проверили его, а затем переписали через CTE, потом через подзапросы, потом ещё, и ещё…
Но упрямый результат каждый раз был один и тот же:
order_id | product_id | warehouse_id |
|---|---|---|
42 | laptop | north |
42 | laptop | south |
42 | mouse | north |
42 | mouse | south |
Всё в нём было странно, но раз уж мы на опыте, то решили по-быстрому накинуть дедупликацию — чтоб отчётность в компании не встала, а с фокусами разберёмся потом. И сразу появились другие вопросы. По какому ключу дедуплицировать? Какие строки удалять? По каким таким данным понять, какие из них лишние?
Не может же быть, что мы сохранили и товары, и склады заказа — а затем потеряли с какого склада уехал конкретный товар! Ещё раз прошлись по запросу.
Препод в универе говорил:
Любую ошибку в запросе можно исправить, пока данные позволяют отличить правильный результат от неправильного.
Не мог же профессор ошибаться!
Профессор — не мог. А вот мы, когда меняли схему базы — запросто!
Фокус в том, что SQL тут ни при чём. Ошибка не в том, что мы не умеем писать запросы. Ошибка — в проектировании.
Причём ошибка с богатой родословной. Исходная строка утверждала один трёхместный факт: “Товар отгружен по заказу с этого склада”. Мы заменили его двумя двухместными фактами: “Товар есть в заказе” и “Склад отгрузил заказ”. А потом склеили их обратно по заказу и наивно решили, что исходный факт вернулся.
Ещё в 1970 году Эдгар Кодд (Edgar Frank Codd) в той самой статье, с которой вообще началась реляционная модель, назвал это ловушкой соединения (connection trap). Пример у него про поставщиков, детали и проекты. Пройти от поставщика через его детали к проектам, где эти детали используются — ещё не значит найти проекты, которые этот поставщик снабжает. Устройство то же самое: трёхместный факт пытаются собрать из двух двухместных связей через общий атрибут. У Кодда это деталь, у нас — заказ.
Пятьдесят шесть лет прошло, а грабли всё те же. Только теперь они называются нормализацией.
Немного теории
Если по-научному, мы разложили отношение на две проекции:
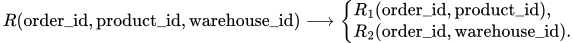
При соединении проекций вылезли ложные кортежи — сочетания, которых в источнике и близко не было. Называется это разложением с потерями (lossy decomposition). Обратное свойство — разложение без потерь соединения (lossless-join decomposition).
А починить-то можно?
Пока мы выяснили только одно: естественное соединение источник не восстановило. Но вдруг справится какой-нибудь другой запрос или хитрый алгоритм? Спойлер: нет!
Сохранившиеся таблицы совместимы как минимум с двумя вариантами: ноутбук уехал с северного склада, а мышка — с южного, или ровно наоборот. Проекции у обоих вариантов одинаковые. Число строк, уникальные значения, частоты значений в каждом столбце — всё совпадает (каждый товар и каждый склад встречаются по разу, заказ — дважды). Проверки, которые смотрят только на это, варианты не различат. Никак.
Вывод печален: никакой алгоритм, получающий только эти две проекции, не гарантирует точное восстановление исходного отношения. Можно угадать по косвенным признакам (например, подняв всю бухгалтерскую первичку), но без дополнительных источников — точно никак.
Представьте протокол Гран-при Формулы-1, разрезанный на две колонки: отдельно пилоты, отдельно позиции. Всё на месте, а кто победил? Видимо, машина безопасности, которая точно ни разу не ошиблась и не нарушила ни одного правила, потому что просто не выезжала. С нашими отгрузками ровно та же история.
Не верите — попробуйте написать запрос, который установит, с какого склада уехал ноутбук. Не получится. И дело не в опыте, просто одни и те же сохранённые данные совместимы с разными исходными отгрузками, а обосновать выбор между ними будет нечем. Алгоритм в обоих случаях получит один и тот же вход. Выберет одну историю — ошибётся, если на самом деле была другая.
Ошибку можно исправить, пока данные позволяют отличить правильный результат от неправильного.
Здесь не позволяют. Поэтому гарантированное восстановление невозможно.
У такого преобразования есть название — неинъективное (non-injective transformation): разные исходные состояния превращаются в один и тот же результат. Как в школьном примере — функция  : девятку она выдаст и при
 , и при
 . Попробуй угадай, что было на входе.
То же самое и в шахматах — по финальной позиции партию не восстановить, так как к одной и той же расстановке ведут разные порядки ходов. Поэтому партии записывают ходами, а не снимками доски.
У нас неинъективность случилась при разложении отношения на проекции: разные исходные отношения дали одинаковые результаты разложения. Но почему оно называется «с потерями», если строк, наоборот, стало больше?
Суть в том, что мы протеряли не данные, а саму возможность отвергнуть сочетания, которых никогда не было! Лишние строки в результате — это и есть потерянная информация. Только с обратным знаком.
Ещё немного теории
Для разложения без потерь должно выполняться строгое равенство:
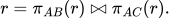
Здесь:
 — исходное отношение,
 — заказ,
 — товар,
 — склад,
 — проекция, содержащая заказ и товар,
 — проекция, содержащая заказ и склад,
 — соединение проекций по общему атрибуту A.
У нас оно не выполняется: в исходном отношении две строки, в соединении проекций — четыре.
Все проверки зелёные. И что?
Допустим, при восстановлении мы промахнулись: ноутбук приписали южному складу, манипулятор “Мышь” — северному. И запустили проверки миграции.
Результаты — загляденье:
Проверка | Источник | Восстановленная таблица |
|---|---|---|
Число строк | 2 | 2 |
Заказ | 42 | 42 |
Товары | laptop, mouse | laptop, mouse |
Склады | north, south | north, south |
Частота каждого товара | По одному разу | По одному разу |
Частота каждого склада | По одному разу | По одному разу |
Ну и зачем тогда эти ваши проверки миграций? Сами же видите, что они бесполезны! Пустая трата времени на разработку и поддержку!
Проверки миграций недолюбливают не за то, что они бесполезны, а как раз за то, что они честные и с ними не договориться. Они честно подтверждают ровно то, что измеряют: в данном случае это количества и распределения отдельных значений. Но соответствие товара складу они не проверяют — их об этом никто не просил.
Поэтому проверка миграции у нас в Modus всегда начинается с вопроса: какой факт вы были обязаны сохранить? У нас это отношение “Заказ — Товар — Склад”. Его и надо сравнивать в источнике и в восстановленном результате.
Мы редко встречали чек-листы критериев приёмки миграций — подавляющее большинство тех, с кем мы общались, показать их не смогли. Из того, что мы видели: совпало число строк, сошлись суммы по деньгам и COUNT(DISTINCT) по ключевым полям. Галочки стоят, акт подписан, а источник через неделю удалили (чтобы не занимал место).
Большинство из того, что нам показывали, проверяет столбцы по отдельности. А в нашей подмене каждый столбец содержит ровно те же значения, что и в источнике. Не «похожие», а те же самые, с теми же частотами. Значит, любая метрика, которая считается по каждому столбцу отдельно и не зависит от порядка строк, подмену просто не заметит. И инструмент тут ни при чём — детерминированная функция одинаковых аргументов неумолимо возвращает одинаковый результат.
Подмена живёт не в значениях, а в сочетаниях. Там её и ловим — сравниваем строки целиком. Вопрос к данным простой: есть ли факты, которые живут только по одну сторону миграции?
CREATE TEMP TABLE restored (LIKE original);
INSERT INTO restored VALUES
(42, 'laptop', 'south'),
(42, 'mouse',  'north');

SELECT 'Только в источнике' AS side, d.*
FROM (
    SELECT * FROM original
    EXCEPT ALL
    SELECT * FROM restored
) AS d

UNION ALL

SELECT 'Только в результате', d.*
FROM (
    SELECT * FROM restored
    EXCEPT ALL
    SELECT * FROM original
) AS d

ORDER BY side, product_id;
side | order_id | product_id | warehouse_id |
|---|---|---|---|
Только в источнике | 42 | laptop | north |
Только в источнике | 42 | mouse | south |
Только в результате | 42 | laptop | south |
Только в результате | 42 | mouse | north |
Четыре строки. Обе настоящие отгрузки исчезли, а вместо них появились две, которых никогда не было. Тот самый чек-лист, что горел зелёным, ничего не увидел. И не мог увидеть.
Две детали, на которых спотыкаются даже опытные дата-инженеры
Первая: EXCEPT ALL, а не EXCEPT. Обычный EXCEPT сравнивает множества, и если при переносе дубль потерялся или размножился, он тактично промолчит.
Вторая: EXCEPT считает NULL равными друг другу, а сверка через JOIN … ON a.col = b.col — нет. На пустых значениях такая сверка поднимет тревогу там, где всё в порядке.
Предвижу возражение: «На таблице в пару миллиардов строк ваш EXCEPT ALL будет считаться до утра!» Да, будет. Поэтому на больших объёмах сравнивают контрольные суммы строк по партициям и дочитывают только расходящиеся куски. Если интересно, дадим несколько примеров из опыта.
К слову, о каталогах проверок. В нашем блоге мы уже разбирали, как собирался DQ-шаблон через MCP: полнота, корректность, уникальность, согласованность, актуальность, одна таблица результатов и каталог правил.
Один из выводов такой: универсальным можно сделать каркас проверок, но не сами правила — они всегда доменные. Сверка фактов — как раз такое доменное правило. И никакая проверка столбцов её не заменит: чтобы её написать, сначала придётся сказать, какой именно факт миграция обязуется сохранить.
А как сверяете вы? Особенно интересно, если ваш способ ловит подмену, не сравнивая строки целиком. Мы утверждаем, что метриками по отдельным столбцам это невозможно, — и с огромным удовольствием признаем, что ошибаемся.
И последнее. Сверка фактов возможна, только пока жив источник. Удалили исходную таблицу — и доказать, что вы ничего не перепутали, уже не сможет никто.
Сколько неправд в одной витрине?
Когда в заказе всего два товара, по косвенным признакам ещё можно догадаться, что откуда уехало. Вариантов здесь маловато.
Кстати, а из скольких исходных вариантов нам придётся выбирать? И насколько это проблемно:
order_product
order_id | product_id |
|---|---|
42 | laptop |
42 | mouse |
order_warehouse
order_id | warehouse_id |
|---|---|
42 | north |
42 | south |
Сколько разных исходных таблиц могли дать такие проекции? «Очевидно же, что четыре: сам же давал выше запрос, который явно их выводит!» — ответил наш товарищ, опытный дата-инженер, когда мы показали ему набросок этой статьи.
Правильный ответ (не подглядывайте)
Не две. Не четыре. Семь!
Соединение проекций никогда не теряет исходных строк — только добавляет лишние. Значит, настоящая история спрятана где-то внутри четырёх строк соединения. Годится любой их набор, в котором каждый товар и каждый склад встречаются хотя бы раз. Партия ноутбуков вполне могла уехать с обоих складов сразу: половина с севера, половина с юга. Ни схема, ни данные этому не противоречат.
Вариант | laptop | mouse | Примечание |
|---|---|---|---|
1 | north | south | исходная таблица |
2 | south | north | |
3 | north, south | north | |
4 | north, south | south | |
5 | north | north, south | |
6 | south | north, south | |
7 | north, south | north, south |
Можно, конечно, сходить к бизнес-аналитикам и выяснить из них, что партиями мы не отгружаем. Тогда вариантов останется два. А вдруг они разведут руками: “В требованиях не написано, что не отгружаем”?
А если в заказе было 10 различных товаров — каждый уехал со своего склада, а каждый склад отгрузил ровно один товар? Давайте посчитаем, сколько исходных вариантов даст наше разложение даже при таких (жёстких с точки зрения современной ERP-системы) условиях.
Первому товару можно назначить любой из десяти складов. Второму — любой из девяти оставшихся: один склад уже занят. Третьему — любой из восьми. Последнему достанется единственный свободный. Итого для 10 позиций заказа:
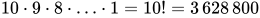
Тут уже по косвенным признакам сложно угадать… Под спойлером запрос, который покажет возможные варианты. Для десяти товаров он выдаст 3,6 миллиона строк, запускайте осторожно:
Перебор возможных вариантов
WITH RECURSIVE possible_cases AS (
    SELECT ARRAY[]::integer[] AS warehouse_by_product

    UNION ALL

    SELECT array_append(c.warehouse_by_product, w.warehouse_id)
    FROM possible_cases AS c
    CROSS JOIN generate_series(1, 10) AS w(warehouse_id)
    WHERE cardinality(c.warehouse_by_product) < 10
      AND NOT (
          w.warehouse_id = ANY (c.warehouse_by_product)
      )
)
SELECT
    42 AS order_id,
    warehouse_by_product
FROM possible_cases
WHERE cardinality(warehouse_by_product) = 10;
В массиве на выходе индекс элемента — это товар, а значение — склад.
Два варианта, о которых шла речь выше, — самый оптимистичный случай: мы точно знаем, что каждый товар уехал ровно с одного склада. Для десяти товаров и десяти складов даже такой оптимизм даёт 3 628 800 вариантов! А вдруг аналитик растерянно улыбнётся и скажет, что такого требования нет и товар может уезжать откуда угодно?
Сколько тогда вариантов для десяти товаров и складов?
SELECT
    m AS products,
    n AS warehouses,
    sum(
        CASE WHEN k % 2 = 0 THEN 1 ELSE -1 END
         div(factorial(n), factorial(k)  factorial(n - k))
        * (2::numeric ^ (n - k) - 1) ^ m
    )::numeric(40, 0) AS histories
FROM (VALUES (2, 2), (3, 3), (10, 10)) AS t(m, n)
CROSS JOIN LATERAL generate_series(0, n) AS k
GROUP BY m, n
ORDER BY m;
products | warehouses | histories |
|---|---|---|
2 | 2 | 7 |
3 | 3 | 265 |
10 | 10 | 1243237913592275536716800402887 |
Тридцать одна цифра! Витрина не просто врёт. Она врёт одним из  возможных способов, и мы не знаем, каким! И это, на минуточку, один заказ. Варианты по заказам перемножаются.
Даже при самых жёстких условиях хватит 13 заказов по 10 позиций, чтобы число историй, совместимых с нашими данными, превысило число атомов в наблюдаемой Вселенной. Тринадцать заказов. А у вас в таблице сколько?
Что на это скажут Хит и Фейгин
Как потерять данные, мы с вами отлично знаем. Но как их сохранить? Что сделает разложение обратимым? И как теперь таблицы-то нормализовывать?!
Тут нас выручит теорема Хита (Heath’s Theorem) 1971 года. Она задаёт достаточное условие разложения без потерь. Звучит она так: пусть отношение имеет схему  , где
 — непересекающиеся группы атрибутов. Если выполняется функциональная зависимость
 , то отношение можно без потерь разложить на проекции
 и
 . Тогда и равенство, которое мы приводили выше, выполняется.
Проще говоря, достаточно, чтобы общие атрибуты проекций однозначно определяли значения одной из отделяемых частей. А еще проще — одному не могут соответствовать разные .
У нас общим атрибутом был номер заказа. Но он не определял ни товар, ни склад: в одном заказе было несколько товаров и несколько складов. Значит, мимо.
Теорема задаёт лишь достаточное условие. Если такой функциональной зависимости нет, это ещё не значит, что разложение обязательно выйдет с потерями. Но что тогда делать, если её действительно нет?
Точный ответ дал Рональд Фейгин (Ronald Fagin) в 1977 году. Разложение на «Заказ — Товар» и «Заказ — Склад» обратимо только тогда, когда у каждого заказа набор товаров и набор складов независимы. Иными словами, каждый товар заказа уезжал с каждого его склада — это называется многозначной зависимостью.
Пример
Вот заказ 43: ноутбук и мышка, каждый — и с севера, и с юга. Заказ склад отгрузки не определяет, теорема Хита разводит руками, а разложение собирается обратно без единой лишней строки. Проверить свои данные можно одним запросом:
CREATE TEMP TABLE shipments_mvd (LIKE original INCLUDING ALL);

INSERT INTO shipments_mvd VALUES
(42, 'laptop', 'north'),
(42, 'mouse',  'south'),
(43, 'laptop', 'north'),
(43, 'laptop', 'south'),
(43, 'mouse',  'north'),
(43, 'mouse',  'south');

SELECT
    order_id,
    count(DISTINCT product_id) * count(DISTINCT warehouse_id) AS rows_after_join,
    count(*)                                                  AS rows_in_source
FROM shipments_mvd
GROUP BY order_id
ORDER BY order_id;
Результат:
order_id | rows_after_join | rows_in_source |
|---|---|---|
42 | 4 | 2 |
43 | 4 | 4 |
Теперь назовём вещи своими именами — мы не «немного ошиблись с нормализацией». Мы привели таблицу к четвёртой нормальной форме — той самой, которую на собеседованиях дата-инженеров и тем более архитекторов DWH совершенно, на наш взгляд, опрометчиво считают академической экзотикой. Только сделали это по многозначной зависимости, которой в данных никогда не было, и которую 4НФ как раз и обязана устранять.
Когда вы последний раз видели 4НФ в проде — осознанно? Подозреваем, что неосознанно она встречается куда чаще.
И ещё одна ловушка, о которой мы поговорим в одной из следующих статей — запрос выше показывает, что зависимость выполняется на сегодняшних данных. Но сегодняшние данные — не закон природы. Завтра придёт заказ 44…
Правило, которое не записано в схему
Так какие у нас были альтернативы? Рассмотрим частые практические варианты.
Бизнес-правило «Товар определяет склад»
Если конкретный товар может уезжать только с одного склада, храним товары заказов и соответствие товаров складам:
DROP TABLE IF EXISTS order_product, product_warehouse;

CREATE TEMP TABLE order_product AS
SELECT DISTINCT order_id, product_id
FROM original;

CREATE TEMP TABLE product_warehouse AS
SELECT DISTINCT product_id, warehouse_id
FROM original;
Собрать всё обратно можно запросом:
SELECT order_id, product_id, warehouse_id
FROM order_product
JOIN product_warehouse USING (product_id);
Бизнес-правило «Склад определяет товар»
Если склады специализированные и каждый отгружает только один вид товара, соответствие сохранится, даже если товар в заказе уезжает с нескольких складов:
DROP TABLE IF EXISTS order_warehouse, warehouse_product;

CREATE TEMP TABLE order_warehouse AS
SELECT DISTINCT order_id, warehouse_id
FROM original;

CREATE TEMP TABLE warehouse_product AS
SELECT DISTINCT warehouse_id, product_id
FROM original;
Обратно собираем так:
SELECT order_id, product_id, warehouse_id
FROM order_warehouse
JOIN warehouse_product USING (warehouse_id);
В этих примерах мы проверили обратимость разложения на уже существующих данных. Чтобы она никуда не делась, бизнес-правила, на которые опирается разложение, должны выполняться и дальше.
Звучит логично, вот только кто именно будет следить за их выполнением? Аналитик? Нейросеть, которая за час напишет импорт из нового маркетплейса? Код-ревьюер в пятницу вечером?
Посмотрите внимательно на наши как бы правильные таблицы. Они созданы через CREATE TABLE AS, то есть без единого ключа. Вставляем ноутбуку второй склад — база молча соглашается, и лишняя строка в витрине тут как тут. Добавляем в заказ клавиатуру, для которой склад ещё не завели — база снова соглашается, а соединение тихонько выбрасывает позицию. Только что боролись с лишними строками, а теперь теряем настоящие.
Бизнес-правило, которое не записано в схему, не выполняется!. Разве что до первого импорта.
А теперь покажем, как это исправить.
Записываем правила в схему
Разберем вариант, где товар определяет склад:
DROP TABLE IF EXISTS order_product, product_warehouse;

CREATE TEMP TABLE product_warehouse (
    product_id   text PRIMARY KEY,
    warehouse_id text NOT NULL
);

CREATE TEMP TABLE order_product (
    order_id   integer NOT NULL,
    product_id text    NOT NULL REFERENCES product_warehouse (product_id),
    PRIMARY KEY (order_id, product_id)
);

-- Пробуем вставить данные

INSERT INTO product_warehouse SELECT DISTINCT product_id, warehouse_id FROM original;
INSERT INTO order_product     SELECT DISTINCT order_id, product_id     FROM original;

-- А так получится?

INSERT INTO product_warehouse VALUES ('laptop', 'south');
INSERT INTO order_product     VALUES (44, 'keyboard');
ERROR:  duplicate key value violates unique constraint "product_warehouse_pkey"
DETAIL:  Key (product_id)=(laptop) already exists.

ERROR:  insert or update on table "order_product" violates foreign key constraint "order_product_product_id_fkey"
DETAIL:  Key (product_id)=(keyboard) is not present in table "product_warehouse".
Теперь “товар определяет склад” — это не устная договорённость, а самый настоящий PRIMARY KEY (product_id). И приятный бонус: ключ проверяет правило прямо во время миграции. Если в исходных данных ноутбук хоть раз уезжал с двух складов, INSERT упадёт. И вы узнаете об этом до того, как удалите исходную таблицу.
Кто уже начал писать комментарии, что “этот ваш контроль на уровне СУБД — для динозавров, а у нас, в продвинутом технологичном high-load’е, целостность проверяется в приложении, потому что эти ваши ненужные ключи тормозят вставку наших мильярдов записей в секунду!”, — расскажите заодно, сколько у вас приложений пишет в эту базу. И сколько из них знает про все правила. И как вы добиваетесь этой согласованности.
Но если ключ в схеме записать просто негде? В аналитических хранилищах это скорее норма, чем экзотика.
Разберём на примерах ClickHouse и GreenPlum
В ClickHouse PRIMARY KEY — это ключ сортировки и разреженный индекс, а вовсе не уникальность. Документация прямо говорит: строк с одинаковым первичным ключом может быть сколько угодно. FOREIGN KEY у него тоже не более, чем метаданные.
Честно работает только CONSTRAINT … CHECK: условие проверяется для каждой строки INSERT. Для правил внутри одной строки — отлично. Для «товар определяет склад» — мимо, так как нам нужно правило на несколько строк сразу.
А ReplacingMergeTree? Он схлопывает строки с одинаковым ключом сортировки, но только при слиянии кусков, когда у сервера дойдут руки (до этого дубли прекрасно видны в обычном SELECT). И главное: конфликт он не отвергает, а молча разрешает. Из пары “Ноутбук — Север” и “Ноутбук — Юг” FINAL оставит последнюю вставленную. Правило вроде бы соблюдено, а отгрузка с севера тихо испарилась.
Greenplum, как наследник PostgreSQL, ключи знает, но с оговорками. Первичный ключ и UNIQUE разрешены, только если таблица распределена по хешу (или реплицирована), а столбцы ключа включают ключ распределения DISTRIBUTED BY. То есть PRIMARY KEY (product_id) будет работать как настоящий первичный ключ, только если product_warehouse распределена по product_id. А внешние ключи объявить можно, но целостность никто проверять не будет: так прямо и написано в документации. Клавиатура без склада заедет в order_product так же беззаботно, как в таблицу без ключей.
Что остаётся? Проверять правила в самом конвейере загрузки. Каждое правило — это запрос, который при соблюдении правила возвращает пустой результат. Не пусто — загрузку останавливаем, а не “потом разберёмся”:
-- Контрольные запросы: оба должны вернуть пустой результат.

-- Непусто — загрузку останавливаем.
-- Правило "товар определяет склад"

SELECT product_id
FROM product_warehouse
GROUP BY product_id
HAVING count(DISTINCT warehouse_id) > 1;

-- Позиции без склада (тот самый внешний ключ, которого нет)

SELECT o.order_id, o.product_id
FROM order_product AS o
WHERE NOT EXISTS (
    SELECT 1
    FROM product_warehouse AS p
    WHERE p.product_id = o.product_id
);
На наших таблицах с ключами оба запроса вернут пусто. Так и задумано.
В ClickHouse первый запрос работает как есть, а со вторым есть классическая ловушка. Привычный антиджойн через LEFT JOIN … WHERE p.product_id IS NULL там по умолчанию не вернёт ничего: несовпавшие строки получают не NULL, а значения по умолчанию (пустую строку, ноль), пока не включена настройка join_use_nulls. Надёжнее явный LEFT ANTI JOIN product_warehouse AS p USING (product_id).
И раз уж зашла речь, EXCEPT ALL для сверки фактов в ClickHouse тоже есть, а обычный EXCEPT там по умолчанию и так ведёт себя как EXCEPT ALL (настройка except_default_mode). Ровно наоборот, чем в PostgreSQL.
Поэтому переносите запросы между базами данных очень внимательно. Помните: это не просто абстрактные гигабайты информации, а реальные бизнес-факты.
Правило следующее. Нет ключа в схеме — значит, ключ живёт в ETL-пайплайне. Или нигде.
Прежде чем читать дальше — изучите эти две схемы. Обе собраны из одной исходной таблицы, и в обеих есть order_warehouse — та самая, с которой начались наши беды. Данные в ней одинаковые до байта.
Схема А:
order_warehouse + order_product.Схема Б:
order_warehouse + warehouse_product.
Одна из них теряет данные, другая — нет. Какая?
Как бы вы ни ответили, вы либо угадали, либо ошиблись, потому что по самим таблицам ответить нельзя.
Смотрите
-- Одни и те же исходные данные, одна и та же order_warehouse

DROP TABLE IF EXISTS order_warehouse, order_product, warehouse_product;

CREATE TEMP TABLE order_warehouse
AS SELECT DISTINCT order_id, warehouse_id   FROM original;

CREATE TEMP TABLE order_product
AS SELECT DISTINCT order_id, product_id     FROM original;

CREATE TEMP TABLE warehouse_product
AS SELECT DISTINCT warehouse_id, product_id FROM original;

SELECT 'схема А: order_warehouse + order_product' AS schema, count(*) AS rows
FROM order_warehouse JOIN order_product USING (order_id)
UNION ALL
SELECT 'схема Б: order_warehouse + warehouse_product', count(*)
FROM order_warehouse JOIN warehouse_product USING (warehouse_id);
Схема А — четыре строки, наша старая знакомая. Схема Б — ровно две, всё на месте. А таблица одна и та же. В одном разложении она — источник неправды, в другом — вполне законная часть.
Отсюда вывод, который не понравится любителям проверять нормализацию по ER-диаграмме: нормализованных таблиц не бывает! Бывают схемы, нормализованные относительно конкретных зависимостей. Нет зависимости в схеме — нечего проверять на ревью.
Зато стоит дописать PRIMARY KEY (warehouse_id) в warehouse_product — и схема Б читается с первого взгляда: склад определяет товар. Ключ — это зависимость, записанная так, чтобы её увидели и база, и ревьюер.
А если ключ поменяется?
Помните, выше мы разбирали бизнес-правила “Товар определяет склад” и “Склад определяет товар”? Согласитесь, в жизни чаще встречается правило “Пока не знаем как надо, сделайте универсально”.
Если склады и товары связаны как попало универсально, выручит идентификатор строки заказа, например order_item_id. Сделаем его сквозным и заведём новую таблицу, которую потом разрежем:
CREATE TEMP TABLE original_with_items (
    order_item_id integer PRIMARY KEY,
    order_id      integer NOT NULL,
    product_id    text    NOT NULL,
    warehouse_id  text    NOT NULL
);

INSERT INTO original_with_items
    (order_id, order_item_id, product_id, warehouse_id)
VALUES
    (42, 1, 'laptop', 'north'),
    (42, 2, 'mouse',  'south'),
    (43, 3, 'laptop', 'south');
С этим идентификатором исходную таблицу можно разложить на три:
CREATE TEMP TABLE order_order_item AS
SELECT order_id, order_item_id
FROM original_with_items;

CREATE TEMP TABLE order_item_product AS
SELECT order_item_id, product_id
FROM original_with_items;

CREATE TEMP TABLE order_item_warehouse AS
SELECT order_item_id, warehouse_id
FROM original_with_items;
А потом без потерь собрать обратно:
SELECT
    o.order_id,
    o.order_item_id,
    p.product_id,
    w.warehouse_id
FROM order_order_item AS o
JOIN order_item_product AS p USING (order_item_id)
JOIN order_item_warehouse AS w USING (order_item_id)
ORDER BY o.order_item_id;
Лишних строк нет: для каждой позиции в каждой проекции ровно одна строка. Идентификатор позиции заодно служит ключом записи об отгрузке. Разложение обратимо. Наконец-то!
Вы серьёзно хотите подсунуть эту поделку серьёзным читателям Хабра? Позицию заказа — на три таблицы? Сделайте одну
order_itemsс ключом и не позорьте компанию своими статьями!
И это справедливое замечание. В учётной системе так обычно и делают — мы регулярно с этим сталкиваемся.
Но наш пример — не для подражания, а для демонстрации принципа: если у факта есть ключ, его можно резать по этому ключу как угодно, и он соберётся обратно без единой лишней строки.
Да, звучит как упражнение из учебника. Но на этом стоят Anchor modeling, шестая нормальная форма и сателлиты Data Vault (вполне себе прод, а не учебник). Там атрибуты разносят по таблицам, чтобы история каждого жила своей жизнью. Условие одно: ключ есть, и он не меняется.
На вере в то, что он не меняется, часто спотыкаются многие. В мире ETL это бывает куда чаще, чем в мире OLTP. Много десятков часов было проведено в подрядах по восстановлению данных, после того как их владельцы не учли этот нюанс. Поэтому внезапная смена ключа опытному дата-инженеру не кажется чем-то невообразимым.
Некто каким-то образом решает, что генерировать ключи при вставке в витрину — плохо, и собирает ключ из номера документа и номера строки. Это, по его словам, удобно и надёжно — но, по нашему опыту, ровно до того, как пользователь задним числом удаляет из документа первую строку.
Что в этом случае происходит? ETL-процесс берёт под козырёк и заливает новую реальность поверх старой.
CREATE TEMP TABLE dwh_shipment_items (
    doc_ref      text    NOT NULL,   -- Ссылка на документ
    line_no      integer NOT NULL,   -- Номер строки документа
    product_id   text    NOT NULL,
    warehouse_id text    NOT NULL,
    PRIMARY KEY (doc_ref, line_no)
);

-- Первая выгрузка документа

INSERT INTO dwh_shipment_items VALUES
('ship-42', 1, 'laptop',   'north'),
('ship-42', 2, 'mouse',    'south'),
('ship-42', 3, 'keyboard', 'north');

-- Пользователи удалили первую строку, остальные перенумеровались.
-- Инкрементальная загрузка изменённых строк по ключу (doc_ref, line_no):

INSERT INTO dwh_shipment_items VALUES
('ship-42', 1, 'mouse',    'south'),
('ship-42', 2, 'keyboard', 'north')
ON CONFLICT (doc_ref, line_no) DO UPDATE
SET product_id   = EXCLUDED.product_id,
    warehouse_id = EXCLUDED.warehouse_id;

SELECT * FROM dwh_shipment_items ORDER BY line_no;
В документе две позиции, в хранилище три. Клавиатура отгружена дважды. Уникальность ключа в порядке, и все проверки дружно отчитались, что проблем нет.
Ключ позиции — не ключ отгрузки
Возвращаемся от ETL-процессов к теории. Сначала хочется обобщить результат до универсального рецепта: храните идентификатор позиции во всех таблицах — и любые сведения о ней соберутся обратно. Но насколько далеко нам может завести эта гарантия? Можно ли теперь разнести любые сведения о позиции по отдельным таблицам и собрать их по order_item_id?
Давайте проверим!
Позиция заказа: два ноутбука. Один уехал с северного склада, второй — с южного, у каждого свой код “Честного знака”. Складская система знает склад, система маркировки — коды. Обе аккуратно хранят ссылку на позицию заказа. Ключ на месте, в каждой таблице. В хранилище соединяем по нему:
-- Два ноутбука, отгружены частями с двух складов

CREATE TEMP TABLE item_units (
    marking_code  text    PRIMARY KEY,   -- код Честного знака
    order_item_id integer NOT NULL,
    warehouse_id  text    NOT NULL
);

INSERT INTO item_units VALUES
('MODUS-001', 1, 'north'),
('MODUS-002', 1, 'south');

-- Складская система знает склады позиции, система маркировки — коды позиции

CREATE TEMP TABLE item_warehouse AS
SELECT DISTINCT order_item_id, warehouse_id FROM item_units;

CREATE TEMP TABLE item_marking AS
SELECT DISTINCT order_item_id, marking_code FROM item_units;

-- Хранилище соединяет их по ключу позиции

SELECT order_item_id, marking_code, warehouse_id
FROM item_marking
JOIN item_warehouse USING (order_item_id)
ORDER BY marking_code, warehouse_id;
Результат сулит нехилые штрафы:
order_item_id | marking_code | warehouse_id |
|---|---|---|
1 | MODUS-001 | north |
1 | MODUS-001 | south |
1 | MODUS-002 | north |
1 | MODUS-002 | south |
Четыре строки на два ноутбука. Какой код уехал с какого склада, теперь не скажет никто. Но примерно ясна реакция проверяющего, когда коды не сойдутся с остатками.
Теорема Хита, не врёт: идентификатор позиции определяет всё о позиции. Проблема в том, что факт уже не про позицию. Как только позицию отгрузили частями, единицей факта стал экземпляр, а ключом — код маркировки.
Идентификатор защищает только то, ключом чего он является
Поэтому перед любым разложением стоит ответить на принципиальный вопрос: что именно описывает одна строка? Заказ, позицию или экземпляр? Кимбалл называл это зерном факта (grain). Ошиблись с зерном — и никакой ключ уже не спасёт.
А всегда ли нужна обратимость?
Намекаете, что теперь каждую миграцию нужно предварительно через теорему Хита гонять? У меня вообще-то спринт, а не диссертация!
Нет, мы о другом. Обратимость — не религия. Бывает, что необратимость — это правильно. А бывает, что это вообще требование закона. Тогда возникает два вопроса — что утверждает одна строка источника и что мы обязуемся восстановить после преобразования? Смотрите, как по-разному они срабатывают:
Преобразование | Одна строка источника утверждает, что… | После преобразования обязуемся восстановить… | Вердикт |
|---|---|---|---|
Разложение отгрузок на “Заказ — Товар” и “Заказ — Склад” | товар позиции отгружен с этого склада | каждую тройку “Заказ — Товар — Склад” | Нужна обратимость. Её нет — это антипаттерн |
Витрина продаж по дням и складам | позиция заказа продана на эту сумму | сумму и количество продаж за день по складу | Необратимо и правильно. Отдельные заказы восстанавливать не обещали |
Обезличивание данных клиентов для аналитиков | заказ сделал этот покупатель | ничего о личности покупателя | Необратимость — требование. Обратимое преобразование здесь — нарушение |
Витрина продаж по дням необратима, и это нормально: отдельные заказы из неё никто восстанавливать не обещал. Но даже здесь обещание диктует схему. Обещали восстановить сумму — значит, хранить нужно сумму и количество, а не средний чек. Почему — расскажем в одной из следующих статей.
А с обезличиванием всё наоборот: там обратимость — нарушение. 152-ФЗ так прямо и говорит: после обезличивания без дополнительной информации определить владельца данных должно быть невозможно. Если вся анонимизация — это хеш от телефона (видели и такой пример), у нас плохая новость: российских мобильных номеров около миллиарда, и перебрать их хеши можно за минуты. Выглядит необратимо, а на деле — нет.
Ошибка не в необратимости. Ошибка — в необратимости, о которой никто не договаривался!
Резюмируем
Итак, антипаттерн проектирования формулируем так:
Объявление набора проекций полноценной заменой исходного отношения без обоснования возможности восстановления тех фактов, которые система обязана сохранять.
Как его обойти? Если новые таблицы должны заменить исходную, обходим пониманием, за счёт каких сохранённых связей мы восстановим исходные факты из оставшихся таблиц.
А теперь — задачка со звёздочкой, как обещали.
Вот четыре отгрузки:
CREATE TEMP TABLE shipments (
    order_id     integer NOT NULL,
    product_id   text    NOT NULL,
    warehouse_id text    NOT NULL,
    PRIMARY KEY (order_id, product_id, warehouse_id)
);

INSERT INTO shipments VALUES
(42, 'laptop', 'north'),
(42, 'laptop', 'south'),
(42, 'mouse',  'north'),
(43, 'laptop', 'north');
Попробуйте разложить эту таблицу на две проекции так, чтобы она собралась обратно без лишних строк.
Спойлер: Не выйдет! Каждая пара подкинет свою лишнюю строку.
А на три — запросто. Каждая проекция по отдельности ничего не знает, а вместе они восстанавливают таблицу точно. Почему так? И какое бизнес-правило должно выполняться, чтобы это работало не только на этих четырёх строках, а всегда?
Подсказка: этот случай разобрал ещё Кодд в 1970 году, только у него были поставщики, детали и проекты. Ответ опубликуем в комментариях, а до тех пор готовы отвечать там на любые вопросы по статье. Если решите раньше — пишите, лучшие решения добавим апдейтом в статью с упоминанием автора.
Какой антипаттерн разберём следующим, мы ещё выбираем: среди кандидатов есть и академические, и сугубо практические. В выборе можете поучаствовать и вы.
А пока — проверьте свою последнюю миграцию запросом с EXCEPT ALL. Вдруг пустой результат — это не про вас.
P. S. Присоединяйтесь к нашему BI-сообществу в Telegram и будьте в курсе последних новостей Modus!
Источники
E. F. Codd. A Relational Model of Data for Large Shared Data Banks. Communications of the ACM, 1970. Ловушка соединения — раздел 2.1.4: https://www.engineering.upenn.edu/~zives/03f/cis550/codd.pdf
I. J. Heath. Unacceptable File Operations in a Relational Data Base. ACM SIGFIDET Workshop, 1971: https://doi.org/10.1145/1734714.1734717
R. Fagin. Multivalued Dependencies and a New Normal Form for Relational Databases. ACM Transactions on Database Systems, 1977: https://doi.org/10.1145/320557.320571
R. Kimball, M. Ross. The Data Warehouse Toolkit — о зерне факта (grain).
OEIS A048291 — последовательность 1, 7, 265, 41503…: число вариантов, которое считает наша формула: https://oeis.org/A048291
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.