SQL, NoSQL, NewSQL, Distributed SQL: как читать архитектуру СУБД
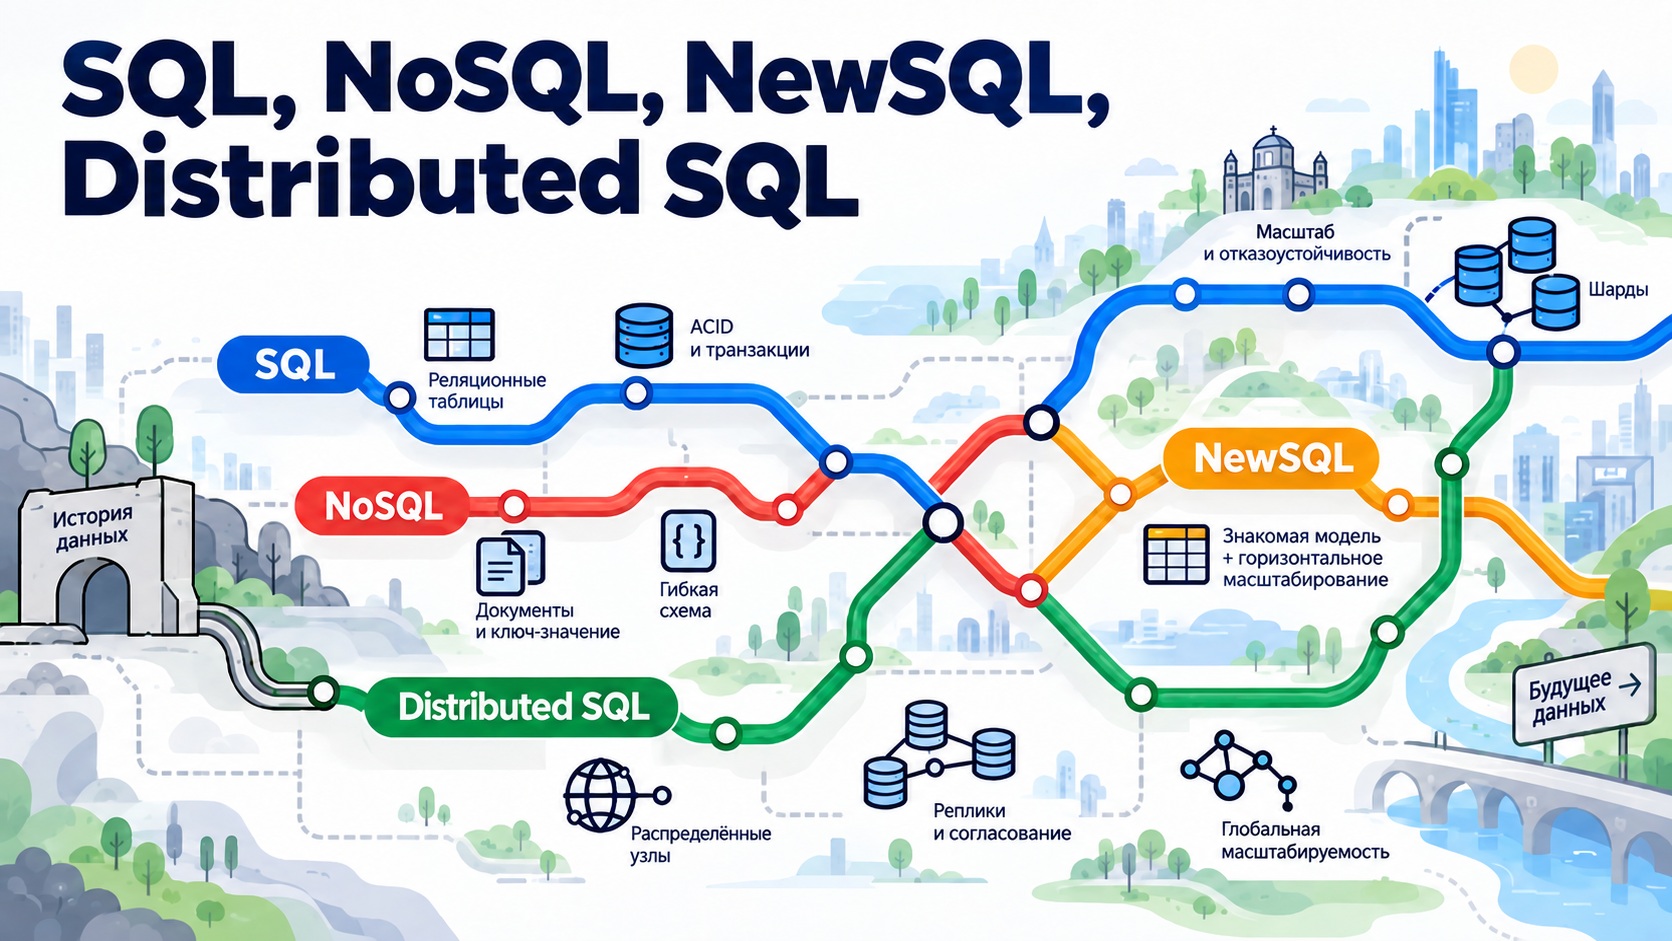
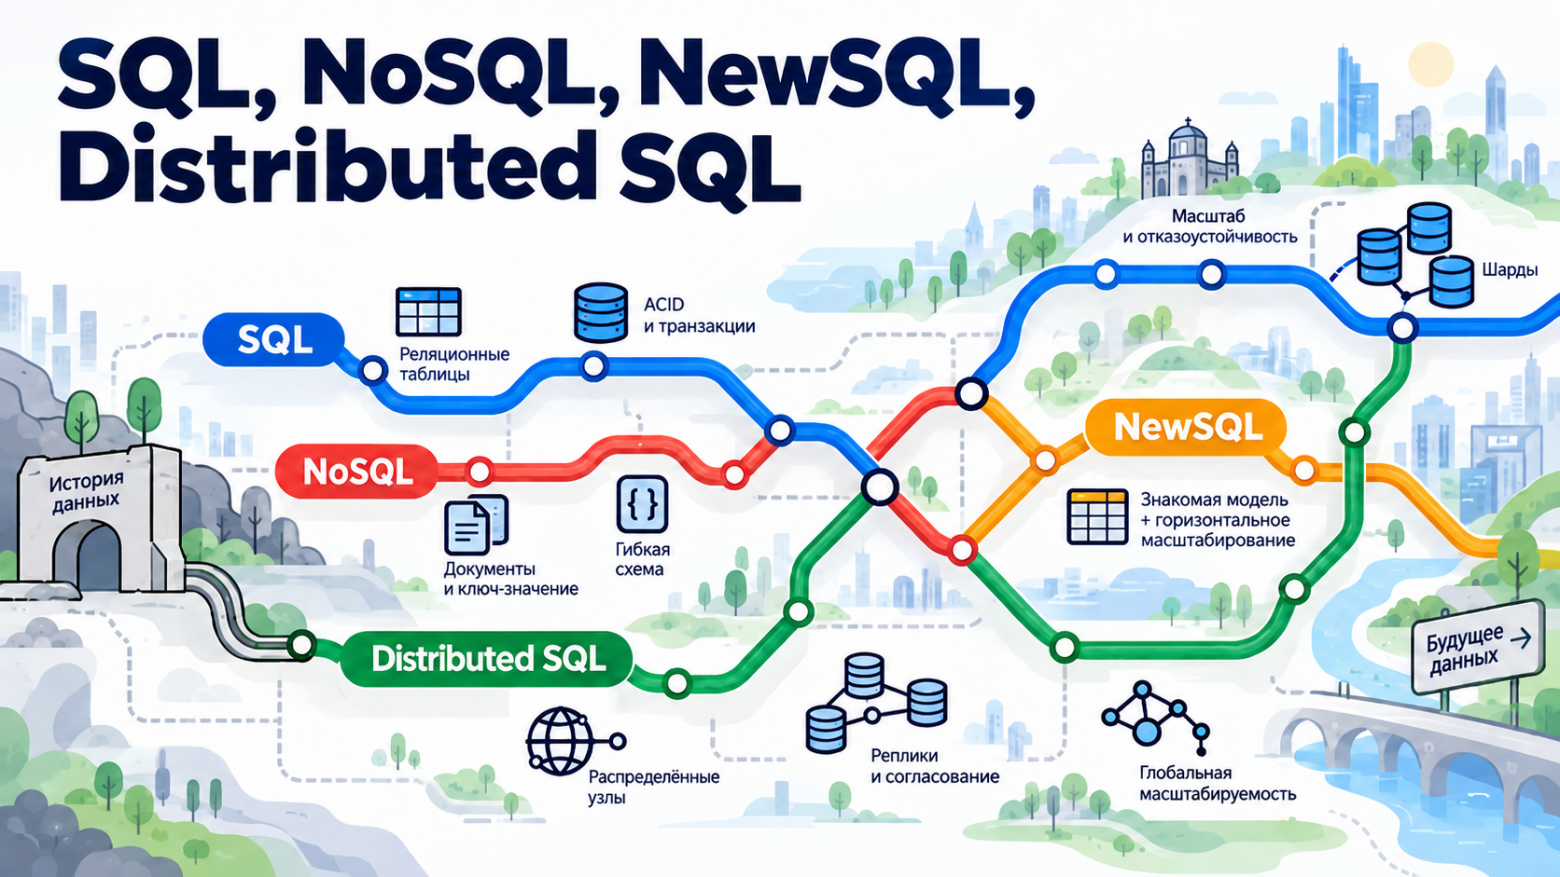
Для человека, впервые погружающегося в историю систем управления базами данных, последовательность SQL → NoSQL → NewSQL выглядит как диалектическая триада: тезис, антитезис, синтез. Сначала традиционные реляционные СУБД стали основой большинства коммерческих информационных систем, затем на волне NoSQL появились архитектуры, которые ради горизонтального масштабирования отказывались от части привычных реляционных ограничений и гарантий, и наконец направление NewSQL попыталось взять лучшее от обоих миров: SQL и ACID – от реляционных СУБД, горизонтальное масштабирование – от NoSQL. Хрестоматийный пример технологической эволюции, когда каждый следующий этап преодолевает ограничения предыдущего, не правда ли? Проблема только в том, что реальная история развития СУБД была совсем не такой линейной.
Распределённые реляционные СУБД существовали задолго до слова NewSQL. NoSQL объединял системы, сильно различавшиеся по модели данных, интерфейсам и гарантиям. А под вывеской NewSQL в разные годы оказывались системы настолько разной архитектуры, что одного этого термина стало недостаточно, чтобы понять устройство конкретной СУБД.
Чтобы разобраться в теме, следует обращать внимание не на то, к какому «поколению» относится база данных, а на то, как она устроена. Такой подход не даст стройной периодизации, зато позволит не подменять реальную историю удобной классификацией. Нас будет интересовать, как возникали, сосуществовали и развивались архитектурные идеи, воплощавшиеся в конкретных СУБД.
SQL до NewSQL: распределённость уже была
Классические реляционные СУБД на протяжении десятилетий оставались основой транзакционных систем. Зрелость реляционных технологий, декларативный язык запросов, ограничения целостности и развитая транзакционная модель сделали такие СУБД стандартным выбором для корпоративных и критически важных приложений. При этом распространённая сегодня ретроспективная картина «раньше SQL-база жила на одном сервере, а потом появились распределённые системы» не соответствует действительности.
Параллельные и распределённые реляционные СУБД, shared-nothing-архитектуры, а также механизмы репликации и секционирования данных появились задолго до NewSQL. Tandem NonStop SQL, Teradata и ряд исследовательских систем в 1980–1990-х годах решали задачи распределённого хранения и параллельной обработки запросов. Однако типичное OLTP-развёртывание долгое время действительно масштабировалось прежде всего вертикально.
Пока нагрузку можно было обслуживать на одном достаточно мощном сервере, границы его возможностей отодвигали, добавляя процессоры, память и более быстрое хранилище. Репликацию использовали прежде всего для повышения доступности, а в некоторых архитектурах — и для масштабирования чтения. Если объём данных или нагрузка перерастали возможности одного узла, приходилось прибегать к шардингу — нередко ручному, видимому приложению и требующему отдельной эксплуатационной логики.
С ростом интернет-сервисов модель вертикального масштабирования и ручного распределения данных стала всё чаще упираться не только в технические, но и в экономические ограничения.
Возникла потребность в горизонтальном масштабировании — возможности добавлять узлы и распределять между ними данные и нагрузку, причём без необходимости переносить в прикладной код логику распределения данных, маршрутизации запросов и обработки отказов
NoSQL: не просто «отказ от SQL»
На часть этих проблем индустрия ответила волной NoSQL. Само название оказалось не особенно удачным: хотя многие ранние NoSQL-системы сознательно не предоставляли SQL-интерфейс, весь класс не сводился к обязательному отказу от SQL или транзакций. Под общим названием NoSQL объединили несколько параллельно развивавшихся направлений: key-value, документные, графовые, wide-column и другие типы систем, сильно различавшиеся по модели данных, интерфейсам и гарантиям.
При этом у многих ранних NoSQL-СУБД были общие черты: они могли использовать специализированный API вместо SQL, предлагать гибкую модель данных, ограничивать транзакции рамками одного документа или ключа либо использовать более слабые модели согласованности. Но это были решения конкретных систем, а не единый набор обязательных признаков, определявший весь класс NoSQL.
Существенным сдвигом стало другое: распределение данных между узлами стало восприниматься не как специальная архитектура для отдельных крупных систем, а как нормальный режим работы базы данных. У этого была своя цена. Межпартиционные операции могли быть дорогими или вообще отсутствовать, часть ограничений целостности переносилась в приложение, а разработчику приходилось явно учитывать особенности распределения данных и модель согласованности конкретного продукта.
Для одних нагрузок такой обмен был вполне оправдан, для других — нет. Если приложению одновременно требовались богатый язык запросов, ограничения целостности и транзакционные изменения нескольких связанных сущностей, компромиссы конкретных NoSQL-систем могли перевешивать преимущества их модели масштабирования. В таких случаях зрелые реляционные СУБД оставались крайне привлекательным вариантом.
Параллельно продолжался поиск способов повысить производительность и масштабируемость транзакционных систем при условии сохранения привычных преимуществ реляционной модели и SQL. В начале 2010-х для довольно разнородных попыток решить эту задачу появилось новое название — NewSQL.
NewSQL: один термин для слишком разных архитектур
Термин NewSQL ввёл аналитик Matthew Aslett в 2011 году. Изначально так обозначали новое направление высокопроизводительных SQL-СУБД, причём горизонтальное масштабирование не было обязательным условием попадания в эту категорию. Наряду с распределёнными системами к NewSQL относили решения, которые пытались радикально повысить производительность OLTP за счёт новой программной или аппаратной архитектуры.
Позднее значение термина стало более узким. В ретроспективе Andy Pavlo и Matthew Aslett уже описывали NewSQL как современные реляционные СУБД для OLTP, пытающиеся дать масштабируемость, ассоциировавшуюся с NoSQL, сохраняя при этом ACID и SQL. Именно эта более узкая трактовка впоследствии во многом закрепилась за термином NewSQL.
Это изменение определения само по себе хорошо показывает проблему. Под одним названием могли оказаться системы с принципиально разной архитектурой. Одна делала ставку на новый движок исполнения, работу преимущественно в памяти и минимизацию накладных расходов традиционной СУБД. Другая распределяла данные между множеством узлов, реплицировала их и координировала транзакции по сети. Это принципиально разные инженерные задачи.
В первом случае основными вопросами становятся организация исполнения транзакций, contention, структура движка, работа с памятью и производительность отдельного узла или тесно связанного кластера. Во втором к ним добавляются распределённая координация, кворумы, сетевые задержки, репликация, локальность данных, восстановление после отказов и цена транзакции, затрагивающей несколько частей кластера.
Называть обе системы NewSQL можно. Но для понимания их архитектуры этого явно недостаточно.
Предположим, производитель базы данных сообщает нам три вещи:
система реляционная;
понимает SQL;
относится к NewSQL.
Что мы теперь знаем о её поведении? Почти ничего из того, что действительно потребуется при проектировании production-системы. Гораздо важнее другие вопросы:
Как выбирается ключ распределения данных, и кто управляет размещением и перебалансировкой: приложение, администратор или сама СУБД?
Можно ли добавлять и удалять узлы без ручного переноса данных и длительных операций обслуживания?
Репликация синхронная или асинхронная?
Может ли транзакция изменять данные в разных партициях?
Какой уровень изоляции она получит?
Что произойдёт при потере узла или зоны доступности?
Можно ли продолжить запись при сетевом разделении?
Сколько сетевых раундов потребуется для подтверждения COMMIT?
Именно поэтому NewSQL остаётся полезным историческим термином, но плохо работает как единственное описание архитектуры конкретной СУБД.
Если нам действительно нужно понять систему, гораздо полезнее перестать спрашивать «это NewSQL?» и перейти к устройству распределения, репликации и транзакций. Для разговора именно об архитектуре полезнее оказывается другой термин — Distributed SQL.
Distributed SQL: указание на архитектуру
Не следует воспринимать Distributed SQL как новую универсальную категорию, автоматически объясняющую устройство СУБД. Это было бы тем же упрощением, от которого мы только что отказались в случае NewSQL.
Distributed SQL также не является «следующей ступенью» после NewSQL. Само выражение distributed SQL использовалось уже в начале 2010-х и не возникло как поздняя замена NewSQL. Например, Google ещё в 2013 году описывал F1 в работе «F1: A Distributed SQL Database That Scales».
Если NewSQL исторически обозначал довольно широкий круг новых высокопроизводительных SQL-систем, то Distributed SQL в современном употреблении гораздо сильнее указывает именно на архитектуру: перед нами логически единая реляционная база данных, данные которой физически распределены между несколькими узлами. SQL-запрос при этом может обращаться к данным, находящимся в разных частях кластера, а сама СУБД берёт на себя значительную часть работы по их размещению, репликации и координации.
У типичной Distributed SQL-системы можно ожидать несколько свойств:
реляционную модель и SQL-интерфейс;
распределение данных между несколькими узлами;
репликацию партиций, диапазонов или других единиц размещения;
встроенные механизмы переживания отказов отдельных узлов;
поддержку ACID-транзакций, обычно включая транзакции, затрагивающие несколько партиций;
автоматическое или в значительной степени автоматизированное перераспределение данных при изменении топологии кластера.
При этом Distributed SQL не является формально стандартизованной категорией с единым обязательным набором свойств. Две СУБД, называющие себя Distributed SQL, могут иметь совершенно разные уровни SQL-совместимости, модели транзакций, способы размещения данных и свойства при отказах. Но термин хотя бы сразу указывает на круг архитектурных вопросов, которые придётся учитывать. Распределённость здесь не является внешним способом масштабирования поверх обычной реляционной СУБД – она заложена в саму архитектуру системы.
От смены приставок — к характеристикам систем
Сравнивать современные СУБД удобнее не по одному названию класса, а сразу по нескольким параметрам.
Характеристика | Что нужно спросить |
Модель данных | Реляционная, документная, key-value, графовая или другая? |
Интерфейс | Полноценный SQL, ограниченный SQL-диалект, API или собственный язык запросов? |
Распределение данных | Как данные распределяются между узлами: один узел, ручной шардинг, автоматическое размещение и ребалансировка? |
Транзакционные гарантии | Какие транзакции поддерживаются, какой уровень изоляции доступен, можно ли атомарно изменять несколько партиций? |
Репликация и согласованность | Как реплицируются данные, где принимается запись, какие кворумы используются и что происходит при отказе части кластера? |
Топология | Один дата-центр, несколько зон доступности или несколько регионов? |
Различия становятся особенно заметны, когда речь заходит о топологии. Одна СУБД может быть рассчитана прежде всего на масштабирование OLTP внутри одного региона, другая — на распределение данных между несколькими регионами или континентами. Во втором случае гораздо большее значение приобретают локальность данных и стоимость удалённой координации. Для архитектора эти различия существенно важнее названия категории.
Региональное и географическое распределение
Особенно хорошо разница между отказоустойчивостью внутри региона и географическим распределением видна на примере топологии кластера.
Представим кластер из трёх узлов, расположенных в трёх зонах доступности одного облачного региона. Данные реплицируются между зонами. Кластер способен пережить отказ отдельного узла, а при правильной конфигурации — и потерю целой зоны. Это распределённая и отказоустойчивая система. Но географически распределённой в обычном смысле её назвать сложно.
Задержки между зонами одного региона обычно сравнительно невелики, поэтому синхронная репликация и сильные гарантии согласованности здесь часто остаются практичными. Хотя бесплатными они не становятся. Чтобы считать запись подтверждённой в синхронно реплицируемой системе, требуется обмен сообщениями между репликами. Даже внутри одного региона это добавляет задержку по сравнению с локальной записью на один сервер.
Теперь разнесём те же данные между удалёнными регионами.
Скорость света внезапно становится параметром нашей СУБД.
Десятки или сотни миллисекунд времени кругового сетевого обмена уже нельзя спрятать оптимизацией движка выполнения запросов. Если для подтверждения записи требуется кворум, включающий удалённый регион, эта задержка становится частью пути COMMIT.
Сильные гарантии согласованности и распределённые транзакции по-прежнему возможны. Spanner продемонстрировал это ещё в начале 2010-х. Но физику сети они не отменяют.
Цена глобальной записи
В геораспределённой системе приходится явно решать, где должны находиться данные. Если пользователь в Стамбуле изменяет объект, основные реплики которого размещены в близлежащем европейском регионе, запись может быть сравнительно быстрой. Если та же транзакция должна синхронно координироваться с Северной Америкой, ситуация меняется. А если одна транзакция одновременно касается данных, «домашние» регионы которых находятся на разных континентах, путь COMMIT становится ещё дороже.
Отсюда возникает целый ряд архитектурных вопросов, которые приходится решать при проектировании системы:
хранить данные ближе к пользователям и сервисам, которые чаще всего с ними работают;
выбирать регион, отвечающий за запись конкретного набора данных;
избегать без необходимости транзакций, охватывающих удалённые регионы;
заранее определять, какие отказы система обязана переживать;
определять, какую цену мы готовы платить за способность пережить потерю целого региона — дополнительной задержкой, числом реплик и стоимостью инфраструктуры.
Это уже совсем другой уровень разговора, чем «поддерживает ли наша база горизонтальное масштабирование».
На примере CockroachDB
CockroachDB хорошо показывает, почему само слово «распределённая» мало что говорит о производительности системы.
Данные в CockroachDB делятся на диапазоны (ranges), каждый диапазон реплицируется, а его реплики образуют Raft-группу. По умолчанию транзакции выполняются на уровне изоляции SERIALIZABLE; система может работать как в пределах одного региона, так и в multi-region-топологии. Но из этого не следует, что транзакция имеет одинаковую стоимость при любом размещении данных.
Имеет значение, где находятся реплики конкретного диапазона, где расположен его leaseholder, какой кворум требуется собрать и какие диапазоны затрагивает транзакция. Транзакция, работающая с одним локальным диапазоном данных, и транзакция, затрагивающая несколько диапазонов в разных регионах, могут иметь одинаковую прикладную семантику, но совершенно разную стоимость выполнения.
При multi-region-развёртывании появляется ещё один выбор: какие именно отказы должна переживать система. Требование пережить отказ одного узла или зоны — одно, требование продолжить работу после потери целого региона — другое. Чтобы сохранить доступность после исчезновения целого региона, voting-реплики нужно разместить так, чтобы кворум сохранялся и без него. Это обычно добавляет межрегиональные обмены и увеличивает задержку записи.
CockroachDB показывает, что географическое распределение и способность пережить потерю региона — разные свойства. Само наличие узлов в нескольких регионах ещё не гарантирует region survivability: всё зависит от размещения реплик, структуры кворума и выбранной конфигурации отказоустойчивости.
Так что же произошло с NewSQL?
Ничего драматического. Термин не оказался «неправильным». В определённый момент он удачно обозначил довольно широкое направление развития SQL-СУБД. Со временем именно эта широта стала его слабостью: одно название объединяло системы с принципиально разной архитектурой и мало говорило о том, как конкретная СУБД распределяет данные, выполняет транзакции и переживает отказы.
С точки зрения истории отрасли такие системы можно объединять, с точки зрения архитектуры – уже не очень. Поэтому сегодня Distributed SQL часто оказывается полезнее не потому, что он «современнее» NewSQL, а потому, что направляет разговор к устройству самой системы.
Возможно, в этом и заключается главная проблема слова NewSQL. Оно хорошо отвечало на вопрос рынка: что это за новая волна SQL-систем? Но почти не отвечало на вопрос инженера: как именно устроена эта база данных?
А именно это в конечном счёте и важно: где лежат данные, кто подтверждает запись, какие гарантии получает транзакция и что произойдёт, когда часть инфраструктуры перестанет отвечать.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.