Workflow as a YAML: детерминированная песочница для агента поверх Pydantic AI
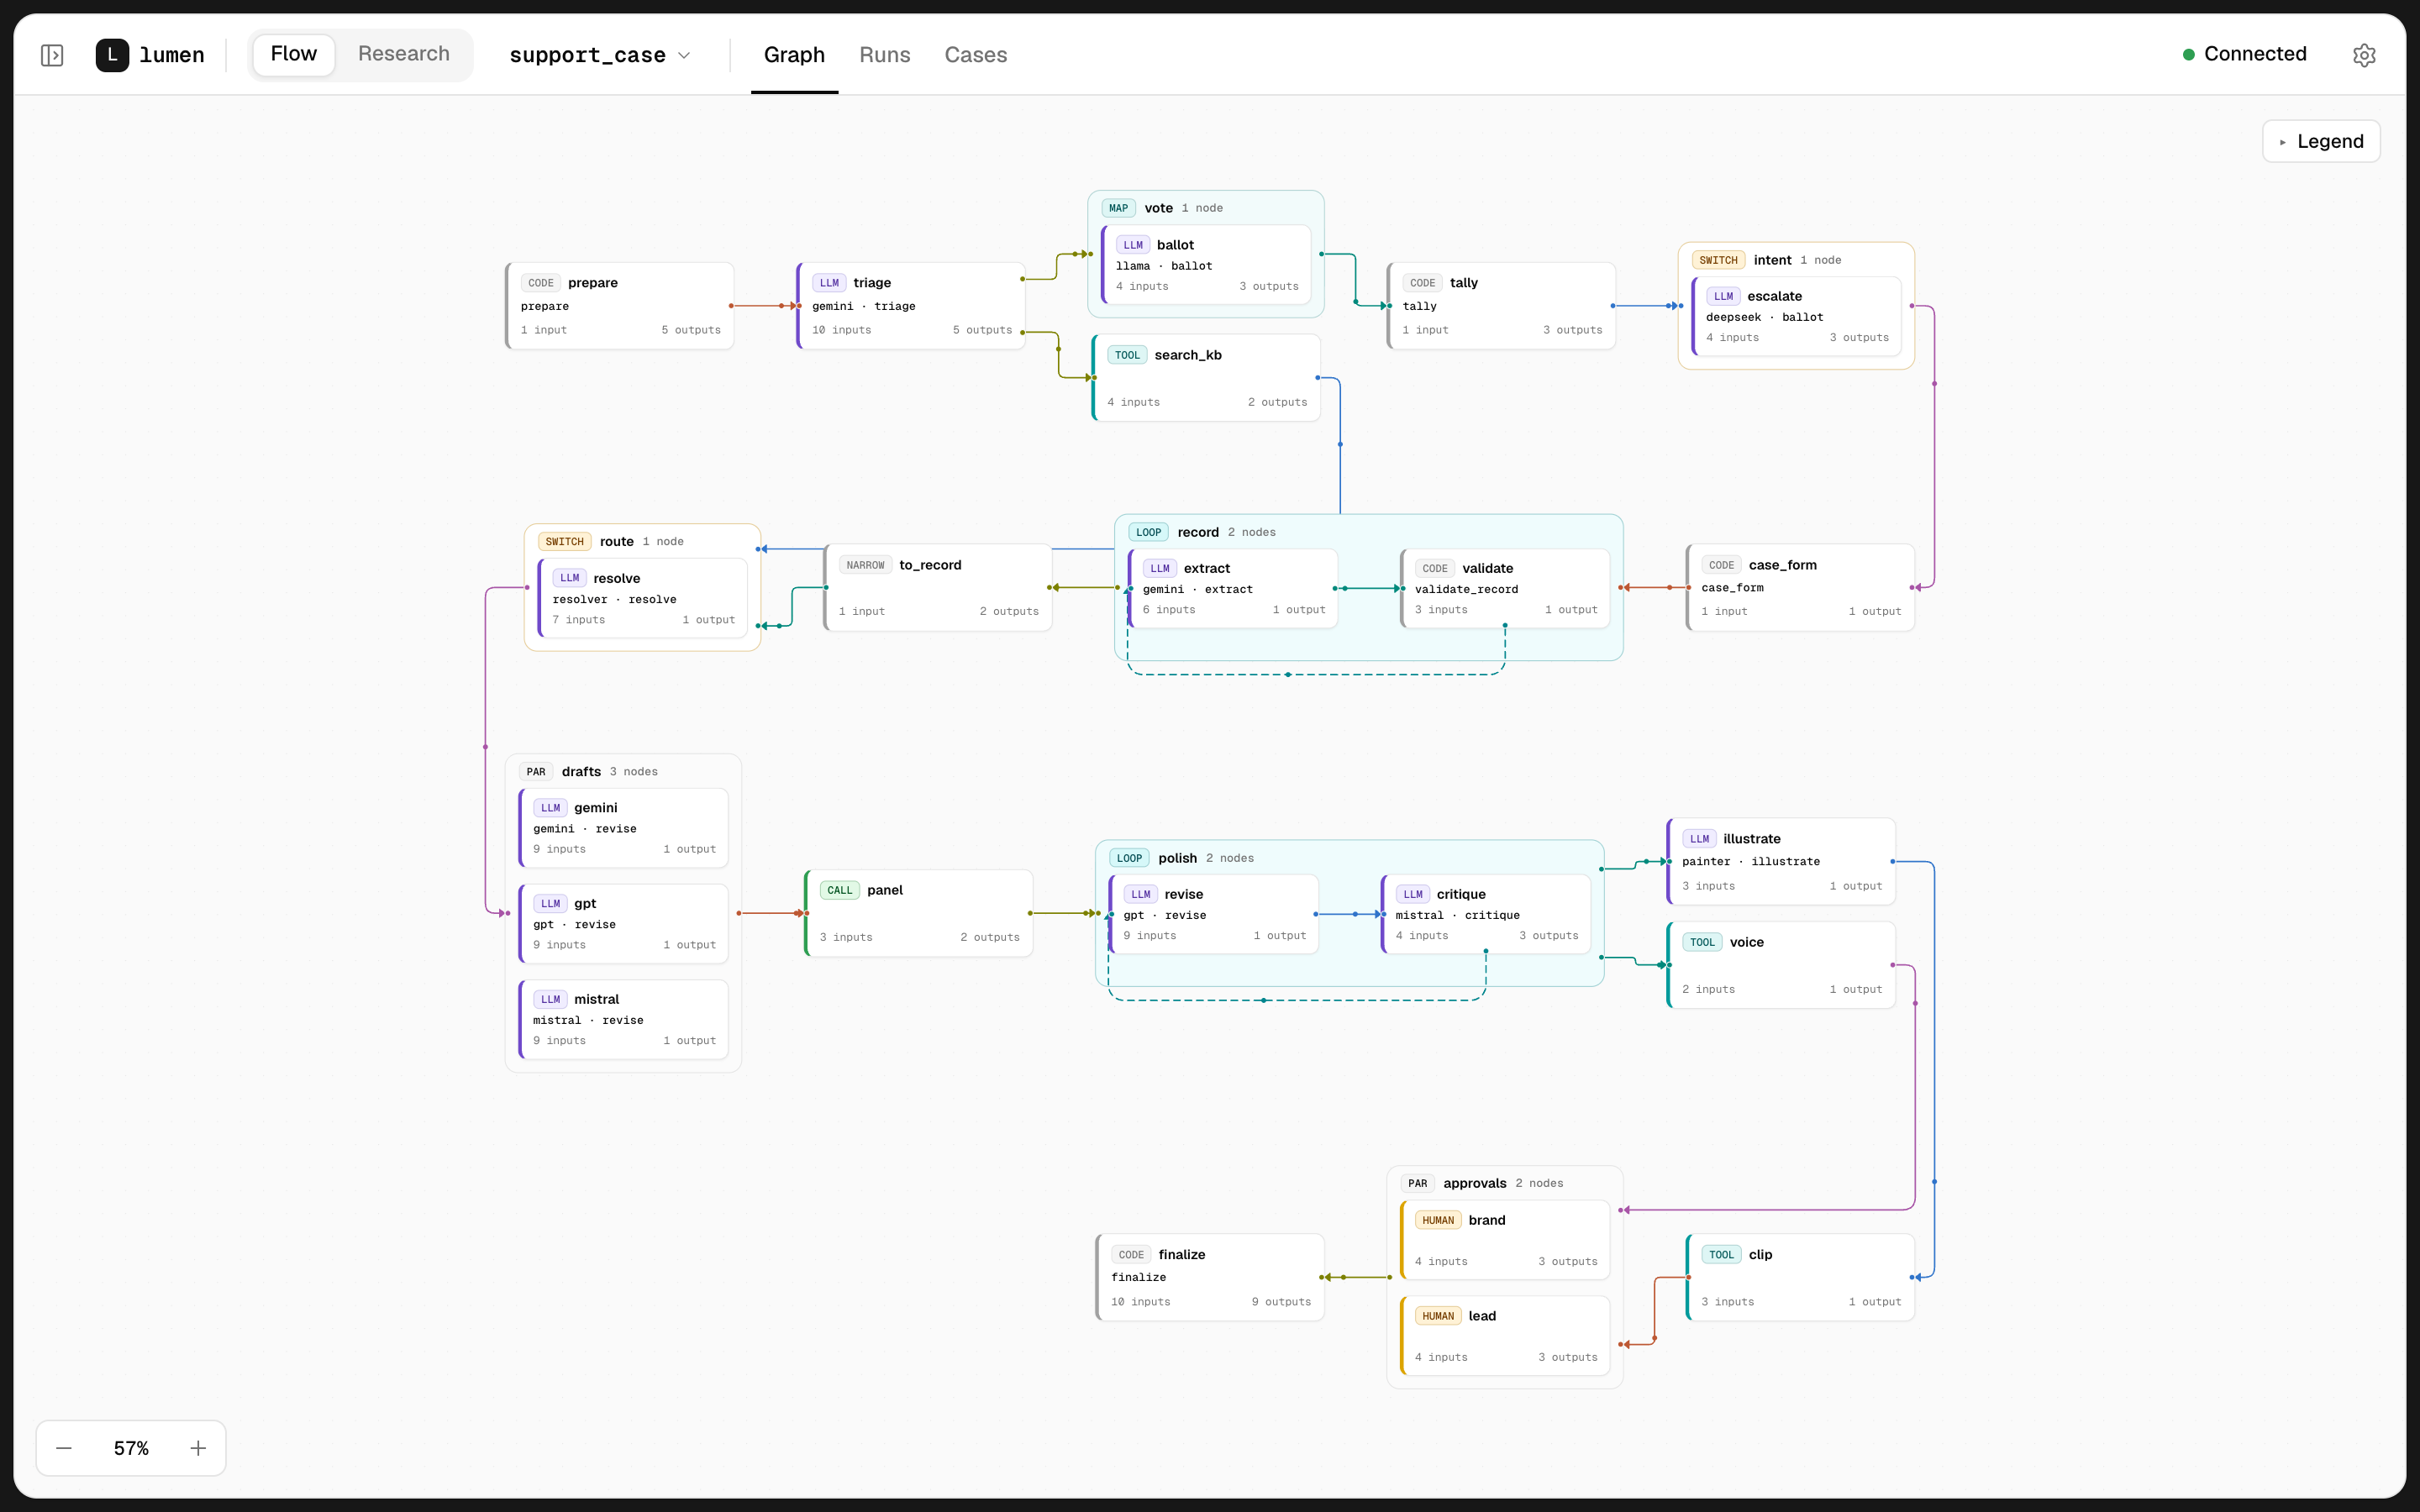
Агент уже пишет код за нас, но с автоматизацией для бизнеса всё иначе: он косячит на каждом шаге, в JSON-трейсе тысячи вызовов, а переписанный промпт вы даже не заметите. Я перестал перепроверять агента вручную — загнал его в жёсткие рамки: wrapper над Pydantic AI, MCP-инструменты, скиллы и Studio с отладчиком. Рассказываю, почему иначе нельзя, и показываю код.
Проблема
Код я всегда пишу вместе с кодинг-агентом — как и все остальные вещи. Но с написанием workflow и автоматизаций с AI при использовании агента проблемы были всегда. Инфраструктуры до сих пор нет: у LangGraph, Pydantic AI и других фреймворков есть какие-то механизмы, но они не решают production-проблемы c workflow и LLM моделями, с которыми сталкиваются люди — сталкивался и я. Как бы я ни пытался это исправить, агенты всё равно косячили. И косячили постоянно.
Причина
Если хотим, чтобы агент работал плюс-минус стабильно, его нужно заковать в жёсткие рамки. Ты не можешь доверять агенту: на десятый-пятнадцатый раз правок он зафакапит все — и ты об этом даже не узнаешь. Он перепишет промпт, и ты тоже об этом не узнаешь. Чтобы гарантировать, что агент пишет правильно и ничего не ломает, нужна правильная архитектура — абстракция — а также тесты, которые скажут агенту, что он сломал после правки.
Фреймворки есть, но это не решает проблему
Сейчас есть готовые фреймворки: VoltAgent, LangGraph, Pydantic AI, CrewAI, Mastra. Они поддерживают стримы, workflow, параллельность, structured JSON output, схемы для Input; observability и инструменты для промптов заявлены у всех. Но заставить кодинг-агента сделать сложный workflow — и протестировать его с помощью VoltAgent, AI-observability и trace-инструментов (Langfuse, LangSmith, Arize Phoenix, Braintrust) было очень тяжело.
Во-первых, даже трейс надо настраивать, пройдёт время. Во-вторых, в трейсе всё хранится в JSON, а сложный workflow собирается из паттернов: map-reduce, llm-as-a-judge, repair, divergent-convergent и другие. Каждый паттерн умножает число вызовов — и вот в трейсе их уже тысячи, а с мультимодальными моделями у вызовов ещё и разные входы и типы данных. Дебажить это невозможно: не понять, что реально было на входе модели, что реально на выходе, какие промпты — особенно если промпты генеративные и собираются из кучи контекста. А сверху — агент, который всё это уже 10 раз переписал. Фреймворк даёт трейс, но не даёт человеку способ его прочитать.
Что я сделал
Подумал и сделал такую историю, как AQVEN. Это wrapper над Pydantic AI, отладка с UI и сама Studio. Три слоя решают три части проблемы.
Слой 1. Фреймворк: Pydantic AI, YAML, Детерминизм
Фреймворк нужен ровно за этим: базовые потребности, которые есть с LLM-моделями и workflow, закрыты внутри, а не «пробуй сам и продумывай архитектуру сам».
Workflow — это просто Markdown и YAML-файлы, где нужен код — подключается код. Подход детерминированный: где ошибка, видно ещё на этапе сборки проекта — как статический типизатор.
Вот как это выглядит в проекте. Flow — декларация графа:
apiVersion: "aqven/v1"
kind: "Flow"
description: "A Lumen customer case: attachment parsing, intent by ballot
  with a cascade, a form with repair, the decision, a knowledge-base reply
  with a judge panel and polishing, reply media and human approvals"
input: "CaseRequest"
output: "CaseOutcome"
context:
- "date"
- "tenant_id"
order:
- "prepare"
- "triage"
- "vote"
- "tally"
- "intent"
# …ещё 12 узлов: case_form, record, search_kb, route, drafts,
# panel, polish, illustrate, voice, clip, approvals, finalize
Узел — отдельная папка из трёх файлов: .node.yaml (связи), .inference.yaml (контракт входа/выхода), *.prompt.md (промпт как шаблон):
apiVersion: "aqven/v1"
kind: "Node"
node: "llm"
description: "Parses the case text and every attachment: summary, category,
  observations, safety risk, marketplace fields"
agent: "gemini"
in:
- name: "message"
  from: "$prepare.out.message"
- name: "photo"
  from: "$input.photo"
- name: "voice_note"
  from: "$input.voice_note"
# …
Контракт шага декларирует типы — их и валидирует «типизатор»:
apiVersion: "aqven/v1"
kind: "Inference"
in:
- name: "message"
  type: "Text"
  description: "Customer case text after whitespace normalization"
  maxLength: 4000
- name: "signals"
  type: "SignalDef[]"
  description: "Category signals the observations are allowed to mark"
  maxItems: 20
- name: "photo"
  type: "Image?"
Промпт — Markdown-шаблон с ветвлениями и переиспользуемыми фрагментами, а не строка в коде:
{% message system cache %}
You are a first-line support specialist for a smart lighting brand. Parse the
customer case together with its attachments…
An observation records what the customer described or what the attachments
show; assumptions are not observations.
{% include "fragments/safety_escalation" %}
{% include "fragments/untrusted_input" %}
{% endmessage %}
{% message user %}
{% case channel %}
{% when "storefront" %}The case came from the online store…{% endcase %}
{{ customer.locale }}
{% endmessage %}
Проверка всего этого не требует ни ключей, ни сети — aqven check валидирует каждый файл и симулирует прогон каждого flow с заглушками вместо вызовов модели:
cd my_project
uv run aqven check my_project
errors: 0, warnings: 0Слой 2. Harness для агента
API был сделан как раз-таки для того, чтобы обернуть агента в harness: окружение, в котором он живёт, из которого не может выходить и в котором 90% времени делает то, что надо.
Harness делают архитектура и фреймворк, которые агент использует, MCP-сервер с 18 инструментами и 12 скиллов — вместе это и есть жёсткое окружение агента. Каждое изменение проходит через проверки: правку в flow агент вносит через отдельный инструмент, а не правкой файлов, и хуки автоматически запускают статический анализ, типы и тесты. Тестовые примеры, по которым оценивается итог, агенту не выдаются — подогнать правку под тесты нельзя.
Проект создаётся сразу подготовленным для агента — aqven new кладёт в него AGENTS.md, CLAUDE.md, .mcp.json с регистрацией MCP-сервера и хуки Claude Code, которые запускают aqven check после каждой правки:
uv tool install aqven
aqven new my_project --template minimal --provider openrouter
cd my_project
claude   # одобрить aqven MCP-сервер
Из MCP-инструментов агенту доступны, в частности: flow_patch (правка графа с CAS — устаревшая версия не применяется), aqven_check, pyright_check, pytest_run, prompt_preview (точный собранный промпт узла), run_* (запуск/события/резюм/форк прогона) и series_* (серии прогонов; held-out строки агенту не возвращаются).
Слой 3. Studio: UI, потому что это невозможно ревьюить
Studio — потому что агент меняет тысячу строк кода за раз. И это невозможно ни рефакторить, ни ревьюить. Соответственно, для этого есть UI.
И второй момент, который закрывает UI: трейс в JSON — это не то, что человек может валидировать. Поэтому отладчик прогона — не дерево спанов, а разбор по структуре flow: у каждого узла вид, статус, цена и время, вложенные ветки раскрываются как матрицы вызовов. Каждая ячейка — вызов: модель, вход, промпт, выход, проверка.
С этого же экрана можно запустить не весь flow, а диапазон узлов, в том числе с середины — на выходах прошлых прогонов. Способ проверить один шаг, не прогоняя весь конвейер.
Есть панели для запуска экспериментов, чтобы понимать, что в workflow работает, что не работает, где какие минусы и плюсы, чтобы компоновать различные решения, проверить, какие модели лучше работают, какие дешевле, какие дороже, в каких ситуациях.
Потому что мультимодальные модели, когда мы работаем с разными типами данных, ведут себя иначе; там бывают баги; нужны различные LLM-as-a-judge и repair-алгоритмы в зависимости от интенции и контекста. И это всё очень сложно.
И когда ты делаешь это в production, действительно приходится проводить разные эксперименты и смотреть, как на реальных данных это реально работает, где какие проблемы и как мы их можем решить.
AQVEN
Wrapper над Pydantic AI, harness для кодинг-агента и локальная Studio.
GitHub: https://github.com/lastonoga/AQVEN
Сайт: https://aqvenstudio.com/
Вопрос: а с какими проблемами сталкиваетесь вы, когда работаете с агентами и LLM и внедряете их в свой бизнес или продукт? Расскажите в комментариях — что ломалось, что не могли проверить, что пришлось перестроить.
P.S. Я автор AQVEN — open-source… (source-available) инструмента, о котором идёт речь. Статья про инженерный опыт: проблему, решение и код.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.