TokenRouter: непрерывная маршрутизация LLM по токенам
Привет, Хабр! Сегодня расскажу, как можно эффективно использовать в своей системе сразу несколько LLM.
ИИ решает самые разные задачи: анализирует тексты, готовит контент, обрабатывает изображения, генерирует видео. Но одна LLM все запросы не тянет. Точнее, тянет, только результат получается хуже, чем мог бы. Технические запросы, такие как расчет гармоник, разбор спецификаций, интерпретацию стандартов — лучше поручать специализированной модели, которая уверенно работает с формулами и таблицами. А общие — универсальной.
Для эффективного направления запросов используется маршрутизация LLM, и здесь речь идет не о сетевом трафике. Запросы перераспределяются между разными моделями, сдвигая границу Парето «стоимость–качество» обслуживания. В результате можно выбрать, какую именно модель нам будет выгоднее использовать в каждом конкретном случае.
В продакшне давно используют маршрутизацию на уровне сессии или запроса. Но многие исследователи утверждают, что заметный выигрыш и по эффективности, и по качеству даст именно маршрутизация на уровне токенов.
Однако эффективное обслуживание токен-уровневого маршрутизированного инференса создает значительные трудности для существующих систем. Текущие системы страдают от серьезной десинхронизации шагов и частых задержек допуска в батч при использовании маршрутизации на уровне токенов, да и реализовать это трудно.
В этом материале рассмотрим работу TokenRouter: Efficient Serving System for Token-Level LLM Routing. В ней описывается система обслуживания LLM, в основе которой заложен принцип «программирование с точки зрения запроса, исполнения с точки зрения модели».
Как работает TokenRouter
Разработчик описывает логику маршрутизации для одного запроса, а рантайм запускает отдельный субсервер для каждой LLM и асинхронно распределяет запросы между ними.
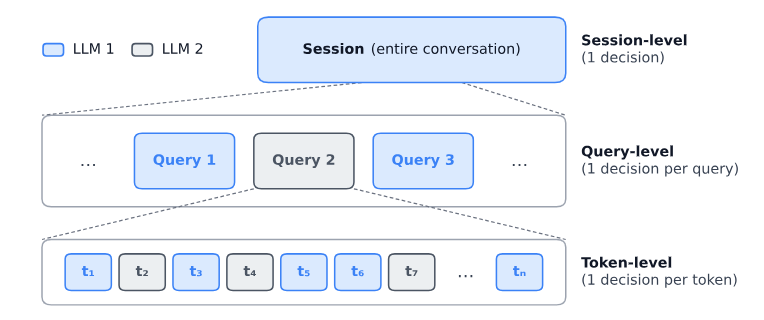
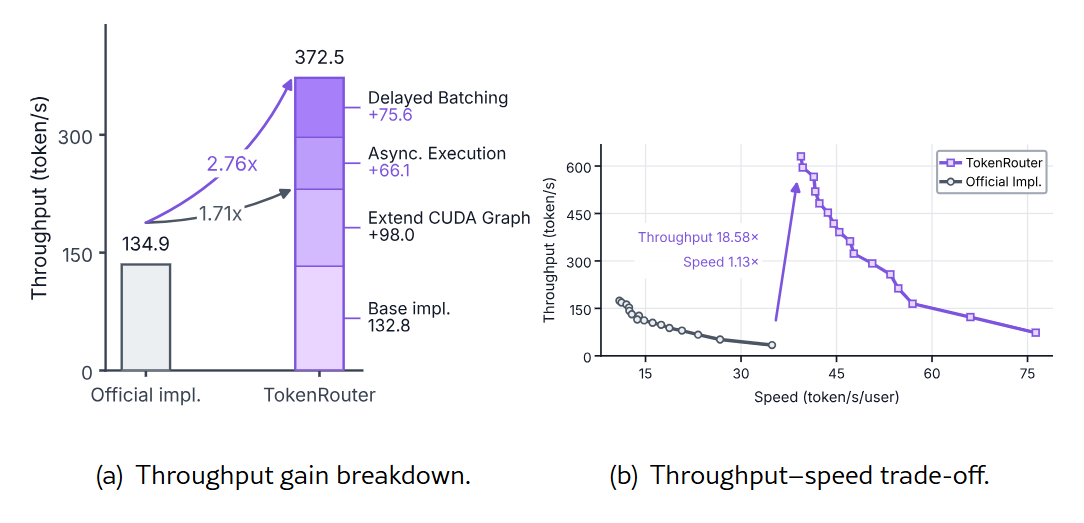
В экспериментах на разных алгоритмах маршрутизации, нагрузках и парах моделей TokenRouter обгоняет существующие системы по пропускной способности декодирования во много раз.
Однако маршрутизация на уровне токенов приносит и ряд проблем:
Десинхронизация шагов. Разные LLM сильно различаются по времени, которое тратят на один шаг декодирования. В синхронном батче каждый шаг ждет самую медленную модель, а быстрые простаивают.
Задержка допуска в батч. Из-за частых переключений моделей запрос попадает к целевой модели, когда та еще обрабатывает предыдущий батч. Приходится ждать следующего — в расписании появляются простои, а батчи дробятся на мелкие.
Сложность реализации. Текущие системы обслуживания не дают интерфейса для решений о маршрутизации на каждом шаге. Встроить ее на уровне токенов непросто — придется переписать большую часть кода. А логику маршрутов еще нужно согласовать с непрерывным батчингом и кэшированием префиксов.
Давайте посмотрим, как TokenRouter справляется со всем этим.
Реализация
Разработчики описывают алгоритм маршрутизации, прослеживая, как один запрос проходит через взаимодействующие LLM, а TokenRouter обеспечивает эффективное обслуживание через асинхронные моделецентричные субсерверы. Всю сложность обслуживания маршрутизации разработчик не видит. Она остается на рантайме, который сам оптимизирует исполнение между моделями и планирует батчи. Для клиента TokenRouter выглядит как обычный сервер с одной LLM.
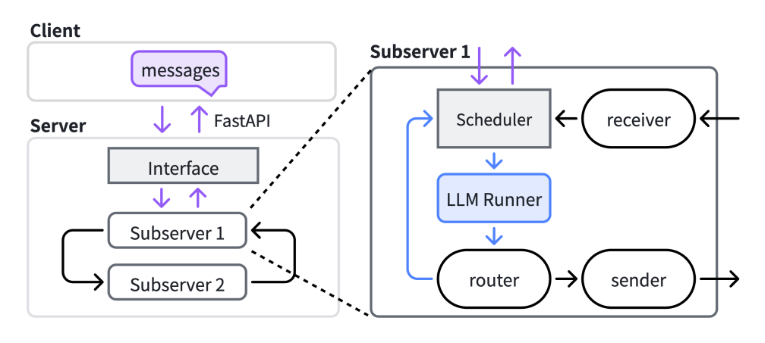
Алгоритмы маршрутизации на уровне токенов реализуются через интерфейс route-send-receive. Он строится вокруг одного запроса, поэтому реализации получаются короткими и понятными. Исполнение при этом устроено вокруг моделей: рантайм смотрит на систему со стороны модели и обрабатывает запросы асинхронно.
Разные LLM работают с разной скоростью. Если их шаги синхронизировать, все ждут самую медленную. Авторы предлагают два решения. Первое — асинхронное исполнение. Второе — планировщик с отложенным батчингом, который копит запросы и запускает их вместе, чтобы снизить среднюю задержку.
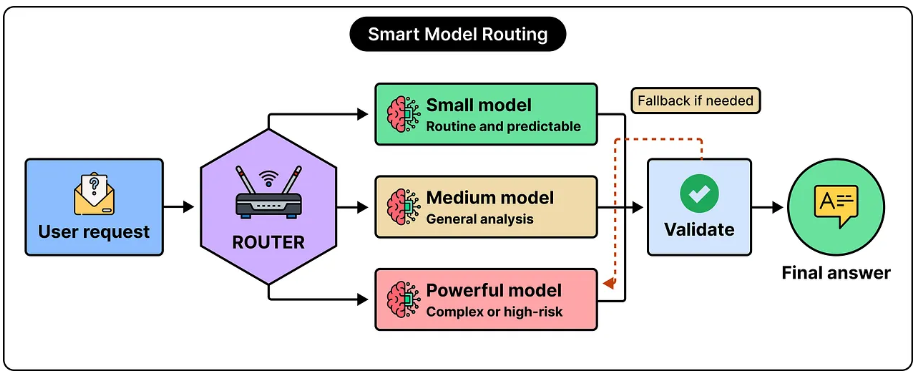
Чтобы это заработало, разработчики пересмотрели весь путь запроса в алгоритмах маршрутизации на уровне токенов. Теперь запрос сначала приходит на входную модель, где выполняется декодирование. После прямого прохода специфичный для данного алгоритма роутер решает, должен ли запрос продолжиться локально или быть передан другой модели. Если запрос делегирован, текущая модель собирает необходимый контекст, такой как последние сгенерированные токены, и отправляет его целевой модели. Та в свою очередь получает запрос, продолжает декодирование и повторяет тот же процесс route-send-receive.
В интерфейсе три основных элемента
Прежде всего это route(result), который вызывается после каждого шага декодирования LLM. Он смотрит на результат прямого прохода: скрытые состояния, логиты следующего токена и уже сэмплированные токены. И по ним выбирает, куда направить каждый запрос из батча. Установка 0 означает, что запрос продолжает декодирование локально, а ненулевое назначение указывает на соответствующую peer-модель.
Элемент send(req) вызывается, когда route передает запрос. Он возвращает настроенное сообщение PeerReq, которое несет ID запроса, суффикс токенов, которые peer-модель еще не видела, поле статуса, указывающее, активен ли запрос или завершен, и любые специфичные для алгоритма поля, необходимые получателю. Позиционный якорь req.loc также прикрепляется, чтобы указать позицию декодирования перед отправкой PeerReq. Получатель может использовать его для определения минимального суффикса, который следует отправить обратно. Точный суффикс зависит от алгоритма. Например, планировщик включает только что сэмплированный токен лишь тогда, когда peer-модель должна его перегенерировать.
Ну а receive(peer_req) вызывается, когда PeerReq прибывает от peer-модели. Он преобразует PeerReq в локальный формат запроса, чтобы модель-получатель могла продолжить декодирование. По умолчанию receive фиксирует все переданные токены из PeerReq, что достаточно для большинства алгоритмов токен-уровневой маршрутизации. Разработчикам нужно переопределять receive только тогда, когда семантика передачи специфична для алгоритма. Например, алгоритм может положить в запрос дополнительное состояние и потом продолжить декодирование.
Давайте посмотрим пример кода, выполняющего маршрутизацию в зависимости от переданного на вход токена.
class RStitchSLM(BaseRouter):

    # self.tau (порог) и self.peer_idx (индекс субсервера LLM) берутся из конфигурации.

    def route(self, result):

        # Делегировать высокоэнтропийные токены peer-LLM; остальные оставить локально.

        probs = result.logits_output.next_token_logits.softmax(dim=-1)

        entropy = -(probs * probs.log()).sum(-1) / math.log(probs.shape[-1])

        destination = torch.zeros_like(entropy, dtype=torch.long)

        destination[entropy > self.tau] = self.peer_idx

        return destination.cpu()

    def send(self, req) -> PeerReq:

        # Отбросить только что декодированный неуверенный токен; попросить LLM перегенерировать.

        token_ids = req.origin_input_ids + req.output_ids[:-1]

        peer_anchor = req.peer_locs[self.peer_idx] or 0

        return PeerReq(rid=req.rid, token_ids=token_ids[peer_anchor:],

                       loc=len(token_ids), finished=req.finished(),...)

    # receive использует поведение по умолчанию и принимает все возвращенные токены.
Архитектура системы
Рантайм TokenRouter устроен так: снаружи один общий интерфейс, а за ним — множество субсерверов. На каждом работает одна модель-кандидат. У субсервера есть планировщик, модуль запуска LLM с приватным пулом KV-кэша и три пользовательские функции — для роутера, отправителя и получателя. Субсерверы работают независимо и общаются через peer-запросы. Внутри они устроены одинаково, поэтому масштабирование сводится к запуску новых субсерверов.
Асинхронное обслуживание
Когда запросы на шаге декодирования синхронизированы, весь батч ждет самую медленную модель.
На рисунке ниже представлены различные варианты возникновения десинхронизации (a,b) и предлагаемый разработчиками TokenRouter вариант (c, d).
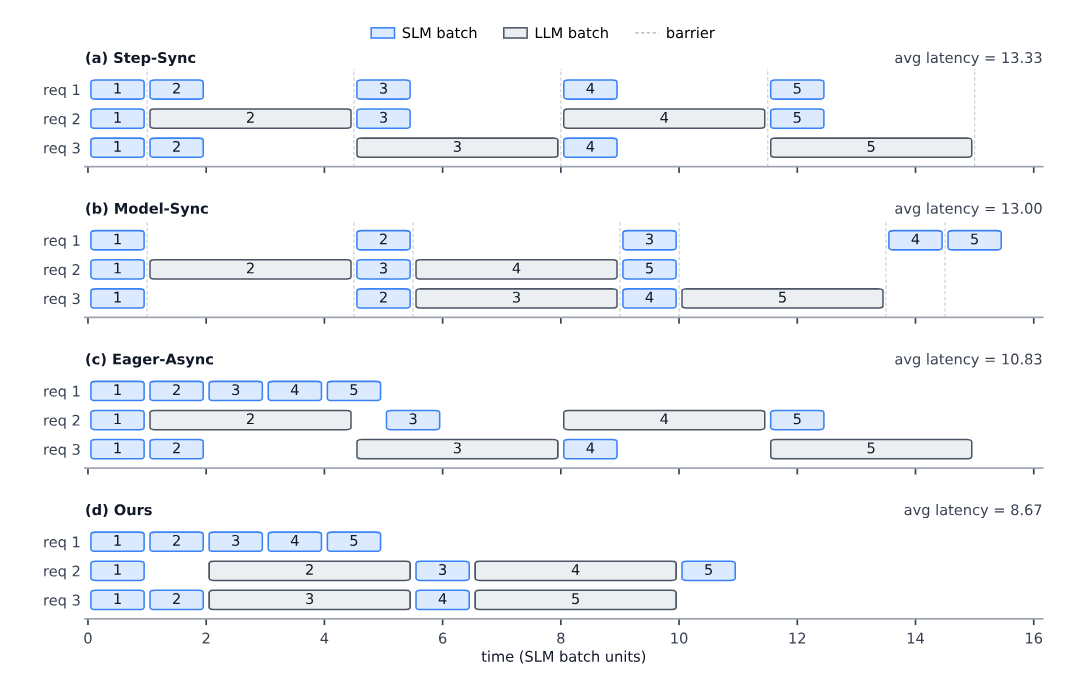
При асинхронности планирование все равно остается. Поскольку маршрутизированные токены приходят редко и нерегулярно, каждому субсерверу нужна своя политика. Задержка допуска — это время от прихода запроса в субсервер до начала его исполнения. На рисунке шаг (c) иллюстрирует проблему при еager-асинхронном планировании. Субсервер запускает шаг, как только приходит любой peer-запрос. Запросы, пришедшие следом, ждут, пока шаг не закончится. Например, токен 3 запроса 3 не может начаться, пока LLM не закончит декодировать токен 2 запроса 2, неся задержку допуска от времени 2 до времени 4,5. Маршрутизация на уровне токенов часто переключает модели, а задержка на шаг сильно скачет. Поэтому такие остановки повторяются, и батч дробится на мелкие куски.
Чтобы снизить задержки допуска, можно использовать планировщик с отложенным батчингом, чтобы больше запросов, нацеленных на одну модель, могли быть исполнены вместе. Планировщик ждет, пока в буфере наберется B запросов, и только тогда запускает батч. На шаге (d) рисунка — пример: у LLM-субсервера B = 2, у SLM-субсервера B = 1. Первый запрос ждет дольше, чем при eager-async на шаге (c). Зато следующие ждут гораздо меньше, и в среднем задержка допуска по нагрузке падает.
TokenRouter также аналитически определяет порог отложенного батчинга B, оптимальный по пропускной способности. Здесь нужно найти компромисс: слишком малый B дает большую задержку допуска в батч, а слишком большой запирает запросы в очереди и лишает малую модель активной работы. Для этого TokenRouter моделирует процесс маршрутизации как цепь Маркова (DTMC).
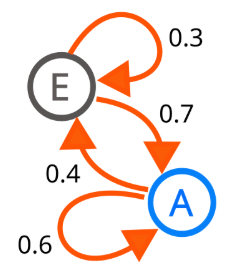
На вход модели подают алгоритм маршрутизации на уровне токенов, конкурентность N, вероятность маршрутизации P и задержку декодирования на шаг L_i для каждой LLM. Дальше модель считает пропускную способность в зависимости от B и подбирает B, дающее наибольшую пропускную способность.
Эксперименты
На практике разработчики оценивали пять алгоритмов маршрутизации в TokenRouter: CITER, R2R, R-Stitch, Co-LLM и ME.
Первые четыре алгоритма выбирают между Qwen3-0.6B и Qwen3-32B. ME работает с тремя моделями: Qwen3-0.6B, Qwen3-8B и Qwen3-32B.
Настройки:
CITER — обученный роутер, τ = 0.98;
R2R — официальный роутер и порог;
R-Stitch — τ = 0.03;
Co-LLM — дообученный Qwen3-0.6B, η = 0.15;
ME — веса ансамбля 0.5, 0.3 и 0.2.
В качестве аппаратной платформы использовался сервер с 8×A100-80G GPU. Малой модели в двумодельных алгоритмах отдавали один GPU, большой — два с тензорным параллелизмом. Еще два GPU отдавали моделям в общее пользование через CUDA MPS. Для ME каждая модель развернута на одном GPU.
Оценивали на трех нагрузках с разной длиной входа и выхода:
low-effort reasoning — короткий вход, короткий выход. Брали AIME2024: около 100 токенов на вход, до 2048 на выход;
high-effort reasoning — короткий вход, длинный выход. Тоже AIME2024, но с лимитом выхода 8192, и в выборку попадали только задачи, где решение Qwen3-32B выходит за 8192 токена;
agentic tasks — многошаговые. Использовали траектории SWE-Smith объемом около 8192 входных токенов с максимальной длиной выхода 1024.
Также собирается статистика по пропускной способности и end-to-end задержке завершения запроса. Для inference-движков формируется батч из N запросов с последующей обработкой, на N воркерах запускают сервинг-системы. Завершив запрос, каждый из них сразу отправляет новый. Для вычисления пропускной способности общее число выходных токенов делят на время работы.
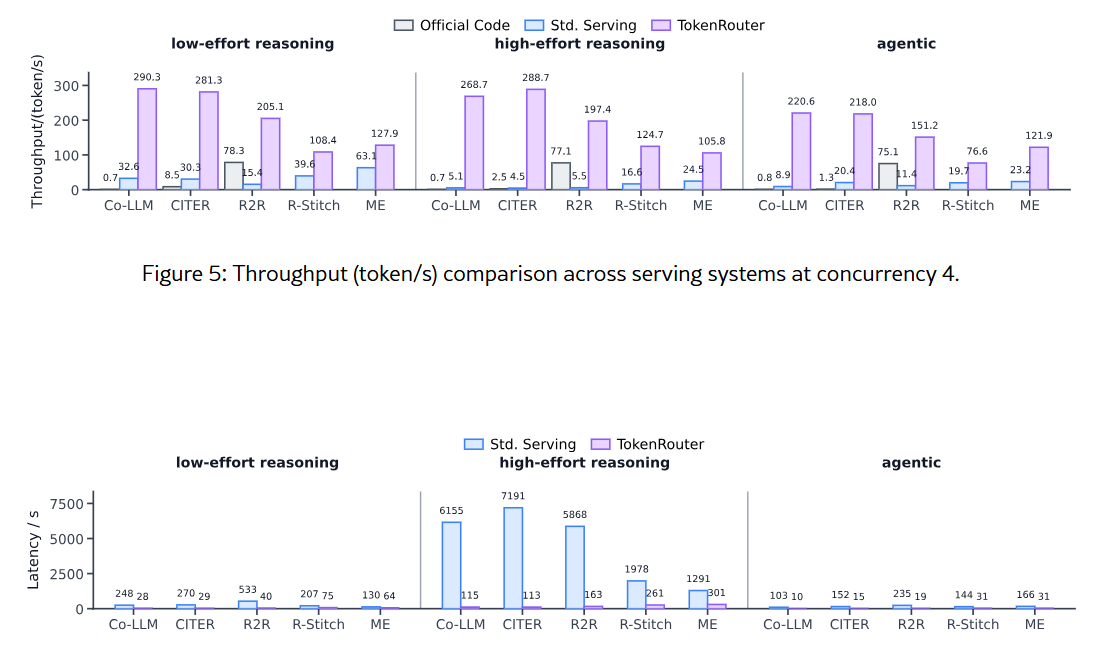
На рисунке видно: в большинстве сочетаний алгоритма и нагрузки TokenRouter стабильно обгоняет официальные реализации и стандартный сервер. Пропускная способность выше в 2,01–64,15 раза. TokenRouter также снижает end-to-end задержку Std. Serving в 2,03–63,64 раза, и хотя Std. Serving существенно улучшает официальные реализации Co-LLM и CITER через асинхронное исполнение, ему не хватает механизма handoff-and-resume TokenRouter. Следовательно, состояние обслуживания маршрутизированного запроса не может быть сохранено через переключение моделей, и каждый возвращающийся токен должен трактоваться как новый запрос. Эта проблема несет существенные накладные расходы для таких операций, как сопоставление префиксов и обновления KV-кэша.
TokenRouter также изящно масштабируется с длиной выхода. Когда выход вырос с 2048 до 8192 токенов, TokenRouter не просел. Std. Serving потерял 58,1–85,2% пропускной способности.
Эти результаты показывают, что TokenRouter эффективно поддерживает разнообразные алгоритмы токен-уровневой маршрутизации в их оригинальных алгоритмических настройках.
Что в итоге?
TokenRouter — эффективная система обслуживания для токен-уровневой маршрутизации LLM, которая разделяет алгоритмы маршрутизации и оптимизацию системы обслуживания.
Архитектура TokenRouter избавляет от главных проблем маршрутизации на уровне токенов: шаги больше не рассинхронизируются, а запросы не ждут допуска в батч.
Проверки, проведенные на разнообразных алгоритмах, рабочих нагрузках и парах моделей, стабильно обеспечивали более высокую пропускную способность декодирования по сравнению с существующими реализациями, создавая прочную основу для будущих исследований в области токен-маршрутизации.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.