超低コストで効率的な学習に成功した画像生成AIモデル「P-JiT」、オープンウェイトで公開中
2名の研究者によるAI研究組織「Linum」が画像生成モデル「Pyramid-JiT(P-JiT)」を公開しました。P-JiTは画像生成AIが抱える「生成に時間とコストがかかる」「制御が難しい」という二つの主要な課題の克服を目指しており、開発コストを2万1千ドル(約331万5千円)に抑えられたことがアピールされています。
Training a Text-to-Image Model for $21K | Field Notes by Linum
https://www.linum.ai/field-notes/pjit-21k
Linum-AI/pjit-21k: 2B-parameter pixel-space text-to-image model (Pyramid-JiT) trained for $21K
https://github.com/Linum-AI/pjit-21k
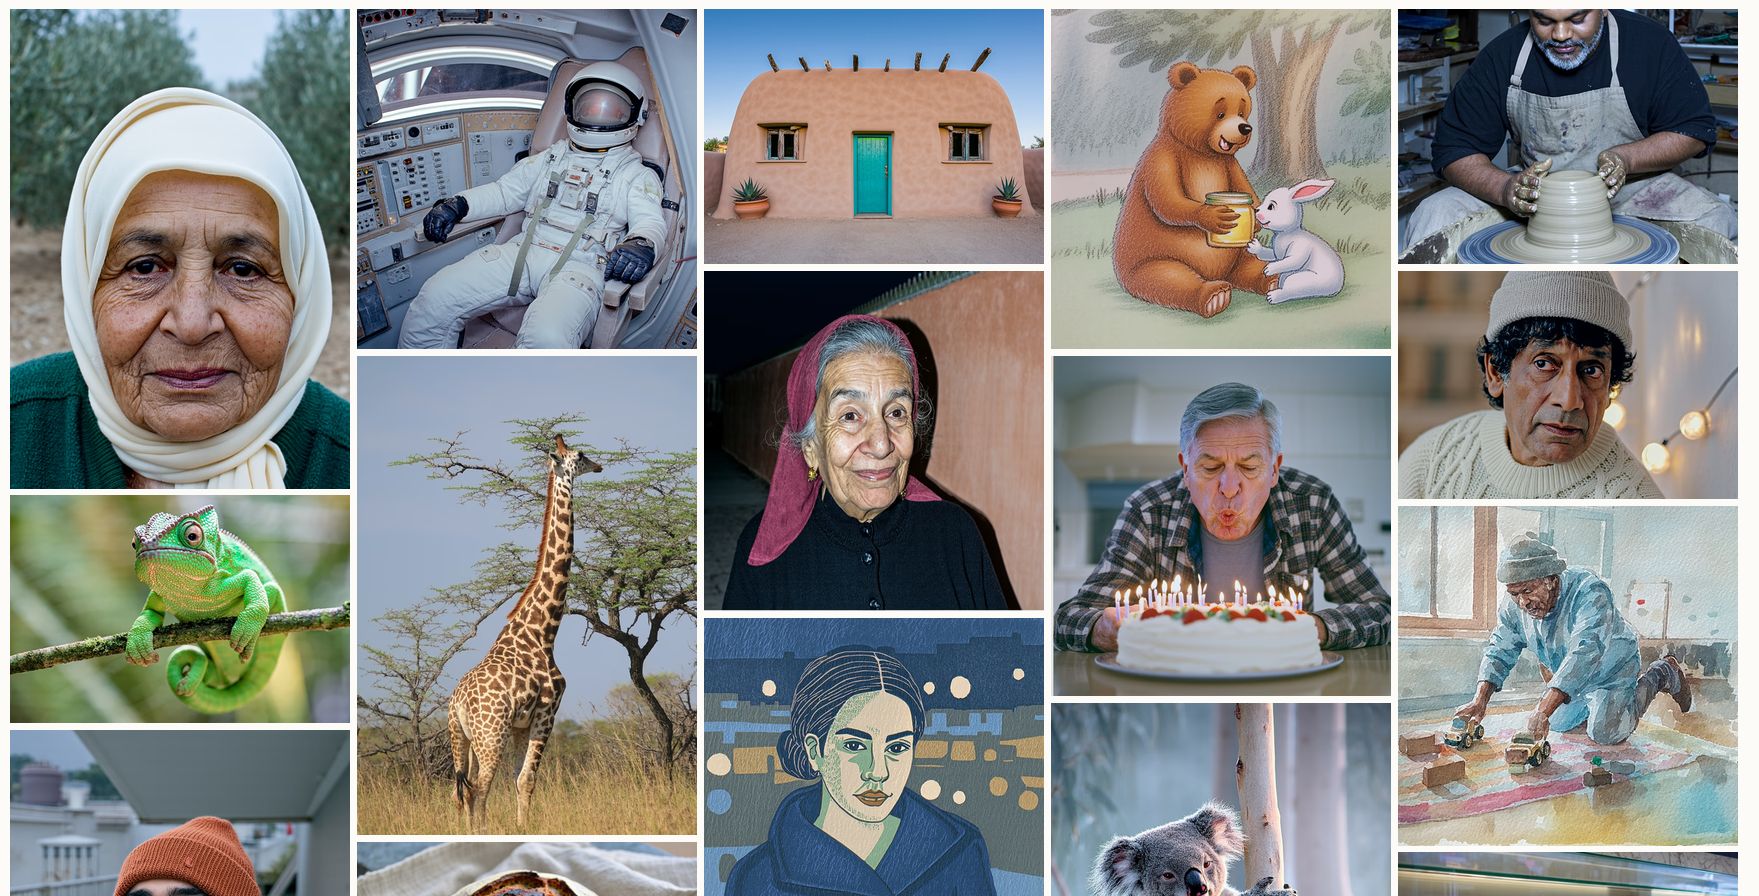
P-JiTの作例が以下。従来の画像生成AIは「画像をVAEで潜在表現に変換する」「潜在表現から画像にデコードする」という処理が必要ですが、P-JiTは潜在表現への変換を行わずに画像をピクセルデータとして直接処理するのが特徴です。
従来の生成モデル、特に動画生成モデルではアテンション機構の計算量がO(n²)、つまり入力シーケンス長の2乗に比例するため、トレーニングと推論に膨大な時間とコストがかかることが大きなボトルネックとなっていました。P-JiTは積極的にトークンを圧縮することでアテンションのコンテキストウィンドウを縮小し、計算コストを大幅に削減することに成功しました。
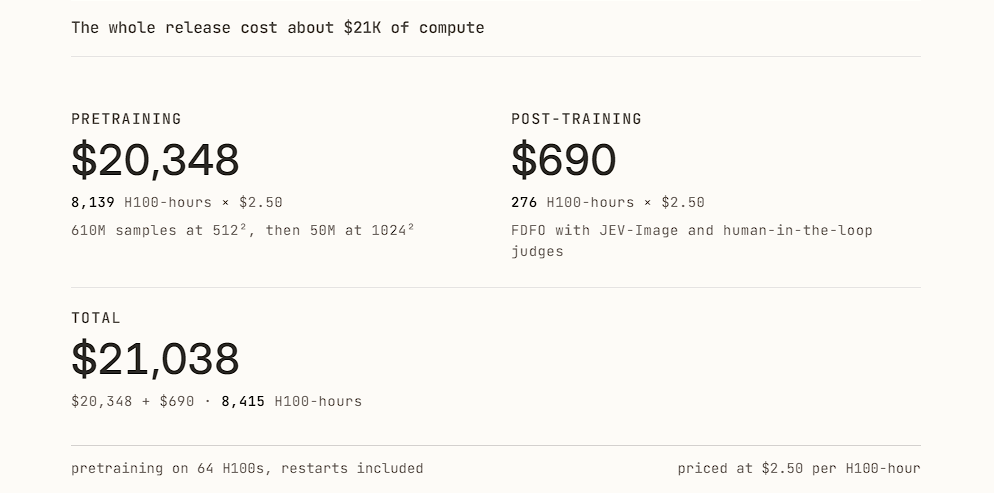
具体的には、従来モデル「Linum v2」が512²の画像を16×16のトークン削減で表現していたのに対し、P-JiTは32×32のトークン削減を可能にしました。このトークン削減による効果はアテンションコンテキストウィンドウを4倍削減することに相当し、結果としてLinum v2と比較して11分の1程度のサンプル数で学習が収束しました。なお学習プロセスで費やしたコストは約2万1千ドルでした。
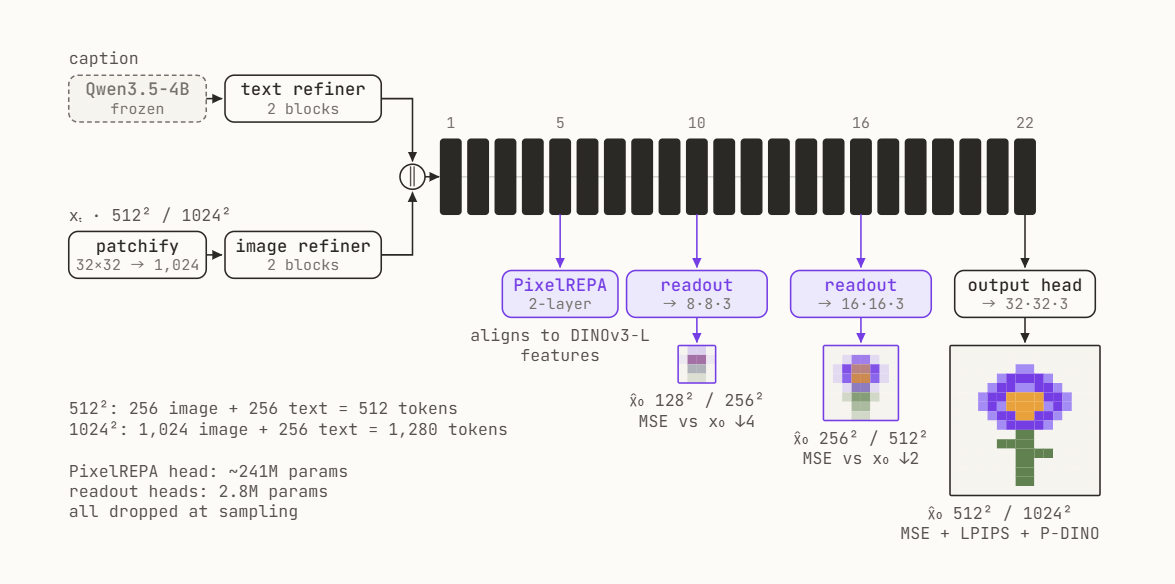
ピクセル空間モデルとして設計されてされたP-JiTはモデルアーキテクチャとしてピクセル空間モデルに適した「ノイズスケジュール」とDiffusion Transformer(DiT)の早期ブロックにおける勾配信号を強化する「リードアウト機構」が導入されています。リードアウト機構はネットワークの早い段階で低解像度の画像バージョンを予測することにより収束を加速させる役割を果たします。
テキストと画像はそれぞれ2つの単一モダリティ「リファイナー」DiTブロックを通過した後、22個の同一のDiTブロックからなる1つのストリームに統合されます。テキストエンコーダーには、モデルパラメータを固定したQwen3.5-4Bモデルが使用され、特定のレイヤー(7・15・27)からの出力が活用されます。画像は32×32のパッチに分割され1024次元の潜在空間に3:1の圧縮率で圧縮された後、画像リファイナーブロックに投影されます。ブロック5ではモデルの潜在空間をDINOv3-Lに合わせた2層のPixelREPA読み出し回路を備えています。ブロック10と16の後に2つのリニア読み出しヘッドがあり、それぞれ1/4解像度と1/2解像度でクリーンな画像を予測します。
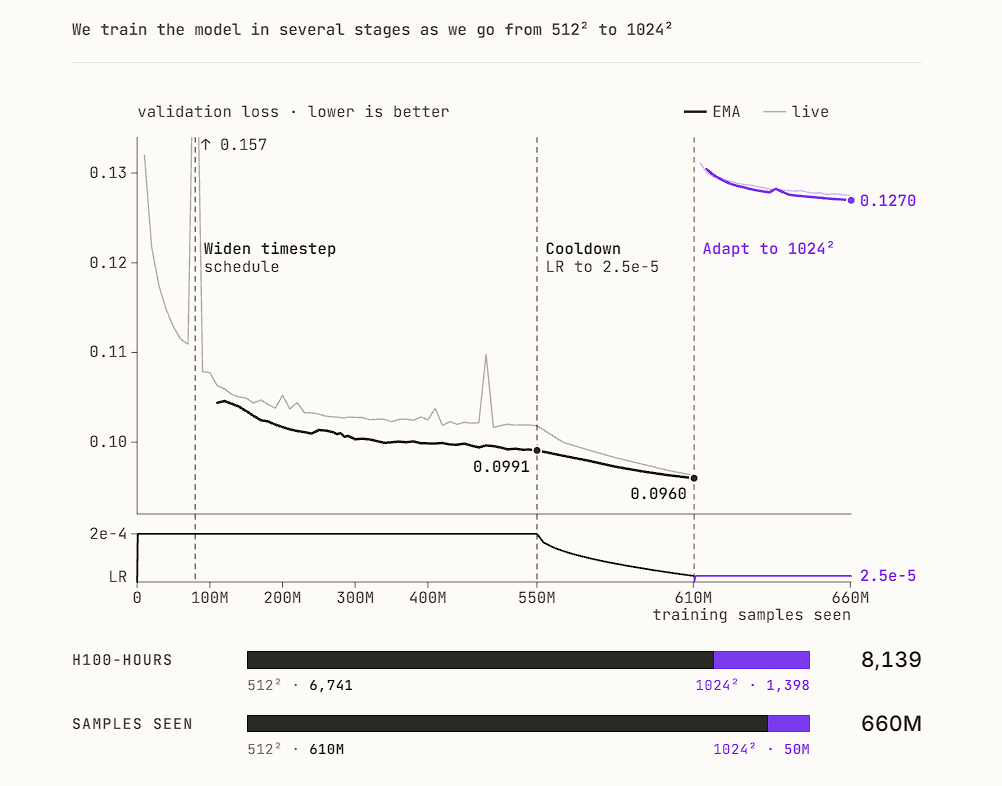
トレーニングプロセスではMSE・PixelREPAによるコサイン距離・最終出力ヘッドでのMSE・LPIPSとP-DINOによる知覚損失(Perceptual Loss)など、複数の損失関数が組み合わされています。トレーニングは段階的に行われ、512²画像で約6億6千万サンプルを学習した後、1024²画像で約5000万サンプルを学習するというカリキュラム学習が採用されています。
P-JiTの学習データにはインフォグラフィックス・PDF・書籍のページなどが含まれておらず、「文字を含む画像」「ポスター」「インフォグラフィック」などの生成には非対応です。またP-JiTは比較的小規模なモデルであり、全身描写・多数のエンティティの描写・複数人物間のインタラクション・広範な世界知識に関しては解決すべき課題がありますが、より大規模なモデルを用いたトレーニングやさらなるポストトレーニングによって軽減される可能性があります。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.