Wispr Flow для Ubuntu за один вечер: плавающая кнопка диктовки на Wayland, и сколько граблей в этом нашлось
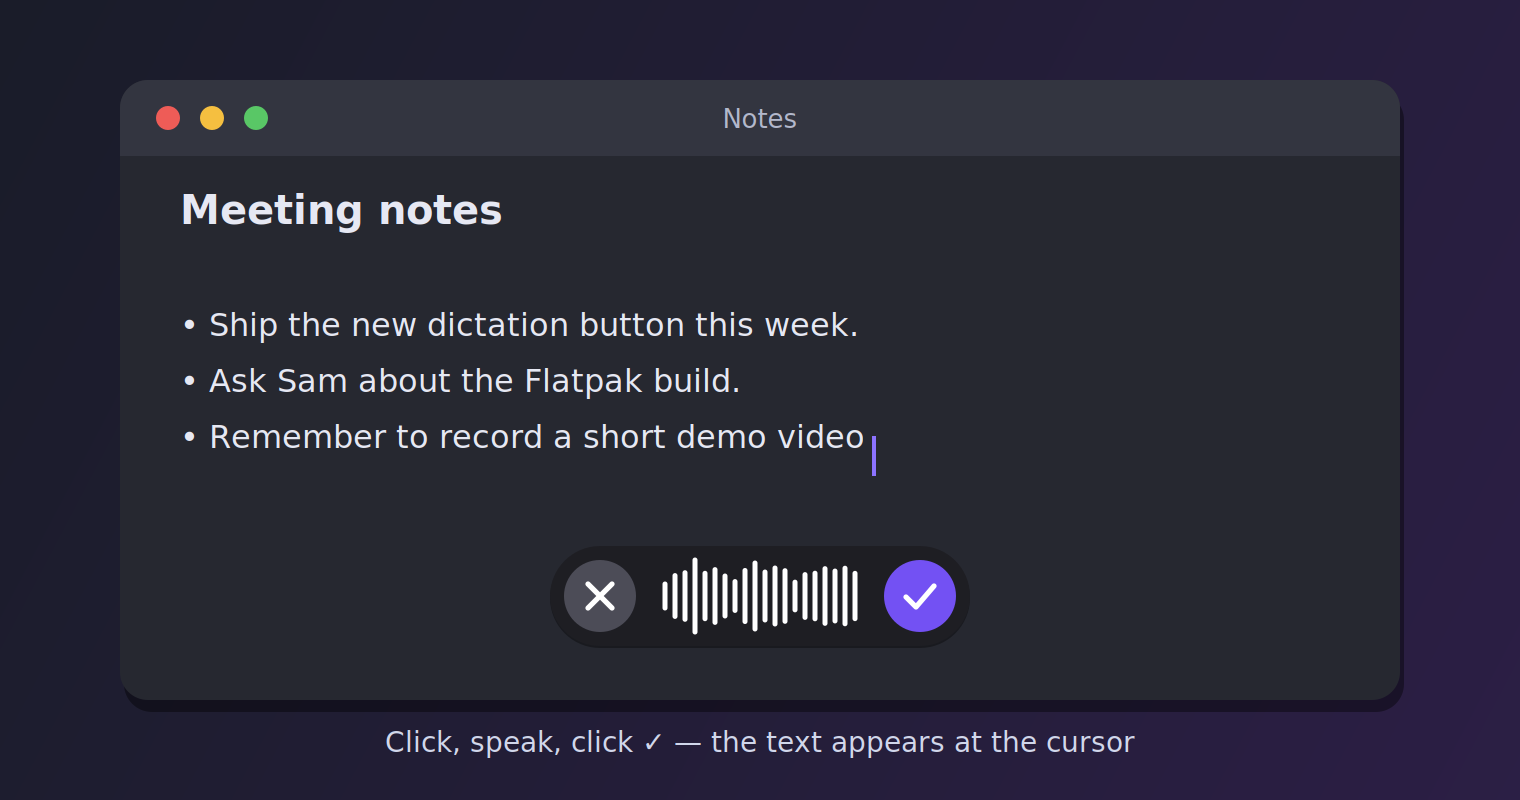
Репозиторий: https://github.com/xelavoklov/voiceflow (MIT). Приложение написано в паре с ИИ‑ассистентом (Claude Code): я формулировал, что нужно, и проверял руками, ассистент писал код и разбирал логи. Про это подробнее в конце.
С чего всё началось
В VS Code я нажал на микрофон в чате Copilot, и он начал что‑то скачивать. Я подумал, что это английская модель распознавания, а многоязычная уже стоит у меня для Copilot CLI. Полез разбираться и выяснил две вещи:
VS Code скачал ту же самую многоязычную модель (
nemotron-3.5-asr-streaming), а качался на самом деле новый рантайм диктовки версии 2.1.0;после докачки диктовка в VS Code всё равно не работала: в логе
UtilityProcessWorker: terminated unexpectedly with code 139. Это segfault нативного рантайма, а «Canceled» в уведомлении был лишь следствием.
Тут и появилась мысль: если уж локальные модели распознавания на машине есть, почему бы не сделать то, чего мне на Linux не хватает, — Wispr Flow: плавающую кнопку, нажал, сказал, текст вставился туда, где стоит курсор. В любом приложении.
Что получилось
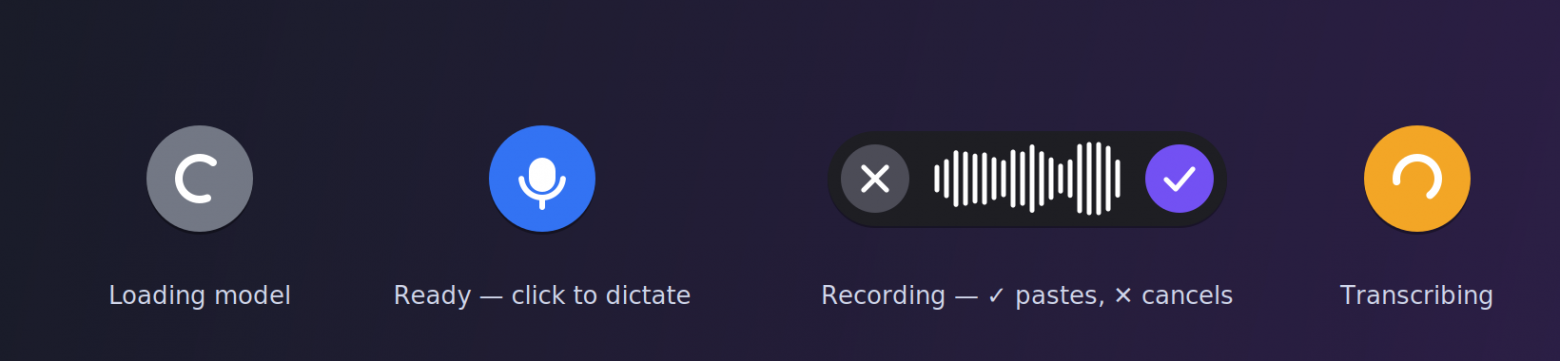
круглая кнопка поверх всех окон, которая не забирает фокус;
клик начинает запись, кнопка раскрывается в капсулу с живой волной, крестиком (отмена) и галочкой (распознать и вставить);
распознавание локальной моделью faster‑whisper на GPU или процессоре, без облака;
текст вставляется в любое поле ввода.
Архитектура
Окно: GTK 3 через XWayland;
Запись:
pw-record, 16 кГц, моно;Распознавание: отдельный процесс
worker.pyв своём venv;Вставка: буфер обмена GTK + виртуальная клавиатура через
/dev/uinput.
Идея простая. Сложности начались, когда это пришлось запускать на GNOME под Wayland.
Окно, которое не крадёт фокус
На Wayland приложение не может ни закрепить своё окно поверх остальных, ни надёжно отказаться от фокуса. Но GTK‑окно, запущенное через XWayland (GDK_BACKEND=x11), в mutter ведёт себя как привычное X11-окно:
os.environ.setdefault("GDK_BACKEND", "x11")
...
self.set_keep_above(True)
self.set_accept_focus(False)     # input hint = false
self.set_skip_taskbar_hint(True)
Благодаря accept_focus = False клик по кнопке не уводит фокус из поля ввода, и вставка потом попадает туда, куда нужно. В логах я это проверял: окно кнопки не получало фокус ни разу.
Вставка текста на Wayland
Тут нет xdotool. Единственный универсальный способ напечатать что‑то в чужое окно: положить текст в буфер обмена и «нажать» Ctrl+V через виртуальную клавиатуру, созданную в /dev/uinput. Создаётся она вручную, без внешних библиотек:
fd = os.open("/dev/uinput", os.O_WRONLY | os.O_NONBLOCK)
fcntl.ioctl(fd, UI_SET_EVBIT, EV_KEY)
for code in (KEY_LEFTCTRL, KEY_LEFTSHIFT, KEY_V):
    fcntl.ioctl(fd, UI_SET_KEYBIT, code)
os.write(fd, struct.pack("80sHHHHI", b"voiceflow-keyboard".ljust(80, b"\0"),
                         0x03, 0x1234, 0x5678, 1, 0) + b"\0" * (4 * 64 * 4))
fcntl.ioctl(fd, UI_DEV_CREATE)
Первая версия не работала: текст оказывался в буфере, но не вставлялся. Лечится двумя вещами:
Пауза ~120 мс между установкой буфера и нажатием: композитору нужно время принять новое содержимое.
Каждое событие клавиши отдельно, с собственным
SYN_REPORT, а не нажатие Ctrl и V одним пакетом.
Прежний буфер обмена я ещё и восстанавливаю через полсекунды, чтобы не портить пользователю его копипаст. Для терминалов нужен Ctrl+Shift+V, поэтому режим вставки переключается в меню.
Вторая версия тоже работала не везде. Сначала буфер ставился через wl-copy, и в окне терминала всё работало, а в браузере вставка молча не срабатывала. Причина нашлась в протоколе Wayland: в GNOME нет data-control, поэтому wl-copy и wl-paste на мгновение создают собственное окно (xdg_toplevel с заголовком wl-clipboard) и забирают фокус. Браузер терял фокус поля ввода и не успевал получить его обратно до Ctrl+V. Теперь буфер ставит само приложение (GTK через XWayland), без внешних утилит. Нажатие Ctrl+V идёт в отдельном потоке, чтобы главный цикл продолжал отвечать на запросы буфера.
Почему распознавание в отдельном процессе
GTK через python3-gi привязан к системному Python (в Ubuntu 26.04 это 3.14), а ctranslate2 для faster‑whisper проще собрать под 3.12. Вместо того чтобы бороться с этим, я разделил: интерфейс на системном Python, а распознавание в отдельном процессе из uv‑окружения. Общаются они JSON‑строками через stdin/stdout. Модель при этом остаётся загруженной между диктовками, и каждая фраза не платит за её загрузку.
Грабли, ради которых стоило писать статью
1. PyAV 19 сломал faster‑whisper
faster-whisper 1.2.1 при чтении аудио вызывает av.open(..., metadata_errors="ignore"), а в PyAV 19 этого параметра нет: TypeError: open() got an unexpected keyword argument 'metadata_errors'. Зависимость в faster-whisper указана без верхней границы, поэтому поставилась самая новая.
Мои записи и так готовые 16-битные wav на 16 кГц, поэтому проще вообще не использовать PyAV: читаю стандартным wave и отдаю модели массив numpy.
2. Микрофон «просыпается» с хлопком и съедает первое слово
Самая необычная находка. Пробовал диктовать, и первое слово терялось, а на тишине модель писала «Продолжение следует...». Я записал сырой файл и посмотрел на него по окнам в 0,1 секунды:
0.0s peak=1.00 mean=+1.00 clip=100%
0.1s peak=1.00 mean=+1.00 clip=100%
0.2s peak=1.00 mean=+0.88 clip=42%
0.3s peak=0.77 mean=+0.24 clip=0%
0.4s peak=0.08 mean=+0.04 clip=0%
Звуковая карта выходит из suspend, и первые ~0,3 секунды сигнал прижат к максимуму (скачок постоянной составляющей). Модель получает шум на старте и сбивается. Теперь воркер перед распознаванием отрезает начало, пока среднее значение окна не вернётся к нулю. Окончательное лечение — отключить suspend источника в WirePlumber, но это уже системная настройка, и в приложение я её не зашивал.
3. Громкость в PipeWire и усиление ALSA — это один регулятор
Я пытался вылечить клиппинг: снизил усиление ALSA (amixer sset Capture 30%) и поднял громкость PipeWire до 80%. Стало хуже: 88% отсчётов в максимуме даже в тишине. Оказалось, что PipeWire связывает свою громкость источника с аппаратным усилением карты, и 80% в PipeWire сразу вернули Capture на 100% (+30 дБ). Я замерил фоновый шум при нескольких значениях:
PW 80% hw=100%: clipped=88.5%
PW 40% hw=100%: peak=0.89
PW 22% hw=79%:  peak=0.02   <- чисто
PW 10% hw=37%:  peak=0.01
Пришлось подбирать один регулятор опытным путём: итог 15%.
4. Whisper на короткой русской фразе определил язык как польский
На «раз, раз, проверка» с автоопределением языка получилось Raz, raz, prawie. латиницей. Короткие фразы для детектора языка слишком короткие. Решение: язык по умолчанию задан явно (русский), переключается в меню.
5. Модель качается 28 КБ/с
У меня в системе был прокси, и через него HuggingFace отдавал ~28 КБ/с, а напрямую около 2 МБ/с. Для приложения это настройка: run.sh читает ~/.config/voiceflow/env, где можно сбросить прокси и указать зеркало (HF_ENDPOINT).
6. GPU без лишнего гигабайта
Для faster‑whisper на GPU нужны cuBLAS 12 и cuDNN 9, это около гигабайта pip‑пакетов. У меня они уже лежали в venv от ComfyUI, поэтому воркер умеет подхватывать их по пути из VOICEFLOW_CUDA_LIBS: он заранее загружает .so через ctypes до импорта модели. На RTX 5 060 Ti модель поднялась на CUDA сразу.
7. Индикатор уровня показывал максимум даже в тишине
Живая волна в капсуле сначала была «забита» на всю высоту. Причина та же постоянная составляющая сигнала у моей карты: в RMS попадало среднее значение, а не речь. Достаточно вычесть среднее перед расчётом:
mean = sum(samples) / len(samples)
rms = math.sqrt(sum((x - mean) ** 2 for x in samples) / len(samples)) / 32768
Установка
git clone https://github.com/xelavoklov/voiceflow
cd voiceflow
./setup.sh
Скрипт ставит нужные пакеты через apt, uv, правило udev для /dev/uinput, окружение с faster-whisper и ярлык с иконкой в меню. Если есть NVIDIA, предложит скачать CUDA‑библиотеки.
Ограничения (честно)
Протестировано на одной машине: Ubuntu 26.04, GNOME Shell 50, Wayland, NVIDIA RTX 5 060 Ti. На других окружениях и дистрибутивах я не проверял.
Вставку через буфер GTK я проверил не во всех приложениях: браузеры, терминалы и редакторы могут вести себя по‑разному.
Для вставки нужен доступ к
/dev/uinput. Это аргумент против Flatpak: в песочнице к нему нет доступа, правильный путь — порталRemoteDesktop, и это придётся переделывать.Глобальной горячей клавиши нет: на Wayland нет переносимого способа её зарегистрировать.
Если звуковая карта «хлопает» при пробуждении, первые ~0,4 с записи теряются, говорить лучше с небольшой паузой.
setup.shя прогнал только в режиме--dry-runна своей машине, на чистой Ubuntu не проверял.
Про «за пять минут» и работу с ИИ
В заголовке я не стал писать «за пять минут», потому что это неправда. Вся работа от идеи до публикации заняла около двух часов, и значительная часть ушла на то, что в статье описано выше: отладка вставки, микрофона, таймингов и ожидание скачивания моделей.
Что сделал ассистент: написал код, читал логи, замерял записи, находил причины (хлопок микрофона, связанные регуляторы громкости, несовместимость PyAV). Что делал я: ставил задачу, нажимал кнопки и говорил в микрофон, потому что ассистент не видит экран и не слышит звук; решал, что публиковать. Все «а работает ли?» проверялись моими руками, и ассистент так и сообщал: что проверено, а что нет.
Мне кажется, главный урок не в скорости, а в том, что большую часть времени съедает не код, а нестандартные ситуации в железе и системе, и их лучше решать замерами, а не догадками.
Идеи и PR приветствуются: особенно интересны тесты на других окружениях (KDE, Fedora, AMD‑карты) и портал RemoteDesktop вместо uinput.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.