Почему softmax теряет градиенты — и как школьная алгебра 7-го класса помогает их сохранить
Представьте: нейросеть почти идеально выучила правильный ответ. Ошибка ещё существует, а градиент по логиту правильного класса уже превратился в машинный ноль. А в другом случае ученик в точности повторяет учителя — и всё равно получает ненулевой сигнал ошибки.
Обе истории связаны с привычными softmax и cross-entropy.
22 октября 2026 года Джонатан Баррон (Jonathan T. Barron), Дэн Гнанапрагасам (Dan Gnanapragasam) и Майкл Тшаннен (Michael Tschannen) из Google DeepMind опубликовали препринт A Fix for Softmax and Cross-Entropy. Авторы разобрали два численных дефекта (в статье они названы Softmax Collapse и Softmax Cancellation) в таких стандартных библиотеках, как PyTorch и JAX, и предложили исправления, сохраняющие исходную математику.
Неужели все нейросети всё это время обучались неправильно? Нет, такой вывод из работы не следует. Но история интересная: иногда для изменения поведения обучения достаточно иначе записать школьную дробь. Давайте посмотрим на числа, графики и код.
Кроме того, описанное тут является столь же фундаментальным, что заслуживает такого же упоминания в учебных курсах, какого удостаивается, например, правильное написание функции сигмоиды или защита от переполнения при написании того же самого softmax.
Что разберём:
Короткий опыт: куда исчезает градиент
Для начала договоримся о трёх словах. Логиты — числа, которыми модель оценивает классы до преобразования в вероятности. Loss, или функция потерь, — штраф за ответ. Градиент показывает, как этот штраф меняется при небольшом изменении каждого числа.
Softmax превращает логиты в вероятности. Для одного правильного класса cross-entropy штрафует модель за низкую вероятность именно этого ответа. Производная потерь по его логиту равна вероятности минус единица; по логитам остальных классов — просто их вероятностям.
В точной арифметике сумма этих производных равна нулю. Прибавление одной константы ко всем логитам не меняет вероятности и штраф, поэтому движение сразу по всем координатам в одинаковую сторону не должно менять loss.
Проверим это на Python с NumPy. Первый класс правильный и уверенно лидирует:
import numpy as np

logits = np.array([20.0, 0.0], dtype=np.float32)

# Обычная схема softmax с защитой от переполнения.
shifted = logits - logits.max()
e = np.exp(shifted)
probs = e / e.sum()

# Производные cross-entropy по логитам, target = 0.
grad = probs.copy()
grad[0] -= np.float32(1.0)

print(f"Вероятности: {probs}")
print(f"Градиент:    {grad}")
print(f"Сумма градиентов: {grad.sum():.6e}")
Вероятности: [1.0000000e+00 2.0611537e-09]
Градиент:    [0.0000000e+00 2.0611537e-09]
Сумма градиентов: 2.061154e-09
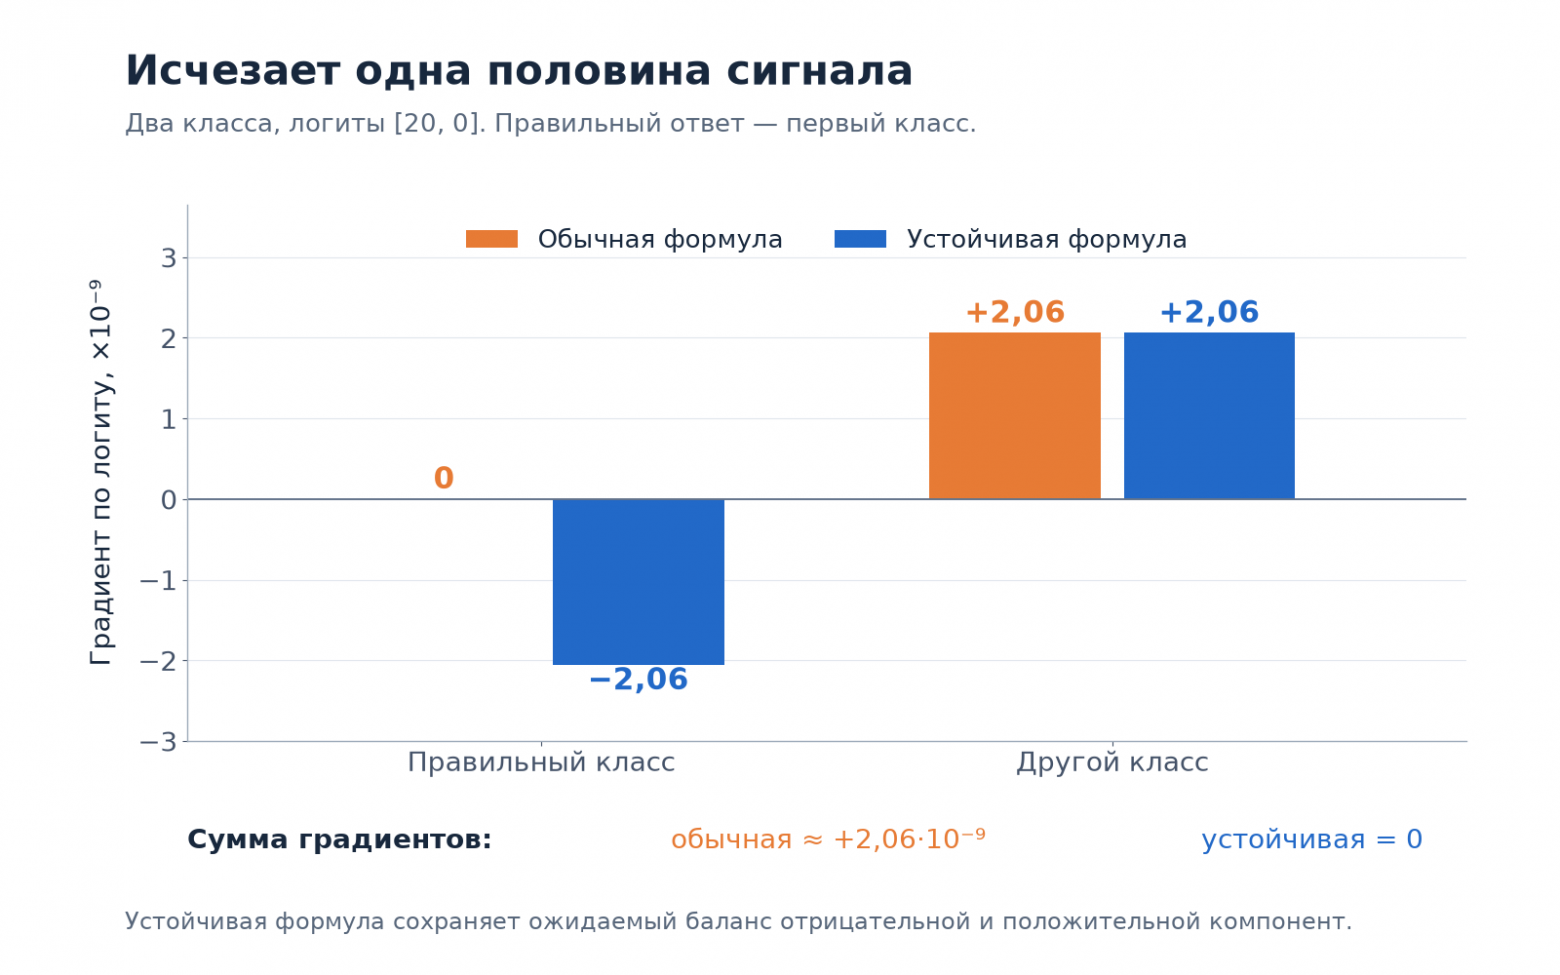
Рис. 1. Для логитов [20, 0] правильный градиент содержит две противоположные компоненты. В обычном вычислении float32 отрицательная компонента исчезает, а положительная остаётся. Собственный численный пример; значения округлены для подписей.
У правильного класса ожидалось примерно −2,06·10⁻⁹, а получилось ровно 0. При этом вероятность второго класса не обнулилась: маленькое положительное число прекрасно помещается в float32.
Проблема возникает при вычислении числа около единицы. У float32 примерно семь значащих десятичных цифр. Крошечную величину ещё можно хранить отдельно, но её прибавление к единице уже не обязательно изменит результат. Следующее вычитание единицы уничтожает оставшуюся информацию.
Здесь мы проверили конкретную вычислительную схему NumPy. Это объясняет механизм ошибки; поведение вашего ядра PyTorch или JAX нужно измерять в вашей среде.
Но ведь устойчивый softmax давно существует?
Да. В коде мы уже вычли максимальный логит перед вычислением экспоненты. От этого вероятности не меняются, а экспоненты не переполняются:
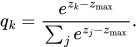
Общую сторону вопроса уже разбирали на Хабре в статье «Откуда в обучении берётся nan: численная нестабильность в ML и почему всё считают в логарифмах» в блоге OTUS. Там речь о переполнениях, NaN и вычислениях в логарифмах.
Однако защита от переполнения ещё не означает, что маленькие разности тоже будут вычисляться точно. Именно здесь начинаются две ошибки из новой работы.
Первая ошибка: Softmax Collapse
Пусть правильный класс имеет номер  . Его логит —
 , вероятность —
 , а производная потерь по этому логиту —
 .
Чтобы не носить за собой длинную сумму, введём отрыв  — преимущество правильного ответа над всеми конкурентами вместе:
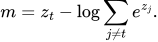
Для двух классов это просто разница двух логитов. Если классов много, учитывать нужно всех конкурентов: отрыв от одного ближайшего соседа уже не равен .
Обозначим их суммарный относительный вес через  :
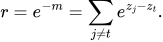
Чем увереннее правильный ответ, тем больше и меньше . Вероятность ответа равна 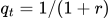 .
Обычное вычисление градиента:
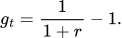
Если слишком мало, сумма  округляется до единицы. Затем вероятность становится машинной единицей, а градиент — машинным нулём. Хотя математически он ещё отрицателен!
Где проходит обрыв
У float32 23 явно хранимых бита дробной части и ещё один неявный ведущий бит для нормальных чисел. Шаг между единицей и следующим большим числом равен  . При округлении к ближайшему прибавка меньше
 уже теряется.
Для этой схемы вычислений приблизительный порог можно записать так:
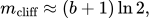
где  — число явно хранимых битов дробной части.
Формат вычисления | Битов дробной части | Порог отрыва |
|---|---|---|
bfloat16 | 7 | ≈ 5,54 |
float16 | 10 | ≈ 7,62 |
float32 | 23 | ≈ 16,63 |
float64 | 52 | ≈ 36,74 |
Это пороги арифметики конкретной операции. Наличие весов в bfloat16 не означает автоматически, что softmax и loss тоже вычисляются в нём: смешанная точность может выполнять чувствительные операции в float32. И сама таблица не заменяет измерения библиотечного ядра.
Исправление: школьная алгебра сохраняет маленькое число
Приведём дроби к общему знаменателю. В числителе останется 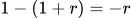 . Получится та же математическая функция, записанная иначе.
Устойчивое вычисление градиента:
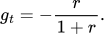
Теперь маленькая величина находится в числителе. Даже если знаменатель округлится до единицы, результат останется примерно равен  . Вместо вычитания почти одинаковых чисел мы сразу вычисляем малую поправку.
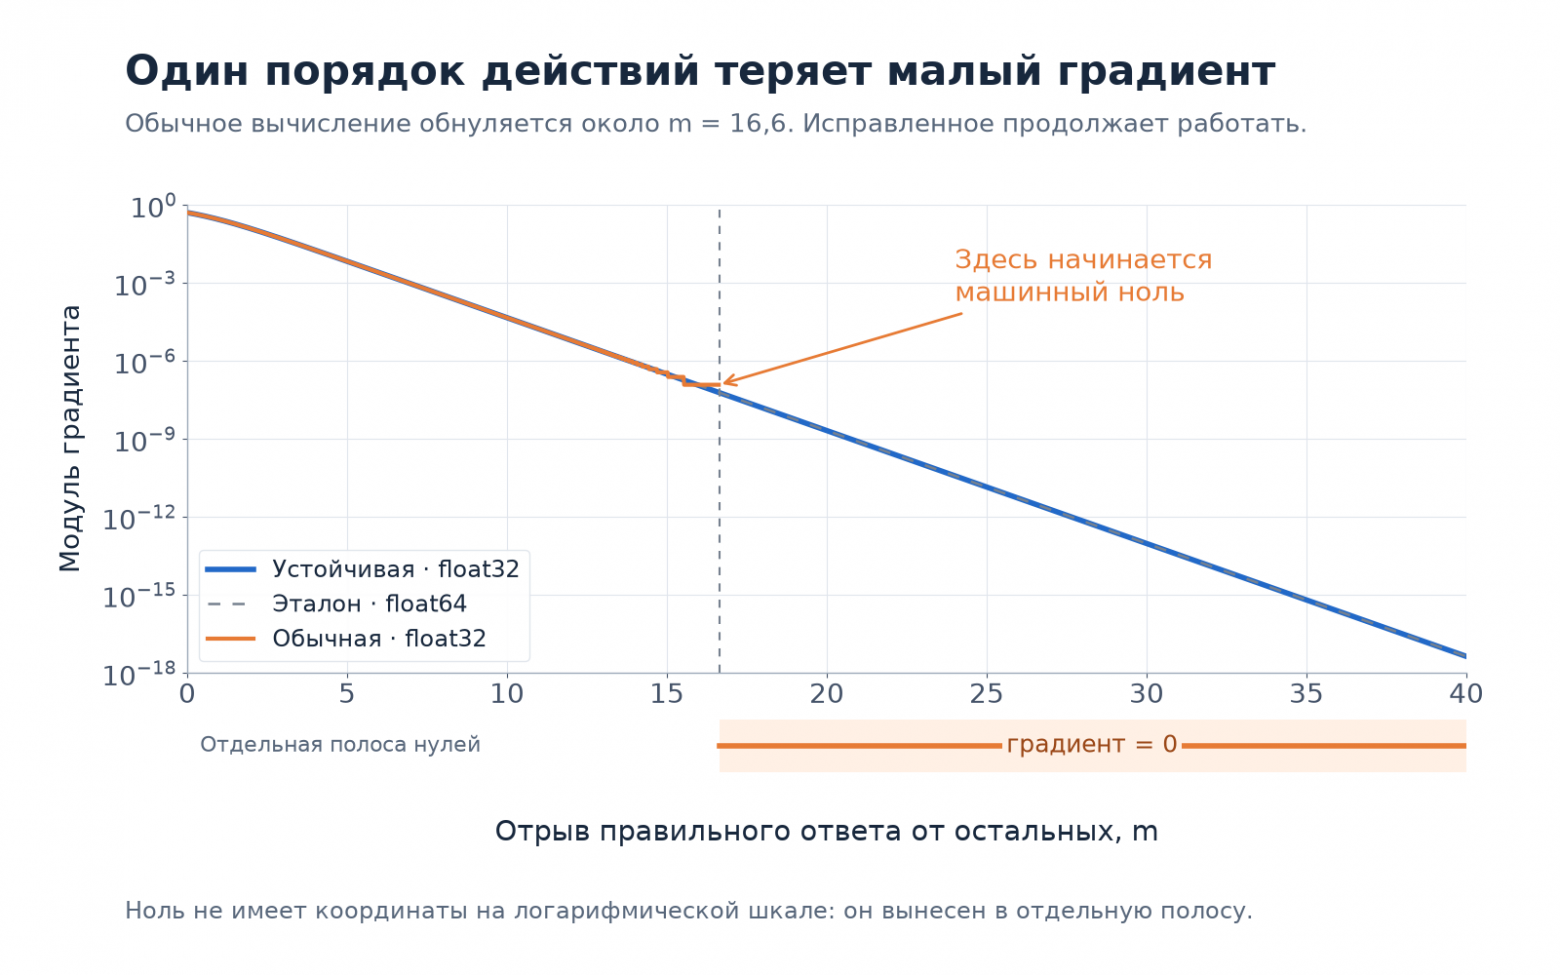
Рис. 2. Модуль градиента правильного класса в зависимости от отрыва m. В обычной схеме float32 градиент обнуляется около m = 16,6. Устойчивая формула продолжает уменьшаться вместе с эталоном. Машинный ноль показан отдельно: на логарифмической оси он не имеет конечной координаты.
Проверим несколько точек с графика:
import numpy as np

m = np.array([10, 15, 16, 17, 20, 30], dtype=np.float32)
one = np.float32(1.0)
r = np.exp(-m)

usual = one / (one + r) - one
fixed = -r / (one + r)

for margin, a, b in zip(m, usual, fixed):
    print(f"m={margin:2.0f}: usual={a: .6e}, fixed={b: .6e}")
m=10: usual=-4.541874e-05, fixed=-4.539786e-05
m=15: usual=-3.576279e-07, fixed=-3.059022e-07
m=16: usual=-1.192093e-07, fixed=-1.125352e-07
m=17: usual= 0.000000e+00, fixed=-4.139937e-08
m=20: usual= 0.000000e+00, fixed=-2.061154e-09
m=30: usual= 0.000000e+00, fixed=-9.357623e-14
Бесконечной точности это не даёт. Если уже сама экспонента станет слишком мала для формата, возникнет underflow — округление к нулю у нижней границы представимых величин. Исправление убирает преждевременную потерю сигнала при прибавлении к единице, но не расширяет диапазон чисел компьютера.
Вторая ошибка: Softmax Cancellation
При дистилляции сеть-ученик учится повторять вероятности фиксированной сети-учителя. Здесь  — вероятность класса у учителя,
 — у ученика, а
 — логит ученика.
Функция потерь с такими «мягкими» метками:
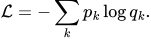
Её производная по логиту ученика:
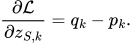
Если ученик идеально повторил учителя, градиент должен стать нулевым. При этом сама cross-entropy обычно не равна нулю: она равна энтропии распределения учителя. Нулевыми при совпадении становятся градиент и KL-дивергенция — мера различия двух распределений.
Но вероятности могут вычисляться разными путями: например, для учителя через деление экспонент, а для градиента ученика — через экспоненту от log_softmax. В точной математике результаты одинаковы; при округлении младшие разряды могут различаться.
import numpy as np

z = np.array([2.0, 1.0, 0.0], dtype=np.float32)
shifted = z - z.max()
e = np.exp(shifted)

p = e / e.sum()                         # путь через softmax
q = np.exp(shifted - np.log(e.sum()))   # через log_softmax

noise = q - p
print(noise)
print(f"Норма: {np.linalg.norm(noise):.6e}")
[ 0.0000000e+00  1.4901161e-08 -1.4901161e-08]
Норма: 2.107342e-08
Логиты совпали, а вычисленный градиент — нет. Это не означает, что компьютер способен получить ненулевой результат из x - x: здесь вычитаются числа, которые уже немного различаются из-за разных вычислительных путей.
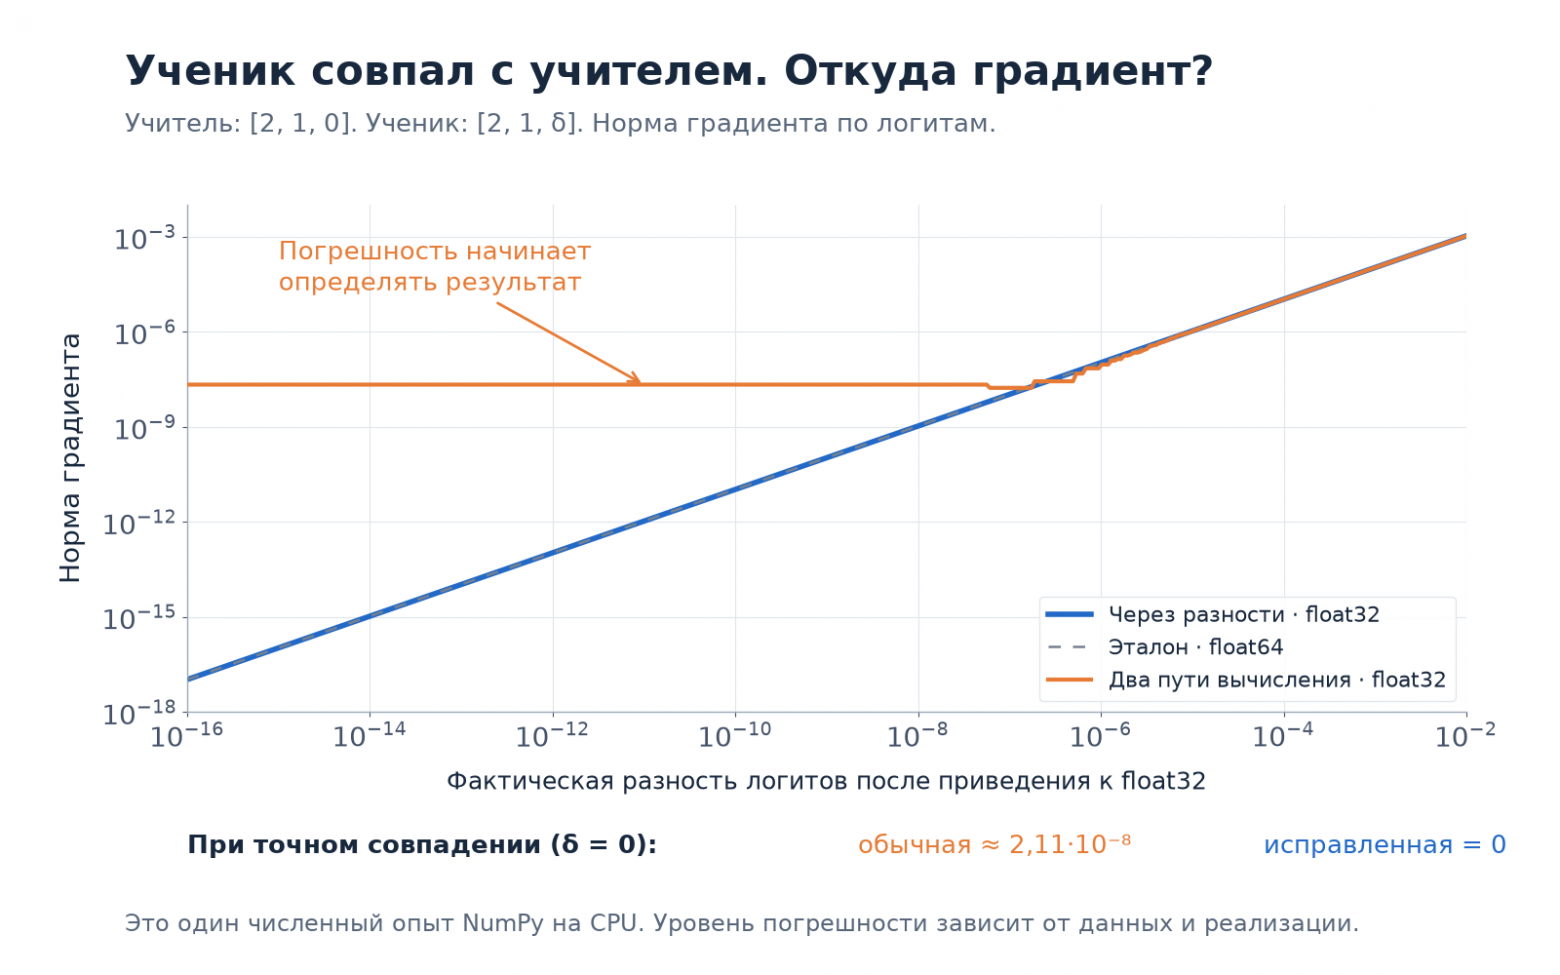
Рис. 3. Учитель имеет логиты [2, 1, 0], ученик — [2, 1, δ]. По горизонтали — фактически представимое различие логитов float32; по вертикали — норма градиента. При сближении моделей погрешность обычного вычисления начинает определять результат. Точное совпадение показано отдельно. Уровень погрешности зависит от данных, формата и реализации.
Исправление: сначала сравнить логиты
Авторы предлагают вычислять маленькую разность вероятностей через разность логитов. Разберём по шагам, чтобы обозначения не превратились в стену символов.
Шаг 1. Находим различие ученика и учителя.
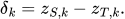
Шаг 2. Вычитаем среднее различие, взвешенное вероятностями учителя. Полученные величины обозначим  :
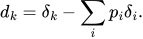
Шаг 3. Вычисляем малую поправку к вероятности. Для удобства обозначим общий нормирующий член через  :
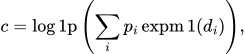
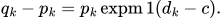
expm1(x) вычисляет  , а
log1p(x) —  . Их специальные реализации сохраняют точность при малом
x, когда прямое вычисление через прибавление или вычитание единицы её теряет.
В точной арифметике здесь снова та же самая разность  . При совпадении логитов сразу получаем нулевые
 , затем
 и . Последняя операция —
expm1(0), которая возвращает машинный ноль.
Проверка исправления при совпавших логитах: короткий NumPy-код
import numpy as np

teacher = np.array([2.0, 1.0, 0.0], dtype=np.float32)
student = teacher.copy()

e = np.exp(teacher - teacher.max())
p = e / e.sum()

delta = student - teacher
d = delta - np.sum(p * delta)
c = np.log1p(np.sum(p * np.expm1(d)))
gradient = p * np.expm1(d - c)

print(gradient)  # [0. 0. 0.]
Это локальная демонстрация для близких логитов, а не готовая функция обучения. Для больших различий нужны дополнительные меры устойчивости; полную реализацию следует смотреть у авторов.
Почему маленькая ошибка может влиять на обучение
Казалось бы: градиент порядка одной стомиллионной — кому какое дело? Но величина шага зависит не только от самого градиента, но и от оптимизатора.
Например, Adam нормирует накопленный сигнал на оценку его недавнего масштаба:
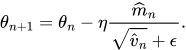
Здесь  — параметры модели,
 — скорость обучения,
 и
 — оценки среднего градиента и среднего его квадрата с поправкой на начальное смещение. Малое
 ограничивает влияние очень маленького знаменателя. Индекс
 теперь обозначает шаг обучения; он не связан с номером правильного класса.
У Softmax Collapse появляется асимметрия: градиент целевого логита исчез, а градиенты конкурентов сохранились. Дальше этот искажённый сигнал проходит через сеть и попадает в адаптивный оптимизатор. Градиент по логиту и градиент по весам — разные вещи: нельзя буквально заключить, что исчезновение одной компоненты немедленно обнулило оценки для всех соответствующих весов.
Авторы связывают такую асимметрию с Slingshot, или эффектом «Рогатки»: после периода низкого loss возникают резкие всплески. В экспериментах работы исправление численной схемы убирает эти всплески и меняет дальнейшее обучение.
На рисунке ниже сравниваются два режима. Weight decay — регуляризация, которая понемногу уменьшает параметры модели; в верхнем эксперименте она включена, в нижнем — нет.
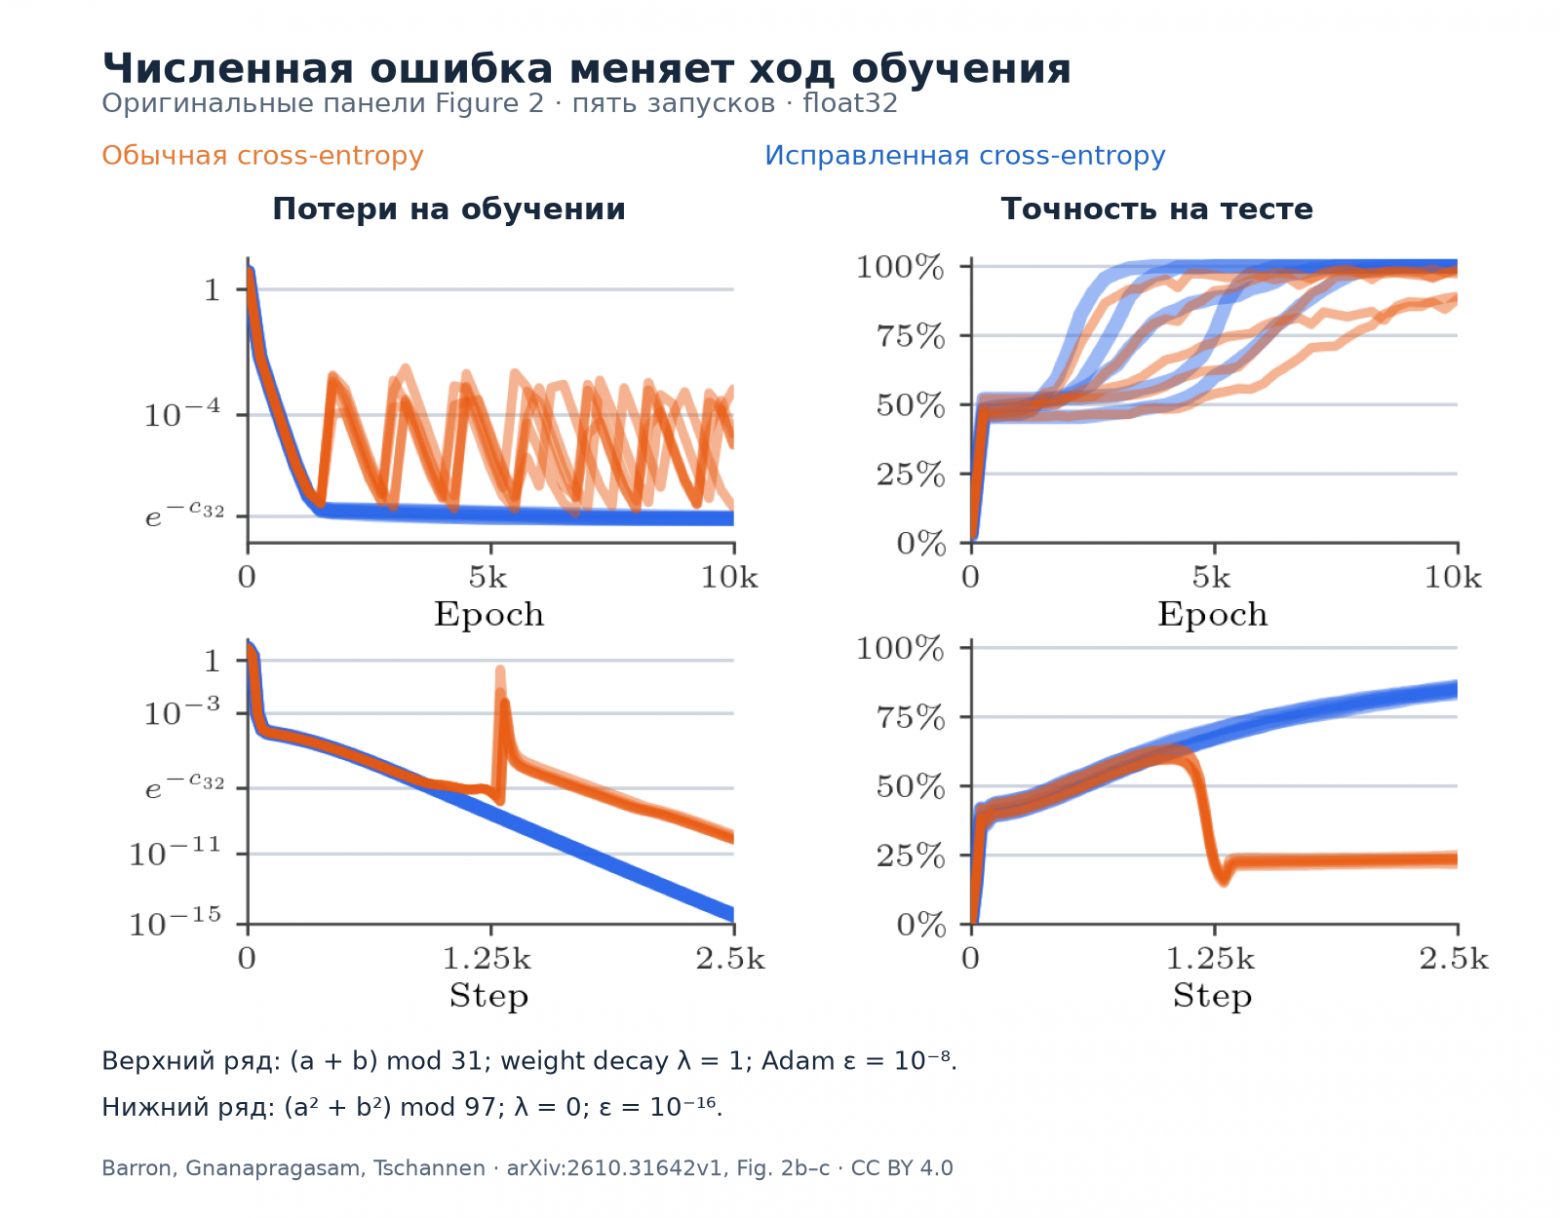
Рис. 4. Оригинальные панели Figure 2b,c работы Barron, Gnanapragasam и Tschannen; добавлены русские пояснения. Слева — loss, справа — тестовая точность. Сверху: сложение по модулю 31, weight decay λ = 1, Adam ε = 10⁻⁸. Снизу: (a² + b²) mod 97, λ = 0, ε = 10⁻¹⁶. Вычисления float32, пять запусков с разными начальными состояниями генератора случайных чисел (seed). Epoch означает эпохи обучения, Step — шаги, c₃₂ ≈ 16,6 — порог точности. Источник: раздел 4 препринта, CC BY 4.0. Это данные авторов, а не наша репродукция обучения.
Это более сильный результат, чем один искусственный пример с двумя числами. Но он не доказывает, что любой всплеск loss у любой LLM вызван именно softmax. В работе рассматриваются определённые модели и задачи; перенос вывода на вашу систему требует отдельного эксперимента.
Как записать loss, чтобы сохранить маленькую величину
Для одного примера с правильным классом cross-entropy математически можно выразить через всех конкурентов. Сначала вычислим:
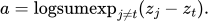
Здесь logsumexp означает «логарифм суммы экспонент», вычисленный устойчивым способом. Затем:
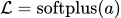
Функция softplus(a) — это устойчивая реализация  . Малую прибавку не нужно сначала складывать с единицей обычной операцией, теряя её до вычисления логарифма.
Ниже — учебная реализация для случая, который мы исследуем: правильный класс имеет максимальный логит. Она возвращает loss и градиент по логитам явно, чтобы их можно было проверить. Это не замена библиотечному autograd, не поддержка всех режимов cross-entropy и не исправление дистилляции.
Проверенный NumPy-пример для уверенного правильного ответа
import numpy as np

def confident_hard_ce(z, target):
    z = np.asarray(z)
    if z.ndim != 1 or z.size < 2 or z.dtype not in (np.float32, np.float64):
        raise ValueError("Нужен 1D-массив float32/float64, K >= 2")
    if not np.isfinite(z).all():
        raise ValueError("Все логиты должны быть конечными")
    if not isinstance(target, (int, np.integer)) or not 0 <= target < z.size:
        raise ValueError("target должен быть целым числом от 0 до K - 1")
    target = int(target)
    if z[target] != z.max():
        raise ValueError("В этом примере правильный класс должен быть лидером")

    other = np.arange(z.size) != target
    d = z[other] - z[target]
    if not np.isfinite(d).all():
        raise ValueError("Разности вышли за диапазон выбранного формата")

    log_r = np.logaddexp.reduce(d)       # log(sum(exp(d)))
    zero = np.zeros((), dtype=z.dtype)
    loss = np.logaddexp(zero, log_r)    # softplus(log_r)

    grad = np.zeros_like(z)
    grad[other] = np.exp(d - loss)
    grad[target] = -grad[other].sum()  # не вычисляем q_t - 1
    return loss, grad

z = np.array([20.0, 0.0], dtype=np.float32)
loss, grad = confident_hard_ce(z, target=0)
print(loss)        # 2.0611537e-09
print(grad)        # [-2.0611537e-09  2.0611537e-09]
print(grad.sum())  # 0.0
np.logaddexp(a, b) устойчиво вычисляет логарифм суммы двух экспонент. Метод reduce последовательно объединяет весь массив конкурентов. Градиенты конкурентов считаются из малых экспонент, а градиент целевого класса — как их отрицательная сумма.
Ограничение на максимальный целевой логит здесь намеренное. Этот фрагмент демонстрирует конкретный режим; для произвольных ответов, батчей, весов классов и автоматического дифференцирования нужна полноценная реализация.
У авторов на странице проекта есть код JAX и интерактивная демонстрация. Для внедрения я бы начинал именно с полной вычислительной схемы и проверки её поведения в нужной библиотеке, а не с копирования одной дроби в производственный код.
Никто не замечал раньше?
Замечали. Более того, работа DeepMind ссылается на предшественников.
Prieto и соавторы, ICLR 2025 исследовали Softmax Collapse и предложили StableMax. Он меняет саму функцию, заменяя экспоненциальное преобразование другим. Здесь же исправление сохраняет математические softmax и cross-entropy, меняя порядок вычислений.
Liu и соавторы в мае 2026 года уже изучали нарушение нулевой суммы градиентов и его связь со Slingshot. Ещё раньше устойчивость softmax и log-sum-exp систематически разбирали Blanchard и Higham.
Новость — в конкретных исправлениях двух дефектов и исследовании их последствий для обучения. Это не первое открытие того, что компьютерная арифметика округляет числа.
Бежать ли переписывать прод?
Я бы начал с измерений. Особое внимание имеет смысл уделить дистилляции с почти совпадающими распределениями, очень уверенным предсказаниям и длительному обучению после запоминания выборки. В последнем случае может наблюдаться grokking: способность обобщать появляется заметно позже, чем высокая точность на обучающих данных.
Но ни большой словарь LLM, ни используемый формат весов сами по себе не дают готового ответа о наличии проблемы. Нужно знать распределение отрывов и фактический формат чувствительных операций.
Label smoothing, или сглаживание меток, уменьшает давление в сторону бесконечной уверенности: целевой ответ получает вероятность меньше единицы. Это может снижать вероятность попадания в проблемный режим, но не исправляет численную формулу. Температура тоже меняет уверенность: при фиксированных логитах высокая температура смягчает распределение, низкая делает его острее. Универсальной защиты из этого не получается.
Практическую проверку я бы построил так:
Подать уверенный правильный ответ, например
[20, 0]вfloat32. Посмотреть на loss, все компоненты градиента и их сумму.Для дистилляции дать ученику и фиксированному учителю одинаковые логиты. Проверять нулевой градиент, а не нулевую cross-entropy.
Повторить опыт для почти совпавших логитов. Сравнить с вычислением повышенной точности и убедиться, что малая добавка сохранилась уже в самих входных данных.
Записать версии библиотеки, устройство и фактический dtype операции. Проверить отдельно нужные режимы смешанной точности и компиляции.
При замене реализации сравнить качество, устойчивость и время обучения в одинаковых условиях. Более точная формула не обязательно быстрее оптимизированного библиотечного ядра.
Выводы
Мне в этой истории нравится сочетание масштаба и простоты. Мы обсуждаем современные нейросети, а ключ к одному из дефектов помещается в школьное преобразование дроби.
Математически одинаковые выражения могут давать разные машинные результаты. В одном случае маленькая величина теряется рядом с единицей, в другом — сохраняется в числителе. Для дистилляции помогает тот же общий подход: вычислять малую поправку непосредственно, пока округление не уничтожило полезную информацию.
Это хороший повод проверить несколько численных инвариантов в своей среде. И гораздо более конкретный вывод, чем «все нейросети всё время обучались неправильно».
А вы встречали необъяснимые всплески loss или дрейф ученика при дистилляции? Особенно интересны воспроизводимые примеры с версиями библиотек, устройством и форматом вычислений.
Источники и воспроизводимость
Barron, Gnanapragasam, Tschannen. A Fix for Softmax and Cross-Entropy, arXiv v1, 22 октября 2026 года, CC BY 4.0.
Страница проекта: формулы, JAX-код и интерактивная демонстрация. Код может обновляться отдельно от arXiv v1.
Prieto и соавторы. Grokking at the Edge of Numerical Stability, ICLR 2025.
Liu и соавторы. Работа о Slingshot и нулевой сумме градиентов, 2026.
Blanchard, D. J. Higham, N. J. Higham. Accurately computing the log-sum-exp and softmax functions.
Все пять NumPy-примеров проверены на CPU: Python 3.12.1, NumPy 2.5.1, явный float32. Первые три рисунка — собственные численные иллюстрации, четвёртый использует результаты авторов исследования с указанием источника.
Если эта публикация вас вдохновила и вы хотите поддержать автора — не стесняйтесь нажать на кнопку
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.