Расшифровка голосовых для CRM на двух ядрах без видеокарты: faster-whisper, ffmpeg и cron
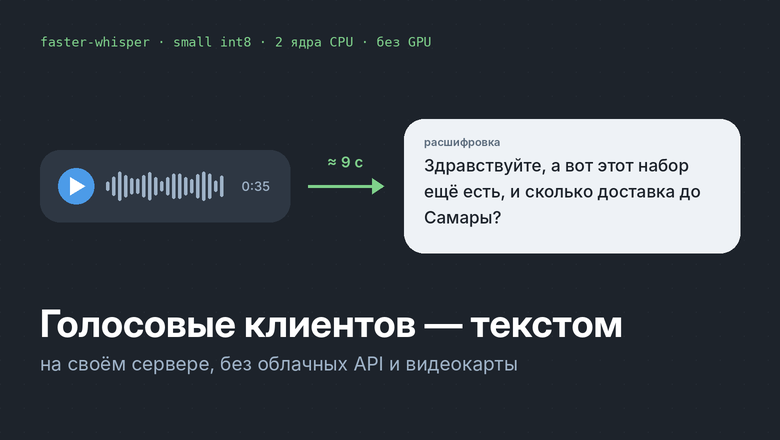
Мы делаем CRM для продаж в переписке. Клиенты наших магазинов любят голосовые: «Здравствуйте, а вот этот набор ещё есть, и сколько доставка до Самары?» Менеджеру такое сообщение нужно прослушать, а в шумном цеху или на созвоне это неудобно. Плюс по списку диалогов не понять, о чём голосовое, пока его не откроешь.
Решение очевидное — показывать под плеером текст. Расскажу, как мы это сделали без облачных API распознавания, на маленьком сервере в России, и на какие грабли наступили.
Почему не взять расшифровку из мессенджера
ВКонтакте умеет расшифровывать голосовые сам: у вложения audio_message в ответе API есть поле с текстом. Но для сообщений сообщества оно у нас оставалось пустым даже спустя несколько дней. У MAX, Telegram и WhatsApp, которые приходят через сервис-посредник, расшифровки нет совсем.
Облачные сервисы распознавания отпали по другой причине: голосовое клиента — это персональные данные. Отправлять их на чужие серверы за границу мы не хотели, поэтому всё должно работать на наших серверах в России, а файлы — не сохраняться.
Модель и железо
Взяли faster-whisper — реализацию Whisper на CTranslate2, которая заметно быстрее оригинала на CPU. Модель small с квантованием int8: на русской разговорной речи она ошибается в отдельных словах, но смысл передаёт уверенно, а большего менеджеру и не надо.
Сервер — облачный, 2 ядра, без видеокарты. Распознавание вынесли на отдельную машину, чтобы не отнимать процессор у самой CRM. На ней голосовое длиной 35 секунд расшифровывается примерно за 9 секунд.
Настройки, которые дали этот результат:
compute_type="int8"— квантование весов, главный выигрыш по скорости на CPU;beam_size=1— жадное декодирование вместо поиска по лучу, на коротких фразах качество почти не меняется;vad_filter=True— детектор голоса вырезает тишину и паузы, которых в голосовых много;language="ru"— без автоопределения языка, это и быстрее, и меньше ошибок на коротких записях.
Грабли: декодирование звука
faster-whisper умеет сам открывать файл через PyAV. На голосовых из мессенджеров это ломалось: на части файлов PyAV падал с ошибкой чтения метаданных, а голосовые приходят в разных форматах: ogg, m4a, mp3.
Проще оказалось отдать декодирование ffmpeg и передать модели уже готовый массив: моно, 16 кГц, float32 от −1 до 1. Тогда формат исходного файла перестаёт иметь значение.
Скрипт распознавания
Вот весь скрипт целиком. Звук приходит на stdin, текст уходит в stdout:
#!/opt/stt/bin/python
import subprocess, sys
import numpy as np
from faster_whisper import WhisperModel

# ffmpeg переводит любой формат в сырой PCM: 16 бит, моно, 16 кГц
raw = subprocess.run(
    ["ffmpeg", "-v", "quiet", "-i", "pipe:0",
     "-f", "s16le", "-ac", "1", "-ar", "16000", "-"],
    input=sys.stdin.buffer.read(), capture_output=True,
).stdout
if not raw:
    sys.exit(2)

audio = np.frombuffer(raw, np.int16).astype(np.float32) / 32768
model = WhisperModel("small", device="cpu", compute_type="int8",
                     download_root="/opt/stt/models", cpu_threads=2)
segs, _ = model.transcribe(audio, language="ru", beam_size=1, vad_filter=True)
sys.stdout.write(" ".join(s.text.strip() for s in segs).strip()))
Интерфейс «stdin → stdout» удобен тем, что скрипт не знает ничего ни про CRM, ни про мессенджеры, а файл нигде не ложится на диск. Основной сервер вызывает его так:
curl -s "$VOICE_URL" | ssh stt-server /opt/stt/stt.pyМодель загружается при каждом вызове. Для нашего потока голосовых это приемлемо; при большой нагрузке скрипт стоит превратить в постоянно работающую службу с очередью.
Как это встроено в CRM
На основном сервере раз в минуту запускается задача:
* * * * * flock -n /tmp/stt_fill.lock timeout 600 python3 /opt/kohorta/stt_fill.py --limit 5flock -n— если предыдущий запуск ещё работает, новый просто не стартует, и задачи не копятся;timeout 600— страховка от зависшего ssh или ffmpeg;--limit 5— не больше пяти голосовых за проход, чтобы всплеск сообщений не забил сервер распознавания.
Сам stt_fill.py делает простую вещь: находит входящие голосовые за последние 2 дня, у которых ещё нет текста, по очереди скачивает звук по ссылке мессенджера, отдаёт его на распознавание и записывает текст во вложение сообщения. Интерфейс CRM показывает текст под плеером, а в списке диалогов вместо «Голосовое сообщение» появляется «🎤 Здравствуйте, а вот этот набор…».
Для каждого сообщения ведётся счётчик попыток: если файл битый или ссылка протухла, после трёх неудач сообщение больше не трогаем. Окно в 2 дня ограничивает выборку: задача не перебирает всю историю переписки на каждом запуске.
Что получилось
Голосовое появляется текстом примерно через минуту после того, как пришло: до ближайшего запуска задачи плюс несколько секунд на распознавание.
Менеджер видит суть голосового прямо в списке диалогов, не открывая его.
Никаких внешних API и оплаты за минуты: модель, звук и текст не покидают наших серверов в России.
Если будете повторять: начните с small int8 и beam_size=1 на CPU, декодируйте звук через ffmpeg, а не через PyAV, и не храните файлы — для расшифровки они не нужны.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.