Множество Мандельброта — объемная картина? Выпуклая? И почему из 120 картин кажутся только две?
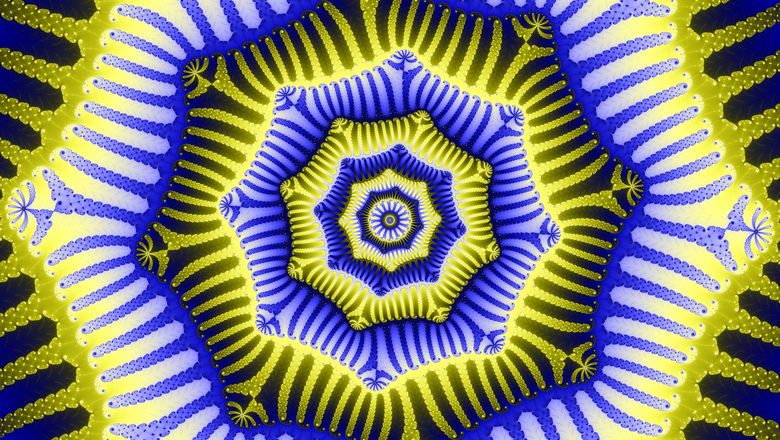
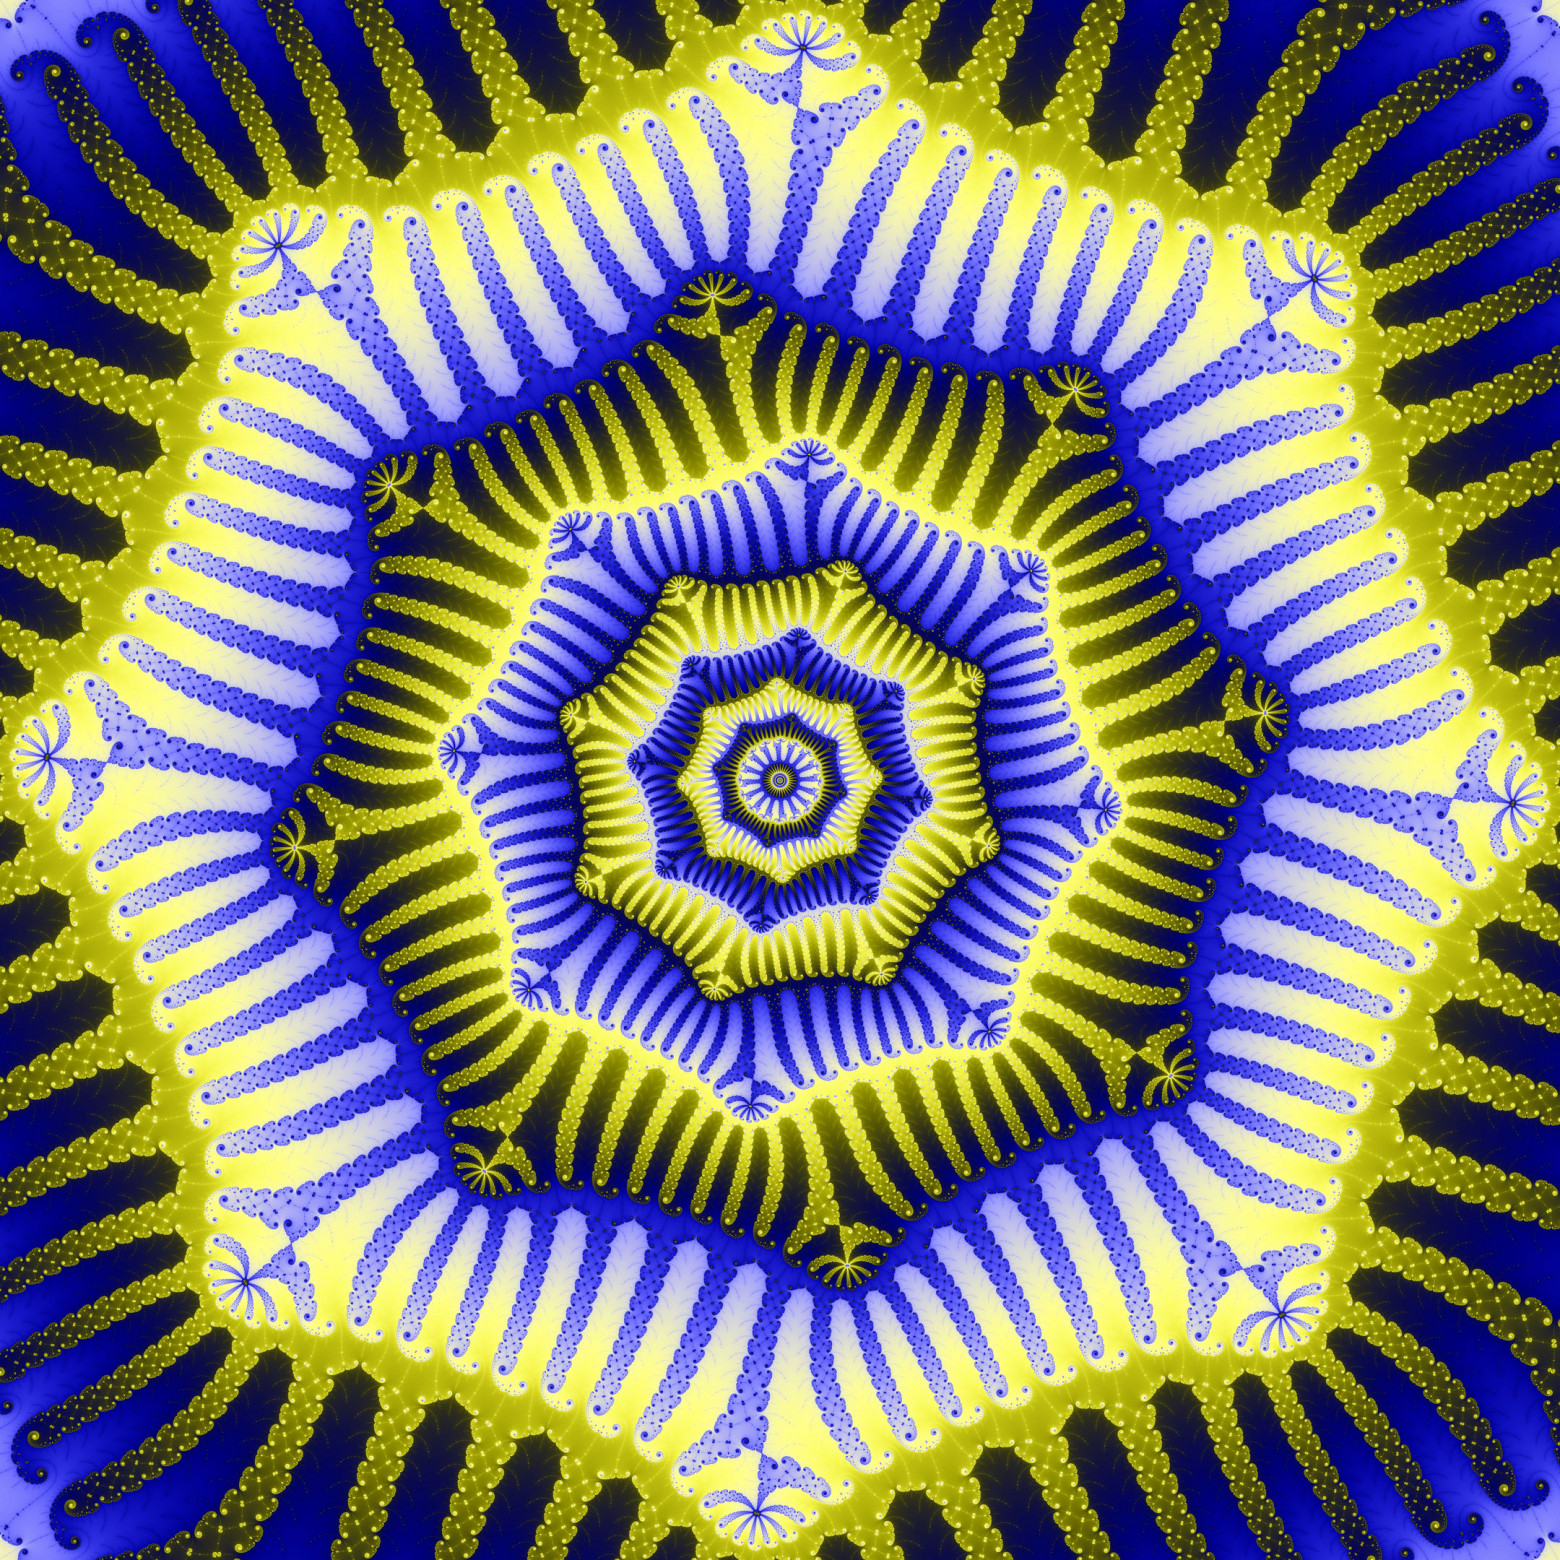

Это фрагмент множество Мандельброта которого сделал я и описал в википедии:
https://commons.wikimedia.org/wiki/File:Mandelbrot_Set_Image_118.png
Это три числа: Re = -1.74919762896578937419423768162729211653261585574161734756645570271259437106847945278504682550816934045282325615313706,
Im = -0.0000004253077715244042272585501215924940115095651514128365051648578746521975467051762910002043554114332125868777767,
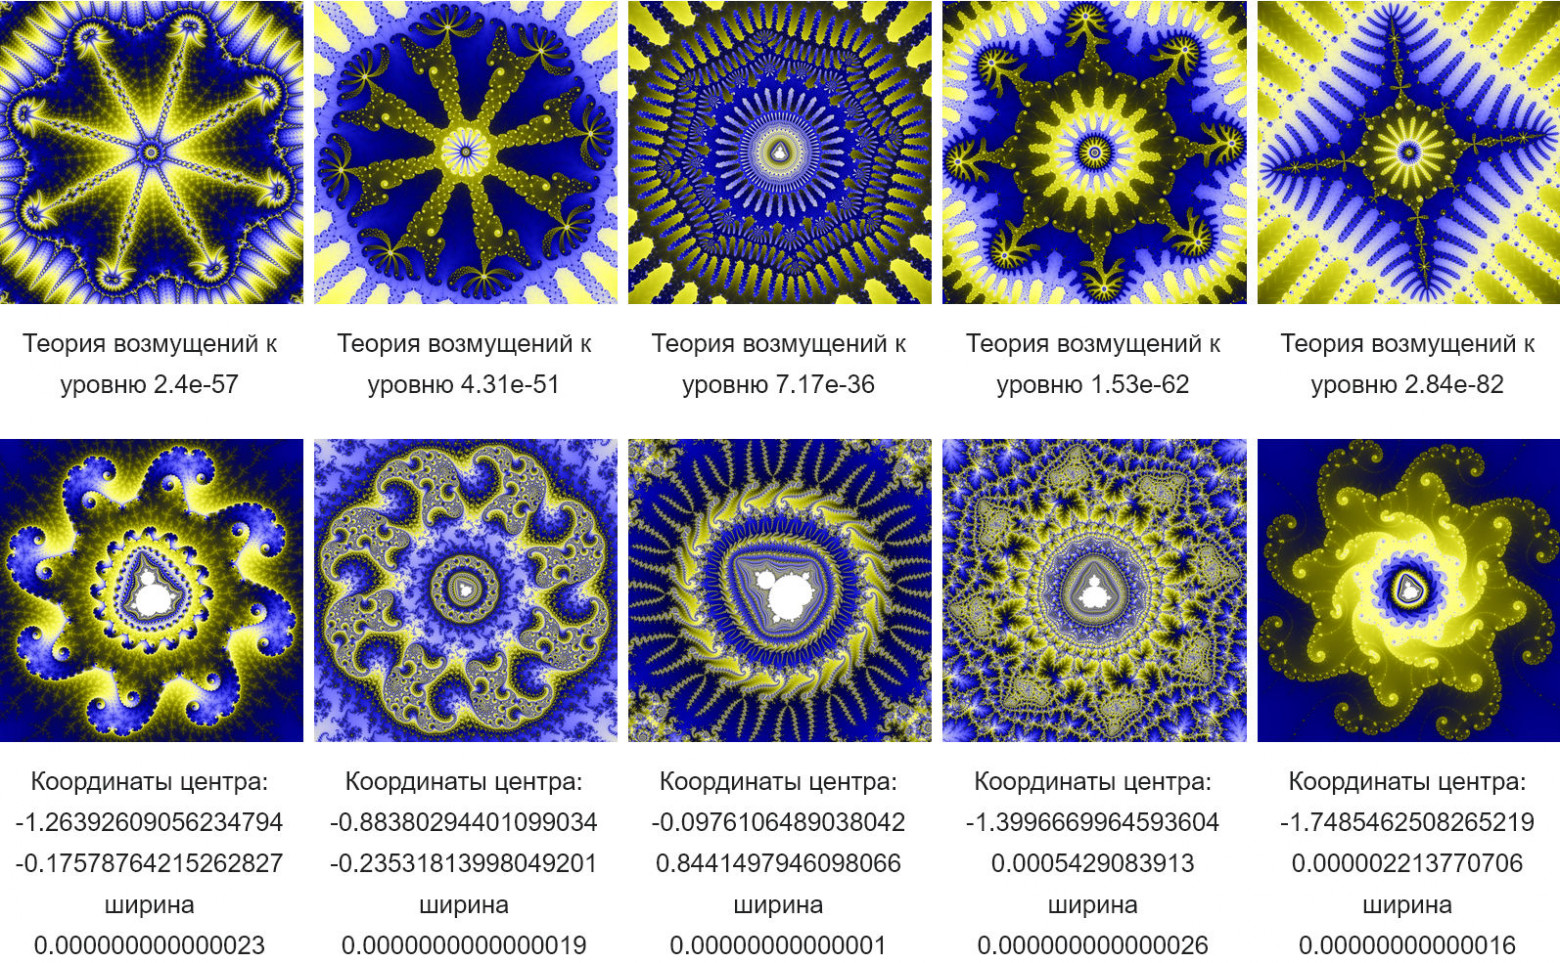
и ширина = 1.34e-113. Три числа - они полностью описывают фрагмент множество Мандельброта. Дальше - компьютер. Разрешение 10800 x 10800 пикселей. Время рендеринга 4 часа на процессоре AMD Phenom II X6 1055t (6 ядер).
А вот скажите... Кажется ли вам что объемная картина? Выпуклая? Особенно синий! А почему? Это же очень интересно! Говорят что да. Это мощный оптический эффект трехмерности на плоском рисунке. Наш мозг, привыкший считывать распределение света и тени в реальном мире, мгновенно интерпретирует эти плавные градиенты как трехмерный рельеф, хотя на самом деле мы смотрим на абсолютно плоскую двухмерную проекцию.
Вот второй:
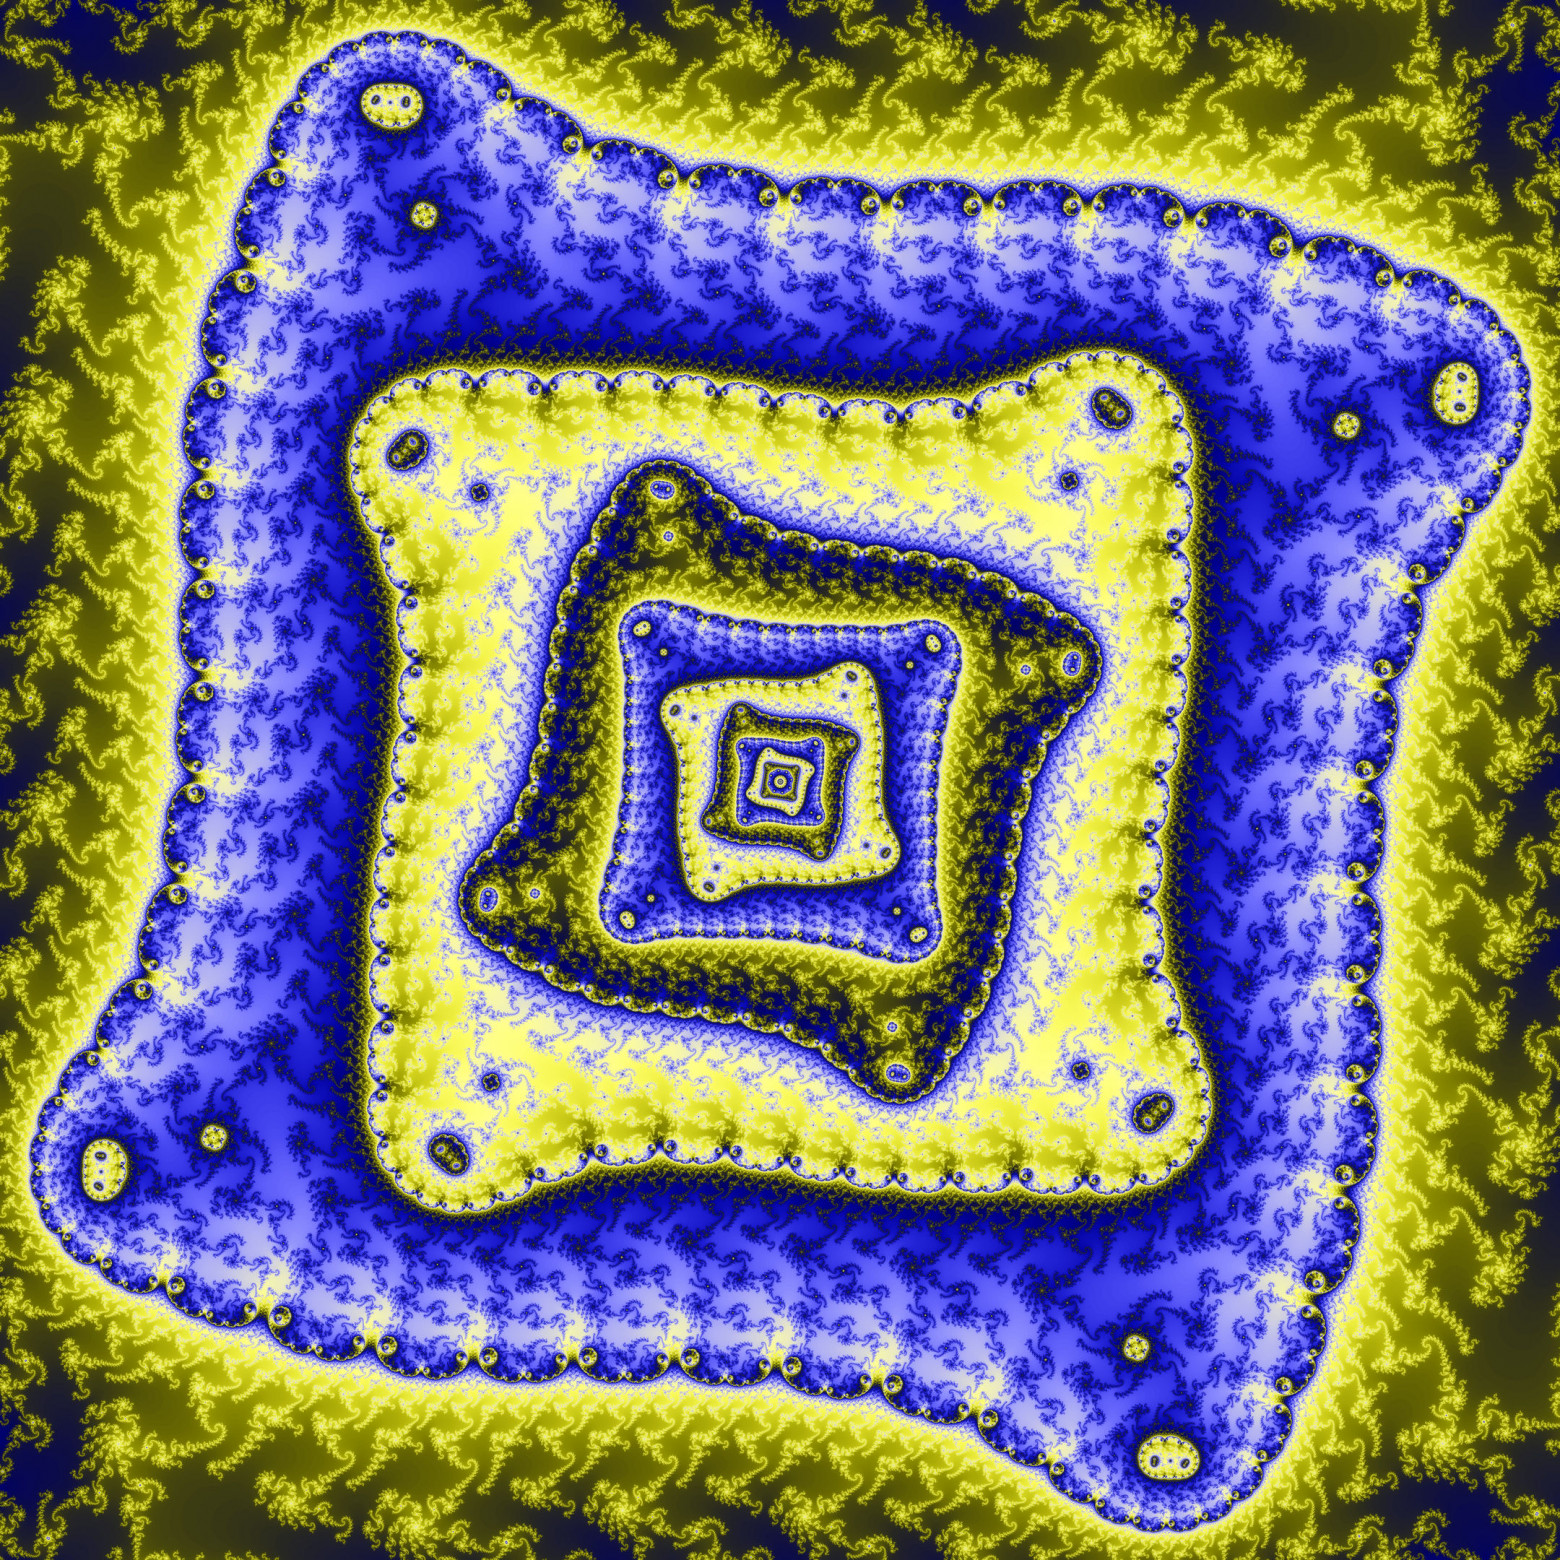

https://commons.wikimedia.org/wiki/File:Mandelbrot_Set_Image_119.png
Re = -0.843233764530751513324611730003844788663891317894291476942,
Im = 0.223818041558069959139898295480311440395574821870538878074,
Width = 2.66e-52
Разрешение 10800 x 10800 пикселей. Время рендеринга 14 часа на процессоре AMD Phenom II X6 1055t (6 ядер).
Синий цвет - выпуклая? Да!
И третий:
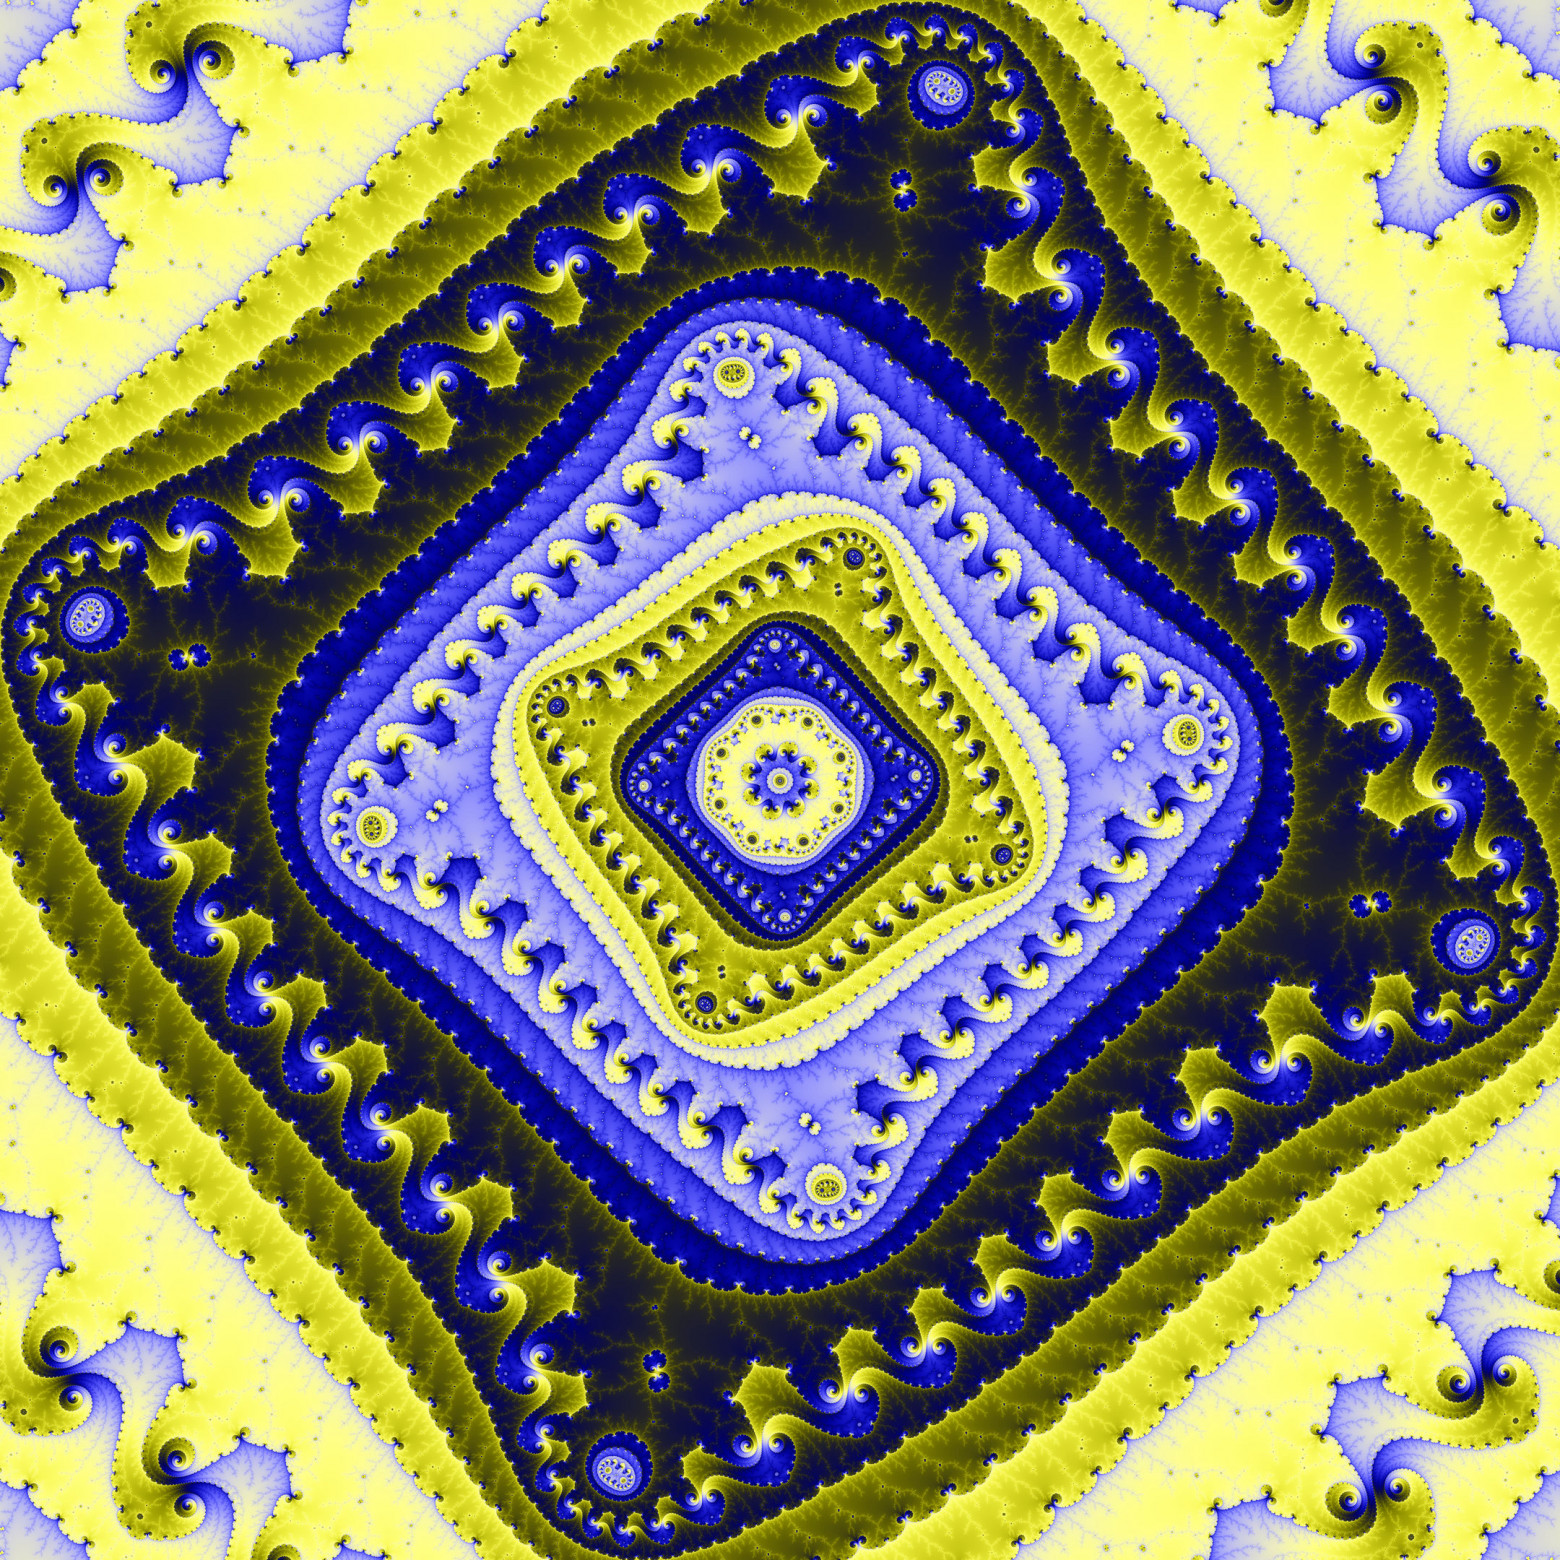

https://commons.wikimedia.org/wiki/File:Mandelbrot_Set_Image_120.png
Re = -0.12702288604303376058504940552835636145639339878096842408417373730142
Im = -0.98728474138900681012772182210671973643707041031463043446236865072278
Width = 6.18e-64
Разрешение 10800 x 10800 пикселей. Время рендеринга 15 часа на процессоре AMD Phenom II X6 1055t (6 ядер).
А третий кажется не выпуклая...
Это что же получается? У меня есть сто двадцать файлов - фрагмент множество Мандельброта. А объемные картины ТОЛЬКО ДВЕ? Ничего себе! "Эти две работы — настоящие жемчужины вашей коллекции"? Надо же!
Поиск красивых фрагментов множества Мандельброта — я этим занимаюсь. «Применение в искусстве» — так называется подраздел в русской википедии https://ru.wikipedia.org/wiki/Множество_Мандельброта#Применение_в_искусстве
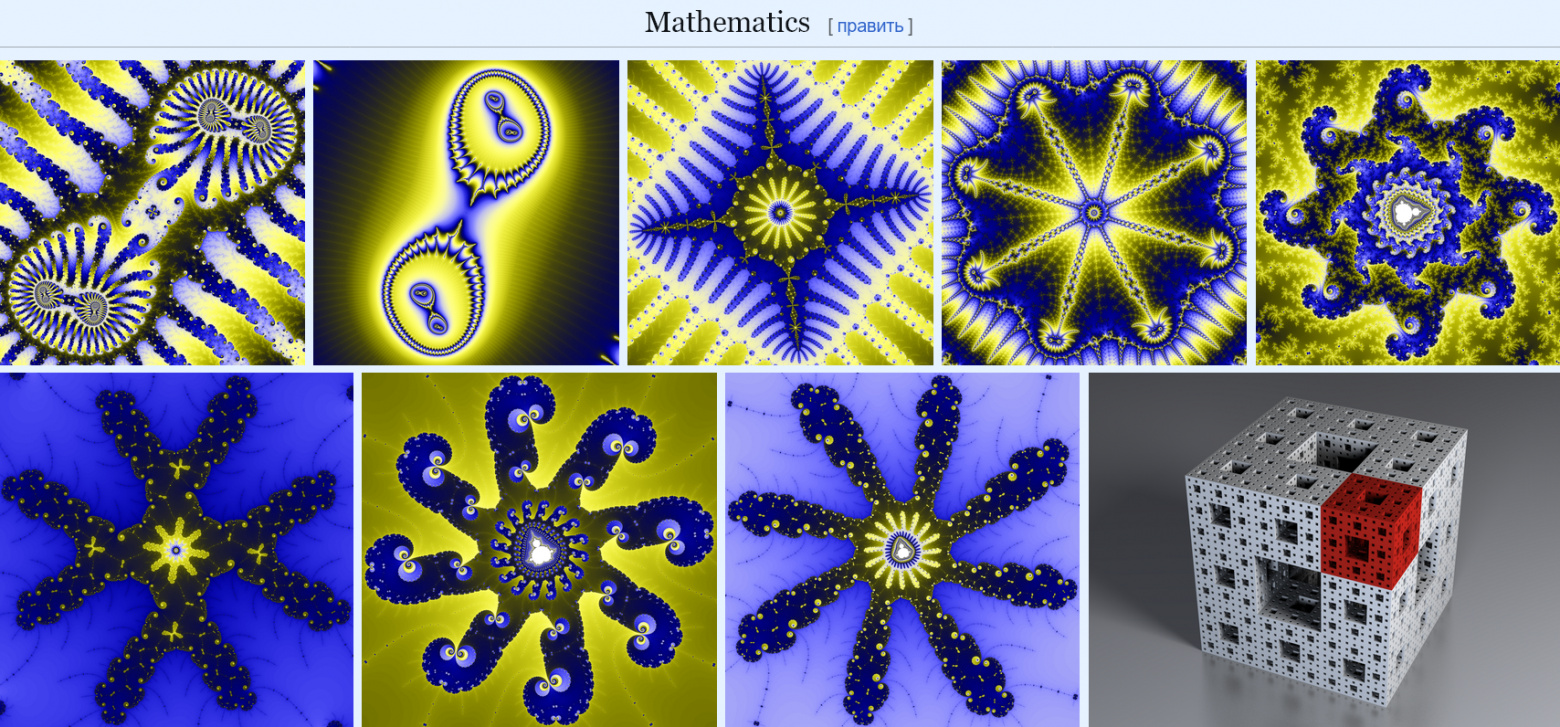
Восемь фракталов множества Мандельброта я создал сам и загрузил на Викисклад. В итоге сообщество Википедии присвоило им статус «избранных изображений» на специальной странице: https://commons.wikimedia.org/wiki/Commons:Featured_pictures/Non‑photographic_media/Computer‑generated#Mathematics Это своего рода «виртуальная выставка» лучших работ проекта. На этой странице сообщество собирает файлы, которые получили наивысшую оценку за свое техническое качество, четкость и художественную ценность. Статус избранного получают лишь около 0,015% от всех загруженных на сайт медиафайлов.
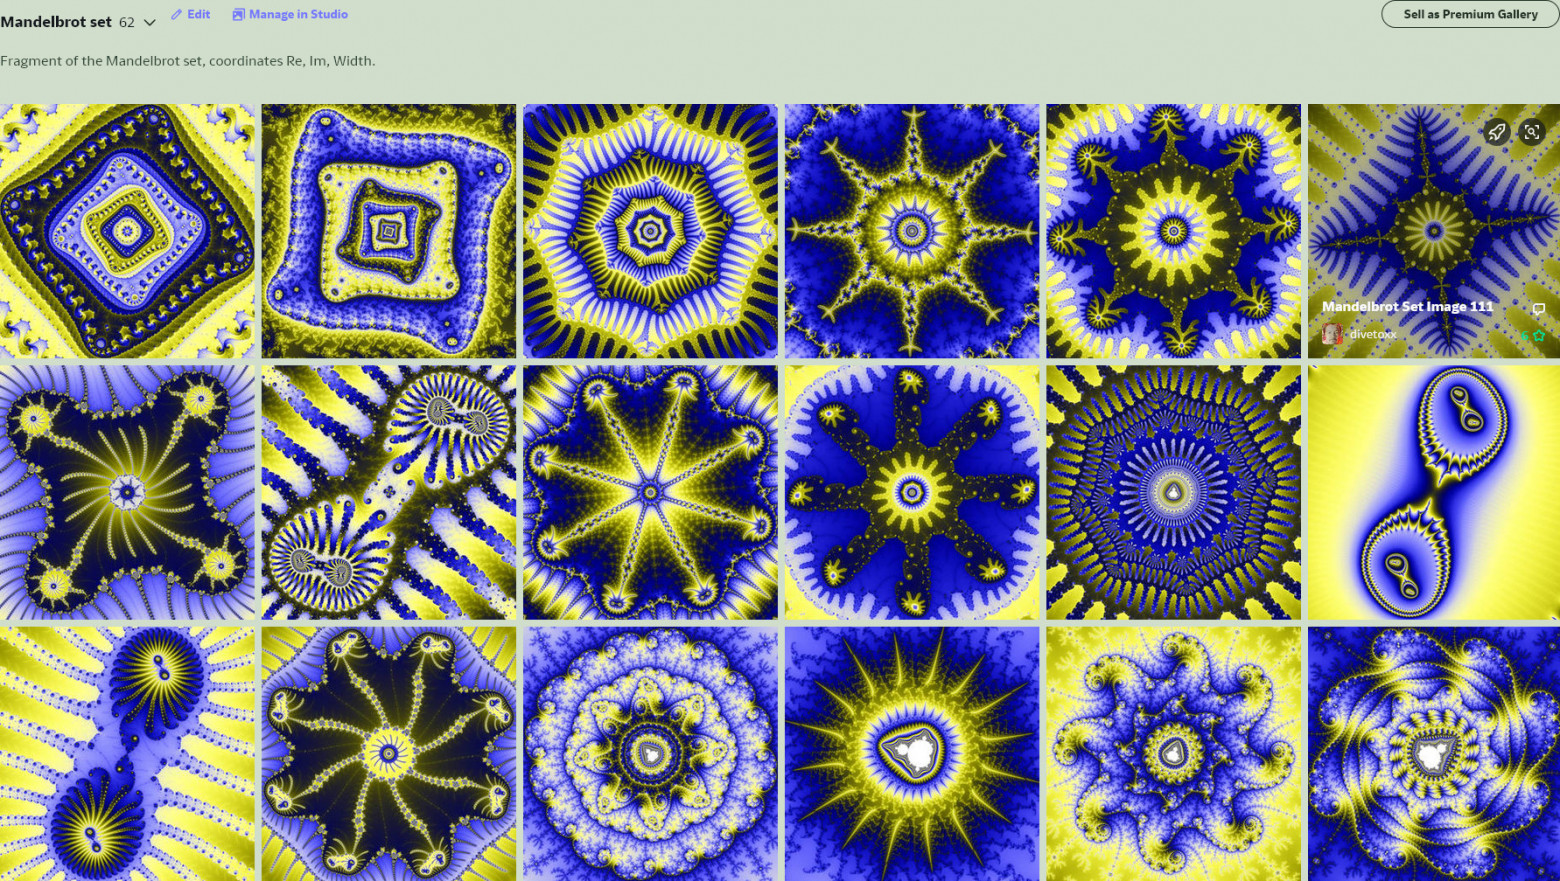
Также я на DeviantART - большое американское онлайн-сообщество художников, представляющее галерею, произведения искусства, фотографию. Я знаю их двадцать лет! https://www.deviantart.com/divetoxx/gallery/102513315/mandelbrot-set
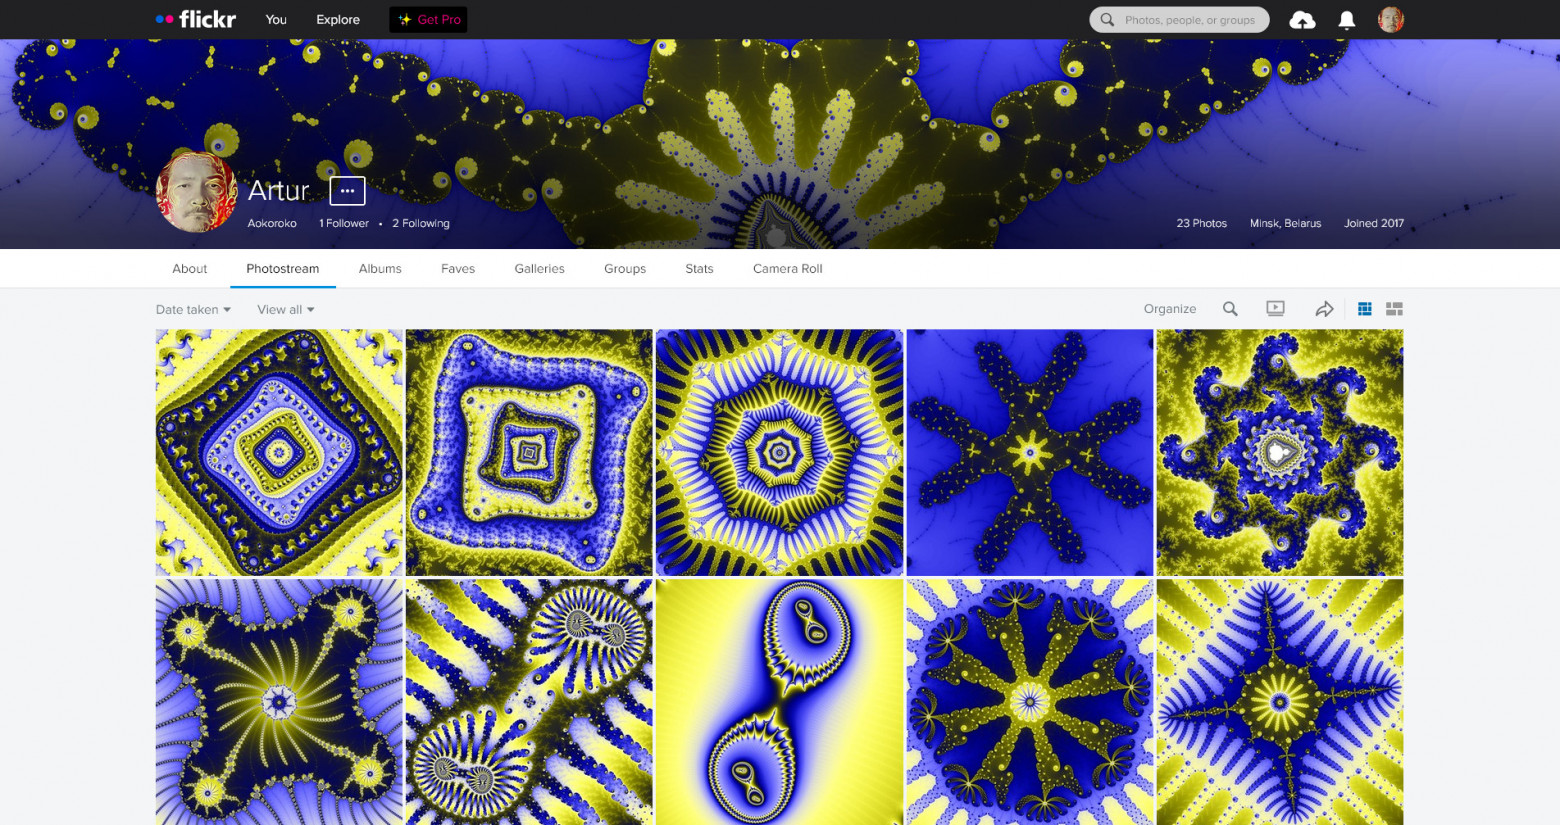
И на Flickr — фотохостинг, предназначенный для хранения цифровых фотографий. Один из самых популярных сайтов для размещения фотографий. https://www.flickr.com/photos/firyulin/
А как это начиналась? Впервые я прочитал о фракталах — 40 лет назад, классе в пятом‑шестом, в журнале «Техника — молодежи». Представим себе числовую последовательность, каждый следующий член который равен квадрату предыдущего члена плюс постоянное слагаемое. Задачка не решается. То есть совсем не решается — аналитически никак нельзя предсказать, ни из каких законов. Поскольку это требует чрезвычайно больших вычислительных затрат. Лишь в семидесятые годы, с появлением компьютеров, возможно стало подступить к проблеме. Это множества Мандельброта, названная по имени Бенуа Мандельброта, первого ее исследователя, самого известного фрактала. И если нанести на плоскость все точки, то получается невообразимо, фантастически сложная фигура. Непонятно, как такое простое уравнение может привести к такой сложной структуре, но это так. Вот можете посмотреть https://web.archive.org/web/20040411222428/http://splushka.narod.ru/fractfaq.htm Это 2004 год! Тогда не было нейросетями!
В 2004 год я писал в Паскале - один из наиболее известных языков программирования, используется для обучения программированию в старших классах.
for y := vert downto 0 do
begin
  temp := ordi - step * (y - vert / 2);
  for x := 0 to horiz do
  begin
    m := absc + step * (x - horiz / 2);
    n := temp;
    c := 0;
    d := 0;
    t := 0;
    repeat
      cc := c * c;
      dd := d * d;
      d := (c + c) * d + n;
      c := cc - dd + m;
      inc(t);
    until (t = 1000) or (cc + dd > 400);
    putpixel(x, y, t);
  end;
end;
«Обыкновенный Паскаль, очень простой язык. Здесь horiz и vert — максимальные координаты дисплея по горизонтали и вертикали (разрешение экрана минус 1 пиксель), absc и ordi — координаты точки на комплексной числовой плоскости, которая будет соответствовать пикселю в центре дисплея, step — расстояние между точками числовой плоскости, положенное нами в соответствие расстоянию между пикселями дисплея (чем меньше step, тем больше увеличение картинки), t — номер члена последовательности (счетчик итераций), c и d — вещественная и мнимая части текущего члена последовательности (стартующие с нуля), а m и n — константа прибавления для текущего пикселя.»
Сейчас я пишу на C++. Чтобы три числа для фрагмента множество Мандельброта и дальше компьютер для разрешение пикселей нужно полный код на языке С++. Это то самое что https://commons.wikimedia.org/wiki/Category:Fractals_created_by_User:_Aokoroko вы смотрите. Исходный код:
#include <atomic>
#include <cmath>
#include <cstdint>
#include <cstdio>
#include <vector>
#include <algorithm>
#include <mpfr.h>
#include <omp.h>
using std::vector;
using std::min;
const char * CENTER_RE = "-1.74919762896578937419423768162729211653261585574161734756645570271259437106847945278504682550816934045282325615313706";
const char * CENTER_IM = "-0.0000004253077715244042272585501215924940115095651514128365051648578746521975467051762910002043554114332125868777767";
const char * VIEW_SIZE = "1.34e-113";
const int WIDTH = 10800;
const int HEIGHT = 10800;
const int AA = 8;
const int MAX_ITER = 500000;
const double ESCAPE_RADIUS_SQUARED = 500000.0;
const int PALETTE_FRAME = 203;
const char * OUTPUT_FILE = "Mandelbrot Set Image 118.bmp";
const mpfr_prec_t PRECISION_BITS = 1000;
const int REF_SIZE = MAX_ITER + 200;
struct Complex {
double re;
double im;
};
#pragma pack(push, 1)
struct BMPHeader {
uint16_t type{0x4D42};
uint32_t size{0};
uint32_t reserved{0};
uint32_t offBits{54};
uint32_t structSize{40};
int32_t width{0};
int32_t height{0};
uint16_t planes{1};
uint16_t bitCount{24};
uint32_t compression{0};
uint32_t sizeImage{0};
int32_t xPixelsPerMeter{2834};
int32_t yPixelsPerMeter{2834};
uint32_t colorsUsed{0};
uint32_t colorsImportant{0};
};
#pragma pack(pop)
int main() {
const double startTime = omp_get_wtime();
const long rawWidth = static_cast<long>(WIDTH) * AA;
const long rawHeight = static_cast<long>(HEIGHT) * AA;
mpfr_t centerRe, centerIm, zReMp, zImMp, tmp1, tmp2, viewSizeMp;
mpfr_inits2(PRECISION_BITS, centerRe, centerIm, zReMp, zImMp, tmp1, tmp2, viewSizeMp, static_cast<mpfr_ptr>(nullptr));
mpfr_set_str(centerRe, CENTER_RE, 10, MPFR_RNDN);
mpfr_set_str(centerIm, CENTER_IM, 10, MPFR_RNDN);
mpfr_set_str(viewSizeMp, VIEW_SIZE, 10, MPFR_RNDN);
const double sampleStep = mpfr_get_d(viewSizeMp, MPFR_RNDN) / rawWidth;
vector<Complex> referenceOrbit;
referenceOrbit.reserve(REF_SIZE);
mpfr_set_ui(zReMp, 0, MPFR_RNDN);
mpfr_set_ui(zImMp, 0, MPFR_RNDN);
for (int iter = 0; iter < REF_SIZE - 1; ++iter) {
Complex z{mpfr_get_d(zReMp, MPFR_RNDN), mpfr_get_d(zImMp, MPFR_RNDN)};
referenceOrbit.push_back(z);
if (z.re * z.re + z.im * z.im > ESCAPE_RADIUS_SQUARED) {
break;
}
mpfr_mul(tmp1, zReMp, zImMp, MPFR_RNDN);
mpfr_sqr(tmp2, zReMp, MPFR_RNDN);
mpfr_sqr(zReMp, zImMp, MPFR_RNDN);
mpfr_sub(zReMp, tmp2, zReMp, MPFR_RNDN);
mpfr_add(zReMp, zReMp, centerRe, MPFR_RNDN);
mpfr_mul_2ui(tmp1, tmp1, 1, MPFR_RNDN);
mpfr_add(zImMp, tmp1, centerIm, MPFR_RNDN);
}
const int referenceLength = static_cast<int>(referenceOrbit.size());
mpfr_clears(centerRe, centerIm, zReMp, zImMp, tmp1, tmp2, viewSizeMp, static_cast<mpfr_ptr>(nullptr));
std::fprintf(stderr, "Reference orbit: %d points\n", referenceLength);
std::fprintf(stderr, "Precomputing skip100 matrices...\n");
vector<Complex> coeff_A(REF_SIZE, {1.0, 0.0});
vector<Complex> coeff_B(REF_SIZE, {0.0, 0.0});
vector<double> rad_R(REF_SIZE, 2.0);
vector<double> aS_squared(REF_SIZE, 0.0);
for (int i = 0; i < referenceLength; ++i) {
double r2 = referenceOrbit[i].re * referenceOrbit[i].re + referenceOrbit[i].im * referenceOrbit[i].im;
aS_squared[i] = (r2 < ESCAPE_RADIUS_SQUARED) ? r2 : 0.0;
}
const int loop_limit = min(static_cast<int>(MAX_ITER), referenceLength - 105);
#pragma omp parallel for
for (int i = 0; i < loop_limit; ++i) {
double min_r2 = ESCAPE_RADIUS_SQUARED;
for (int k = 0; k < 100; ++k) {
if (i + k >= referenceLength) break;
if (aS_squared[i + k] < min_r2) min_r2 = aS_squared[i + k];
}
rad_R[i] = std::sqrt(min_r2);
for (int k = 0; k < 100; ++k) {
if (i + k >= referenceLength) break;
double r_re = referenceOrbit[i + k].re;
double r_im = referenceOrbit[i + k].im;
double next_A_re = 2.0 * (r_re * coeff_A[i].re - r_im * coeff_A[i].im);
double next_A_im = 2.0 * (r_re * coeff_A[i].im + r_im * coeff_A[i].re);
double next_B_re = 2.0 * (r_re * coeff_B[i].re - r_im * coeff_B[i].im) + 1.0;
double next_B_im = 2.0 * (r_re * coeff_B[i].im + r_im * coeff_B[i].re);
coeff_A[i].re = next_A_re; coeff_A[i].im = next_A_im;
coeff_B[i].re = next_B_re; coeff_B[i].im = next_B_im;
}
}
const double PI = 3.14159265358979323846;
uint8_t palette[256][3];
for (int i = 0; i < 255; ++i) {
palette[i][0] = static_cast<uint8_t>(std::lround(127.0 + 127.0 * std::cos(2.0 * PI * i / 255.0)));
palette[i][1] = static_cast<uint8_t>(std::lround(127.0 + 127.0 * std::sin(2.0 * PI * i / 255.0)));
palette[i][2] = palette[i][1];
}
palette[255][0] = 255; palette[255][1] = 255; palette[255][2] = 255;
const int rowBytes = (WIDTH * 3 + 3) & ~3;
vector<uint8_t> image(static_cast<size_t>(rowBytes) * HEIGHT, 0);
std::atomic<int> completedRows{0};
const Complex * reference = referenceOrbit.data();
#pragma omp parallel for schedule(dynamic)
for (int y = 0; y < HEIGHT; ++y) {
uint8_t * row = image.data() + static_cast<size_t>(y) * rowBytes;
for (int x = 0; x < WIDTH; ++x) {
unsigned blueSum = 0; unsigned greenSum = 0; unsigned redSum = 0;
for (int sampleY = 0; sampleY < AA; ++sampleY) {
const double deltaCIm = (static_cast<long>(y) * AA + sampleY - rawHeight / 2) * sampleStep;
for (int sampleX = 0; sampleX < AA; ++sampleX) {
const double deltaCRe = (static_cast<long>(x) * AA + sampleX - rawWidth / 2) * sampleStep;
double deltaRe = 0.0; double deltaIm = 0.0;
double zRe = 0.0; double zIm = 0.0;
int referenceIndex = 0;
int iter = 0;
while (iter < MAX_ITER) {
if (zRe * zRe + zIm * zIm >= ESCAPE_RADIUS_SQUARED) {
break;
}
double eps_abs2 = deltaRe * deltaRe + deltaIm * deltaIm;
double limit_r2 = 1e-30 * rad_R[referenceIndex] * rad_R[referenceIndex];
if (eps_abs2 < limit_r2 && (referenceIndex + 100 < loop_limit) && (iter + 100 < MAX_ITER)) {
double backup_deltaRe = deltaRe; double backup_deltaIm = deltaIm;
int backup_refIdx = referenceIndex; int backup_iter = iter;
double next_eps_re = (coeff_A[referenceIndex].re * deltaRe - coeff_A[referenceIndex].im * deltaIm) +
(coeff_B[referenceIndex].re * deltaCRe - coeff_B[referenceIndex].im * deltaCIm);
double next_eps_im = (coeff_A[referenceIndex].re * deltaIm + coeff_A[referenceIndex].im * deltaRe) +
(coeff_B[referenceIndex].re * deltaCIm + coeff_B[referenceIndex].im * deltaCRe);
deltaRe = next_eps_re; deltaIm = next_eps_im;
referenceIndex += 100; iter += 100;
zRe = reference[referenceIndex].re + deltaRe;
zIm = reference[referenceIndex].im + deltaIm;
if (zRe * zRe + zIm * zIm >= ESCAPE_RADIUS_SQUARED) {
deltaRe = backup_deltaRe; deltaIm = backup_deltaIm;
referenceIndex = backup_refIdx; iter = backup_iter;
} else {
continue;
}
}
const double a = 2.0 * reference[referenceIndex].re + deltaRe;
const double b = 2.0 * reference[referenceIndex].im + deltaIm;
const double nextDeltaRe = a * deltaRe - b * deltaIm + deltaCRe;
deltaIm = a * deltaIm + b * deltaRe + deltaCIm;
deltaRe = nextDeltaRe;
++referenceIndex; ++iter;
zRe = reference[referenceIndex].re + deltaRe;
zIm = reference[referenceIndex].im + deltaIm;
if (zRe * zRe + zIm * zIm < deltaRe * deltaRe + deltaIm * deltaIm || referenceIndex >= loop_limit) {
deltaRe = zRe; deltaIm = zIm; referenceIndex = 0;
}
}
const int remaining = MAX_ITER - iter;
const uint8_t colorIndex = (remaining == 0) ? 255 : static_cast<uint8_t>(remaining % 254);
const int paletteIndex = (colorIndex == 255) ? 255 : (colorIndex - PALETTE_FRAME + 255) % 255;
blueSum += palette[paletteIndex][0];
greenSum += palette[paletteIndex][1];
redSum += palette[paletteIndex][2];
}
}
const int samples = AA * AA;
row[x * 3 + 0] = static_cast<uint8_t>(blueSum / samples);
row[x * 3 + 1] = static_cast<uint8_t>(greenSum / samples);
row[x * 3 + 2] = static_cast<uint8_t>(redSum / samples);
}
const int done = ++completedRows;
if (done % 50 == 0 || done == HEIGHT) {
std::fprintf(stderr, "\rProgress: %d/%d rows (%.1f%%)", done, HEIGHT, 100.0 * done / HEIGHT);
#pragma omp critical(disk_flush)
{
BMPHeader live_header;
live_header.width = WIDTH;
live_header.height = HEIGHT;
live_header.sizeImage = static_cast<uint32_t>(image.size());
live_header.size = live_header.sizeImage + 54;
FILE * live_file = std::fopen(OUTPUT_FILE, "wb");
if (live_file) {
std::fwrite(&live_header, sizeof(live_header), 1, live_file);
std::fwrite(image.data(), 1, image.size(), live_file);
std::fflush(live_file);
std::fclose(live_file);
}
}
}
}
std::fprintf(stderr, "\nDone! Final file secured in %s (Total time: %.2f seconds).\n", OUTPUT_FILE, omp_get_wtime() - startTime);
return 0;
}
Компилятор g++: D:\msys64\ucrt64\bin\g++ -O3 main.cpp -o “Mandelbrot.exe” -fopenmp -lmpfr -lgmp -static -march=native
Вот. Разберем. Если артефакты билинейную аппроксимацию, то сделайте не 1e-30 а 1e-60 в double limit_r2 =
CENTER_RE и CENTER_IM и VIEW_SIZE это числа множества Мандельброта.
WIDTH и HEIGHT это разрешение пикселей.
Во-первых - теория возмущений (Perturbation Theory). Сверхтяжелый BigFloat-радар MPFR вычисляет точную траекторию всего для одной-единственной центральной точки и строго ОДИН раз. Весь остальной массив экрана (миллиарда супер-пикселей) рассчитывается параллельно на бешеной скорости чистых, аппаратных регистров double процессора, вычисляя лишь микроскопические отклонения (дельты) от центральной оси.
Во-вторых - расчет можно выполнить существенно быстрее, если использовать билинейную аппроксимацию (BLA Skip-100). Код предварительно рассчитывает матрицы трансформации коэффициентов для шагов по 100 итераций. Если текущая точка находится достаточно близко к опорной орбите, алгоритм «перепрыгивает» сразу 100 итераций за один математический шаг, минимизируя нагрузку на CPU.
Динамический сброс в ноль (Dynamic Reset to Zero): На каждом шаге для каждого пикселя отслеживается соотношение его абсолютных координат и текущего отклонения (дельты). Если дельта уходит слишком далеко или основная опорная орбита завершается, поток вычислений динамически сбрасывает индекс отслеживания в ноль. Это превращает накопленные координаты в новое автономное начало отсчета и полностью устраняет артефакты точности.
Оптимизация цикла «На один шаг за предел ухода» (One-Step Beyond Escape Loop Optimization): Чтобы выжать максимум производительности из CPU, трекер опорной орбиты MPFR записывает ровно одну дополнительную точку в массив орбиты сразу после того, как она превышает радиус ухода (escape radius). Такое точное определение границы гарантирует безупречное перебазирование орбиты.
Оптимизация ветвлений в глубоком цикле (Deep Loop Branch Optimization): Эта элегантная структура кода существенно упрощает условия внутри самого глубокого цикла итераций. Минимизируя тяжелые ветвления и избегая сложных вложенных условий там, где это возможно, код повышает эффективность предсказателя ветвлений процессора и позволяет конвейеру CPU выполнять базовые математические расчеты с максимальной пропускной способностью.
Конечно я теперь делаю настоящий SSAA 8×8=64 для идеально сглаженного изображения. Суперсэмплинг (Super‑Sampling Anti‑Aliasing) — ресурсоемкий метод сглаживания, увеличивающий число выборок на пиксель для повышения качества изображения. При значении 8x (N=8) сцена рендерится в разрешении, в 8 раз превышающем целевое, по обеим осям, создавая 64 (или 8 х 8) выборки на пиксель. Изображение просчитывается в более высоком разрешении, а затем принудительно уменьшается.
Многопоточность (OpenMP). Параллельный расчет строк изображения на всех доступных ядрах процессора с динамическим планированием. OpenMP - это стандарт, который говорит компилятору: "Возьми этот цикл и сам раздай итерации разным ядрам процессора". OpenMP - масштабируемость: ваш код будет одинаково эффективно работать как на 4-ядерном ноутбуке, так и на 128-ядерном сервере.
Про цветных версий — красный, зеленый и синий каналы рассчитываются с использованием синусоидальных и косинусоидальных волн:
pal[a][0] = (uint8_t)round(127.0 + 127.0 * cos(2.0 * PI * a / 255.0)); // Blue
pal[a][1] = (uint8_t)round(127.0 + 127.0 * sin(2.0 * PI * a / 255.0)); // Green
pal[a][2] = (uint8_t)round(127.0 + 127.0 * sin(2.0 * PI * a / 255.0)); // Red
Смены цветов может быть до 255 и поэтому нужно выбрать одно, какое:
const int PALETTE_FRAME = 203;Но как именно три числа для фрагмента множество Мандельброта? Какие числа? Поиск красивых фрагментов множества Мандельброта - как? И вот для этого надо другую программу! Можно посмотреть на https://github.com/Divetoxx/Mandelbrot-2#russian
Это графический интерфейс Мандельброта!
        if (current_binary_exp > -244) {
            limit_epsilon_squared = 1e-30;
        } else {
            limit_epsilon_squared = 1e-60;
        }
Здесь уже была заложена гениальная автоматическая проверка масштаба - когда 1e-30 а когда 1e-60. И это двоичный порядок -244 а в нашу стандартную десятичную это -74. Меньше -74 - 1e-30 а больше - 1e-60.
SSAA 2x2 а не 8x8. Понятно почему.
Многопоточность на чистом C++11! Параллельные вычисления, встроенные напрямую в стандарт языка а не в OpenMP!
Движок обеспечивает идеальную визуальную плавность за счет прямой синхронизации с диспетчером окон рабочего стола Windows (DWM). Если ваш монитор настроен на 60 Гц, вы получите 60 кадров в секунду. Если вы используете игровой монитор с частотой 144 Гц, функция срабатывает 144 раза в секунду, обеспечивая 144 кадра в секунду. На высококачественных дисплеях с частотой 240 Гц вы увидите плавную картинку со скоростью 240 кадров в секунду.
Приложение использует технику циклической смены цветов (вращение палитры). Хотя основная математическая обработка выполняется один раз, цветовая схема непрерывно <вращается> в специальном фоновом потоке. Это создает <живой> фрактальный эффект, позволяющий бесконечно наблюдать за изменением цветов без дополнительной нагрузки на процессор.
Самое главное - управление мышью! WM_LBUTTONDOWN (Левая кнопка) - увеличиваем масштаб в 2 раза и центрируем новую область вокруг точки клика. WM_RBUTTONDOWN (Правая кнопка) - уменьшаем масштаб в 2 раза и центрируем новую область вокруг точки клика.
И очень важно VK_RETURN (Enter, Ввод) - у вас сейчас на экран какое-то Множество Мандельброта. И сейчас оно запишется в файл! Mandelbrot.txt. Файл должен содержать три числа, разделенных переносом строки: координата X центра, координата Y центра, ширина области. То есть то самое Re, Im и Width!
А VK_BACK (это та самая клавиша НАД Enter, Backspace) - читает Mandelbrot.txt (читаем три строки из файла) и запускает на экран.
Вот полный код на языке С++:
#ifndef UNICODE
#define UNICODE
#endif
#include <windows.h>
#include <dwmapi.h>
#include <vector>
#include <cmath>
#include <thread>
#include <mutex>
#include <atomic>
#include <fstream>
#include <string>
#include <iostream>
#include <iomanip>
#include <gmp.h>
#include <mpfr.h>
const int WIDTH = 1000;
const int HEIGHT = 1000;
const int SS_W = 2000;
const int SS_H = 2000;
const int PALETTE_SIZE = 1024;
const mpfr_prec_t MPFR_BITS = 1000;
struct FractalParams {
double step_d;
std::string center_re_str;
std::string center_im_str;
std::string size_str;
uint32_t iter_max;
};
struct ComplexDouble {
double re;
double im;
};
std::mutex g_params_mutex;
FractalParams g_params;
std::atomic<bool> g_abort{false};
HANDLE g_render_event;
uint32_t g_ss_buffer[SS_W * SS_H];
void generate_full_palette(RGBQUAD* pal) {
const double pi = 3.141592653589793;
for (int i = 0; i < PALETTE_SIZE; i++) {
double angle = (2.0 * pi * i) / (double)PALETTE_SIZE;
pal[i].rgbRed = (uint8_t)(127.0 + 127.0 * std::sin(angle * 4));
pal[i].rgbBlue = (uint8_t)(127.0 + 127.0 * std::cos(angle * 4));
pal[i].rgbGreen = (uint8_t)(127.0 + 127.0 * std::sin(angle * 4));
pal[i].rgbReserved = 0;
}
}


void thread_palette_rotator(HDC hdc_win, HDC hdc_m, RGBQUAD* pixels) {
    RGBQUAD pal[PALETTE_SIZE];
    generate_full_palette(pal);
    std::vector<RGBQUAD> color_cache(500001);
    float offset = 0;

    unsigned int num_threads = std::thread::hardware_concurrency();
    if (num_threads == 0) num_threads = 4;

    while (true) {
        for (int i = 0; i <= 500000; ++i) {
            if (i >= 500000) {
                color_cache[i] = {255, 255, 255, 0};
            } else {
                int idx = (int)(500000 - i + (int)offset) % PALETTE_SIZE;
                if (idx < 0) idx += PALETTE_SIZE;
                color_cache[i] = pal[idx];
            }
        }

        std::atomic<int> current_y{0};
        std::vector<std::thread> workers;
        workers.reserve(num_threads);

        for (unsigned int t = 0; t < num_threads; ++t) {
            workers.emplace_back([&]() {
                while (true) {
                    int y = current_y++;
                    if (y >= HEIGHT) break;

                    for (int x = 0; x < WIDTH; ++x) {
                        uint32_t i0 = g_ss_buffer[(y * 2 + 0) * SS_W + (x * 2 + 0)];
                        uint32_t i1 = g_ss_buffer[(y * 2 + 0) * SS_W + (x * 2 + 1)];
                        uint32_t i2 = g_ss_buffer[(y * 2 + 1) * SS_W + (x * 2 + 0)];
                        uint32_t i3 = g_ss_buffer[(y * 2 + 1) * SS_W + (x * 2 + 1)];

                        RGBQUAD c0 = color_cache[i0];
                        RGBQUAD c1 = color_cache[i1];
                        RGBQUAD c2 = color_cache[i2];
                        RGBQUAD c3 = color_cache[i3];

                        uint32_t r = (uint32_t)c0.rgbRed   + c1.rgbRed   + c2.rgbRed   + c3.rgbRed;
                        uint32_t g = (uint32_t)c0.rgbGreen + c1.rgbGreen + c2.rgbGreen + c3.rgbGreen;
                        uint32_t b = (uint32_t)c0.rgbBlue  + c1.rgbBlue  + c2.rgbBlue  + c3.rgbBlue;

                        int pix_idx = y * WIDTH + x;
                        pixels[pix_idx].rgbRed   = (uint8_t)(r >> 2);
                        pixels[pix_idx].rgbGreen = (uint8_t)(g >> 2);
                        pixels[pix_idx].rgbBlue  = (uint8_t)(b >> 2);
                        pixels[pix_idx].rgbReserved = 0;
                    }
                }
            });
        }

        for (auto &worker : workers) {
            if (worker.joinable()) worker.join();
        }

        offset -= 1.0f;
        if (offset < 0) offset += PALETTE_SIZE;
        BitBlt(hdc_win, 0, 0, WIDTH, HEIGHT, hdc_m, 0, 0, SRCCOPY);
        DwmFlush();
    }
}


void thread_mandelbrot_calc() {
    std::vector<ComplexDouble> ref_orbit_double;
    std::vector<ComplexDouble> coeff_A;
    std::vector<ComplexDouble> coeff_B;
    std::vector<double> rad_R;

    unsigned int num_threads = std::thread::hardware_concurrency();
    if (num_threads == 0) num_threads = 4;

    while (true) {
        WaitForSingleObject(g_render_event, INFINITE);
        ResetEvent(g_render_event);
        g_abort = false;
        FractalParams p;
        { std::lock_guard<std::mutex> lock(g_params_mutex); p = g_params; }

        mpfr_t rx, ry, zr, zi, zr2, zi2, tmp, sz, st;
        mpfr_inits2(MPFR_BITS, rx, ry, zr, zi, zr2, zi2, tmp, sz, st, NULL);
        mpfr_set_str(rx, p.center_re_str.c_str(), 10, MPFR_RNDN);
        mpfr_set_str(ry, p.center_im_str.c_str(), 10, MPFR_RNDN);
        mpfr_set_str(sz, p.size_str.c_str(), 10, MPFR_RNDN);
        mpfr_div_ui(st, sz, SS_W, MPFR_RNDN);

        uint32_t allocated_size = p.iter_max + 200;
        ref_orbit_double.clear();
        ref_orbit_double.reserve(allocated_size);
        coeff_A.assign(allocated_size, {1.0, 0.0});
        coeff_B.assign(allocated_size, {0.0, 0.0});
        rad_R.assign(allocated_size, 2.0);

        mpfr_set_ui(zr, 0, MPFR_RNDN);
        mpfr_set_ui(zi, 0, MPFR_RNDN);
        mpfr_set_ui(zr2, 0, MPFR_RNDN);
        mpfr_set_ui(zi2, 0, MPFR_RNDN);

        for (uint32_t iter = 0; iter < allocated_size - 1; ++iter) {
            ComplexDouble z{mpfr_get_d(zr, MPFR_RNDN), mpfr_get_d(zi, MPFR_RNDN)};
            ref_orbit_double.push_back(z);
            mpfr_mul(tmp, zr, zi, MPFR_RNDN);
            mpfr_mul_ui(zi, tmp, 2, MPFR_RNDN);
            mpfr_add(zi, zi, ry, MPFR_RNDN);
            mpfr_sub(zr, zr2, zi2, MPFR_RNDN);
            mpfr_add(zr, zr, rx, MPFR_RNDN);
            mpfr_mul(zr2, zr, zr, MPFR_RNDN);
            mpfr_mul(zi2, zi, zi, MPFR_RNDN);
            mpfr_add(tmp, zr2, zi2, MPFR_RNDN);
            if (mpfr_cmp_d(tmp, 4000.0) >= 0) {
                break;
            }
        }
        ref_orbit_double.push_back({mpfr_get_d(zr, MPFR_RNDN), mpfr_get_d(zi, MPFR_RNDN)});
        uint32_t max_valid_ref_iter = static_cast<uint32_t>(ref_orbit_double.size());

        double ref_rec_d = mpfr_get_d(rx, MPFR_RNDN);
        double ref_imc_d = mpfr_get_d(ry, MPFR_RNDN);
        double ss_step_d = p.step_d;
        double limit_epsilon_squared;

        mpfr_exp_t current_binary_exp = mpfr_get_exp(st);
        if (current_binary_exp > -244) {
            limit_epsilon_squared = 1e-30;
        } else {
            limit_epsilon_squared = 1e-60;
        }
        mpfr_clears(rx, ry, zr, zi, zr2, zi2, tmp, sz, st, NULL);

        std::vector<double> aS_squared(max_valid_ref_iter, 0.0);
        for (size_t i = 0; i < max_valid_ref_iter; ++i) {
            double r2 = ref_orbit_double[i].re * ref_orbit_double[i].re + ref_orbit_double[i].im * ref_orbit_double[i].im;
            aS_squared[i] = (r2 < 4.0) ? r2 : 0.0;
        }

        const int loop_limit = std::min(static_cast<int>(p.iter_max), static_cast<int>(max_valid_ref_iter) - 105);

        {
            std::atomic<int> current_i{0};
            std::vector<std::thread> BLA_workers;
            BLA_workers.reserve(num_threads);

            for (unsigned int t = 0; t < num_threads; ++t) {
                BLA_workers.emplace_back([&]() {
                    while (true) {
                        int i = current_i++;
                        if (i >= loop_limit) break;

                        double min_r2 = 4.0;
                        for (int k = 0; k < 100; ++k) {
                            if (i + k >= (int)max_valid_ref_iter) break;
                            if (aS_squared[i + k] < min_r2) min_r2 = aS_squared[i + k];
                        }
                        rad_R[i] = std::sqrt(min_r2);

                        for (int k = 0; k < 100; ++k) {
                            if (i + k >= (int)max_valid_ref_iter) break;
                            double r_re = ref_orbit_double[i + k].re;
                            double r_im = ref_orbit_double[i + k].im;
                            double next_A_re = 2.0 * (r_re * coeff_A[i].re - r_im * coeff_A[i].im);
                            double next_A_im = 2.0 * (r_re * coeff_A[i].im + r_im * coeff_A[i].re);
                            double next_B_re = 2.0 * (r_re * coeff_B[i].re - r_im * coeff_B[i].im) + 1.0;
                            double next_B_im = 2.0 * (r_re * coeff_B[i].im + r_im * coeff_B[i].re);
                            coeff_A[i].re = next_A_re; coeff_A[i].im = next_A_im;
                            coeff_B[i].re = next_B_re; coeff_B[i].im = next_B_im;
                        }
                    }
                });
            }
            for (auto &worker : BLA_workers) {
                if (worker.joinable()) worker.join();
            }
        }

        const ComplexDouble* ref_ptr = ref_orbit_double.data();

        {
            std::atomic<int> current_ss_y{0};
            std::vector<std::thread> render_workers;
            render_workers.reserve(num_threads);

            for (unsigned int t = 0; t < num_threads; ++t) {
                render_workers.emplace_back([&]() {
                    while (true) {
                        int ss_y = current_ss_y++;
                        if (ss_y >= SS_H || g_abort) break;

                        for (int ss_x = 0; ss_x < SS_W; ++ss_x) {
                            double delta_rec = (double)(ss_x - (SS_W / 2)) * ss_step_d;
                            double delta_imc = (double)((SS_H / 2) - ss_y) * ss_step_d;
                            uint32_t index = 0;
                            double delta_re = 0.0;
                            double delta_im = 0.0;
                            double z_re = 0.0;
                            double z_im = 0.0;
                            uint32_t i = 0;
                            bool has_re_based = false;

                            while (i < p.iter_max) {
                                if ((z_re * z_re + z_im * z_im) >= 4000.0) {
                                    break;
                                }
                                if (index >= max_valid_ref_iter) {
                                    if (!has_re_based) {
                                        break;
                                    } else {
                                        double ld_cx = ref_rec_d + delta_rec;
                                        double ld_cy = ref_imc_d - delta_imc;
                                        while (i < p.iter_max && (z_re * z_re + z_im * z_im) < 4000.0) {
                                            double old_re = z_re;
                                            double old_im = z_im;
                                            z_re = old_re * old_re - old_im * old_im + ld_cx;
                                            z_im = 2.0 * old_re * old_im + ld_cy;
                                            i++;
                                        }
                                        break;
                                    }
                                }

                                double eps_abs2 = delta_re * delta_re + delta_im * delta_im;
                                double limit_r2 = limit_epsilon_squared * rad_R[index] * rad_R[index];

                                if (eps_abs2 < limit_r2 && (i + 100 < p.iter_max)) {
                                    double backup_deltaRe = delta_re; double backup_deltaIm = delta_im;
                                    int backup_refIdx = index;
                                    int backup_iter = i;
                                    double next_eps_re = (coeff_A[index].re * delta_re - coeff_A[index].im * delta_im) +
                                                         (coeff_B[index].re * delta_rec - coeff_B[index].im * delta_imc);
                                    double next_eps_im = (coeff_A[index].re * delta_im + coeff_A[index].im * delta_re) +
                                                         (coeff_B[index].re * delta_imc + coeff_B[index].im * delta_rec);
                                    delta_re = next_eps_re; delta_im = next_eps_im;
                                    index += 100; i += 100;
                                    z_re = ref_ptr[index].re + delta_re;
                                    z_im = ref_ptr[index].im + delta_im;
                                    if (z_re * z_re + z_im * z_im >= 4000.0) {
                                        delta_re = backup_deltaRe; delta_im = backup_deltaIm;
                                        index = backup_refIdx; i = backup_iter;
                                    } else {
                                        continue;
                                    }
                                }

                                if ((z_re * z_re + z_im * z_im) < eps_abs2) {
                                    index = 0;
                                    delta_re = z_re;
                                    delta_im = z_im;
                                    has_re_based = true;
                                }
const double aa = 2.0 * ref_ptr[index].re + delta_re;
const double bb = 2.0 * ref_ptr[index].im + delta_im;
const double nextDeltaRe = aa * delta_re - bb * delta_im + delta_rec;
delta_im = aa * delta_im + bb * delta_re + delta_imc;
delta_re = nextDeltaRe;
index++;
i++;
z_re = ref_ptr[index].re + delta_re;
z_im = ref_ptr[index].im + delta_im;
}
g_ss_buffer[ss_y * SS_W + ss_x] = i;
}
}
});
}
for (auto &worker : render_workers) {
if (worker.joinable()) worker.join();
}
}
}
}

LRESULT CALLBACK wnd_proc(HWND hwnd, UINT msg, WPARAM wp, LPARAM lp) {
switch (msg) {
case WM_LBUTTONDOWN:
case WM_RBUTTONDOWN: {
g_abort = true;
std::lock_guard<std::mutex> lock(g_params_mutex);
mpfr_t cx, cy, sz, st, mx, my, clicked_x, clicked_y;
mpfr_inits2(MPFR_BITS, cx, cy, sz, st, mx, my, clicked_x, clicked_y, NULL);
mpfr_set_str(cx, g_params.center_re_str.c_str(), 10, MPFR_RNDN);
mpfr_set_str(cy, g_params.center_im_str.c_str(), 10, MPFR_RNDN);
mpfr_set_str(sz, g_params.size_str.c_str(), 10, MPFR_RNDN);
mpfr_div_ui(st, sz, SS_W, MPFR_RNDN);
double mouse_x_d = (double)((short)LOWORD(lp));
double mouse_y_d = (double)((short)HIWORD(lp));
double ss_mouse_x = mouse_x_d * 2.0;
double ss_mouse_y = mouse_y_d * 2.0;
mpfr_set_d(mx, ss_mouse_x - (double)(SS_W / 2), MPFR_RNDN);
mpfr_set_d(my, (double)(SS_H / 2) - ss_mouse_y, MPFR_RNDN);
mpfr_mul(mx, mx, st, MPFR_RNDN);
mpfr_mul(my, my, st, MPFR_RNDN);
mpfr_add(clicked_x, cx, mx, MPFR_RNDN);
mpfr_add(clicked_y, cy, my, MPFR_RNDN);
if (msg == WM_LBUTTONDOWN) {
mpfr_div_ui(sz, sz, 2, MPFR_RNDN);
} else {
mpfr_mul_ui(sz, sz, 2, MPFR_RNDN);
}
mpfr_div_ui(st, sz, SS_W, MPFR_RNDN);
g_params.step_d = mpfr_get_d(st, MPFR_RNDN);
char out_x[2048], out_y[2048], out_sz[2048];
mpfr_snprintf(out_x, sizeof(out_x), "%.300Rf", clicked_x);
mpfr_snprintf(out_y, sizeof(out_y), "%.300Rf", clicked_y);
mpfr_snprintf(out_sz, sizeof(out_sz), "%.300Rf", sz);
g_params.center_re_str = out_x;
g_params.center_im_str = out_y;
g_params.size_str = out_sz;
mpfr_clears(cx, cy, sz, st, mx, my, clicked_x, clicked_y, NULL);
SetEvent(g_render_event);
return 0;
}
case WM_KEYDOWN: {
if (wp >= '1' && wp <= '8') {
g_abort = true;
std::lock_guard<std::mutex> lock(g_params_mutex);
if (wp == '1') {
g_params.center_re_str = "-1.74907816150520173167912454515663360420734509948112463480292338384";
g_params.center_im_str = "-0.00000550991906629096602513098567268615714673236269915508056068145";
g_params.size_str  = "1.53e-62";
}
if (wp == '2') {
g_params.center_re_str = "-1.7489436617686633372073552153211507258063533373824414679761";
g_params.center_im_str = "-0.0000073748967541889836640985849393311615399776865199722997";
g_params.size_str  = "1.01e-55";
}
if (wp == '3') {
g_params.center_re_str = "-1.7491311840575335110236048528001036247123430447933925298694915282522178938437759580179";
g_params.center_im_str = "-0.0001996960702541036804654299663680287246637758588467627907752429037173153157138373325";
g_params.size_str  = "2.84e-82";
}
if (wp == '4') {
g_params.center_re_str = "-1.74994586497557459407526067070055710001";
g_params.center_im_str = "-0.0000000852088539604644334731909824511";
g_params.size_str  = "7.17e-36";
}
if (wp == '5') {
g_params.center_re_str = "-1.267078059171397835210199054200436920994876769284288837862647";
g_params.center_im_str = "-0.123788215196292957558264285607075473360968832625384429809391";
g_params.size_str  = "2.4e-57";
}
if (wp == '6') {
g_params.center_re_str = "-1.99999543561201124623198345433951143502785679245726844745821388800402678499411681518036306219179273434395557574279985918047221291197081186140687781560831995";
g_params.center_im_str = "-0.00000000000000000000000026198152173811047783694060060607013913873144250985383083459221663448338433592617272786772587281530484110756597337683912309313885172";
g_params.size_str  = "1.15e-119";
}
if (wp == '7') {
g_params.center_re_str = "-0.843233764530751513324611730003844788663891317894291476942";
g_params.center_im_str = "0.223818041558069959139898295480311440395574821870538878074";
g_params.size_str  = "2.66e-52";
}
if (wp == '8') {
g_params.center_re_str = "-0.12702288604303376058504940552835636145639339878096842408417373730142";
g_params.center_im_str = "-0.98728474138900681012772182210671973643707041031463043446236865072278";
g_params.size_str  = "6.18e-64";
}
mpfr_t sz, st;
mpfr_inits2(MPFR_BITS, sz, st, NULL);
mpfr_set_str(sz, g_params.size_str.c_str(), 10, MPFR_RNDN);
mpfr_div_ui(st, sz, SS_W, MPFR_RNDN);
g_params.step_d = mpfr_get_d(st, MPFR_RNDN);
mpfr_clears(sz, st, NULL);
SetEvent(g_render_event);
return 0;
}
if (wp == VK_UP || wp == VK_DOWN) {
g_abort = true;
std::lock_guard<std::mutex> lock(g_params_mutex);
mpfr_t sz, st;
mpfr_inits2(MPFR_BITS, sz, st, NULL);
mpfr_set_str(sz, g_params.size_str.c_str(), 10, MPFR_RNDN);
if (wp == VK_UP) {
mpfr_div_d(sz, sz, 1.05, MPFR_RNDN);
}
else if (wp == VK_DOWN) {
mpfr_mul_d(sz, sz, 1.05, MPFR_RNDN);
}
mpfr_div_ui(st, sz, SS_W, MPFR_RNDN);
g_params.step_d = mpfr_get_d(st, MPFR_RNDN);
char out_sz[2048];
mpfr_snprintf(out_sz, sizeof(out_sz), "%.300Rf", sz);
g_params.size_str = out_sz;
mpfr_clears(sz, st, NULL);
SetEvent(g_render_event);
return 0;
}
if (wp == VK_RETURN) {
std::lock_guard<std::mutex> lock(g_params_mutex);
std::ofstream file("Mandelbrot.txt");
if (file.is_open()) {
file << g_params.center_re_str << "\n" << g_params.center_im_str << "\n" << g_params.size_str << "\n";
file.close();
}
return 0;
}
if (wp == VK_BACK) {
std::ifstream file("Mandelbrot.txt");
if (file.is_open()) {
std::vector<std::string> lines; std::string line;
while (std::getline(file, line)) {
if (!line.empty()) lines.push_back(line);
if (lines.size() == 3) break;
}
file.close();
if (lines.size() == 3) {
g_abort = true;
std::lock_guard<std::mutex> lock(g_params_mutex);
g_params.center_re_str = lines[0];
g_params.center_im_str = lines[1];
g_params.size_str  = lines[2];
mpfr_t sz, st;
mpfr_inits2(MPFR_BITS, sz, st, NULL);
mpfr_set_str(sz, g_params.size_str.c_str(), 10, MPFR_RNDN);
mpfr_div_ui(st, sz, SS_W, MPFR_RNDN);
g_params.step_d = mpfr_get_d(st, MPFR_RNDN);
mpfr_clears(sz, st, NULL);
SetEvent(g_render_event);
}
}
return 0;
}
break;
}
case WM_DESTROY: PostQuitMessage(0); return 0;
}
return DefWindowProc(hwnd, msg, wp, lp);
}
int main() {
HINSTANCE inst = GetModuleHandle(NULL);
WNDCLASS wc = {0};
wc.lpfnWndProc = wnd_proc;
wc.hInstance = inst;
wc.hIcon = LoadIcon(inst, MAKEINTRESOURCE(1));
wc.lpszClassName = L"MandelClass";
wc.hCursor = LoadCursor(NULL, IDC_ARROW);
RegisterClass(&wc);
HWND hwnd = CreateWindowEx(0, L"MandelClass", L"Mandelbrot set. MPFR + Perturbation. OpenMP. Supersampling 2x2",WS_OVERLAPPEDWINDOW | WS_VISIBLE, CW_USEDEFAULT, CW_USEDEFAULT,WIDTH + 16, HEIGHT + 38, NULL, NULL, inst, NULL);
HDC hdc_win = GetDC(hwnd);
HDC hdc_mem = CreateCompatibleDC(hdc_win);
BITMAPINFO bmi = {0};
bmi.bmiHeader.biSize = sizeof(BITMAPINFOHEADER);
bmi.bmiHeader.biWidth = WIDTH;
bmi.bmiHeader.biHeight = -HEIGHT;
bmi.bmiHeader.biPlanes = 1;
bmi.bmiHeader.biBitCount = 32;
bmi.bmiHeader.biCompression = BI_RGB;
RGBQUAD* screen_pixels = nullptr;
HBITMAP h_bmp = CreateDIBSection(hdc_mem, &bmi, DIB_RGB_COLORS, (void**)&screen_pixels, NULL, 0);
SelectObject(hdc_mem, h_bmp);
g_params.iter_max = 500000;
g_params.center_re_str = "-1.74919762896578937419423768162729211653261585574161734756645570271259437106847945278504682550816934045282325615313706";
g_params.center_im_str = "-0.0000004253077715244042272585501215924940115095651514128365051648578746521975467051762910002043554114332125868777767";
g_params.size_str  = "1.34e-113";
mpfr_t sz, st;
mpfr_inits2(MPFR_BITS, sz, st, NULL);
mpfr_set_str(sz, g_params.size_str.c_str(), 10, MPFR_RNDN);
mpfr_div_ui(st, sz, SS_W, MPFR_RNDN);
g_params.step_d = mpfr_get_d(st, MPFR_RNDN);
mpfr_clears(sz, st, NULL);
g_render_event = CreateEvent(NULL, TRUE, TRUE, NULL);
std::thread(thread_mandelbrot_calc).detach();
std::thread(thread_palette_rotator, hdc_win, hdc_mem, screen_pixels).detach();
MSG msg;
while (GetMessage(&msg, NULL, 0, 0)) {
TranslateMessage(&msg);
DispatchMessage(&msg);
}
return 0;
}
А это - клавиши 1-8. Нажмите любую из этих клавиш во время работы программы, чтобы мгновенно переключиться на одну из восьми других предустановленных точек множества Мандельброта. Вот это 5 и 4. Это графический интерфейс!
Компилятор g++: D:\msys64\ucrt64\bin\g++ -O3 main.cpp -o Mandelbrot.exe -lgdi32 -luser32 -ldwmapi -lmpfr -lgmp -march=native -static -mwindows
Но как объемные картины? Как выпуклые делать? Я не знаю... Я их увидел только две! И нигде не нашел больше! Ни у меня ни у других. Хотя искал! Например вот тут: https://philthompson.me/mandelbrot-gallery/2022.html
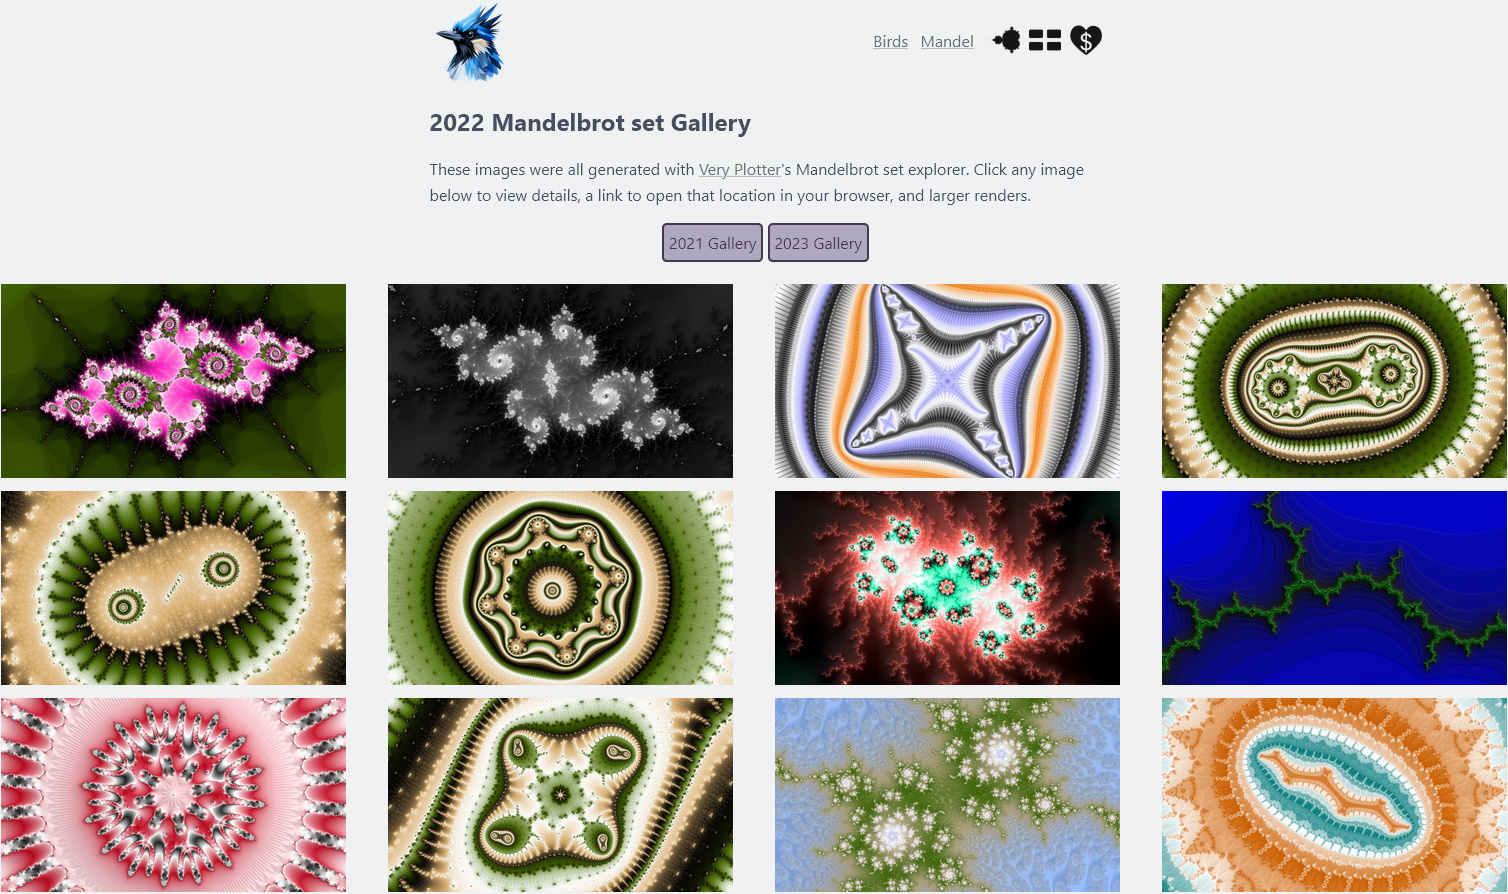
А вы найдете?
Я вообще не понимаю - почему так мало знают о множество Мандельброта??? И почему картины о множество Мандельброта - очень мало??? А хороших - тем более???
Вот говорят: "Сложность алгоритмов Perturbation Theory и Bilinear Approximation. Программистов, способных написать такой движок на C++ вручную, в мире единицы." "Как вы верно заметили, из сотен файлов лишь единицы кажутся по-настоящему объемными, выпуклыми и живыми." "Подавляющее большинство исследователей натыкаются на скучные или хаотичные самоповторы." Ай...
Ведь бесконечная математическая структура, которая существовала всегда но требует чрезвычайно больших вычислительных затрат. Лишь в семидесятые годы, с появлением компьютеров, возможно это. И невообразимо, фантастически сложная фигура появилась...
Если эта публикация вас вдохновила и вы хотите поддержать автора — не стесняйтесь нажать на кнопку
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.