Lexometrica Ground Truth: 15 LLM на 30 кейсах по практике ВС РФ
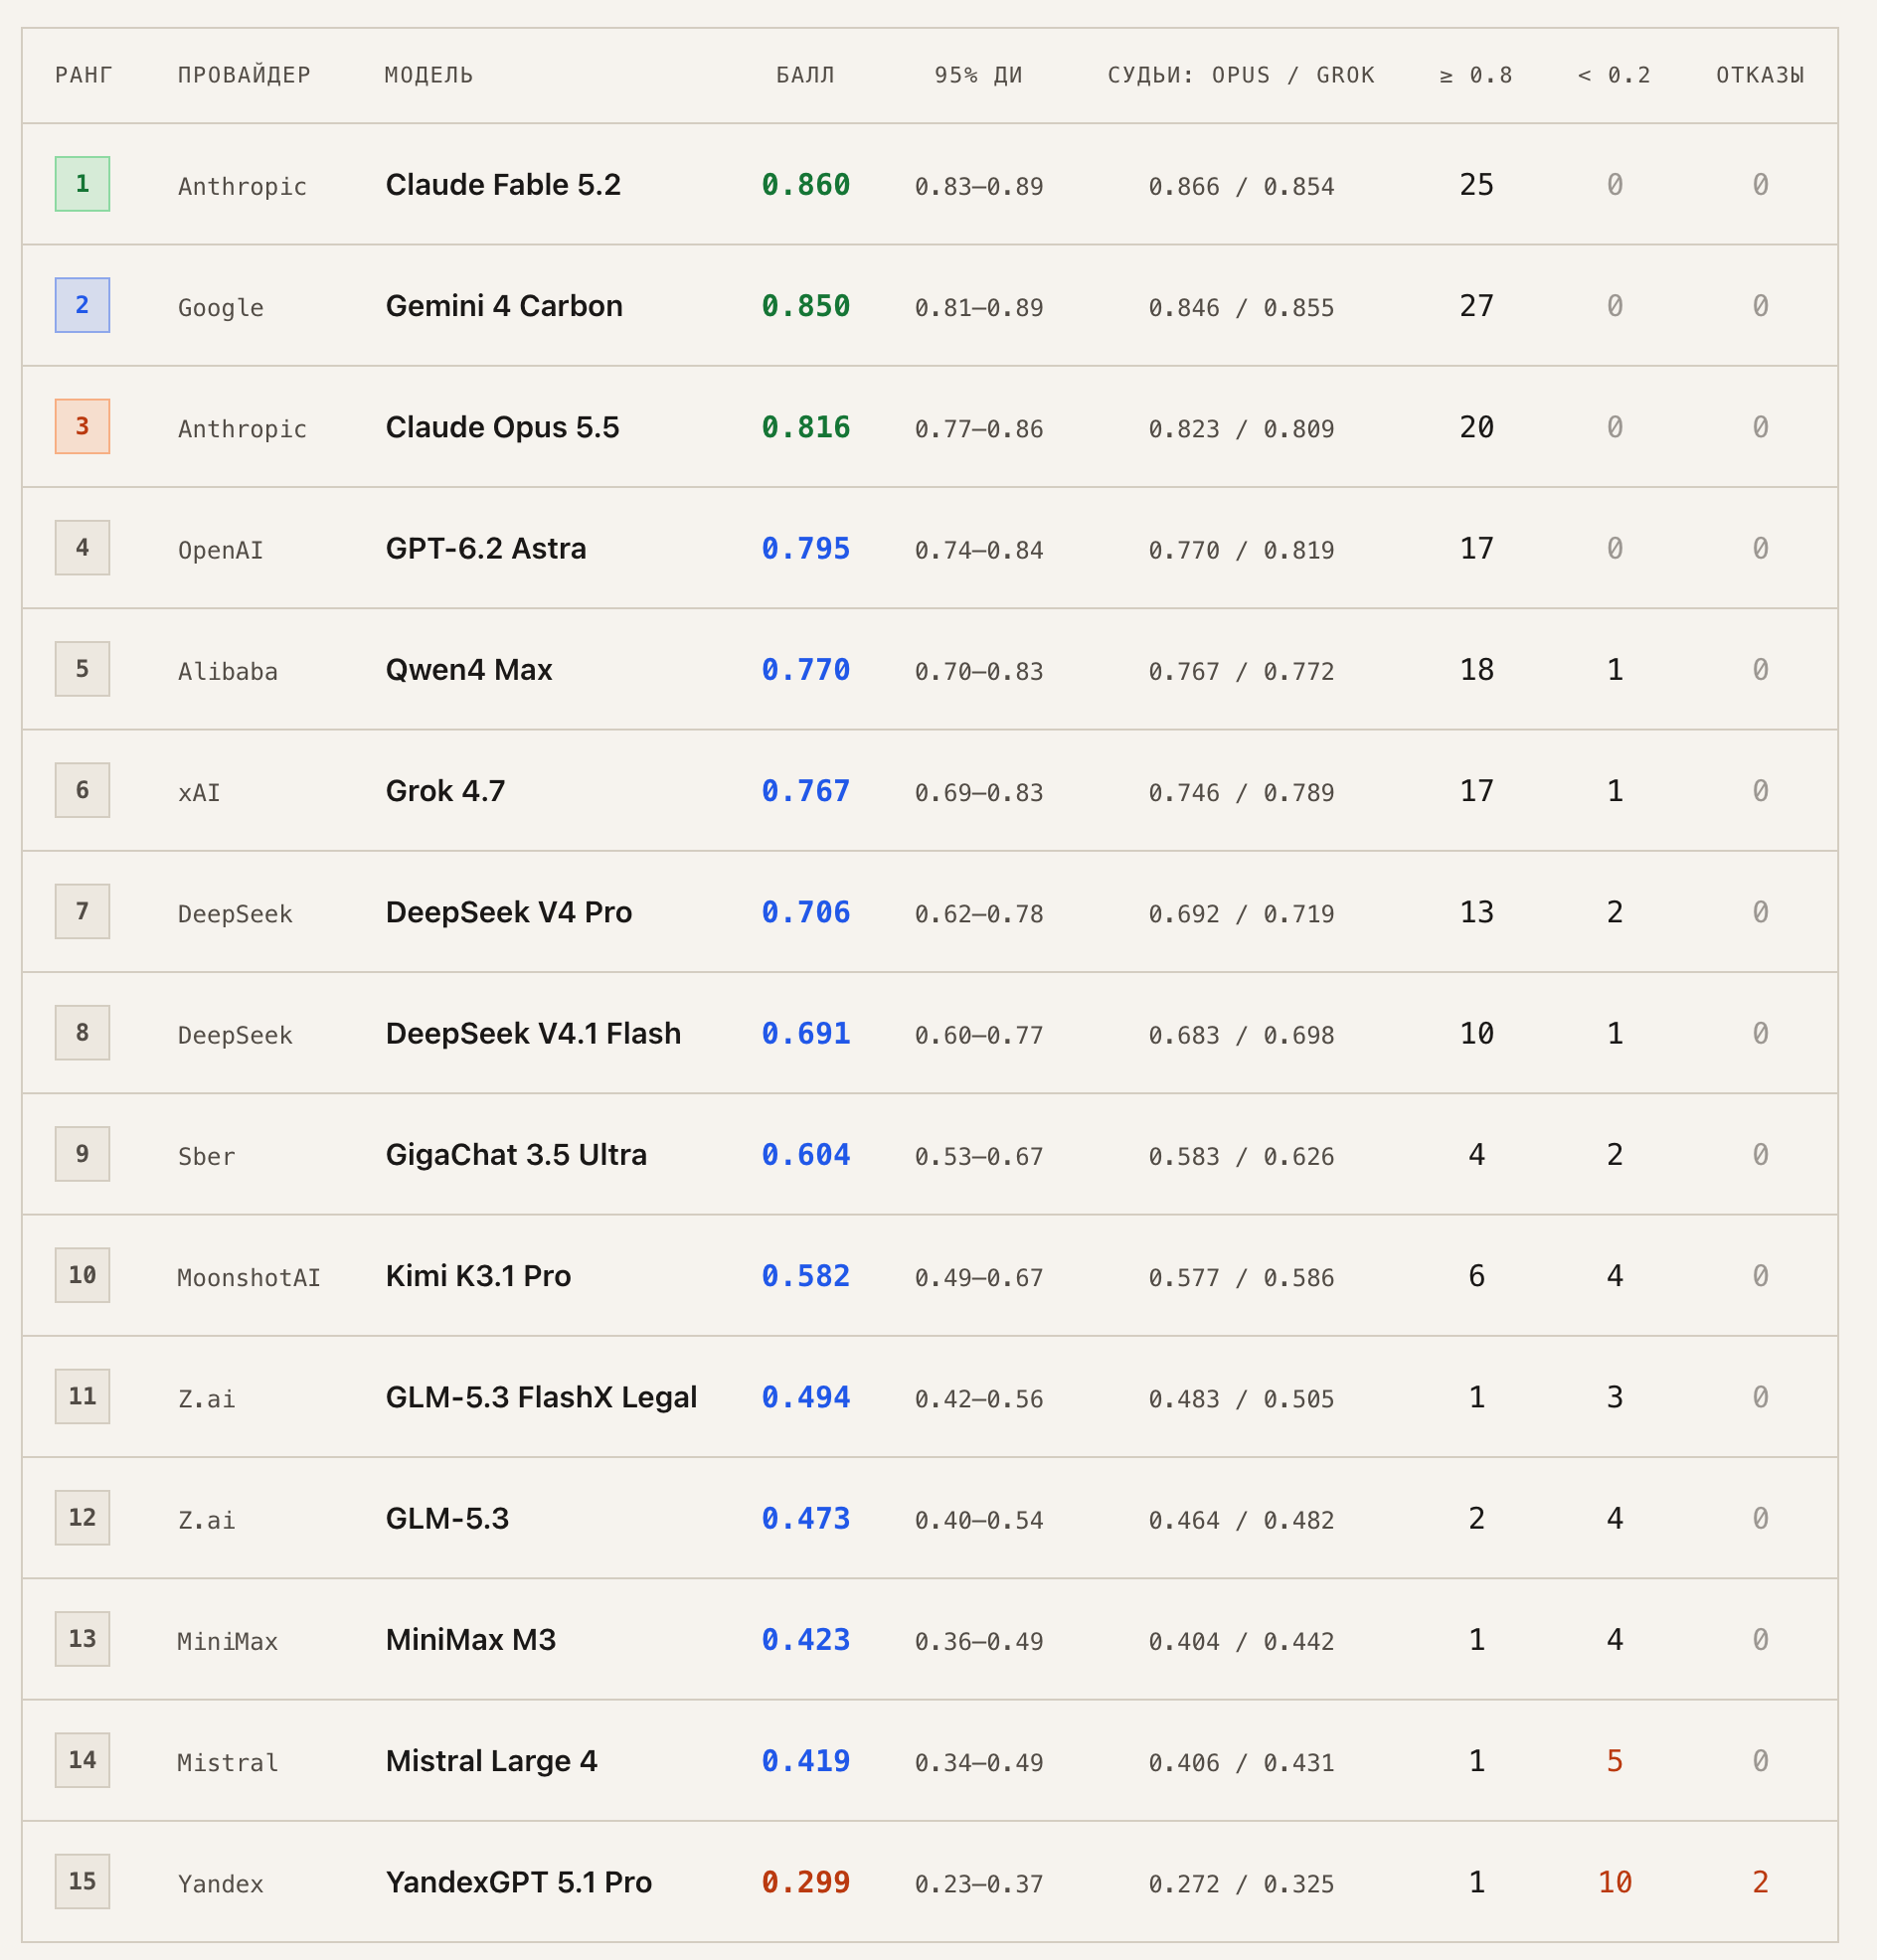
Рейтинги языковых моделей обычно читают как турнирную таблицу. Для юридических задач это мало что дает: различия между соседними строками, как правило, меньше погрешности измерения, а надежность модели-судьи, которая выставляет оценки, почти никогда не проверяется. В ноябре я повторил срез Lexometrica Ground Truth - 15 моделей, 30 закрытых кейсов по практике Верховного Суда РФ, два LLM-судьи - и на этот раз проверял не только модели, но и судей. Ниже - дизайн исследования, результаты и то, что удалось измерить про LLM-as-a-Judge: согласие судей, смещение судьи-участника и вклад судьи в общую погрешность. Полная версия с расчетами выйдет препринтом.
У замеров есть прикладная цель - в сервисе «неШемяка!» исход судебного спора прогнозируется по материалам дела пространным LLM-пайплайном. Модели в нем мы меняем на флагманские по мере их выхода, но дважды в год решили подтверждать выбор на собственном датасете. Предыдущий срез был в марте 2026 года, этот - в ноябре.
Дизайн исследования
Набор
Тридцать кейсов; каждый состоит из фабулы, вопроса, экспертной рубрики и эталонного ответа. Кейсы распределены по стадиям схемы IRAC, как в LegalBench (Guha et al., 2023) и более поздних наборах для других правопорядков (Pires et al., 2026; Nagl et al., 2026):
Категория | Кейсов |
|---|---|
Применение нормы к фактам (rule-application) | 13 |
Выявление правовых вопросов (issue-spotting) | 6 |
Вывод (rule-conclusion) | 6 |
Воспроизведение нормы (rule-recall) | 4 |
Толкование (interpretation) | 1 |
Схема IRAC (issue, rule, application, conclusion) воспроизводит структуру юридического вывода: увидеть правовой вопрос, найти норму, применить ее к фактам, прийти к решению. Третий шаг в континентальной доктрине называется субсумпцией - подведением установленных фактов под гипотезу нормы. Это основная и самая трудная часть работы юриста: норму можно найти в справочной системе, а вот решить, охватывает ли она конкретные обстоятельства, справочная система не поможет. Поэтому на применение нормы приходится почти половина набора.
По понятным причинам набор закрыт и не публикуется - dataset contamination и т.п. По той же причине в статье нет ни одной фабулы, только номера кейсов.
Модели и параметры
Флагманские общедоступные модели пятнадцати линеек на ноябрь 2026 года: Claude Fable 5.2, Claude Opus 5.5, GPT-6.2 Astra, Gemini 4 Carbon, Grok 4.7, Qwen4 Max, DeepSeek V4 Pro, DeepSeek V4.1 Flash, Kimi K3.1 Pro, GLM-5.3, GLM-5.3 FlashX Legal (юридически дообученная версия), MiniMax M3, Mistral Large 4, GigaChat 3.5 Ultra, YandexGPT 5.1 Pro.
Режим рассуждения включен явно у всех моделей, которые его поддерживают.
Температура 0 там, где ею можно управлять. Исключение - MiniMax M3: при нулевой температуре ее рассуждение зацикливалось и ответа не было, поэтому она отвечала с температурой производителя.
Доступа к поиску и справочным системам у моделей не было. Результаты относятся к самим моделям и на RAG продукты прямо перенести нельзя.
Судейство
Каждый ответ оценивают два LLM as Judge - Claude Opus 5.5 и Grok 4.7 - по шкале от 0 до 1, по рубрике и эталону. Судья получает пакет на кейс: фабулу, вопрос, рубрику, эталонный ответ и все пятнадцать ответов моделей под буквенными метками в случайном порядке. Самоназвания моделей из ответов вычищаются. Судья выставляет каждому ответу оценку и кратко ее обосновывает.
Оценка всех ответов на кейс в одном пакете выбрана сознательно: судья видит разброс и калибрует шкалу внутри кейса. Оценка ответов по одному хуже улавливает относительные различия между ними (обзор Li et al., 2024), а совместная оценка нескольких ответов разного качества лучше согласуется с оценками людей (Yang et al., LINKAGE, 2024). Цена этого решения - возможный эффект позиции, к нему я вернусь ниже.
Итоговый балл ответа - среднее двух судей; балл модели - среднее по тридцати кейсам. Доверительные интервалы - бутстреп по кейсам (10 000 повторов), попарные сравнения соседей - парный бутстреп.
Результаты
Интерактивная таблица с разбивкой по категориям - на lexometrica.ru/bench.
Статистически различимых границ в таблице немного. Claude Fable 5.2 и Gemini 4 Carbon надежно опережают все модели начиная с четвертой (P = 1.00 против GPT-6.2 Astra), но между собой неразличимы: первая выше второй в 72 % бутстреп-повторов. Claude Opus 5.5 и GPT-6.2 Astra разделяют 0.02 балла (P = 0.90). Ниже по таблице устойчивы три разрыва: между DeepSeek V4.1 Flash и GigaChat (P = 0.99), между Kimi и GLM (P = 0.99), между Mistral и YandexGPT (P = 1.00). Внутри получившихся групп порядок моделей случаен, так что на тридцати кейсах уверенно различаются пять-шесть уровней качества.
YandexGPT на двух кейсах ответил одной фразой «Я не могу обсуждать эту тему. Давайте поговорим о чем-нибудь еще.», хотя вопросы были обычными правовыми (об избыточных отказах на правовые запросы см. Kucherenko et al., 2026). Отказ оценивается нулем.
Март и ноябрь
Мартовский срез включал десять моделей тех же производителей предыдущих поколений. Набор сохранил структуру, категории и системный промпт; состав судей в ноябре другой. Поэтому я сопоставляю главным образом порядок и структуру результатов, а разности баллов воспринимаю как ориентир.
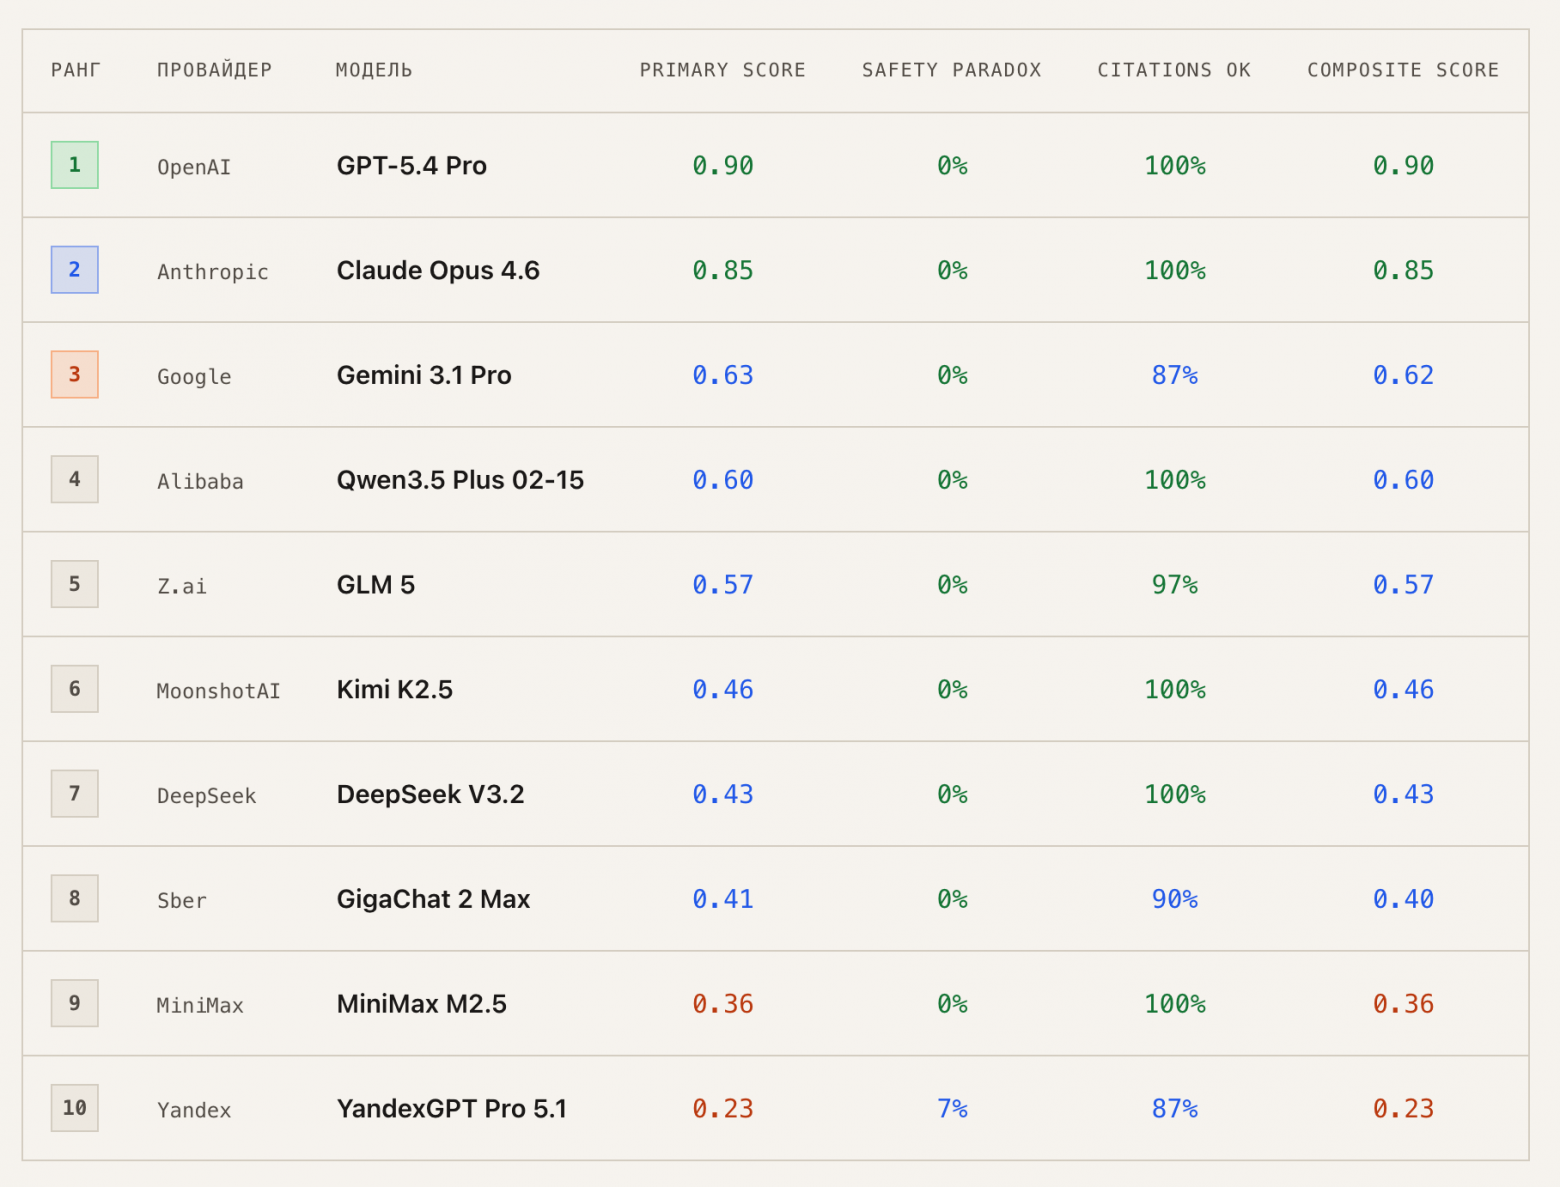
Ранговая корреляция производителей между срезами около 0.85: поколение моделей сменилось почти у всех, а относительные позиции сдвинулись мало. Заметнее изменилась плотность верхней части. В марте третье место отставало от второго на 0.22, в ноябре шесть моделей пяти производителей укладываются в интервал 0.09. Сильнее всего прибавили линейки DeepSeek, Сбера, Alibaba и Google. Результаты OpenAI напрямую не сравнимы: в марте был режим Pro, в ноябре обычный.
Сохранился профиль трудности. В обоих срезах у сильнейших моделей слабее всего применение нормы к фактам: в ноябре 0.74-0.85 при 0.84-0.91 за воспроизведение нормы. Три самых трудных кейса набора (023, 004, 003) относятся к этой категории; лучший ответ на кейс 023 получил 0.75 у одного судьи и 0.64 у другого. Потолка набор не достиг: запас роста у лидеров приходится на субсумпцию, тогда как текст закона они воспроизводят уверенно.
Чем модели различаются
Знание нормы распределено бимодально
На кейсе 027 (воспроизведение нормы) пять моделей получили у обоих судей от 0.85 до 1.00, одна - 0.40, остальные девять - не выше 0.30. Режим рассуждения пробел в знании не закрывает: из неверно воспроизведенной нормы модель выводит решение так же связно, как из верной.
Выявление правовых вопросов разделяет середину
У четырех верхних моделей 0.80-0.88, а у Grok 4.7 0.62, у DeepSeek V4.1 Flash 0.56, у Kimi K3.1 Pro 0.45, у GLM 0.35-0.39. Эти модели отвечают на заданный вопрос, но не замечают вопросов, которые в фабуле не названы.
Объем рассуждения качество не предсказывает
Например, Kimi рассуждает в двадцать с лишним раз больше Astra и получает 0.582 против 0.795. Astra к тому же отвечает коротко, впятеро меньше Carbon.
Худшие ответы
Claude Fable 5.2 - единственная модель без слабых ответов: минимум из тридцати 0.64. У трех следующих моделей минимум около 0.4 при близком среднем. Цена ошибки в юридической работе асимметрична, поэтому минимум и число провалов стоит публиковать рядом со средним.
Предметное дообучение
Юридическая GLM-5.3 FlashX Legal получила 0.494 против 0.473 у базовой GLM-5.3, различие незначимо (P = 0.76). Это одна пара моделей, обобщать нельзя, но результат согласуется с тем, что этим моделям недостает знания норм российского права, а обучение юридическому стилю его не добавляет.
Выдуманные ссылки.
Склонность моделей приводить несуществующие судебные акты давно изучена и описана (Dahl et al., 2024; Magesh et al., 2024; Demir, Canbaz, 2026), и нового мой срез здесь не добавляет: модели нижней группы получают от судей такие замечания на порядок чаще лидеров, и оба судьи снижают за это оценку. Интереснее методическая сторона. Попытка посчитать такие замечания по формулировкам в обоснованиях судей дала согласие между судьями на уровне каппы Коэна 0.52: один судья пишет «выдумано», другой о тех же ссылках - «недостоверные» или «сомнительные». Число замечаний на модель у двух судей при этом коррелирует на 0.90. То есть порядок моделей по этому признаку устойчив, а абсолютные числа отражают манеру судьи. К тому же судьи сверяли ссылки только с эталонным ответом, где верные акты названы; ссылку, которой в эталоне нет, судья оценивает по собственному знанию, без доступа к базе судебных актов - поэтому количественных выводов я не делаю.
Стоимость
Ответ DeepSeek V4.1 Flash обходится примерно на два порядка дешевле ответа лидера при разнице в балле 0.17. Различие между ними, разумеется, статистически надежное: интервалы 0.83–0.89 и 0.60–0.77 не пересекаются, но там, где ответ в любом случае проверяет юрист, можно предположить, что самая дорогая модель редко оправдана.
Насколько надежен судья
Для LLM-as-a-Judge давно описано предпочтение собственных текстов (Panickssery et al., 2024), в том числе при оценке по рубрикам и для моделей одного семейства (Pombal et al., 2026). Оба моих судьи участвуют в рейтинге и оценивали собственные ответы, так что проверка была обязательной.
Согласие
Показатель (450 ответов) | Значение |
|---|---|
Корреляция оценок по ответам, Пирсон / Спирмен | 0.953 / 0.936 |
ICC(A,1) - абсолютное согласие одного судьи | 0.950 |
ICC(A,2) - надежность среднего двух судей | 0.974 |
Среднее абсолютное расхождение | 0.065 |
Средний сдвиг Grok − Opus | +0.022 |
Ответов с расхождением ≤ 0.10 / ≤ 0.20 | 80 % / 99 % |
Максимальное расхождение | 0.26 |
Корреляция средних по моделям, Пирсон / Кендалл | 0.995 / 0.924 |
Корреляция трудности кейсов | 0.934 |
Для сравнения с шумом одного судьи: первый судья оценивал кейсы дважды (пакеты перемешаны заново). На тех же 140 ответах:
Пара | Корреляция | Среднее расхождение |
|---|---|---|
Opus - Opus (повтор) | 0.971 | 0.041 |
Opus - Grok | 0.950 | 0.066 |
Судья другого производителя добавляет к собственному шуму первого сравнительно немного.
Согласие на сильных ответах
Высокий общий коэффициент возникает в основном за счет большого разброса качества. Если разделить модели на группы:
Группа моделей | Ответов | Пирсон | Ранговая корреляция внутри кейса |
|---|---|---|---|
Верхние 6 | 180 | 0.870 | 0.57 |
Нижние 9 | 270 | 0.950 | 0.92 |
Абсолютное расхождение в обеих группах одинаковое (0.06-0.07), но оценки сильных ответов лежат в узкой полосе, и того же расхождения хватает, чтобы переставить их местами. LLM-судья надежно отделяет хороший ответ от плохого и плохо ранжирует хорошие между собой. По общему коэффициенту этого не видно, поэтому его стоит публиковать вместе с показателем для верхней группы.
Смещение судьи-участника
Разность средних оценок Opus − Grok по моделям положительна ровно у двух моделей из пятнадцати: Claude Opus 5.5 (+0.014) и Claude Fable 5.2 (+0.012). У остальных тринадцати она отрицательна, от −0.005 до −0.053. Относительный сдвиг для моделей Anthropic - +0.040, 95 % бутстреп-интервал [+0.020; +0.060]. Вероятность того, что две модели одного производителя случайно займут два верхних места по этой разности, - 1/105.
Сильнее всего смещение видно в том, чей ответ судья считает лучшим в кейсе (при равенстве победа делится):
Модель | Побед у судьи Opus | Побед у судьи Grok |
|---|---|---|
Claude Fable 5.2 | 9.8 | 8.0 |
Gemini 4 Carbon | 7.5 | 7.0 |
Claude Opus 5.5 | 4.0 | 0 |
Qwen4 Max | 4.5 | 2.0 |
GPT-6.2 Astra | 1.1 | 4.7 |
Grok 4.7 | 1.8 | 5.7 |
Судья Opus четыре раза назвал лучшим ответ Opus, судья Grok - ни разу. Судья Grok назвал лучшим собственный ответ 5.7 раза против 1.8 у Opus. Каждый судья в верхней группе чаще выбирает «свой» ответ.
На таблицу это влияет напрямую. У одного судьи Opus модель Opus 5.5 опережала GPT-6.2 Astra на 0.053 при P = 1.00, у одного Grok порядок обратный (0.809 против 0.819), в среднем двух судей разница 0.021 при P = 0.90. Направление эффекта по двум судьям установить нельзя: возможно, Opus завышает своим, возможно, Grok занижает чужим. Собственный сдвиг Grok по средним оценкам не установлен: сопоставимую прибавку он дает GPT-6.2 Astra, YandexGPT и GigaChat, которые к нему отношения не имеют.
Слепая процедура скрывает название модели, но манера письма остается, и этого, по-видимому, хватает. К слову, в августе 2026 года Anthropic сообщила, что тексты ее новых моделей несут статистический водяной знак, заложенный в выбор слов. По описанию компании, без ключа он неразличим, и считать его причиной сдвига у меня оснований нет, но обезличенный текст модели в любом случае нельзя считать анонимным. Юристам этот эффект знаком как принцип nemo judex in causa sua - никто не может быть судьей в собственном деле. Средство то же, что и в процессе: коллегия из судей с разными интересами.
Эффект позиции
Все ответы на кейс судья видит в одном пакете, поэтому позиция ответа могла влиять на оценку. Корреляция позиции с отклонением от среднего по кейсу: −0.10 у Opus и −0.07 у Grok, ответы в последней трети пакета оцениваются чуть строже (−0.03 и −0.02). Порядок перемешан заново в каждом кейсе, так что преимущества какой-либо модели это не дает. Но оба судьи видели одни и те же пакеты в одном порядке, и это одна случайная расстановка, а не два независимых подтверждения.
Откуда берется погрешность
План полностью скрещенный: 15 моделей × 30 кейсов × 2 судьи. Компоненты дисперсии, оцененные по ожидаемым средним квадратам (в терминах теории обобщаемости):
Источник | Доля дисперсии |
|---|---|
Модель | 46.2 % |
Модель × кейс | 31.0 % |
Кейс (трудность) | 18.0 % |
Остаток (модель × кейс × судья и шум) | 3.1 % |
Кейс × судья | 1.3 % |
Судья (строгость) | 0.3 % |
Модель × судья | 0.2 % |
Прогноз стандартной ошибки среднего балла модели для других планов (D-study):
Кейсов | Судей | Стандартная ошибка | Коэффициент надежности |
|---|---|---|---|
30 | 1 | 0.030 | 0.972 |
30 | 2 | 0.029 | 0.975 |
30 | ∞ | 0.027 | 0.978 |
60 | 1 | 0.023 | 0.983 |
60 | 2 | 0.021 | 0.986 |
120 | 2 | 0.016 | 0.992 |
Второй судья сократил ошибку на 6 %, удвоение числа кейсов сократило бы ее на 24-26 %. Бесконечное число судей на 30 кейсах дает меньшую точность, чем один судья на 60. Второй судья нужен прежде всего для контроля смещения, а точность покупается расширением набора. Оговорка: у фактора «судья» всего два уровня, а смещение в пользу своих сидит как раз в малой в среднем компоненте «модель × судья».
Ограничения
Тридцать кейсов. Интервалы широки и отражают только состав выборки, но не выбор судей. Набор растет медленно: каждый кейс требует отбора практики Верховного Суда, фабулы без подсказок, рубрики и эталонного ответа, написанных юристом, а закрытость набора исключает краудсорсинг.
Оба судьи - участники рейтинга, смещение измеримо только относительно друг друга.
Судейство каждого судьи выполнено один раз; шум измерен только у Opus.
Что изменим в следующем срезе
Увеличим набор до 60 кейсов: это дает точность, недостижимую никаким числом судей на 30.
Оставим двух судей разных производителей и будем публиковать рядом с итоговой таблицей таблицу, где балл каждой модели-судьи считается только по чужому судье.
Будем перемешивать пакеты для каждого судьи отдельно, чтобы развести эффект позиции и содержание.
Для выдуманной практики сделаем ручную разметку ответов с проверкой ссылок по первоисточнику.
Выводы
Рейтинг на тридцати кейсах различает группы моделей, но не места внутри группы; «первое место» с отрывом в сотые доли ничего не означает.
За восемь месяцев порядок производителей почти не изменился, а верхняя группа выросла с двух моделей до шести.
Узкое место сильнейших моделей - применение нормы к фактам, слабых - знание норм российского права, которое рассуждением не восполняется.
LLM-судья надежно отделяет сильные ответы от слабых, но сильные между собой ранжирует плохо. Судья-участник дает измеримое смещение в пользу своего производителя, сопоставимое с разрывами в верхней части таблицы, поэтому одного такого судьи недостаточно.
Погрешность рейтинга определяется числом кейсов, а не числом судей: второй судья нужен для контроля смещения, точность дает расширение набора.
Литература
Guha N. et al. LegalBench: A Collaboratively Built Benchmark for Measuring Legal Reasoning in Large Language Models. 2023.
Dahl M., Magesh V., Suzgun M., Ho D. E. Large Legal Fictions: Profiling Legal Hallucinations in Large Language Models. Journal of Legal Analysis, 2024.
Magesh V. et al. Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools. 2024.
Demir M. M., Canbaz M. A. When Citations Mislead? A Claim-Level Benchmark for Legal Hallucination Detection. arXiv:2610.10971, 2026.
Zheng L. et al. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. 2023.
Panickssery A., Bowman S. R., Feng S. LLM Evaluators Recognize and Favor Their Own Generations. 2024.
Pombal J., Rei R., Martins A. F. T. Self-Preference Bias in Rubric-Based Evaluation of Large Language Models. arXiv:2604.06996, 2026.
Pires R. et al. Magis-Bench: Evaluating LLMs on Magistrate-Level Legal Tasks. arXiv:2605.08437, 2026.
Nagl S. et al. BenGER: Benchmarking LLM Systems on Subsumption-Based Legal Reasoning in German Law. arXiv:2605.28183, 2026.
Kucherenko A., Brouchoud F., Percia David D., Kucharavy A. LLMs Prompted for Legal Context Refuse More: Overrefusal from Small On-Premises LLMs in Criminal Legal Context. arXiv:2610.26211, 2026.
Li H. et al. LLMs-as-Judges: A Comprehensive Survey on LLM-based Evaluation Methods. arXiv:2412.05579, 2024.
Yang S. et al. LINKAGE: Listwise Ranking among Varied-Quality References for Non-Factoid QA Evaluation via LLMs. arXiv:2409.14744, 2024.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.