Все запросы вернули 200 OK, а записи пропали. Как пагинация незаметно теряет данные
Всем привет! Меня зовут Александр, я работаю с ETL на Python: забираю данные из чужих API и складываю их в базу.
В этой работе меня больше всего пугают не те ошибки, после которых скрипт падает с трейсбеком. С ними все понятно: упало, пошел чинить. Хуже те, после которых в логе стоит «готово». Одна из таких связана с пагинацией: API на каждый запрос ответил 200, загрузчик дошел до последней страницы, а в базе одной записи не хватает и еще одна лежит дважды.
В статье покажу, откуда это берется при обычном обходе по offset, воспроизведу без сети на 30 строках и расскажу, как искать такие потери в выгрузке, которая уже прошла. В конце будет короткий список вопросов, которые стоит задать своему загрузчику.
Начнем со скрипта. Он каждую ночь забирает записи из API, и ошибок в логах у него нет.
def load_rides():
    rides, offset = [], 0
    while True:
        page = requests.get(URL, params={"offset": offset, "limit": 100}).json()
        if len(page) < 100:
            break
        rides += page
        offset += 100
    save_to_db(rides)
Таймауты и проверку статуса ответа оставлю в стороне — это отдельная тема. В самом обходе страниц здесь три проблемы: теряется последняя страница, обход сдвигается при изменении данных, у цикла нет предела.
Последняя страница не попадает в результат
if len(page) < 100: break стоит раньше, чем rides += page. Если последняя страница неполная, код отбрасывает ее целиком.
В дни, когда число записей делится на 100, все сходится, поэтому потерю можно не замечать месяцами.
Обход по offset дублирует и теряет записи, если данные меняются
Запрос с offset=3 API понимает так: отсортировать все, что есть сейчас, пропустить три записи и отдать следующие. О том, где вы остановились в прошлый раз, он ничего не знает. Загрузчик помнит, сколько записей пропустить, а не на какой записи он остановился. Если между двумя запросами список изменился, под тем же номером лежит уже другая запись.
Возьмем шесть поездок, страницы по три, новые первыми. Загрузчик забрал первую страницу. В этот момент появляется новая поездка 106:
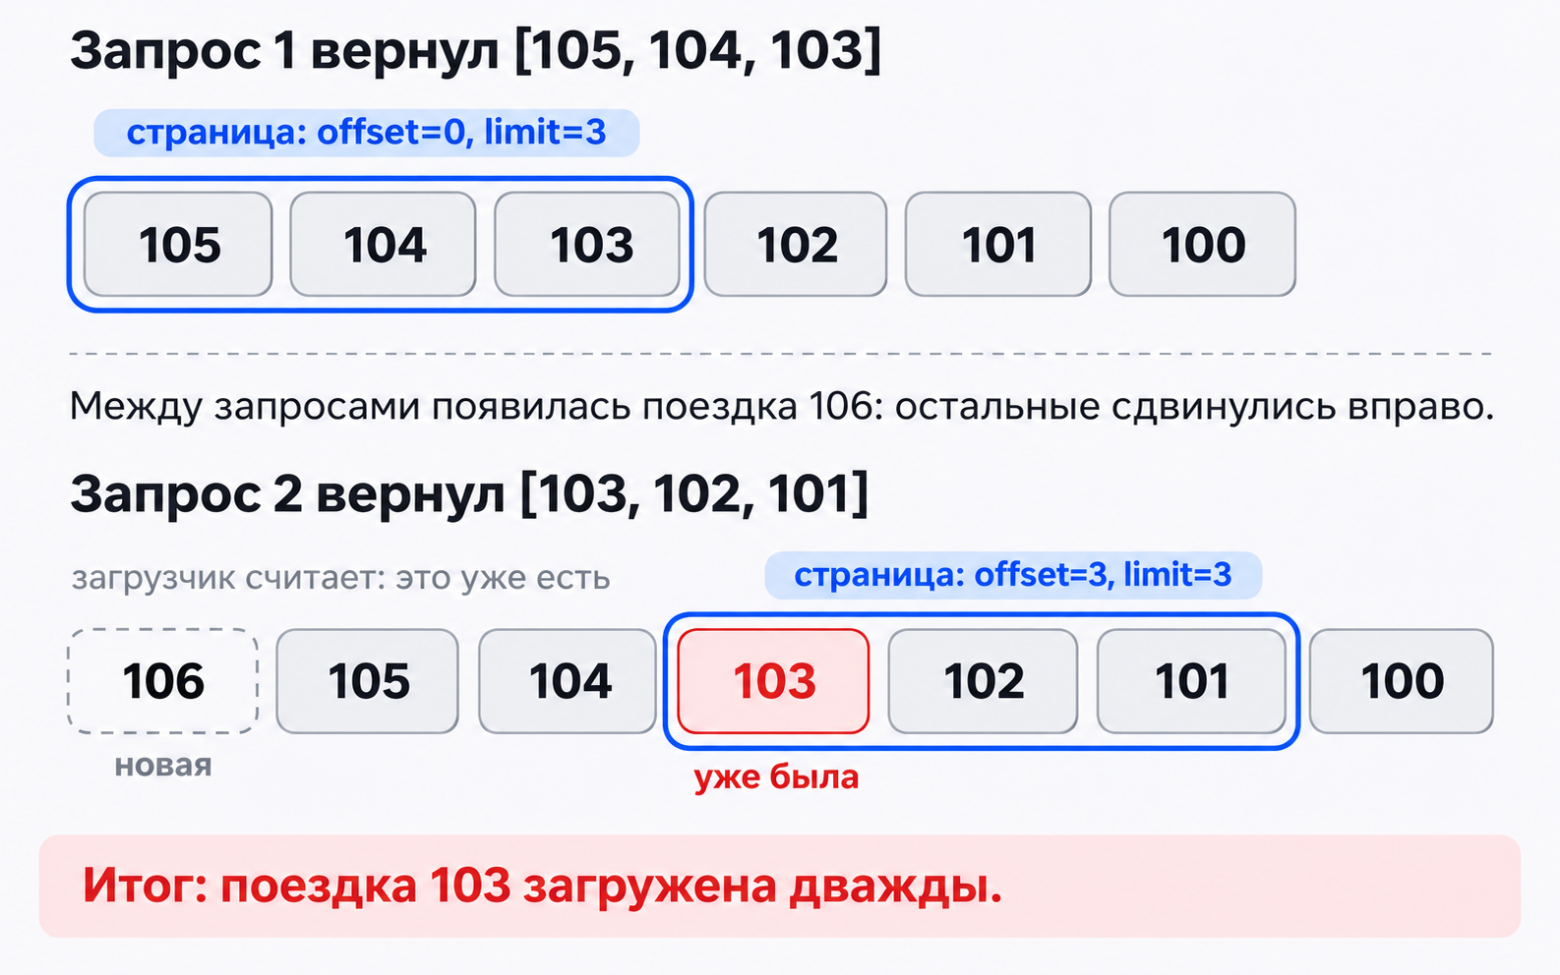
Все сдвинулось на одно место, и поездка 103 пришла второй раз.
Теперь наоборот: после первой страницы поездку 104 удалили.
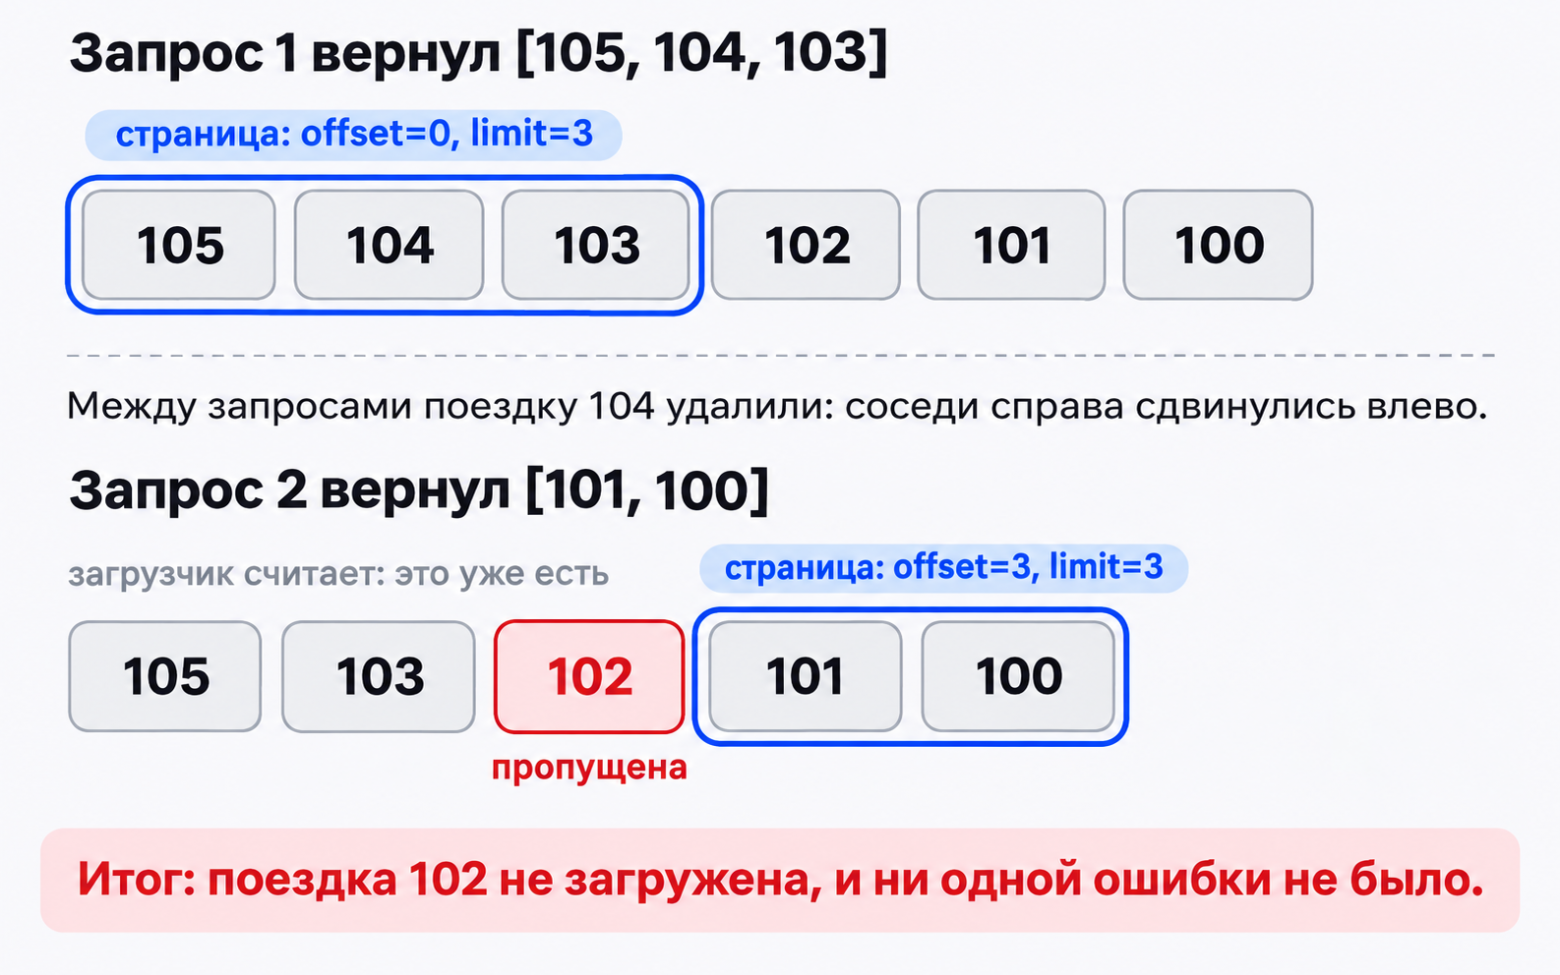
Поездка 102 оказалась среди первых трех, и следующий запрос ее пропустил. API ни разу ее не отдал и ни разу не ответил ошибкой.
По‑моему, второй случай хуже первого. Повтор виден в ответах API, и уникальный ключ в базе его погасит. А пропущенную запись в своих данных вы не найдете, сколько ни ищите.
Воспроизведение без сети и без библиотек:
class RidesApi:
    """Игрушечный API: поездки страницами, новые первыми."""

    def init(self, ids):
        self.ids = sorted(ids, reverse=True)

    def get_page(self, offset, limit):
        return self.ids[offset:offset + limit]


def load_rides(api, limit, after_first_page=None):
    rides, offset = [], 0
    while True:
        page = api.get_page(offset, limit)
        if not page:
            return rides
        rides += page
        offset += limit
        if after_first_page:          # что-то происходит с данными, пока мы идем
            after_first_page(api)
            after_first_page = None


def add_106(api):
    api.ids.insert(0, 106)


def remove_104(api):
    api.ids.remove(104)


start = [100, 101, 102, 103, 104, 105]
print(load_rides(RidesApi(start), 3))               # [105, 104, 103, 102, 101, 100]
print(load_rides(RidesApi(start), 3, add_106))      # [105, 104, 103, 103, 102, 101, 100]
print(load_rides(RidesApi(start), 3, remove_104))   # [105, 104, 103, 101, 100]
Сдвига не будет, если пройденная часть списка не меняется, пока вы идете. Например, источник только пополняется, а сортировка идет от старых к новым: новые записи встают в конец и ничего не сдвигают. Так что перед выбором способа обхода посмотрите, в каком порядке API отдает записи.
У цикла нет предела
while True закончится, только если API вернет короткую страницу. За концом списка API ведут себя по‑разному: одни за концом списка отдают пустой список, другие ошибку, третьи — снова последнюю страницу. Если она полная и повторяется, цикл не закончится.
Загрузчику нужен собственный бюджет запросов. Когда бюджет исчерпан, а конец списка не найден, он должен завершиться исключением. Вернуть «что успел» нельзя: код, который вызвал загрузчик, не отличит неполный список от полного и запишет его в базу.
Закладка вместо номера позиции
Если API умеет keyset‑пагинацию (ее же называют курсорной), следующую страницу выбирают не по номеру позиции, а по значению ключа последней полученной записи: «дай записи с id меньше 103».
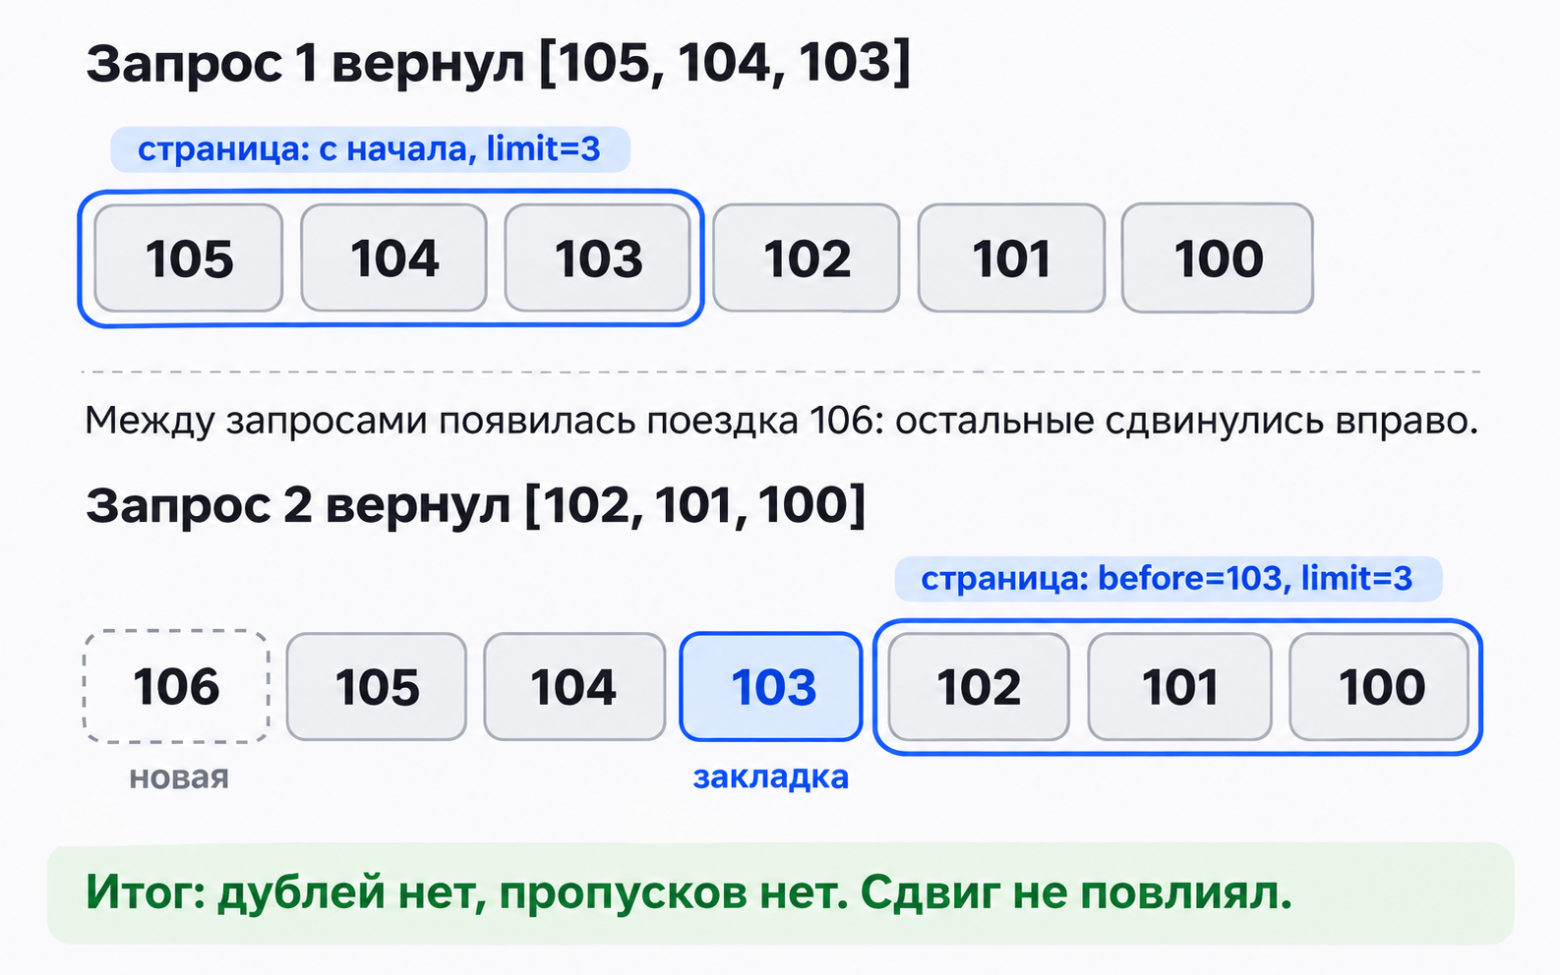
При сравнении по сохраненному неизменному ключу вставки и удаления перед границей ее не сдвигают. Тот же сценарий, что выше, но данные меняются сразу в обе стороны — и обход с исправленным циклом:
def load_rides(get_page, limit, max_pages=10_000):     rides, before = [], None     for  in range(maxpages):                # предел: цикл закончится в любом случае         page = get_page(before, limit)         if not page:                         # конец подтвержден пустой страницей             return rides         rides += page                         # сначала сохранили страницу...         before = page[-1]                     # ...потом сдвинули закладку на последнюю запись     raise RuntimeError(f"{max_pages} запросов, а конец списка не найден")   class RidesApi:     """Игрушечный API с закладкой: отдает поездки с id меньше before, новые первыми."""      def init(self, ids):
        self.ids = sorted(ids, reverse=True)
        self.calls = 0

    def get_page(self, before, limit):
        self.calls += 1
        if self.calls == 2:                   # между первым и вторым запросом данные меняются
            self.ids.insert(0, 106)
            self.ids.remove(104)
        return [i for i in self.ids if before is None or i < before][:limit]


print(load_rides(RidesApi([100, 101, 102, 103, 104, 105]).get_page, 3))
# [105, 104, 103, 102, 101, 100] - без дублей и пропусков
Оговорки:
— API должен такую пагинацию поддерживать. Если нет — остается offset со всеми условиями выше.
— Ключ сортировки должен быть уникальным и неизменным. Одного времени создания недостаточно, если значения могут повторяться: нужен уникальный дополнительный ключ, например пара «время + id».
— У некоторых API курсор — непрозрачный токен, и как он поведет себя при удалении записи, зависит от реализации.
— Выгрузка по закладке все равно собрана из ответов в разные моменты времени. Запись, которую изменили или удалили после того, как вы ее забрали, останется у вас в старом виде, и обход этого не исправит.
Как проверить выгрузку, которая уже прошла
Перезапуск мало что покажет: сдвиг зависит от того, что происходило с данными в те секунды, и во второй раз может не случиться.
Я записываю трассу: какие запросы загрузчик делал и что получил. По ней часть проблем можно найти арифметикой, без обращения к API:
— каждый следующий запрос начинается там, где закончился предыдущий? Если дальше — это разрыв;
— один и тот же запрос не повторялся?
— разные запросы не вернули одинаковую страницу?
— число разных id совпадает с тем, что API сообщил в total?
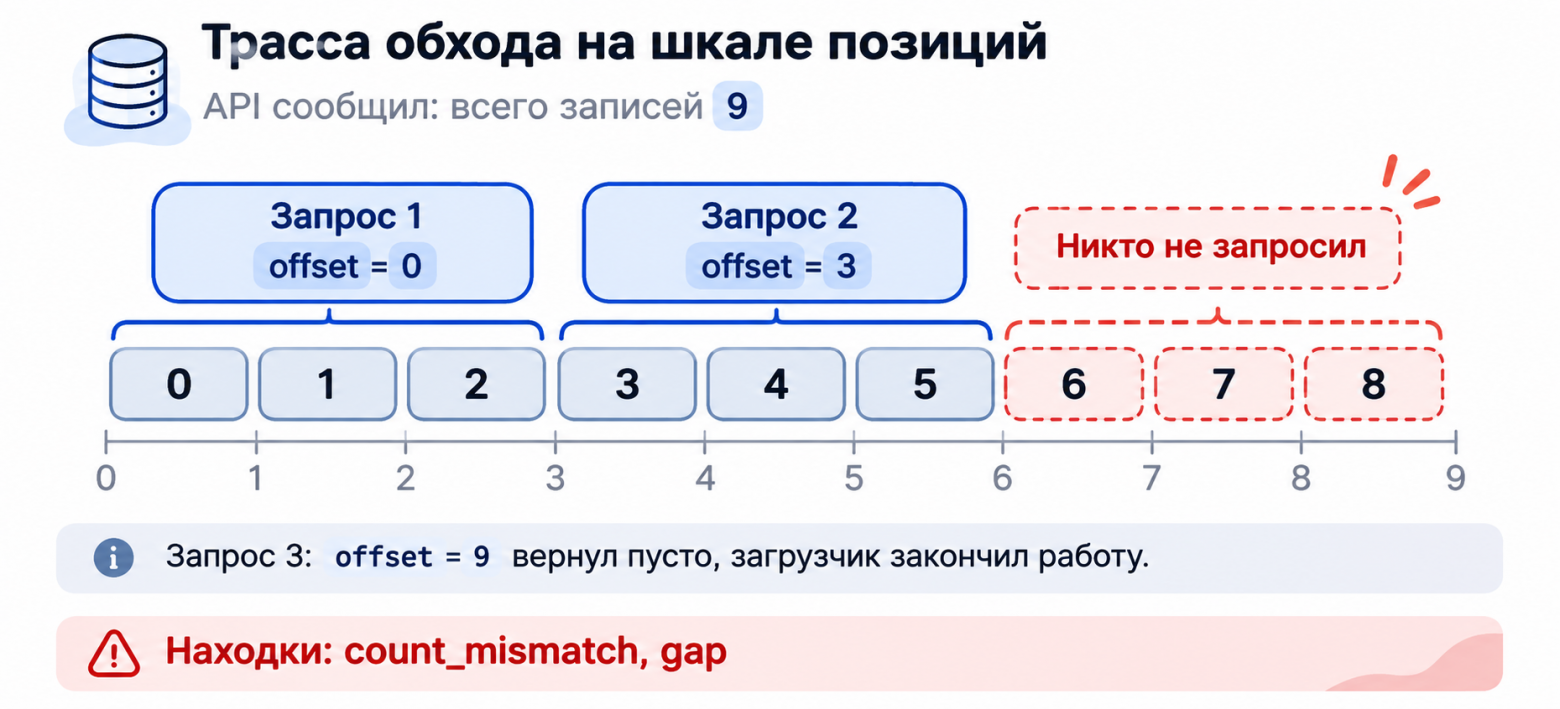
Про последний пункт: сверка с total имеет смысл, только если total посчитан с теми же фильтрами, что и выгрузка, и вы помните, что источник мог измениться между подсчетом и обходом.
Чистая трасса полноту выгрузки не доказывает: в ней всего лишь нет признаков проблемы. Находку тоже надо разбирать, а не чинить вслепую: повтор запроса после сетевого сбоя, например, нормальное поведение.
Такие проверки я собрал в открытый инструмент PageTrace. Он читает записанную трассу (JSONL или HAR из браузера) и проверяет ее без запросов в сеть. В репозитории есть готовый пример сломанной трассы:
pip install pagetrace
pagetrace check examples/broken-cursor.jsonl
Формат трассы и список проверок — в README: https://github.com/Corner324/PageTrace (MIT).
Пять вопросов к загрузчику с пагинацией
1. Как API сообщает о конце списка, и что сделает загрузчик, если этот сигнал не придет?
2. Попадает ли в результат последняя неполная страница?
3. Обход идет по номеру позиции или по ключу? Если по номеру — может ли пройденная часть списка измениться во время обхода?
4. Если по ключу — уникален и неизменен ли он?
5. Записывает ли загрузчик трассу и сверяет ли число полученных записей с тем, что сообщил API?
Если хочется не читать, а чинить
Статья показывает, откуда берутся потери. Ловить их в чужом коде — отдельный навык, и чтением он не ставится. Поэтому из этого материала я собрал бесплатный практикум на Stepik: Пагинация API на Python: потери, дубли и бесконечный цикл.
Что там есть сверх статьи: — Четыре инцидента вместо одного примера. В двух вы получаете чужой сломанный загрузчик и трассу его запросов и чините его. В двух пишете проверку, которая находит потери и дубли по трассе.
— Автопроверка со сценариями сбоев. Она подменяет API под вашим кодом: меняет данные посреди обхода, повторяет последнюю страницу, игнорирует курсор. Если решение ошиблось, вы видите, на каком сценарии и какие запросы оно сделало.
— То, что в статью не влезло: почему нельзя останавливаться на неполной странице, что делать, когда API не обращает внимания на курсор, и как отличить в трассе повтор запроса от зацикливания.
— База для тех, кто с пагинацией не работал: вводный урок про запросы, страницы и чтение трассы.
Ставить ничего не нужно, задания решаются в браузере. Код заданий и все сценарии открыты, их можно забрать в свой проект: https://github.com/Corner324/pagination‑trainer.
Какие еще способы тихо потерять данные при пагинации вы встречали? Напишите в комментариях — самые интересные добавлю в практикум.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.