Shit happens, или как не ломаться, когда у облака плохой день (и у вас тоже)
Облака учат нас жить в нескольких зонах доступности. Правда, до мультизоны редко доходят руки: то нет времени на развёртывание, то прикладные сервисы не умеют работать в нескольких экземплярах, то сетевые задержки мешают системам взаимодействовать. Так и живём, пока не падает зона.
Пожар, сирены воют, инженеры в панике пытаются поднять системы, менеджеры ругаются и ищут виновных, бизнес теряет деньги. Спустя какое-то время провайдер восстанавливает работу зоны, а вы пишете постмортем.
Представим, что команда не только пережила это падение, но и собрала мультизональную инсталляцию в облаке с маршрутизацией, репликацией и балансировкой. Она обслуживает пользователей и, главное, продолжает работать, когда падает одна из зон доступности.
Казалось бы, всё хорошо. Но однажды у провайдера случается катастрофа: одна за другой падают зоны доступности, а сроки восстановления туманны.
Публичные облака строят сверхнадёжными, и мало кто думает, что зрелое облако может отказать целиком. Шанс мал, но не равен нулю. Обычно на этом месте мы останавливаемся и, размахивая кружкой пива, уходим холиварить про BCP и DRP, но не в этот раз. Сегодня поговорим о том, как масштабировать мультизональную модель на несколько независимых площадок — и не утонуть в сложности их эксплуатации.
Три поросенка кластера
Допустим, мы учли опыт падения облака целиком и развернули инфраструктуру на нескольких площадках. Возьмём родное облако, соседнее облако и пару-тройку железных серверов в арендованных стойках надёжного ЦОДа — он-то уж точно упадёт последним.
Разберём сценарий с кубером. Сети, данные, объектные хранилища и прочие приятные сердцу вещи оставим за скобками.
Задача кажется простой: поднять три кубера, организовать сетевую связность — и дело в шляпе! Но как только начинаешь продумывать архитектуру, выясняется, что путей минимум два:
Использовать управляемые сервисы облака
Развернуть всё самостоятельно на вычислительных ресурсах облака
Путь первый: управляемые сервисы
Изучив стеки, понимаем, что в первом случае площадки построены на разных технологиях:
любимое облако работает на vCloud Director;
не такое любимое — на OpenStack;
площадка в ЦОДе — на бесплатной платформе виртуализации oVirt.
Сервисы Managed Kubernetes в этих облаках тоже различаются. Повлиять на технологический стек мы почти не можем: состав компонентов по большей части определяет команда разработки облака. Получаем такую картину:
первая площадка: K8s 1.35.1, Cilium, собственные CSI с поддержкой ReadWriteMany и собственный Ingress-контроллер;
вторая: K8s 1.33.4, Calico, Ceph RBD и NGINX Ingress;
наш ЦОД, где технологии совпадают со стеком любимого облака: K8s 1.35.1, Cilium, oVirt CSI и NGINX Ingress. Ingress-контроллер приходится брать другой, так как любимое облако не предоставляет свой контроллер внешним пользователям.
В разных облаках различаются даже конфигурации одинаковых инструментов. Каждый собирает кластер по-своему, поэтому и настраивать его под свои сервисы придётся по-разному.
На разных площадках по-разному устроены сетевые политики и работают драйверы хранилищ. Не везде получится использовать один PVC для нескольких инстансов одной системы. А Ingress-контроллеры будут отличаться аннотациями и реализацией одинаковых функций.
К тому же для каждой площадки нужен свой инфраструктурный код. Под разные облака и гипервизоры придётся писать отдельные Terraform-модули, чтобы инфраструктура оставалась воспроизводимой.
И это только кластер. Поверх него придётся достроить ещё много всего — но желание что-то строить пропадает.
Путь второй: собрать всё самостоятельно
Во втором случае сборка и эксплуатация кластеров целиком ложатся на нас. Придётся следить за обновлениями компонентов облака и cloud-controller-manager — или писать свой и обновлять его, когда API облака меняется. Придётся проверять совместимость компонентов платформы между собой сразу на нескольких площадках. Придётся также отслеживать уязвимости в модулях платформы и планировать обновления на всех площадках, а это неизбежно добавит головной боли.
В итоге такая инсталляция, скорее всего, встанет в круглую сумму. Оценить расходы можно в калькуляторе совокупной стоимости.
Птица Говорун стоит целого зоопарка
Итак, мы хотели повысить отказоустойчивость сервисов, а получили три разных кластера, три набора инфраструктурных инструментов и перспективу провести месяцы за написанием Terraform-модулей. Альтернатива — платформа собственной сборки, которая требует много ресурсов на поддержание, развитие и обновление.
Хорошо бы иметь инструмент, который позволит создавать кластеры в разных инфраструктурах, приводить их к общему виду и управлять ими из одного места. И желательно, чтобы при падении этого самого места остальные кластеры не отправлялись вслед за ним.
Третий путь: унифицировать управление
И здесь к нашим двум путям добавляется третий, потому что примерно для таких задач мы и разрабатываем «Штурвал». В основе его архитектуры — разделение на кластер управления и клиентские кластеры. Первый отвечает за создание кластеров, управление их жизненным циклом, доступами и системными сервисами. Вторые — обычные Kubernetes-кластеры с собственным control plane, в которых работают пользовательские приложения.
Кластер управления «Штурвала» разместим в нашем ЦОДе на oVirt, клиентские кластеры — в vCloud Director, OpenStack и том же oVirt.
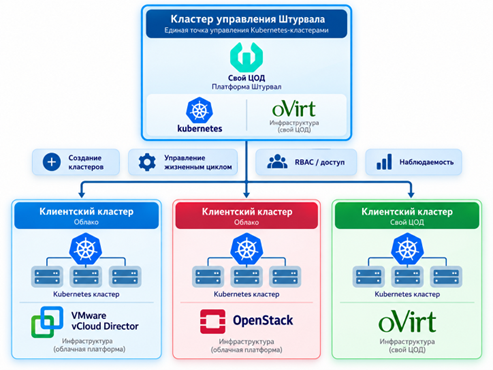
Под капотом «Штурвал» использует фреймворк Cluster API (CAPI) — проект экосистемы Kubernetes, позволяющий декларативно управлять жизненным циклом кластеров. Вместо того чтобы самостоятельно создавать виртуальные машины, инициализировать узлы и собирать Kubernetes из отдельных компонентов, мы описываем желаемое состояние кластера, а контроллеры занимаются его реализацией.
За взаимодействие с конкретными инфраструктурами отвечают соответствующие провайдеры Cluster API. Один работает с API OpenStack, другой — с vCloud Director, третий — с oVirt.
Для нас это означает, что все три кластера можно создавать и сопровождать через один интерфейс, несмотря на различия в виртуализации, сетях и хранилищах.
Конечно, при настройке каждого провайдера всё равно придётся указать параметры инфраструктуры: сети, шаблоны виртуальных машин, хранилища и учётные данные. «Штурвал» не делает OpenStack и oVirt одинаковыми, но избавляет от необходимости самостоятельно собирать и поддерживать три отдельных механизма развёртывания Kubernetes.
Общая конфигурация вместо трёх разных
Вспомним, с чего мы начинали: на одной площадке у нас Kubernetes 1.35 с Cilium, на другой — 1.33 с Calico, а на третьей — собственный набор компонентов.
Когда мы создаём кластеры через платформу, то получаем согласованный набор версий Kubernetes и системных компонентов. Вместо трёх подходов к устройству кластера — общая платформенная конфигурация.
Создаваемые кластеры настраиваются через ClusterProfile: можно задавать общие параметры Kubernetes, адреса реестров образов, внешние сервисы мониторинга и логирования, дополнительные манифесты. Вместо трёх кластеров, по-разному настроенных тремя инфраструктурными командами, получаем три кластера, собранных по общим правилам.
Различия в инфраструктуре при этом сохраняются. CSI для OpenStack и oVirt не становятся одним и тем же драйвером, а доступность ReadWriteMany по-прежнему зависит от возможностей конкретного хранилища. Но хотя бы Kubernetes и его эксплуатационные инструменты больше не требуется каждый раз собирать с нуля.
Централизованная эксплуатация
После создания кластеров начинается повседневная эксплуатация. Пользователям нужны доступы, приложениям — ресурсы, кластерам — обновления, а инженерам — возможность увидеть, что происходит на каждой площадке. В «Штурвале» эти задачи решаются централизованно. Из кластера управления мы можем управлять жизненным циклом клиентских кластеров и доступами, а также использовать общие инструменты наблюдаемости.
Для доставки приложений можно использовать интегрированный Argo CD. Единый GitOps-подход позволяет поддерживать нужные версии и конфигурации приложений на разных площадках, не превращая их в три независимых процесса развёртывания. У нас остаются три отдельных Kubernetes-кластера, но управлять ими становится значительно проще.
И вот что интересно: кластер управления «Штурвала» не участвует непосредственно в обработке пользовательских запросов в клиентских кластерах. У каждого из них собственный control plane, и при недоступности управляющего кластера уже запущенные приложения продолжат работать. Да, мы временно потеряем часть возможностей централизованного управления. Но аварийный доступ к клиентским кластерам можно получить через административный kubeconfig на узлах control plane. Получается довольно удобная конструкция: управление Kubernetes централизовано, а сами кластеры остаются независимыми друг от друга.
В результате у нас три Kubernetes-кластера в независимых инфраструктурах, но единый набор инструментов для их создания и сопровождения. При этом недоступность одной площадки не затрагивает Kubernetes-кластеры на остальных, если между ними нет общих критических зависимостей.
Важно сказать, что вы можете собрать похожую конфигурацию самостоятельно на открытых компонентах. Да, в ней не будет части возможностей вроде сквозной ролевой модели или нескучных обоев удобного веб-интерфейса, и работать с ней будет менее удобно. Но это тоже рабочая стратегия. Весь вопрос только в стоимости владения решением.
Вместо эпилога
Мы разобрали только инфраструктурную часть задачи. За кадром остались маршрутизация, репликация данных и обеспечение доступности самих приложений. Всё это придётся решать отдельно, но опыт построения мультизональной архитектуры поможет проще пройти оставшиеся этапы.
Всем ли нужна мультикластерная конфигурация? Совершенно точно нет. В идеале стоит сначала оценить бизнес-риски, требования к непрерывности работы сервисов и ресурсы на сопровождение мультикластерной архитектуры. Затем сравнить затраты на неё с потенциальными потерями, если отказаться от такого уровня избыточности.
Мультиклауд потребует заметных затрат на поддержку инфраструктуры на нескольких площадках. Команде понадобится дополнительная экспертиза, чтобы весь этот карнавал сопровождать и развивать. Ведь каждое новое решение всегда приносит нюансы, многие из которых проявляются только в эксплуатации.
Решить, нужна ли вам мультиклаудная архитектура, можете только вы. И если ответ будет положительным, становиться директором зоопарка совершенно необязательно. По крайней мере, в «Штурвале» мы постарались избавить команды от необходимости самостоятельно собирать и сопровождать отдельную систему управления Kubernetes для каждой площадки.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.