Оптимизация расхода ферромарганца в ДСП-3 с помощью Catboost
Привет, это Рамиль Максютов со второй частью цикла про плавки в ДСП-3. Первая часть тут: https://habr.com/ru/articles/1105616/
В этой статье на данных из первой части учим CatBoost предсказывать минимальную дозу ферромарганца для выплавки отливки из стали 35Л в дуговой сталеплавильной печи с основной футеровкой.
Что мы предсказываем
Цель — минимальная доза ФМн78, которая доводит марганец ровно до нижней границы ГОСТ 977-88 (0,45 %) при том усвоении, которое плавка реально имела:
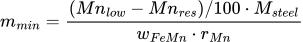
Здесь Mn_low = 0,45 % — нижняя граница, Mn_res — остаточный марганец от шихты, M_steel — масса жидкой стали (около 3000 кг), w_FeMn — доля марганца в ФМн78 (0,78), r_Mn — усвоение марганца. Мастер усвоение заранее не знает, и в этом вся задача: модель должна оценить m_min по величинам, которые известны до добавки.
Если вы не читали первую статью: усвоение в генераторе падает при перегреве, избытке кислорода и низкой основности шлака. Модель этих правил не видит и должна восстановить их по данным.
Что модель видит на входе
Признак | Почему его можно наблюдать до добавки |
|---|---|
scrap_2a_kg, scrap_6a_kg, pig_iron_kg | веса завалки известны с весовой |
oxygen_m3 | расходомер кислорода пишет объём во время продувки |
slag_basicity | основность перед выпуском измеряется по пробе шлака |
tap_temp_c | погружной термопарой осуществляется замер до добавки ферросплавов в ковш |
carbon_pct | экспресс-проба после продувки |
В признаки не попало ничего «из будущего»: ни доза femn78_kg, ни итоговый manganese_pct, ни mn_recovery, ни ликвидус, ни перегрев, ни gost_pass. Если подать модели mn_recovery, она покажет идеальные метрики. Это самая частая ошибка в таких задачах, поэтому список признаков в коде задан явно.
Разбиение данных
В первом варианте скрипта обучения тестовая выборка одновременно была eval_set для ранней остановки и источником финальных метрик. Такая оценка чуть оптимистична: модель выбирает число деревьев по тем же данным, на которых потом оценивается. Теперь три части:
Часть | Плавок | Для чего |
|---|---|---|
train | 1280 | обучение деревьев |
validation | 320 | ранняя остановка и выбор лучшей итерации |
test | 400 | финальные метрики, модель её не видела |
Код model.py
Сначала импорты, список признаков и формула цели. Константы берутся из генератора, чтобы цель считалась по тем же числам, по которым создавались данные:
from __future__ import annotations

import argparse
import json
from pathlib import Path

import numpy as np
import pandas as pd
from catboost import CatBoostRegressor, Pool
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score
from sklearn.model_selection import train_test_split

from .generator import (
    FEMN_MN_CONTENT,
    GOST_MANGANESE,
    LIQUID_STEEL_KG,
    RESIDUAL_MN,
)

FEATURES = [
    "scrap_2a_kg",
    "scrap_6a_kg",
    "pig_iron_kg",
    "oxygen_m3",
    "slag_basicity",
    "tap_temp_c",
    "carbon_pct",
]
TARGET = "femn78_min_kg"
HEADROOM = "femn78_headroom_kg"


def min_femn_dose(mn_recovery):
    """FeMn78 dose (kg) that lands manganese on the lower GOST limit."""
    needed_pct = GOST_MANGANESE[0] - RESIDUAL_MN
    return needed_pct / 100.0 * LIQUID_STEEL_KG / (FEMN_MN_CONTENT * mn_recovery)


def add_targets(df: pd.DataFrame) -> pd.DataFrame:
    out = df.copy()
    out[TARGET] = min_femn_dose(out["mn_recovery"])
    out[HEADROOM] = out["femn78_kg"] - out[TARGET]
    return out
HEADROOM — разница между тем, что фактически добавили, и минимумом. О том, как её читать, — в конце раздела.
Обучение:
def train(
    df: pd.DataFrame,
    seed: int = 42,
    iterations: int = 1000,
) -> tuple[CatBoostRegressor, dict]:
    data = add_targets(df)
    dev, test = train_test_split(data, test_size=0.2, random_state=seed)
    train_part, val = train_test_split(dev, test_size=0.2, random_state=seed)

    model = CatBoostRegressor(
        iterations=iterations,
        learning_rate=0.05,
        depth=6,
        loss_function="MAE",
        random_seed=seed,
        verbose=0,
        allow_writing_files=False,
    )
    model.fit(
        Pool(train_part[FEATURES], train_part[TARGET]),
        eval_set=Pool(val[FEATURES], val[TARGET]),
        early_stopping_rounds=100,
        use_best_model=True,
    )

    pred = model.predict(test[FEATURES])
    mse = mean_squared_error(test[TARGET], pred)
    baseline = np.full(len(test), train_part[TARGET].median())

    importance = model.get_feature_importance()
    metrics = {
        "n_rows": int(len(data)),
        "n_train": int(len(train_part)),
        "n_val": int(len(val)),
        "n_test": int(len(test)),
        "best_iteration": int(model.get_best_iteration()),
        "test_mae_kg": float(mean_absolute_error(test[TARGET], pred)),
        "test_rmse_kg": float(np.sqrt(mse)),
        "test_r2": float(r2_score(test[TARGET], pred)),
        "baseline_mae_kg": float(mean_absolute_error(test[TARGET], baseline)),
        "target_std_kg": float(data[TARGET].std()),
        "gost_pass_rate": float(data["gost_pass"].mean()),
        "headroom_true_mean_kg": float(data[HEADROOM].mean()),
        "headroom_predicted_test_mean_kg": float((test["femn78_kg"] - pred).mean()),
        "feature_importance": {
            name: float(value) for name, value in zip(FEATURES, importance)
        },
    }
    return model, metrics
Что здесь стоит отметить:
loss_function="MAE" минимизирует среднюю абсолютную ошибку в килограммах, которую технолог понимает на интуитивном уровне.
allow_writing_files=False не даёт CatBoost создавать в рабочей папке каталог catboost_info.
baseline — предсказывать медиану обучающей выборки. Без неё цифра MAE ничего не значит: 0,35 кг — это мало или много? Надо сравнивать с простейшей альтернативой.
get_best_iteration() показывает, где сработала ранняя остановка. У меня она на итерации 164 из 1000.
Сохранение, загрузка и предсказание:
def load_model(path: str | Path) -> CatBoostRegressor:
    model = CatBoostRegressor()
    model.load_model(str(path))
    return model


def predict_min_dose(model: CatBoostRegressor, **features: float) -> float:
    row = pd.DataFrame([features], columns=FEATURES)
    return float(model.predict(row)[0])


def main() -> None:
    parser = argparse.ArgumentParser(description="Train the minimum FeMn78 dose model.")
    parser.add_argument("--data", type=Path, default=Path("data/eaf_melts_2000.csv"))
    parser.add_argument("--model", type=Path, default=Path("models/fmn78_model.cbm"))
    parser.add_argument("--metrics", type=Path, default=Path("models/metrics.json"))
    parser.add_argument("--seed", type=int, default=42)
    args = parser.parse_args()

    df = pd.read_csv(args.data)
    model, metrics = train(df, seed=args.seed)

    args.model.parent.mkdir(parents=True, exist_ok=True)
    model.save_model(str(args.model))
    args.metrics.write_text(json.dumps(metrics, indent=2, ensure_ascii=False))

    print(f"test MAE:      {metrics['test_mae_kg']:.3f} kg")
    print(f"test RMSE:     {metrics['test_rmse_kg']:.3f} kg")
    print(f"test R2:       {metrics['test_r2']:.3f}")
    print(f"baseline MAE:  {metrics['baseline_mae_kg']:.3f} kg (train median)")
    print(f"saved model to {args.model}, metrics to {args.metrics}")


if __name__ == "__main__":
    main()
Модель сохраняется в родном формате CatBoost (.cbm), а не в pickle. Pickle может выполнить произвольный код при загрузке, поэтому публиковать такой файл в открытом доступе не хотелось бы.
python -m eafsim.modeltest MAE: 0.352 kg
test RMSE: 0.442 kg
test R2: 0.836
baseline MAE: 0.873 kg (train median)
saved model to models/fmn78_model.cbm, metrics to models/metrics.jsonКак читать метрики
Метрика | Значение |
|---|---|
MAE на тесте | 0,352 кг |
MAE при предсказании медианы обучающей выборки | 0,873 кг |
RMSE на тесте | 0,442 кг |
R² на тесте | 0,836 |
Стандартное отклонение цели | 1,073 кг |
Модель ошибается в среднем на 0,35 кг, а простая медиана — на 0,87 кг, то есть примерно в 2,5 раза больше. Для данных с шумом это хороший результат, но надо помнить: модель восстанавливает правила, заложенные в генераторе, а основная часть ошибки идёт от шума furnace_noise, который по определению непредсказуем.
Важность признаков
Признак | Важность, % |
|---|---|
slag_basicity | 69,7 |
oxygen_m3 | 10,8 |
pig_iron_kg | 6,6 |
tap_temp_c | 3,7 |
carbon_pct | 3,4 |
scrap_6a_kg | 3,0 |
scrap_2a_kg | 2,8 |
Основность объясняет большую часть, и это следует из устройства генератора: из трёх штрафов на этих данных реально работает один. Температура и кислород почти не влияют не потому, что они неважны в печи, а потому, что в сгенерированных плавках они не заходят в область, где штраф включается. Подробнее — в первой статье, в разделе про данные.
Что означает «запас» в килограммах
В датасете мастер в среднем добавляет 26,9 кг ФМн78, а расчётный минимум в среднем порядка 17 кг. Разница (HEADROOM) в среднем равна 9,84 кг на плавку, а по прогнозам модели на тесте — 9,96 кг.
Это верхняя оценка!!!, а не прогноз экономии. Цель считается от ровно нижней границы 0,45 %, без запаса надёжности. В цехе так дозировать нельзя: любая ошибка модели в минус означает брак по марганцу. Рабочую дозу считаем как предсказание плюс запас (в приложении он задаётся ползунком), и чем больше запас, тем меньше экономия.
Приложение на Streamlit
Приложение лежит в app.py рядом с пакетом и читает три готовых файла: data/eaf_melts_2000.csv, models/fmn78_model.cbm и models/metrics.json. Ничего не обучается на лету, поэтому оно открывается мгновенно, а метрики на экране ровно те, что напечатал скрипт обучения.
На четырёх вкладках:
Обзор — метрики, важность признаков и гистограмма запаса;
Датасет — таблица, скачивание и словарь колонок;
Калькулятор — ползунки шихты и параметров плавки, ответ в килограммах;
О проекте — что это и чем не является.
Импорты, пути и тексты
Приложение двуязычное (английский и русский). Все строки лежат в словаре TEXT, ключи одинаковые для обоих языков. В статье словарь целиком не привожу: он занимает около 180 строк и состоит из подписей и пояснений. Вот его форма:
import json
from pathlib import Path

import pandas as pd
import plotly.express as px
import streamlit as st

from eafsim.generator import CHARGE_KG, COLUMNS, FEMN_RANGE, SCRAP_2A_RANGE
from eafsim.model import FEATURES, HEADROOM, add_targets, load_model, predict_min_dose

ROOT = Path(__file__).parent
DATA_PATH = ROOT / "data" / "eaf_melts_2000.csv"
MODEL_PATH = ROOT / "models" / "fmn78_model.cbm"
METRICS_PATH = ROOT / "models" / "metrics.json"

st.set_page_config(page_title="EAF melt simulator", page_icon="🔥", layout="wide")

TEXT = {
    "en": {"title": "...", "tab_overview": "Overview", "m_mae": "Test MAE, kg", ...},
    "ru": {"title": "...", "tab_overview": "Обзор", "m_mae": "MAE на тесте, кг", ...},
}
Полный словарь — в app.py в репозитории. Подписи с подстановкой (например, warn_low) содержат {lo:.0f} и {hi:.0f}: их подставляет str.format, когда рекомендованная доза оказывается ниже обучающего диапазона.
Загрузка и общий каркас
Данные и модель кэшируются: st.cache_data для таблицы, st.cache_resource для объекта CatBoost. Если одного из трёх файлов нет, приложение не падает с трейсбеком, а говорит, что запустить.
@st.cache_data
def load_data(path: Path) -> pd.DataFrame:
    return pd.read_csv(path)


@st.cache_resource
def get_model(path: Path):
    return load_model(path)


missing = [p.name for p in (DATA_PATH, MODEL_PATH, METRICS_PATH) if not p.exists()]
if missing:
    st.error(
        f"Missing files: {', '.join(missing)}. Run "
        "`python -m eafsim.generator` and `python -m eafsim.model` first."
    )
    st.stop()

lang_label = st.radio("Language / Язык", ["English", "Русский"], horizontal=True)
t = TEXT["en" if lang_label == "English" else "ru"]
lang = "en" if lang_label == "English" else "ru"

df = load_data(DATA_PATH)
model = get_model(MODEL_PATH)
metrics = json.loads(METRICS_PATH.read_text())
enriched = add_targets(df)

st.title(t["title"])
st.markdown(t["subtitle"])

tab_overview, tab_dataset, tab_calc, tab_about = st.tabs(
    [t["tab_overview"], t["tab_dataset"], t["tab_calc"], t["tab_about"]]
)
Вкладка «Обзор»
Пять метрик сверху, под ними важность признаков и гистограмма запаса. Метрики читаются из metrics.json, а не пересчитываются: приложение показывает ровно те числа, что получил обучающий скрипт.
with tab_overview:
    c1, c2, c3, c4, c5 = st.columns(5)
    c1.metric(t["m_heats"], f"{metrics['n_rows']:,}".replace(",", " "))
    c2.metric(t["m_pass"], f"{metrics['gost_pass_rate']:.1%}")
    c3.metric(t["m_mae"], f"{metrics['test_mae_kg']:.3f}", help=t["m_mae_help"])
    c4.metric(t["m_baseline"], f"{metrics['baseline_mae_kg']:.3f}", help=t["m_baseline_help"])
    c5.metric(t["m_headroom"], f"{metrics['headroom_true_mean_kg']:.2f}", help=t["m_headroom_help"])

    left, right = st.columns(2)
    with left:
        st.subheader(t["importance"])
        imp = pd.DataFrame(
            {
                "feature": list(metrics["feature_importance"]),
                "importance": list(metrics["feature_importance"].values()),
            }
        )
        fig = px.bar(imp, x="importance", y="feature", orientation="h", labels={"importance": t["importance_x"], "feature": ""})
        fig.update_layout(yaxis={"categoryorder": "total ascending"}, height=340, margin={"l": 0, "r": 0, "t": 10, "b": 0})
        st.plotly_chart(fig, width="stretch")
    with right:
        st.subheader(t["headroom_hist"])
        fig = px.histogram(enriched, x=HEADROOM, nbins=40, labels={HEADROOM: t["headroom_x"]})
        fig.update_layout(height=340, margin={"l": 0, "r": 0, "t": 10, "b": 0}, yaxis_title="")
        st.plotly_chart(fig, width="stretch")
    st.caption(t["overview_note"])
Вкладка «Датасет»
Первые 200 строк, кнопка скачивания и таблица-словарь колонок, которая строится прямо из COLUMNS генератора. Описания не дублируются: поменял словарь в одном месте, обновились и README, и приложение.
with tab_dataset:
    st.subheader(t["dataset_header"])
    st.dataframe(df.head(200), width="stretch")
    st.download_button(t["download"], df.to_csv(index=False).encode("utf-8"), "eaf_melts_2000.csv", "text/csv")
    st.subheader(t["columns_header"])
    schema = pd.DataFrame(
        [
            {t["col_name"]: name, t["col_unit"]: spec["unit"], t["col_desc"]: spec[lang]}
            for name, spec in COLUMNS.items()
        ]
    )
    st.dataframe(schema, width="stretch", hide_index=True)
Калькулятор
Главная вкладка для демонстрации. Пользователь задаёт шихту и параметры плавки, модель отвечает минимальной дозой ФМн78. Лом 2А не вводится вручную, а считается как остаток от 3300 кг: так сумма шихты всегда сходится, и в приложении нельзя собрать плавку, невозможную для генератора. Если получившийся 2А вне обучающего диапазона, показывается предупреждение: модель в этой области экстраполирует.
with tab_calc:
    st.subheader(t["calc_header"])
    st.caption(t["calc_hint"])

    col_a, col_b = st.columns(2)
    with col_a:
        scrap_6a = st.slider(t["s_6a"], 400, 1300, 900, 10)
        pig_iron = st.slider(t["s_pig"], 200, 400, 250, 5)
        scrap_2a = CHARGE_KG - scrap_6a - pig_iron
        st.metric(t["derived_2a"], f"{scrap_2a:.0f}")
        if not SCRAP_2A_RANGE[0] <= scrap_2a <= SCRAP_2A_RANGE[1]:
            st.warning(t["warn_2a"])
        carbon = st.slider(t["s_carbon"], 0.30, 0.42, 0.36, 0.005)
    with col_b:
        oxygen = st.slider(t["s_o2"], 35.0, 75.0, 42.0, 0.5)
        basicity = st.slider(t["s_basicity"], 1.8, 2.9, 2.4, 0.05)
        tap_temp = st.slider(t["s_temp"], 1530, 1660, 1558, 1)
        reference = st.number_input(t["ref_dose"], value=27.0, step=0.5)
        margin = st.slider(t["margin"], 0.0, 3.0, 0.5, 0.1)

    recommended = predict_min_dose(
        model,
        scrap_2a_kg=scrap_2a,
        scrap_6a_kg=scrap_6a,
        pig_iron_kg=pig_iron,
        oxygen_m3=oxygen,
        slag_basicity=basicity,
        tap_temp_c=tap_temp,
        carbon_pct=carbon,
    )
    with_margin = recommended + margin

    r1, r2, r3 = st.columns(3)
    r1.metric(t["r_min"], f"{recommended:.2f} kg")
    r2.metric(t["r_margin"], f"{with_margin:.2f} kg")
    r3.metric(t["r_delta"], f"{reference - with_margin:.2f} kg")
    if recommended < FEMN_RANGE[0]:
        st.info(t["warn_low"].format(lo=FEMN_RANGE[0], hi=FEMN_RANGE[1]))

with tab_about:
    st.markdown(t["about"])
Запускать так:
streamlit run app.pyТесты
Восемь тестов проверяют не «код запускается», а свойства, на которых держится честность проекта: воспроизводимость, разнообразие значений (ровно тот дефект со ступенчатой функцией), совпадение колонок со словарём, и что модель после сохранения и загрузки даёт те же предсказания.
import numpy as np
import pandas as pd
import pytest

from eafsim.generator import (
    COLUMNS,
    PIG_IRON_RANGE,
    SCRAP_2A_RANGE,
    SCRAP_6A_RANGE,
    simulate,
)
from eafsim.model import FEATURES, TARGET, add_targets, load_model, predict_min_dose, train


@pytest.fixture(scope="module")
def heats() -> pd.DataFrame:
    return simulate(n=600, seed=7)


def test_simulation_is_reproducible():
    pd.testing.assert_frame_equal(simulate(n=200, seed=1), simulate(n=200, seed=1))


def test_different_seeds_differ():
    assert not simulate(n=200, seed=1).equals(simulate(n=200, seed=2))


def test_columns_are_documented(heats):
    assert list(heats.columns) == list(COLUMNS)


def test_charge_is_fixed_and_within_ranges(heats):
    total = heats["scrap_2a_kg"] + heats["scrap_6a_kg"] + heats["pig_iron_kg"]
    assert total.between(3300 - 2, 3300 + 2).all()
    assert heats["scrap_2a_kg"].between(*SCRAP_2A_RANGE).all()
    assert heats["scrap_6a_kg"].between(*SCRAP_6A_RANGE).all()
    assert heats["pig_iron_kg"].between(*PIG_IRON_RANGE).all()


def test_both_outcomes_present(heats):
    rate = heats["gost_pass"].mean()
    assert 0.5 < rate < 1.0


def test_recovery_has_many_distinct_values(heats):
    assert heats["mn_recovery"].nunique() > 50


def test_min_dose_is_below_actual_dose_on_average(heats):
    enriched = add_targets(heats)
    assert (enriched["femn78_kg"] - enriched[TARGET]).mean() > 0


def test_train_save_load_predict(tmp_path, heats):
    model, metrics = train(heats, seed=0, iterations=150)
    assert np.isfinite(metrics["test_mae_kg"])
    assert metrics["test_mae_kg"] < metrics["baseline_mae_kg"]

    path = tmp_path / "model.cbm"
    model.save_model(str(path))
    restored = load_model(path)

    row = heats.iloc[0][FEATURES].to_dict()
    assert predict_min_dose(restored, **row) == pytest.approx(predict_min_dose(model, **row))
Самый полезный из них — test_recovery_has_many_distinct_values: он ловит вырождение цели в несколько значений, из-за которого у меня первый вариант показывал ложный MAE.
Итоги
Модель восстанавливает минимальную дозу ФМн78 с ошибкой 0,35 кг против 0,87 кг у медианы. Хорошая метрика на синтетике ничего не доказывает о реальной печи: модель учит правила генератора. Ценно то, что техника работает: честный сплит на три части, бейзлайн, признаки только из «прошлого».
Куда развивать:
Подставить реальные диапазоны и пороги с печи.
Добавить режимы, при которых штрафы за перегрев и кислород реально срабатывают.
Перейти на квантильную регрессию (возможно).
Сравнить с реальными плавками, если кто-то может их дать.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.