Пулы под NVMe: как мы переработали хранение данных в all-flash СХД
Скоростные NVMe-диски диктуют свои правила: рост производительности идет рука об руку с потребностью экономить каждый гигабайт и продлевать жизнь накопителям. Все это достигается грамотной работой с данными. Именно поэтому для новой all-flash СХД TATLIN.AFA мы переработали пулы с косвенной адресацией. В статье разберу архитектуру пулов 2.0: запись полным страйпом без RMW, inline-компрессию и будущую дедупликацию.
Привет, Хабр! Меня зовут Алексей Шушарин, я архитектор Data Path в департаменте СХД YADRO и разрабатываю ПО для продуктов TATLIN. В прошлой статье я рассказывал о компоненте Mapper и пулах с косвенной адресацией в TATLIN.UNIFIED. Эта статья — продолжение того разговора, но у нее есть важный повод: компания представила новый продукт, а вместе с ним и значительные изменения компонента Mapper.
TATLIN.AFA: новая платформа, новые требования к пулам
TATLIN.AFA — новая all-flash СХД старшего уровня и первая в России All-NVMe система хранения. Она построена на нашей модульной платформе TATLIN.X. Система умещается в компактном 2U-формате и обеспечивает более 2 миллионов IOPS и до 50 ГБ/с пропускной способности, а также поддерживает длинные схемы защиты данных и онлайн-компрессию на лету.
TATLIN.AFA работает на том же ПО TATLIN.OS, что и UNIFIED, поэтому почти весь функционал, к которому вы привыкли, доступен и здесь, но на полностью новой аппаратной платформе. Один из ключевых слоев TATLIN.OS — Mapper, который отвечает за реализацию пулов с косвенной адресацией. Для новой СХД мы существенно переработали этот компонент. All-flash конфигурация потребовала алгоритмов хранения, оптимизированных под твердотельные накопители и способных эффективно работать с длинными схемами защиты данных. Кроме того, переработка закладывалась как фундамент для двух функций, которые невозможно реализовать в прежней схеме — компрессии и дедупликации. О том, как были устроены прежние пулы и какие новые возможности появились в пулах 2.0, я расскажу в этой статье.
Архитектура пулов 2.0: от Bitmap Allocator к двухуровневой адресации
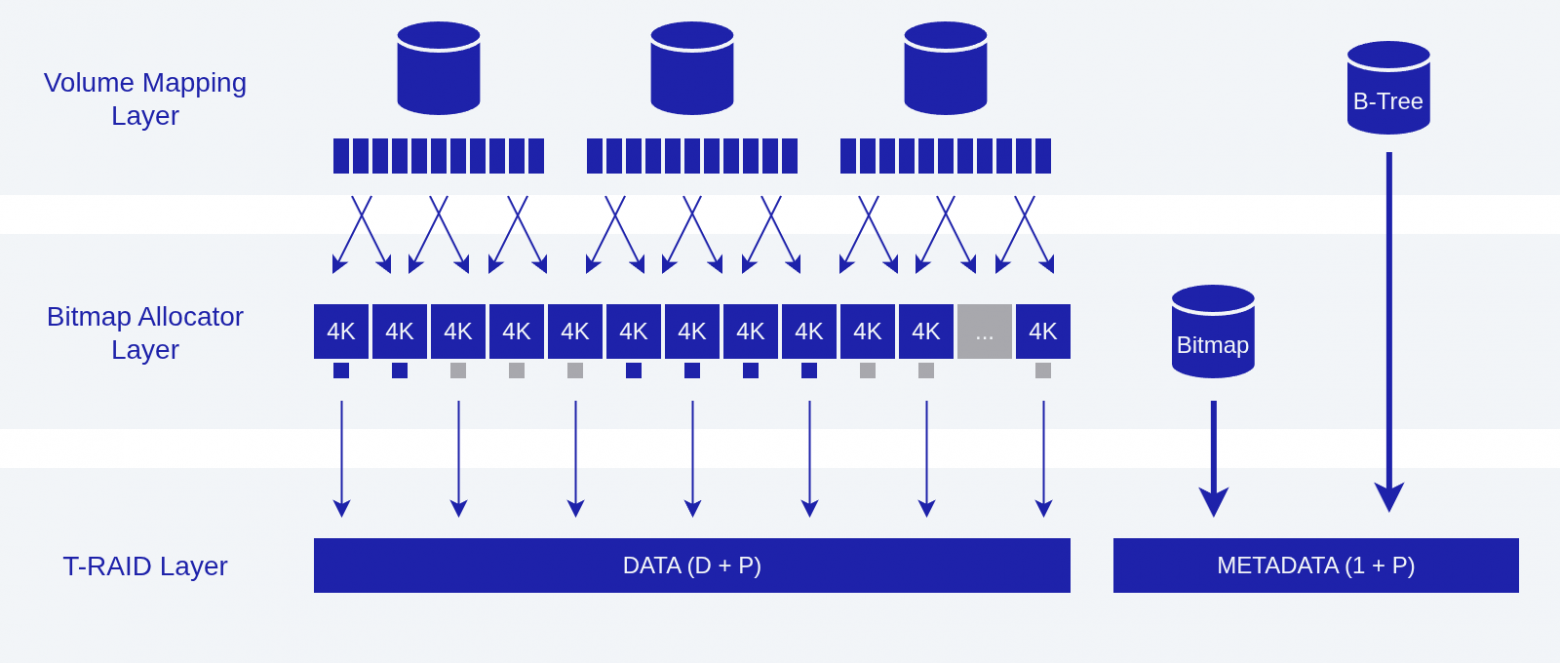
Пул с косвенной адресацией — это пул накопителей, обеспечивающий защиту данных согласно выбранной схеме и предназначенный для создания тонких томов, поддерживающих RoW-снапшоты (Redirect-on-Write, «перенаправление при записи») и клоны. Такой пул формируется из нескольких уровней программного стека.
Volume Mapping Layer — отображает логические адреса тома в адреса уровня ниже. На этом уровне находятся тонкие тома, снапшоты и клоны. Как он устроен, включая структуру B-Tree для преобразования адресов, мы подробно разбирали в отдельной статье.
Bitmap Allocator Layer — выделяет блоки под записываемые данные. Информацию о том, какие блоки заняты, а какие свободны, он хранит в битовой карте в области метаданных.
T-RAID Layer — обеспечивает отказоустойчивость за счет избыточного кодирования. Данные защищаются по схеме D+P, метаданные — по схеме 1+P. О T-RAID есть отдельная статья. Кстати, в TATLIN.AFA мы добавили новые длинные цепочки защиты, такие как 10+2, 10+3 и 14+2, и планируем расширять этот список еще более экономичными схемами
В пулах 2.0 стек претерпел существенные изменения. На смену Bitmap Allocator пришла более гибкая двухуровневая схема косвенной адресации.
Pool Mapping Layer — новый слой отображения адресов на уровне пула. его основная задача — обеспечить возможность изменять физическое расположение данных, не затрагивая верхние слои адресации. Это стало основой для фоновой сборки мусора и переупаковки данных на физических носителях, что позволило избежать операций Read-Modify-Write (RMW) и всегда выполнять запись полным страйпом.
Slab Allocator Layer — отвечает за аллокацию блоков и использует битовую карту для их учета, но в отличие от Bitmap Allocator оперирует более крупными блоками, слэбами по 2 МБ, что позволяет существенно сократить размер битовой карты.
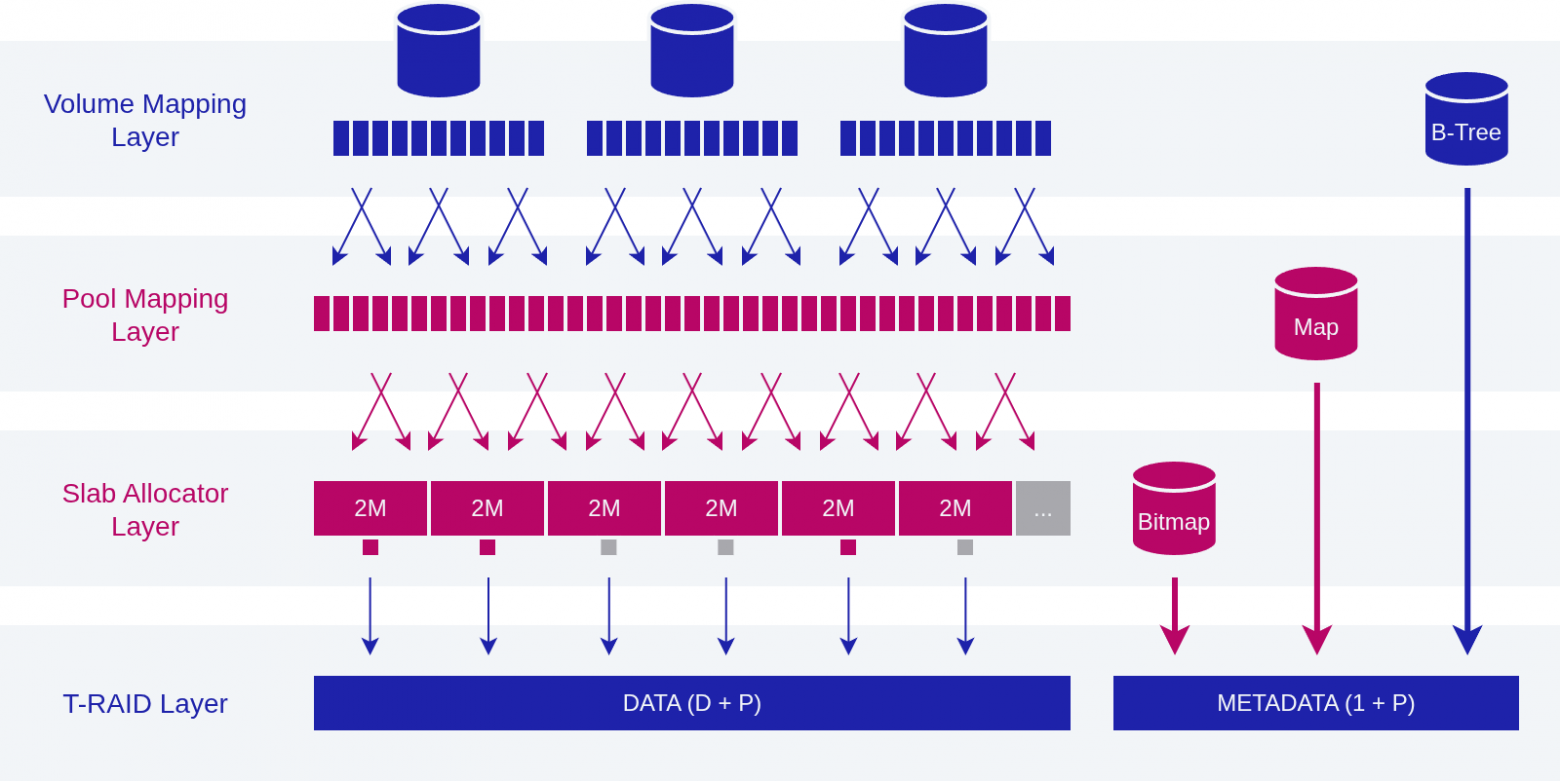
В результате пулы 2.0 получили более гибкую и эффективную схему адресации, которая стала основой для ряда ключевых возможностей:
Запись полным страйпом. Запись данных всегда выполняется полным страйпом, что обеспечивает максимальную производительность. Частичное обновление страйпа с помощью операции RMW больше не требуется.
Сквозной Trim/Unmap. Поддержка операции Unmap на всем пути данных позволяет получить максимальную производительность и обеспечить долговечность SSD-накопителей.
Сборщик мусора. Фоновый процесс переупаковывает данные, перемещая актуальные данные в новые, более плотные структуры и освобождая устаревшие блоки.
Компрессия. Благодаря новому уровню косвенной адресации стало возможным адресовать блоки данных переменной длины — это позволяет внедрять компрессию данных как в потоке записи, так и в фоновом режиме.
Дедупликация. Новый уровень косвенной адресации включает механизм хранения счетчиков ссылок на блоки данных, что открывает возможность для реализации дедупликации.
Пулы 2.0 в работе: запись, сборка мусора и приоритеты IO
Рассмотрим, как пулы 2.0 работают на практике, на примере двух сценариев: записи данных и фоновой сборки мусора. А также разберем, как приоритизация IO позволяет этим процессам не мешать друг другу.
Только полный страйп: скорость, ресурс SSD и меньше лишних записей
Важное свойство пулов 2.0 — запись полными страйпами. Косвенная адресация позволяет размещать данные гибко, а кеш на запись дает возможность накапливать и группировать запросы. Вместе они превращают любую, даже самую «рваную» случайную запись в последовательную запись крупными блоками, полными страйпами. У такого подхода несколько значительных преимуществ.
Скорость. Случайная запись для накопителей ощутимо медленнее последовательной. Превращая случайные запросы в последовательные крупные блоки, мы даем накопителю работать в его самом быстром режиме.
Долговечность. Прежде чем записать небольшой объем данных, приходится стирать целый большой блок: твердотельные накопители имеют конечный ресурс записи. Дружелюбная к флеш-памяти нагрузка в виде крупных последовательных записей продлевает срок жизни накопителей.
Эффективность. Записывая полный страйп, мы формируем все необходимые контрольные суммы за один проход. При частичном изменении страйпа пришлось бы не только пересчитывать контрольные суммы, но и записывать новые контрольные суммы и обновленные данные на диск, что заметно увеличивает объем записанных данных. Полнострайповая запись избавляет от этих лишних операций записи, что особенно важно для длинных схем защиты, где страйп включает много блоков данных.
Путь данных от кеша до дисков
В первую очередь данные попадают в энергонезависимый кеш на запись, где сохраняются, а хост получает подтверждение записи. Дальнейшие шаги выглядят так:
В кеше на запись данные накапливаются и группируются, поэтому любой паттерн записи, мелкие случайные запросы или крупные последовательные, превращается в последовательную запись крупными блоками.
Накопленные данные записываются на диск слэбами, причем запись организована так, чтобы минимизировать количество операций. Минимальная единица записи — полный страйп, но на практике за раз записывается сразу несколько страйпов. Так на каждый диск ложится большой объем данных подряд, что для накопителей эффективнее, чем писать отдельные небольшие порции.
По завершении записи данных выполняется транзакционное обновление метаданных. Если во время записи произошла ошибка, метаданные не обновляются, и система остается в согласованном состоянии.
Важная деталь: новые данные всегда записываются в свободные слэбы, даже если выполняется перезапись уже существующих. Это полностью исключает операцию Read-Modify-Write.
Откуда берется «мусор» и как его убирают
Устаревшие блоки, материал для будущей сборки мусора, появляются в пуле тремя путями:
Перезапись данных. При перезаписи новые данные записываются в свободные слэбы, а старые блоки, ранее содержавшие эти данные, помечаются как устаревшие.
Операция Unmap. Unmap помечает блоки данных как устаревшие, после чего эти данные освобождаются и становятся доступными для повторного использования.
Удаление. При удалении тома или снапшота происходит тот же процесс: принадлежавшие ему блоки помечаются как устаревшие.
«Мусорные» блоки нужно так или иначе возвращать в оборот. За это отвечает фоновая сборка мусора, ее работа тоже складывается из этапов:
Сборка мусора запускается, когда в пуле накапливается достаточное количество устаревших блоки. В первую очередь обрабатываются слэбы с максимальным количеством устаревших блоков. Так за один проход освобождается больше всего пространства.
Актуальные данные из выбранных слэбов копируются в новые слэбы, а оригинальные слэбы, содержащие устаревшие блоки, освобождаются.
По завершении копирования происходит обновление метаданных, так что те же адреса Pool Mapping Layer теперь указывают на другое физическое расположение данных.
Для освобожденных слэбов выполняется операция Trim, которая сообщает дискам, какие блоки можно пометить как свободные. Это избавляет накопители от лишних копирований и продлевает их ресурс.
У сборки мусора есть своя цена: переупаковка данных создает дополнительные операции чтения и записи, увеличивая общий write amplification. Однако у этого процесса есть два свойства, которые позволяют свести его влияние на пользовательскую нагрузку к минимуму. Во-первых, сборка мусора выполняется в фоне, зачастую в моменты в моменты простоя системы, когда пользовательской нагрузки нет, или она минимальна, поэтому сборка не влияет на обработку пользовательского IO. Во-вторых, ощутимую нагрузку она вносит только при нехватке свободного места в пуле.
Три приоритета IO: как запись и сборка мусора не мешают друг другу
Чтение, запись и фоновая сборка мусора постоянно конкурируют за процессорные и дисковые ресурсы. Чтобы они не мешали друг другу, обновленная реализация компонента Mapper вводит понятие приоритета обработки IO. Каждому запросу ввода-вывода назначается приоритет в зависимости от его типа. Благодаря этому система может планировать использование процессора и дисковых ресурсов, минимизируя задержку обработки входящих запросов. Определены три вида IO:
Cache Bypass IO. Операции ввода-вывода, работающие напрямую с дисками. Задержка при обработке таких операций напрямую влияет на время получения ответа хостом, поэтому они имеют наивысший приоритет, что обеспечивает минимальную задержку.
Cache Flush IO. Операции записи, выполняемые при сбросе кеша на запись. Сами по себе они не оказывают прямого влияния на задержку обработки входящих запросов, поэтому имеют меньший приоритет. Однако по мере заполнения кеша приоритет этих операций повышается, чтобы освободить в нем место для новых запросов, иначе входящие записи начнут ждать освобождения места, что скажется на времени ответа хосту.
Garbage Collection IO. Операции ввода-вывода, инициируемые процессом сборки мусора. По умолчанию они обладают наименьшим приоритетом, что позволяет выполнять сборку мусора в фоновом режиме, исключая негативное влияние на пользовательское IO. Однако по мере исчерпания свободных слэбов в пуле приоритет сборки мусора увеличивается, чтобы система не осталась без свободного места.
Data Reduction: inline и офлайн-обработка
Поговорим о компрессии и дедупликации, функциях, которые стали возможны благодаря переработке пулов и которые напрямую экономят полезную емкость для пользователя. Обе функции объединяются под общим термином Data Reduction.
Начнем с того, какими бывают эти функции. И компрессия, и дедупликация предлагают два принципиально разных подхода в зависимости от того, когда именно они выполняются.
Inline — обработка на лету, непосредственно на пути записи данных. Пока данные еще находятся в памяти системы, они сразу проходят компрессию или дедупликацию и на диск попадают уже в обработанном виде.
Плюс: место освобождается сразу, никакого «долга» на будущее, полезная емкость растет немедленно.
Минус: встраивание в горячий путь записи добавляет нагрузку на процессорные ресурсы.
Offline — фоновая обработка уже записанных данных. Данные изначально ложатся на диск в исходном виде, а их сжатие или дедупликация выполняются отдельным фоновым процессом, когда система менее загружена.
Плюс: не влияет на путь записи, не увеличивает задержку пользовательских операций.
Минус: место начинает освобождаться не сразу, а по мере работы фонового процесса.
По своей природе фоновая обработка напоминает сборщик мусора, о котором я рассказывал ранее: данные перекладываются и переписываются в фоне, в удобный момент, без влияния на основную нагрузку.
В TATLIN.AFA эти функции появляются поэтапно. В новом релизе 4.1 работает inline-компрессия — сжатие на лету, прямо на пути записи. В следующих релизах к ней добавятся офлайн-компрессия, которая обрабатывает уже записанные данные в фоне, и затем дедупликация.
Структура хранения: как она открывает путь к компрессии и дедупликации
В первой версии пулов косвенной адресации структура хранения была привязана к блокам фиксированного размера, и этого было достаточно для обычной записи. Но как только мы хотим сжимать данные или устранять дубликаты, картина меняется. Сжатые данные перестают быть фиксированного размера: блок, который занимал 4 КБ, после компрессии может занимать, например, 1 КБ или 3 КБ. Чтобы хранить такие данные эффективно, без пустот и перерасхода места, система должна уметь адресовать блоки переменного размера. А дедупликация, в свою очередь, требует механизма, который позволял бы многим логическим блокам ссылаться на одну и ту же физическую копию данных, то есть вести учет ссылок на блоки. Новый уровень косвенной адресации Pool Mapping Layer решает обе задачи.
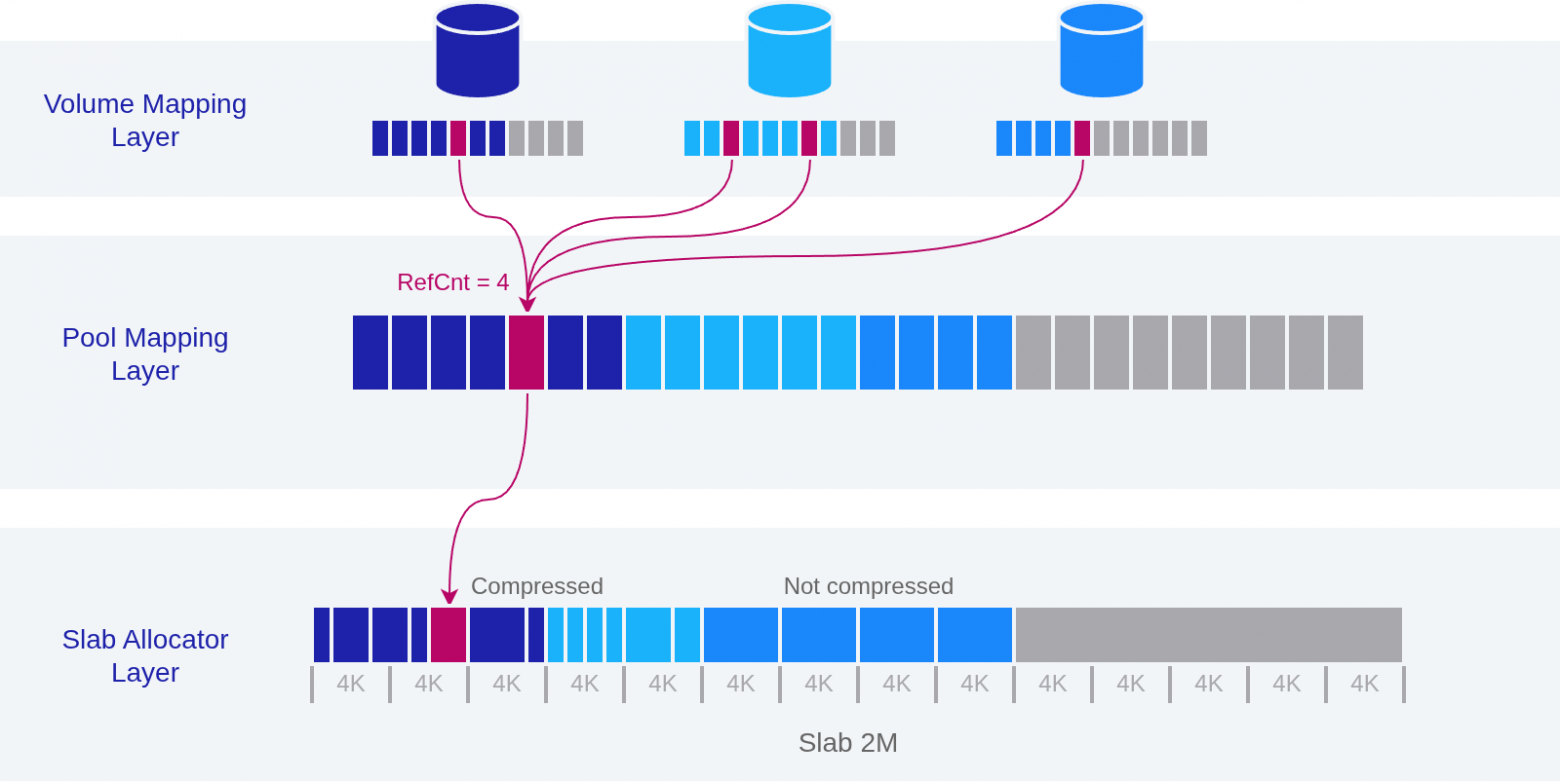
Адресация сжатых данных. Сжатые блоки имеют переменную длину. Благодаря новому уровню косвенной адресации обеспечивается адресация с гранулярностью всего 8 Б. Это позволяет эффективно размещать в хранилище сжатые данные произвольной длины и не тратить лишнее место на выравнивание.
Подсчет ссылок на блоки. Механизм учета ссылок на блоки данных — обязательное условие для выполнения дедупликации. Именно новый уровень косвенной адресации реализует эту функциональность: он дает системе возможность хранить несколько ссылок на одну физическую копию блока и корректно управлять ее жизненным циклом. Пока на блок ссылаются, он жив.
Таким образом, переработка пулов заложила саму возможность сжатия и устранения дубликатов.
Где в пути записи сжимаются и дедуплицируются данные
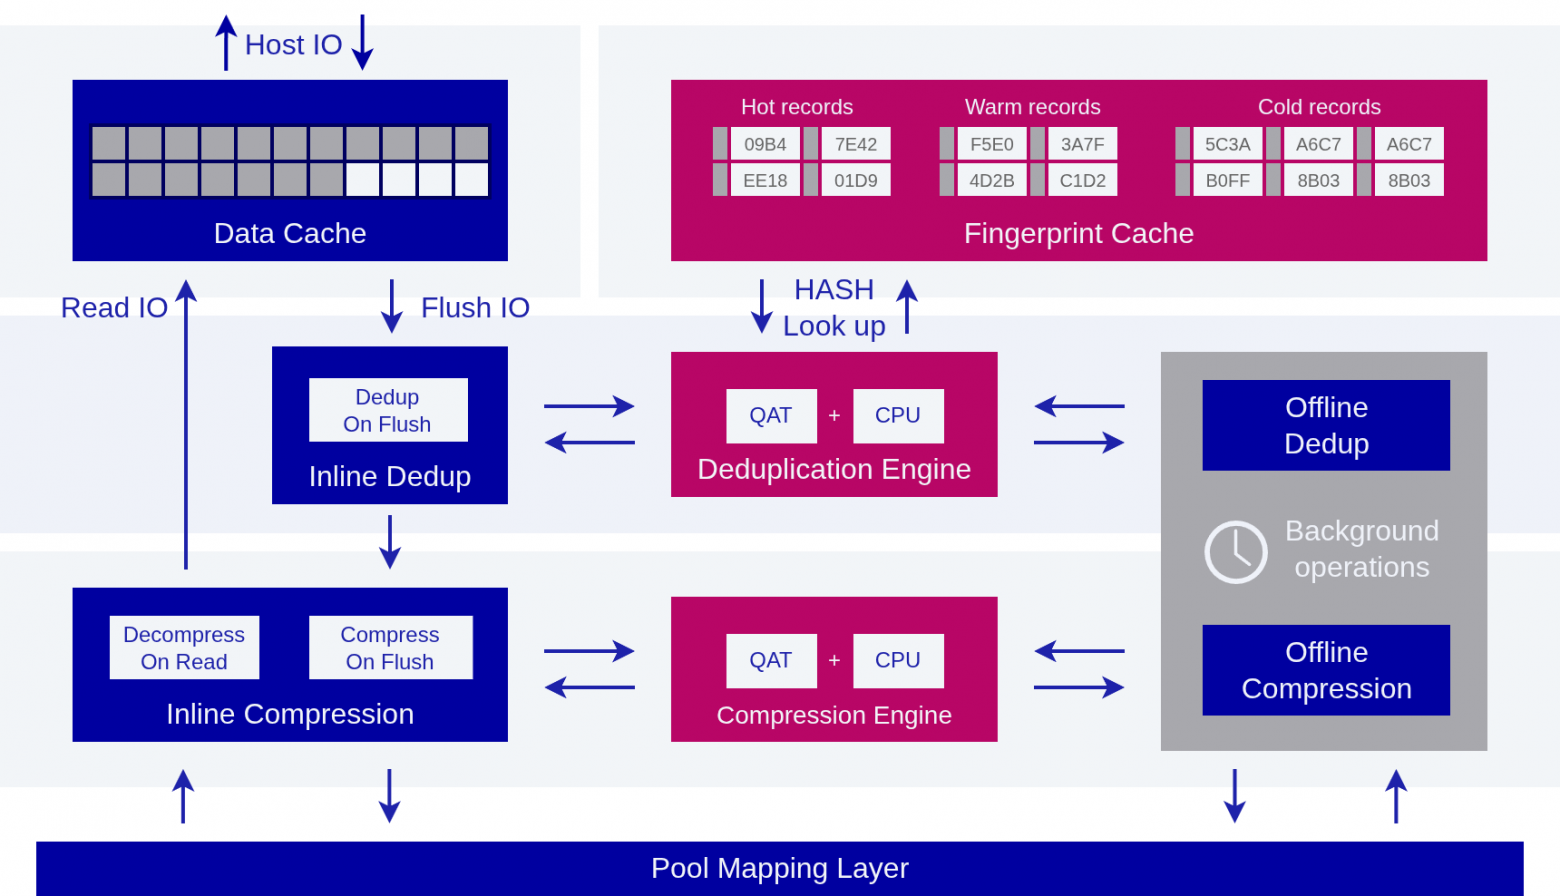
Разберем стек ввода-вывода на примере записи данных. Именно здесь выполняются компрессия и дедупликация.
Сначала подтверждение хосту, потом обработка
Обработка данных начинается с кеша на запись: записываемый блок попадает в кеш, после чего хост сразу получает ответ об успешной записи и может продолжать работу. Дальнейшая обработка (дедупликация и компрессия) происходит уже после того, как хост получил подтверждение, и потому напрямую не влияет на время ответа хосту.
Дедупликация: хеш-отпечатки и трехуровневый кеш
Текущий дизайн дедупликации предусматривает работу с гранулярностью 4 КБ. Для каждого записываемого блока данных вычисляется хеш-отпечаток, по которому ищется уже сохраненная копия. Если дубликат найден, дальнейшие шаги упрощаются: компрессия в этом случае не нужна, и система лишь создает ссылку на уже существующий блок. Важно, что хеш вычисляется по оригинальным, еще не сжатым данным. Это позволяет отсечь дубликаты до того, как данные будут обработаны, и не тратить ресурсы на сжатие того, что хранить повторно не имеет смысла.
Для хранения и поиска хеш-отпечатков реализован многоуровневый кеш, зеркалируемый между контроллерами хранения. Он состоит из трех уровней: Cold, Warm и Hot. Записи перемещаются между уровнями в зависимости от того, сколько дубликатов для них было найдено: чем чаще блок встречается в данных, тем «горячее» становится его отпечаток и тем дольше он удерживается в кеше. Такой подход повышает эффективность дедупликации за счет того, что дольше сохраняются отпечатки с наибольшей вероятностью дубликата.
По умолчанию блок данных считается дубликатом при совпадении хеш-отпечатка. В дедупликации применяется алгоритм хеширования семейства SHA-2, вероятность коллизии для которого ничтожно мала. Чтобы представить себе ее масштаб: это как случайно выбрать одну конкретную песчинку из всех песчинок на пляжах Земли... и повторить это дважды, выбрав ту же самую. На практике такую вероятность можно приравнять к нулю — совпадение хеш-отпечатков практически наверняка означает, что блоки идентичны.
Однако для случаев, когда требуется особый уровень уверенности, например для суперкритичных данных, предусмотрена опция побайтового сравнения блоков при совпадении хеш-отпечатка. Она позволяет полностью исключить даже гипотетический риск коллизии и подтвердить идентичность блоков непосредственно по содержимому, что, конечно, несколько замедлит производительность.
Компрессия: LZ4, QAT и CPU
Если дубликата в хранилище нет, данные проходят следующий этап — компрессию. Для сжатия выбран алгоритм LZ4, который обеспечивает высокую производительность при хорошей степени сжатия. Такой баланс критичен, ведь сжатие выполняется inline, на горячем пути записи, и не должно становиться бутылочным горлышком.
Сжатые данные имеют переменную длину, и для их размещения на диске выполняется плотная упаковка: блоки раскладываются с выравниванием 8 Б, которое обеспечивает Pool Mapping Layer. Благодаря этому сжатые блоки аккуратно заполняют пространство слэбов без пустот и излишнего расхода места.
Чтобы разгрузить центральный процессор, TATLIN.AFA использует аппаратное ускорение на базе Intel QAT для выполнения компрессии. А вот декомпрессию при чтении мы сознательно выполняем на CPU. Intel QAT обеспечивает высокую пропускную способность, но сама отправка задачи в QAT и получение результата вносит заметную задержку в обработку запроса. Для компрессии это не проблема: к моменту обработки хост уже получил подтверждение записи (данные лежат в кеше) и на первый план выходит пропускная способность. А вот при чтении задержка декомпрессии прибавляется ко времени обработки запроса, поэтому здесь мы предпочитаем CPU: к тому же декомпрессия не так требовательна к ресурсам процессора. Так мы используем аппаратное ускорение там, где оно приносит максимальную пользу, и одновременно получаем минимальную задержку при обработке IO.
Фоновая обработка: те же компоненты, другой режим
До сих пор речь шла об inline-обработке: о том, что происходит на пути записи в реальном времени. Но, как я упоминал в начале раздела, у компрессии и дедупликации есть и фоновый режим работы. Он не встраивается в основной путь записи, однако использует те же самые компоненты: аппаратное сжатие через QAT и общий кеш хеш-отпечатков. Так архитектура закладывает возможность включить офлайн-обработку в последующих релизах без перестройки уже работающих механизмов.
Пулы 1.0 против 2.0: что показали замеры
Разговор о пулах 2.0 был бы неполным без подтверждения их эффективности на практике. В этом разделе я покажу результаты сравнения производительности новых пулов с версией 1.0 и объясню, что именно стало причиной различий.
Прежде чем перейти к цифрам, важная оговорка. Данные о производительности носят ознакомительный характер и не являются официальными. Испытания проводились на инфраструктуре для разработки, которая не оптимизирована для задач тестирования производительности. Поэтому речь идет не о рекордных показателях системы, а о сравнительной характеристике пулов 1.0 и 2.0 в идентичных условиях.
Замеры выполнялись на предварительно прописанном пуле с уже записанными данными. Это сделано намеренно, чтобы учесть запускаемый сборщиком сценарий освобождения ранее записанных данных, что неизбежно сопровождает постоянную перезапись в реальной эксплуатации. Такой подход дает более честную картину, чем тесты на «чистом» пуле.
Обсудим три сценария: запись мелким блоком, запись крупным блоком и чтение мелким блоком.
Запись 8К: выигрыш за счет отказа от RMW
Начнем со сценария, где разница между версиями видна наиболее ярко — записи мелким блоком. Здесь новые пулы демонстрируют существенный выигрыш.
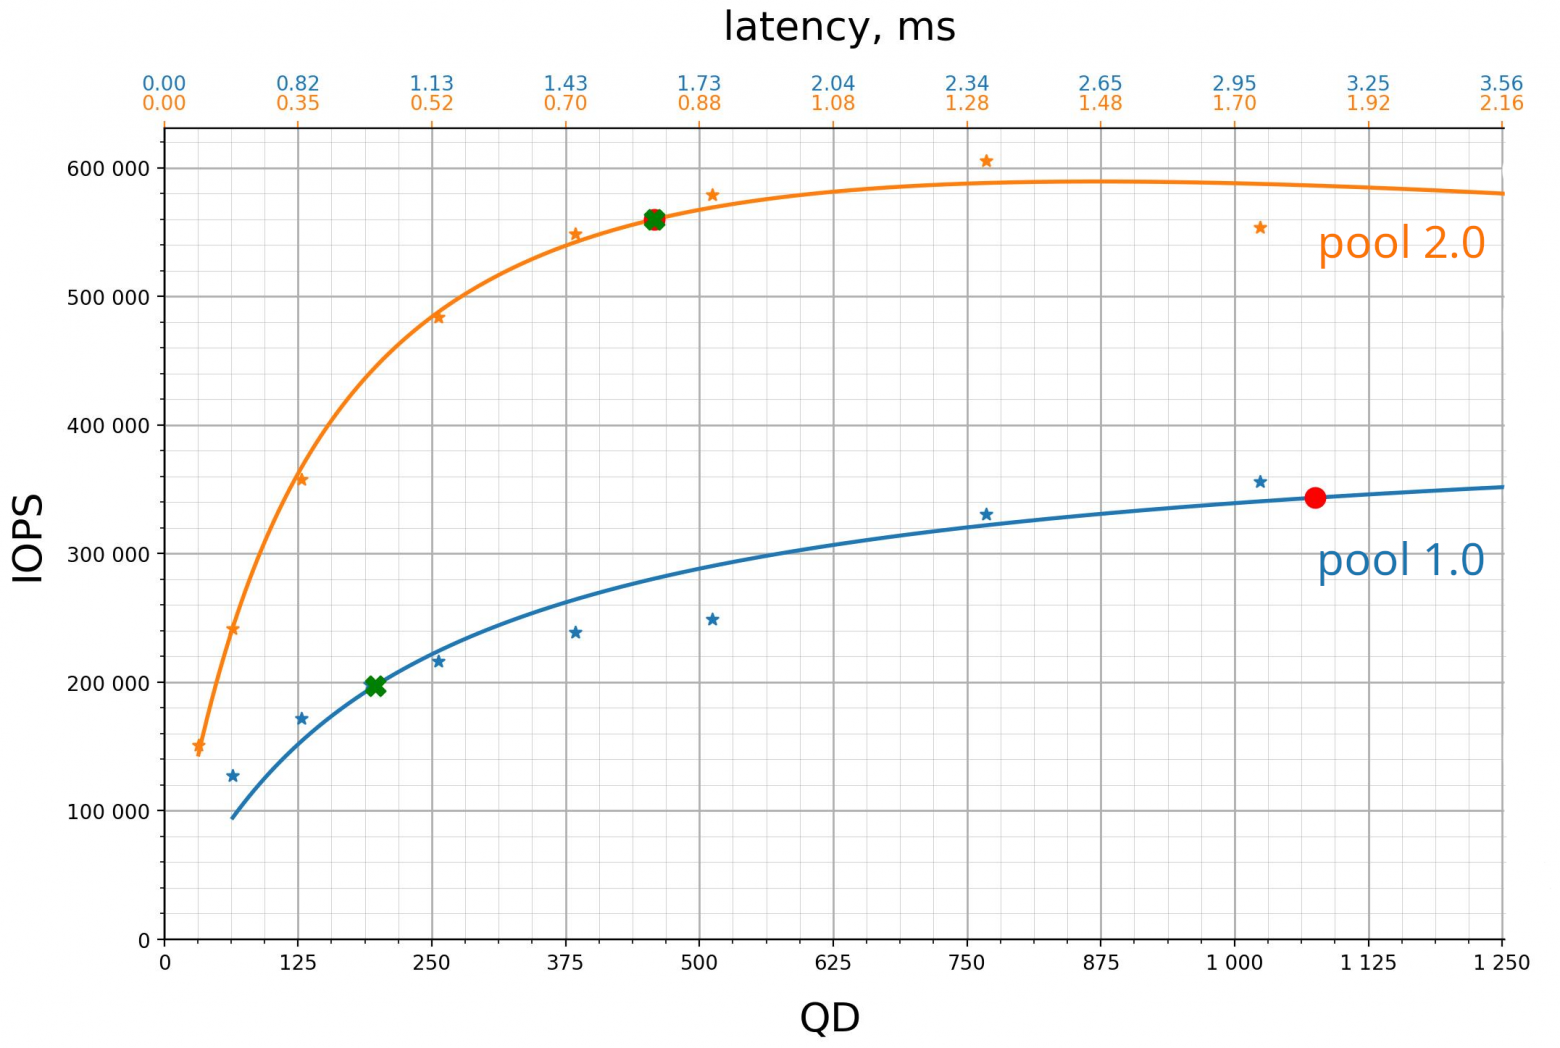
В пулах 1.0 запись мелкого блока не покрывает страйп целиком и требует операции Read-Modify-Write (RMW): система вынуждена читать неизмененную часть страйпа, объединять ее с новыми данными и пересчитывать контрольные суммы — это лишние чтения и заметная задержка. В пулах 2.0 этой проблемы не существует. Благодаря косвенной адресации новая запись всегда попадает в свободные слэбы полным страйпом и операция RMW при частичном обновлении просто не нужна. Отсутствие RMW и дает новым пулам преимущество при записи мелким блоком.
Запись 32К: паритет, когда блок равен страйпу
Теперь рассмотрим запись крупным блоком.
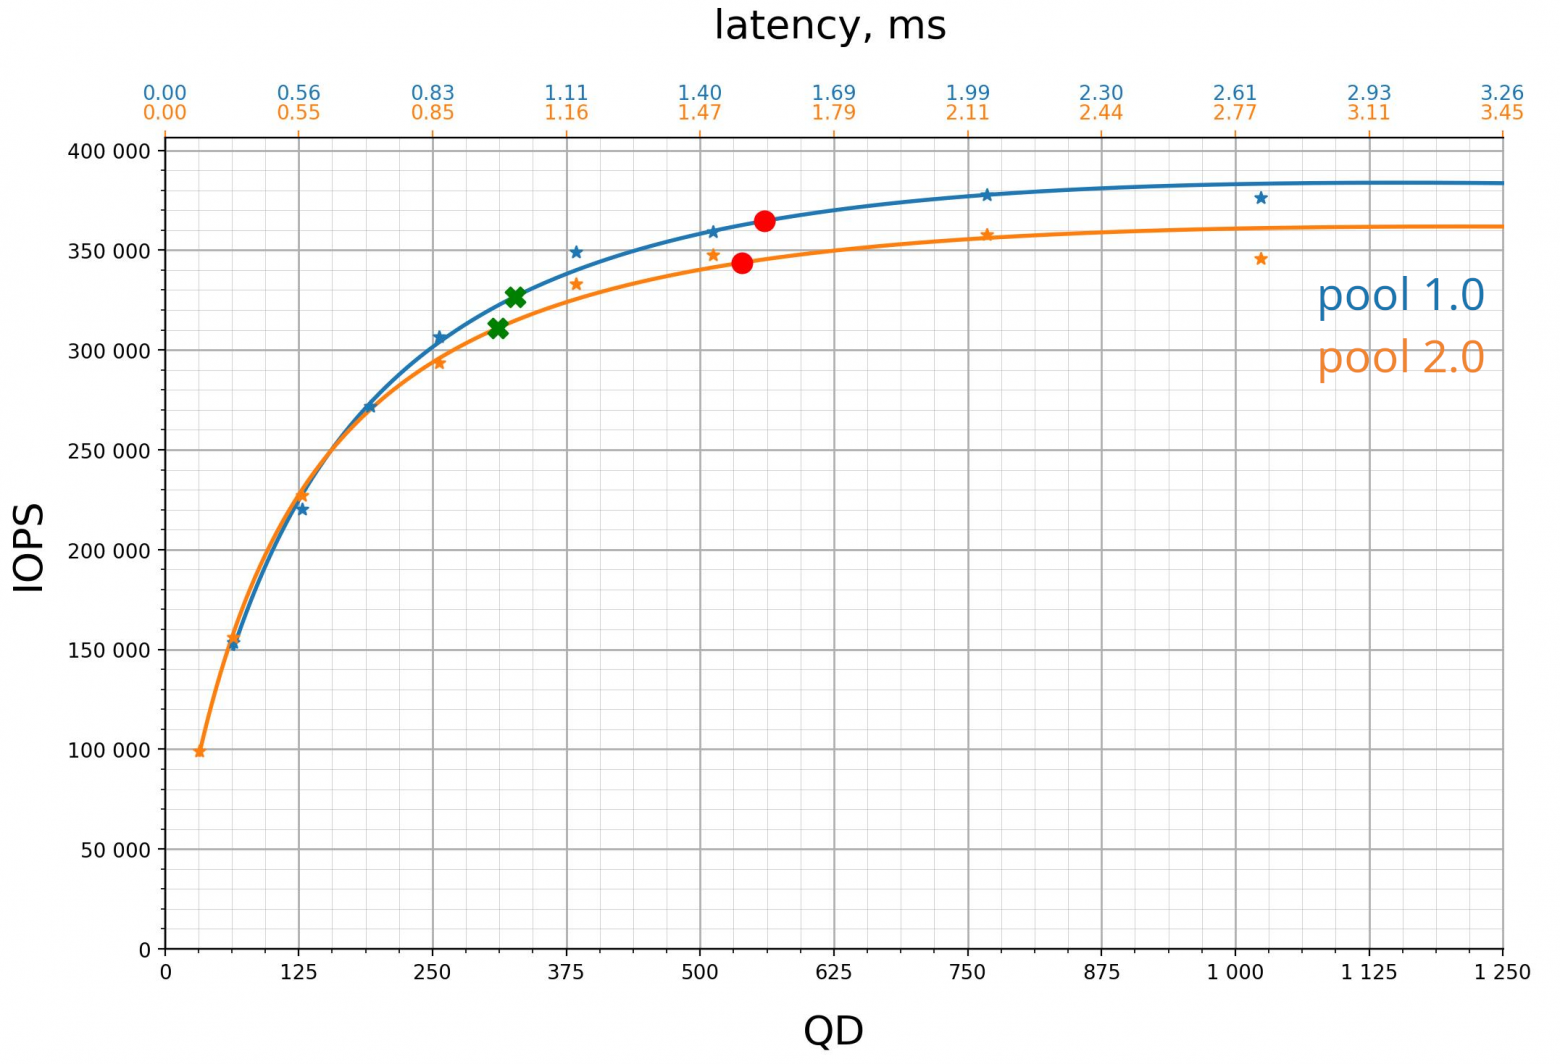
В данном тесте размер блока равен 32 КБ и совпадает с размером страйпа, поэтому здесь картина принципиально иная. При таком объеме записи обе версии пулов выполняют запись полным страйпом: данных из одного запроса достаточно, чтобы заполнить его целиком, и RMW не требуется ни там, ни здесь. Поэтому существенной разницы между пулами 1.0 и 2.0 не наблюдается.
Это хорошая иллюстрация того, что преимущество пулов 2.0 не «магическое» ускорение записи вообще, а избавление от накладных расходов именно там, где они возникают: при частичном обновлении страйпа.
Чтение 8К: лишний уровень адресации без лишней задержки
Наконец, посмотрим на чтение мелким блоком. Здесь разницы в производительности между пулами 1.0 и 2.0 не наблюдается — обе версии обслуживают запросы на чтение с одинаковой скоростью.
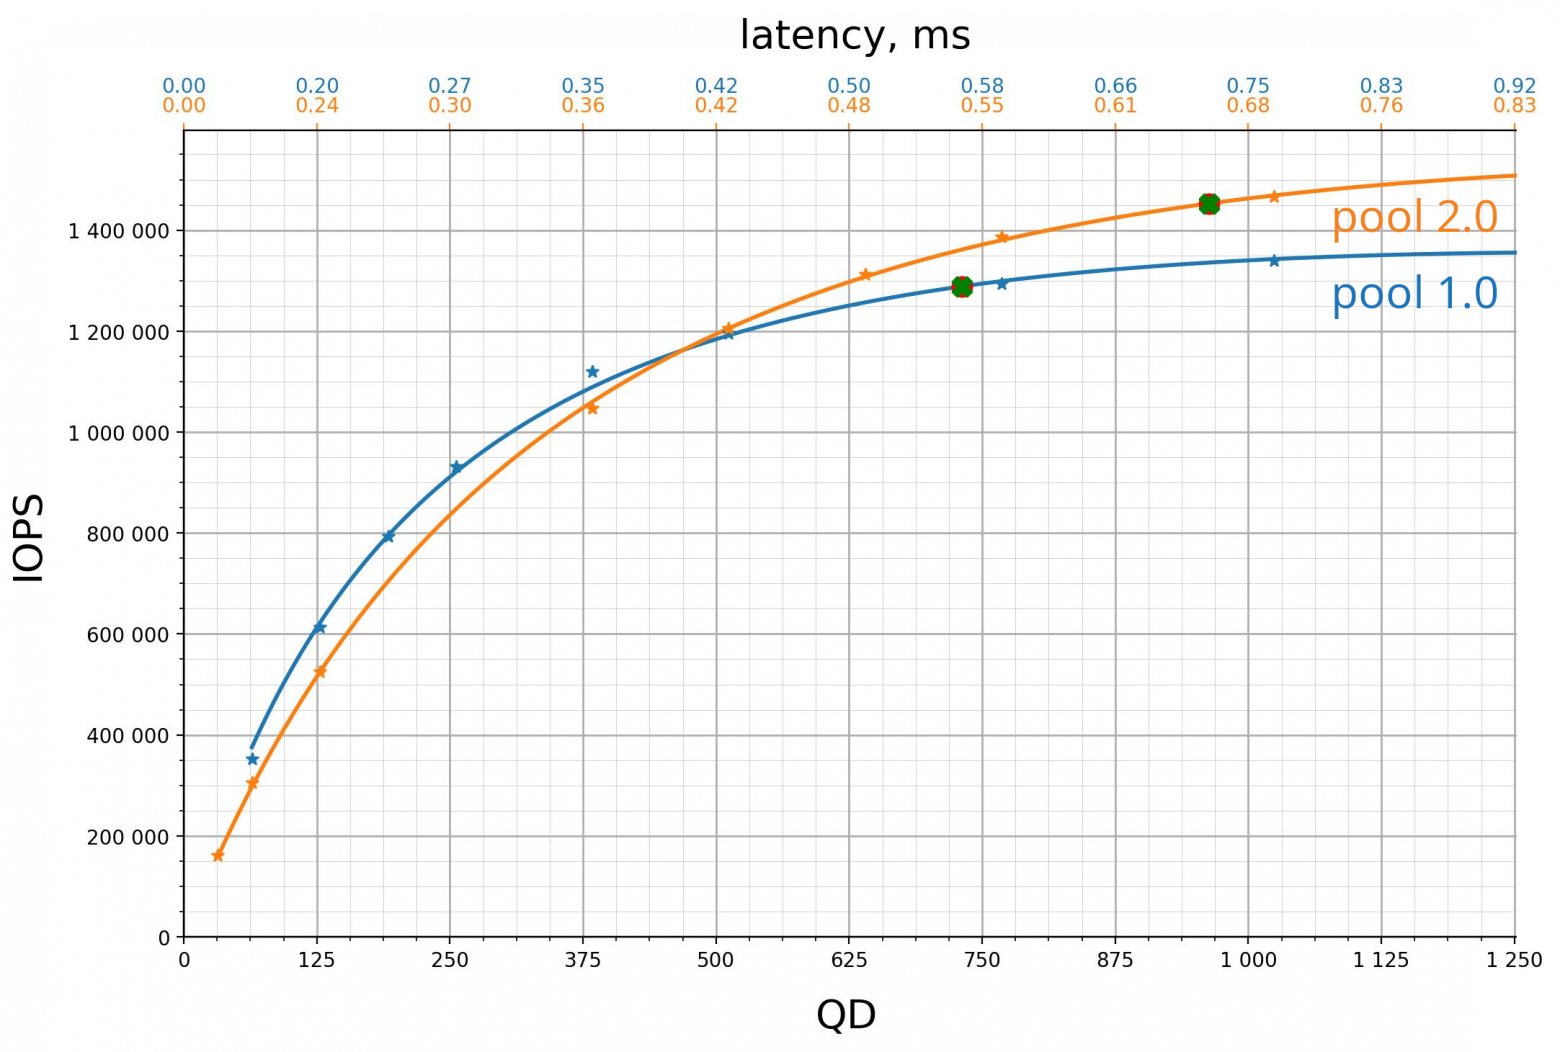
Для пулов 2.0 это очень показательный результат. Новый уровень адресации, Pool Mapping Layer, добавил в путь обращения к данным дополнительный шаг трансляции адресов, и логично было бы ожидать от него заметной задержки. Однако измерения показывают, что дополнительный уровень адресации на скорости чтения практически не сказался. Дополнительная трансляция адресов вписана в существующую цепочку обработки IO так, что не добавляет ей ощутимой задержки. Таким образом, новые возможности пулов — гибкость адресации, сборка мусора, фундамент для компрессии и дедупликации — достались нам без ущерба для базовой производительности чтения.
Именно такой баланс мы и хотели получить: заметный выигрыш в записи, где он дает наибольший эффект, и отсутствие новых задержек там, где дополнительные абстракции могли бы замедлить систему.
Планы: от inline-компрессии в 4.1 к дедупликации
В этой статье я рассказал, как устроены пулы 2.0, какие возможности они открыли и как это отразилось на производительности. На этом работа не заканчивается: мы постоянно занимаемся добавлением новой функциональности и повышением надежности СХД, и впереди у нас планы, которые станут логичным продолжением всего, о чем шла речь. Новые пулы вышли вместе с продуктом TATLIN.AFA и релизом программного обеспечения 4.0. Это лишь отправная точка.
Уже в версии 4.1 реализована поддержка inline-компрессии — сжатия данных на лету. Следом мы планируем добавить офлайн-компрессию — фоновую обработку уже записанных данных, а затем свет увидит и поддержка дедупликации. Объединенные под общим термином Data Reduction, эти функции превращаются для пользователя в прямую экономию полезной емкости хранилища.
Таким образом, вся работа над пулами 2.0 закладывает фундамент для дальнейшего развития продуктов TATLIN — шаг за шагом, от релиза к релизу мы будем наращивать возможности и повышать эффективность хранения данных.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.