Агенты тоже любят индивидуальный подход, или Почему для генерации кода не существует универсальной обвязки
Замечали ли вы, что одна и та же модель в одном ИИ-помощнике для написания кода прекрасно чинит баги, а в другом не вывозит простую задачу? Кажется, что в этом виновата сама модель. Но это не совсем так. Мне захотелось поделиться с вами исследованием, в котором была рассмотрена программная оболочка вокруг модели, так называемая обвязка, или харнесс (по-английски — harness). Это рабочее место агента, где решается, как он составляет план, какие использует инструменты для работы с файлами и терминалом и что делает, когда переписка становится слишком длинной и перестает помещаться в контекстное окно.
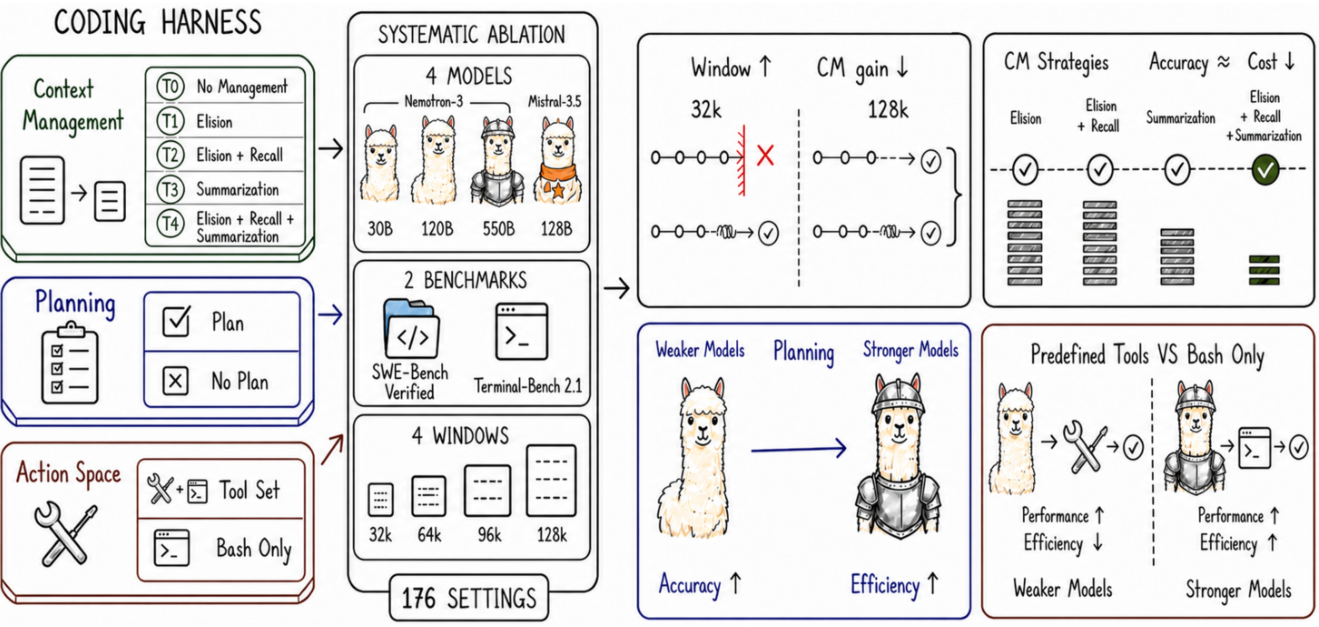
Обычно для сравнения обвязок берут готовые инструменты, прогоняют их на одних и тех же задачах и оценивают результаты. Но на них влияют сразу несколько факторов, и практически невозможно понять, какой из них сыграл главную роль. К тому же одна и та же обвязка с разными моделями ведет себя по-разному. А тут исследователи собрали простую обвязку и поочередно меняли в ней планирование, набор действий и управление контекстом. Результаты оказались довольно неожиданными. То, что нужно слабой модели, сильной либо не нужно, либо мешает, а некоторые умные механизмы вообще почти никем не используются. Ниже расскажу об этом подробнее.
Для начала посмотрим, из чего состоит обвязка.
Устройство тестовой обвязки
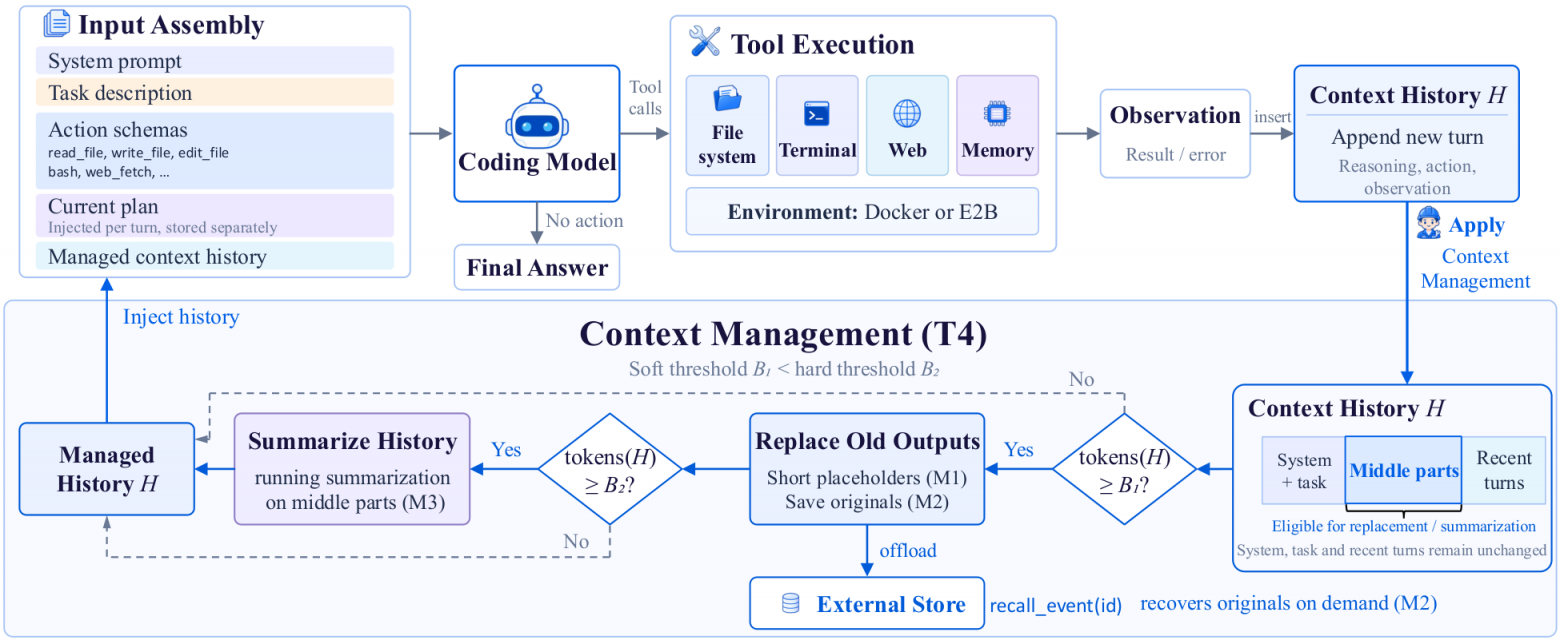
В основе обвязки лежит цикл ReAct. Модель рассуждает, совершает действие, смотрит на результат и идет на новый круг, пока не решит, что задача выполнена и пора остановиться. В экспериментах сам цикл не менялся, а исследователи настраивали только три компонента.
Начнем с планирования. Когда оно включено, модель получает инструмент update_plan, составляет с его помощью список шагов и по ходу работы обновляет его. Каждый шаг помечается как выполненный, текущий или предстоящий, и текущим может быть только один. Перед каждым ходом модели показывают только свежую версию плана, которая полностью заменяет прежнюю и не копится в переписке, так что устаревшие черновики не занимают контекст.
Набор действий тестировали в двух вариантах. В полном у модели восемь инструментов, с помощью которых можно читать, создавать и точечно править файлы, смотреть содержимое папок, искать по именам файлов и по тексту кода, запускать команды терминала и загружать веб-страницы. При правке файлов изменение не пройдет, если модель не прочитала весь файл, поэтому она не перезапишет то, чего не видела. В урезанном варианте остается только терминал, не считая служебных инструментов плана и восстановления текста. Читать, искать и править файлы модели приходится командами оболочки, которые она сама пишет. Такие правки обвязка не отслеживает.
Для управления контекстом проверили пять вариантов. Первый ничего не делает с перепиской, и когда она перерастает окно, работа обрывается с ошибкой. С ним сравнивают все остальные.
Остальные четыре варианта строятся на двух идеях. Первая заключается в том, чтобы заменять устаревшие результаты инструментов короткой заглушкой с пометкой, сколько строк убрано. При этом действия модели сохраняются в истории. Заглушки проверили в двух вариантах. В одном убранный текст необратимо пропадает, в другом отдельно сохраняется, и модель может его вернуть. Вторая идея заключается в том, чтобы пересказать старую часть истории. Пересказ отдельным вызовом готовит та же модель, а при следующем сжатии не пишет его заново, а обновляет. Это дороже заглушек, потому что вызов оплачивается как обычная работа модели.
Пятый вариант совмещает обе идеи и опирается на два порога заполнения окна. Сначала, на мягком пороге, включаются дешевые заглушки. Если этого мало и история доходит до жесткого порога, самые старые события уходят в пересказ. Так, дорогой вызов модели нужен только тогда, когда уже не хватает заглушек. При любом сжатии начало переписки с задачей и несколько последних ходов остаются нетронутыми.
Все остальное во всех конфигурациях было одинаковым, чтобы разницу в результатах объясняли только эти три компонента. Например, после правки кода на Python запускается линтер, и его замечания сразу попадают к модели, поэтому, не дожидаясь тестов, она исправляет синтаксическую ошибку или лишний импорт. Исключение составляет вариант с одним терминалом, потому что линтер срабатывает только на правки через файловые инструменты. Есть еще защита от зацикливания. Если модель повторяет одно и то же действие несколько раз подряд, ей напоминают сменить подход, а если такие повторы раз за разом заканчиваются одной и той же ошибкой, то задачу досрочно останавливают.
Как сравнивали конфигурации
Для экспериментов взяли четыре модели. Три из них, Nemotron-3 на 30, 120 и 550 миллиардов параметров, были из одного семейства, и по ним удалось проследить, как меняется эффект с ростом модели. Четвертая, Mistral-Medium-3.5-128B, была из другого семейства и понадобилась, чтобы проверить, не завязаны ли выводы на особенности одной линейки. Все модели запускали у себя через SGLang с температурой 0, то есть без случайного выбора слов.
Задачи брали из двух наборов. В первом, SWE-Bench Verified, было 500 реальных задач по исправлению ошибок в открытых репозиториях на Python, проверенных вручную. Второй, Terminal-Bench 2.1, состоял из 89 задач, которые целиком решались в командной строке.
Пять вариантов управления контекстом проверили на четырех размерах окна, от 32 до 128 тысяч токенов. Получилось 20 комбинаций для каждой пары «модель и набор задач», и во всех планирование было включено, а инструменты были полные. Потом добавили два отдельных теста при самом большом окне и полном варианте управления контекстом. В одном отключили планирование, в другом заменили полный набор инструментов одним терминалом. Так вышло 22 настройки на каждую из восьми пар, то есть 176 конфигураций.
Для каждой конфигурации считали долю решенных задач и среднюю стоимость одной задачи в долларах. Стоимость определяли по ценам OpenRouter за входные и выходные токены, и у разных моделей она сильно отличалась, от нескольких центов за миллион токенов у самой маленькой Nemotron до нескольких долларов у Mistral.
Чтобы отличить настоящую разницу от случайной, точность сравнивали парным тестом Макнемара на одних и тех же задачах и вводили поправку на множественные сравнения (процедура Бенджамини — Хохберга, доля ложных открытий не выше 5%). На Terminal-Bench с его 89 задачами многие различия так и не достигли статистической значимости.
Что происходит, когда заканчивается контекст
На SWE-Bench Verified разрыв между конфигурациями с управлением контекстом и без него был сильнее всего заметен при маленьком окне и постепенно сокращался по мере его роста. На Terminal-Bench динамика была такой же, только при узком окне разрыв выходил меньше.
Это можно объяснить переполнением. Без управления контекстом при окне в 32 тысячи токенов в среднем по моделям терялось 78,7% задач на SWE-Bench. Переписка доходила до предела раньше, чем агент заканчивал работу, и выполнение обрывалось с ошибкой. При окне в 128 тысяч токенов таких потерь оставалось 8,7%. На Terminal-Bench доля потерь снизилась с 61 до 12%. В вариантах с управлением контекстом из-за переполнения не потерялось ни одной задачи — при любом размере окна.
Управление контекстом почти не меняло порядок и пропорции этапов, через которые проходил агент, то есть поиск нужного места в коде, правку и проверку. Оно лишь позволяло работе дойти до завершения. А чем больше становилось окно, тем больше траекторий укладывалось в него и без всякого управления, поэтому стиралась разница между его наличием и отсутствием.
Как агенту работать со старой историей
Заглушки и пересказ дали близкую точность, но по стоимости сильно различались. Заглушка обходится дешево, потому что это замена части уже готового текста. Пересказ каждый раз требует отдельного вызова модели, а он оплачивается так же, как ее основная работа.
Поэтому самым выгодным оказался комбинированный вариант, когда дорогой пересказ включается, только если не хватает заглушек. При сопоставимой точности он вышел самым дешевым почти для всех сочетаний модели и набора задач, а пересказ в нем понадобился реже, чем в варианте с одним только пересказом.
Отдельно хотелось бы сказать про возможность вернуть убранный текст. Идея выглядела разумно. Если агенту понадобился старый результат, он запрашивает его обратно, а не перечитывает файл и не запускает заново команду. На практике моделям это почти не пригодилось. Больше чем в половине конфигураций, где был доступен такой инструмент, за всю задачу его ни разу не вызвали. Им пользовалась почти исключительно лишь самая слабая модель, и то в основном при самом узком окне, а остальные редко к нему обращались. Но и у нее точность не выросла. В самом активном случае, на Terminal-Bench при окне в 32 тыс. токенов, она вызывала инструмент в среднем больше четырех раз на задачу, а результат оказался на 3,4 пункта ниже, чем у заглушек без возможности восстановления. По всем моделям и наборам задач разницы между этими двумя вариантами не нашли. Где-то точность была чуть выше, где-то чуть ниже, а в среднем отличалась меньше чем на полпункта.
Что нужно слабой модели, а что сильной
Слабой модели оказались нужны и планирование, и готовые инструменты. С сильными моделями вышло иначе.
Для Nemotron-3 30B планирование стало условием хоть какого-то результата. Без него типичная траектория на SWE-Bench сокращалась с сорока до пяти ходов, и больше двух третей запусков заканчивались без единой правки в коде. С планом таких запусков было 27,8%. В 58,4% запусков без плана модель так и не вышла за этап поиска нужного места в коде, а с планом таких было 10,4%. В итоге план поднял долю решенных задач на 11,6 пункта на SWE-Bench и на 4,5 пункта на Terminal-Bench. Правда, работа стала длиннее, а значит, и дороже.
С инструментами ситуация была похожей. Когда этой модели оставили один терминал, она продолжала вызывать инструменты, которых в таком режиме нет, и обвязка не могла их выполнить. На Terminal-Bench из-за таких вызовов обрывались две трети запусков, а средняя траектория сокращалась с 71 до 15 ходов. Точность упала на 15 пунктов на SWE-Bench и на 10 пунктов на Terminal-Bench.
У Nemotron-3 550B и Mistral планирование почти не меняло точность. На SWE-Bench она слегка снижалась, зато стоимость падала примерно на 30%. Разбор ходов показал, что исчезали в основном проверки после правки. Модель реже перепроверяла уже готовое решение, а на поиск ошибки и саму правку это почти не влияло.
С инструментами у Nemotron-3 550B вышло наоборот. С одним терминалом точность выросла на 3,6 пункта на SWE-Bench и на 5,6 пункта на Terminal-Bench, а стоимость упала на 53% и 30%. Вызовов стало меньше на 32% и 24%, а повторных правок одного и того же файла на SWE-Bench в среднем 1,5 вместо 4,6 на задачу. Похоже, что в терминале модель собирала несколько операций в одну команду и не дробила их на отдельные шаги. Готовый набор инструментов для нее, судя по всему, был скорее лишней нагрузкой, чем опорой.
Nemotron-3 120B вела себя менее предсказуемо. Устойчивого прироста точности от планирования не было, а стоимость на SWE-Bench выросла, зато на Terminal-Bench снизилась. Готовые инструменты дали ей небольшой прирост точности, примерно на 1,6 пункта на SWE-Bench и на 4,5 пункта на Terminal-Bench.
У Mistral результат зависел от типа задач. Без готовых инструментов на SWE-Bench она потеряла 23,2 пункта точности, и треть запусков (32,8%) заканчивалась без единой правки, а с полным набором таких было 1,2%. На Terminal-Bench один терминал, наоборот, дал прибавку в 6,7 пункта. Судя по всему, дело в том, что задачи Terminal-Bench и так решаются командами. Около 72% действий с файлами и рабочей папкой Mistral выполняла через терминал даже с полным набором инструментов, а на SWE-Bench около 40%, и там готовые инструменты для чтения, поиска и правки оставались важными.
Вместе с инструментами менялись инструкции для модели и автоматическая проверка кода после правок, поэтому итоговый эффект складывался из нескольких факторов.
Как обвязка меняет поведение агента
Чтобы понять, что стоит за этими результатами, а не просто зафиксировать их, каждый ход в траектории агента авторы исследования разметили по рабочей фазе с помощью отдельной модели-судьи. Для SWE-Bench выделили несколько категорий: поиск файла с багом, попытка воспроизвести проблему, правка кода, проверка результата и прочие вспомогательные действия вроде установки зависимостей. Для Terminal-Bench набор категорий устроен детальнее и сгруппирован в более крупные фазы: понимание задачи через чтение и поиск, написание кода, проверка через запуск решения или тестов, и все остальное вроде работы с git или навигации по директориям. Эту разметку сверили с разметкой живых асессоров на выборке траекторий, и совпадение получилось высоким, так что на нее можно опираться при интерпретации результатов.
Управление контекстом продлевает траекторию агента, но почти не меняет то, чем он занят на каждом шаге. При узком окне без управления большинство запусков обрывается еще на этапе поиска бага, до проверки решения почти не доходит дело. С любой из управляемых стратегий траектория заметно удлиняется, и агент успевает дойти до верификации. При широком окне разница между стратегиями почти стирается. Длина траектории и доля запусков без единой правки становятся похожими почти у всех моделей, независимо от того, какую стратегию используют. Агент на каждом шаге занимается тем же самым, просто при тесном окне без управления он не успевает пройти весь путь от поиска бага до проверки решения.
Что касаемо планирования, то оно влияет на то, в какой момент агент решает остановиться. У слабой модели без плана большинство запусков заканчивается без единой правки, причем почти все застревают еще на этапе поиска файла с багом. С планом доля таких провалов заметно падает, он удерживает модель на задаче дольше и не дает ей сдаться на старте. А вот у сильных моделей план почти не влияет на то, доходят ли они до правки, зато сокращает хвост из избыточных прогонов тестов после того, как решение уже готово, поэтому траектория с планом у них становится короче, а не длиннее.
Набор инструментов работает иначе. Он не трогает ни длину траектории, ни момент остановки, а меняет масштаб каждого отдельного действия. С готовым набором агент делает много мелких шагов: отдельными вызовами читает файл, правит, запускает тест. С одним терминалом шагов меньше, но каждый крупнее, потому что несколько операций помещаются в одну команду через конвейер или связку условий. Это видно и в том, как меняется редактирование файлов: модель реже возвращается к одному и тому же файлу мелкими порциями и чаще переписывает нужный кусок сразу целиком. На Terminal-Bench похожая логика видна в том, что при переходе на один терминал растет доля операций, где файл создается или заменяется полностью, а не правится точечно, и это характерно для всех моделей.
Как подобрать обвязку под конкретную модель
Ни один из трех компонентов не дает прироста сам по себе, в отрыве от модели и задачи, под которую его настраивают.
Управление контекстом стоит включать в полную силу при небольшом окне, где оно не дает работе обрываться из-за переполнения. При достаточном окне разница почти исчезает, и выбор стратегии становится скорее вопросом стоимости. Лучше всего себя показала комбинация элизии и суммаризации с двумя порогами.
Планирование и полный набор инструментов скорее всего нужны слабым моделям, которые без них часто бросают задачу на полпути или пытаются вызвать несуществующие инструменты. Для сильных моделей эти же компоненты уже не поднимают точность, а просто снижают стоимость, поскольку модель перестает по многу раз перепроверять готовое решение. Для них можно проверить, не выгоднее ли урезанная обвязка — без планирования и с одним терминалом вместо набора инструментов. Восстановление удаленной истории можно вообще не добавлять, модели им почти не пользуются, а выигрыша это не дает даже там, где пользуются.
Разница между двумя бенчмарками при этом меняет саму логику выбора обвязки, а не только цифры точности. Там, где правки точечные и разбросаны по файлам репозитория, готовые инструменты для чтения и редактирования почти всегда полезны. Там же, где решение задачи и так укладывается в команды терминала, они иногда только мешают лишним выбором. Поэтому при выборе обвязки важно смотреть не только на модель, но и на то, завязаны ли задачи на файловую структуру или на работу через shell.
Само исследование имело свои ограничения. Каждую конфигурацию прогоняли только один раз, а один из бенчмарков совсем небольшой, так что часть различий там статистически не значима. Планирование и набор инструментов проверяли только при одной стратегии управления контекстом и на самом большом окне, так что неизвестно, сохраняются ли эти эффекты в других комбинациях. Один из бенчмарков состоит только из задач на Python, так что выводы про инструменты против терминала могут иначе выглядеть для других языков. А размер модели — здесь лишь приблизительный ориентир ее возможностей, потому что на результат влияют еще и особенности обучения, и то, насколько модель привычна к терминалу.
Универсальной обвязки, которая одинаково хорошо подходит любой модели и любой задаче, не существует. Ее собирают под конкретную пару «модель + задача».
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.