api‑contract‑check — библиотека для генерации валидаторов из TS‑кода и проверки API‑запросов
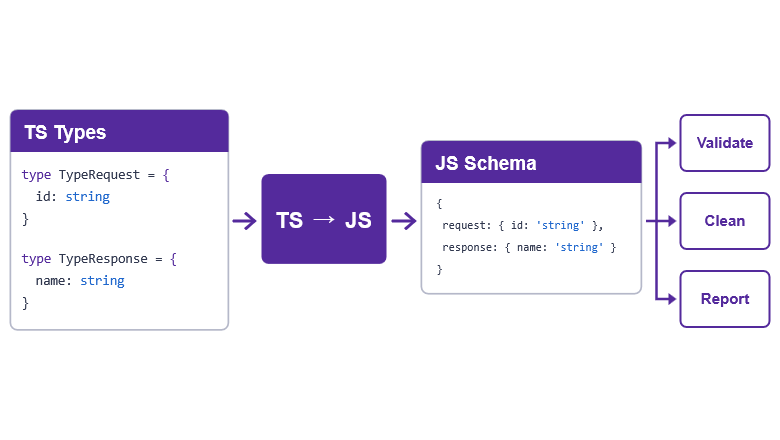
Продолжаю делиться выложенными в OpenSource библиотеками, которые использую в работе. В этот раз речь пойдет о наиболее универсальном, на мой взгляд, подходе для валидации приходящих с бэкенда данных: в клиентской части пишутся обычные DTO-модели на TypeScript, а валидаторы создаются автоматически.
Вот ссылки на документацию на русском и английском, а в статье я сравню различные подходы к валидации.
Зачем нужна валидация API
В большинстве проектов, которые видел, валидация не производилась вообще — вызовы XHR / fetch выполнялись в componentDidMount / useEffect или аналогах для других фреймворков. Это становилось крупнейшей точкой отказа из-за ручных ошибок, внезапного изменения контрактов со стороны бэкенда или просто несогласованности, когда бэкенд обещает string, но присылает null или поле и вовсе отсутствует.
В обратную сторону это тоже работает — фронтенд может отправлять некорректные или неиспользуемые бэкендом поля. Интеграция со внешними системами в целом требует валидации для стабильности, иначе поиск рассогласований будет долгим и дорогим, так как ошибки могут всплыть в совершенно неожиданных местах, а не в точке запроса за данными. Поэтому было создано несколько подходов, которые решали вышеперечисленные проблемы.
Подход 1: генерация из OpenAPI схем
В крупных энтерпрайз-проектах мелочиться не стали. Бэкенд генерировал OpenAPI схемы (например, для отображения в Swagger) и из них либо создавались только TS-типы (минимальный подход), либо создавались готовые эндпоинты для вызова запросов за данными (условно, api.getUser уже типизирован и вызывает fetch на нужную точку) с опциональным встраиванием runtime-валидаторов.
Этот подход у многих применяется до сих пор, но количество недостатков слишком велико:
сгенерированная схема может по факту расходиться с тем, что присылает бэкенд. На практике это происходит часто и зависит от используемых фреймворков на бэкенде. Например, при
param?: stringможет прийтиnullвместо отсутствующего параметра, либо из-за сложности устройства типов на бэкенде схема получается неполнойверсионирование становится очень сложным. Например, для задачи в новой ветке бэкендер опубликовал npm-пакет
"@api-spec": "123.3.1877-feature-123", однако в dev-ветку уже вмерджены изменения от других разработчиков, что может вызывать конфликты. Нужны постоянные rebase, перегенерация, переустановка зависимостей, иногда — отдельные инстансы Swagger для тестировщиков. При большом потоке изменений и при использовании нескольких бэкендов, которые генерируют разные npm-пакеты вроде"@api-spec-payments"/"@api-spec-geo", эту рутину приходится выполнять несколько раз в день, а затраты на инфраструктуру растутфронтенд и бэкенд не могут работать над задачей параллельно — обязательно должен сначала быть реализован (хотя бы на моках) бэкенд, чтобы сгенерировать новый пакет. Либо все скатывается в ручной обмен спецификациями в чате, со всей сопутствующей непрозрачностью и отставанием от мастер-веток
фронтенд может использовать только 1 свойство, а бэкенд присылает 100 (возможно, это легаси, техдолг или ориентация на разных фронтенд-потребителей). Сгенерированный по OpenAPI клиент не очищает лишнее — он не знает, чем пользуется конкретный фронтенд, соответственно нужна либо ручная выборка нужных данных, либо в состояние приложения попадают лишние данные, занимающие процессорное время и память
в большинстве подходов генерируется монолитный API-клиент, в котором не будет работать tree-shaking или lazy loading. Если на главной странице нужен только 1 эндпоинт — загрузятся и все остальные, а если в конкретном проекте используется только часть эндпоинтов — то ненужные все равно попадут в бандл
Все, что делает сгенерированный по OpenAPI JS-клиент, — проверяет, что он сгенерирован по этой спецификации. В нем нет знания о нуждах фронтенда-потребителя или гарантии соответствия данным, реально возвращаемым бэкендом. Учитывая большие требования к организационным моментам и инфраструктуре, этот подход довольно неэффективен.
Подход 2: ручное описание схемы на фронтенде
Если проект перерос MVP, но не дорос до энтерпрайза, то, как правило, используют ручной подход. В OSS огромное количество библиотек для валидации, которые в основном проектировались для форм, но могут применяться и для API. Например, при использовании Zod / Valibot схемы выглядят так:
import * as z from 'zod';

const userSchema = z.object({
  id: z.string(),
  name: z.string(),
  age: z.number().optional(),
});

type TypeUser = z.infer<typeof userSchema>;
В целом пользоваться этим подходом довольно удобно, но есть и нюансы:
не все библиотеки очищают лишние параметры и логируют лишнее
размер библиотек, как правило, намного больше, чем необходимо для проверки API-контрактов
в проекте теперь существуют типы, написанные вручную и выведенные из валидаторов с помощью infer, что может создавать путаницу
вывод типов из схемы увеличивает время прохождения typecheck-проверок, а также ненадежно работает в IDE
написать схему вручную все равно немного сложнее и дольше, чем TS-тип
Проблемы здесь не выглядят серьезными, но лучше все же использовать специально созданные для валидации API инструменты.
Подход 3: генерация валидаторов из TS-типов
Это не новый подход — в OSS давно существуют ts-interface-builder и typia. Одни библиотеки создают отдельные файлы с валидаторами, другие — непосредственно модифицируют код с помощью плагина для бандлера. Однако функционал не всегда соответствует именно нуждам проверки API-запросов в плане очистки лишних параметров, логирования, набора поддерживаемых конструкций TS AST и размера. А также итоговые схемы не всегда сериализуемы, то есть их будет сложно использовать с альтернативными библиотеками проверки или выводить в документацию.
Здесь и вступает в игру api-contract-check — специализированная библиотека именно для валидации API-запросов. Один из ее модулей работает в пайплайне сборки, создавая схемы для валидации из TS-типов:
import path from 'node:path';

import { createValidators } from '@arfa-tools/generator/api-contract-check/builder';

const { result, deps } = createValidators(
  [path.resolve('src/api/getUser.ts')],
  {
    tsconfigPath: 'tsconfig.json',
    requestDeclaration: 'TypeRequest',
    responseDeclaration: 'TypeResponse',
    getDegraded: (names) => console.log(names),
  }
);

// { request: { id: 'string' }, response: { name: 'string' } }
console.log(result[0].schema)
Итоговая схема — это обычный JS-объект, с которым можно работать как угодно:
сериализовать через JSON.stringify и сохранить в отдельный файл, который будет лениво загружаться при вызове
преобразовать в схему для Zod / аналога
использовать непосредственно в коде вызова вместо отдельных файлов
выводить в документацию и тому подобное
В любом случае — это уже работа с обычным JS-объектом. Всю сложную работу по резолвингу импортов, сбору типов и конвертации TS AST в JS api-contract-check уже выполнил. Для работы с AST используется довольно производительный алгоритм — syntax interpreter, который по бенчмаркам производительнее ts.createProgram / oxc-parser / SWC и для файла с графом из 100 импортов выполняется за ~2 мс (вне зависимости от того, «холодный» это запуск или «горячий»).
Второй модуль работает в рантайме, выполняя валидацию и очистку, при этом весит меньше 1 килобайта в сжатом виде. Если внешний интерфейс для вызова API сделать таким:
import type { TypeRequest, TypeResponse } from './api/getUser';
import { validator } from './validators/api/getUser';

const user = await request<TypeRequest, TypeResponse>({
  url: '/api/getUser',
  request: { id: 'user-1' },
  validator,
});
то внутри request достаточно вызвать соответствующие функции для валидации:
import { check, type TypeRootSchema } from '@arfa-tools/generator/api-contract-check/checker';

async function request<TRequest, TResponse>({ url, validator, request }: {
  url: string;
  request: TRequest;
  validator: TypeRootSchema;
}): Promise<TResponse> {
  const requestErrors = check({
    schema: validator,
    type: 'request',
    value: request,
    getExtraneous: console.warn
  });

  if (requestErrors) {
    throw new Error(`Request validation failed:\n${requestErrors.join('\n')}`);
  }

  const response = await (await fetch(url, {
    method: 'POST',
    headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify(request),
  })).json();

  const responseErrors = check({
    schema: validator,
    type: 'response',
    value: response,
    getExtraneous: console.warn
  });

  if (responseErrors) {
    throw new Error(`Response validation failed:\n${responseErrors.join('\n')}`);
  }

  return response as TResponse;
}
Все лишнее будет очищено и залогировано, а необходимое — проверено на соответствие TS-типам. Скорость работы валидации высокая — это просто проход по объекту со сравнением, но typia, разумеется, будет немного быстрее, так как не использует схемы.
Если вы решили преобразовывать схемы для сторонних валидаторов, то нужно использовать их встроенные методы.
Почему третий подход наиболее универсален
При проверке именно API-запросов практически нет смысла проверять формат email или длину строк, поэтому схемам достаточно обеспечивать соответствие данных TS-типам, так как детальные проверки выполняются на бэкенде и на уровне БД. При этом в формах как раз можно использовать Zod-like валидаторы для оптимистичной проверки (хотя на моей практике было достаточно вручную написанных проверок без сторонних библиотек).
Самое важное, что в третьем подходе остается единственный источник правды — нативный TS-тип только с нужными конкретному фронтенду полями, а приведение реальных данных в соответствие и поиск расхождений автоматизированы, находятся в request-функции и не дают некорректным данным попадать в приложение, вызывая непредсказуемые ошибки.
Есть, разумеется, и недостаток — необходимо вручную синхронизировать типы в проекте с OpenAPI или бэкендерами, но это не блокирует параллельную разработку фронтенда и бэкенда, не создает существенных конфликтов при мердже и не требует большой инфраструктуры, как в первом подходе. При этом схема подходит и для небольших проектов, добавляя минимум ручной работы и позволяя отлавливать ошибки синхронизации на раннем этапе.
api-contract-check входит в состав ARFA Generator через PluginValidators, упрощая интеграцию в процесс сборки, но можно использовать и отдельно для кастомных пайплайнов — например, в подходе с генерацией из OpenAPI библиотека может создавать схемы валидации, так как поддерживает in-memory резолвинг без физически сохраненных файлов.
На этом все, остальное можно посмотреть в репозитории и документации, а я пойду оформлять в OpenSource другие свои библиотеки — осталось еще много интересных и много лет используемых, при этом не теряющих актуальности.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.