[Перевод] Почему Bun на Rust собирается впятеро быстрее, чем на Zig, и при чём тут линкер
Я написал buildprof (GitHub), открытый инструмент трассировки, который показывает, куда уходит время при компиляции под Linux. Вот видео в реальном времени: buildprof профилирует чистую сборку ripgrep.
Бывает, что сборка медленная просто потому, что кода много. Но чаще в ней сидят проблемы, которые можно исправить: плохой параллелизм, повторная работа, скачивание зависимостей или один огромный вызов компилятора либо линкера. buildprof делает всё это наглядным, и сразу видно, что стоит копать и оптимизировать.
Запускается он так: перед любой привычной командой сборки пишете buildprof --.
buildprof -- make -j16
buildprof -- cargo build
buildprof -- ninja -C out/target
buildprof -- just build
buildprof -- ./dev/custom-build-script.sh
buildprof записывает каждый процесс, который запускает команда сборки, включая их подпроцессы (и подпроцессы подпроцессов…), и раскладывает всё на одной временной шкале. Время идёт слева направо, ширина полосы — длительность, дочерние процессы рисуются под тем, кто их запустил.
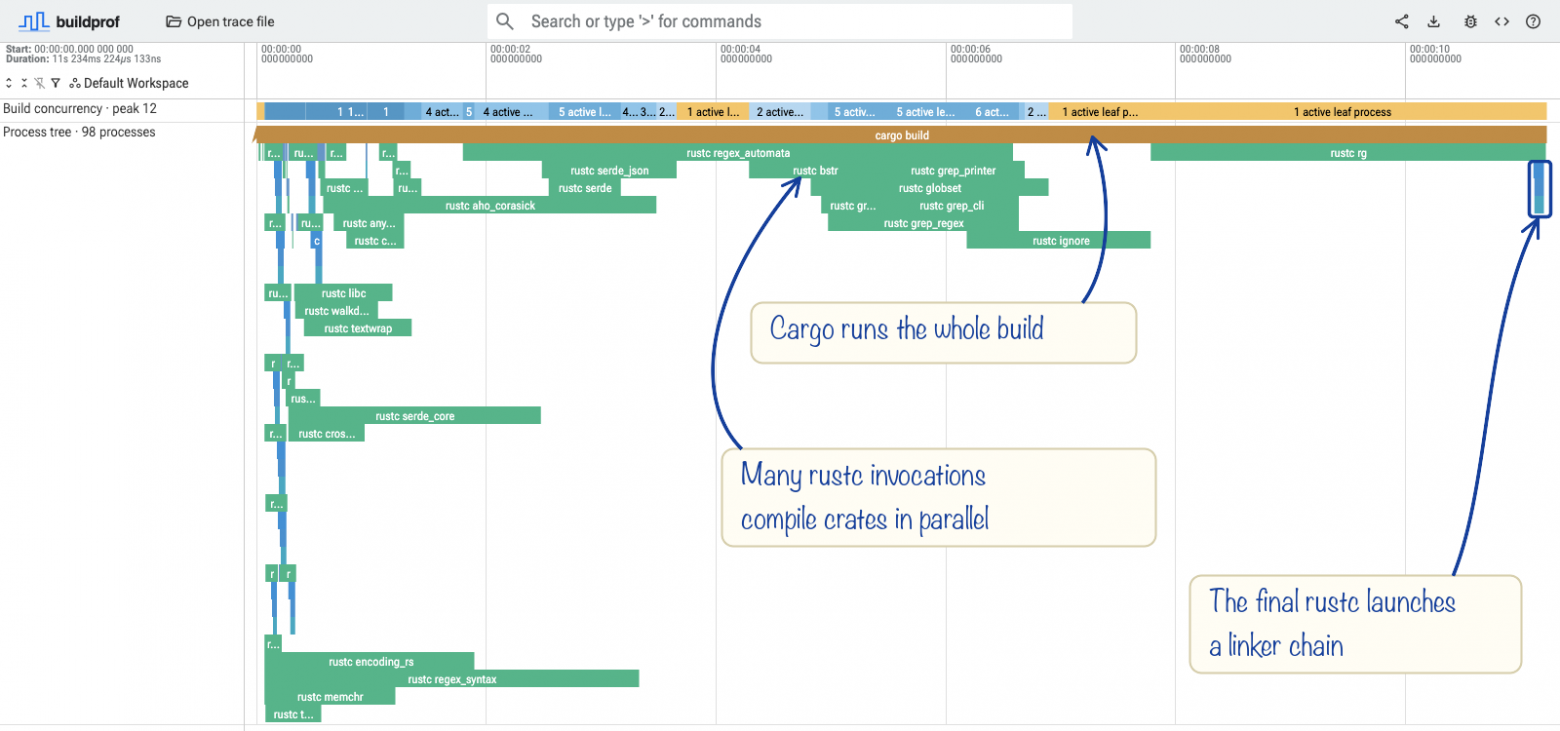
Сборка ripgrep: Cargo тянется через всю сборку, вызовы rustc параллельно компилируют крейты, последний rustc запускает цепочку линковки
Сделать buildprof меня заставил вот этот твит Джарреда Самнера, главного архитектора JavaScript-рантайма Bun. Он у меня никак не шёл из головы:
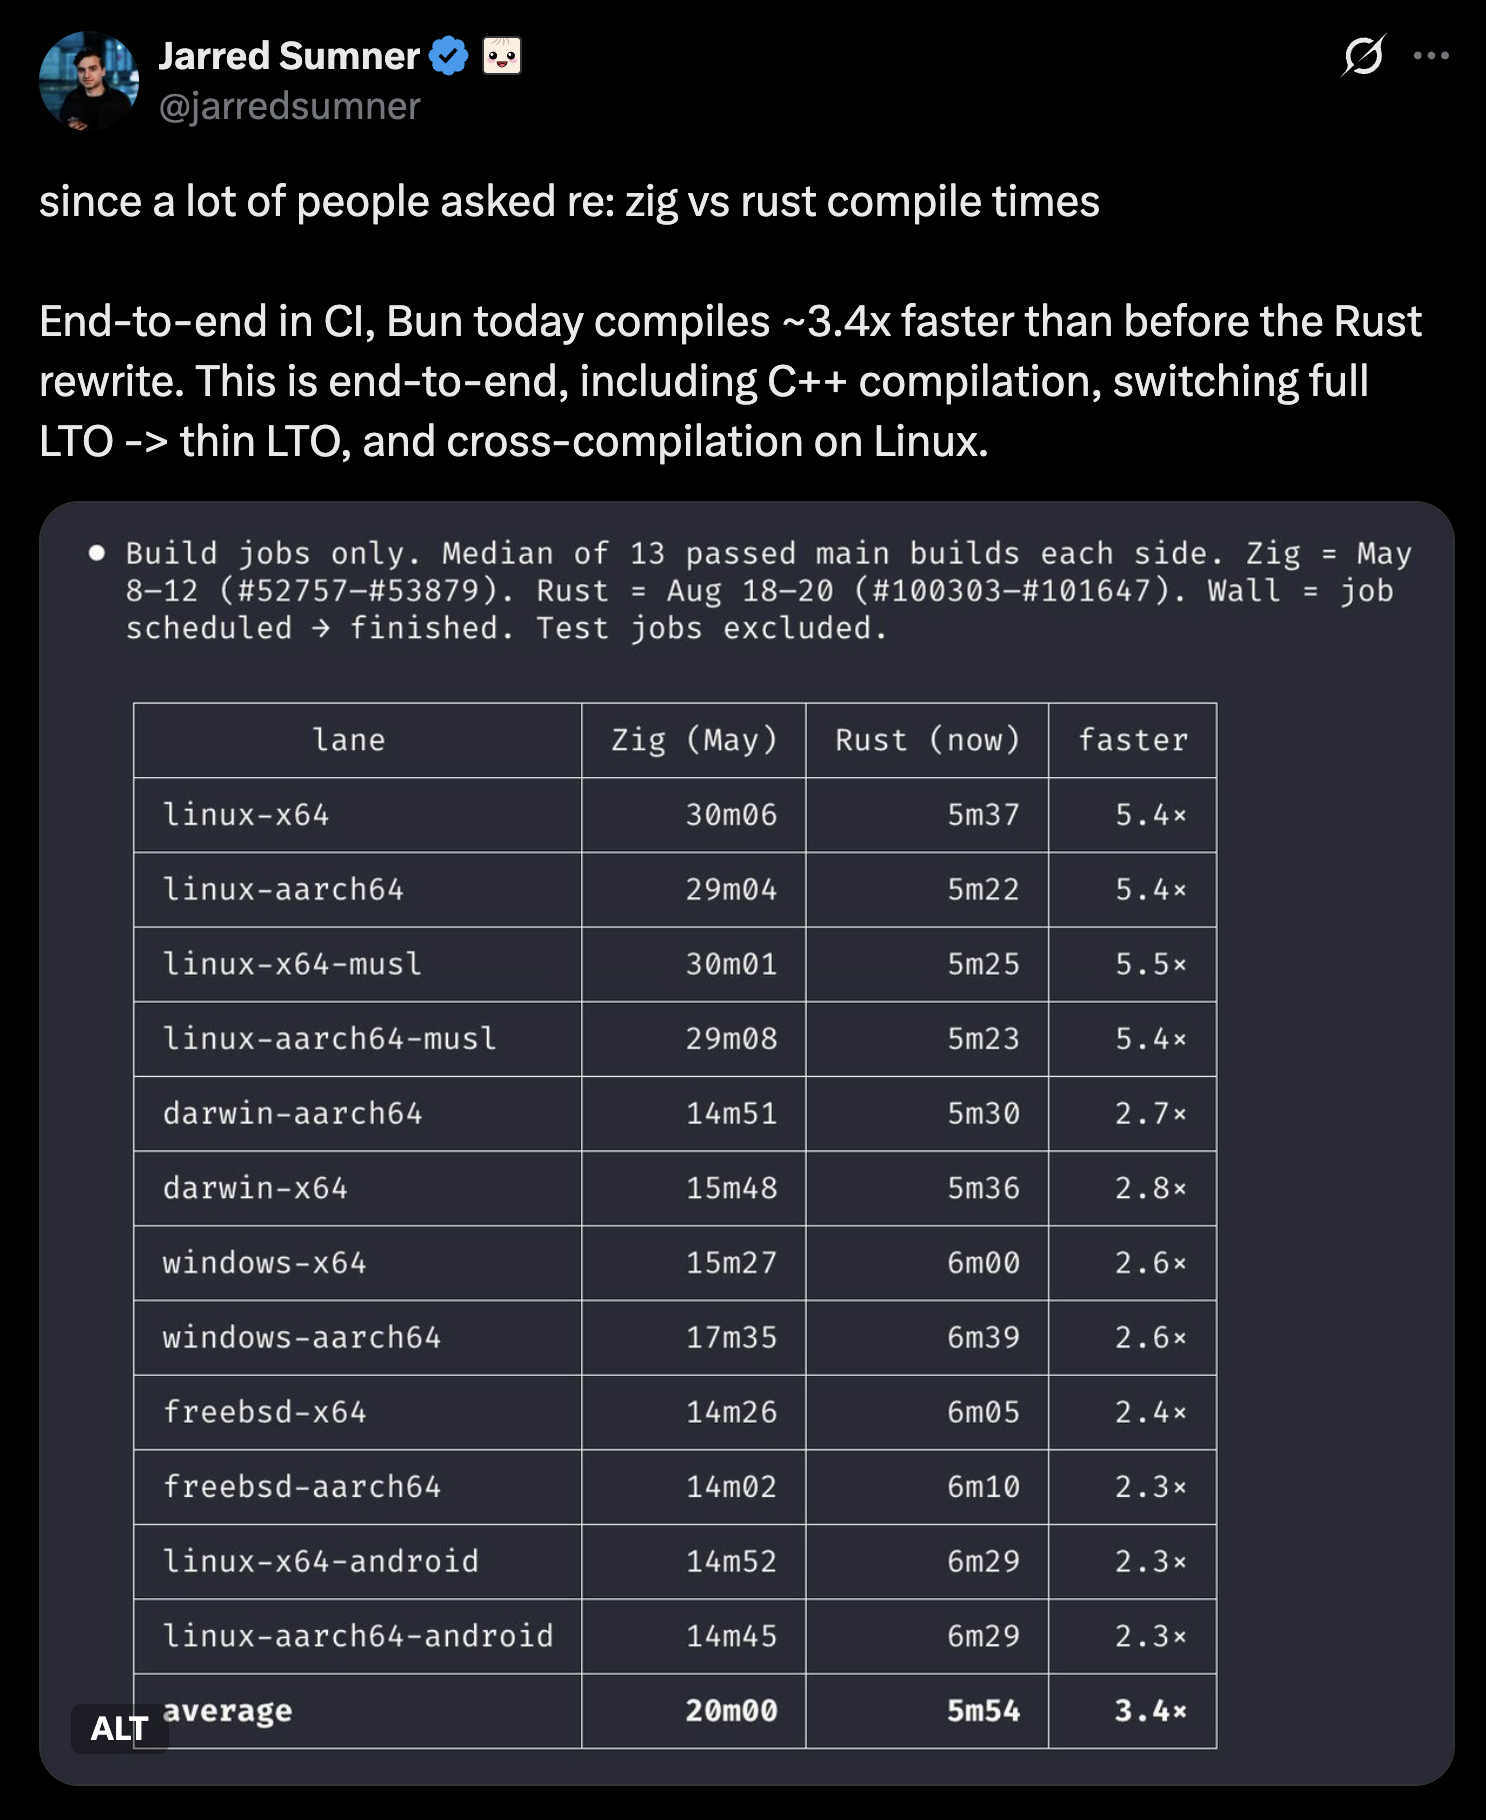
Сравнение Джарреда Самнера: медианная сборка Bun 1.3.14 под Linux — 30 минут 6 секунд, Bun 1.4.0 — 5 минут 37 секунд
Точнее, не давало покоя утверждение, что новая сборка Bun на Rust под Linux больше чем в пять раз быстрее старой сборки на Zig. По моему опыту, проекты на Zig обычно собирались намного быстрее проектов на Rust сравнимой сложности. Одного этого хватило, чтобы почуять загадку.
А ещё в твите была важная деталь, которую легко пропустить: сборка на Zig шла с Full LTO, а сборка на Rust — с ThinLTO.
Обычно компиляторы оптимизируют отдельные единицы компиляции почти независимо друг от друга [1]. Оптимизация во время линковки (LTO) позволяет оптимизировать через эти границы. Full LTO сводит все единицы в одну большую задачу оптимизации, а ThinLTO сохраняет больше разделения, и значительная часть работы может идти параллельно.
По прошлому опыту я знал, что эта разница может колоссально влиять на время сборки. В твите она упоминалась вскользь, и мне стало интересно, какую часть громкого ускорения она объясняет.
Начал я с того, что попробовал воспроизвести цифры.
Цифры воспроизвелись. И что дальше?
Я взял Bun 1.3.14 и Bun 1.4.0 и написал несколько скриптов, которые повторяют их CI-сборки под Linux x64 на виртуальной машине с 6 ядрами и 12 потоками. Скрипты сохраняли шаги сборки и зависимости между ними, но всё выполнялось на одной машине [2].
Мои замеры оказались того же порядка, что и у Джарреда:
Сборка под Linux x64 | Эпоха Zig | Эпоха Rust |
|---|---|---|
Медиана CI, которую привёл Bun | 30m06s | 5m37s |
Мой повтор CI-профиля на одной машине | 24m24s | 5m40s |
Итак, разрыв проявился и у меня. Но между двумя замерами поменялся не только язык, так что же на самом деле дало разницу? Может, всё это время съедал компилятор Zig? Или линковка с Full LTO? Или в сборке Bun было что-то ещё, о чём я даже не подумал?
Тут включился мой мозг человека, который занимается профилированием и инструментами разработчика. Когда я пытаюсь понять, почему что-то медленно, мне нужен трейс: что произошло, когда и сколько длилось. Было бы здорово получить такой трейс для этих сборок, положить их на шкалу и посмотреть, куда реально уходит время.
Но в сборке участвует куча разных инструментов, и у каждого своё представление о происходящем. Что можно записать, чтобы видеть их все разом?
Сборка — это дерево процессов
Когда вы набираете cargo build или zig build, кажется, что запускается одна программа. Система сборки решает, что нужно пересобрать, в каком порядке и что можно делать параллельно. Но всю работу она обычно сама не делает: она запускает компиляторы, генераторы кода, архиваторы, линкеры и произвольные скрипты. А те могут запускать новые программы, которые запускают ещё какие-то…
Разные системы сборки описывают эту работу по-разному. Cargo видит крейты, Ninja видит рёбра графа сборки, CMake генерирует инструкции для другой системы сборки. Но с точки зрения операционной системы всё это (в основном) выглядит как процессы, которые запускают другие процессы [3].
Например, в сборке на Rust может быть такая цепочка:
cargo
└── rustc
    └── cc
        └── collect2
            └── ld.lld
Если записывать, когда каждый подпроцесс стартует и завершается, их можно разложить на шкале. Вот как эта цепочка выглядит в buildprof:
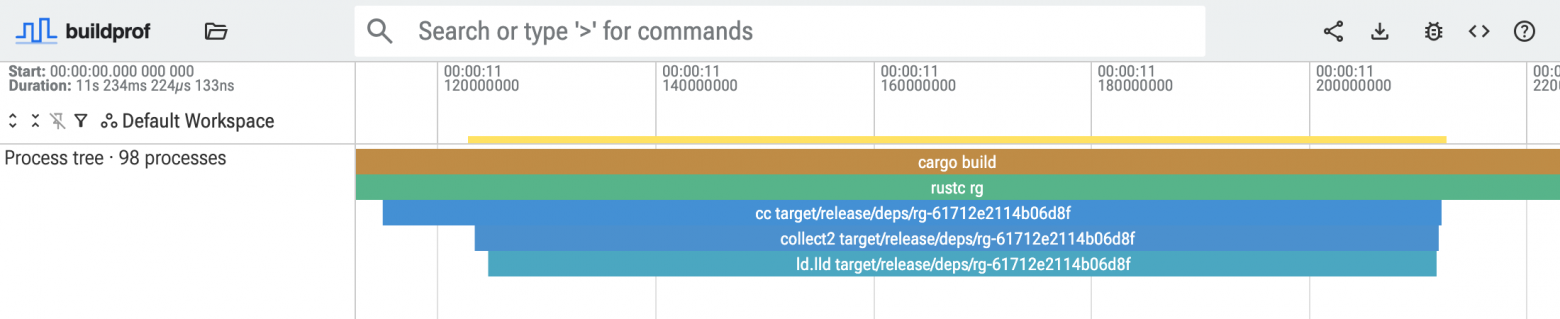
Финальная линковка в сборке ripgrep: cargo запускает rustc, под ним cc, collect2 и ld.lld
У визуализации сборки на этом уровне есть несколько приятных свойств:
Она не зависит от системы сборки. Cargo, Ninja, Zig, Make и большинство других систем делают основную работу, порождая процессы, так что под каждую не нужна отдельная интеграция.
Она сама собой включает самописные скрипты. И те, что над системой сборки (подготовка репозитория, загрузка зависимостей), и те, что под ней (генераторы кода, обработчики ресурсов).
По ней можно отследить файлы между шагами сборки. Если записывать, какие файлы каждый процесс читает и пишет, видно, какие шаги готовят входные данные для других. Это работает даже между разными системами сборки!
С этого и начался buildprof: записать дерево процессов и превратить его в шкалу, по которой можно ходить. Подробностей там ещё много, до них я доберусь позже. Но как только это заработало, я смог вернуться к исходному вопросу: чем Bun занимался все эти двадцать четыре минуты?
Натравливаем на Bun
Почему CI-сборка на Zig была настолько медленнее?
Сначала я записал CI-сборку эпохи Zig в buildprof, теми же скриптами, что и раньше:
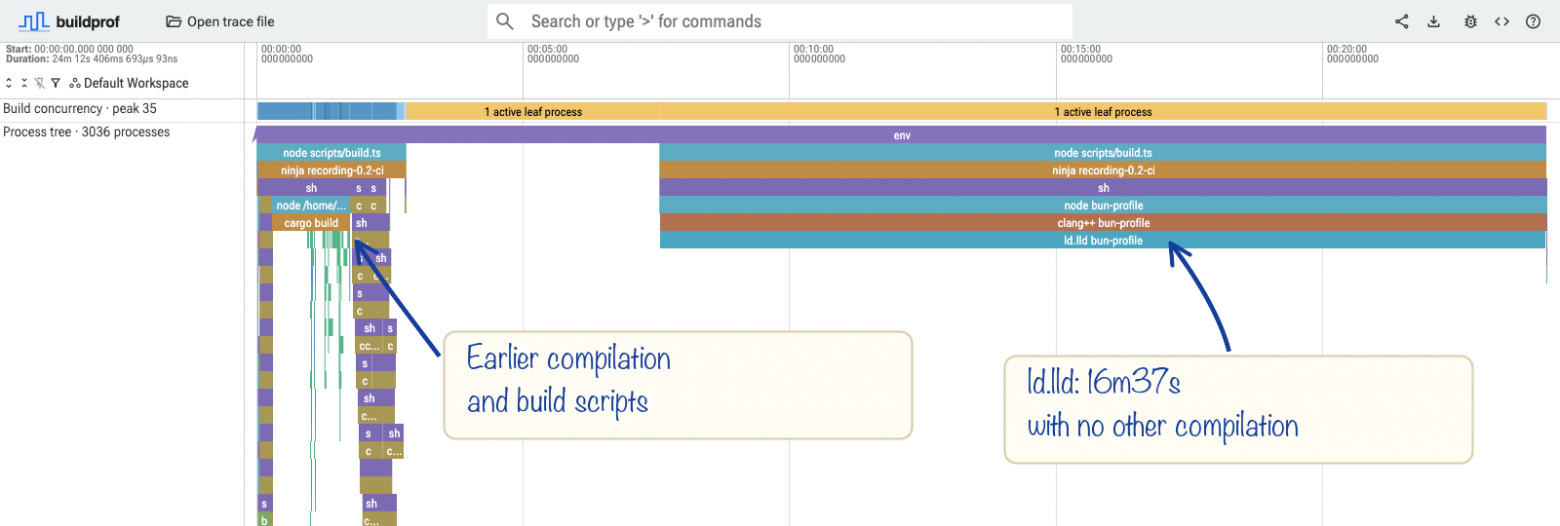
Полная CI-сборка эпохи Zig. Открыть в buildprof
Огромная проблема видна сразу: вызов линкера ld.lld доминирует во времени сборки. Он работал в одиночку в самом конце больше шестнадцати минут, около двух третей всей сборки. Чем он, чёрт возьми, всё это время занимался?
Если кликнуть на линкер, видна его командная строка — buildprof сохраняет её автоматически:
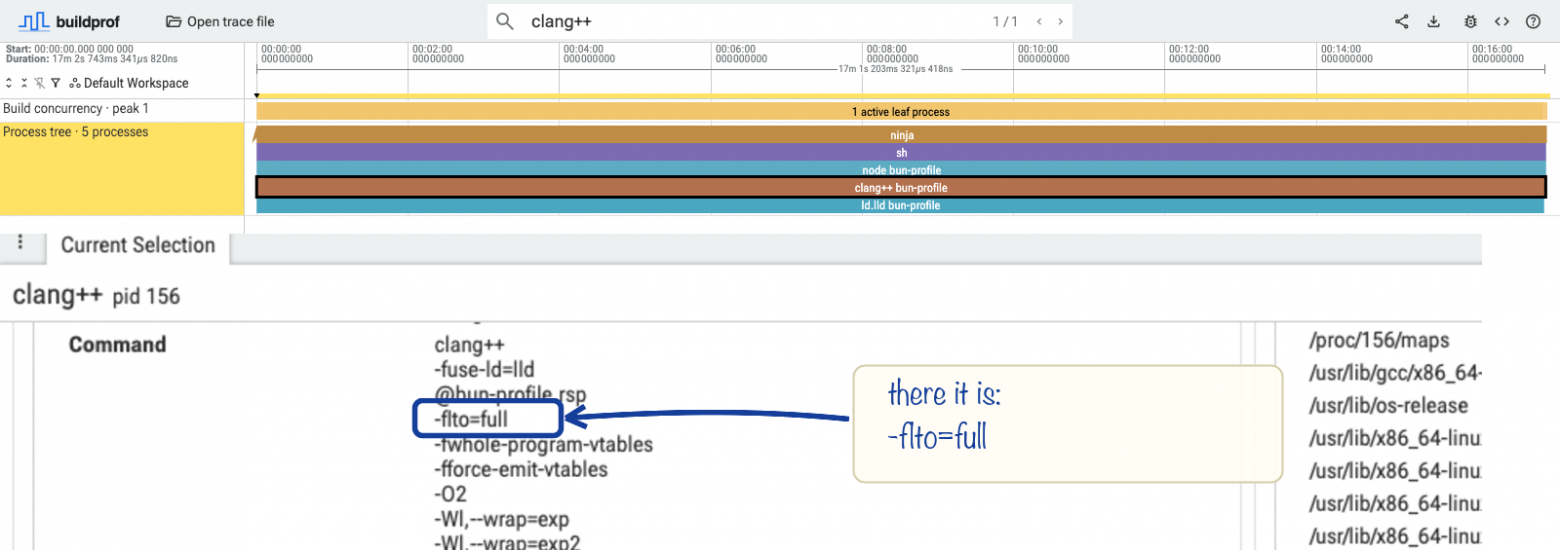
Выбранный линкер эпохи Zig и его флаг Full LTO
Вот и Full LTO, как и говорил Джарред. Раз линковка шла так долго, главным подозреваемым стал он.
Но одно дерево процессов не могло сказать, действительно ли эти шестнадцать минут — заслуга LTO. К счастью, LLD записывает собственные внутренние события с таймингами, и buildprof умеет их подхватывать с флагом --compiler-traces.
Я записал финальную линковку ещё раз, на этот раз с --compiler-traces:
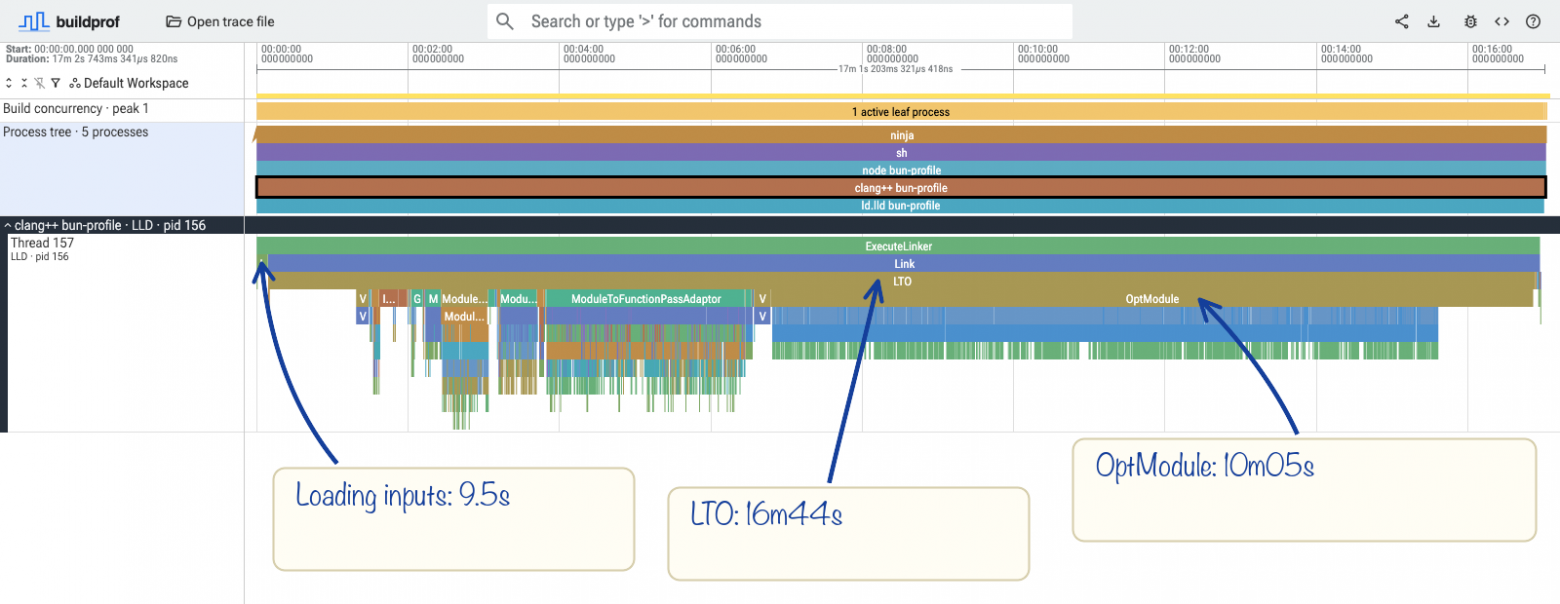
Внутренние фазы LLD. Открыть в buildprof
Теперь видно, что почти всё время действительно уходит на LTO. Линкер гоняет по программе проходы компилятора, а не просто склеивает уже скомпилированные файлы. Одна только полоса OptModule занимает чуть больше десяти минут, и в неё входят проходы, генерирующие машинный код [4].
А чем отличалась CI-сборка на Rust?
Раз в сборке на Zig столько времени уходило на LTO, мне захотелось посмотреть, сколько линкуется сборка на Rust. Записал и её:
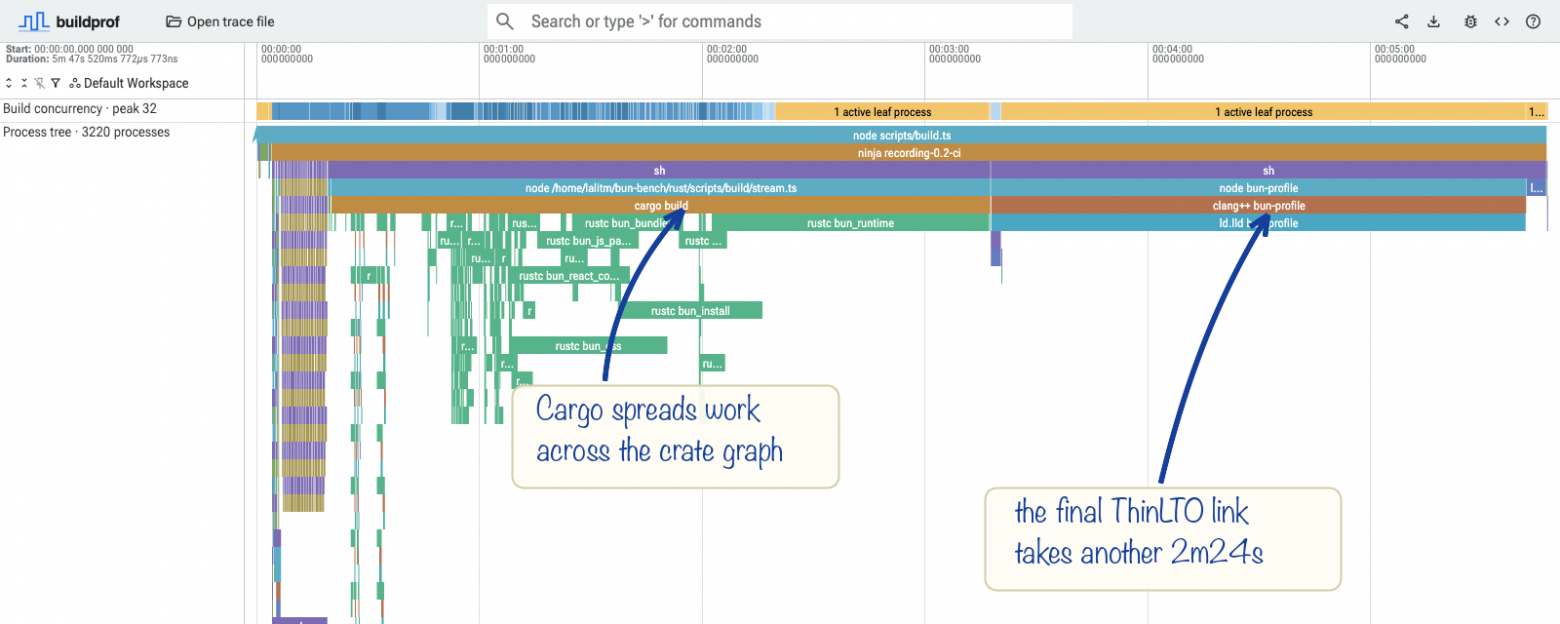
Полная CI-сборка эпохи Rust. Открыть в buildprof
Всего 2m24s. И, как и ожидалось, в командной строке линкера есть -plugin-opt=thinlto:
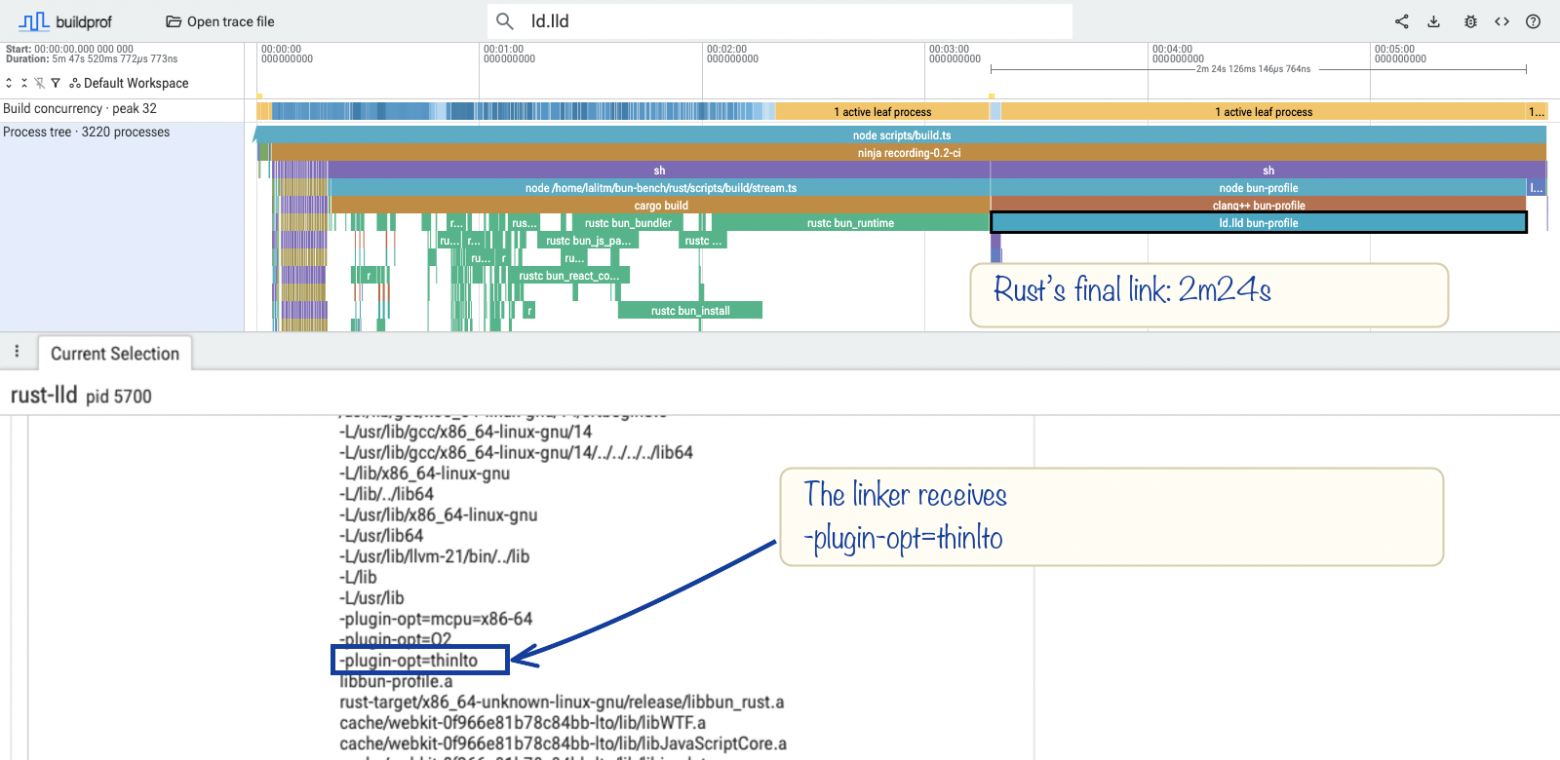
Вызов линкера в сборке на Rust с включённым ThinLTO
Обе сборки делали LTO, но с разными настройками и с очень разным временем линковки. А что, если оставить код Bun на Zig, но сменить Full LTO на ThinLTO? Какую часть разрыва это закроет?
Пробуем ThinLTO
Я переключил флаги сборки Bun на Zig на ThinLTO и записал ещё одну чистую сборку, а для сравнения — свежую сборку с Full LTO:
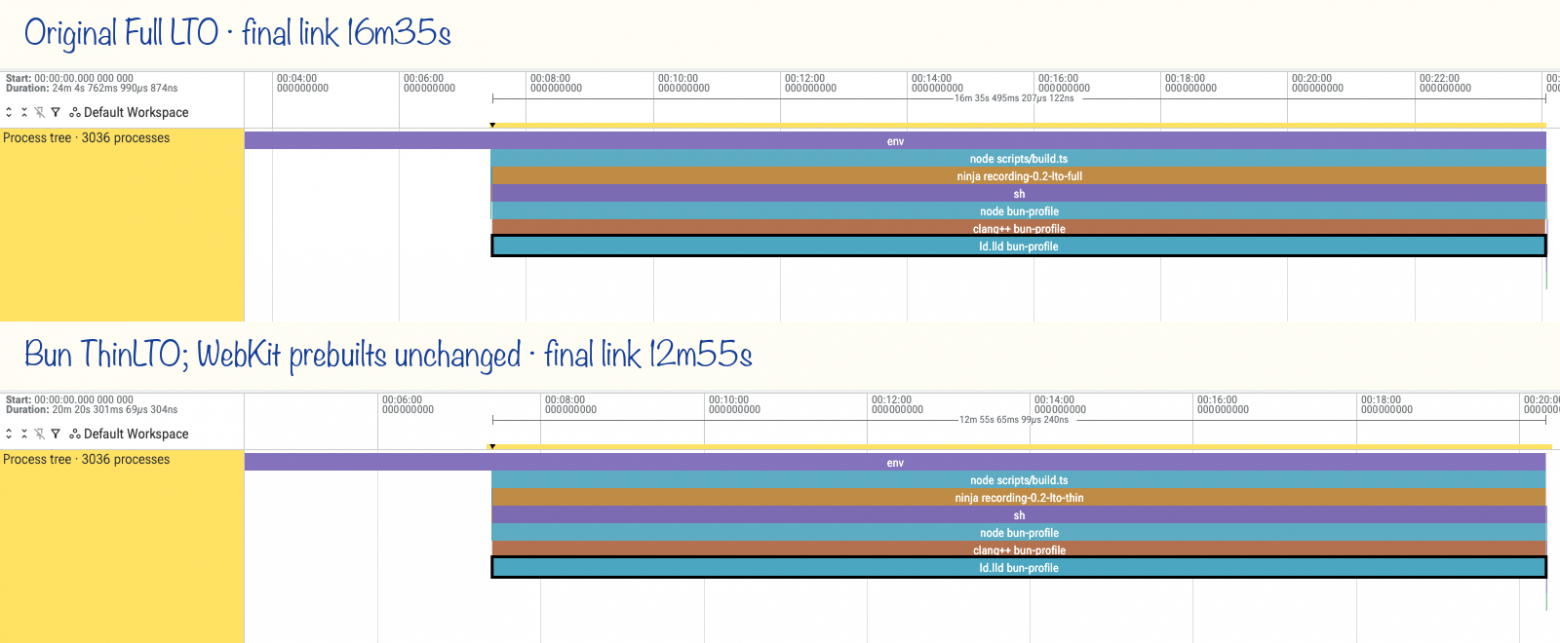
Открыть в buildprof: Full LTO · частичный ThinLTO
В этой паре записей линковка ускорилась на 3m40s, но всё равно занимала почти тринадцать минут. Почему она по-прежнему такая дорогая?
Вернувшись к трейсу компилятора, я заметил, что много работы приходится на функции с JSC в имени. Это JavaScriptCore, движок, на котором Bun выполняет JavaScript. Линкер заодно компилировал и JavaScript-движок [5].
Клик по вызову линкера показал среди его входных данных библиотеки WebKit, в том числе libJavaScriptCore.a:
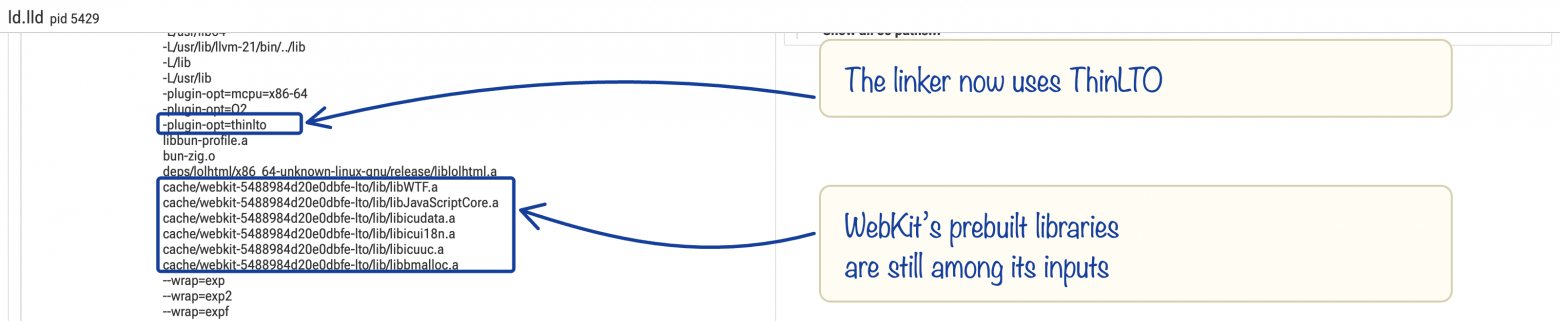
В команде линкера включён ThinLTO, но во входных данных по-прежнему библиотеки WebKit, включая libJavaScriptCore.a
Проследив эти входные данные назад по сборке, я выяснил, что Bun сам эти библиотеки не компилировал. Он скачивал их из отдельной сборки WebKit. А когда я проверил флаги той сборки, там снова было -flto=full. Сборка на Rust использовала более новую ревизию WebKit, в рецепте сборки которой был выбран ThinLTO.
Я поменял то, как Bun компилирует собственный код, но скачанные библиотеки всё равно содержали входные данные для Full LTO, и линкеру всё так же приходилось оптимизировать этот код и превращать его в машинный. Чтобы это изменить, пришлось бы пересобрать и WebKit.
Пересобираем WebKit
Я взял историческую ревизию WebKit и пересобрал её вместе с зависимостями ICU с совместимыми настройками ThinLTO. Затем подменил скачанные библиотеки собранными, оставив изменения ThinLTO в самом Bun.
Вот записанные сборки [6]:
Сборка эпохи Zig | Вся сборка | Финальная линковка |
|---|---|---|
Исходная, Full LTO | 24m24s | 16m35s |
Bun на ThinLTO, исходные архивы WebKit | 20m20s | 12m55s |
Bun на ThinLTO, пересобранные с ThinLTO WebKit и ICU | 15m11s | 7m22s |
Теперь линковка занимала 7m22s. Всё ещё медленнее, чем у сборки на Rust, но улучшение было достаточным, чтобы я захотел посмотреть дальше линкера.
А что с остальной сборкой?
Сборка всё равно шла пятнадцать минут, и почти восемь из них проходило до того, как линкер вообще стартовал. Чего он ждал? Я вернулся к исходному CI-трейсу, чтобы проследить входные данные от собственного кода Bun.
buildprof записывает ещё и то, какие файлы каждый процесс читает и пишет. Если процесс читает файл, который записал другой, buildprof у себя внутри связывает их. Опция «Show on timeline» рисует эти связи стрелками. Здесь линкер читает libbun-profile.a из компиляции C++ и bun-zig.o из Zig. Оба файла приходят через шаги копирования; если пройти по ним назад, попадаешь на процессы, которые их произвели:
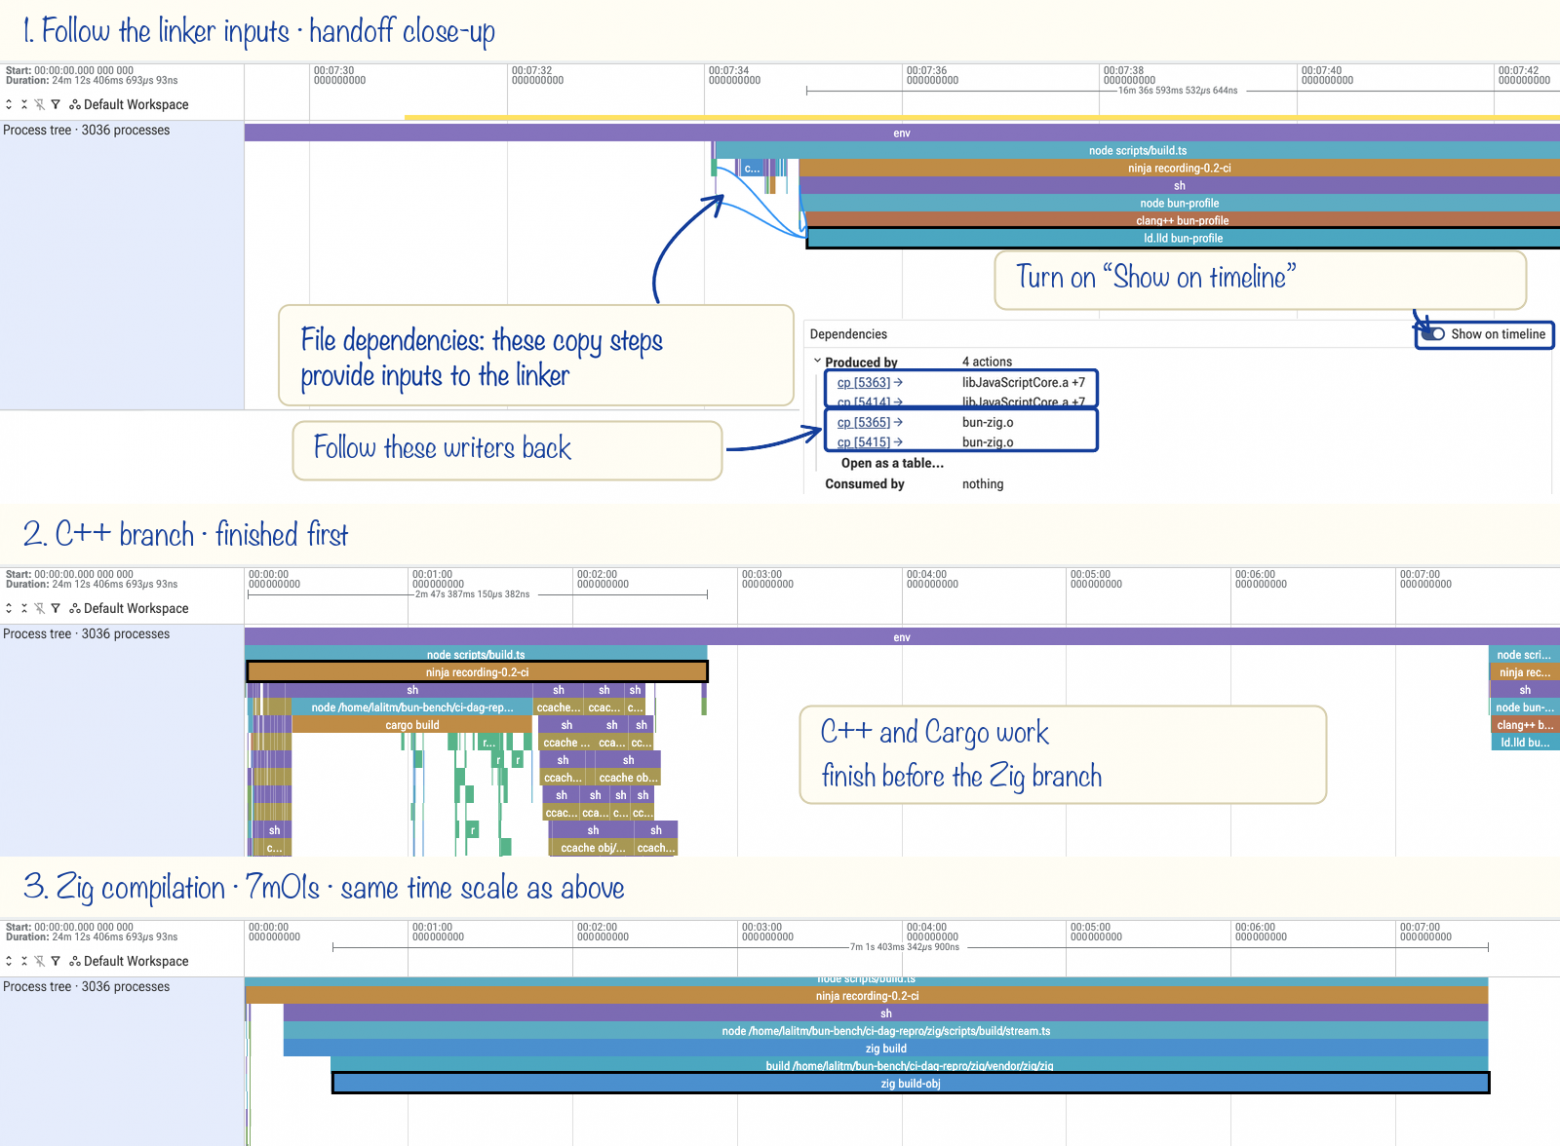
Идём по стрелкам зависимостей линкера через шаги копирования к производителям на C++ и Zig. Панели производителей в одном масштабе времени; C++ заканчивает первым
C+±часть компиляции закончилась первой. Линкер ждал bun-zig.o, поэтому не мог начать, пока не закончится и ветка Zig.
Тут я снова посмотрел на сборку на Rust, сравнил, как она устроена, и главная причина её скорости стала очевидной: Bun разбит больше чем на 90 крейтов, а на Zig всё пытались собрать как один модуль Zig!
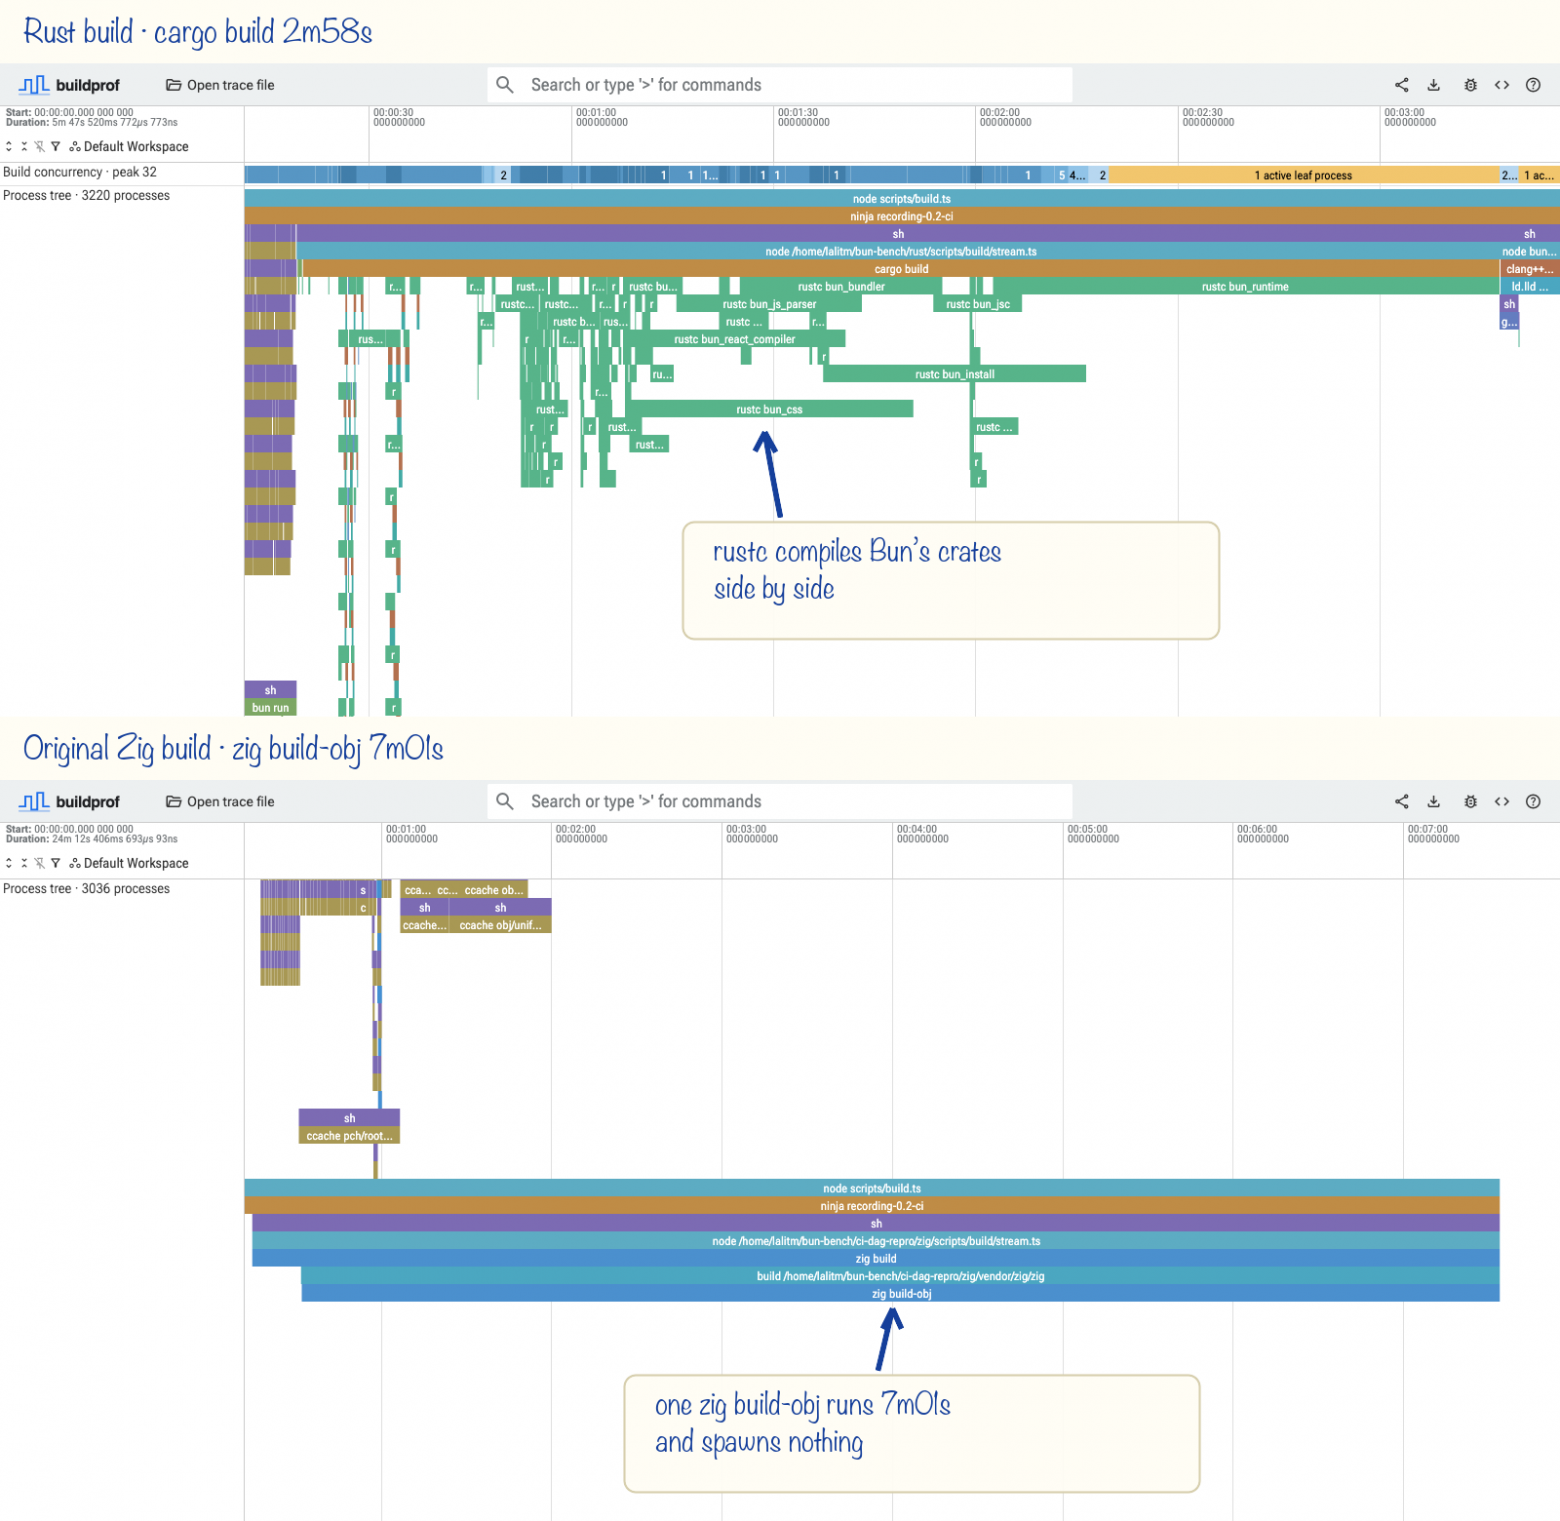
Cargo разветвляется на именованные процессы rustc по крейтам Bun, а рядом — единственный процесс zig build-obj, который вообще ничего не порождает
Значит, сборка на Zig не может распараллелиться так, как сборка на Rust. Подозреваю (хотя и не доказал), что этим же объясняется медленная линковка: линкеру приходится оптимизировать один огромный модуль биткода ThinLTO там, где у Rust та же работа разнесена по крейтам.
На этом мне пришлось остановиться: чтобы идти дальше, нужно было бы самому разбить модуль Zig на части, а раз этот код всё равно уже устарел, я решил, что оно того не стоит.
Итого:
Главной аномалией исходной сборки на Zig по сравнению со сборкой на Rust был гигантский шаг линковки, который в одиночку шёл в самом конце.
Поменять настройки LTO только для Bun было недостаточно: WebKit, существенная часть сборки, по-прежнему использовал Full LTO.
Когда я поменял и его, сборка на Zig ускорилась с двадцати четырёх минут до пятнадцати.
Даже после этого линковка занимала 7 минут, а вся сборка — 15.
Подавляющая часть оставшейся разницы — структурная: Rust распределяет компиляцию по 90 с лишним крейтам, а сборка на Zig прогоняла всё через один модуль.
И раз уж на то пошло, в трейсах нашлось ещё несколько вещей, мимо которых я не смог пройти…
Что ещё пряталось в сборке
В сборке может оказаться что угодно
Посреди CI-сборки Bun я нашёл команды, которые спрашивают у публичного интернета IP-адрес машины, разглядывают запущенные Docker-контейнеры и читают сообщение последнего Git-коммита.
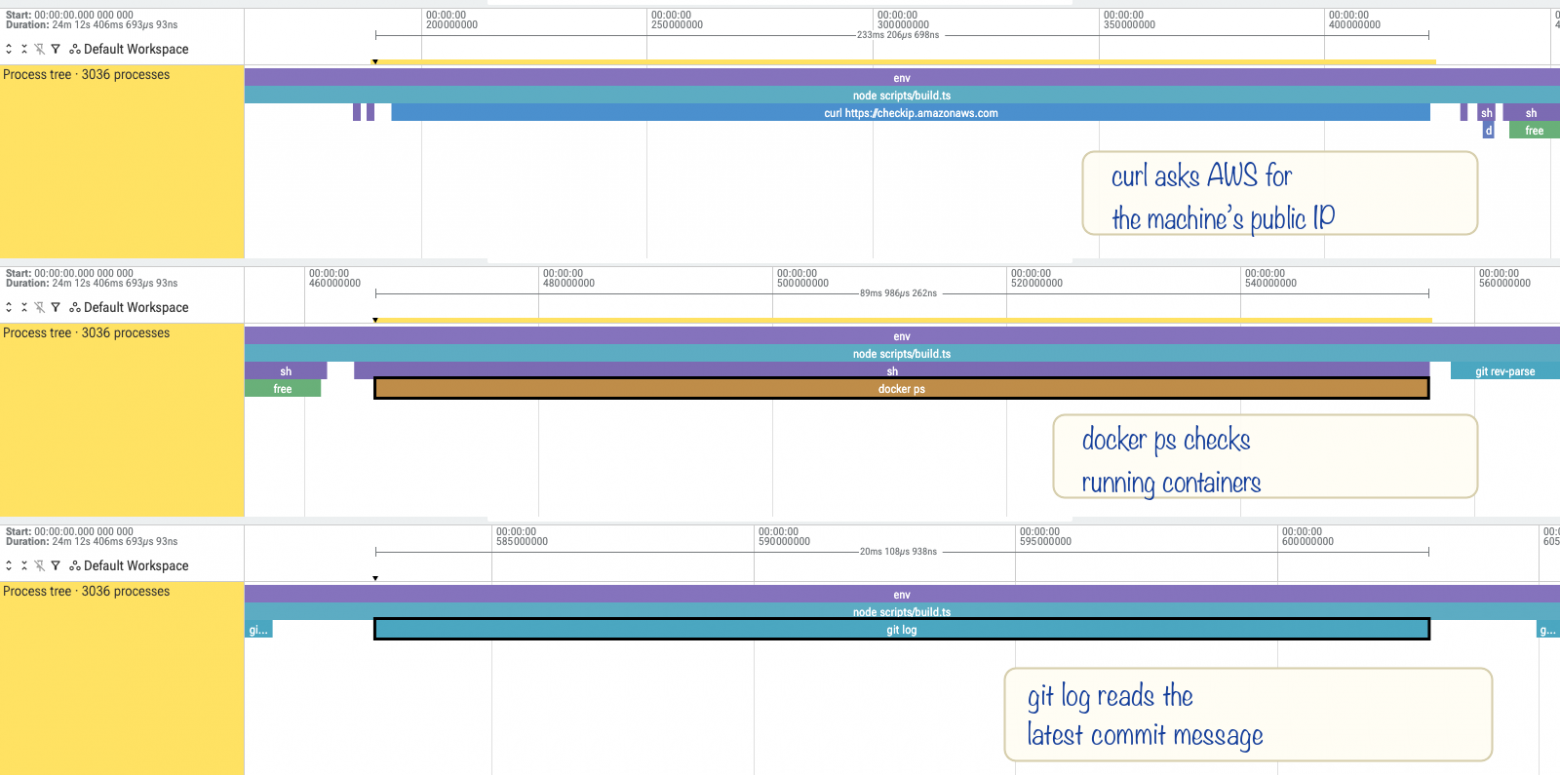
Мелкие команды настройки CI в дереве процессов
Все вместе они занимают куда меньше секунды. Оптимизировать нечего, просто я не ожидал встретить их в трейсе сборки.
Холодная загрузка зависимостей
Сборки выше переиспользовали уже скачанные зависимости, поэтому я ещё записал свежую загрузку WebKit. Скачивание и распаковка архива заняли около двадцати секунд. Первые двенадцать мы видим только работающий Node. Потом он запускает tar и gzip, и распаковка видна отдельно.
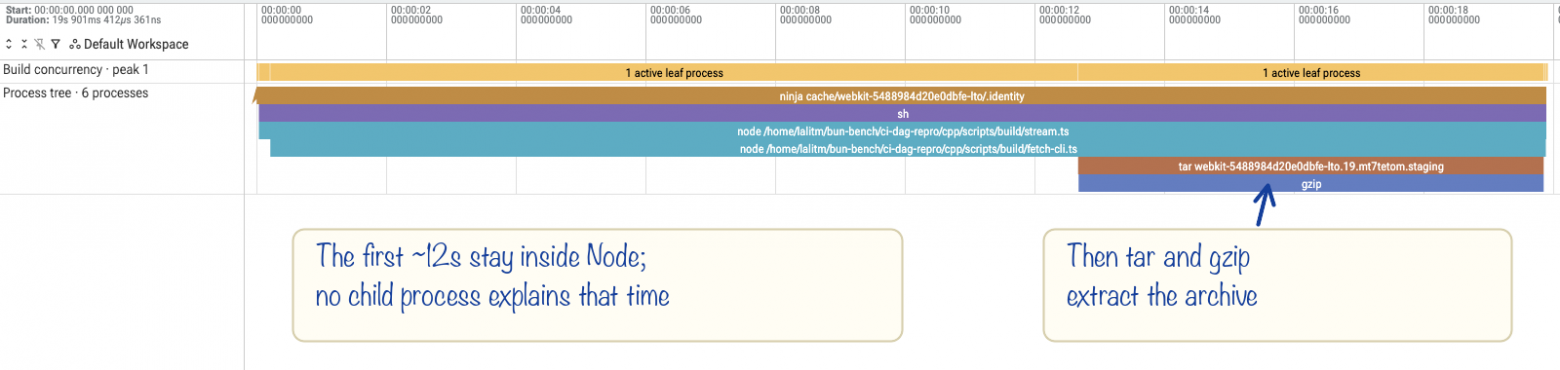
Холодная загрузка и распаковка WebKit
Заглядываем внутрь одной компиляции C++
Раньше мы прошли от входных данных линкера назад к компиляции C++ в Bun. Внутрь вызовов компилятора тоже можно заглянуть. Я выбрал один из последних заканчивающихся файлов, ZigGeneratedClasses.cpp, и повторил его команду из Ninja с --compiler-traces. Для Clang buildprof включает -ftime-trace и добавляет его внутренние тайминги на шкалу процессов [7].
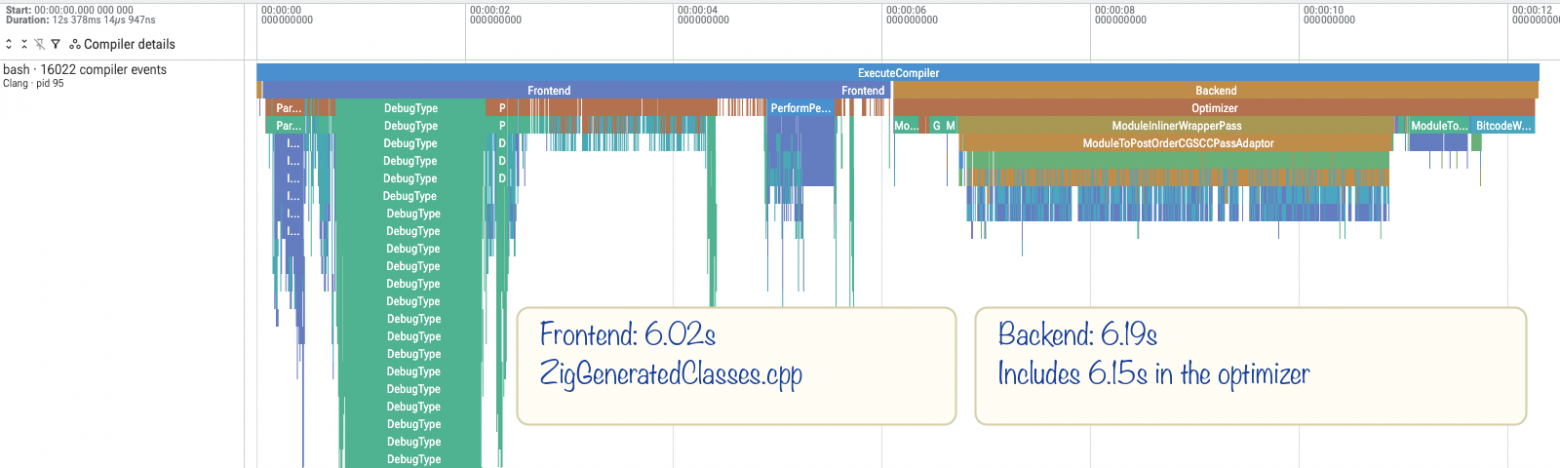
Фазы фронтенда и бэкенда Clang при компиляции ZigGeneratedClasses.cpp
Повтор занял около двенадцати секунд, почти поровну между фронтендом и бэкендом Clang. Если приблизить, видно, что на ModuleInlinerWrapperPass, одну из фаз Clang, приходится больше четырёх секунд работы бэкенда.
Как buildprof устроен внутри
Записывающая часть buildprof использует ptrace, тот же интерфейс Linux, что и отладчики. Я рассматривал и eBPF, и ftrace, но ptrace идеально подходит именно для такой задачи. Трассировка через eBPF требует прав CAP_BPF и CAP_PERFMON и цепляется к потенциально нестабильным точкам трассировки и функциям ядра. С ftrace пришлось бы жонглировать экземплярами трассировки, чтобы не мешать другим пользователям. Да и фильтры, которые ловят ровно процесс сборки и всех его потомков, настраивать муторно [8].
С ptrace я могу запустить сборку и напрямую следить за её потомками. Его встроенные события сообщают buildprof, когда процессы делают fork, exec новой программы или завершаются. А для работы с файловой системой buildprof ставит seccomp-фильтр, который перехватывает только нужные ему вызовы.
Во что обходится buildprof, почти целиком зависит от того, сколько файлов открывает сборка. Для ripgrep запись почти не изменила время сборки. Redis открывал файлы гораздо чаще, и запись добавила около пяти секунд [9]:
Сборка | Без трассировки | Только процессы | Процессы + файлы |
|---|---|---|---|
ripgrep / Cargo | 12.27s | 12.30s | 12.43s |
Redis / Make | 26.78s | 27.04s | 31.89s |
Если эти накладные расходы мешают, трассировку файловой системы можно отключить флагом --no-file-events и оставить только шкалу процессов.
Я работаю над Perfetto, так что для интерфейса он был естественной отправной точкой: UI buildprof — мягкий форк UI Perfetto. Можно было бы просто открывать записи на ui.perfetto.dev, но мне хотелось самому решать, как раскладывать дерево процессов, какие подробности показывать по клику на команду, и делать вещи вроде тех самых стрелок по запросу между производителями и потребителями файлов.
К счастью, последние несколько лет мы делали UI Perfetto расширяемым через плагины. Большая часть UI buildprof переиспользует эту инфраструктуру. Сложное (разбор трейсов, запросы к событиям, отрисовку шкалы и управление рабочими пространствами) берёт на себя Perfetto, а я могу сосредоточиться на том, что делает всё это полезным для сборок.
Про записывающую часть и UI я собираюсь подробно рассказать в отдельном техническом посте.
Нужно ли было делать что-то новое?
Сейчас очень легко сделать инструмент просто потому, что можешь. Но здесь было не так: прежде чем браться за buildprof, я долго и упорно искал готовый инструмент, который дал бы мне такую картину.
Начал я с ninjatracing, которым пользовался много раз. Он превращает лог сборки Ninja в шкалу, где видно, что запускалось и сколько шло параллельно.
Вот лог Ninja из сборки эпохи Zig.
Но Ninja видит только часть сборки Bun. Скриптов, которые его вызывают, в его логе нет, а запущенные им команды выглядят цельными блоками, даже если порождают целые деревья подпроцессов.
Нашлось ещё несколько инструментов, каждый из которых закрывал свою часть задачи:
Cargo timings хорошо работает для сборок под управлением Cargo, но не может разложить произвольную работу внутри
build.rsи не видит скриптов-обёрток над Cargo. В Bun Cargo — лишь часть сборки: снятый мной отчёт покрывал 1m51s из 5m40s CI-сборки.-ftime-traceв Clang показал подробности внутри вызова компилятора, но не может показать, что в это время делает остальная сборка. Интеграция Zig с Tracy копает ещё глубже, но рассчитана скорее на то, чтобы разбираться в самом компиляторе.straceиtracexecумеют следить за произвольными процессами черезforkиexec, но показывают общие события процессов; шкалы, заточенной под сборку, у них нет.
Ближе всех подобрался What the Fork (через HN): он следит за процессами в разных системах сборки и показывает картину, заточенную под сборку. Но, насколько я понял, он всё ещё в закрытой бете, и открывать исходники, похоже, не планируют.
Что дальше с buildprof
buildprof уже делает то, чего я от него хотел, и я собираюсь дорабатывать его по мере того, как пользуюсь им на своих сборках. Но кое-что хотелось бы улучшить.
Во-первых, накладные расходы на запись: замеры на Redis показали, что трассировку файловой системы есть куда ускорять, особенно для сборок, которые открывают много файлов. Ещё хотелось бы поддержать macOS, где я тоже частично работаю, и, может быть, Windows, если будет интерес.
Есть и другие системы сборки и тулчейны, на которых я хочу его проверить, включая npm, Gradle и Bazel. Большим шагом вперёд был бы расчёт критического пути: в этом посте мы шли по зависимостям вручную, а buildprof мог бы сам находить цепочку работы, которая держит сборку, и подписывать её.
Скорее всего, я возьмусь за это, когда оно мне понадобится.
Вывод
Любопытство я удовлетворил, хотя потратил на это заметно больше времени, чем рассчитывал. А по дороге сделал инструмент, который теперь хочу держать под рукой каждый раз, когда сборка идёт слишком долго.
Примечания
В C и C++ единица компиляции — это обычно исходный файл вместе с подключёнными заголовками. Rust компилирует крейты, которые можно разбить на несколько единиц генерации кода. Zig обычно компилирует все исходники программы на Zig вместе, как одну единицу компиляции. Форк компилятора Zig, которым пользуется Bun, умеет делить её на несколько модулей LLVM, но CI-сборка Bun при включённом LTO явно выбирала один.
CI-сборка эпохи Zig выполняла этапы компиляции C++ и Zig на разных машинах Buildkite и передавала результаты на финальный этап линковки. Мой скрипт запускал эти этапы одновременно на одной машине, ждал оба результата, копировал их локально вместо передачи по сети и потом линковал. Граф зависимостей при этом должен сохраняться, но из-за другого железа и того, что оба этапа шли на одной машине, конкуренция за ресурсы, очевидно, была совсем другой. Учтите ещё, что мои тайминги — одиночные прогоны (хотя и довольно стабильные), а цифры Bun — медианы.
Процесс может проделать большую работу внутри себя, в том числе в нескольких потоках, ничего больше не запуская. Шкала процессов такой параллелизм не покажет. Чтобы заглянуть внутрь процесса, нужна трассировка от самой программы, как у Clang и LLD в примерах в статье.
LLVM выдаёт событие
OptModuleиз своего legacy-менеджера проходов, который LLD использует для генерации кода. Инлайнинг и другие проходы оптимизации IR могут идти до него, так что эта полоса — не всё время, потраченное на оптимизацию модуля.В той же записи линковки с Full LTO 26 825 событий
OptFunctionс символами JSC в сумме дают около 209 с. Это суммарное время событий; весь вклад JavaScriptCore в линковку оно не измеряет. Одно событие для примера длится 2,94 с, его символ после деманглинга —JSC::JITThunks::initialize(JSC::VM&).Скрипт записи. Эти тайминги — только сборка Bun с уже готовыми библиотеками; пересборка WebKit и ICU была раньше и в них не входит. Можно, конечно, натравить buildprof и на неё, но это уже другая кроличья нора… Контрольный архив WebKit с Full LTO я не пересобирал, поэтому не могу приписать каждую сэкономленную секунду одной только настройке LTO.
Сейчас buildprof поддерживает трейсы компилятора от Clang, LLD и nightly Rust.
Трассировка через eBPF использует права вроде
CAP_BPFиCAP_PERFMON, как описано в определениях capabilities в ядре. ftrace даёт отдельные экземпляры трассировки и фильтры по PID, но их всё равно нужно настраивать и иметь доступ к tracefs.ptraceтоже зависит от настроек безопасности хоста: контейнерам могут понадобиться дополнительные права, чтобы трассировать дочерние процессы.Медианы пяти чистых сборок в каждом режиме на одной и той же ВМ, шесть заданий сборки. Скрипт замера.

KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.