Криптохеш: почему нельзя обратить функцию, если все операции обратимы
У вас не возникало желания понять, почему майнеры тратят уйму электричества на перебор хешей, вместо того чтобы вычислить нужное значение алгебраически? Ведь все элементарные операции обратимы – в какой момент из обратимых операций появляется функция, для которой уже нельзя написать обратную? Где именно сокрыта магия?
Это попытка объяснить на пальцах, как из простых и обратимых операций, таких как сложение (+) и умножение (*), а также остатка от деления (условно обратимой операции) собрать одностороннюю функцию. Такую, для которой не получится не просто восстановить оригинальное значение (понятно, что остаток от деления приводит к потере части информации), а найти вообще хоть какое-нибудь число, для которого функция выдаст заданный хеш.
Необратимая функция – это математическая операция, которую легко и быстро выполнить в прямом направлении, но практически невозможно найти исходный аргумент по известному результату.
Представим, что у нас есть некоторое неизвестное число x. Мы передаём его функции f и получаем конкретное число y:

Теперь поставим обратную задачу. Мы знаем результат y и знаем, как устроена функция f (её исходный код открыт). Что мешает нам просто выполнить все операции в обратном порядке и вычислить x?
Причём нам совершенно не обязательно находить исходное значение x. Подойдёт любое число, для которого функция выдаст тот же результат y.
На первый взгляд, никаких проблем возникнуть не должно. Ведь сложение и умножение – простые операции, для которых существуют обратные: вычитание и деление.
Ещё со школы мы знаем, как решать такие уравнения.
Начнём со сложения

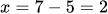
Чтобы найти неизвестное x, достаточно перенести пятёрку в правую часть:
Аналогично с умножением

Делим обе части на пять и получаем:

Остаток от деления
Ещё потребуется остаток от деления, или операция по модулю, которая в программировании обычно обозначается символом %.
Например, 17 % 5 = 2. Мы делим 17 на 5, получаем 3 и остаток 2. Именно этот остаток и является результатом операции.
На первый взгляд, здесь уже возникает проблема. Ведь по одному остатку невозможно восстановить исходное число. Но вспомним наше условие: нам не требуется восстановить именно исходное число – подойдёт любое, которое даст тот же результат.
Попробуем обратить операцию взятия остатка:

Каким может быть x? Например, 2, 7, 12, 17, 22 и так далее. Все эти числа при делении на 5 дают остаток 2.
Иначе говоря, у нас есть даже готовая формула:

где k – любое целое число.
А если нам подходит любое решение, можно просто взять k = 0 и получить x = 2.
То есть операция взятия остатка от деления действительно необратима в строгом математическом смысле: мы не можем однозначно восстановить исходное число. Но найти хотя бы одно подходящее значение совершенно несложно.
Итак, со сложением и умножением всё предельно просто: если к неизвестному числу что-то прибавили, мы это вычитаем. Если умножили на ненулевое число – делим. Даже остаток от деления сам по себе не представляет проблемы, если нам подходит любой исходный аргумент.
И если таких операций будет не две, а тысяча, казалось бы, ничего принципиально не изменится. Обратимые операции можно выполнять в обратном порядке, начиная с последней, а там, где возникает несколько возможных значений, – выбирать любое подходящее.
Я выбрал максимально простую программу, которая уже обладает магическим эффектом – после некоторого шага уже не позволяет применить привычные алгебраические вычисления. Вся программа будет состоять из повторяющейся инструкции:
export function hash(m: number): number {
  let x = m;
  x = (x * x + m) % P; // шаг 1
  x = (x * x + m) % P; // шаг 2
  x = (x * x + m) % P; // шаг 3
  // ...
  x = (x * x + m) % P; // шаг N
  return x;
}
Вроде бы всё просто – умножение и сложение. Но в какой-то момент найти обратное уже невозможно, причём момент наступает достаточно быстро.
Так в какой же момент эта простая схема перестаёт работать и возникает магия?
Давайте по порядку…
Шаг 1
Тут всё легко. К нашему значению x мы будем применять одну и ту же формулу последовательно несколько раз. Для первого шага – только один раз. Вот эта формула:
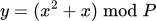
Или запись в TypeScript:
export function hash(m: number): number {
  return (m * m + m) % P;
}
Интересно, что сама по себе формула довольно простая – это то самое квадратное уравнение из школы. И несмотря на остаток от деления, если P – простое число, обратную задачу по-прежнему можно решить достаточно быстро. Мы можем найти подходящее значение без особых проблем!
При условии, что P – нечётное простое число, обратную задачу можно записать следующим образом.
Исходная функция:
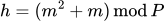
Это квадратное уравнение, которое без модуля имело бы вид:
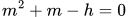
По школьной формуле находим дискриминант и корни:

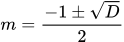
Теперь учитываем модуль P.
Дискриминант вычисляем по модулю:
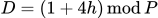
Минус единицу заменяем на P − 1:
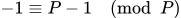
Деление на 2 заменяем умножением на (P + 1) / 2, поскольку:
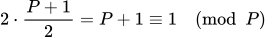
Остаётся найти квадратный корень по модулю, то есть такое число s, для которого:
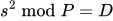
И получаем итоговую формулу:
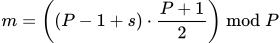
Здесь s – один из квадратных корней дискриминанта по модулю P. Если такого корня нет, решений тоже нет. Если есть, формула даёт подходящее значение m.
Таким образом, даже после добавления остатка от деления квадратное уравнение по модулю простого числа всё ещё можно эффективно решить.
Реализация этого примера – шаг 1 (step1.ts).
Шаг 2
Теперь наша функция принимает вид:
export function hash(m: number): number {
  let x = m;
  x = (x * x + m) % P; // шаг 1
  x = (x * x + m) % P; // шаг 2
  return x;
}
Можно подставить вместо x во втором шаге выражение из первого шага и записать иначе:
export function hash(m: number): number {
  let x = (((m * m + m) % P) * ((m * m + m) % P) + m) % P;
  return x;
}
Если раскрыть скобки:
export function hash(m: number): number {
  let x = (m * m * m * m + 2 * m * m * m + m * m + m) % P;
  return x;
}
Видно, что уже на втором шаге у нас возникло уравнение 4-й степени. Каждый новый шаг, при видимой простоте записи в коде, увеличивает степень уравнения. И это проблема, возможно, вы помните ещё со школы:
Теорема Абеля – Руффини утверждает:
Для произвольного полиномиального уравнения пятой степени и выше не существует общей формулы в радикалах (то есть выражающей его корни через коэффициенты с помощью конечного числа сложений, вычитаний, умножений, делений и извлечений корней).
Но тут есть нюанс. У нас-то уравнения по модулю, а не обычные, и для них таки алгоритмы существуют. Но и они не настолько оптимальны, как хотелось бы.
Реализация этого примера – шаг 2 (step2.ts).
Дальнейшие шаги
На третьем шаге у нас получится уравнение уже 8-й степени, на четвёртом – 16-й, на пятом – 32-й и так далее.
То есть каждый новый шаг удваивает степень уравнения. И уже после 20 шагов мы получаем степень больше миллиона.
В репозитории есть примеры для 17 шагов (step17.ts) и 25 шагов (step25.ts), а также реализация самого алгоритма обращения (algebra.ts).
Конкретная оценка для алгоритма Кантора – Цассенхауса:
P | Шагов, чтобы степень догнала P | Время | Память |
|---|---|---|---|
2²⁰ (наш) | 20 | 2–3 мин | ~1 ГБ |
2²⁴ | 24 | ~1 ч | ~20 ГБ |
2³⁰ | 30 | ~4 дня | ~1 ТБ |
2⁴⁰ | 40 | ~20 лет | ~1 ПБ |
2⁶⁴ | 64 | ~10⁸ лет | ~10¹⁰ ТБ |
2¹²⁸ | 128 | ~10²⁸ лет | ~10²⁹ ТБ |
2²⁵⁶ | 256 | ~10⁶⁷ лет | ~10⁶⁸ ТБ |
Выводы
Внимательный читатель заметит, что строгого математического доказательства невозможности решить данное уравнение за приемлемое время у меня нет (как нет такого доказательства и для SHA-256 – всё держится на вере, по сути).
Но уже понятно, что если быстрое решение и существует, то математика там достаточно сложная. Для большинства хватит посмотреть на существующее медленное решение, чтобы понять: халявы там нет, даже продвинутая математика пока не работает. Быстрое решение, если и существует, найти не так просто.
Можно поклацать онлайн-примеры.
Код примеров доступен в репозитории.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.