Presidio на практике: русский язык, свои правила и LiteLLM
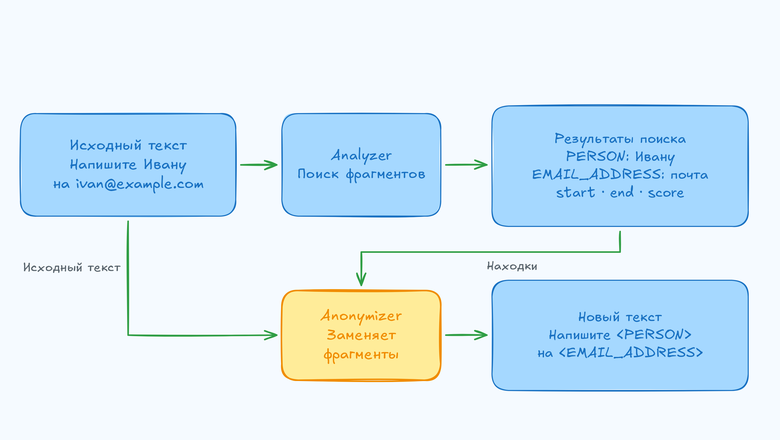
Перед отправкой текста во внешнюю LLM можно заменить имена и контакты метками, а после ответа вернуть значения. Для этого я проверил Presidio: настроил русский язык, подключил две NER-модели и LiteLLM Proxy.
Ниже - устройство конвейера и результаты на 20 вымышленных текстах. Полные запуски есть в видео, код и зависимости - в репозитории.
Поиск и замена - два отдельных шага
AnalyzerEngine находит чувствительные фрагменты и возвращает их тип, границы start/end и оценку score. AnonymizerEngine получает эти находки вместе с исходным текстом и применяет замену, маскирование или удаление.
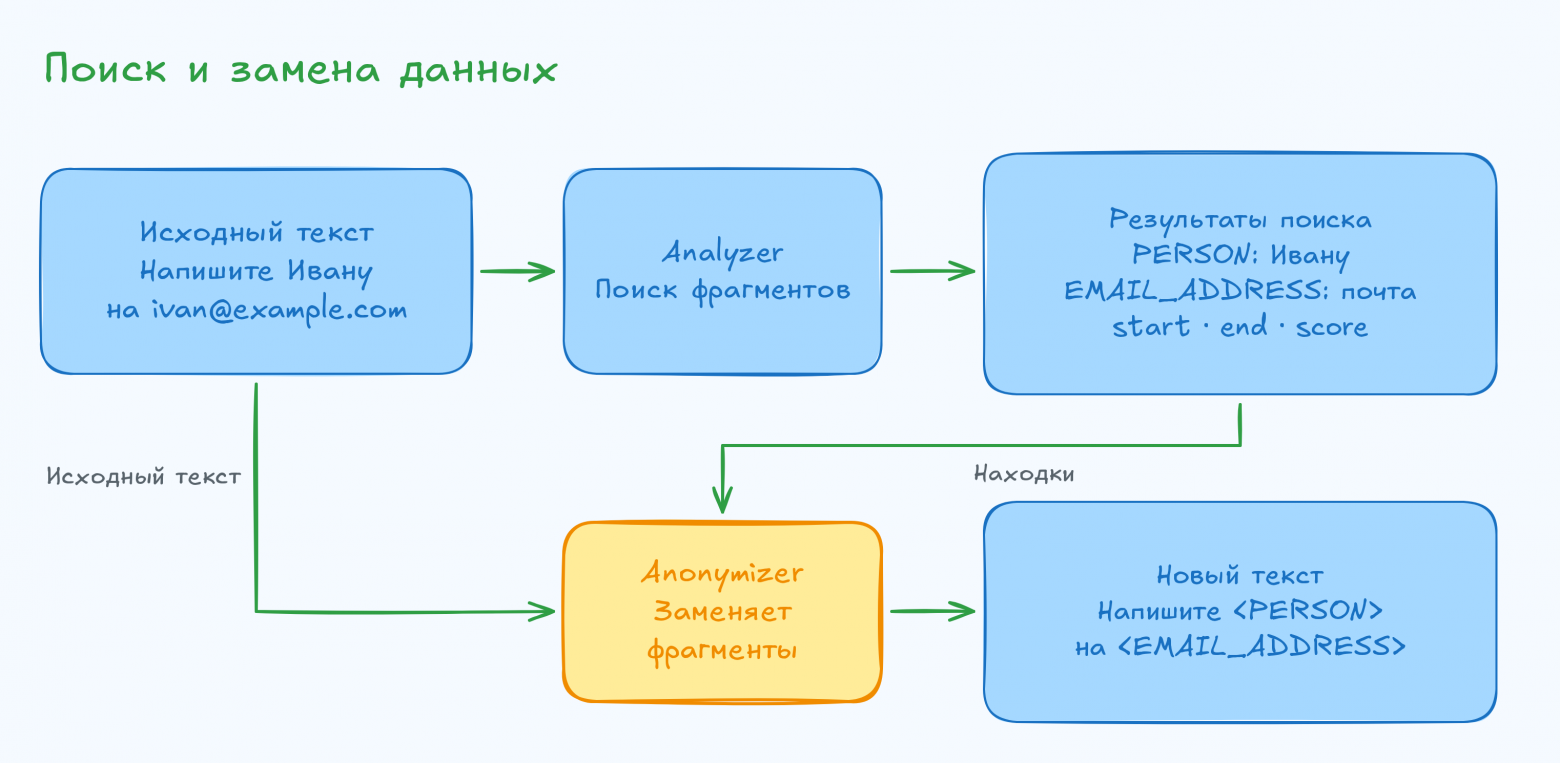
Anonymizer меняет найденные интервалы. Если Analyzer пропустил часть адреса, она останется в тексте.
Такое разделение позволяет менять распознаватели и способ замены независимо друг от друга. score при этом служит оценкой распознавателя, а не гарантией правильности находки.
Что настроить для русского языка
В Analyzer есть реестр распознавателей и NLP-движок для языкового разбора. Распознаватели используют регулярные выражения, проверки формата или NER - модель поиска именованных сущностей. NLP-движок подготавливает токены, начальные формы слов и сущности.
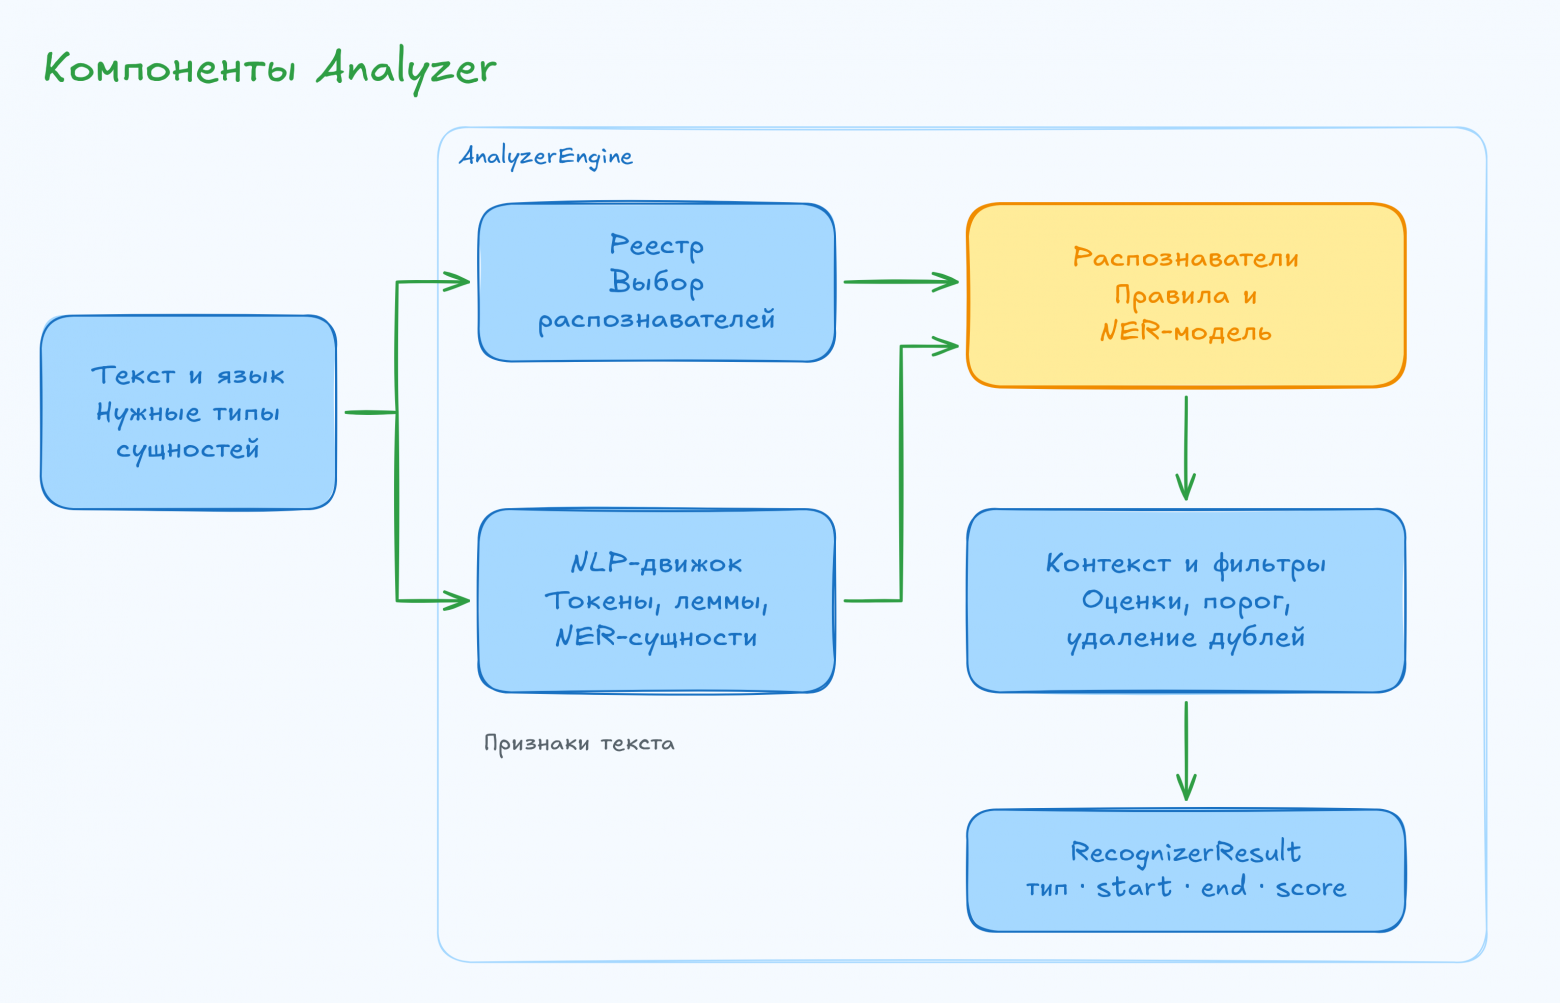
Реестр выбирает распознаватели для языка и типов сущностей. После поиска применяются контекстная обработка и фильтры.
Одного language="ru" недостаточно: русский язык нужно согласовать с NLP-моделью и распознавателями. В примерах использовались Presidio 2.2.366, spaCy 3.8.18 и ru_core_news_lg 3.8.0.
В коде ниже make_analyzer("baseline") - функция из репозитория, которая собирает русскую конфигурацию со штатными правилами и spaCy:
from support.detection import make_analyzer
from presidio_anonymizer import AnonymizerEngine

analyzer = make_analyzer("baseline")
text = "Иван Петров подготовит отчет. Его почта: ivan.petrov@example.com."
found = analyzer.analyze(
    text=text, language="ru", entities=["PERSON", "EMAIL_ADDRESS"]
)
result = AnonymizerEngine().anonymize(text=text, analyzer_results=found)
print(result.text)
Результат:
<PERSON> подготовит отчет. Его почта: <EMAIL_ADDRESS>.
entities ограничивает типы, которые ищем в этом вызове. Границы находок относятся к исходной строке: text[start:end] возвращает найденный фрагмент, правая граница не включается.
Добавляем собственное правило
Для номера клиента CUST-4821 достаточно регулярного выражения. Зарегистрируем новый тип и добавим его в список поиска:
from presidio_analyzer import Pattern, PatternRecognizer

analyzer.registry.add_recognizer(PatternRecognizer(
    supported_entity="CUSTOMER_ID",
    supported_language="ru",
    patterns=[Pattern("Номер клиента", r"\bCUST-[0-9]{4}\b", 0.95)],
))
customer_text = text + " Номер клиента: CUST-4821."
found = analyzer.analyze(
    text=customer_text, language="ru",
    entities=["PERSON", "EMAIL_ADDRESS", "CUSTOMER_ID"],
)
print(AnonymizerEngine().anonymize(customer_text, found).text)
До правила номер оставался открытым. После замены:
<PERSON> подготовит отчет. Его почта: <EMAIL_ADDRESS>. Номер клиента: <CUSTOMER_ID>.
Оценка 0.95 здесь задана нами, а не измерена на выборке. Способ обработки выбирается отдельно: replace подставляет метку, mask скрывает символы, redact удаляет фрагмент.
Меняем модель и сравниваем результат
Я подключил Fastino GLiNER2.5 Multi и Metrika RU PII через собственный LocalRecognizer. Адаптер вызывает модель, переводит ее метки в типы Presidio и возвращает координаты с оценками.
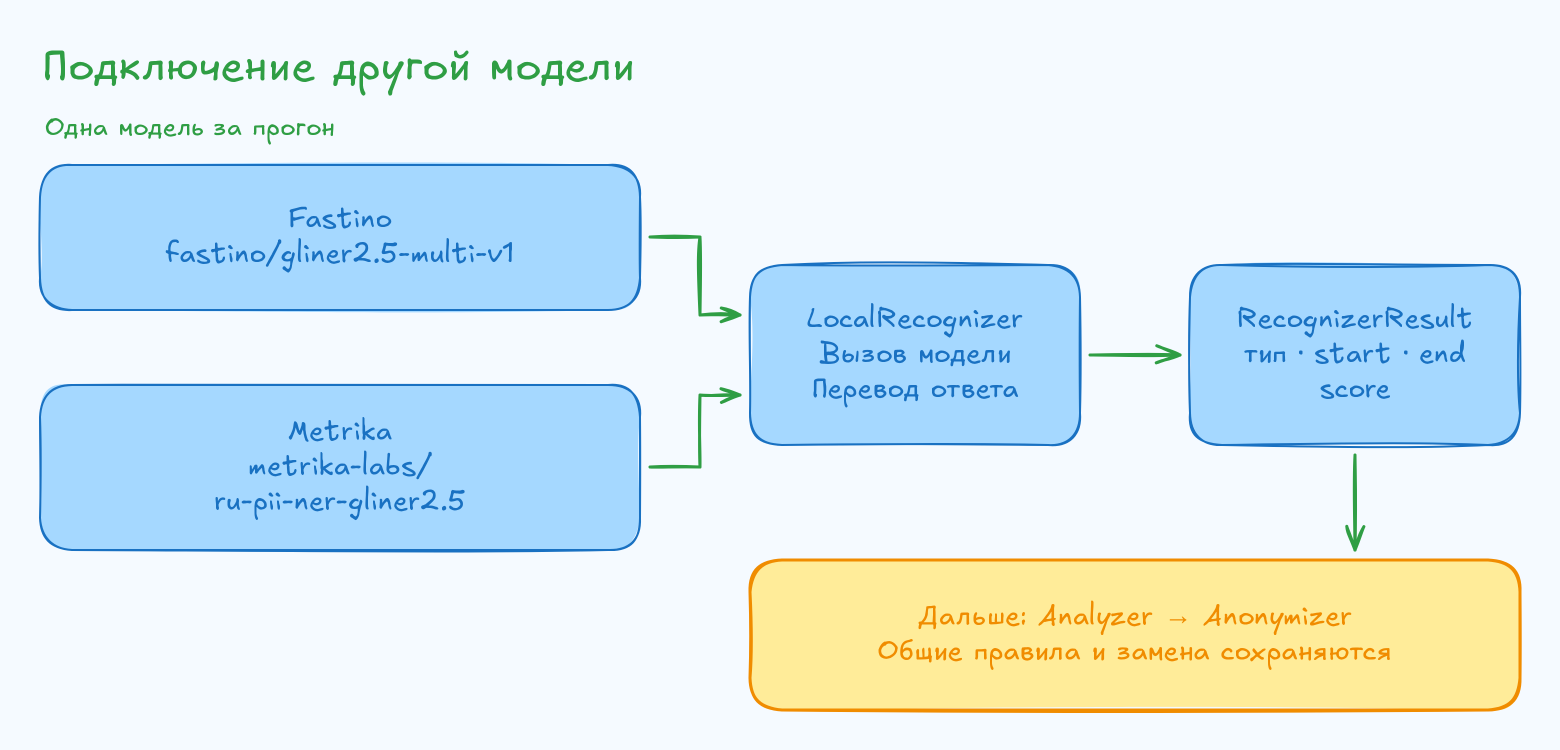
В каждом прогоне работает одна модель. Общие правила и последующая замена сохраняются.
На одних и тех же 20 текстах сравнил три конфигурации: общие правила со spaCy, с Fastino и с Metrika. В двух последних SpacyRecognizer заменен новым распознавателем; русский NLP-движок остается. Общими были правила почты, телефона, IP и даты.
В наборе 25 размеченных упоминаний и четыре отрицательных текста. Полное скрытие означает, что закрыты все непробельные символы упоминания независимо от предсказанного типа. Лишние скрытые символы считаются отдельно.
Модели работали на CPU, по одному тексту, с четырьмя потоками и в FP32 - 32-битной точности. Порог 0,5 закреплен до запуска; одинаковое число не означает одинаковую калибровку моделей. Пересекающиеся интервалы объединялись по одной политике. Полные условия и ревизии весов.
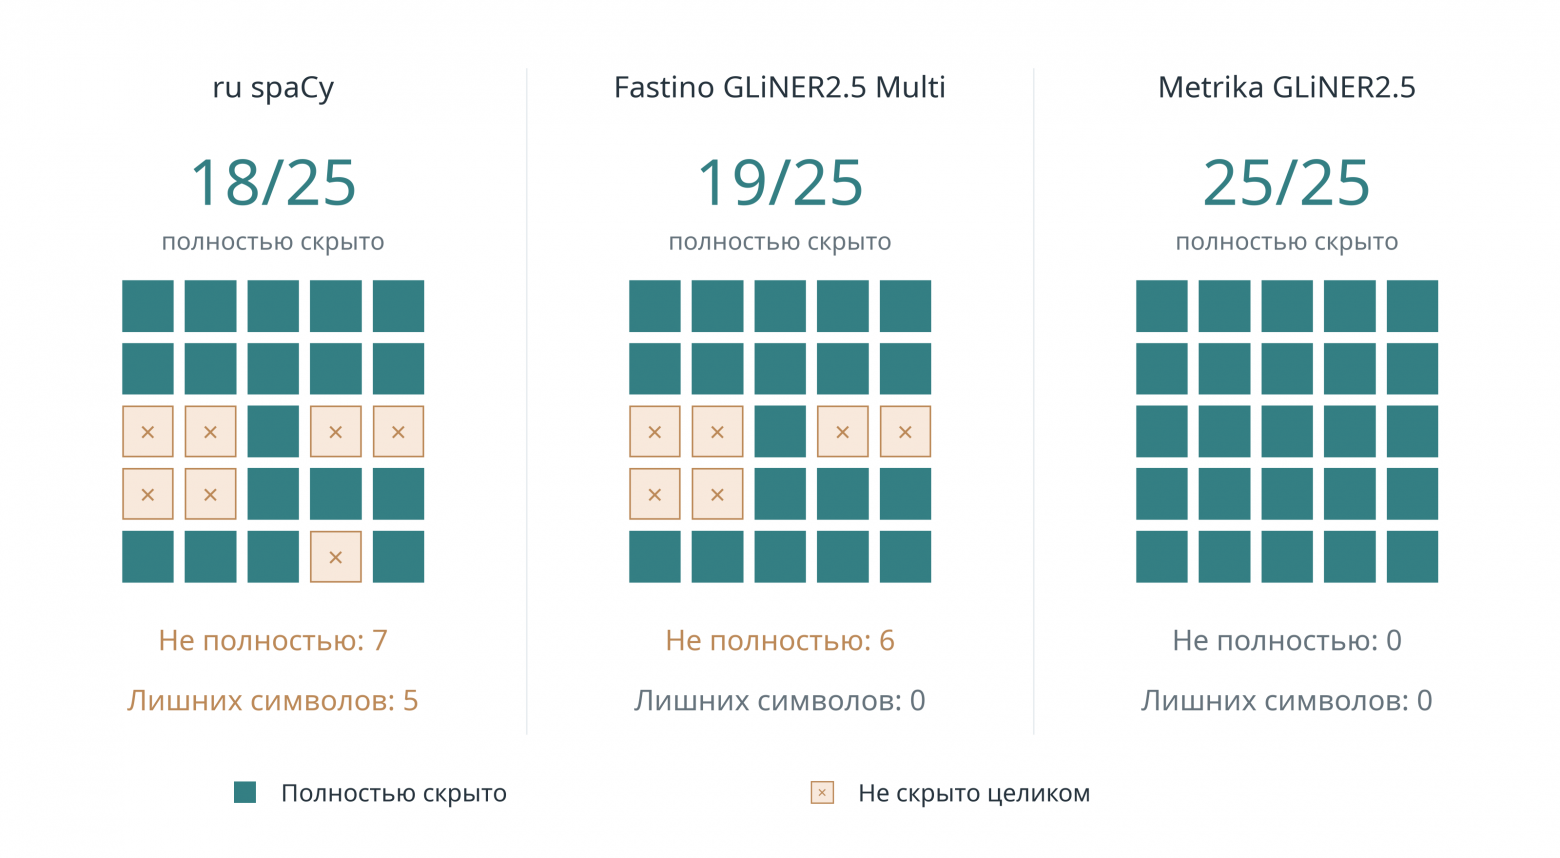
Квадрат - одно упоминание; позиции совпадают у всех конфигураций. Бирюзовое скрыто полностью, светлое с крестом - не целиком. На четырех отрицательных текстах у всех было 0 срабатываний.
На этом небольшом наборе Metrika закрыла все упоминания. Это не оценка качества на любых документах. Пять лишних символов у spaCy - слово “Логин”, ошибочно принятое за имя.
Разницу показывает адрес:
Исходный текст:
Адрес доставки: г. Тверь, ул. Лесная, д. 14, кв. 23.

Общие правила + ru spaCy:
Адрес доставки: г. <LOCATION>, ул. <LOCATION>, д. 14, кв. 23.

Общие правила + Fastino:
Адрес доставки: <LOCATION>, ул. Лесная, д. 14, кв. 23.

Общие правила + Metrika:
Адрес доставки: <LOCATION>.
В первых двух вариантах есть <LOCATION>, но часть адреса осталась открытой. Поэтому наличие находки и полное скрытие - разные результаты.
Возвращаем значения после ответа
Одинаковая метка <PERSON> для всех имен теряет различие между людьми. В демонстрации использован локальный словарь: пара “тип + точное значение” получает свою метку, повторы - ту же самую.
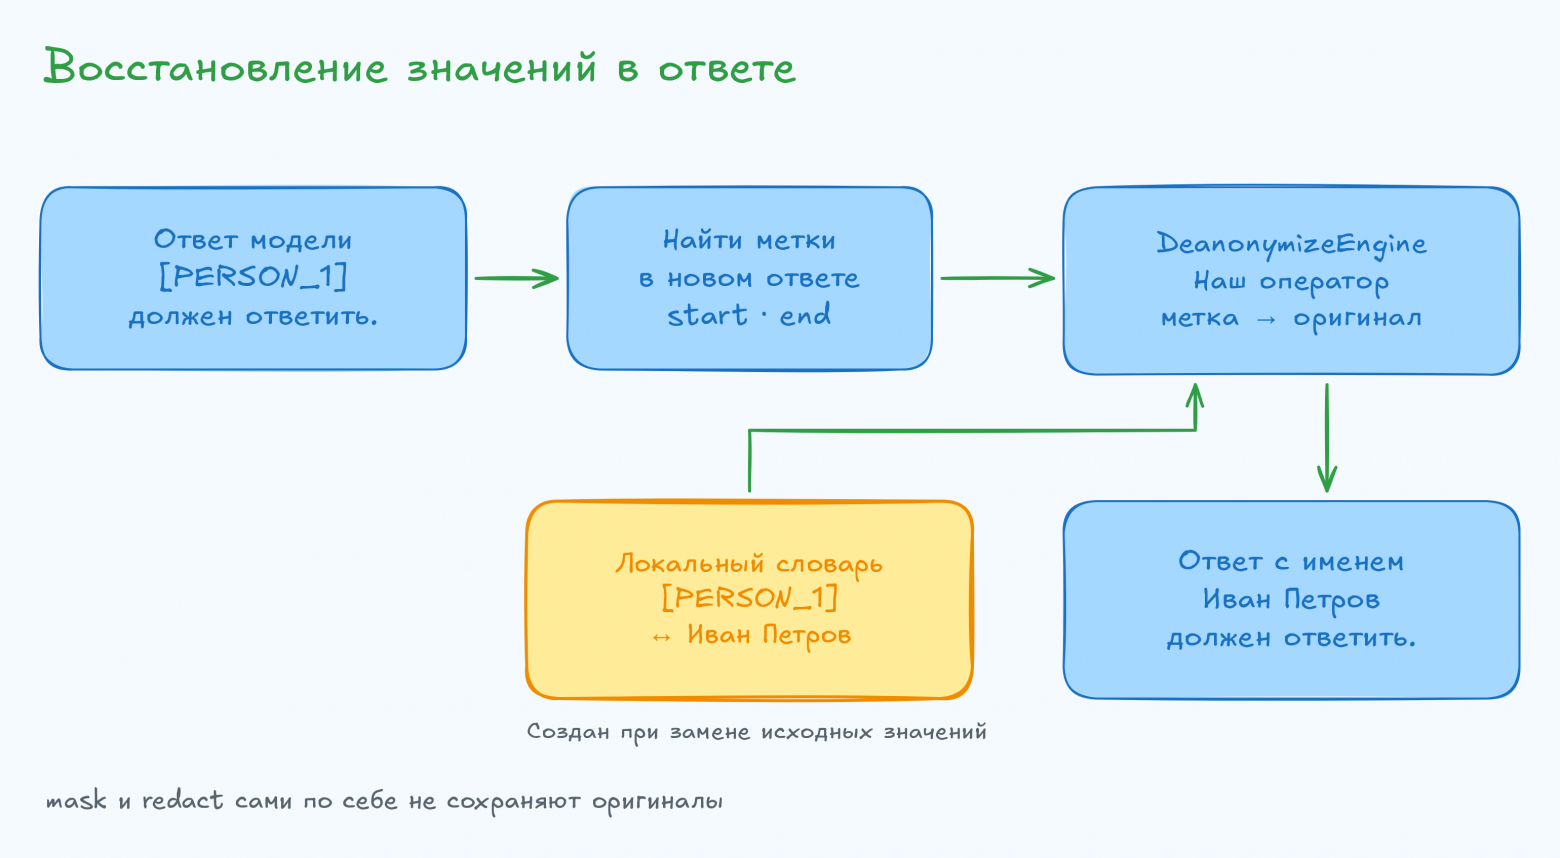
Учебный пример: словарь создается при замене, а позиции меток заново определяются в ответе модели. Формат метки сокращен.
Собственный оператор AnonymizerEngine выдает метки. После ответа приложение находит их новые координаты и передает в DeanonymizeEngine с оператором восстановления. Возвращаются только известные метки разрешенных типов. Обычные mask и redact оригиналы для этого не сохраняют.
Словарь в памяти процесса выбран для демонстрации. Для продакшена нужно защищенное хранение с разграничением доступа, изоляцией сессий, шифрованием и сроком удаления. Также нужно определить работу при перезапуске и нескольких экземплярах сервиса. Разные написания имени, например “Иван” и “Ивану”, такой словарь автоматически не связывает.
Подключаем LiteLLM
Обработку запросов разных клиентов можно вынести в прокси. В примере LiteLLM 1.108.1 вызывает локальные /analyze и /anonymize, за которыми работают движки Presidio, затем отправляет запрос в DeepSeek.
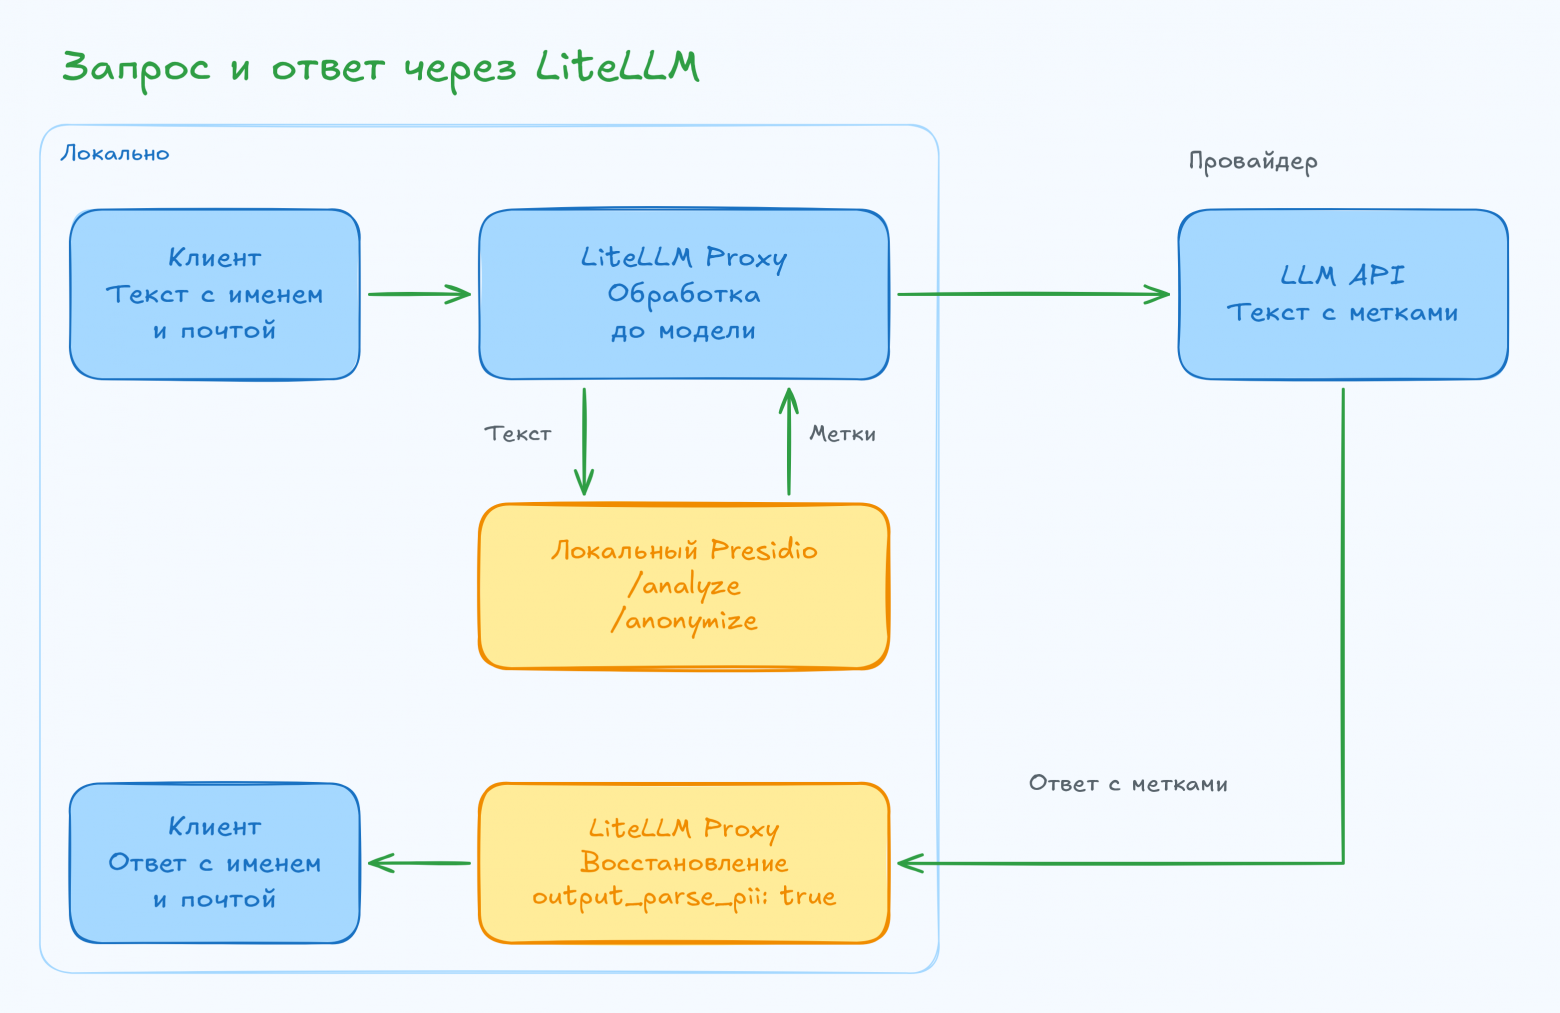
До модели LiteLLM вызывает Presidio, после ответа восстанавливает значения. Это механизм интеграции LiteLLM, отдельный от собственного оператора выше.
Часть конфигурации:
guardrails:
  - guardrail_name: presidio-restore
    litellm_params:
      guardrail: presidio
      mode: pre_call
      default_on: false
      presidio_language: ru
      presidio_filter_scope: input
      output_parse_pii: true
      pii_entities_config:
        PERSON: MASK
        EMAIL_ADDRESS: MASK
      presidio_score_thresholds:
        ALL: 0.5
Обработчик включается явно. В теле запроса POST /v1/chat/completions к прокси нужно указать его имя:
text = (
    "Клиент Марина Соколова, почта marina.sokolova@example.com. "
    "Подготовьте одну короткую фразу: кому нужно ответить. "
    "Сохраните полученные метки буквально."
)
payload = {
    "model": "demo-deepseek",
    "messages": [{"role": "user", "content": text}],
    "guardrails": ["presidio-restore"],
}
В сохраненном запросе вместо имени и почты провайдер получил <PERSON_1> и <EMAIL_ADDRESS_2>. Он ответил:
Ответить нужно клиенту <PERSON_1> на почту <EMAIL_ADDRESS_2>.
Клиент после восстановления получил:
Ответить нужно клиенту Марина Соколова на почту marina.sokolova@example.com.
Форма имени сохранена как в ответе. output_parse_pii возвращает известные значения; поиск новых персональных данных в ответе задается отдельно через presidio_filter_scope. В одной из попыток режим both повторно скрыл восстановленные значения, поэтому итоговый пример использует input. Потоковые ответы и произвольные вызовы инструментов здесь не проверялись. Конфигурация и запуск, описание параметров.
Итог
Presidio связывает распознаватели и операции над найденными фрагментами. Свои форматы можно добавить правилами, другие сущности искать моделью, а обработку встроить в прокси. Качество скрытия зависит от того, какие границы нашел распознаватель: это видно даже на одном адресе.
Дообучение под домен, кеширование, хранение соответствий и влияние маскирования на качество агента хочу разобрать отдельно - для каждой темы нужен свой опыт.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.