Как я пишу почти автономного агента для разработки своих пет-проектов
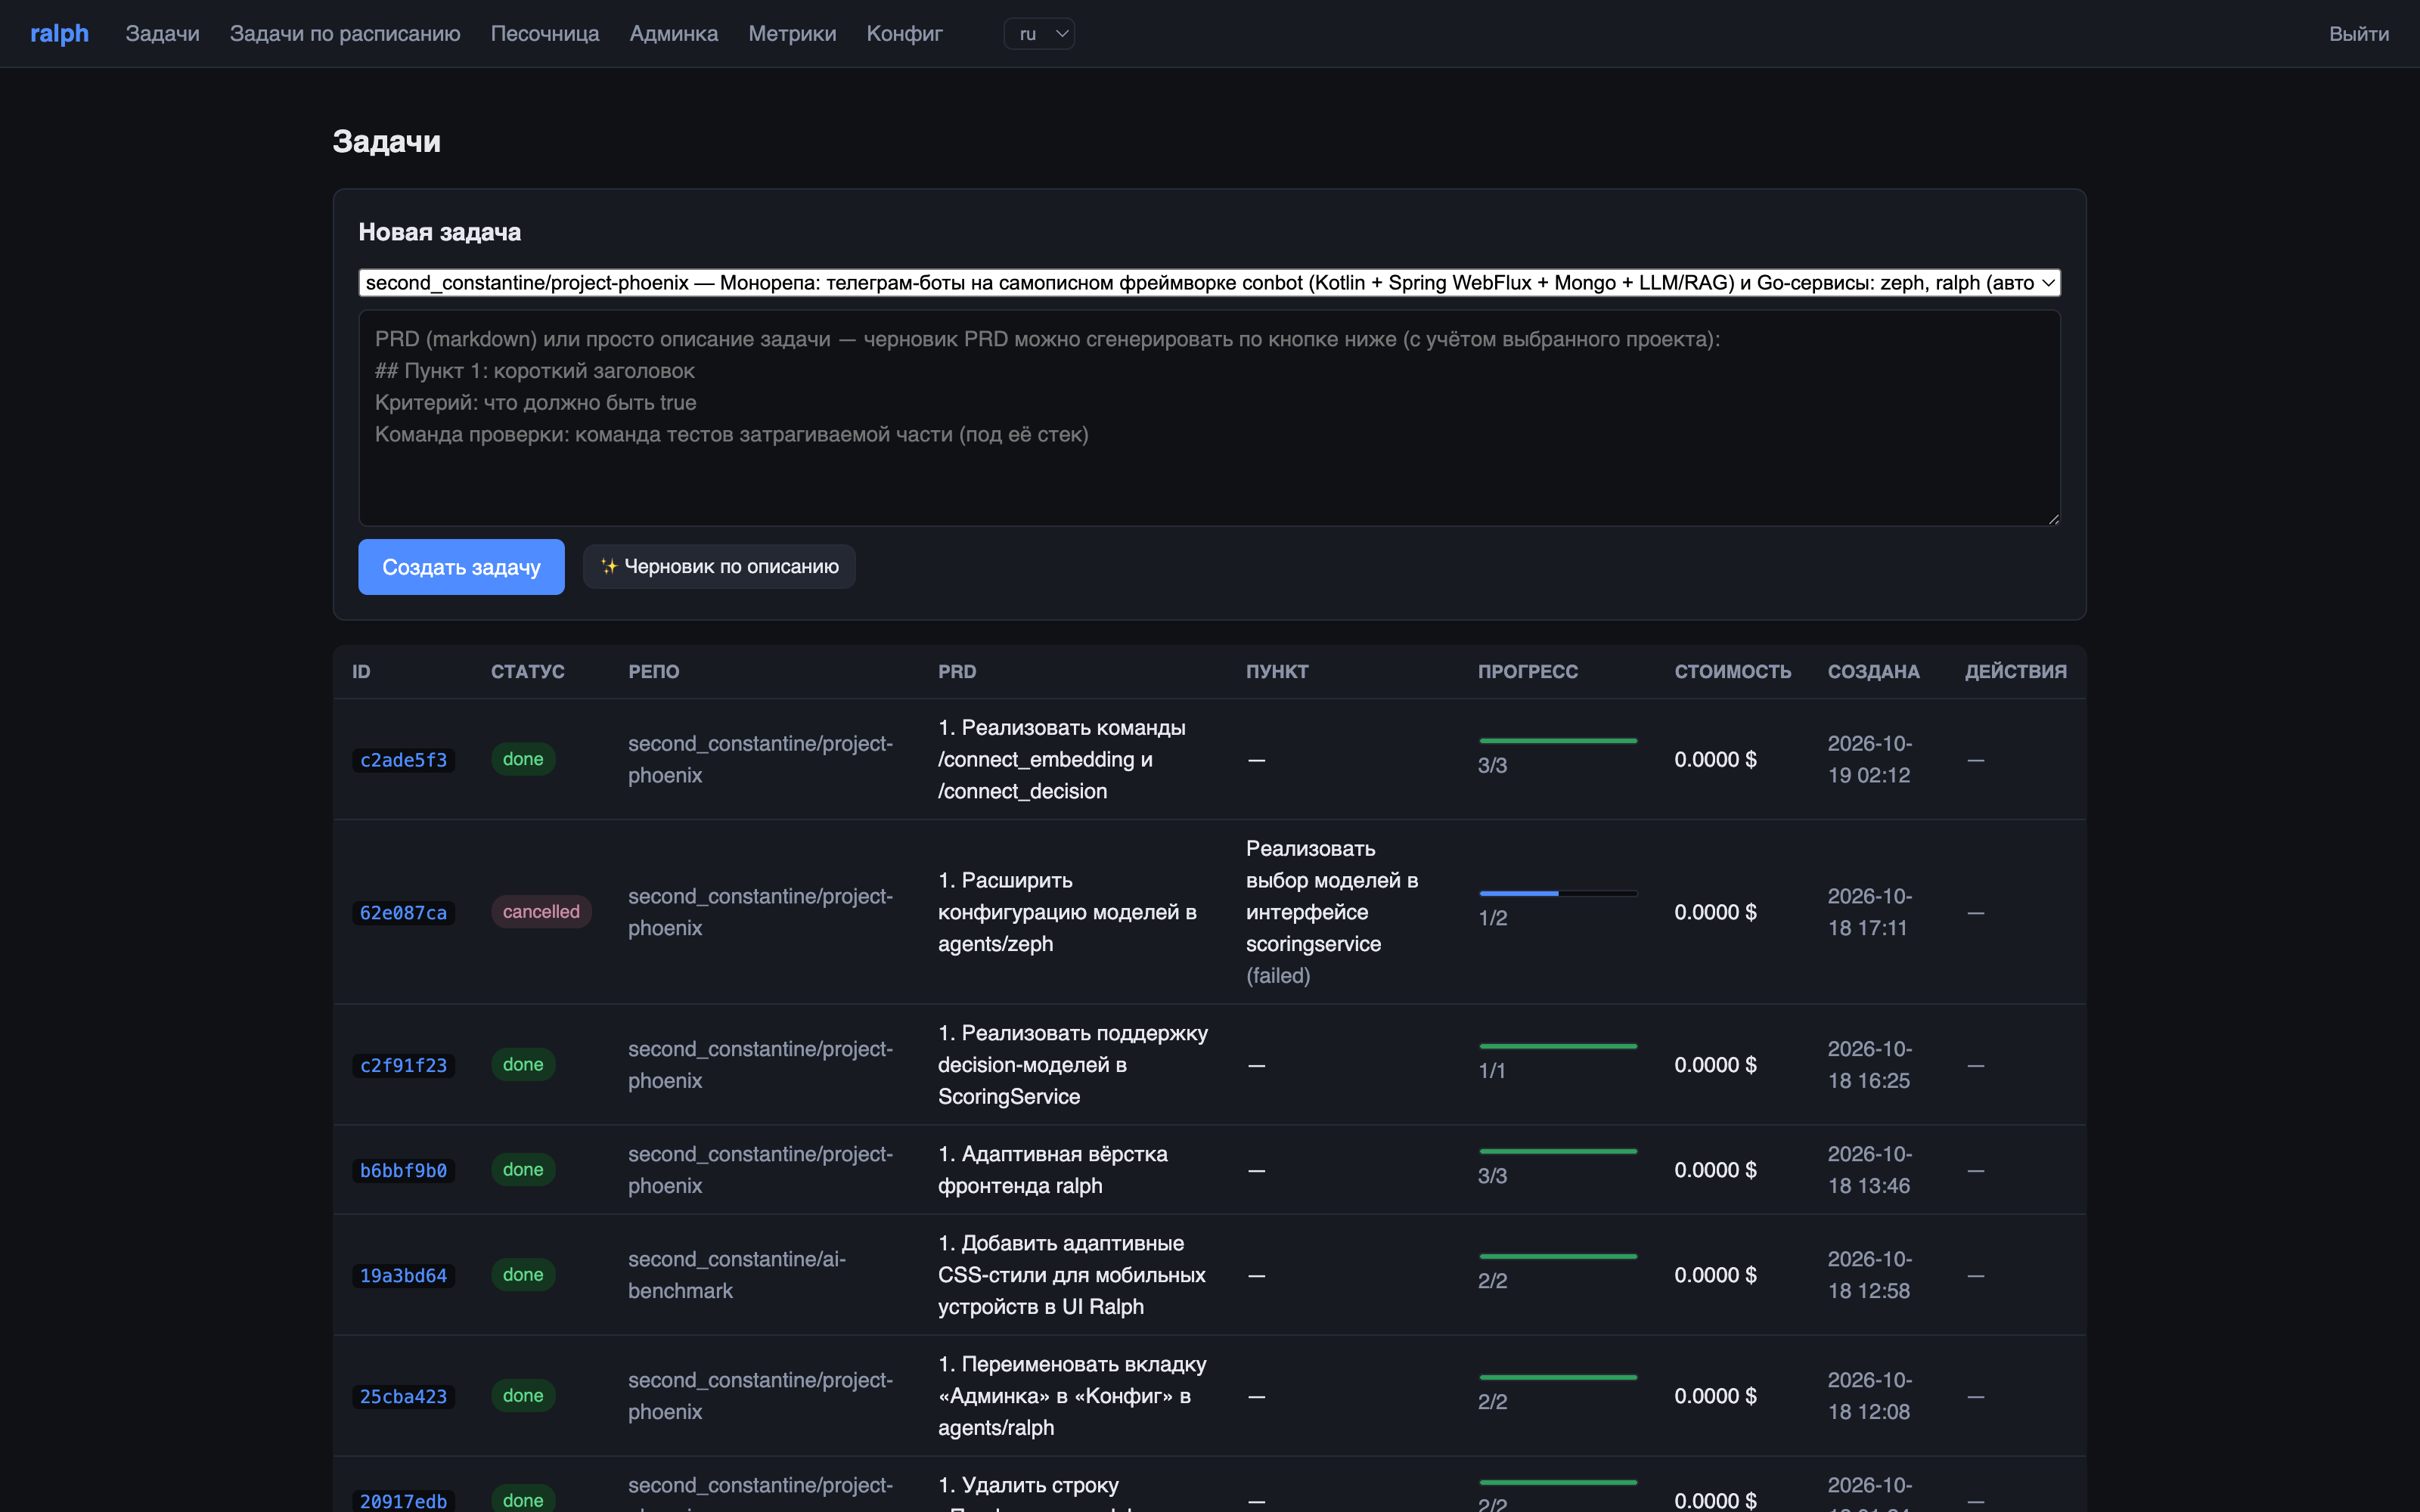
Агенты уже везде. Они пишут код в IDE, в терминале, в облаках — и с каждым месяцем их больше. Можно закрывать глаза и ждать, пока «хайп спадёт», но лично я решил разобраться изнутри: собрать своего агента и посмотреть, где это ломается. Статей «как написатьсвоего агента» на Хабре хватает, поэтому тут про другое — заметки изнутри: что понял по пути, что сработало, а что нет. Претензии на методологию или «правильный путь» не заявляю.
Да, я использовал «генератор текста» для написания этой статьи — но я не Лев Толстой, а главное не то, как написан текст, а какую он несёт информацию. Увы, нейрослопить LLM пока может только текст, а идею должен закладывать пока ещё человек.
Мечта о локальном
Первой мыслью было ограничиться локальным инференсом: свои модели, свои данные, вечерами бесплатно и без API-ключей. Из железа — RTX 3090 на 24 ГБ и RTX 2080 Ti на 11 ГБ. Дальше — как мечта столкнулась с реальностью:
Почему локальный инференс для агента — это боль
Итерация агента — это десятки вызовов LLM с контекстом: куски кода, дифы, вывод команд. На этом локальные модели подводят по трём осям:
Качество. В 24 ГБ живут ~30B-модели в кванте; из них кодить когерентно длинные сессии и аккуратно пользоваться инструментами умеют единицы, и проверять надо полным циклом агента, а не HumanEval.
Скорость. Сотни вызовов × локальный tok/s = «наблюдение за циклом агента». Мой единственный дефицитный ресурс — вечер.
Память. Вторая карта под мелкий слот — приятный бонус, но качество важнее.
Итог — гибрид: мелкое по силам локальным, тяжёлая работа — облаку. Приятная деталь: слот в моём агенте не привязан к модели — в него втыкается любая, облачная или локальная, и меняется на горячую. Так что мечта «всё локально» не похоронена, она ждёт сильные локальные модели.
LLM не думает за вас
Главная мысль, которая закрепилась за эти недели: LLM — прокачанный генератор текстов и в т.ч. кода. Думать за вас она не будет — она хорошо продолжает начатое. Постановка задачи, критерий «готово», границы дозволенного — это приносить должен человек. Если этого не сделал ты — она продолжит и без тебя, и результат получится в лучшем случае «в среднем по интернету».
Со временем сформулировал для себя это как сдвиг уровня: раньше я писал код, теперь — систему, которая пишет код: правила, критерии, проверки. Можно назвать это «метапрограммированием» — когда агент сам проверяет своё исполнение.
Про язык, кстати, забавная деталь: все инструкции агенту у меня на русском — и ничего. LLM не отличают языки вообще: они оперируют токенами и векторами, а не «переводят текст на английский, чтобы понять, чего хочет пользователь» — такого механизма в них просто нет. Поэтому язык инструкции — всего лишь способ задать направление действий модели: важно, какая мысль в ней закодирована, а не на каком она языке. Почему так и что из этого следует на практике — тема отдельной статьи, тут не растекаюсь.
Обезьяна с гранатой
Про вайбкодинг у Вастрика давным-давно был отличный разбор, повторять не буду. У меня к явлению сейчас сложная любовь: не всё так плохо — инструменты реально ускоряют прототипы, и я их тоже использую. Но вайбкодер без технических и доменных знаний — это обезьяна с гранатой: граната обязательно взорвётся, вопрос только когда и в чьих руках. Код будет написан, будет «работать» — до первого ревью, до первого отказа, до первого прод-инцидента.
Исследования это подтверждают на цифрах:
DomCoder (arXiv): на доменном коде (веб на Go, геймдев на C++) ChatGPT просел в CodeBLEU на ~51%; главные ошибки — перепутанные или забытые вызовы API библиотек. Доменные знания надо подавать в контекст — из весов модели их не достать.
METR (RCT, 2025): опытные разработчики на своих репо с AI-инструментами делали задачи на 19% медленнее, а сами были уверены, что на 20% быстрее — и до, и после. (К февралю 2026-го METR пересмотрел дизайн эксперимента: новые данные уже намекают на ускорение, но методику они сами объявили ненадёжной из-за селекционных эффектов. Мораль симметрична: верить ощущениям нельзя ни в минус, ни в плюс.)
GitClear (211 млн строк, 2020–2024): рефакторинг упал с ~25% (2021-й) до <10% (2024-й), и в 2024-м copy/paste впервые обогнал «перемещённый» код — клонировать стали чаще, чем переиспользовать.
Мне повезло: пет-проекты мои, я сам себе доменный эксперт. Поэтому рецепт у меня простой: не запрещать агенту ошибаться — он всё равно будет, — а встроить в конструкцию проверяемость. Каждая инструкция Ralph несёт критерий готовности и команду проверки. Не «сделай красиво», а «таблица сортируется, тест зелёный, вот команда».
Как это выглядит у меня
Ralph — это Go-оркестратор вокруг харнеса pi: процесс pi на итерацию, RPC поверх JSONL. Модели — обычные, ничего особенного не придумывал: вся инженерия — в цикле вокруг них.
Задача выглядит как PRD: пункты, под каждым — критерий готовности и «команда проверки». Цикл всегда один: маленький диспетчер классифицирует шаг → субагент подходящей величины правит файлы → команда проверки прогоняется по-настоящему. Все пункты зелёные → MR (пул-реквест). Merge жму я.
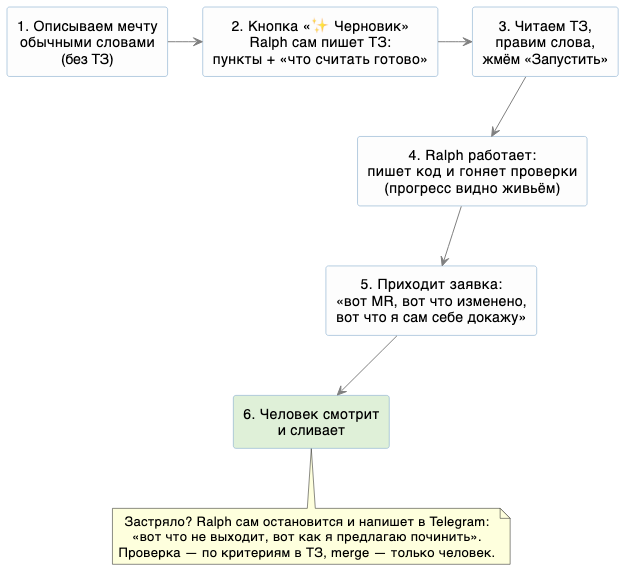
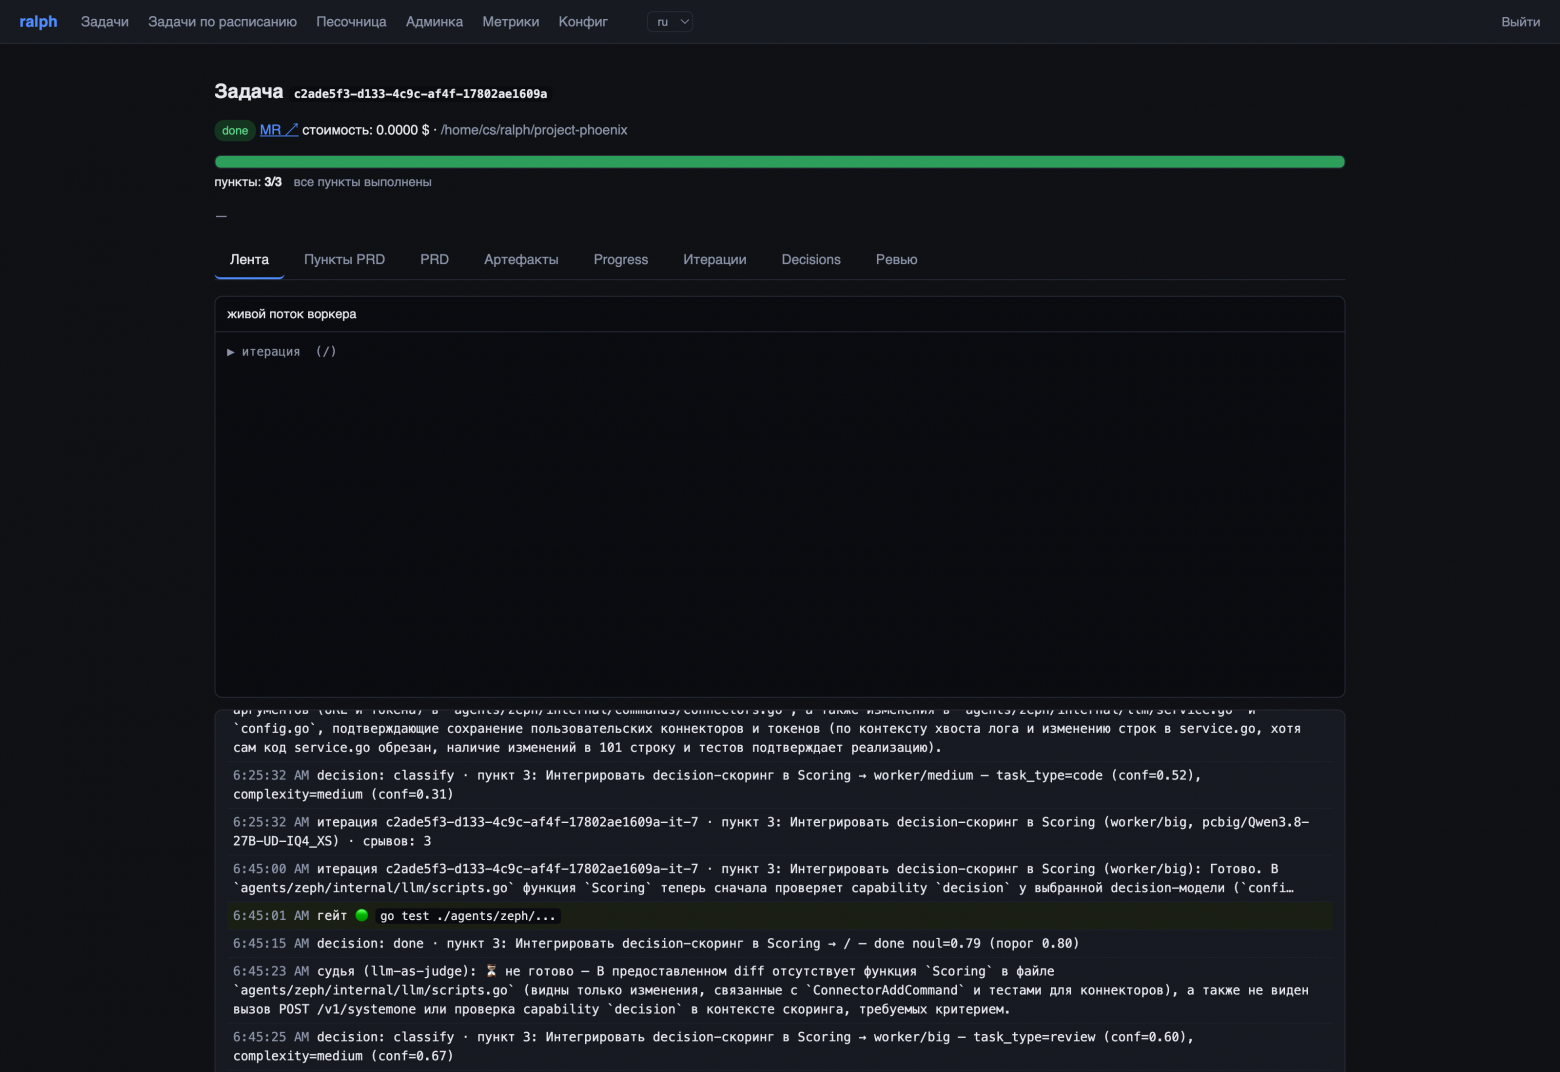
Что внутри цикла (кратко, для интересующихся)
Каждая проверка — это шрам, собранный на живом опыте:
Гейт — команда из PRD. Не решается моделью: пока тест красный, пункт не закрыт.
Done-чек — decision-модель голосует готовностью по свежему прогрессу, diff-стату ветки и хвосту вывода гейта; порог 0.8. На пустом диффе она выдала 0.16, на реальной работе — 0.69. Сигнал, не монетка.
Судья — decision-модель не «видит» иконки и картинки по тексту диффа и занижает готовность вечно; после трёх срывов подключается генеративная модель — её «готово» перевешивает.
Супервайзер — после двух провальных итераций подряд большая модель отвечает «что не так / как чинить»; стоп = пауза и сообщение в Telegram.
Финальное ревью — перед push весь дифф против всех критериев (+ мусор, секреты); блокеры → авто-итерации «исправь только замечания».
Модели — сменный экипаж по ролям (любая модель в любой слот, в т.ч. локальная — тогда бесплатно; смена на горячую): диспетчер почти бесплатен и гоняется десятки раз в день, тяжёлая модель — только там, где без неё никак, при серии срывов эскалация сразу на неё.
Самое познавательное — не гладкие случаи, а поломки:
Дезертирство. Агент поправил файлы в соседнем репозитории. Теперь его инструменты видят только свой клон и
/tmp, остальное блокируется.Вечный ревизор. Старый
goна хосте ронял тесты не по вине агента — цикл честно прожёг несколько итераций в пустые ревизии. Отсюда супервайзер: пауза, «что не так / как чинить».Не тот фреймворк. Черновик PRD прицепил Gradle-команду к задаче в Go-модуле монорепы. Теперь перед генерацией снимается контекст проекта — стек, модули, команды под затрагиваемый стек.
Съеденное
_. Telegram в legacy-маркдауне превратил ссылку на MR в 404. Лечение — HTML parse mode и честное экранирование.
Общий вывод из поломок: ошибки агента дёшевы, если их замечает конвейер. Поэтому проверок много — и там, где может командовать сама реальность (тест), они не модельные.
Агент пишет сам себя
С середины октября часть коммитов подписана Ralph <ralph@…>: агент дорабатывает сам себя и всё это проходит через его собственный цикл PRD → воркер → гейт → ревью → MR.
Что по цифрам?
Любимый коммит — правка по ревью (попытка 1): финальное ревью нашло блокер, воркер исправил, чек зазеленел. Механизм самопроверки починил собственный код. Забавно жить в такой петле.
Итого за десять дней: ~120 коммитов, v0.1.0 → v0.11.0, ~33 тысячи строк Go.
$ git log --author=ralph@next-way.by --format="%h %ad %s" --date=format:"%e %b, %H:%M"
211278f6 19 Oct, 06:45 ralph: пункт 3, итерация 1 (worker/big)
cd113b12 19 Oct, 06:23 ralph: пункт 2, итерация 3 (worker/medium)
cb15a56a 19 Oct, 05:56 ralph: пункт 2, итерация 1 (worker/medium)
3044c63c 19 Oct, 05:25 ralph: пункт 1, итерация 1 (worker/medium)
0ec279d1 18 Oct, 19:42 ralph: пункт 1, итерация 1 (worker/small)
4b76ed49 18 Oct, 17:13 ralph: пункт 1, итерация 3 (worker/big)
e9021cd0 18 Oct, 15:48 ralph: правка по ревью (попытка 1)
18be87fc 18 Oct, 10:55 chore(ralph): версия v0.11.0 — разделение профилей по моделям
aa5ca645 18 Oct, 04:51 ralph: пункт 2, итерация 1 (worker/medium)
ee3c89b1 18 Oct, 04:33 ralph: пункт 1, итерация 1 (worker/small)
5e1b6ff7 14 Oct, 18:40 ralph: пункт 1, итерация 1 (worker/medium)
b720c459 14 Oct, 14:42 ralph: пункт 3, итерация 1 (worker/medium)
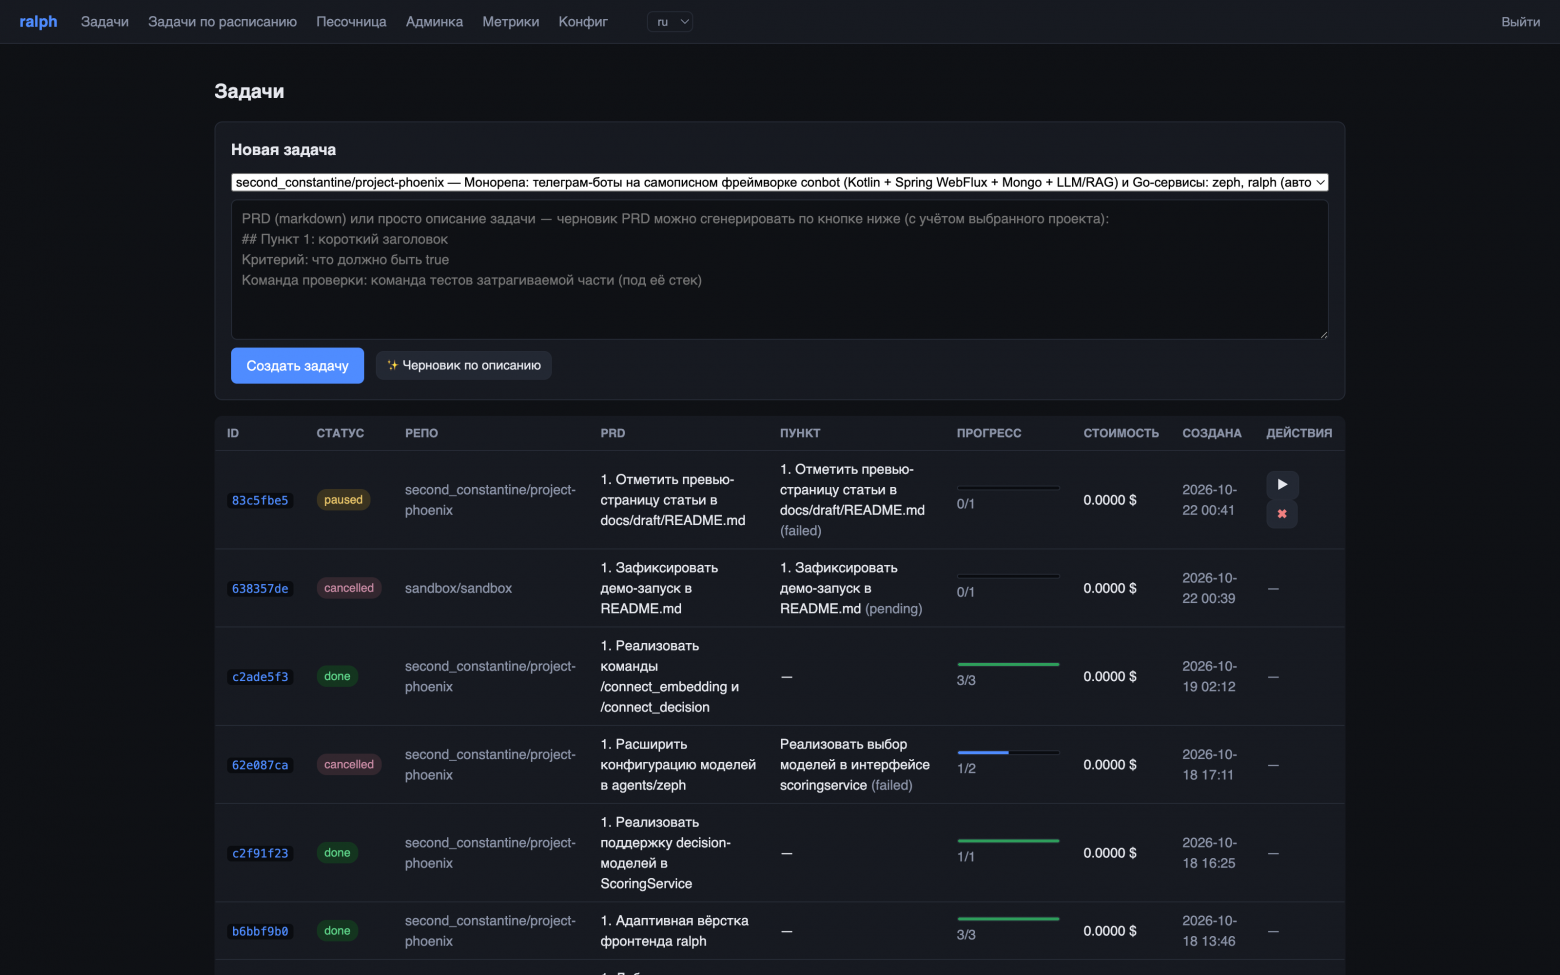
Еще скриншоты
Про деньги
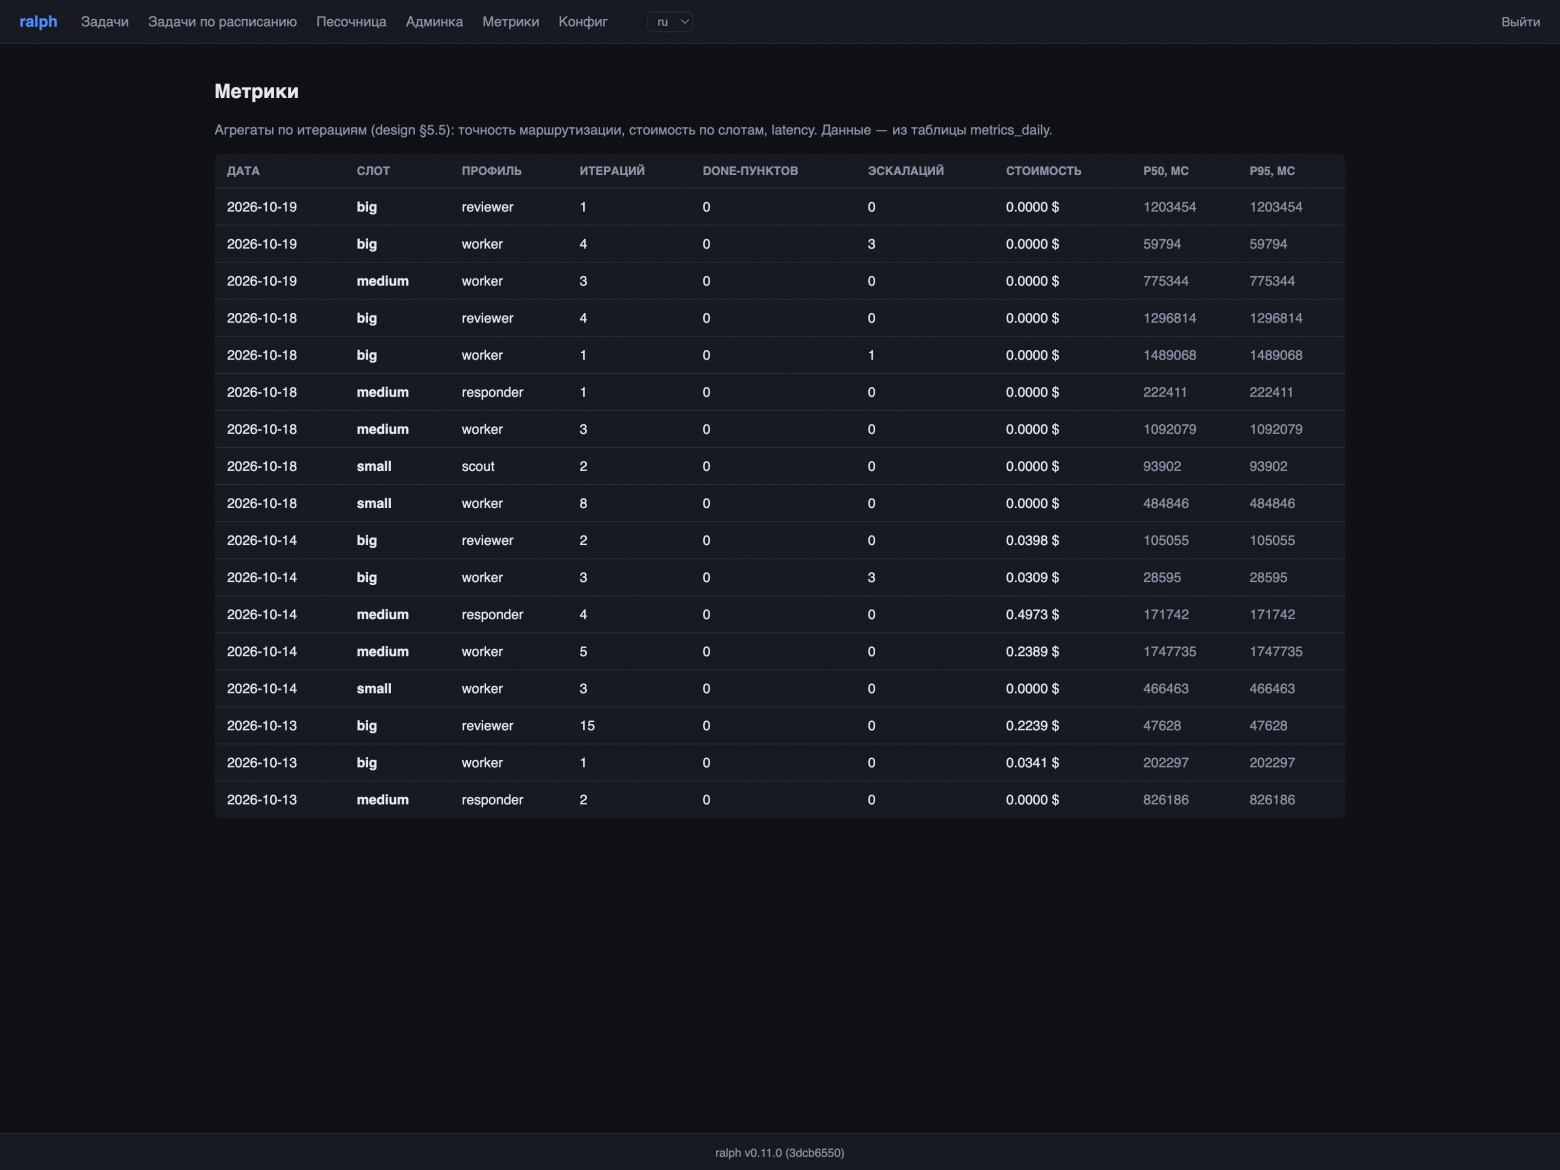
Каждая задача и итерация видна деньгами, не «баллами»: цены облачных моделей — с прайс-таблицы провайдера, локальные — ноль, офф-пик вдвое дешевле — планировщик учитывает окно. Итерация в тестах: 15.8К входных токенов → $0.0024. Пока цена «примерно ноль и где-то там», цикл не настроить — датчик нужен обязательно.
Мир меняется, и что с этим делать
Итог моего эксперимента.
Агенты от нас не уйдут — вопрос не «будет ли», а «как делить работу». Моя ставка совпадает с классикой: код пишут агенты, за человеком остаётся ревью и решения. Это не костыль, а разумное деление: агент доводит работу до состояния «проверяемо».
Вайбкодинг без подводных камней не бывает — обезьяна с гранатой всё-таки обезьяна. Но «не всё так плохо»: если знания домена и проверки встроены в систему, граната превращается в рабочий инструмент.
Главный навык смещается не в «умение писать промпты», а в умение описать, что значит «готово», и научить машину это проверять.
Что у меня не получилось: всё локально (см. выше), чужие репо без контейнерной песочницы (рано), никакой магии — Ralph пишет хуже сильного инженера и выигрывает настойчивостью и проверками.
Ralph съедает мою ненавистную часть работы — доводку. Мне остаётся: критерии, ревью, редкие споры с агентом за архитектуру. Кажется, так и выглядит ближайшее будущее разработки — не «агенты заменят», а «агенты делают, человек проверяет и решает». Как это произойдёт у всех остальных — покажет время; мои идеи, впрочем, уже доживают до MR, а не томятся бесконечно в беклоге.
P.S. Ожидаю прожарку от технарей в комментариях, если таких ещё не успели заменить агенты) но учитывайте, что это мой первый пост, поэтому не судите строго.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.