Googleが新型AIチップ「TPU 8tx」「TPU 8i Max」を発表、AMD製CPUを採用した機密情報保護モデルと処理性能2倍のモデルが登場
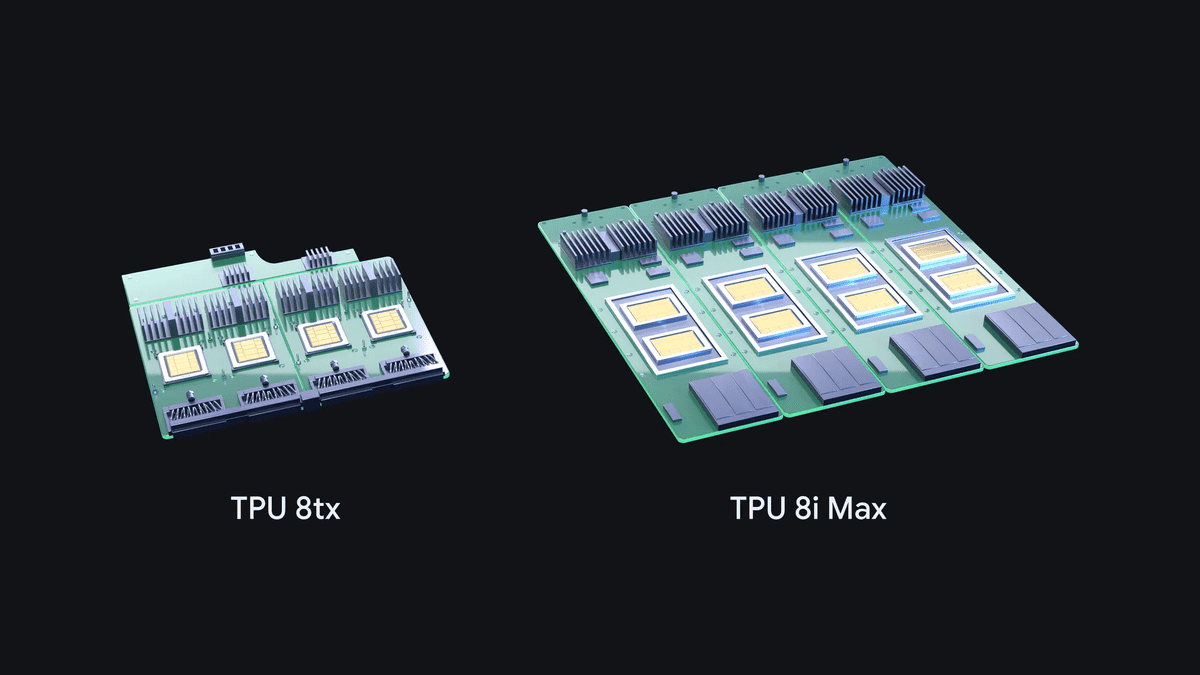
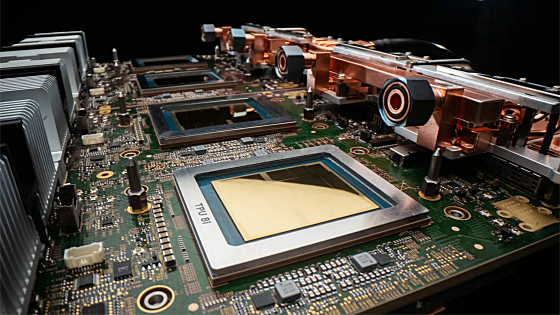
近年はAIが質問に回答するだけでなく、複数の作業を自律的に進める「AIエージェント」の利用が広がっています。AIエージェントには大量の情報を読み込んで長時間処理を続ける能力が求められるほか、企業の機密情報を安全に扱う仕組みも必要です。
GoogleはAIエージェントの普及に伴う新たな需要に対応するため、第8世代TPUに2種類のシステムを追加しました。新たなチップを一から開発する代わりに既存のTPUを基にメモリやネットワーク、セキュリティ機能を組み合わせることで、用途に応じたシステムを短期間で開発できるとのこと。
第8世代TPUのラインナップはこんな感じ。TPU 8t、TPU 8i、TPU 8tx、TPU 8i Maxの4種類が用意されています。
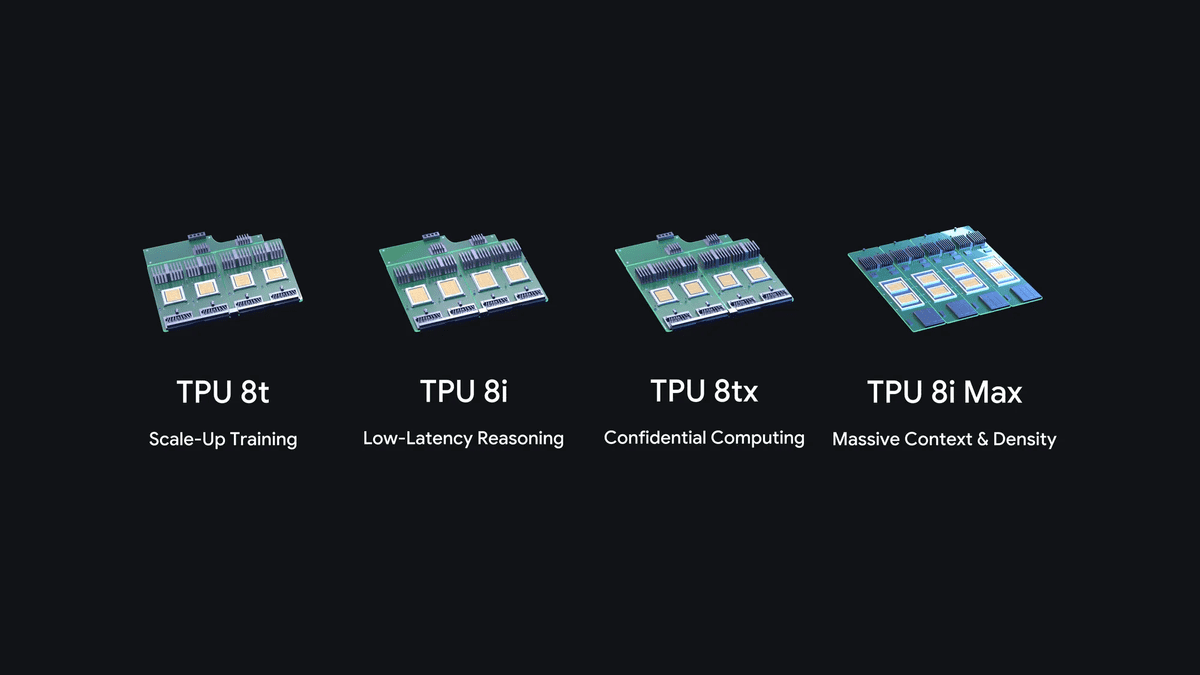
新たに追加されたTPU 8txは、企業や政府機関が機密情報を扱う際の安全性を高めるために設計されたシステムです。一般的にデータは保存時や通信時に暗号化されますが、コンピューターが処理する際にはメモリ上で復号する必要があります。機密情報を扱うAIでは処理中のデータやAIモデル自体を保護することが課題となります。
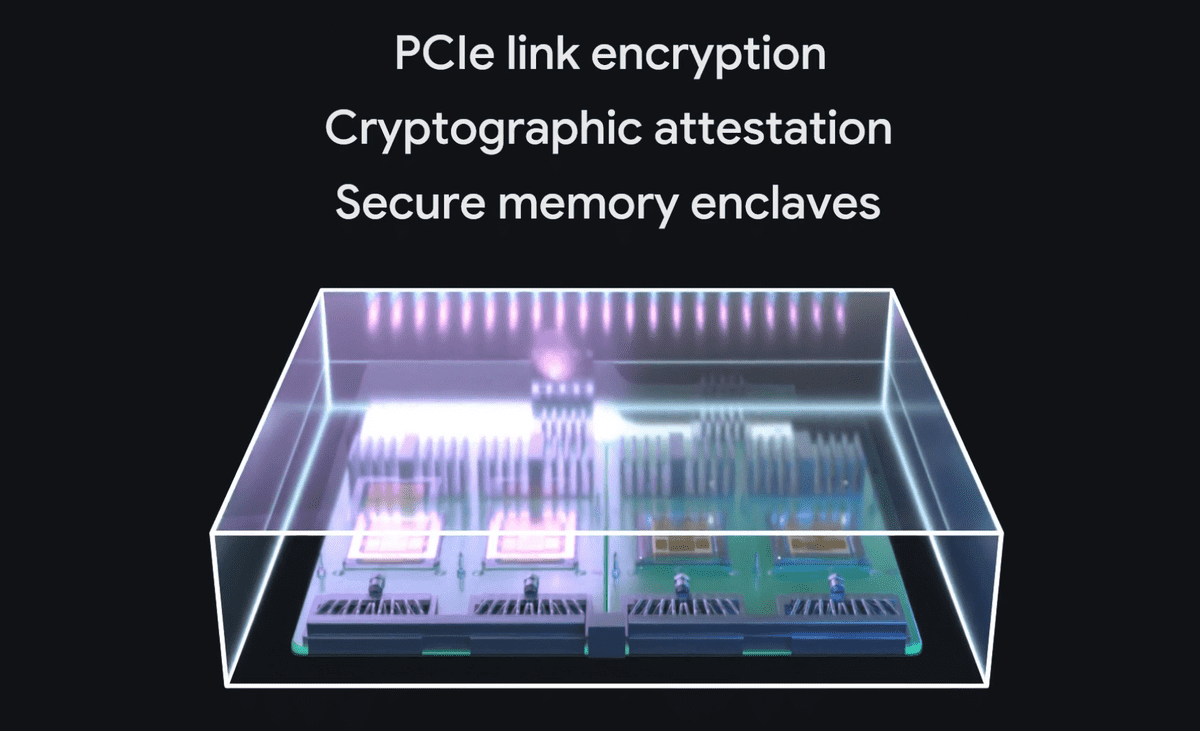
TPU 8txはTPU 8tと同じチップを採用し、ホストCPUとしてAMDの第5世代EPYCプロセッサーを組み合わせています。ハードウェアレベルで機密情報を保護する仕組みを備えており、AIが処理している最中もデータやモデルの重みを保護・分離できるとのこと。また、低遅延ネットワーク技術「Boardfly」を採用することで、TPU 8tと比較して処理の遅延を最大半分に削減しています。性能への影響もほぼないと述べられています。
TPU 8txは小規模な学習処理にも対応しており、企業が保有するデータを使った追加学習や、大規模モデルの能力を小規模モデルに引き継がせる「蒸留」、試行錯誤を通じてAIを改善する「強化学習」などを実行できます。機密データを別のシステムに移動させずにAIモデルの調整と運用を行えるというわけです。
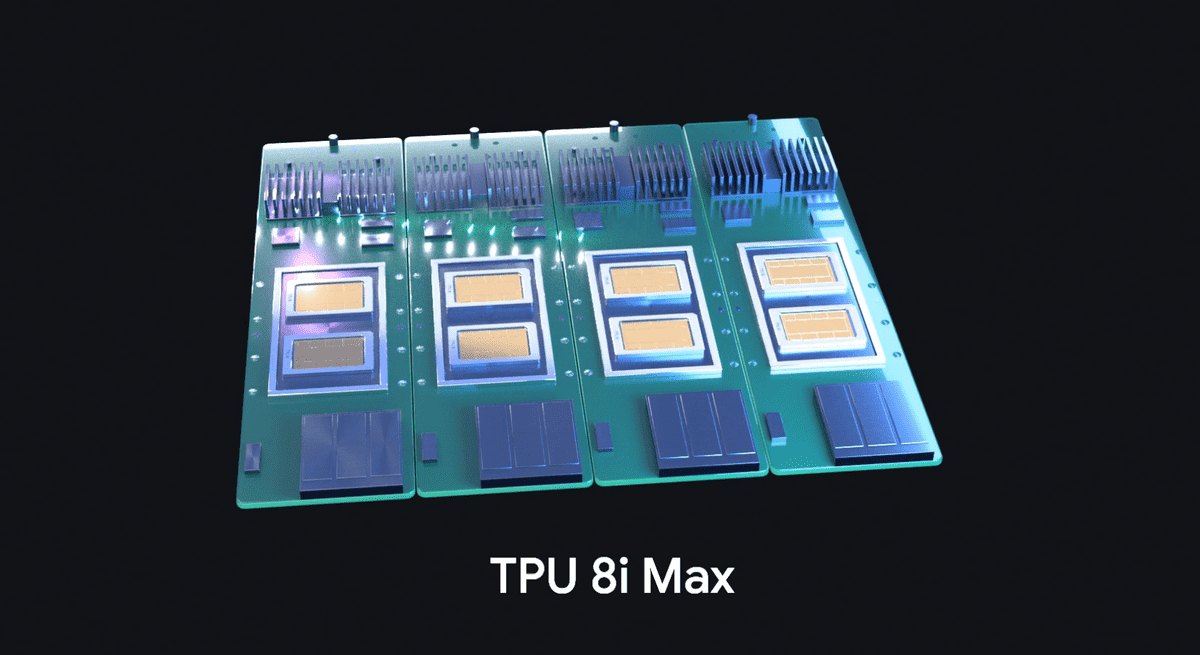
一方のTPU 8i Maxは、大量の情報を参照しながら処理を進めるAI向けに設計されています。AIが一度に参照できる情報量は「コンテキストウィンドウ」と呼ばれ、ソフトウェアのコード全体や数時間分の動画などをAIに扱わせる場合、膨大なデータをメモリから読み込む必要があります。大量のデータを処理する際は、メモリの転送速度が処理性能を制限する原因になります。
TPU 8i Maxは既存のTPU 8iを2個、1つのパッケージにまとめることで大量のデータを効率よく処理できるようになっているとのこと。TPU 8iと比較して演算性能、SRAM容量、高帯域幅メモリ(HBM)の転送速度がそれぞれ2倍に向上しました。演算性能とメモリ性能を同時に引き上げることで、AIが大量の情報を扱う際の処理待ちを減らせるとのこと。さらに、TPU 8i Maxは既存のサーバーラックと同じ設置面積に従来の2倍の数のチップを搭載できるため、データセンターの設置面積当たりの演算性能も向上しています。
Googleは新システムの発表に合わせて、TPU向けソフトウェアの拡充についても説明しました。2026年10月にオープンソース化した「TorchTPU」によって、AI開発で広く利用される「PyTorch」のコードをTPU上で動作させられるほか、AIエージェントの開発環境からTPUの設定や性能調整を支援する新たなツールもプレビュー版として公開しています。
GoogleのAI・インフラストラクチャ部門の上級副社長を務めるアミン・ヴァーダット氏は、TPU 8tを大規模な学習、TPU 8iを低遅延の推論、TPU 8txを機密情報の保護、TPU 8i Maxを大量の情報を扱う処理に割り当てることで、AIエージェントの幅広い用途に対応できると説明しています。
Googleが1年間に4種類のTPUシステムを発表したのは初めてです。TPU 8txとTPU 8i Maxの具体的な提供開始日や価格は記事作成時点で明らかになっていません。Googleのスンダー・ピチャイCEOは、Google DeepMindの研究者とハードウェア開発者が共同で設計を進めることで、従来の半導体開発サイクルを待たずに顧客向けの技術革新を続けられると述べています。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.