Одна франшиза — три адреса и два написания: дедупликация каталога франшиз по открытым данным
Человек, который вводит в поиск запрос вроде «франшиза каталог для малого», получает несколько каталогов, и в каждом тысячи карточек. Кажется, что из них легко собрать одну таблицу рынка: обойти, склеить, посчитать. Я так и думал, пока не попробовал склеить два каталога и один каталог сам с собой.
Ниже - что я взял за ключ записи, сколько раз каждый ключ подвёл и что в итоге работает. Код на Python, данные сняты 6 и 16 октября 2026 года.
Каталог франшиз для малого бизнеса 2026 глазами парсера
Каталог франшиз для малого бизнеса 2026 года, с которого я начал, отдаёт страницы сервером целиком, без JavaScript и без антибота для моего сервера в Амстердаме. 6 октября я обошёл выдачу каталога и сохранил адреса карточек в порядке показа: 2 284 адреса.
Карточка выглядит так: /franchise/4036-franshiza-franshiza-zdraste. Число в начале - id, дальше слаг. Внутри - название, ниша в заголовке страницы, год основания, число точек, «Инвестиции от» и, что оказалось самым интересным, плашка маркировки рекламы.
16 октября я взял каждую четвёртую карточку списка, 571 адрес, и открыл их заново.
Ключ первый: адрес
Первое, что делает любой сборщик, - считает адрес уникальным. Здесь это не так уже на входе:
`python ids = [re.search(r"/franchise/(\d+)", u).group(1) for u in urls] len(urls), len(set(ids)) # (2284, 2034) `
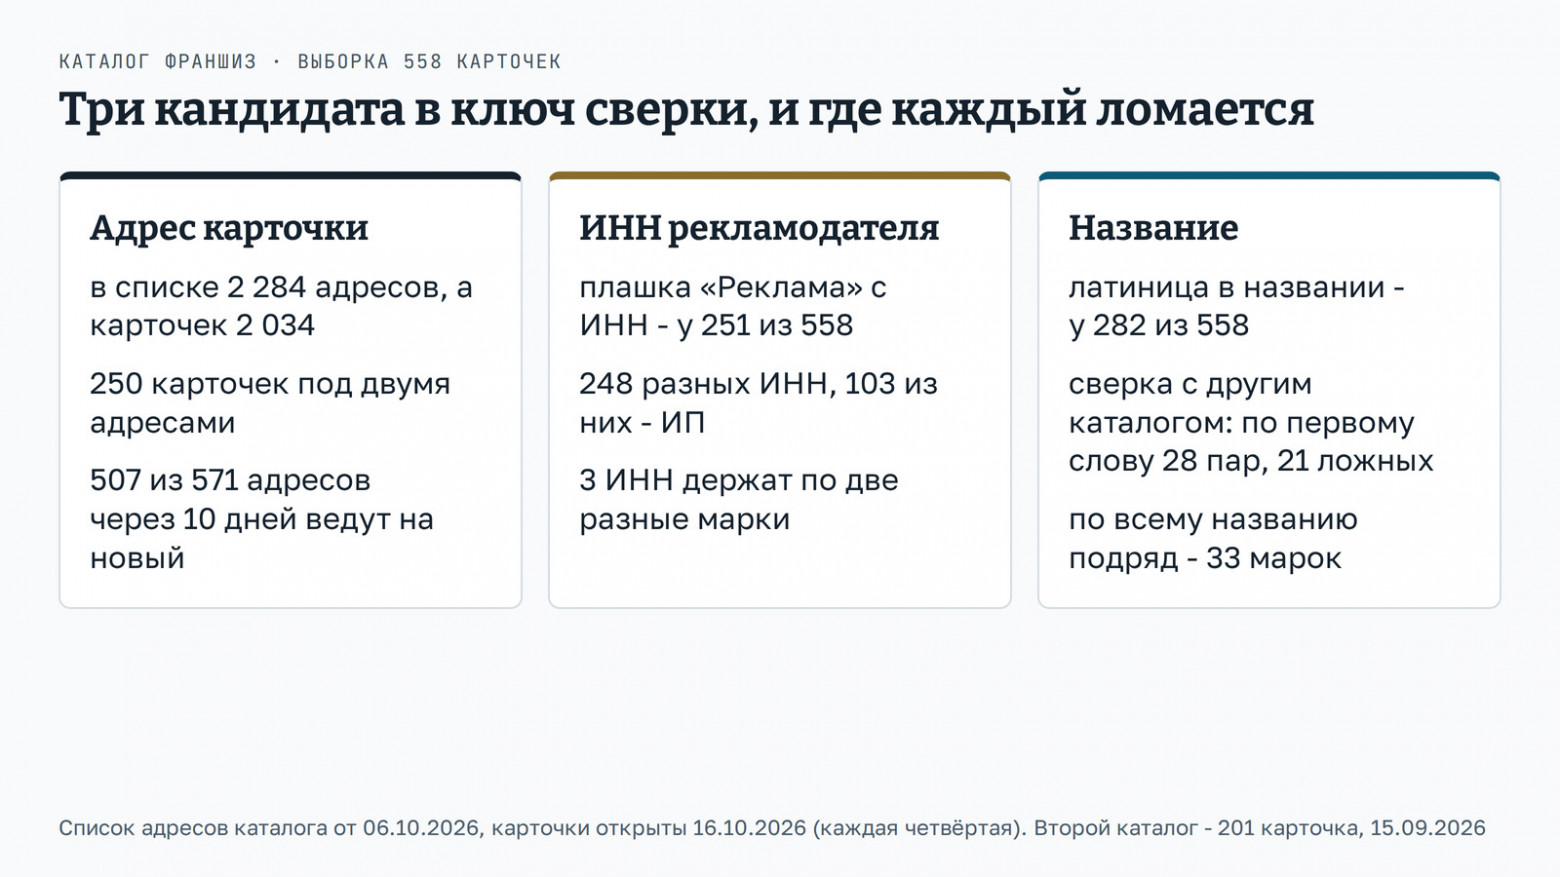
2 284 адреса, но только 2 034 карточки. 250 карточек стоят в выдаче дважды: один раз как 4689-franshiza-franshiza-resellup, второй раз как 4689-franshiza-resellup. Слово «franshiza» в первом варианте повторено, и так написаны все 2 034 адреса старого вида.
Через десять дней старый вид исчез. Из 571 адреса выборки 507 отдали редирект на новый слаг без двойного слова, и это ровно все адреса старого вида. Кто собрал базу 6 октября с адресом в роли ключа, 16 октября получит половину «новых» карточек, которые на деле старые.
Вывод банальный, но я его выучил заново: ключ записи - id из адреса, а не адрес, и сам адрес надо брать после редиректа (resp.geturl()).
Ключ второй: ИНН из маркировки
Хотелось ключ, который живёт вне каталога. Таким казался ИНН. Карточка - рекламное размещение, и по 38-ФЗ у неё должна быть пометка «Реклама» с рекламодателем и токеном erid. На карточке это выглядит как строка «ООО ... ИНН:1675005232 · erid: 2SDnjc...».
Первый проход дал красивую картину: около сотни ИНН на нескольких карточках, а у верхних по пять-пятнадцать карточек разных марок. Я уже писал вывод про рекламные агентства, когда открыл одну карточку руками. Плашек на странице было семь: одна в шапке и шесть у чужих рекламных блоков ниже. Регулярка брала первую попавшуюся, и на карточках без своей плашки это был чужой баннер.
Исправленный разбор ищет плашку только в шапке карточки, до <h1>:
`python h1 = page.find("<h1") head = page[page.find("fr-head"):h1] m = re.search(r"([^|>\n]{3,160}?)\s*ИНН:\s*(\d{10,12})\s*(?:<[^>]+>|\s|\|)erid:\s(\w+)", re.sub(r"<[^>]+>", " | ", head)) `
После этого картина стала скучной и честной. Своя плашка есть у 251 карточки из 558, у 307 её нет вовсе. Разных ИНН 248: у юрлиц (10 цифр) 145, у ИП (12 цифр) 103. Всего три ИНН встречаются на двух карточках, и во всех трёх случаях это две разные марки одного владельца, а не дубль. Если склеить их по ИНН, любой рейтинг франшиз, собранный из такого каталога, потеряет две настоящие сети.
То есть ИНН из маркировки годится как атрибут, но не как ключ: у половины карточек его нет, а один ИНН может означать несколько сетей. Есть и третья ловушка: ИНН рекламодателя не обязан быть ИНН правообладателя товарного знака. Рекламу может заказывать управляющая компания, партнёр или представитель. Проверить знак по названию в открытом реестре ФИПС гостю нельзя, поиск там по номеру свидетельства (проверял 10 сентября 2026 года).
Ключ третий: название
Остаётся название. У одной и той же сети в двух каталогах оно пишется по-разному: в одном «Суши Мастер», в другом есть только слаг sushi-master. Значит, сравнивать надо в одной письменности. Я привёл названия к ядру (убрал слово «Франшиза», кавычки, регистр, ё) и транслитерировал по той же схеме, что и слаги каталогов:
```python TR = dict(zip("абвгдеёжзийклмнопрстуфхцчшщъыьэюя", ["a","b","v","g","d","e","e","zh","z","i","y","k","l","m","n","o","p", "r","s","t","u","f","kh","ts","ch","sh","shch","","y","","e","yu","ya"]))
def core(name): n = re.sub(r"^\s*франшиза\s+", "", name, flags=re.I).replace("ё", "е") n = re.sub(r"[«»\"'“”„™®!.,:;()]+", " ", n) return " ".join(n.lower().split()) ```
Здесь вылезли свои мелочи. В 282 названиях из 558 есть латиница, а в пяти словах буквы двух алфавитов перемешаны внутри одного слова: латинская «C» в конце кириллического сокращения, «PRO» перед русским корнем. Для транслитерации это разные строки, хотя глазами слово одно.
Дальше сверка со вторым каталогом, 201 карточка от 15 сентября. Первая версия сравнивала первое значимое слово ядра с первым значимым словом слага:
`python naive = [(c, path) for c in cores for t, path in slugs if c[0] == t[0] and len(c[0]) > 3] `
28 пар, из которых 21 ложная. Любые «суши», «кофе» и «точка» склеивают разные сети: четыре суши-бренда в одну кучу, салон красоты с кофейней самообслуживания. Вторая версия требует, чтобы всё ядро названия стояло в слаге подряд:
`python def strict(core_tokens, slug_tokens): n = len(core_tokens) return any(slug_tokens[i:i + n] == core_tokens for i in range(len(slug_tokens) - n + 1)) `
Так нашлось 33 марки, общие для двух каталогов, и одна из них под сомнением: однословное название, которое встречается и как обычное слово. Зато строгая версия потеряла настоящую пару: на карточке первого каталога в название вписаны слова ниши, и ядро стало длиннее, чем в слаге второго.
Что в итоге работает
Порядок, который я оставил себе:
1. Внутри одного каталога ключ - его собственный id после редиректа. Адрес хранить, но не сравнивать. 2. ИНН из плашки маркировки - атрибут, а не ключ. Пустой у половины карточек и общий у разных марок одного владельца. 3. Между каталогами - ядро названия в одной транслитерации, совпадение всего ядра подряд, а однословные ядра и названия со словами ниши разбирать руками. 4. Перед сверкой - проверить слова на смесь алфавитов. Пять случаев на 558 мало, но каждый из них тихо ломает строгое сравнение.
Из 558 карточек одного каталога во втором нашлось 33 марки. Это не доля рынка и не оценка каталогов, а нижняя граница пересечения: второй каталог меньше, снят на месяц раньше, и часть сетей в нём записана так, что никакая транслитерация их не сведёт.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.