Переобулись на ходу: как мы перевезли 25 микросервисов с MS SQL Server на PostgreSQL
Mindbox — российская SaaS‑платформа для персонализации маркетинга и цен. До недавнего времени главной реляционной БД для работы наших сервисов был MS SQL Server. Чтобы не зависеть от продукта Microsoft мы переписали наши сервисы на работу с PostgreSQL — СУБД с открытым исходным кодом.
Всем привет! Я Андрей Васильев, инженер платформы в команде баз данных Mindbox. За первые 3 месяца 2 026 года я с двумя коллегами перенес 90 БД с MSSQL на PostgreSQL. В статье расскажу, как мы переносили схемы и переливали данные с помощью pgloader и CDC через Debezium и Kafka.
Инвентаризация: что нужно было перенести
Все сервисы Mindbox развернуты в четырех окружениях: staging, beta, sigma и stable. Каждое из них обслуживает отдельную группу клиентов. Staging — самое маленькое окружение, на нем мы обкатываем изменения до выхода в прод. Самое большое, stable — продакшен контур, который обслуживает 70% наших клиентов.
Окружения мы переносили по очереди: сначала staging, затем более крупные, а самый нагруженный и критичный stable — последним. Первая волна миграции затронула 25 сервисов Mindbox. Учитывая, что сервис может быть развернут в нескольких окружениях получилось около 90 баз данных.
Для понимания объемов приведу статистику по окружению stable:
Таблицы | Строки, млн | ГБ в SQL Server | ГБ в PostgreSQL | |
Окружение stable | 558 | 658,1 | 841 | 369,8 |
Самая большая БД | 25 | 433,6 | 278,5 | 181,9 |
Общий объем баз после переезда сократился в 2,3 раза, а гигантские БД в PostgreSQL заняли в 4 раза меньше места, чем в SQL Server. Эта разница объясняется типом и размером хранимых значений:
SQL Server хранил текст в UTF-16, а PostgreSQL — в UTF-8, где кириллица и латиница в среднем занимают меньше места. Это работает на любой, даже короткой, строковой колонке.
PostgreSQL дополнительно сжимает длинные текстовые и бинарные значения через TOAST: если значение не помещается в строку таблицы, оно переносится в отдельную TOAST‑таблицу и по умолчанию сжимается PGLZ.
Таким образом, база, где основной объем — это множество коротких строковых и числовых полей, слабо меняется в размере при переезде. А база, где объем сосредоточен в нескольких текстовых или бинарных колонках, может ужаться в несколько раз — там складываются переход на UTF-8 и сжатие PGLZ.
Семь баз с большим объемом текста стояли особняком. Они связаны с сервисами рассылок и на момент миграции содержали 10,09 млрд строк общими объемом 17,1 Тб. Их мигрировали позже, когда обкатали алгоритм переноса. На PostgreSQL они заняли в 4 раза меньше места.
Погоня за нулевым даунтаймом: как искали схему миграции
Когда мы искали рабочую схему переноса данных, первым делом оценили самый очевидный вариант: перевести SQL Server в read only, перелить данные в PostgreSQL с помощью pgloader и переключить приложение. Cкорость переноса при таком подходе и с этим инструментом составляла бы примерно 50 ГБ в час. Это означало, что самая большая база будет находиться в состоянии read only больше 3,5 часов. Для наших сервисов такой даунтайм недопустим. Дело не только в RPS. Самые нагруженные сервисы, которые работают с БД, обрабатывают всего 300 запросов в секунду в пике и почти не видны снаружи по трафику. При этом они в фоне непрерывно выполняют транзакционно значимую работу. Например, у сервиса фидов меньше одного запроса в секунду на админку, но он постоянно обновляет цены. И если его остановить на час, по всем витринам и рассылкам расползутся неактуальные цифры. У рантайма сценариев RPS в привычном смысле нет вообще, но это ключевая фича продукта, и ее вообще нельзя останавливать ни на секунду.
Нам нужен был минимальный даунтайм, который еще и не зависит от объема переносимых данных. Исходя из этого требования, остановились на схеме с использованием механизма CDC + Debezium. CDC (change data capture) отслеживает изменения в базе данных. В SQL Server он читает журнал транзакций и сохраняет изменения в служебные таблицы. Debezium работает поверх Kafka Connect. Коннектор‑источник читает изменения из CDC таблиц и складывает их в Kafka, а коннектор‑приёмник получает данные и применяет их в PostgreSQL.
В финальном виде общий сценарий выглядел так:
Снапшот, снятый с SQL Server, льется часами в PostgreSQL при полноценно работающем сервисе.
CDC в это время собирает изменения на SQL Server и после миграции снапшота применяет их в PostgreSQL.
SQL Server в момент переключения переводим в read only и ждем, пока хвост изменений запишется в PostgreSQL.
Мы предполагали, что такая схема позволит удерживать даунтайм в пределах нескольких минут независимо от размера БД. В целом, так и получилось. Почти)
Стратегия переноса: pgloader, CDC + Debezium
Писать свой код для синхронизации нам не пришлось. Для переноса снапшота решили использовать pgloader. Это open‑source утилита, которая умеет переносить схему и данные из разных СУБД в PostgreSQL. Изменения, образовавшиеся в SQL Server после снятия снапшота, доливались в PostgreSQL двумя готовыми плагинами для Debezium:
io.debezium.connector.sqlserver.SqlServerConnector — source‑коннектор, читает изменения из CDC‑таблиц SQL Server и отправляет их в Kafka.
io.debezium.connector.jdbc.JdbcSinkConnector — sink‑коннектор, читает события из Kafka и применяет изменения в PostgreSQL.
В неймспейсе приложения одним Helm‑чартом разворачивали всю необходимую инфраструктуру:
— Kafka на Strimzi, 3 контроллера и 3 брокера, KRaft;
— Kafka Connect в двух репликах;
— Kafka UI;
— sql‑exporter, чтобы мониторить сквозную задержку при синхронизации.
Порядок шагов при запуске синхронизации был важен для сохранения целостности данных:
Шаг 1: включить CDC на стороне SQL Server. Агент внутри SQL Server начинает вычитывать транзакционный лог и складывать данные в служебные таблицы в схеме cdc.
Шаг 2: включить только source‑коннектор Debezium. События начинают накапливаться в Kafka, в PostgreSQL пока ничего не идет.
Шаг 3: снять свежий бэкап SQL Server и восстановить его в отдельную read only базу.
Шаг 4: перелить данные в PostgreSQL через pgloader.
Шаг 5: включить sink‑джобу, которая читает из топиков CDC и вставляет данные в PostgreSQL.
События, которые sink применяет в PostgreSQL, идемпотентны: insert.mode: upsert и primary.key.mode: record_key. Каждое трансформируется в INSERT... ON CONFLICT DO UPDATE по первичному ключу. Поэтому перед созданием снапшота изменения можно было безболезненно копить в Kafka. Sink их применял и ничего не ломал, даже если запись уже была в снапшоте. В таком случае существующая в PostgreSQL строка просто обновлялась.
Sink мог падать с нарушением уникального индекса. Он делает ON CONFLICT только по первичному ключу и не учитывает другие уникальные ограничения таблицы. Проблема возникала, например, если старую строку удалили, а новую создали с другим Id, но с тем же бизнес‑ключом. В снапшоте уже лежала новая строка, а sink при воспроизведении старых событий сначала пытался вставить предыдущую. По первичному ключу конфликта не было, но уникальный индекс по бизнес‑ключу был уже занят. Например, для таблицы с первичным ключом Id и уникальным индексом по паре бизнес‑полей (MessageId, Discriminator) последовательность действий всех акторов могла быть такой:
Время | Что происходит в SQL Server | Что записывается в Kafka |
10:00 | Включили source-коннектор, в таблице нет строки с парой (42, 'SendingIp') | |
10:05 | Приложение создает запись Id = 100 с парой (42, 'SendingIp') | INSERT Id = 100 |
10:07 | Приложение удаляет строку Id = 100 и создает заново: Id = 101 с парой (42, 'SendingIp') | DELETE Id = 100 INSERT Id = 101 |
10:10 | Сняли бэкап и перелили снапшот | |
11:00 | Включили sink, он применяет события из очереди с 10:00 |
Получалось, что в снапшоте лежит конечное состояние на 10:10, то есть одна строка с Id = 101. Kafka же хранит весь путь изменений, начиная с 10:05. Уже первое событие из очереди INSERT... ON CONFLICT («Id») для Id = 100 sink обработать не сможет. По первичному ключу конфликта нет, так как в PostgreSQL нет строки с Id = 100. Но пара (42, 'SendingIp') уже занята строкой с Id = 101, приехавшей со снапшотом. Следующим в Kafka лежит событие про удаление строки с Id = 100, после которого все и сошлось бы, но до него sink не доберется. Он упадет с ошибкой: duplicate key value violates unique constraint «UX_MessageDetails_MessageId_Discriminator».
Такое ограничение sink можно обходить. Например, из PostgreSQL вручную удалять строки, которые мешают применять накопленные события. Можно еще снимать проверки уникальности на время синхронизации. Мы делали и так, и эдак.
Порядок шагов при проведении синхронизации обеспечивал консистентность данных по внешним ключам. Если изменения по разным таблицам применять в произвольном порядке, вставка дочерней строки может опередить родительскую и sink упадет. Поэтому, чтобы не сломать последовательность событий, мы в чарте применили самый консервативный набор настроек:
— source‑коннектор отправлял события CDC из всех таблиц в один Kafka‑топик,
— sink применял события по одному: параметр sink‑коннектора batch.size был равен 1.
Так изменения доходили до PostgreSQL в том же порядке, в каком происходили в SQL Server, и внешние ключи не мешали синхронизации. Для большинства БД такой скорости хватало. Но на сервисе фидов с постоянным потоком обновлений строк sink не успевал обрабатывать изменения, и очередь росла. Для этого случая пришлось и batch.size увеличивать, и распределять события разных таблиц по отдельным топикам, а для этого временно снимать FK на PostgreSQL.
Схемы баз данных: как и с помощью чего их переносили
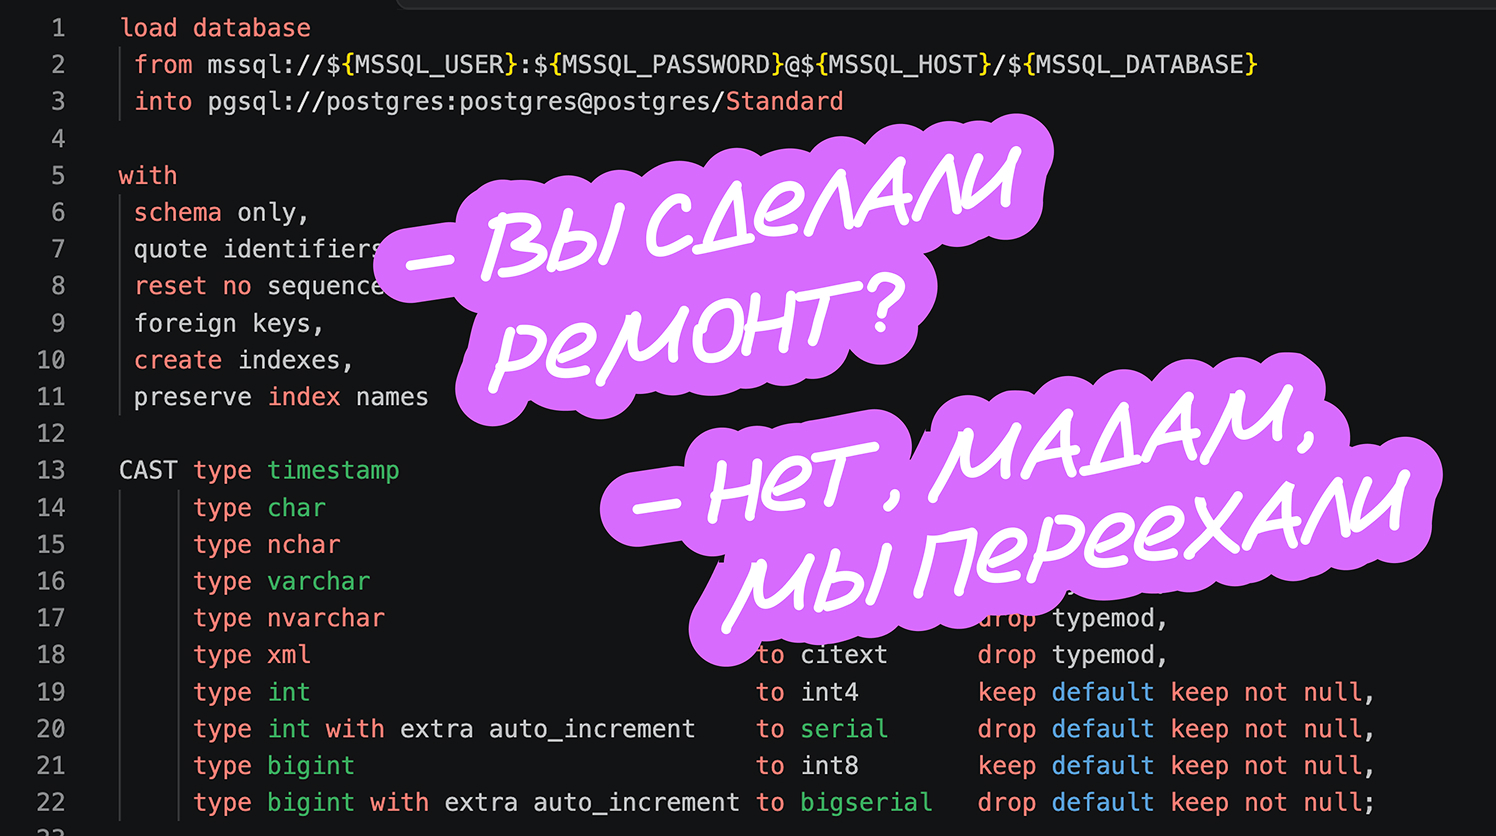
Для перетаскивания структур БД между SQL Server и PostgreSQL мы решили использовать все тот же pgloader, который помимо данных умеет переносить и схему. Просто поднимали пустой PostgreSQL в Docker и запускали pgloader вот с таким конфигом:
Конфиг pgloader для переноса схемы
load database
 from mssql://${MSSQL_USER}:${MSSQL_PASSWORD}@${MSSQL_HOST}/${MSSQL_DATABASE}
 into pgsql://postgres:postgres@postgres/Standard

with
 schema only,
 quote identifiers,
 reset no sequences,
 foreign keys,
 create indexes,
 preserve index names

CAST type timestamp                        to bytea,
     type char                             to citext      drop typemod,
     type nchar                            to citext      drop typemod,
     type varchar                          to citext      drop typemod,
     type nvarchar                         to citext      drop typemod,
     type xml                              to citext      drop typemod,
     type int                              to int4        keep default keep not null,
     type int with extra auto_increment    to serial      drop default keep not null,
     type bigint                           to int8        keep default keep not null,
     type bigint with extra auto_increment to bigserial   drop default keep not null;
Схему из SQL Server pgloader переносит с ограничениями:
— теряет INCLUDE‑колонки индексов;
— трансформирует Computed‑колонки в обычные;
— преобразует identity в serial;
— вовсе не переносит условия фильтрации индексов, CHECK‑констрейнты и пользовательские функции.
На первых тестовых прогонах мы обнаружили несколько дополнительных и неочевидных ограничений. Например, SQL Server для типа time по умолчанию поддерживает точность до 7 знаков. pgloader это никак не учитывал, потому что PostgreSQL поддерживает максимум 6. Нам пришлось на стороне SQL Server понижать точность отдельной миграцией, иначе данные переезжали некорректно.
Отдельно решали вопрос с тем, как разные СУБД сравнивают строки. В SQL Server поиск по строкам по умолчанию case‑insensitive, если установлена специальная коллация уровня сервера. В PostgreSQL сделать так отдельной case‑insensitive коллацией нельзя, потому что перестает работать pattern matching. Поэтому все строковые колонки в сгенерированной схеме мы приводили к citext. У него нет ограничений по длине и индексы на колонках строятся дольше, но мы с этим смирились. Изменение типа пришлось поддерживать и на уровне приложений: в Npgsql переопределяли маппинг.
Для поиска всех расхождений между схемами источника и таргета мы использовали компарер — собственную утилиту, которая читала метаданные из обеих СУБД и сравнивала их таблицу за таблицей. Результатом работы компарера был машиночитаемый дифф, к которому мы прикрутили классификатор несоответствий. Дальше мы по таблице резолюшенов вручную разбирали полученный дифф, вносили на PostgreSQL нужные фиксы и снова запускали компарер. Обычно на 2–3 итерации получали приемлемый результат, когда нет критичных расхождений между схемами и есть уверенность, что данные перенесутся корректно.
Чтобы частично автоматизировать процесс для типовых расхождений, которые были одинаковыми на всех базах, мы написали пачку bash‑скриптов. Они поднимали пустой PostgreSQL в Docker, запускали pgloader и генерировали SQL‑фиксы на identity, длину citext‑колонок и уникальные ограничения. Перенос INCLUDE‑колонок мы починили в самом pgloader, в нашем форке. Остальные несоответствия, такие как computed‑колонки, обрабатывали вручную по диффу компарера. Сейчас, наверное, с этой задачей справится любая нейронка, но когда мы начинали все это делать, модели были не такие продвинутые.
В результате всех «приседаний» мы разработали процесс, который с натяжкой, но можно назвать конвертером. Благодаря ему мы могли получать заветный рабочий файл schema_dump.sql для каждого сервиса.
Bulk-миграция для экономии времени: снапшот + pgloader и обвязка на C#
Перенос снапшота из SQL Server в PostgreSQL оркестрирует наша кастомная обвязка на C#. Она выполняет семь шагов:
1. Проверяет, переведена ли база SQL Server в режим READ_ONLY.
2. Проверяет конфигурацию кластера PostgreSQL, а именно достаточно ли выделено CPU и memory, и выключена ли синхронная репликация. Дефолтных значений было недостаточно и кластер не выдерживал нагрузку при переливке большого снапшота.
3. Генерирует скрипты before.sql и after.sql. Первый удаляет внешние, уникальные и первичные ключи, индексы и computed‑колонки. Второй после переливки возвращает все обратно и настраивает sequences на актуальные значения. Привязанные к колонке последовательности пересчитываются из уже залитых данных через MAX(col), а свободные переносятся по значению из SQL Server, как есть. Без этих скриптов COPY записывал бы данные, проверяя все ключи и индексы на каждой строке. И переливка заняла бы в 5–6 раз больше времени.
4. Выполняет before.sql.
5. Запускает pgloader отдельным Job в k8s и ожидает результат его работы.
6. Сверяет количество строк на SQL Server и PostgreSQL и аварийно завершает миграцию, если есть расхождение.
7. Выполняет after.sql.
Для bulk‑заливки данных из снапшота мы используем pgloader. Он умеет загружать данные в PostgreSQL через COPY. Мы искали альтернативу, но инструментов было немного: в основном, платные или облачные решения, что нам не подходило. Попробовали dalibo/sqlserver2pgsql, но решили не связываться — инструмент было сложно настроить и запустить, он работал нестабильно и постоянно падал на загрузке java‑зависимостей.
Если бы мы переезжали сейчас, то, возможно, воспользовались бы pgferry — однобинарной утилитой на Go, для которой разработчики заявляют высокую скорость холодной переливки. Но первый коммит в проекте появился только 22 февраля 2 026 года, когда мы уже вовсю переезжали, так что с pgferry тогда не сложилось.
В общем, мы остановились на pgloader, потому что он уже используется в стеке для переноса схемы. Правда, и с ним пришлось повозиться. pgloader некорректно обрабатывал nvarchar и nchar и падал на суррогатных парах UTF-16 — символах за пределами Basic Multilingual Plane. Чаще всего это были эмодзи с кодовыми точками выше U+FFFF. В итоге пришлось делать форк pgloader и изменить в нем чтение строковых колонок. Мы сдвинули перекодирование на сторону источника и колонки стали читаться так: cast([col] collate Latin1_General_100_CI_AS_SC_UTF8 as varchar(max)) — главную роль здесь играет флаг «SC» (Supplementary Characters) в имени коллации. Он включает корректную работу с суррогатными парами. В результате SQL Server отдает данные уже как валидный UTF-8, и баг перекодирования в pgloader не задействуется.
Конфиг pgloader для переливки данных снапшота
pgloader:
  config: |
    load database
    from mssql://${SqlServerUser}:${SqlServerPassword}@${SqlServerHost}/${SqlServerDatabase}
    into pgsql://${PostgresUser}:${PostgresPassword}@${PostgresHost}/${PostgresDatabase}
    with
    data only,
    truncate,
    create no schemas,
    create no tables,
    create no indexes,
    no foreign keys,
    quote identifiers

    excluding table names like 'DatabaseMigrations' in schema 'dbo'
    excluding table names like 'sysdiagrams' in schema 'dbo'
    excluding table names like 'VersionInfo' in schema 'dbo'

    set mssql parameters textsize to '1073741824'; # 1 ГиБ, иначе при дефолтном textsize большие блобы обрезаются
Хвост миграции: CDC и его «особенности»
CDC — это штатный механизм SQL Server, который мы активируем на первом шаге миграции. Как оказалось, у CDC есть особенности и ограничения, которые нужно учитывать. Например, запуском CDC можно легко и непринужденно сломать приложение, которое работает с БД. Если в отслеживаемой таблице сделать INSERT или UPDATE со значением nvarchar(max) больше 64 КБ, то запрос упадет с ошибкой 7139. Все дело в ограничении репликации, которое активируется в момент включения CDC. Чтобы пофиксить, нужно увеличить серверную настройку max text repl size. Значение для нее зависит от максимальной длины возможного nvarchar(max) в таблице.
EXEC sp_configure 'max text repl size', 2097152;
RECONFIGURE;
Более замысловатый кейс мы поймали на нашем SQL Server 2 019 при failover, когда primary оказался на другой реплике: захват изменений остановился без каких‑либо ошибок. Причина крылась в архитектуре самого CDC. Дело в том, что данные захвата хранятся в схеме cdc внутри пользовательской базы в таблицах cdc.<table>_CT, cdc.change_tables и cdc.lsn_time_mapping. Но есть еще две джобы SQL Agent:
— cdc.<db>_capture читает журнал транзакций и наполняет CDC‑таблицы;
— cdc.<db>_cleanup удаляет старые данные.
Сами джобы, их шаги, расписания и таблица параметров хранятся отдельно в системной базе msdb. Пользовательская база вместе со схемой cdc, в отличие от msdb, входит в Availability Group. И при failover новый primary получает cdc‑данные, но ничего не знает о состоянии msdb.
Чинили так:
1. Заранее создавали CDC‑джобы на каждой secondary реплике через sp_add_job, sp_add_jobstep, sp_attach_schedule, sp_add_jobserver и копировали параметры в msdb.dbo.cdc_jobs.
2. Научили джобы понимать, где они работают. Для этого тело каждого шага обернули проверкой роли, которую исполняет реплика. Шаг запускался только если база сейчас primary:
DECLARE @DatabaseName SYSNAME = DB_NAME()
IF (SELECT sys.fn_hadr_is_primary_replica(@DatabaseName)) = 1
BEGIN
  <исходная команда>
END
3. Дали capture‑джобе возможность подняться после переключения, так как Failover Agent ее не перезапускал. Для этого завели расписание на старт «раз в минуту, круглосуточно». Таким образом, на secondary‑реплике джоба каждую минуту просыпалась и сразу завершалась. Но когда реплика становилась primary, джоба начинала читать лог изменений.
EXEC msdb.dbo.sp_add_jobschedule
    @job_name             = 'cdc.MyDb_capture',
    @name                 = 'CDC_Failover_Recovery_MyDb',
    @freq_type            = 4,  -- ежедневно
    @freq_subday_type     = 4,  -- в минутах
    @freq_subday_interval = 1;  -- каждую минуту
Capture возобновлял чтение с того LSN, на котором остановился. Для это ничего изобретать не пришлось, потому что верхняя граница обработанного журнала транзакций хранилась в пользовательской базе в реплицируемой таблице cdc.lsn_time_mapping. А урезать транзакционный лог было нельзя, потому что SQL Server не дает это сделать, пока CDC не забрал данные.
Еще был сюрприз от CDC, строго связанный с большим объемом данных. В Mindbox есть сервис импорта фидов, который по расписанию скачивает товарные каталоги клиентов, разбирает их и складывает товары в одну таблицу. Расписание работает через Quartz в той же базе. Когда Quartz запускает импорт, начинается массовое обновление каталога, поэтому нагрузка на базу растет волнами. Особенность сервиса в том, что запись в его базе происходит всего в пару таблиц. Эти таблицы насчитывают несколько сотен миллионов строк. И хотя во время импорта INSERT не очень много — несколько операций в секунду, UPDATE идет непрерывным потоком. Таким образом, каталог не столько растет, сколько постоянно переписывается.
С дефолтными параметрами CDC maxtrans = 500, maxscans = 10 и pollinginterval = 5 захват на горячих таблицах не происходил. Потолок изменений, которые CDC способен обработать, считается чисто арифметически: maxscans × maxtrans / pollinginterval, а это по умолчанию всего 1 k транзакций в секунду. Все, что записали в БД сверх этого, capture не «догонит» никогда.
Чтобы capture хоть как‑то успевал собирать апдейты, мы крутили maxtrans и maxscans. За отставанием захвата следили прямо в SQL Server, который великодушно сохранял лог в sys.dm_cdc_log_scan_sessions для каждого прохода capture‑джобы. Запрос получился таким:
SELECT TOP (10)
       session_id,
       start_time,
       end_time,
       duration,               -- секунды
       latency,                -- секунды
       last_commit_cdc_time,   -- время последнего захваченного коммита
       tran_count,
       command_count,
       log_record_count,
       empty_scan_count,
       error_count,
       scan_phase
FROM sys.dm_cdc_log_scan_sessions
WHERE session_id <> 0           -- 0 это агрегат, не сессия
ORDER BY start_time DESC;
latency — это время в секундах, на сколько CDC отстает от журнала транзакций. Если latency растет при ненулевом tran_count, значит CDC уже уперся в потолок maxscans × maxtrans / pollinginterval. На таком объеме изменений cleanup‑джоба тоже была бесполезной со своими дефолтными настройками: retention в трое суток, threshold 5k строк за один DELETE и ежесуточный запуск в 02:00. Таблицы CDC разрастались до терабайта за полдня, после чего очистка прекращалась вовсе. Сначала мы пытались «крутить» настройки, но потом убедились, что за те же полдня с момента включения CDC успеваем переключить БД.
Битва за пропускную способность: как разгоняли CDC и Debezium
Чтобы захваченные CDC изменения в SQL Server применились в PostgreSQL, мы использовали Debezium. По умолчанию он отправляет изменения каждой таблицы в отдельный Kafka‑топик. Мы же, поставив несколько экспериментов, пошли наперекор дефолтам Debezium и прописали в ранбук правило объединять события всех таблиц в один топик.
transforms: reroute
transforms.reroute.type: org.apache.kafka.connect.transforms.RegexRouter
transforms.reroute.regex: (.*)
transforms.reroute.replacement: mssql.all_tables
Мы решили, что так будет проще и безопасней для миграции большей части данных. Используя единый топик, хоть и жертвуя параллелизмом на приемнике, мы обеспечивали тот же относительный порядок изменений по таблицам, что был в SQL Server. При этом внешние ключи в PostgreSQL переживали синхронизацию без дополнительного вмешательства.
Kafka Connect для Debezium и оба коннектора мы разворачивали одним Helm‑chart. На производительность больше всего повлияли две настройки Kafka producer на уровне worker:
producer.compression.type: lz4 — включает сжатие сообщений перед отправкой в Kafka.
producer.batch.size: 65536 — увеличивает размер батча до 64 К.
Без этих настроек, а особенно без компрессии, продюсеры сильно снижают общую пропускную способность. Например при миграции БД для сервиса фидов после применения этих настроек скорость отправки выросла с 500 до 15 k сообщений в секунду.
Kafka Connect-манифест, который задает настройки воркеров
apiVersion: kafka.strimzi.io/v1beta2
kind: KafkaConnect
metadata:
  name: {{ include "kafkaConnect.name" . }}
  annotations:
    strimzi.io/use-connector-resources: "true"
spec:
  version: 3.9.0
  replicas: 2
  resources:
    requests:
      cpu: "1"
      memory: "4Gi"
    limits:
      memory: "4Gi"
  image: {{ .Values.registry }}/kafka-connect:1.0.4
  bootstrapServers: {{ include "kafka.clusterName" . }}-kafka-bootstrap:9092
  config:
    config.providers: secrets
    config.providers.secrets.class: io.strimzi.kafka.KubernetesSecretConfigProvider
    group.id: connect-cluster
    offset.storage.topic: connect-cluster-offsets
    config.storage.topic: connect-cluster-configs
    status.storage.topic: connect-cluster-status
    producer.batch.size: 65536
    producer.buffer.memory: 67108864
    producer.compression.type: lz4
    producer.linger.ms: 20
    # .Values.kafkaConnect.config пуст по умолчанию — сюда обычно ничего не подмешивается
  metricsConfig:
    type: jmxPrometheusExporter
    valueFrom:
      configMapKeyRef:
        name: {{ include "kafkaConnect.name" . }}-connect-metrics
        key: metrics-config.yml
  template:
    pod:
      imagePullSecrets:
        - name: image-pull
Дефолтное поведение source‑коннектора тоже меняли:
— snapshot.mode: no_data. Отключает встроенный механизм, когда Debezium сам делает снапшот. В нашей схеме миграции начальный объем данных мы переливаем с помощью pgloader, который все же быстрее прокачки всей БД через Kafka.
— include.schema.changes: false. Отключает передачу изменений схемы через CDC. Схемой PostgreSQL управляет только мигратор микросервиса, поэтому приехавший через CDC DDL гипотетически может сломать синхронизацию и испортить уже перелитые данные.
Манифест source-коннектора
{{- if .Values.connectors.sqlserver.enabled }}
apiVersion: kafka.strimzi.io/v1beta2
kind: KafkaConnector
metadata:
  name: {{ .Release.Name }}-sqlserver-source
  labels:
    strimzi.io/cluster: {{ include "kafkaConnect.name" . }}
spec:
  class: io.debezium.connector.sqlserver.SqlServerConnector
  tasksMax: 1
  autoRestart:
    enabled: true
  config:
    connector.class: io.debezium.connector.sqlserver.SqlServerConnector
    max.queue.size: 16384
    max.batch.size: 4096
    poll.interval.ms: 100
    database.encrypt: false
    database.hostname: {{ .Values.connectors.sqlserver.databaseHost }}
    database.port: {{ .Values.connectors.sqlserver.databasePort }}
    database.user: ${secrets:{{ include "sqlserver.secret.name" . }}:username}
    database.password: ${secrets:{{ include "sqlserver.secret.name" . }}:password}
    database.names: {{ .Values.connectors.sqlserver.databaseName }}
    database.history.kafka.bootstrap.servers: {{ include "kafka.clusterName" . }}-kafka-bootstrap:9092
    database.history.kafka.topic: schema-changes.inventory
    topic.prefix: mssql
    schema.history.internal.kafka.bootstrap.servers: {{ include "kafka.clusterName" . }}-kafka-bootstrap:9092
    schema.history.internal.kafka.topic: schema-changes.mssql
    schema.history.internal.consumer.bootstrap.servers: {{ include "kafka.clusterName" . }}-kafka-bootstrap:9092
    schema.history.internal.producer.bootstrap.servers: {{ include "kafka.clusterName" . }}-kafka-bootstrap:9092
    snapshot.isolation.mode: snapshot
    snapshot.mode: no_data
    time.precision.mode: connect        # вместе с timestamp.handling.mode ниже решает вопрос точности datetime2
    timestamp.handling.mode: string
    tombstones.on.delete: 'false'       # вместе с delete.enabled: 'true' у sink — так удаления доезжают до PostgreSQL
    key.converter: org.apache.kafka.connect.json.JsonConverter
    key.converter.schemas.enable: 'true'
    value.converter: org.apache.kafka.connect.json.JsonConverter
    value.converter.schemas.enable: 'true'
    include.schema.changes: 'false'
    # transforms: reroute
    # transforms.reroute.type: org.apache.kafka.connect.transforms.RegexRouter
    # transforms.reroute.regex: (.*)
    # transforms.reroute.replacement: mssql.all_tables
{{- end }}
В качестве консьюмера мы использовали штатный JdbcSinkConnector Debezium. Для миграции большинства БД его стандартной конфигурации хватало. Но для сервисе фидов sink пришлось специально разгонять.
Первая мысль была увеличить batch.size с 1 до 500. Тут же возникала проблема: внутри батча изменения в PostgreSQL применялись в произвольном порядке, что несовместимо с наличием внешних ключей. Пришлось на время миграции их удалять. Команды удаления брались из before.sql, возврата — из after.sql. Конкретных цифр сейчас не назову, но прирост скорости был ощутимый даже на одной задаче и одном топике. Хотя сервис фидов продолжал сопротивляться.
Потом решили пойти дальше и отказались от схемы «один топик на все» в пользу дефолтной для Debezium схемы «топик на таблицу». На стороне sink подкрутили параметры для запуска параллельной обработки:
— tasksMax: 13 — разрешили запускать несколько задач sink;
— topics.regex: mssql.* — подписали sink на все топики, которые создает source‑коннектор;
— partition.assignment.strategy: CooperativeStickyAssignor — включили распределение партиций между задачами sink. В нашей схеме без этой настройки параллелизация не работала. При значении RangeAssignor распределение партиций каждого топика начиналось заново с первой задачи sink. Поскольку в каждом топике у нас была только одна партиция, все они доставались одной и той же задаче, а остальные простаивали. При этом казалось, что tasksMax не работает: задач больше одной, а пропускная способность не менялась. В итоге конфигурация sink‑коннектора выглядела так:
apiVersion: kafka.strimzi.io/v1beta2
kind: KafkaConnector
metadata:
  name: {{ .Release.Name }}-postgres-sink
  labels:
    strimzi.io/cluster: {{ include "kafkaConnect.name" . }}
spec:
  class: io.debezium.connector.jdbc.JdbcSinkConnector
  tasksMax: 13
  autoRestart:
    enabled: true
  config:
    bootstrap.servers: {{ include "kafka.clusterName" . }}-kafka-bootstrap:9092
    consumer.override.group.id: mssql.group.db.postgres
    connector.class: io.debezium.connector.jdbc.JdbcSinkConnector
    connection.url: jdbc:postgresql://{{ include "postgres.host" . }}:{{ .Values.connectors.postgres.databasePort }}/{{ .Values.connectors.postgres.databaseName }}?connectTimeout={{ .Values.connectors.postgres.connectTimeout }}&socketTimeout={{ .Values.connectors.postgres.socketTimeout }}
    connection.username: ${secrets:{{ include "postgres.secret.name" . }}:username}
    connection.password: ${secrets:{{ include "postgres.secret.name" . }}:password}
    errors.deadletterqueue.topic.name: psql.debezium.deadletterqueue
    hibernate.dialect: org.hibernate.dialect.PostgreSQLDialect
    batch.size: 500
    consumer.override.max.partition.fetch.bytes: 16777216
    consumer.override.max.poll.records: 5000
    consumer.override.partition.assignment.strategy: org.apache.kafka.clients.consumer.CooperativeStickyAssignor
    topics.regex: mssql.*
Debezium умеет распределять записи по нескольким партициям в одном топике. И в погоне за параллелизацией было бы правильнее использовать эту возможность. Тогда параллелизм внутри таблицы стал бы возможен, а порядок применения изменений можно было бы сохранять в пределах первичного ключа, организовав роутинг событий по его хэшу. Однако возможность эту мы обнаружили слишком поздно, когда уже проводили миграцию. Мы поняли, что не сможем быстро настроить несколько партиций на топик и от идеи отказались. Ретроспективно считаю, что решение было верным для ситуации с сервисом фидов, но неправильным для проекта в целом.
Для миграции сервиса фидов параллелизации не хватило. На горячих таблицах при работающем приложении очередь необработанных изменений продолжала расти вопреки нашим ожиданиям.
Тюнить производительность с помощью настроек мы уже не могли, так что оставалось ускорять только саму вставку в PostgreSQL. Запись тормозили два больших индекса, каждый — с несколькими дополнительными INCLUDE‑колонками. Когда мы их удалили, вставка ускорилась вдвое, и очередь накопленных изменений наконец начала сокращаться.
Возвращать индексы обычным CREATE INDEX было нельзя, это заблокировало бы таблицу, которая в тот момент находилась еще в процессе синхронизации. Поэтому мы выжидали, когда очередь сократится, и запускали построение индексов через CONCURRENTLY параллельно синхронизации. Когда очередь становилась совсем небольшой, мы останавливали запись в SQL Server, дожидались полной синхронизации и переключали приложение на PostgreSQL.
В день переключения получился вот такой таймлайн:
16:24 | включили CDC |
19:17 | запустили sink, очередь изменений — 20 млн строк |
19:30 | начали строить первый индекс |
23:23 | индексы были готовы и мы остановили основную пишущую нагрузку, чтобы добить остаток очереди |
23:40 | перевели SQL Server в READ_ONLY |
00:00 | приложение заработало на PostgreSQL |
Даунтайм на запись получился 40 минут. На чтение даунтайма не было вообще, потому что приложение до последнего читало из SQL Server, даже когда он находился в readonly‑режиме. Сервис фидов был единственным из 25, где нам не удалось уложиться в несколько минут простоя.
Heartbeat: как следили за синхронизацией
Перед переключением приложения нам нужно было знать, прошла ли синхронизация. А если нет, то на какое время PostgreSQL отстает от SQL Server. Но Debezium никак не показывает сквозную задержку, а consumer lag в Kafka может разве что сообщить, сколько сообщений sink еще не успел обработать. Чтобы закрыть вопрос мониторинга, мы через наш чарт создавали таблицу debezium.debezium_heartbeat в обеих базах и запускали две sql‑exporter джобы с расписанием раз в секунду.
Первая джоба в SQL Server записывала heartbeat строку:
INSERT INTO [debezium].[debezium_heartbeat](created_at_utc)
OUTPUT Inserted.created_at_utc, 1 as value
VALUES(GETUTCDATE());
Запись через CDC и Debezium попадала в PostgreSQL, где ее читала вторая джоба:
SELECT current_timestamp AS current_timestamp_utc,
       EXTRACT(EPOCH FROM current_timestamp - created_at_utc) * 1000 AS sync_delay_ms
FROM debezium.debezium_heartbeat
ORDER BY created_at_utc DESC
LIMIT 1;
Получившаяся метрика sql_debezium_heartbeat_sync_delay_ms — это сквозная задержка синхронизации, измеренная данными.
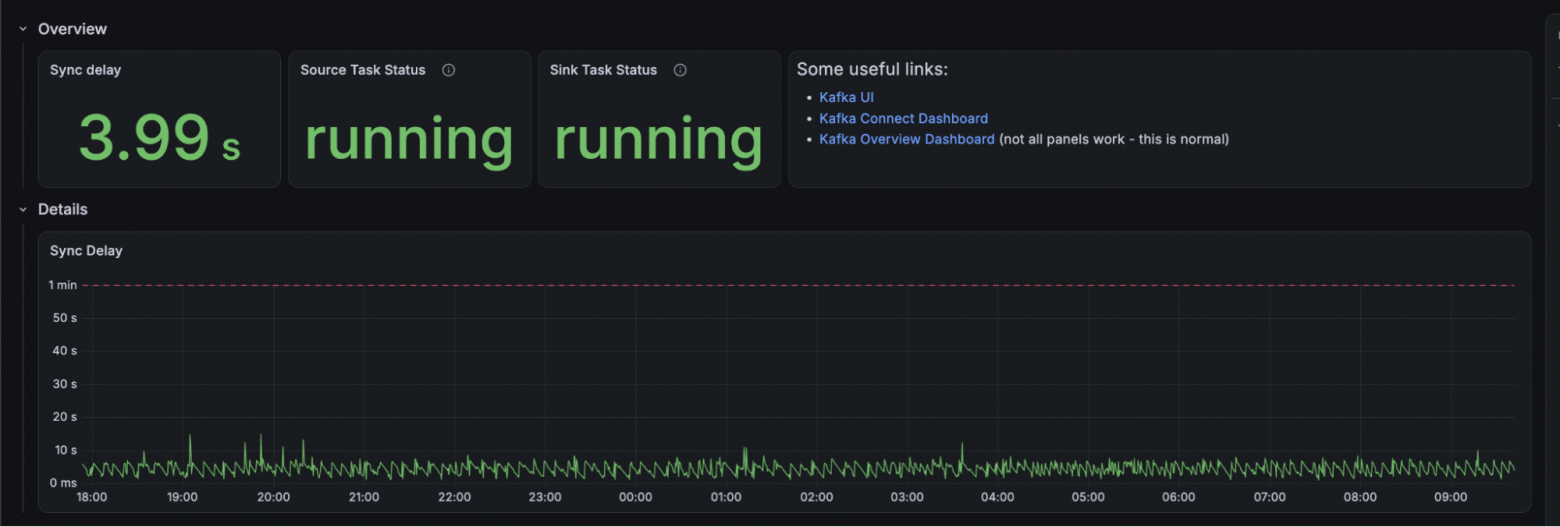
Состояние коннекторов мы мониторили через Kafka Connect. Метрика kafka_connect_worker_connector_failed_task_count показывала количество упавших задач.
На основе имеющихся метрик для мониторинга настроили три алерта:
Условие, которое сохраняется дольше 5 минут | Тема алерта |
sync_delay_ms > 60000 | Слишком большая задержка |
absent(sync_delay_ms) == 1 | Метрика пропала |
kafka_connect_worker_connector_failed_task_count > 0 | Задача коннектора упала |
Переключение: как переводили сервисы на PostgreSQL и «стелили соломку»
Приложение уже поддерживало PostgreSQL: в сервисе были нужные настройки и имплементация. По значению переменной окружения USE_POSTGRES сервис для работы выбирал провайдер‑специфичную обвязку, написанную под конкретную СУБД. До переключения было USE_POSTGRES=false: сервис работал с SQL Server. Переключение сводилось к одному MR с изменением двух строк:
Connection string переводили на primary реплику PostgreSQL,
Переменную окружения USE_POSTGRES устанавливали в true.
Чтобы избежать потери данных и не растянуть даунтайм при переключении, мы заранее проверяли, что ранбуки запускаются, а сверка строк, обновление сиквенсов и воркеры работают как ожидается.
Каждый сервис переключали на PostgreSQL в шесть шагов:
Мерджили MR, получали helmfile diff и ожидали появления кнопки интервенции.
Переводили SQL Server в readonly.
Подтверждали, что у consumer group sink нулевой лаг.
Сверяли количество строк между SQL Server и PostgreSQL, если размер таблиц позволял это сделать быстро.
Обновляли сиквенсы на MAX(Id) в PostgreSQL отдельным ранбуком.
Нажимали кнопку интервенции, поднимая приложение на PostgreSQL.
Пункты 3–6 — это даунтайм, и его длительность в общем случае зависела от времени деплоя сервиса. Шаг 3, где иной раз ждали окончания синхронизации, занимал 5–10 секунд. А в среднем, весь простой занимал не более 10 минут.
Перед переключением нужно было решить, как дозировать нагрузку на PostgreSQL. Работая с SQL Server мы понимали, сколько ресурсов нужно сервисам и как база ведет себя под нагрузкой. Применить эти знания к новой СУБД было невозможно ни расчетами, ни экстраполяцией, потому что слишком уж многое на PostgreSQL работает иначе:
— планировщик и планы запросов,
— конкурентные запросы,
— MVCC вместо блокировок,
— HOT‑обновления,
— autovacuum,
— профиль дисковых операций.
Понять, сколько ресурсов все это будет потреблять можно только в бою, поэтому после переключения мы решили наращивать нагрузку на новую базу постепенно.
Перед PostgreSQL ставили пулер с заниженным default_pool_size, чтобы приложение не могло сразу открыть слишком много соединений с базой. После переключения увеличивали пул и следили за метриками, получая контролируемый разгон. Это давало время отреагировать на проблему, если что‑то шло не так уже на 10% нагрузки.
В качестве пулера мы использовали pgbouncer, который разворачивали через оператор CloudNativePG в режиме transaction pooling. default_pool_size задается для каждого инстанса pgbouncer отдельно. И общий потолок серверных соединений — это число инстансов, умноженное на размер пула, поэтому при изменении числа соединений приходилось учитывать количество инстансов. Наши дефолтные значения — это три инстанса по 150, всего 450 соединений.
Чек-лист миграции через CDC: как подготовиться к переезду
Делюсь чек‑листом, который мы собрали после переноса 90 баз данных без единого отката. Чтобы миграция через CDC прошла предсказуемо, рекомендую заранее проверить настройки и учесть ограничения на каждом этапе.
Перед включением CDC на источнике
— определить, каким базам нужен CDC. Стейджинги и базы на несколько гигабайт быстрее и дешевле перенести без CDC, переведя их в readonly на время переливки.
— увеличить max text repl size;
— разложить CDC‑джобы по репликам для баз в Availability Group;
— сопоставить расчетный потолок capture — maxscans × maxtrans / pollinginterval — с фактическим write‑rate базы;
— настроить cleanup под объем данных, если CDC будет работать долго: подобрать retention, threshold и расписание.
Перед переносом схемы и снапшота
— сверить схему в PostgreSQL со схемой источника;
— снизить точность time на стороне SQL Server до шести знаков, иначе данные могут перенестись с искажениями;
— исключить из синхронизации таблицы без первичного ключа, computed‑колонки, RowVersion и служебные таблицы миграций;
— поднять textsize у pgloader, чтобы большие блобы не обрезались при чтении;
— перевести базу‑источник в READ_ONLY перед переливкой через pgloader;
— увеличить ресурсы кластера PostgreSQL и настроить shared_buffers, maintenance_work_mem и max_parallel_maintenance_workers на время переливки;
— переливать данные без индексов, ключей и констрейнтов, а после переноса восстановить их;
— после переливки обновить сиквенсы: привязанные к колонкам пересчитать из MAX(col), остальные перенести из SQL Server.
Для синхронизации
— соблюдать порядок включения: сначала source, затем снапшот из бэкапа, сделанного после включения source, и только потом sink. Иначе часть изменений может потеряться;
— отправлять изменения всех таблиц в один топик по умолчанию, чтобы сохранить их порядок и не снимать внешние ключи на время синхронизации.
— включить сжатие на воркере Kafka Connect и увеличить producer.batch.size.
— увеличивать batch.size в sink больше единицы только после снятия внешних ключей: внутри батча порядок изменений не гарантирован.
Для мониторинга
— измерять сквозную задержку по данным, а не только по телеметрии. Consumer lag показывает количество непрочитанных сообщений, но не время отставания PostgreSQL от SQL Server;
— настроить алерт не только на рост задержки, но и на исчезновение метрики;
— настроить алерт на падение задачи коннектора.
Перед переключением
— включить пулер и уменьшить default_pool_size с учетом количества его инстансов.
— прогнать заранее все ранбуки, которые понадобятся во время переключения, и проверить работу воркеров.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.